Prompt Research: Fragen organisieren und KI-Antworten überwachen
Prompt Research organisiert die Fragen, mit denen die Sichtbarkeit einer Marke in AI-Antworten untersucht wird. Themen, Erwähnungsinformationen, Sentiment, Sichtbarkeitsindikatoren und Tracking-Steuerungen werden hier zusammengeführt, dazu ein detaillierter Bericht für eine einzelne Frage.
Nutzen Sie es, um echte Kundenfragen zu untersuchen, Plattformen zu vergleichen und ein wiederholbares Monitoring-Set aufzubauen. Das Hinzufügen eines Prompts misst oder konfiguriert die Recherche; es sorgt nicht selbst dafür, dass die Marke von einer AI-Plattform eher empfohlen wird.
Die Prompt-Liste prüfen
- Öffnen Sie Prompt Research und prüfen Sie die Website.
- Legen Sie Zeitraum, Branded/Unbranded-Bereich und Platforms fest.
- Suchen Sie nach einer Frage oder sehen Sie sich die Themengruppen an.
- Nutzen Sie Filter By und Customise Columns, um die Tabelle einzugrenzen.
- Aktivieren Sie das Kontrollkästchen eines Prompts, um die Steuerungen Edit, Delete, Track und View Details einzublenden. Ein Klick auf den Prompt-Text öffnet ebenfalls den zugehörigen Einzelbericht.
Der Durchlauf nutzte Last 7 days, Unbranded und All platforms. Die Tabelle zeigte 90 Prompts über sechs Themen, mit Erwähnungen, Branded-Status, Sentiment, Visibility Score, Erscheinungshäufigkeit, Tracking, Thema und Source Intent. Mehrere Fragen hatten Ergebnisse, waren aber als Untracked gekennzeichnet. Die Präsenz in der Liste ist also kein hinreichender Beleg dafür, dass wiederkehrendes Tracking aktiviert ist.
Eine Suche reduzierte die Tabelle auf eine Frage, während die Kennzahl Total Prompts weiterhin 90 anzeigte. Behandeln Sie Tabellenfilterung und den Geltungsbereich der dashboardweiten Zusammenfassung getrennt.
Einen einzelnen Prompt hinzufügen
Wählen Sie Add Prompt. Das Formular für Einzeleinträge enthält Select Topic, Enter Your Prompt und Location, mit Add als Absendesteuerung. Der Erklärungstext bezeichnet Thema und Ort als optional; verwenden Sie sinnvolle Werte, wo relevant, und prüfen Sie die Validierung in Ihrem Konto.
Formulieren Sie eine konkrete Kundenfrage. Für lokale Discovery sollten Sie den gemeinten Ort angeben: „Can you recommend a Kerala restaurant in Southampton, UK?" ist kontrollierter als „Where should I eat nearby?" Prüfen Sie das Standortprofil der Website, statt anzunehmen, dass jedes Modell weiß, was „nearby" bedeutet.
Das Formular für Einzeleinträge wurde geprüft, ohne einen künstlichen Prompt im Konto anzulegen.
Prompts per Bulk-Import einspielen
Der Tab Bulk Prompts akzeptiert eine CSV-Datei und nennt ein Maximum von 20 MB. Die Anweisungen benennen diese Spalten:
| Spalte | Anforderung | Im Formular angezeigte Bedeutung |
|---|---|---|
| Prompt | Erforderlich | Exakte Frage, die in AI-Antwortmaschinen ausgewertet wird. |
| Topic | Optional | Kategorie oder Themengebiet der Frage. |
| Country | Optional | Zweibuchstabiger Code wie GB, US oder IN. |
| Location | Optional | Stadt oder Region; laut Anweisungen wird bei leerem Wert der Standort des Website-Profils verwendet. |
Das Formular zeigt außerdem Steuerungen für Select Topic und Location, gefolgt von Update Prompts In Bulk. Der Vorrang zwischen Formularwerten und Werten je Zeile, der Umgang mit Duplikaten und die Importvalidierung wurden nicht getestet. Bestätigen Sie dieses Verhalten vor einem großen Upload.
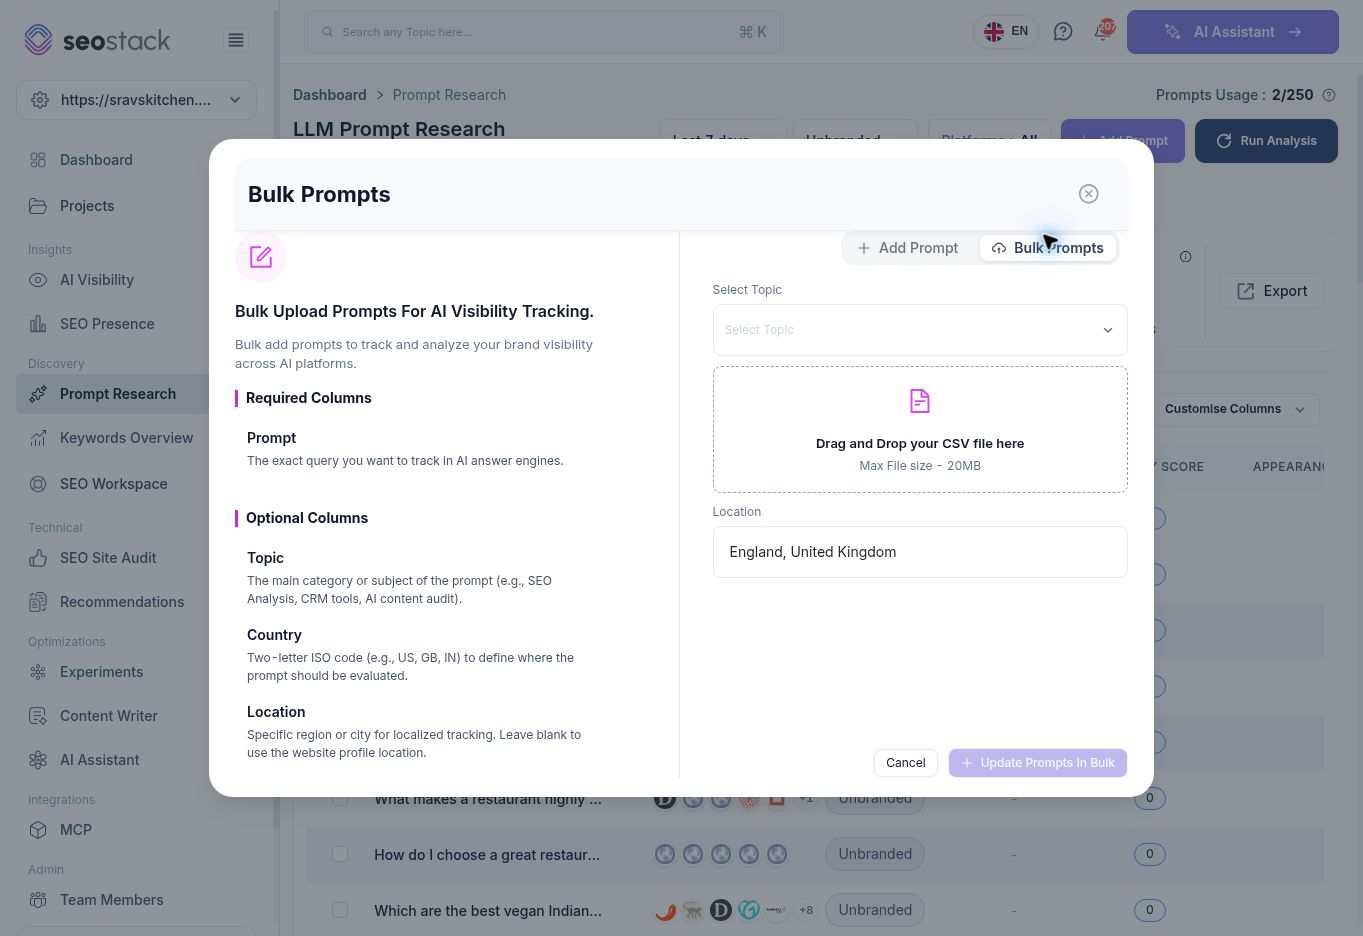 Bulk-Prompt-Formular und dokumentierte CSV-Spalten.
Wiederkehrendes Tracking einrichten
Wählen Sie die gewünschten Prompt-Zeilen aus und klicken Sie auf Track. Der Konfigurationsdialog listet die ausgewählten Themen auf und bietet 2x/Week, Weekly und Monthly. Daily war im getesteten Konto hinter einem Add-on gesperrt. Außerdem gibt es ein Kontrollkästchen Rank Change Alerts, das standardmäßig aktiviert war.
Prüfen Sie Frequenz, ausgewählte Fragen und Alert-Einstellung, bevor Sie Confirm & Start Tracking wählen. Der Durchlauf öffnete diesen Dialog und brach ihn ab; wiederkehrende Läufe wurden nicht aktiviert, kein Add-on gekauft und kein Alert versendet. Zeitplanung und Alert-Zustellung bleiben unbestätigt.
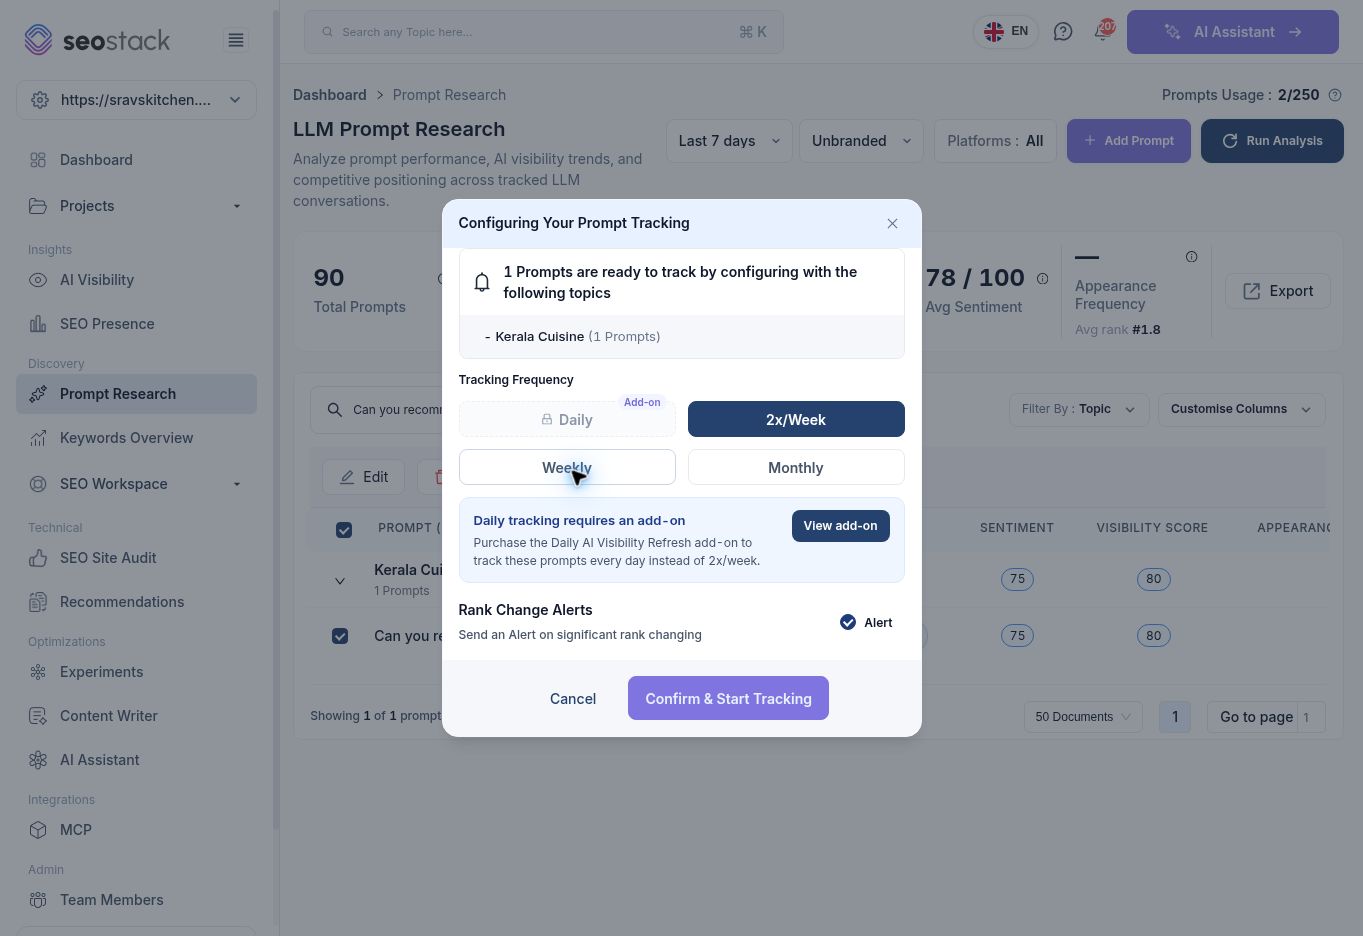 Einstellungen für Tracking-Frequenz und Rank-Change-Alerts.
Die Nutzungsanzeige zeigte 2/250 Prompts, obwohl der Bericht 90 Fragen enthielt. Der Tooltip beschrieb ein monatliches Kontingent. Setzen Sie Nutzungszähler, Listenbestand, Anzahl der Läufe und Anzahl der getrackten Fragen nicht gleich, ohne zu klären, wie jeweils gezählt wird.
Kennzahlen sorgfältig lesen
| Kennzahl oder Feld | Praktische Interpretation |
|---|---|
| Total Prompts | Fragenbestand im angegebenen Geltungsbereich des Berichts, nicht Besuche oder eindeutige Nutzer. |
| Visibility Consistency / Prompt Success Rate | Unterschiedliche Plattformmaße; gehen Sie nicht davon aus, dass sie denselben Nenner haben oder dasselbe bedeuten. |
| Competitor Visibility Gap | Ein Lückenindikator, den Sie anhand der Fragen und der Wettbewerbsbelege untersuchen sollten. |
| Avg Sentiment | Vom Modell abgeleitetes Sentiment, keine Kundenzufriedenheitsumfrage. |
| Appearance Frequency | Ein Häufigkeitsindikator für beobachtete Erscheinungen; ein Strich bedeutet fehlend/nicht verfügbar, nicht automatisch null. |
| Average Position / Avg rank | Ein Positionsmaß in gesampelten AI-Ausgaben, kein organisches Google-Ranking. |
| Source Intent | Eine Klassifikation, die gegen den Wortlaut der tatsächlichen Frage zu prüfen ist. |
Die genauen Formeln für Consistency-, Success- und Gap-Kennzahlen der Übersicht erfordern eine Bestätigung durch den Anbieter. In der getesteten Übersicht zeigte Visibility Consistency 100 %, während die Prompt Success Rate bei 17,78 % lag – 100 % Consistency darf also nicht als „erscheint in jeder Antwort" beschrieben werden.
Eine einzelne Frage untersuchen
Die Detailseite zeigt Analysis runs, Platforms covered, Runs with brand mentioned und Latest run, gefolgt von Erscheinungshäufigkeit, durchschnittlicher Position, Mention Share of Voice, Citation Rate und Sentiment.
Die Diagramme erlauben die Betrachtung von Appearance, Mention SoV, Citation Rate und Sentiment; der Zeitreihenbereich bietet Mentions oder Avg Rank sowie den Wettbewerbsvergleich. Sources & Citation Categories und AI Recommendations haben jeweils die Bereiche Latest run und Latest per platform. Diese Abschnitte beschreiben ausdrücklich Belege aus ausgewählten Läufen, nicht alle historischen Läufe zusammengefasst.
Nutzen Sie Run Analysis Now für eine frische Einzelanalyse und warten Sie, bis alle Plattformen fertig sind, bevor Sie die Ergebnisse interpretieren. Optimise with Content Writer steht als Steuerung für den nächsten Schritt bereit; ein Entwurf garantiert keine künftige Erscheinung oder Zitierung.
Die Detailseite zeigte zunächst keine Historie für eine Frage, deren Übersichtszeile Sichtbarkeit und Sentiment aufwies. Das ist eine Diskrepanz bei Geltungsbereich/Historie, kein Beleg für null tatsächliche Erwähnungen. Prüfen Sie Laufanzahl und Zeitraum, bevor Sie leere Diagramme oder scheinbare Nullwerte interpretieren.
Die Antwort hinter einem Ergebnis prüfen
Der Einzeltest wurde mit drei Läufen über drei Plattformen abgeschlossen. Alle drei erwähnten die Marke. Die Ansicht All zeigte 100 % Appearance Frequency, durchschnittliche Position 2, 38 % Mention Share of Voice, 67 % Citation Rate und Sentiment 75/100. Die Filterung auf ChatGPT reduzierte den Bericht korrekt auf einen Lauf, mit Position 1 und 100 % Citation Rate. Ein 100-%-Ergebnis aus einem einzigen Lauf ist kein Beleg für langfristige Konsistenz.
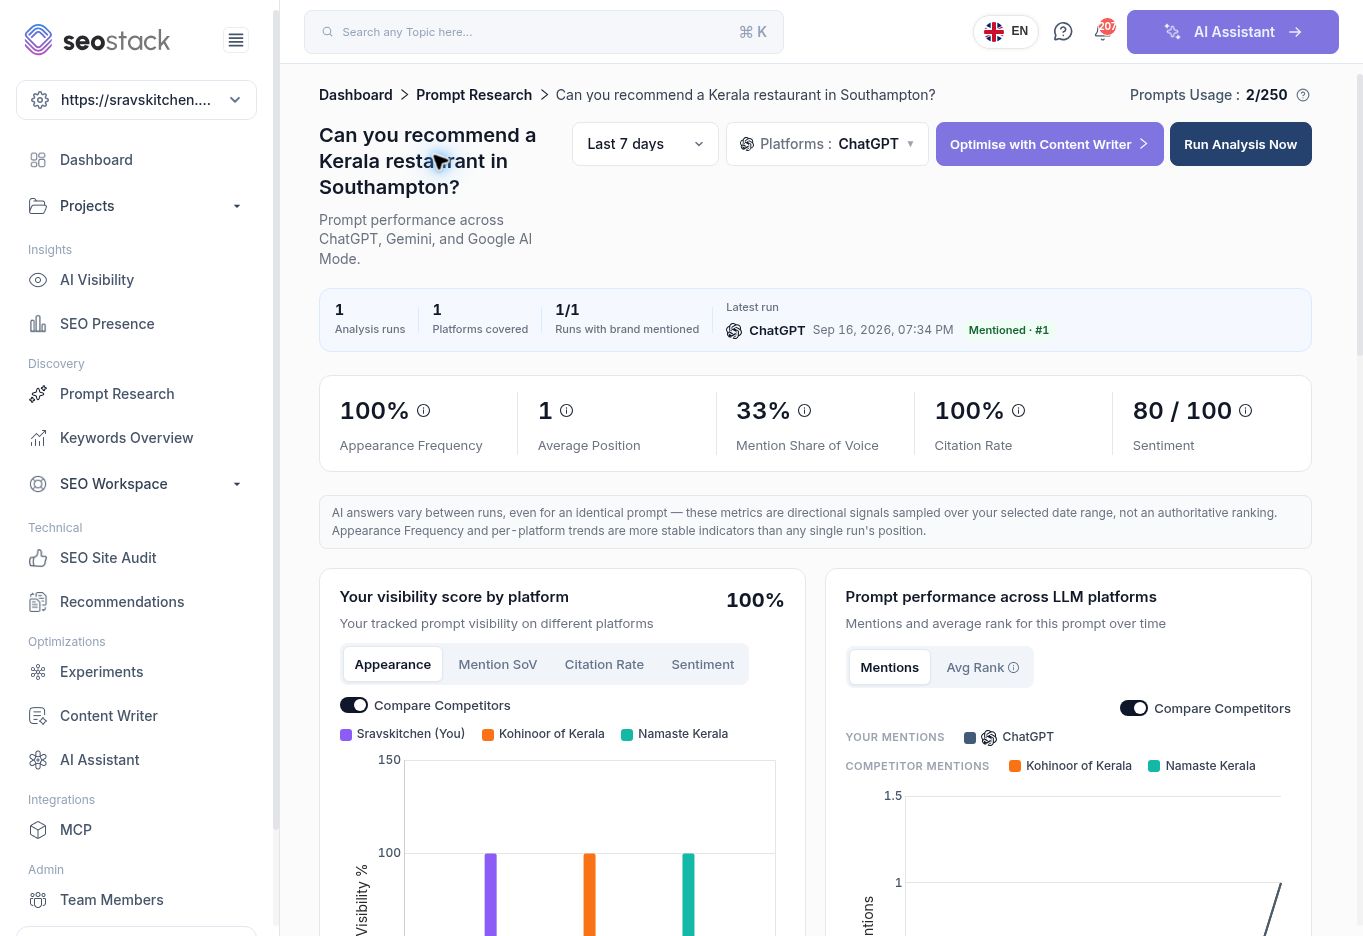 Prompt-Detailansicht nach einem abgeschlossenen Lauf, gefiltert auf ChatGPT.
Die Tabelle Prompt Run History Across Platforms zeigt Datum/Uhrzeit, Plattform, Erwähnungsstatus, Position, Suchanfragen, Antwort, Zitierungen und Region. Öffnen Sie Response Breakdown, um vier Tabs zu prüfen:
- Response: was das Modell in diesem Lauf geantwortet hat.
- Competitors: in der Antwort genannte Marken; der Dialog erklärt, dass Blau eine Marke kennzeichnet, die auch als Quelle zitiert wurde.
- Sources: Links, die das Modell verwendet oder referenziert hat.
- Actions: vorgeschlagene nächste Schritte aus dieser Analyse.
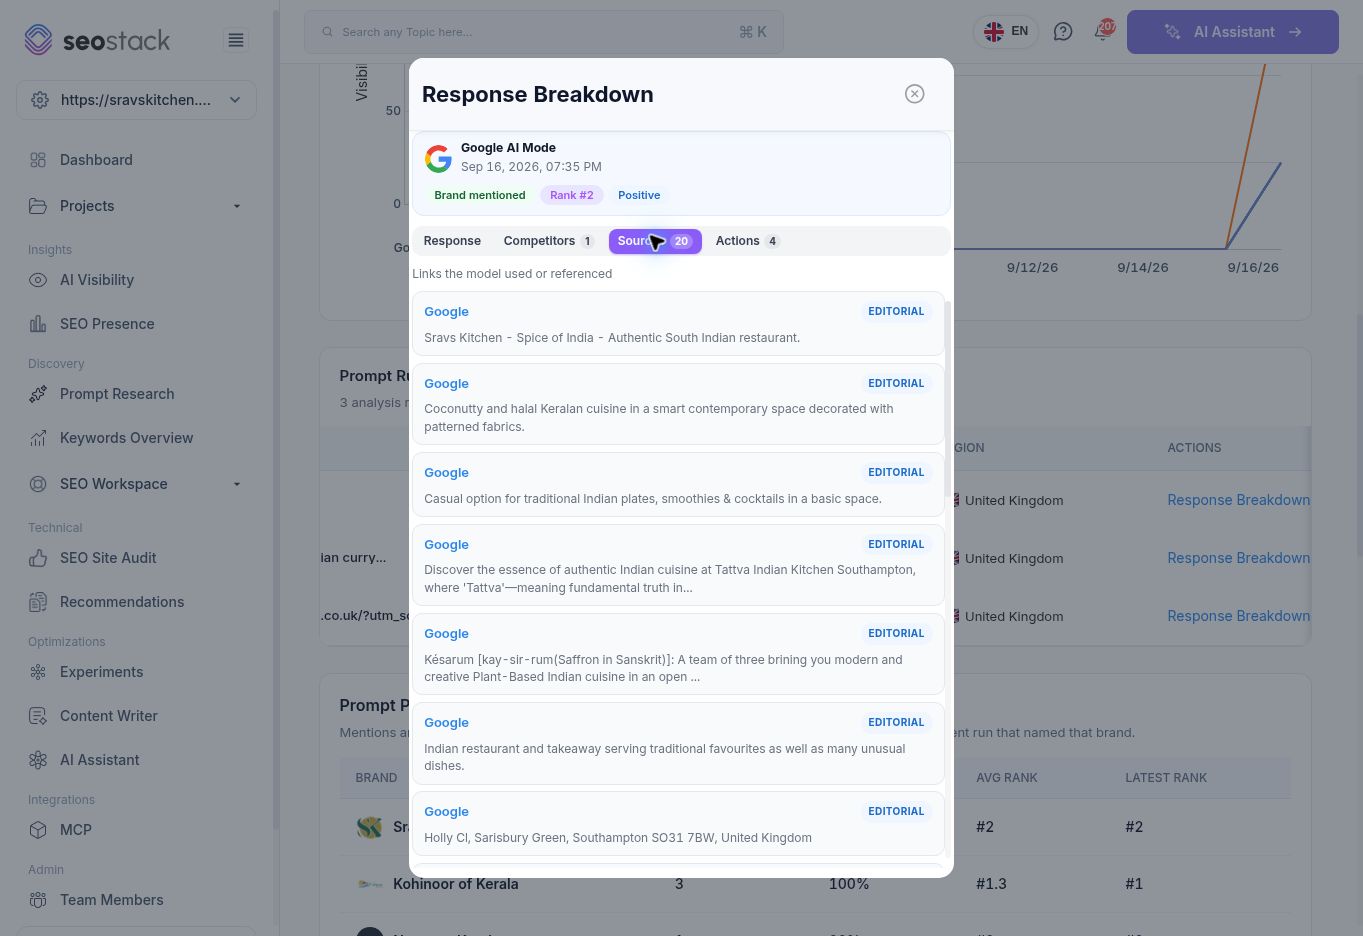 Tab „Sources" innerhalb eines einzelnen Response Breakdown.
Quellenkarten können Vermittlerdomains wie Google statt der eigenen Domain des Unternehmens verwenden. Prüfen Sie das tatsächliche Ziel und den Kontext, bevor Sie eine Karte als Zitierung der eigenen Website werten. Kategorielabels wie Editorial, UGC und Corporate sind zu prüfende Klassifikationen, keine unabhängig verifizierten Qualitätsbewertungen.
Die Markenvergleichstabelle unterscheidet Mentions, Visibility, Avg Rank und Latest Rank. Laut Erläuterung stammt Latest Rank aus dem jüngsten Lauf, in dem die Marke genannt wurde; es ist nicht zwingend ein Rang aus dem insgesamt jüngsten Lauf.
Prüfen Sie vorgeschlagene Maßnahmen gegen das tatsächliche Angebot des Unternehmens. Übernehmen Sie vom Modell generierte Angaben zu Gerichten, Ernährungsformen, Öffnungszeiten oder Services nicht ungeprüft, und werten Sie eine vorgeschlagene Maßnahme nicht als Beleg für eine fehlende Funktion auf der Live-Website.
Beispiel: ein brauchbares lokales Fragenset aufbauen
Wählen Sie für ein Restaurant Fragen zu seiner tatsächlichen Küche, Lage, Speisekarte und zu relevanten Kundenbedürfnissen. Trennen Sie Markenfragen von generischen Discovery-Fragen. Die beobachtete Liste enthielt im Themenset eines britischen Restaurants eine Frage zu Southampton, NY: ein Anlass, die Relevanz zu prüfen, und nicht, eine Landingpage für New York anzulegen.
Vergleichen Sie wiederholte Ergebnisse für dieselben Fragen und Plattformen. Prüfen Sie Quellen und inhaltliche Lücken, bevor Sie Content planen. AI-Antworten variieren selbst bei identischen Prompts, und die Detailseite beschreibt ihre Messwerte ausdrücklich als richtungsweisende, gesampelte Signale und nicht als verbindliche Rankings.
Troubleshooting und geprüfter Umfang
Während des kontoweiten AI-Laufs war Add Prompt vorübergehend deaktiviert; es wurde nach Abschluss verfügbar. Warten Sie den laufenden Vorgang ab, statt wiederholt einen weiteren zu starten.
Formulare für Einzel- und Bulk-Eingabe, Auswahlaktionen, Tracking-Konfiguration und Steuerungen des Einzelberichts wurden geprüft. Import-/Exportdateien, das Bearbeiten/Löschen von Prompts, wiederkehrende Zustellung und die Übergabe an den Content Writer wurden nicht ausgeführt. Die Übersichtsergebnisse wurden vor und nach einer abgeschlossenen Analyse über alle Modelle geprüft. Eine separate Einzelanalyse wurde über drei Plattformen abgeschlossen; ihre Historie, der Plattformfilter und die Tabs des Response Breakdown wurden verifiziert.