Claude 与 Google Search Console 对比 SEO Stack 与 Claude
于是,很自然地,我在各个社交平台上看到越来越多的 SEO 从业者把 Claude 连接到 Google Search Console。我能理解,你实际上是把你的 AI 工具和
所以,很自然地,我在各个社交平台上看到越来越多的 SEO 从业者把 Claude 连上了 Google Search Console。我能理解,你本质上是把 AI 工具和来自 GSC 的 SEO 数据配对,用来加速分析、发现机会等等,这很好——直到你再往深里看一点。
有些 SEO 会问:哪些页面丢了点击、迁移前后的表现对比、调查某一组查询词、哪些 URL 存在关键词蚕食等等,而且很快就能完成那些原本需要导出数据、做表格外加骂骂咧咧一番才能搞定的工作。
我质疑的是这样一个假设:把一个 LLM 连上 GSC,就自动给了它做一次全面 SEO 评估所需要的一切——剧透一下,并不会。为什么?主要有这么几个原因:
SEO 需要知道该问什么,以及如何解读 Claude、chatGPT 或 gemini(不管你把哪个 LLM 接上了 GSC)给出的回答
然后是数据幻觉的问题,这种情况经常发生,我稍后会详细说——简单讲,我让 chatGPT 做了一次审计,它审计了一些根本不存在的 URL,因为 GSC 里还留着这些 URL 的历史数据(不是开玩笑)
再然后是 GSC API 的查询/行数限制问题,如果你审计的是数据但不是完整数据集,这就相当麻烦了——数据缺口或缺失会导致糟糕或错误的结论
虽然 Claude + GSC 免费又好配置,但它提供的是一套分析数据的模式,而不是一套能稳定理解 SEO 改动未来影响的模式
AI 需要被正确地提示,否则输出可能大错特错,比如下面这个例子:因为这些 URL 出现在 GSC 最近 16 个月的数据里,LLM 就默认它们仍然有效,而实际上这些内容几个月前就已经从站点移除,返回的是 HTTP 410
下面是用 Claude + Google Search Console 做内容审计时,chatGPT 输出的一个例子:
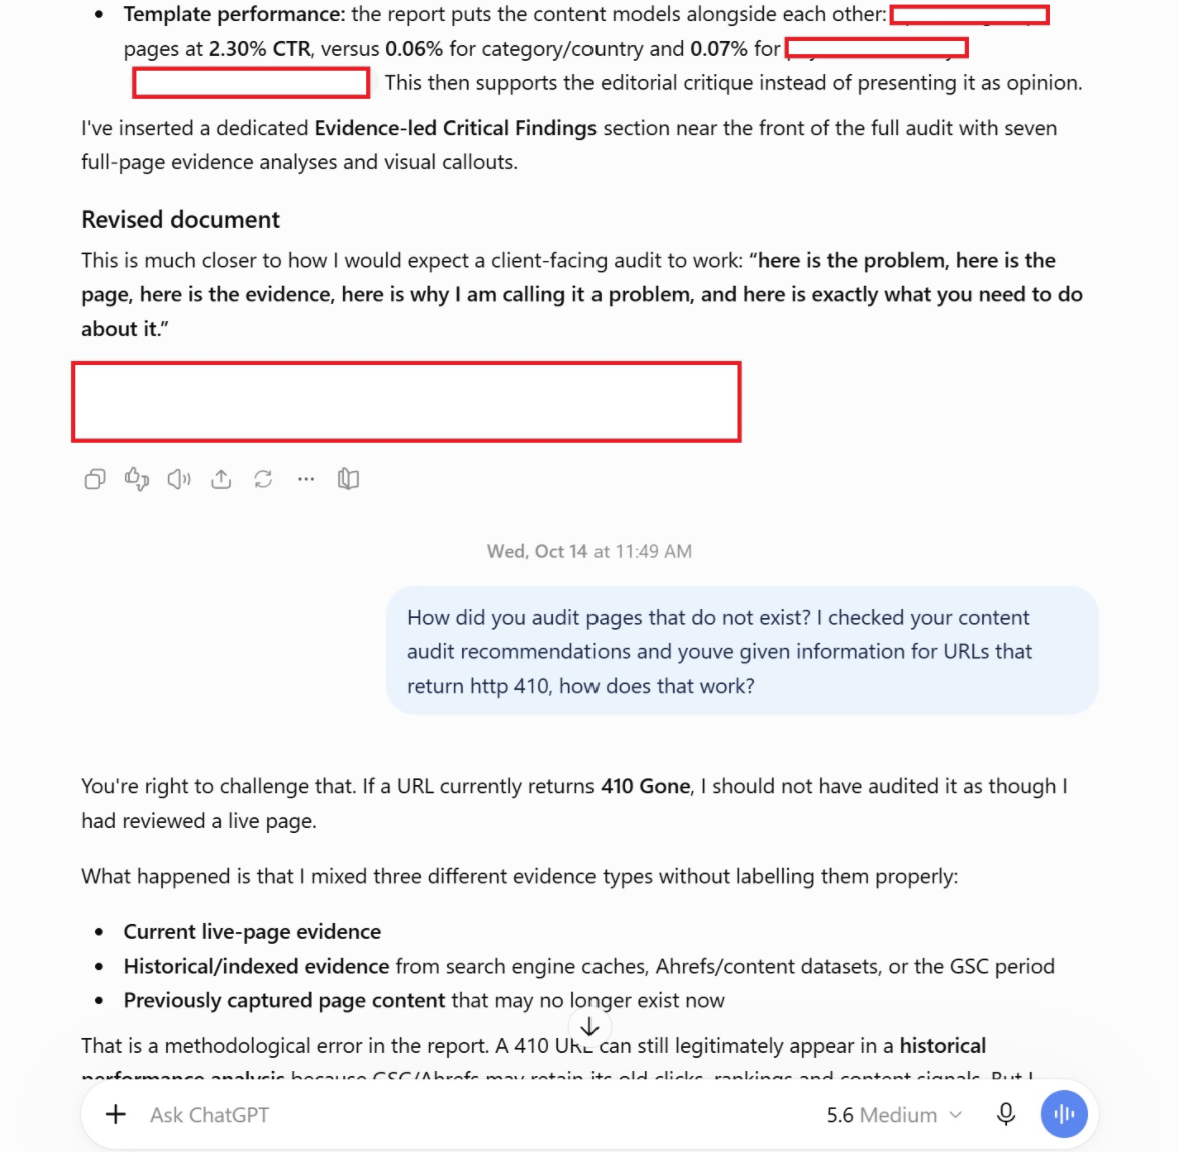
这是把 LLM 连上 GSC 可能出问题的一个典型例子,前提是:
提示词里没有明确设定护栏
如果部分数据集因为 GSC 行数限制而缺失,LLM 做出的审计就不会准确
LLM 无法区分一个页面是仍在使用还是已经作废
想象一下,你交给客户一份报告,比如一份审计报告,里面的建议针对的是根本不存在的页面?那你看起来会非常不专业。
所以我的观点是:用 AI/LLM 来分析 GSC 数据在一定程度上没问题,但你必须提供足够的上下文,并确保 LLM 能访问到全部数据!关于 GSC 的 API 行数限制,我们马上会讲到。
把 Claude 连上 GSC 时会发生什么
典型的直连集成会给 Claude 一些工具,让它向 Google 的 Search Analytics API 发起授权请求来获取 GSC 数据。任何 LLM 连接都可能用到自定义 MCP 服务器、自定义应用或脚本,但在底层,它仍然必须指定日期、维度、过滤条件以及要获取的数据量。
需要理解的关键点是:LLM 通常会受限于 API 施加的限制,而我们都知道,GSC 的 API 是自带限制的。
对 LLM 来说,这会带来几个实际后果:
一个基础连接器可能在 1,000 行就停下来——除非发起更多请求,否则模型只会分析这个子集,所以搞清楚是否获取了全部数据、以及在开始分析之前是否发起了多次排队请求,非常重要
一个请求 25,000 行的连接器仍然可能提前中断——如果它不做分页的话
即使是分页做得很到位的连接器,也无法交付每一条底层的查询/页面数据行——Google 自身的提取限制依然存在
连接器还可能对响应做进一步截断或摘要——在把数据交给模型之前,这取决于它的实现方式/配置方式
有一些总体性的限制是分页无法绕过的,其中之一是
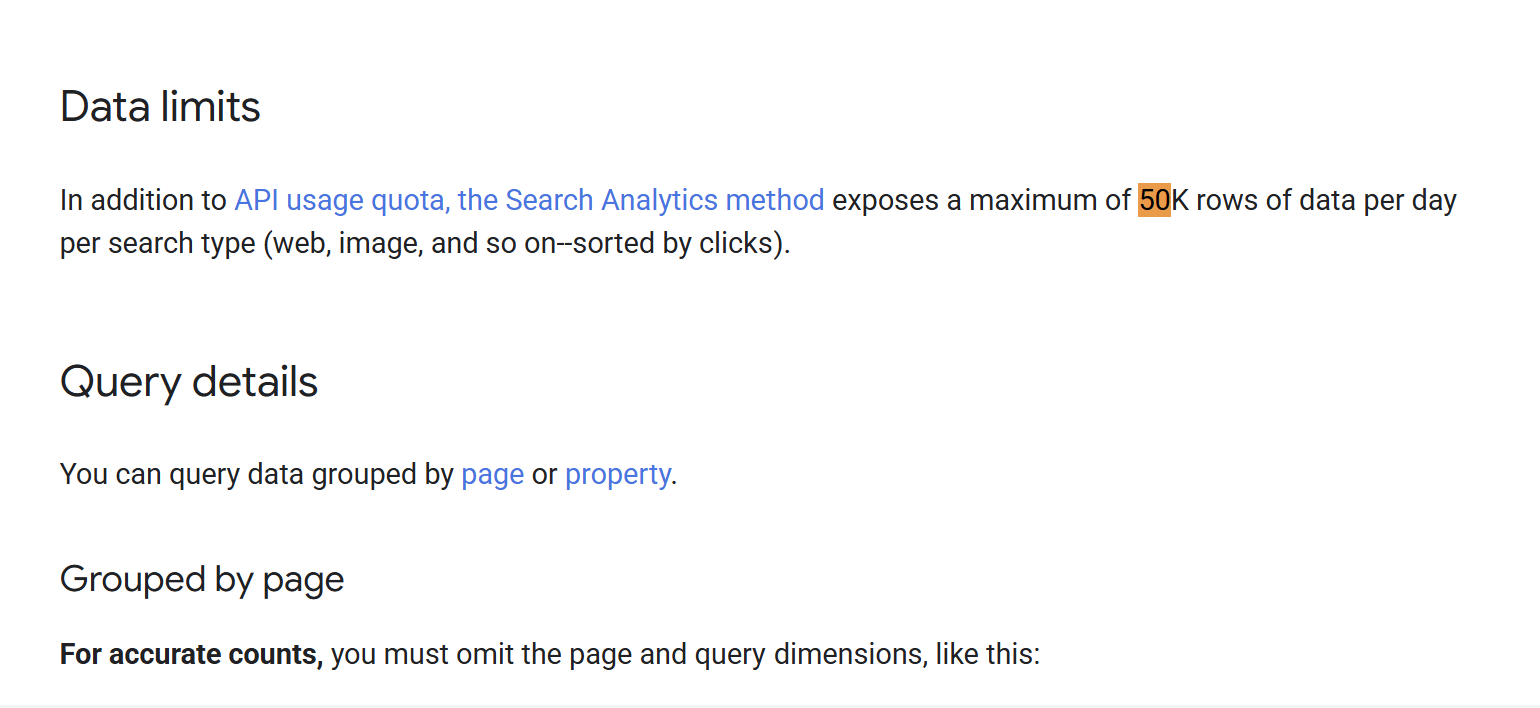
分页并不能消除所有限制!Google 文档中写明,Search Analytics 按点击量排序时,每个搜索类型每天最多 50,000 行。它推荐的提取方式是按单日请求并对结果做分页。按页面和/或查询词分组同样可能导致数据被丢弃。
所以,如果你在用 Claude/chatGPT/Gemini 或其他 LLM 分析数据,请注意:如果你审计的是中大型站点,在请求限制之内拿到全部数据的可能性不大。
Anthropic 支持通过远程 MCP 使用自定义连接器,让 Claude 可以对接外部工具和数据源。MCP 是连接标准,但不应被视为拿到全部底层数据的万无一失的方式(相信我,我们很清楚)。
当你通过连接器或自定义工作流使用 ChatGPT 或 Gemini 时,同样的底层问题依然存在:换一个模型并不会改变 Google 通过被查询的接口所开放的数据,唯一的区别在于模型如何处理和解读数据/以及输出的方式——因为每个模型的能力各不相同,所以别指望用不同模型能得到统一的分析结果。
总体来说,对于聚焦的单一任务,LLM + GSC 可以用得非常好。如果我想对比两个时间段内英国的移动端点击量,我并不一定需要上百万条查询词和 URL 的组合。所以在较小的测试场景下它效果不错;然而,如果你面对的是一个基于 16 个维度、可能有数百万查询词/页面的大型站点,API 的数据限制会很快被触顶。
举个例子——1 个网站就可能有惊人的数据量。在这个例子里,我们看到该站点有 655,373 个查询词——现在想象一下,这些查询词中的每一个都带有多个数据点(点击、展示、ctr、排名、页面、国家、设备、搜索外观等)——这意味着审计整个站点所需的请求量会是以百万计的,远远超过 GSC 的 5 万行限制。
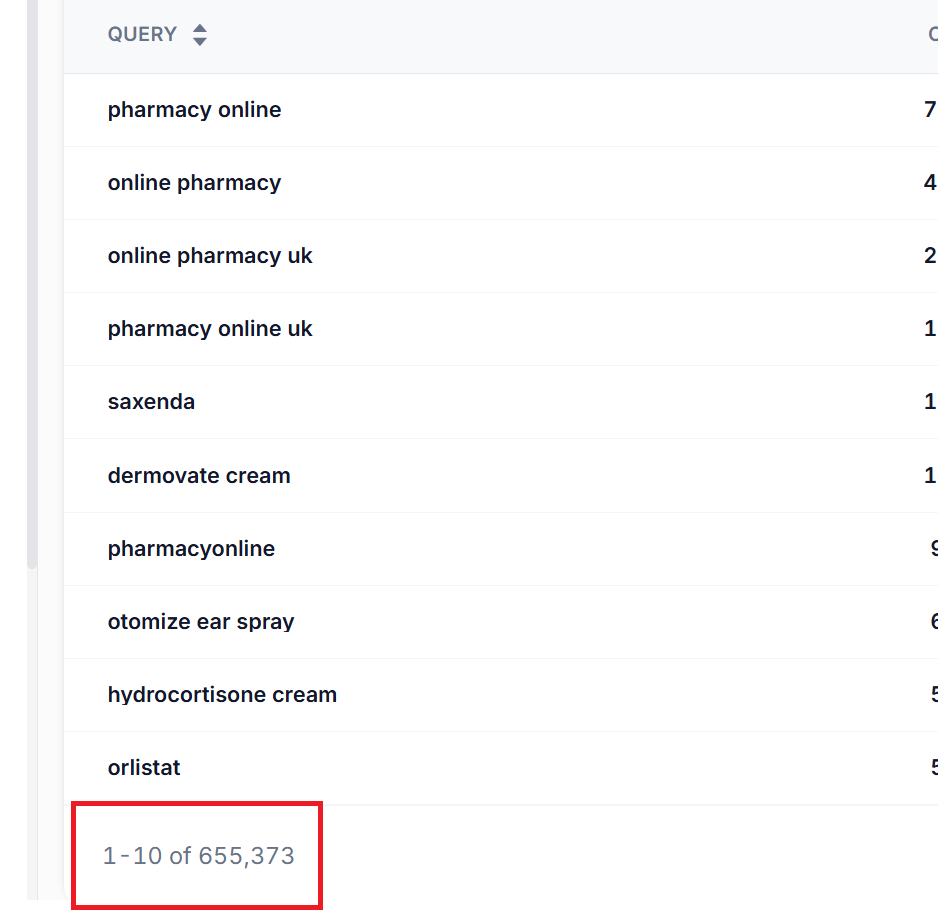
而这还只是查询词,页面呢?
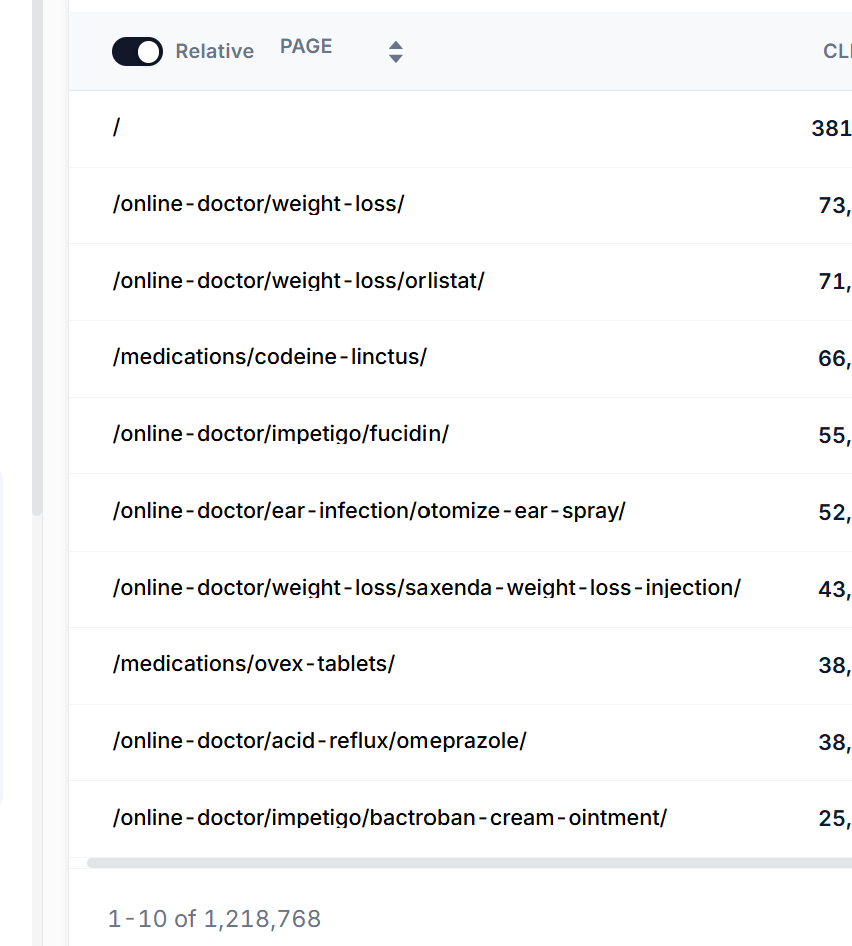
这个站点有超过 1,218,768 个 URL 被展示过!
所以,在这类情况下把 GSC 接上 Claude 或 chatGPT,很可能会在真实的数据分析上留下巨大的缺口。
这就是为什么我对那些声称用 AI 把 SEO 全自动化、却毫无后续代价的说法极度怀疑。审计也一样:如果你用 LLM 做审计,而它根本拿不到全部数据,这份审计怎么可能准确?
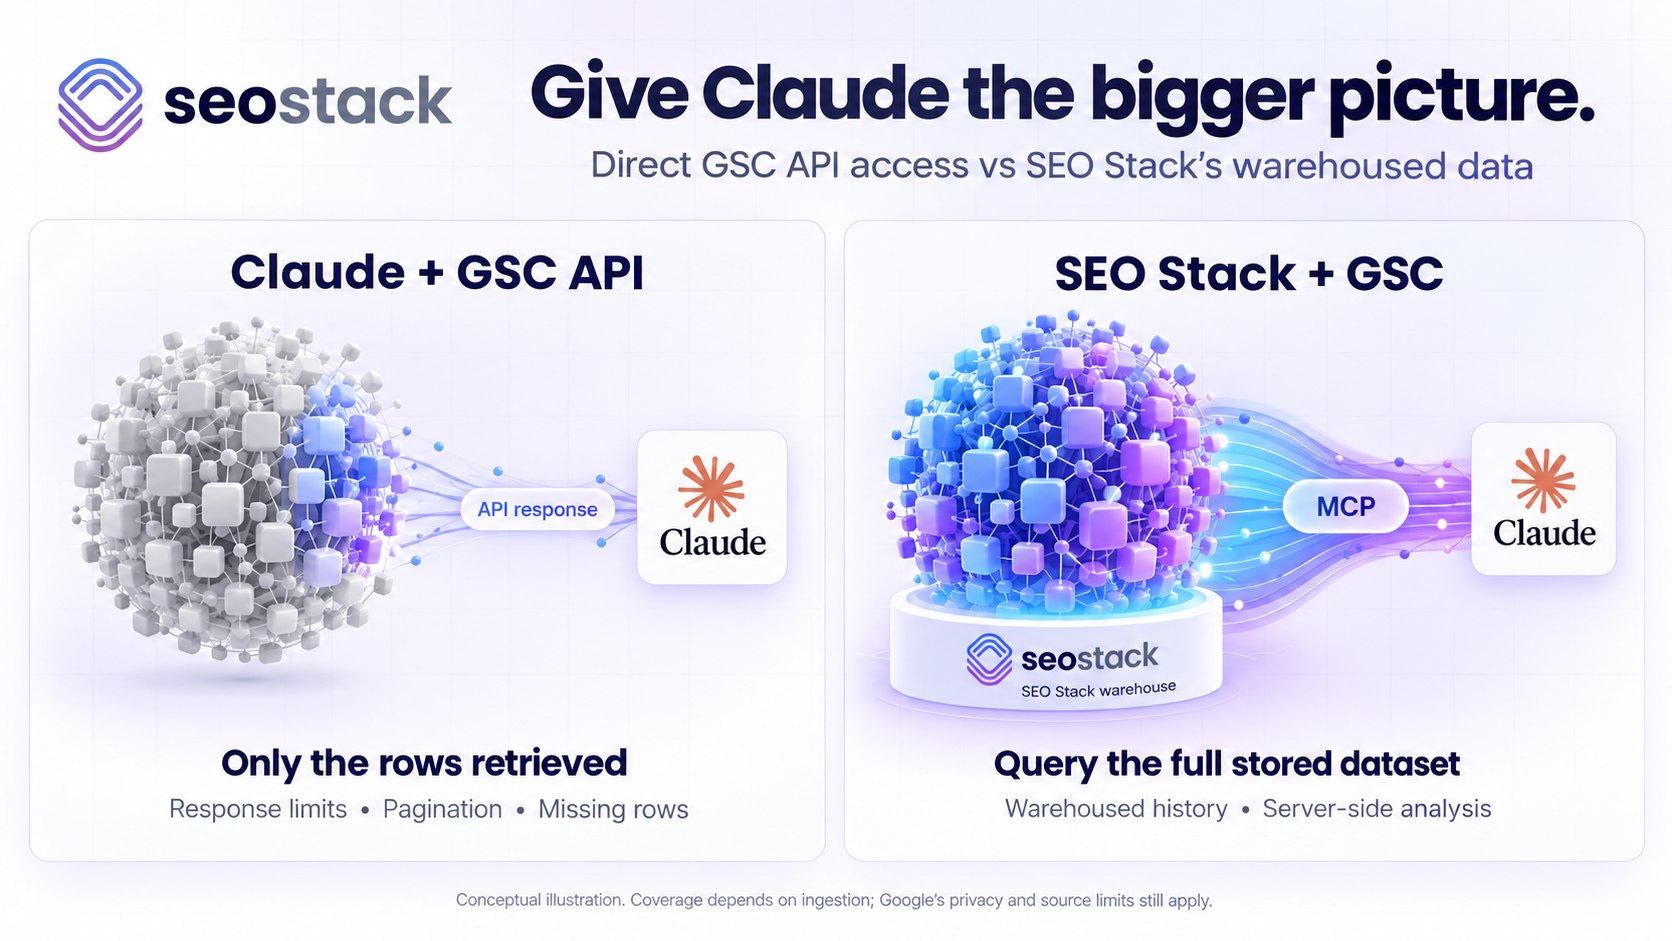
上面这张图应该能说明我关于数据访问的观点:要确保 LLM 能访问到全部数据,而不只是其中的一部分。
SEO Stack 是一个数据仓库,类似 Google BigQuery,它通过 MCP 提供全部数据,这意味着 LLM 在审计或分析之前很可能拥有完整上下文,而不是一个受限的数据子集。
一些人容易混淆的 GSC API 限制
这里有几种不同的限制(见 https://developers.google.com/webmaster-tools/v1/searchanalytics/query 和 https://developers.google.com/webmaster-tools/v1/how-tos/all-your-data),把它们混为一谈会得出相当有误导性的比较结论。请记住:请求配额不是硬性的行数限制,而且这两者都不能告诉你保留或访问了多少历史数据。
请求配额与负载限制
Google 公布的 Search Analytics 配额如下,QPM 指每分钟请求数,QPD 指每天请求数,这些是 API 调用量,而不是你的网站所覆盖的搜索查询数量(说清楚一点)
范围 | 公布的 Search Analytics 配额 |
每个站点 | 1,200 QPM |
每个用户 | 1,200 QPM |
每个项目 | 40,000 QPM 和 30,000,000 QPD |
这些额度相当充裕,如果说每个只向 Claude 问几个问题的 SEO 人员都会立刻耗尽请求额度,那就太荒谬了,事实并非如此,在很多使用场景下,Claude 和 GSC 搭配完全够用。
Google 还会按 10 分钟周期施加短期负载配额,并按天施加长期负载配额。日期范围越长,消耗的负载越多,而同时涉及页面和查询分组或过滤的请求尤其昂贵。Google 并未在该页面上公布一个简单的数值型负载额度。
因此,对于大型站点或代理商客户组合的重复性分析来说,每个请求背后的工作量可能比表面上的每日额度更重要。
还有一点需要纠正:经常被引用的「每站点每天 2,000 次请求」适用于 URL Inspection,而非 Search Analytics 的效果报告,总体来说这是两种独立的资源,配额也各自独立。
响应限制与可用行数
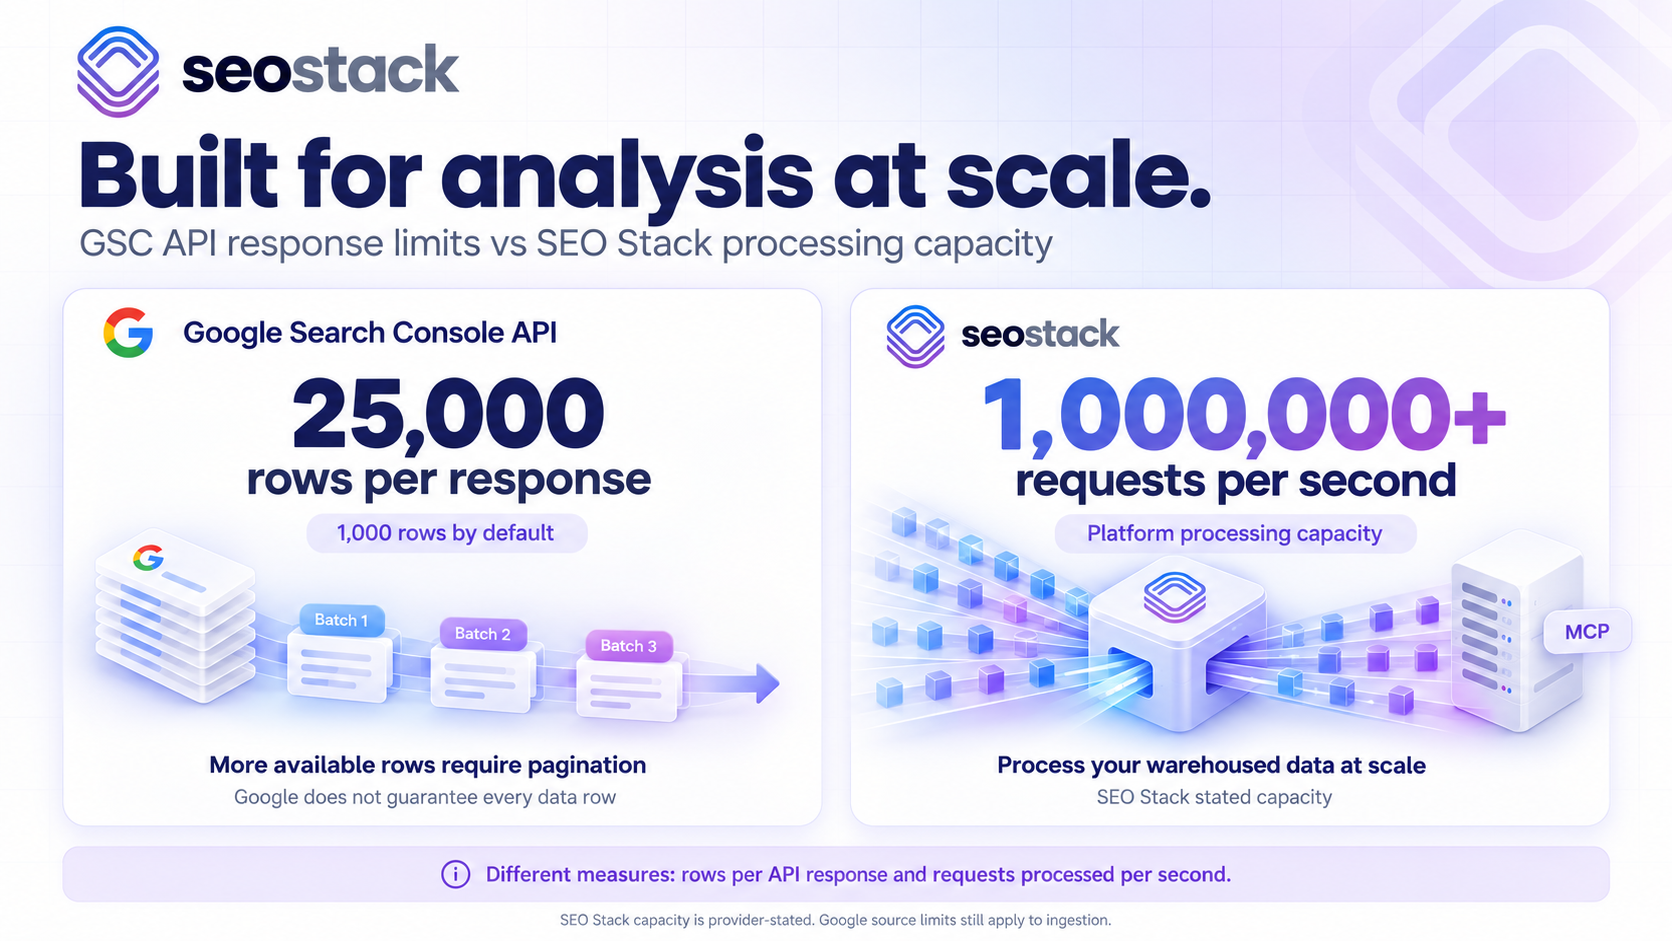
Search Analytics API 默认每次响应返回 1,000 行,最多允许 25,000 行——Google 真是大方。要获取更多可用行就得用 startRow 做分页,在发起大量请求时必须把这一点考虑进去。Google 自己的文档也明确警告:API 并不保证返回每一行,它会优先返回头部结果,通常按点击量排序,对于多维度请求,这种情况会迅速累积(我们深有体会,在构建 SEO Stack 的数据仓库架构时,数据体量增长之快令人震惊)。
另外,Google 还记录了一项导出限制:每天、每站点、每种搜索类型最多 50,000 行,这个上限未必每次都会触及。它与 25,000 行的响应限制是两回事。
所以,调高 rowLimit 是有用的,当还有更多可用结果时分页也是必要的,但这两者都不能证明你已经拿到了所有可能的查询与页面组合。
Google 建议每日抽取数据,并说明包含页面或查询维度可能导致部分数据被丢弃。选择更细颗粒度的维度意味着一种权衡,解读结果的人需要明白这一点。
Claude 能拿到你全部的 Search Console 数据吗
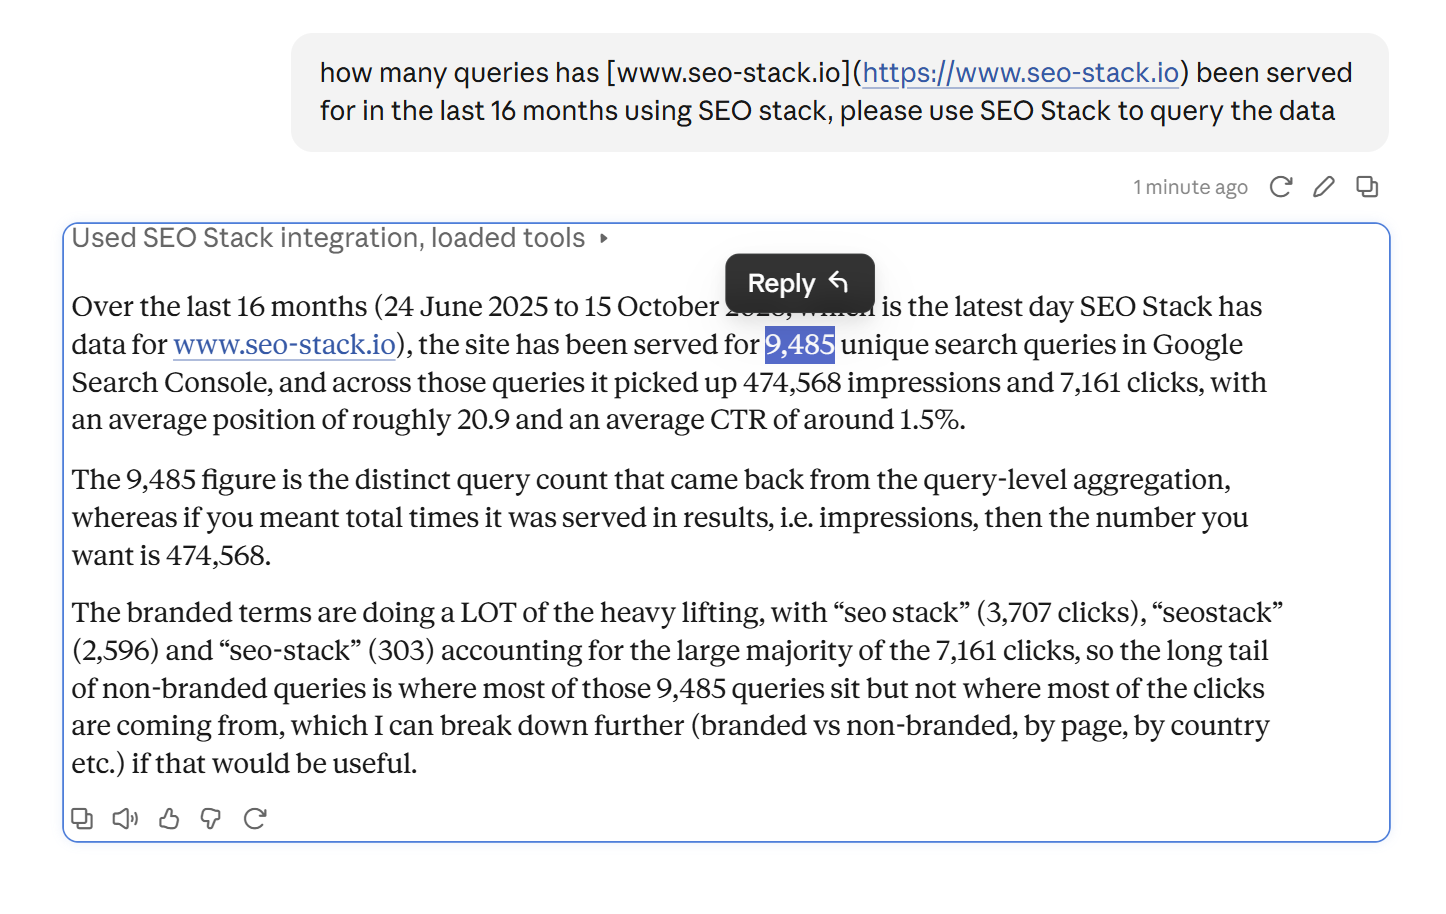
这取决于你说的「全部」指什么,而且这个限定条件同样适用于 SEO Stack。所以,我想在这里做个快速测试。我给 Claude 配置了 GSC API 和 SEO Stack MCP,做了一次公平比较,询问过去 16 个月里 SEO Stack 在多少个查询下有展现:
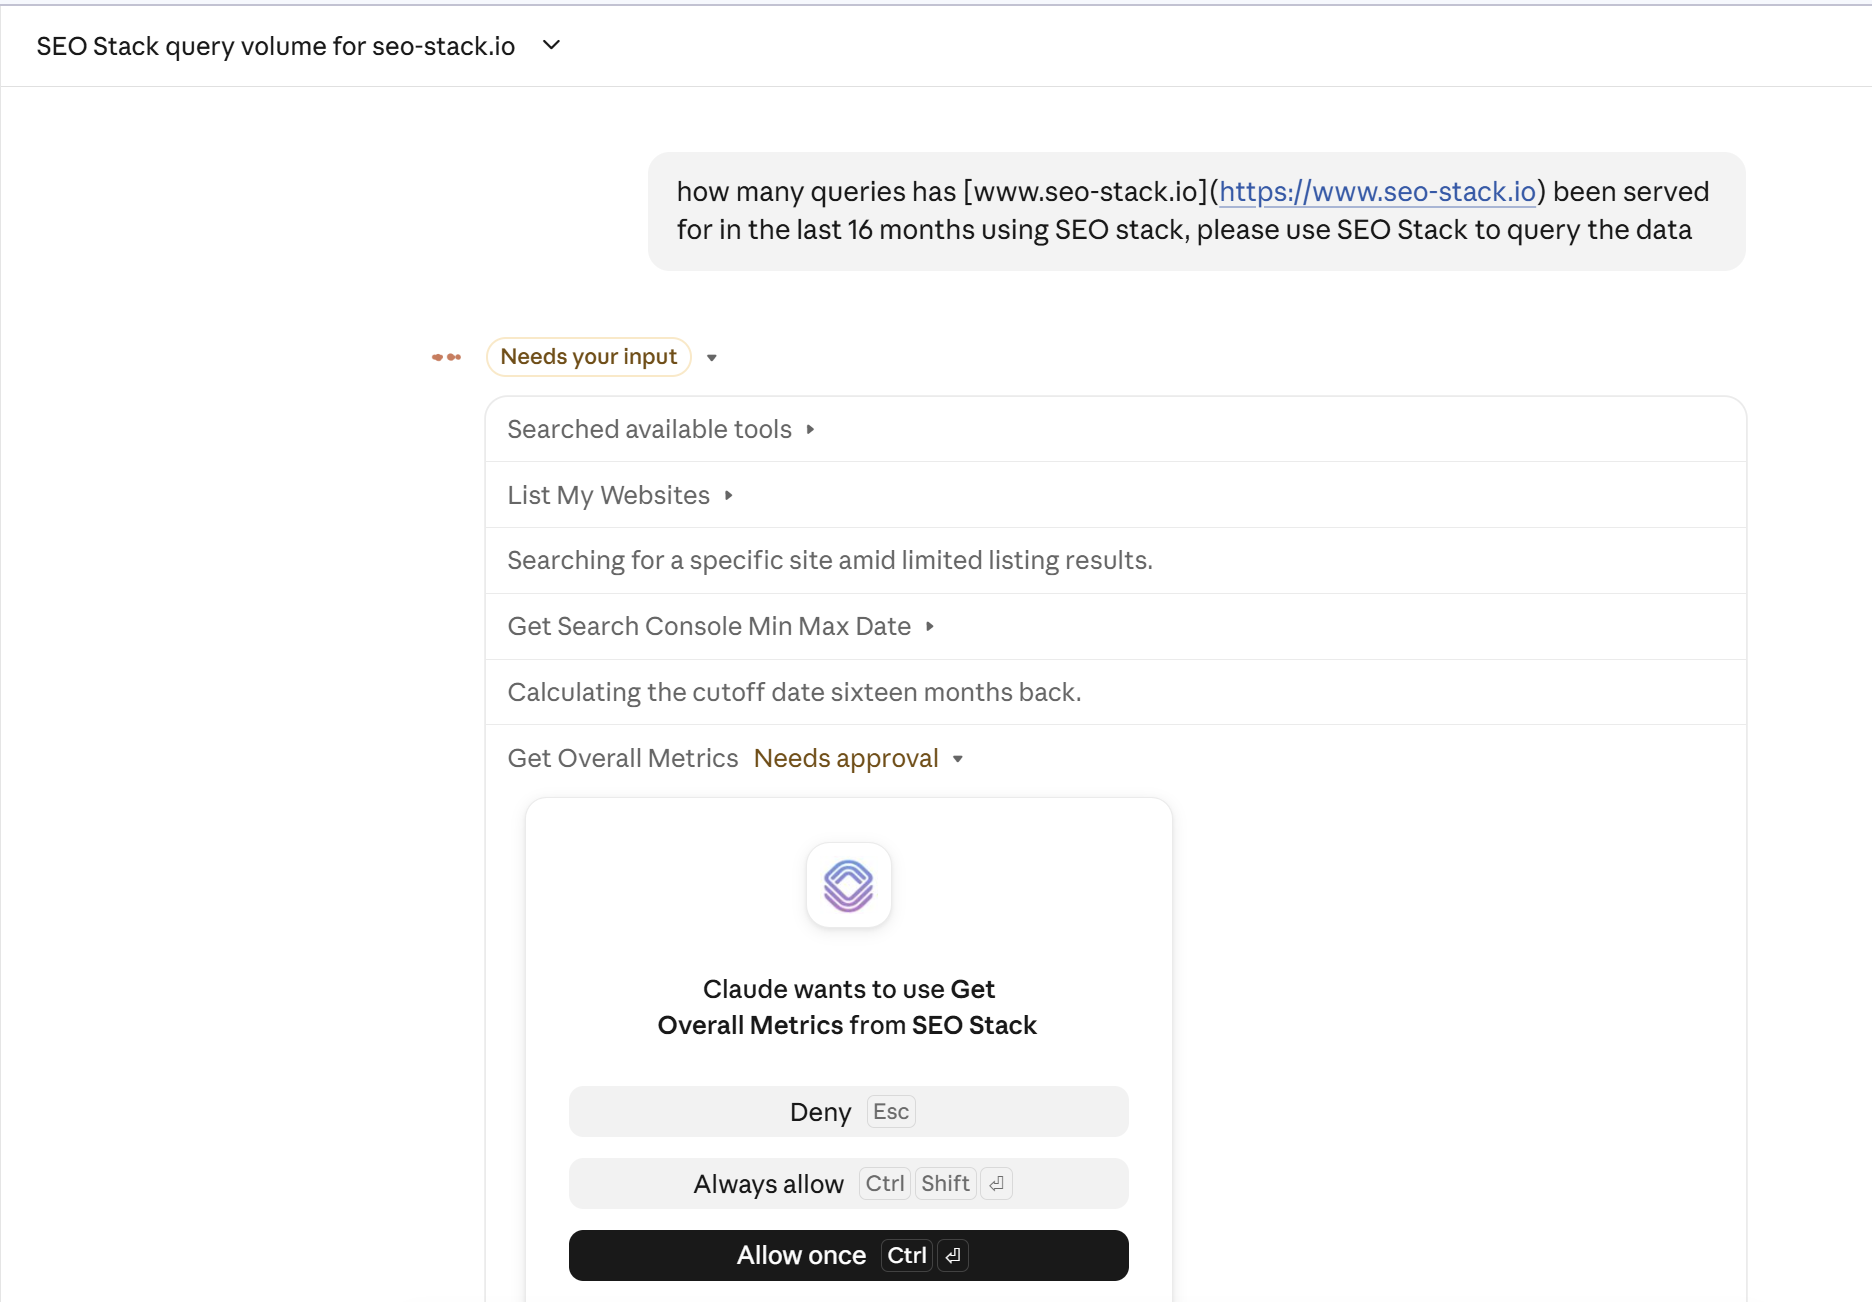
结果如下:
然后我查看 GSC >> API Integration,看到 >
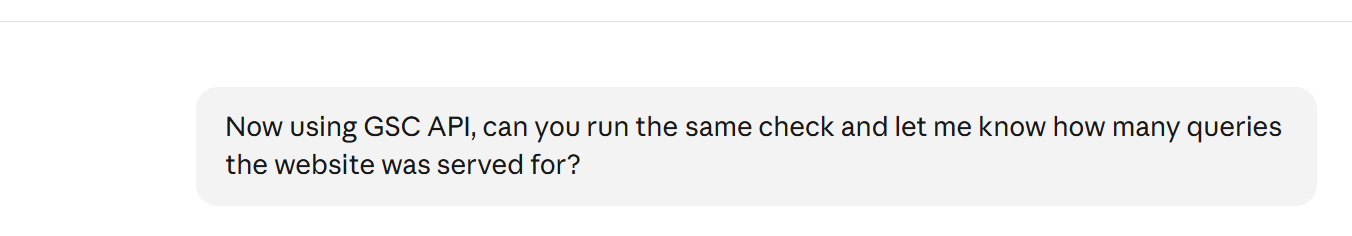
而返回的查询数量呢?

所以,是的,查询数量上立刻就出现了差异,其中一部分也可以归因于 SEO Stack 拥有更长周期的数据,因为它不受 16 个月的限制。
接着说,有三件事值得分别核查:
第一,你的连接器是否取回了该请求下所有可用的行?不管你用的是哪种连接器或方案,我都建议确认它确实拿到了全部数据,没有遗漏任何内容。
第二,数据源是否暴露了你的分析所需的全部细节?在请求量这件事上,完成分页并不等于解除了 Google 的内部数据限制。
第三,你要的信息是不是 Google 有意不披露的?匿名化的点击/查询数据就是典型例子,Google 为保护用户隐私,将其排除在详细查询报告之外。总计数据中可能包含这些活动,但具体的查询词是缺失的。
所以,上面这一点在一定程度上解释了:为什么把具名查询加总后得到的点击总数,会与对应匹配的整体报告不一致(因为数据有遗漏)。这并不自动意味着连接器出了问题,但可以推断并非所有数据都能通过这些请求获取或暴露出来,这在做分析或审计时会引发各种各样的问题!
我也会避免把所有缺失都笼统称作抽样,隐私过滤、响应行数限制、每日导出限制,以及连接器只返回了第一批数据,这些是不同的问题,含义也各不相同,如果我们要批评 AI 分析的质量,至少应该精确说明缺的究竟是什么。
不完整的数据抽取如何扭曲 SEO 建议
以下是一些示例性的问题/潜在风险,它们可能发生(而且确实在发生),并不是在断言每个 GSC 连接器或 Claude 给出的每个答案都会如此。一个扎实的集成方案会核查数据覆盖度、在模型之外完成计算,并明确说明不确定性。
正如我前面强调的,数据不完整意味着审计建议或 SEO 分析可能基于错误数据,给出错误建议和错误洞察,我测试过,这种情况经常发生,尤其是在伴随幻觉的时候。
所以,你可能会遇到以下这些问题:
长尾机会从评估中消失
设想一个商品目录庞大的电商网站,有数千个能带来展现但点击极少的查询。如果分析只拿到了排在前面的高点击行,它可能会聚焦在那些本就表现良好的商品上,却忽略了尚未成熟的品类或值得关注的、具有商业价值的搜索。一般来说,站点往往会有大量 ZSV(零搜索量)查询,其中很多会被请求漏掉。
输出或建议听起来可能完全合理,但它所依据的那份列表,对于「我们所有的机会在哪里?」这个问题来说仍然是个糟糕的答案,尤其当一大批查询缺失或被忽略的时候。
适合用来汇报你最大流量来源的那份数据选择,未必适合用来发现被忽视的需求,而正如我们从长尾数据中所知,更高意图的机会往往就潜藏在那里。
缺失的行看起来像是排名下滑
假设某个查询出现在某一时段的抽取结果中,却在下一时段缺席,一个不够谨慎的工作流(或缺乏人工监督的工作流)可能会把它判定为可见度流失,而实际上这一行可能只是落在了返回结果的选择范围之外——如果行请求超时或超出限制,就会有大量数据缺失,而如果 LLM 不理解这一点,它就可能把这当成损失来汇报。
所以,举例来说,在建议进行内容大改之前,我会想针对该查询做一次定向核查,使用一致的过滤条件,并清楚了解数据抽取方式。「不在这次响应里」和「Google 不再展示这个网站」是完全不同的两种观察结论。
像 Claude 或 ChatGPT 这样的 LLM 可能给出糟糕的建议,或者推断你应该创建你其实已经有的内容,因为它们无法访问站点的全部数据,也看不到更远的范围(除非它们拥有你网站索引的明确清单)。
关键词自噬评估会遗漏相互竞争的 URL
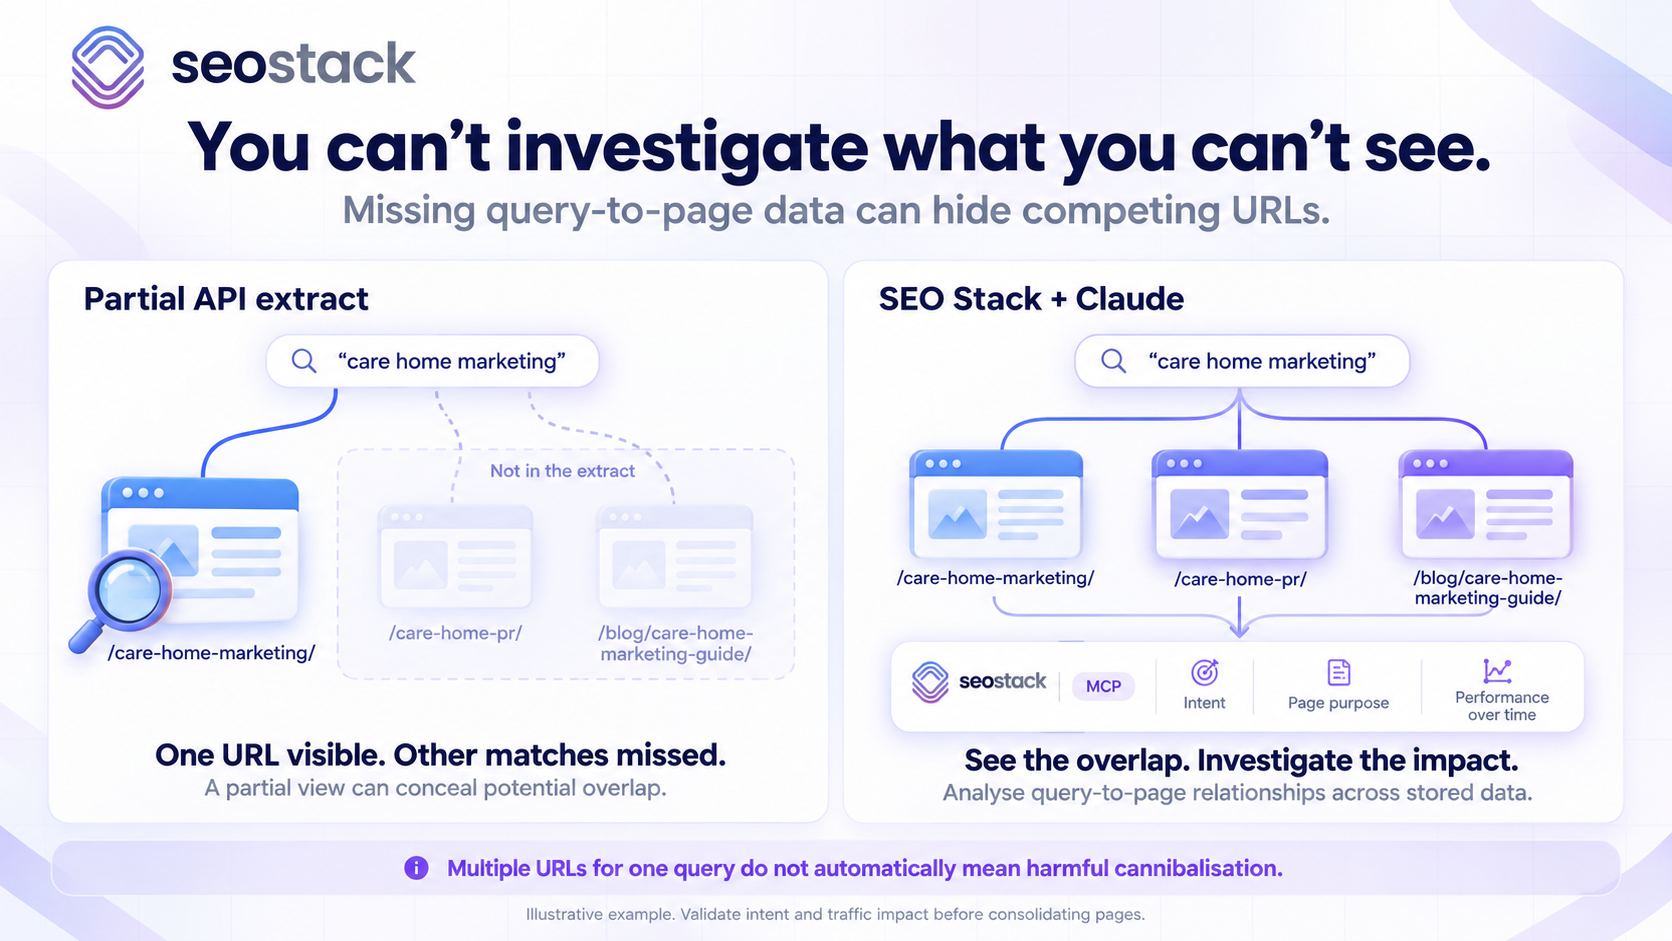
如果你的分析只拿到了某个查询所对应的其中一个 URL,就无法真正查清是否存在另一个页面在与它竞争。即便两个 URL 都出现了,它们同时存在也只是值得调查的理由,并不能自动认定为自噬。
做自噬分析时,你的 LLM 需要访问全部数据(全部),否则一旦有部分数据缺失,相互自噬的 URL/查询可能根本不会出现——这种情况确实会发生。
除此之外,你仍然需要考察意图、页面目的、随时间的变化,以及所谓的竞争是否真的在影响或减少有价值的流量。
品牌词分类会产生误导
假设有一个站点,在匹配的整体报告中有 10,000 次点击,而检索到的具名查询占了 7,000 次,其中 2,000 次被归类为品牌词。
品牌词占检索到的查询点击的 28.6%,因此把这个比例当作全部 10,000 次点击中的品牌占比就会产生误导,因为剩下的 3,000 次并未被分类。你可以说有 2,000 次可识别的品牌点击,占总量的 20%,但这依然无法确定真实的品牌总占比。
历史数据和你的行数一样重要
Search Console 提供大约 16 个月的滚动效果历史数据,Google 推出这一延长窗口是为了支持更长周期和同比对比,但它仍然是一个有限的报告期。
而 SEO Stack 给你的是 10 年,不是 16 个月,是 10 年!
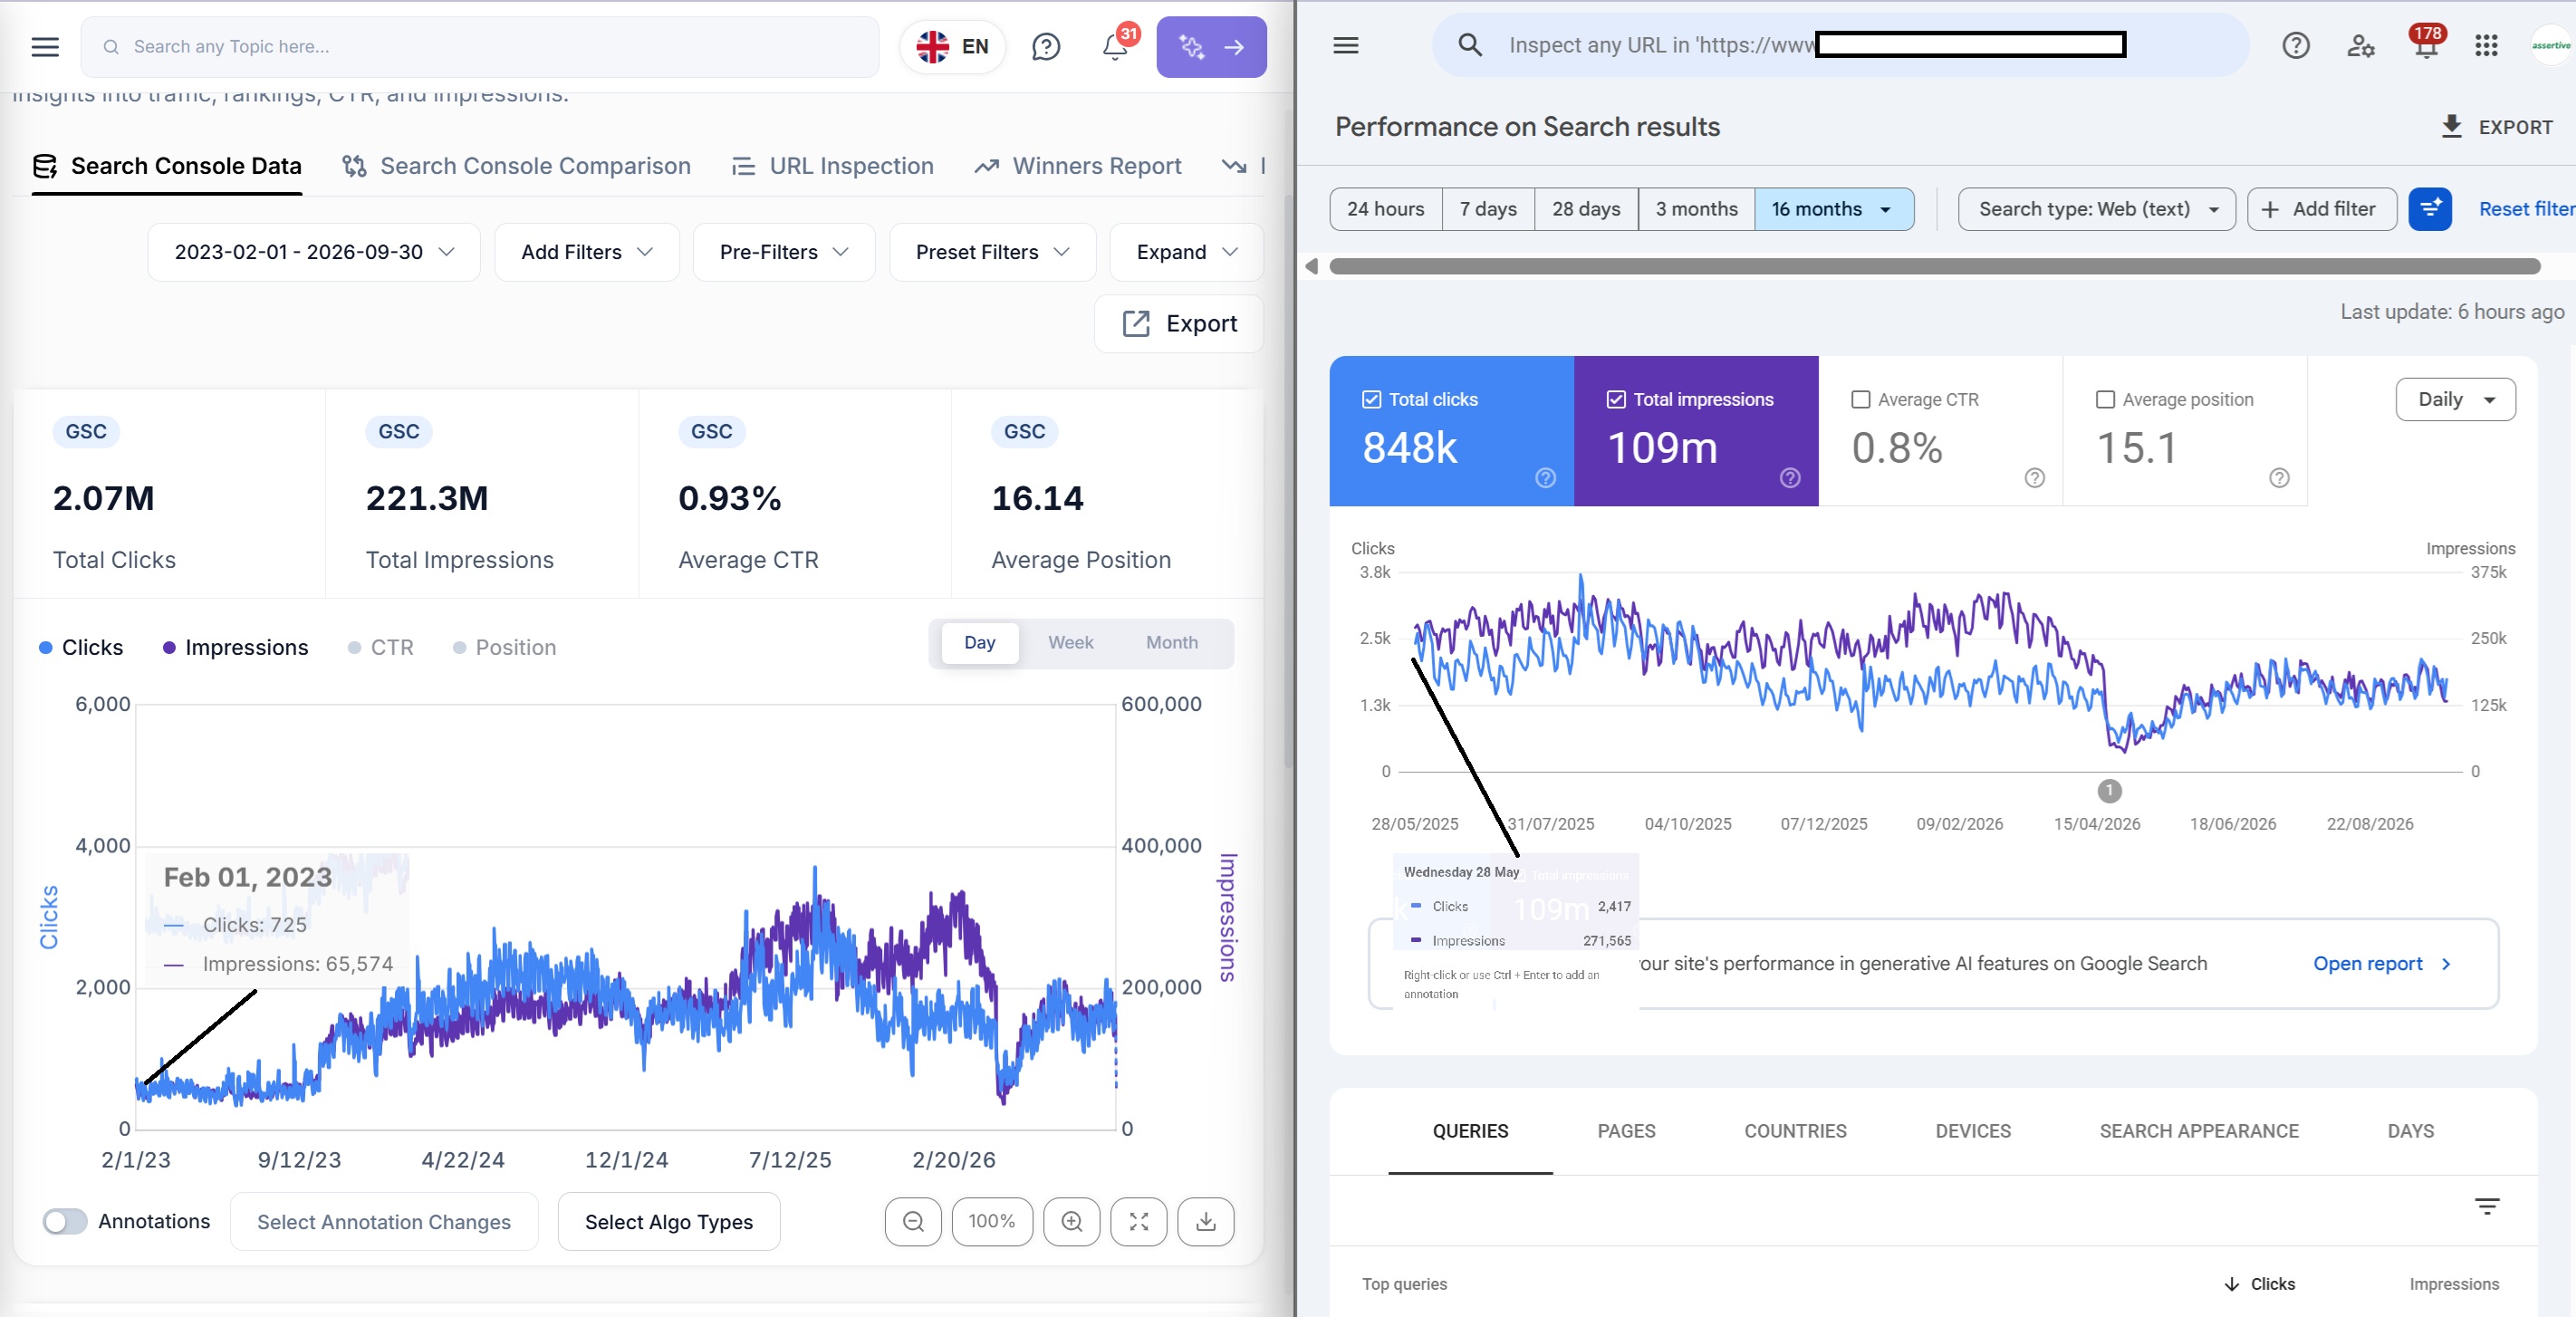
这或许足够把上个月和去年同月做对比,或者做近 3 个月的同比,但它不足以恰当地评估 5 年的季节性表现、回顾一次更早的迁移,或者查清某次下滑是否早在最近一次 Google 更新之前就已经开始。
你没法让 Claude 分析根本不存在的 GSC 数据,超过 16 个月就什么都没有了——除非你使用 Google BigQuery。有些 SEO 确实在用,但很多人没有,因为它虽然很适合存储来自 GSC 的数据,却没有传统的用户界面,也不允许用户以 GSC 式的界面与历史 GSC 数据交互,使用者通常需要懂 SQL、Python,或者把它与 Google Data Studio 集成。
所以我的建议很直接:趁还能访问的时候把数据留存下来。你的 GSC 存档会随着时间推移越来越有价值,想想那些长尾和关键词数据?想想能做 12 个月的同比对比。
BigQuery 解决了其中很重要的一部分
Google 原生的 Search Console 批量导出会把每日效果数据发送到 BigQuery,不受 API 的每日行数限制。这让它成为大型网站的一个认真可考虑的选项,而不只是换一种方式下载同样受限的 API 提取结果。
这里有个细节值得注意:Google 的概览文档把匿名查询描述为被排除,而其表结构参考文档中则记录了保留匿名记录但隐去查询文本。有用的区分是:匿名化的指标是可以呈现的,但被隐藏的搜索词不会显示出来——这会让分析时的数字出现偏差。
因此,BigQuery 能够应对一个重要的提取损失来源,并保留历史数据。只要有人去搭建和维护,它也能支撑一套成熟的报告系统和 AI 工作流——但很多 SEO 没接触过 BigQuery,或者只是没时间去配置。
我不会否定这一点:对于已有数据团队、已有 Google Cloud 基础设施和特定分析需求的企业来说,它可能正是正确的选择——虽然我们提倡 SEO 从业者和企业使用 SEO Stack 来做数据仓储,但我们也清楚有些企业想要自己的内部方案(AI 出现之后更是如此)。
而对于只想要可用的历史报告、不想再开一个技术项目的 SEO 来说,实际操作起来就没那么有吸引力了。
麻烦都在数据仓库之外
Google 的配置流程需要一个已开通结算的 Cloud 项目、启用 BigQuery 服务、为导出服务账号设置权限,并在 Search Console 中配置导出目标。有免费使用额度,超出相应额度后存储和查询都要收费。原生导出从开启之后才开始收集数据,不会自动回填此前的 16 个月。
然后你还得把存储下来的表变成团队真正能用的东西。
BigQuery 有自己的界面,你也可以用 Looker Studio、其他 BI 产品或自定义应用做出体验完全一致的报告。但仅仅开启导出,你不会得到一个现成的 SEO 应用,带着你熟悉的筛选、对比和调查工作流,贯通近期与历史数据。
总得有人去决定这些报告怎么运作、维护各项定义,并在数字对不上时处理问题。
Google 的查询指南还说明,导出的行不一定是已合并的,因此指标需要做适当的聚合。它提供了 CTR 和排名的计算方式,包括导出表结构所需的排名调整。
当然,Claude 可以帮你写 SQL,但查询仍然需要核对。一条针对完整数据仓库成功执行的错误计算,依然是错误的计算。
SEO Stack 与 Claude 在哪里结合得更强
SEO Stack 把托管式数据仓储、SEO 界面以及连接该存储数据的 MCP 结合在一起。其公布的产品内容包括 GSC、GA4 和 AI visibility 的历史数据,可通过应用或以编程方式访问,保留期限取决于套餐以及实际累积的历史数据。
对用户来说,这就把近期和更早的报告放进了同一个工作环境。你可以先向 Claude 提问,再到应用里去查看相关细分,而不是完全依赖它写出来的叙述。
这是个相当实在的优势。如果我要给出一项商业建议,我希望能够查看数字、更改时间段并质疑其解读,而不必在别处重新搭一遍报告。
这款产品还做了一个对 AI 工作流很重要的区分:它在数据仓库之上提供了预置的分析功能。已公布的 MCP 工具包括时间段对比、查询与页面分组,以及 URL 分段分析,计算在服务端完成。
与其让模型从大量原始数据批次中拼出一份目录对比,不如由服务执行受支持的对比并返回结果,交给 Claude 去解释。
这样代理需要协调的提取工作更少,某个不完整的数据批次悄悄变成最终答案基础的机会也更少。
一次请求拿到仓储数据究竟意味着什么
SEO Stack 宣传在一次 MCP 请求中即可访问当前和已仓储的 GSC 数据,支持大结果集获取和服务端聚合。对于受支持的仓库查询,这可以避免代理自己去对 Google 的实时 API 做分页。
最有用的理解是:一次分析请求可以在相关的留存数据集上运行,而不需要 LLM 逐条读取每一行底层记录。
举例来说,一次目录对比可以在海量存储行上计算变化,并返回一张包含目录、点击和差值的紧凑表格。Claude 可以基于这个结果开展工作,同时详细记录仍然可供深入调查。
这比把一千万行塞进对话里、指望模型准确处理完要合理得多。Anthropic 自己的工程指南也讨论过在模型上下文之外处理和过滤 MCP 结果,以减少它需要消耗的数据量。
一次分析请求也不意味着每次调查都能在一次工具调用里结束。识别网站、检查可用日期、获取对比结果、查看某个可疑 URL,合理地可能涉及多次调用。收益在于避免不必要的提取和准备工作,而不是阻止有价值的追问。
无论你选择哪款产品,有两点限定条件我都会坚持强调。读取数据仓库并不会消除最初采集时就存在的限制,任何供应商也无法还原 Google 从未披露的查询词。数据留存必须先行发生,你才能分析更早的历史,购买十年的留存额度并不会凭空变出十年的历史表现数据。
三种方案对比
需求 | Claude 搭配实时 GSC API 连接器 | 原生 BigQuery 导出搭配 AI 工作流 | SEO Stack 搭配 Claude |
聚焦的表现类问题 | 在请求范围设定正确时可用 | 可通过数据仓库查询实现 | 由预置工具支持 |
采集限制 | 受 API 限额与连接器行为约束 | 原生批量导出可规避 API 的每日行数限制 | 取决于向数据仓库输送数据的采集方式 |
更长时间跨度的历史分析 | 需要超出实时 GSC 历史范围的归档 | 按你的设置保留已采集的导出数据 | 按相应套餐保留历史数据 |
可复用的分析计算 | 取决于连接器的实现方式 | 需自建或采用 SQL 与报表逻辑 | 预置的对比与分组工具 |
一致的 SEO 界面 | 取决于连接器 | 需自建或配置报表层 | 随 MCP 一并提供的应用 |
一次请求覆盖已存储的全部历史 | 需要单独的归档服务 | 配合合适的查询工具可实现 | 在支持的 MCP 查询中已明确提供 |
被隐藏的查询词 | 无法恢复 | 导出数据中并未披露 | 无法从未披露的源数据中恢复 |
这是对纯实时 API 集成、Google 原生导出以及 SEO Stack 已公布能力的对比。一个成熟的自定义连接器同样可以包含缓存、数据仓库和服务端分析,但到那一步,你比较的就是两套完整系统,而不是直连 API 与托管平台之间的差别。
在相信答案之前我会问的问题
无论你用的是 SEO Stack、自定义 MCP 还是 BigQuery 工作流,我都希望分析在给出建议之前先明确几件事:
它使用了哪个资源、哪种搜索类型、哪些日期和哪些筛选条件?
它分析的是该范围内完整的留存数据集,还是一份有限的提取数据?
最新可用日期是哪一天,已存储的历史中是否存在缺口?
某个查询词缺失,意味着经过验证确实不存在,还是仅仅在这份提取数据中不存在?
总量是否在相同的聚合层级上进行比较,未知查询词产生的活动是否被单独区分?
有哪些证据支持这条建议,还有哪些进一步的核查会改变结论?
这些并非纸上谈兵的细节。它们决定了一条建议是否值得落地执行,尤其是当它涉及删除页面、重构网站或投入数月的内容预算时。
我宁可得到一个承认数据存在缺口的答案,也不要一份文笔优美、却悄悄假装缺口不存在的解释。
这类工作流我为什么会选 SEO Stack
对于快速、定义明确的问题,基础的 GSC 集成是个不错的起点。如果你具备围绕 BigQuery 搭建数据仓库和报表系统的技能与资源,那也是一条很好的路径。
对于那些想要留存搜索历史、想要一个真正能用的界面、并希望 Claude 连接到预置分析工具的团队,SEO Stack 把这些需求整合到了一起。你不会只拿到一条能用的 AI 连接,然后还要面对一长串待办事项,数据才能真正派上用场。
吸引我的地方在于,可以针对已存储的历史提出问题,拿回受支持的计算结果,然后在应用中进一步查看。相比在不知道模型被允许看到什么的情况下接受一份自信满满的判断,这是做 SEO 决策更扎实的基础。
通过 SEO Stack 的 MCP 连接 Claude,使用背后的数据仓库和分析功能,同时保留自行追问和核查答案的能力。连接本身是有用的,但真正让它值得拥有的,是数据以及你使用数据的方式。
资料来源
资料核查于 2026 年 10 月 23 日。Google 与 Anthropic 的资料记录的是平台行为。SEO Stack 的资料描述的是该产品已公布的能力,而非经独立基准测试的集成测试结果。
2. Google Search Console API 使用限额
3. Google Search Analytics 查询参考文档
6. Google 发布全新 Search Console 及 16 个月表现数据
8. Google 批量导出概述 与 导出表参考文档
11. SEO Stack 数据仓库以及与 BigQuery 的对比

SEO Stack 创始人
Daniel 是 SEO Stack 的创始人。他在技术 SEO 和搜索数据领域深耕二十余年,在客户项目中一次又一次撞上 Search Console 的同样限制后,他着手打造了 SEO Stack。
Daniel 拥有丰富的 SEO 经验,创办过 SEO 代理机构、审计业务以及一家发展良好的咨询公司。业余时间里,Daniel 喜欢做 SEO 实验并分享实验结果。
发布于 2026年10月24日


