增加一个完整的 SEO 服务中心页
高ChatGPT · 2026 年 8 月 5 日
做一个结构清晰的“SEO 服务”落地页,清楚列出并说明 AI 回答中提到的每项服务(关键词研究、页面优化、技术优化、内容、外链建设、本地 SEO、数据分析)。使用经过关键词优化的标题、描述性的 meta 标签,以及指向各服务子页面的内链。
AI 与 LLM 可见度
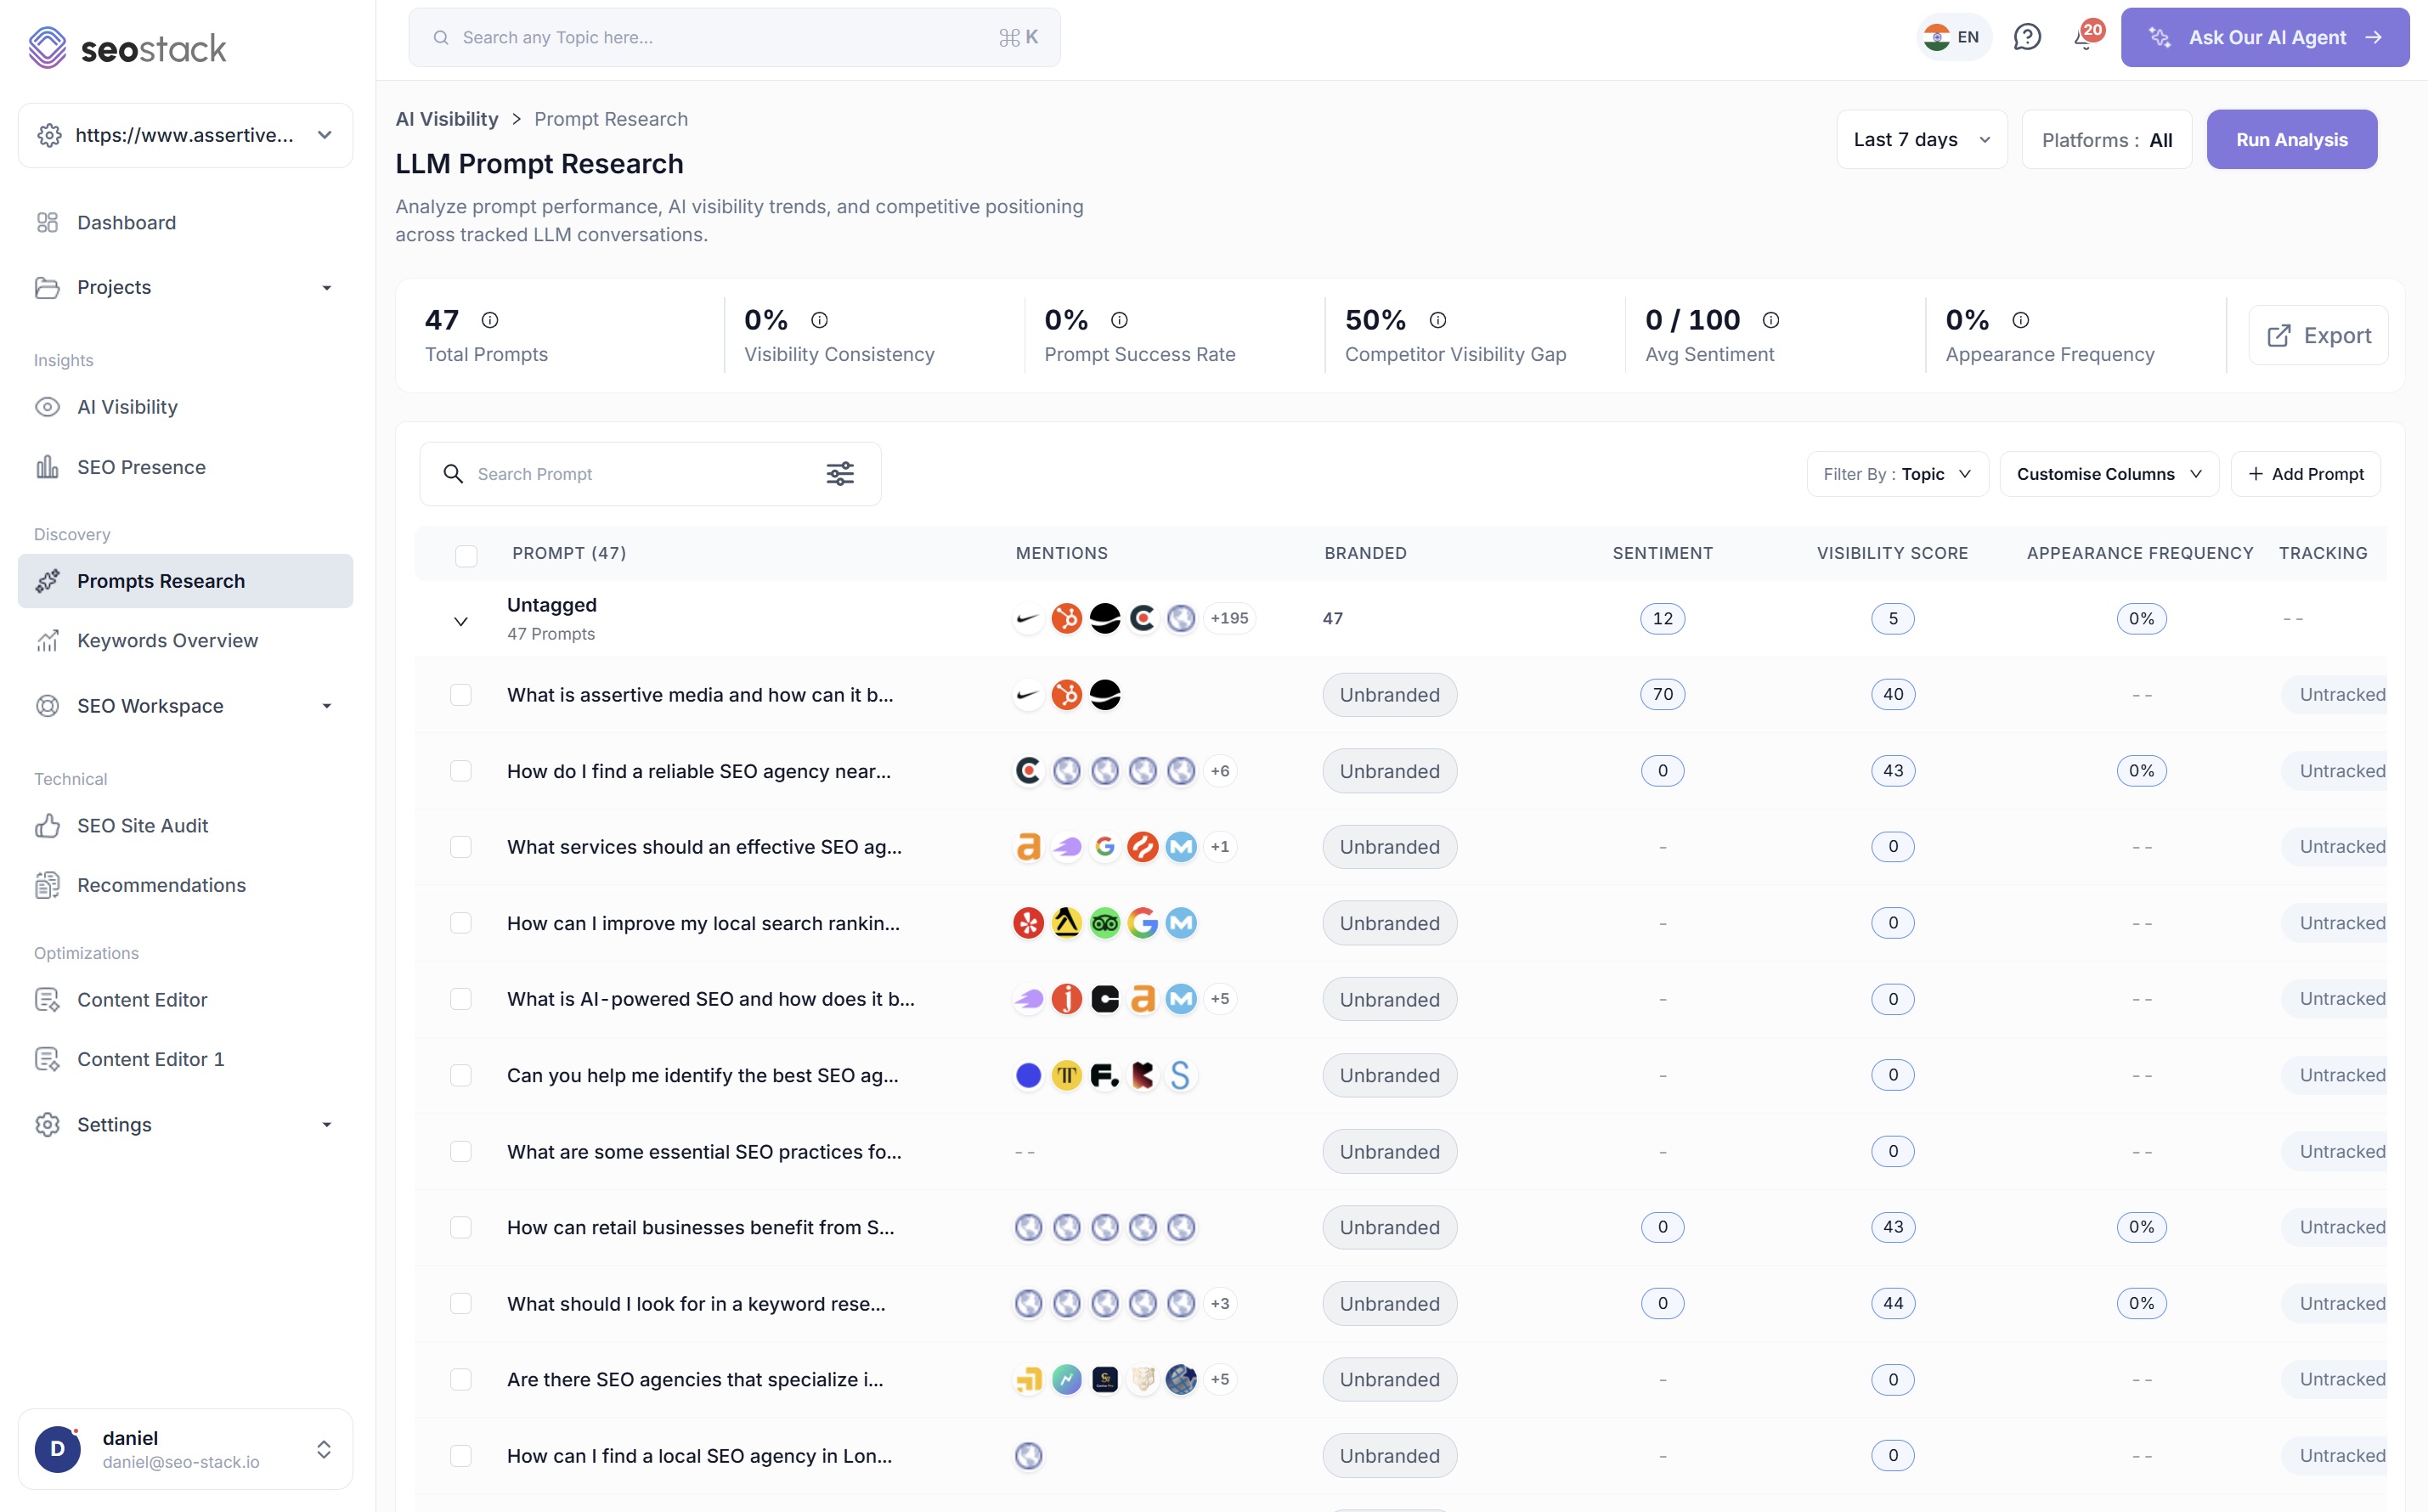
V3 新增批量研究、添加并追踪提示词,然后在提示词层级分析表现:成功率、与竞争对手的可见度差距、情感倾向和出现频率。
获领先企业信赖
问题所在
如果你追踪的是没人会问的提示词,那追踪 AI visibility 就毫无意义。大多数品牌一开始会猜几个听起来靠谱的问题,拿到一个还不错的分数,却始终没发现:在他们这个品类里真正带来购买的那些问题,答案完全被别人占着。
什么是提示词研究
提示词就是有人真正输入到 ChatGPT、Gemini 或 AI Mode 里的问题。提示词研究就是找出你的买家会问的那些问题,跟踪答案里点名了谁,并在被点名的是别人时补上这个差距。
| 考量项 | 关键词 | 提示词 |
|---|---|---|
| 基本单位 | 输入到搜索框里的一个短字符串。“seo agency” | 一个完整的问题,通常带有背景和限制条件。“一家有效的 SEO 代理商应该提供哪些服务?” |
| 结果 | 十条蓝色链接。你要么有排名,要么没有。 | 一段综合生成的答案,里面点名几个品牌。你要么在其中,要么完全不被提及。 |
| 一致性 | 大体稳定。同一个查询返回的结果大致相同。 | 同一个提示词每次运行的答案都不一样,所以单次结果说明不了任何问题,出现频率才是真正的信号。 |
| 搜索量数据 | 有公开的搜索量,可以据此做规划。 | 没有任何搜索量数据。判断一个提示词值不值得跟踪,靠的是相关性和竞争对手是否出现。 |
| 还有谁在里面 | 竞争对手占据你下方各自独立的结果位。 | 竞争对手和你被写进同一段答案里,顺序由模型决定。 |
为什么重要
跟踪没人问的提示词,你会得到一个好看但毫无意义的数字。跟踪你所在品类中购买前会问的问题,同样的数字就变成了预测。
竞争对手可见度差距告诉你,在你跟踪的提示词中,有多大比例是对手出现而你没有出现。这不是虚荣指标,而是一份你缺席的具体答案清单。
传统搜索把你放在竞争对手的上面或下面。AI 答案把你和他们并排放在一起,顺序由模型决定,于是这个先后顺序本身就成了需要去做的工作。
同一个提示词跑两次,可能得到两个不同的答案。只有跨时间、跨平台的跟踪,才能把真正的下滑和普通波动区分开。
工具内部
三个层级,依次回答下一个问题:哪些提示词重要,我在这个提示词上表现如何,以及具体该改什么。
提及列是页面上最快能看明白的一栏
提示词旁边一排竞争对手的网站图标,不用点开任何东西,就立刻告诉你这个答案是不是属于别人。
它会告诉你什么时候不该相信它
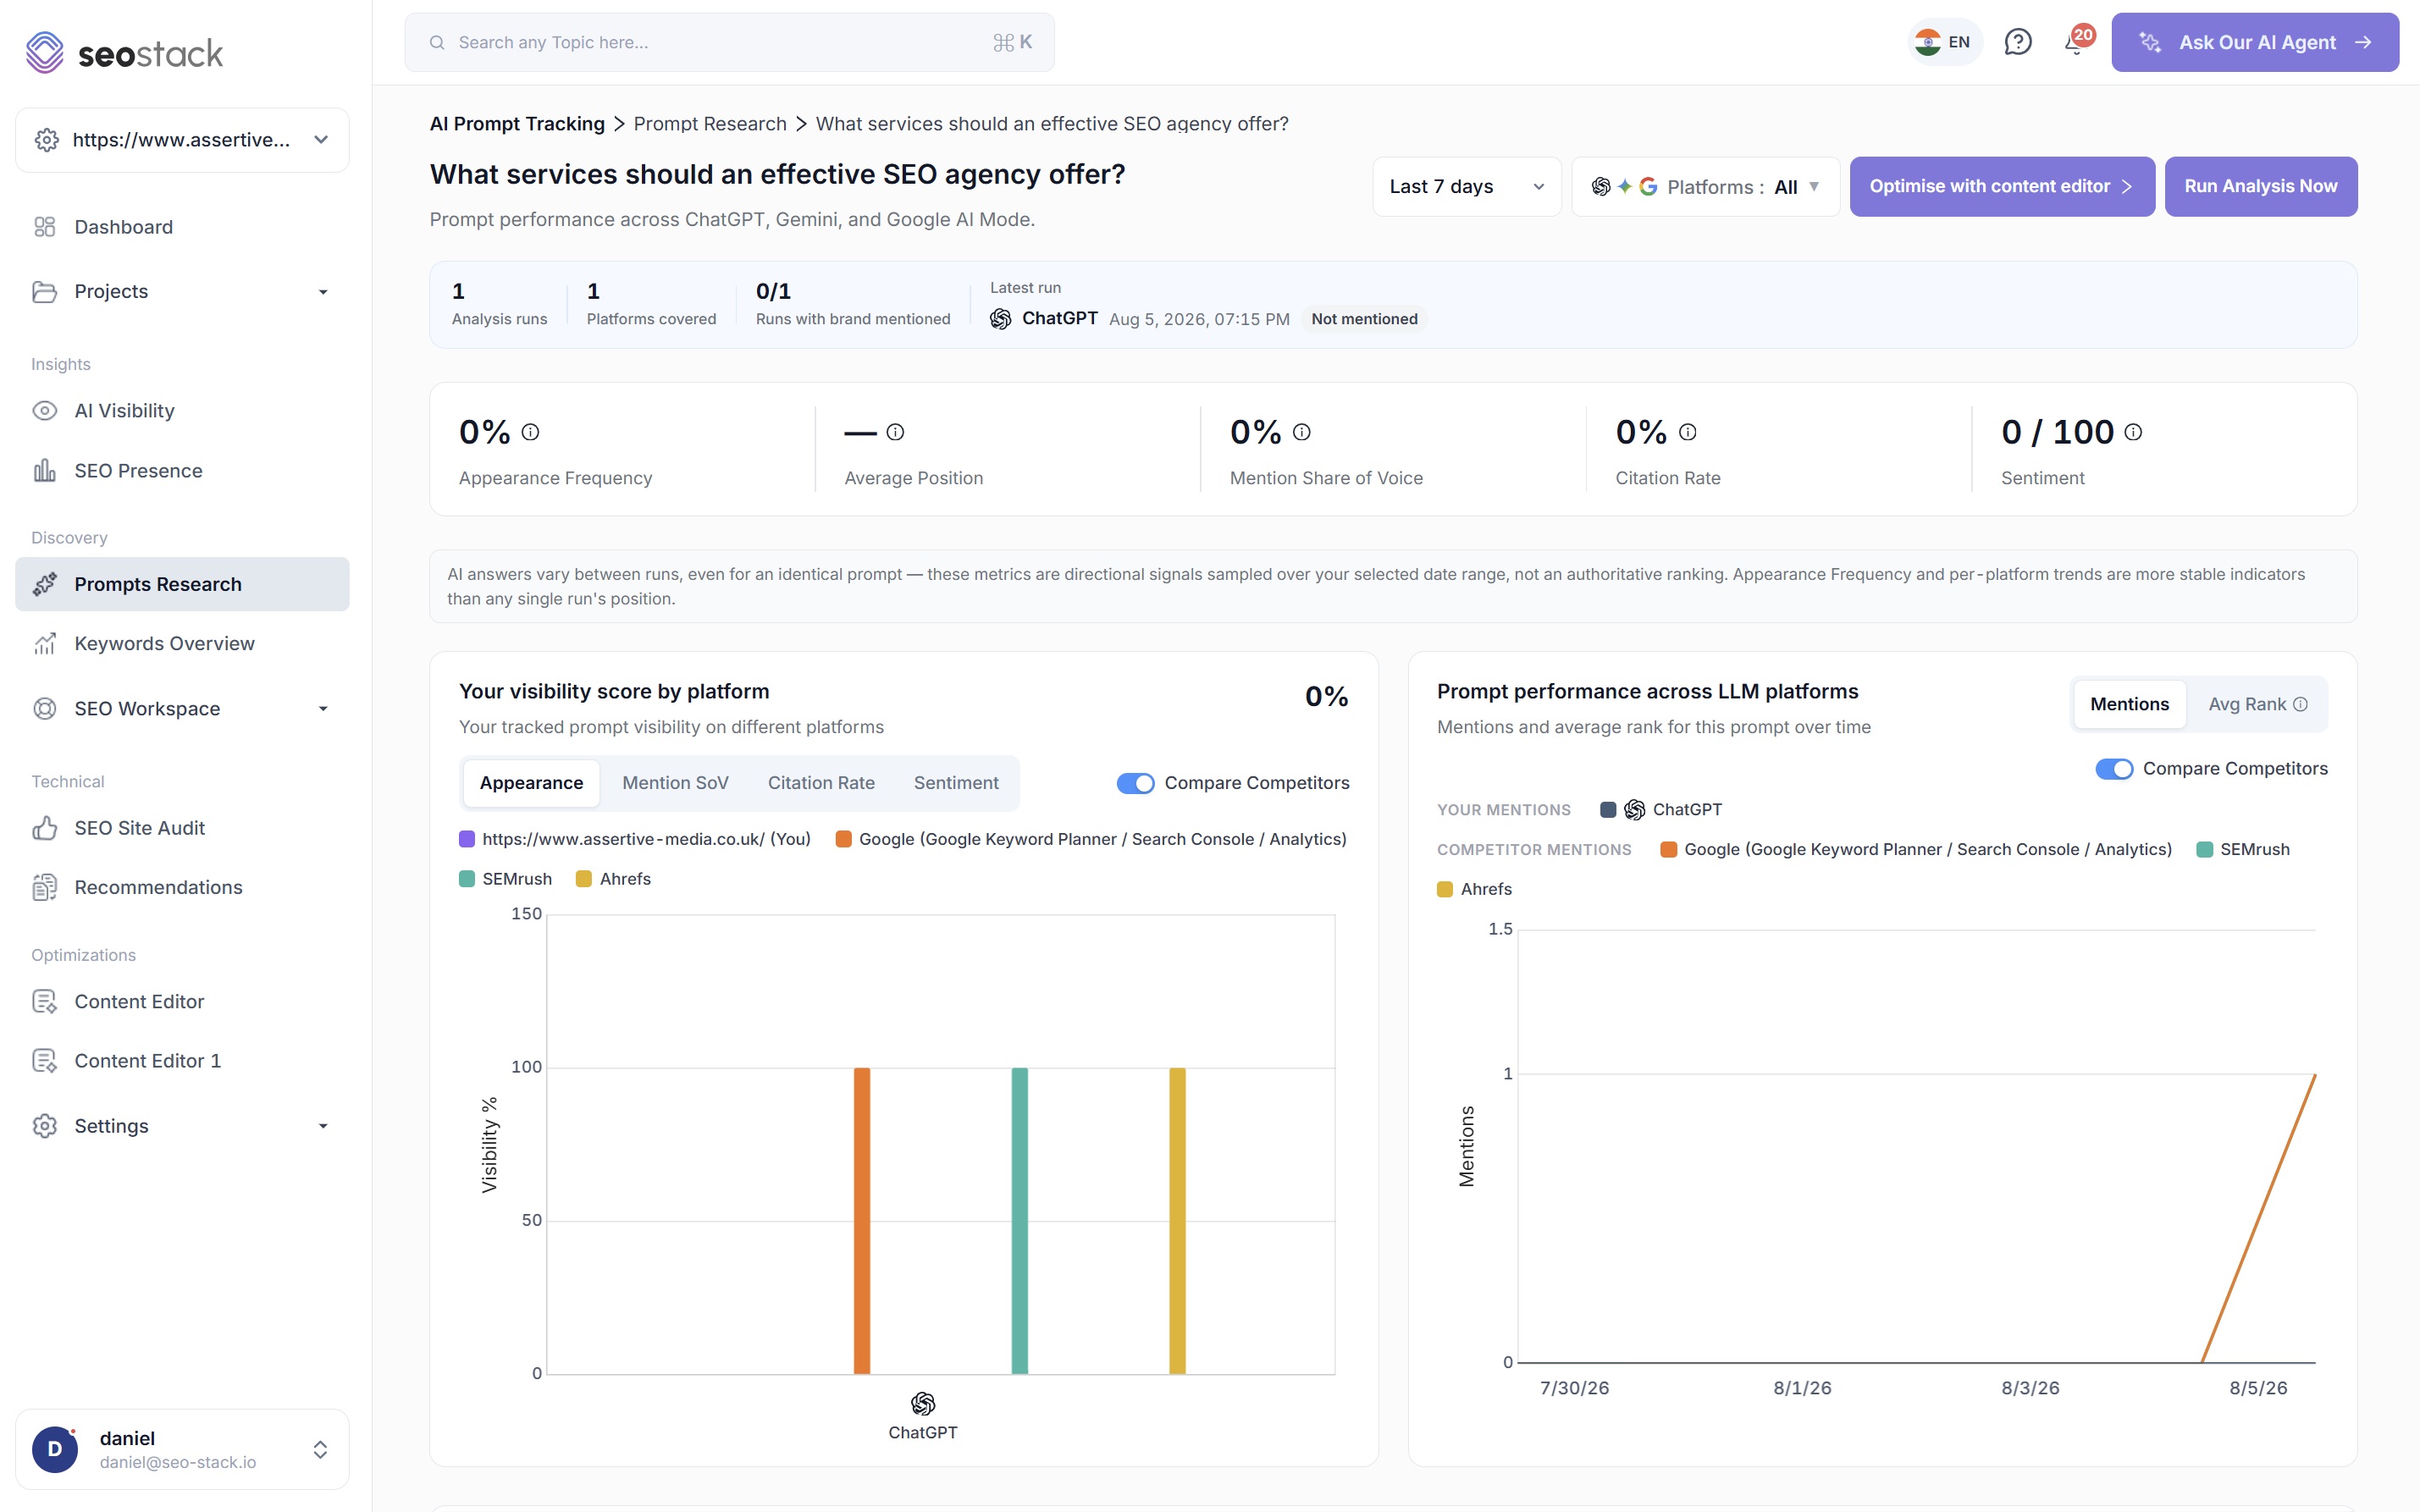
界面会直接说明:AI 答案每次运行都会变化,这些是方向性信号,而不是权威排名。出现频率和各平台趋势被标注为稳定的指标。
来源与引用分类
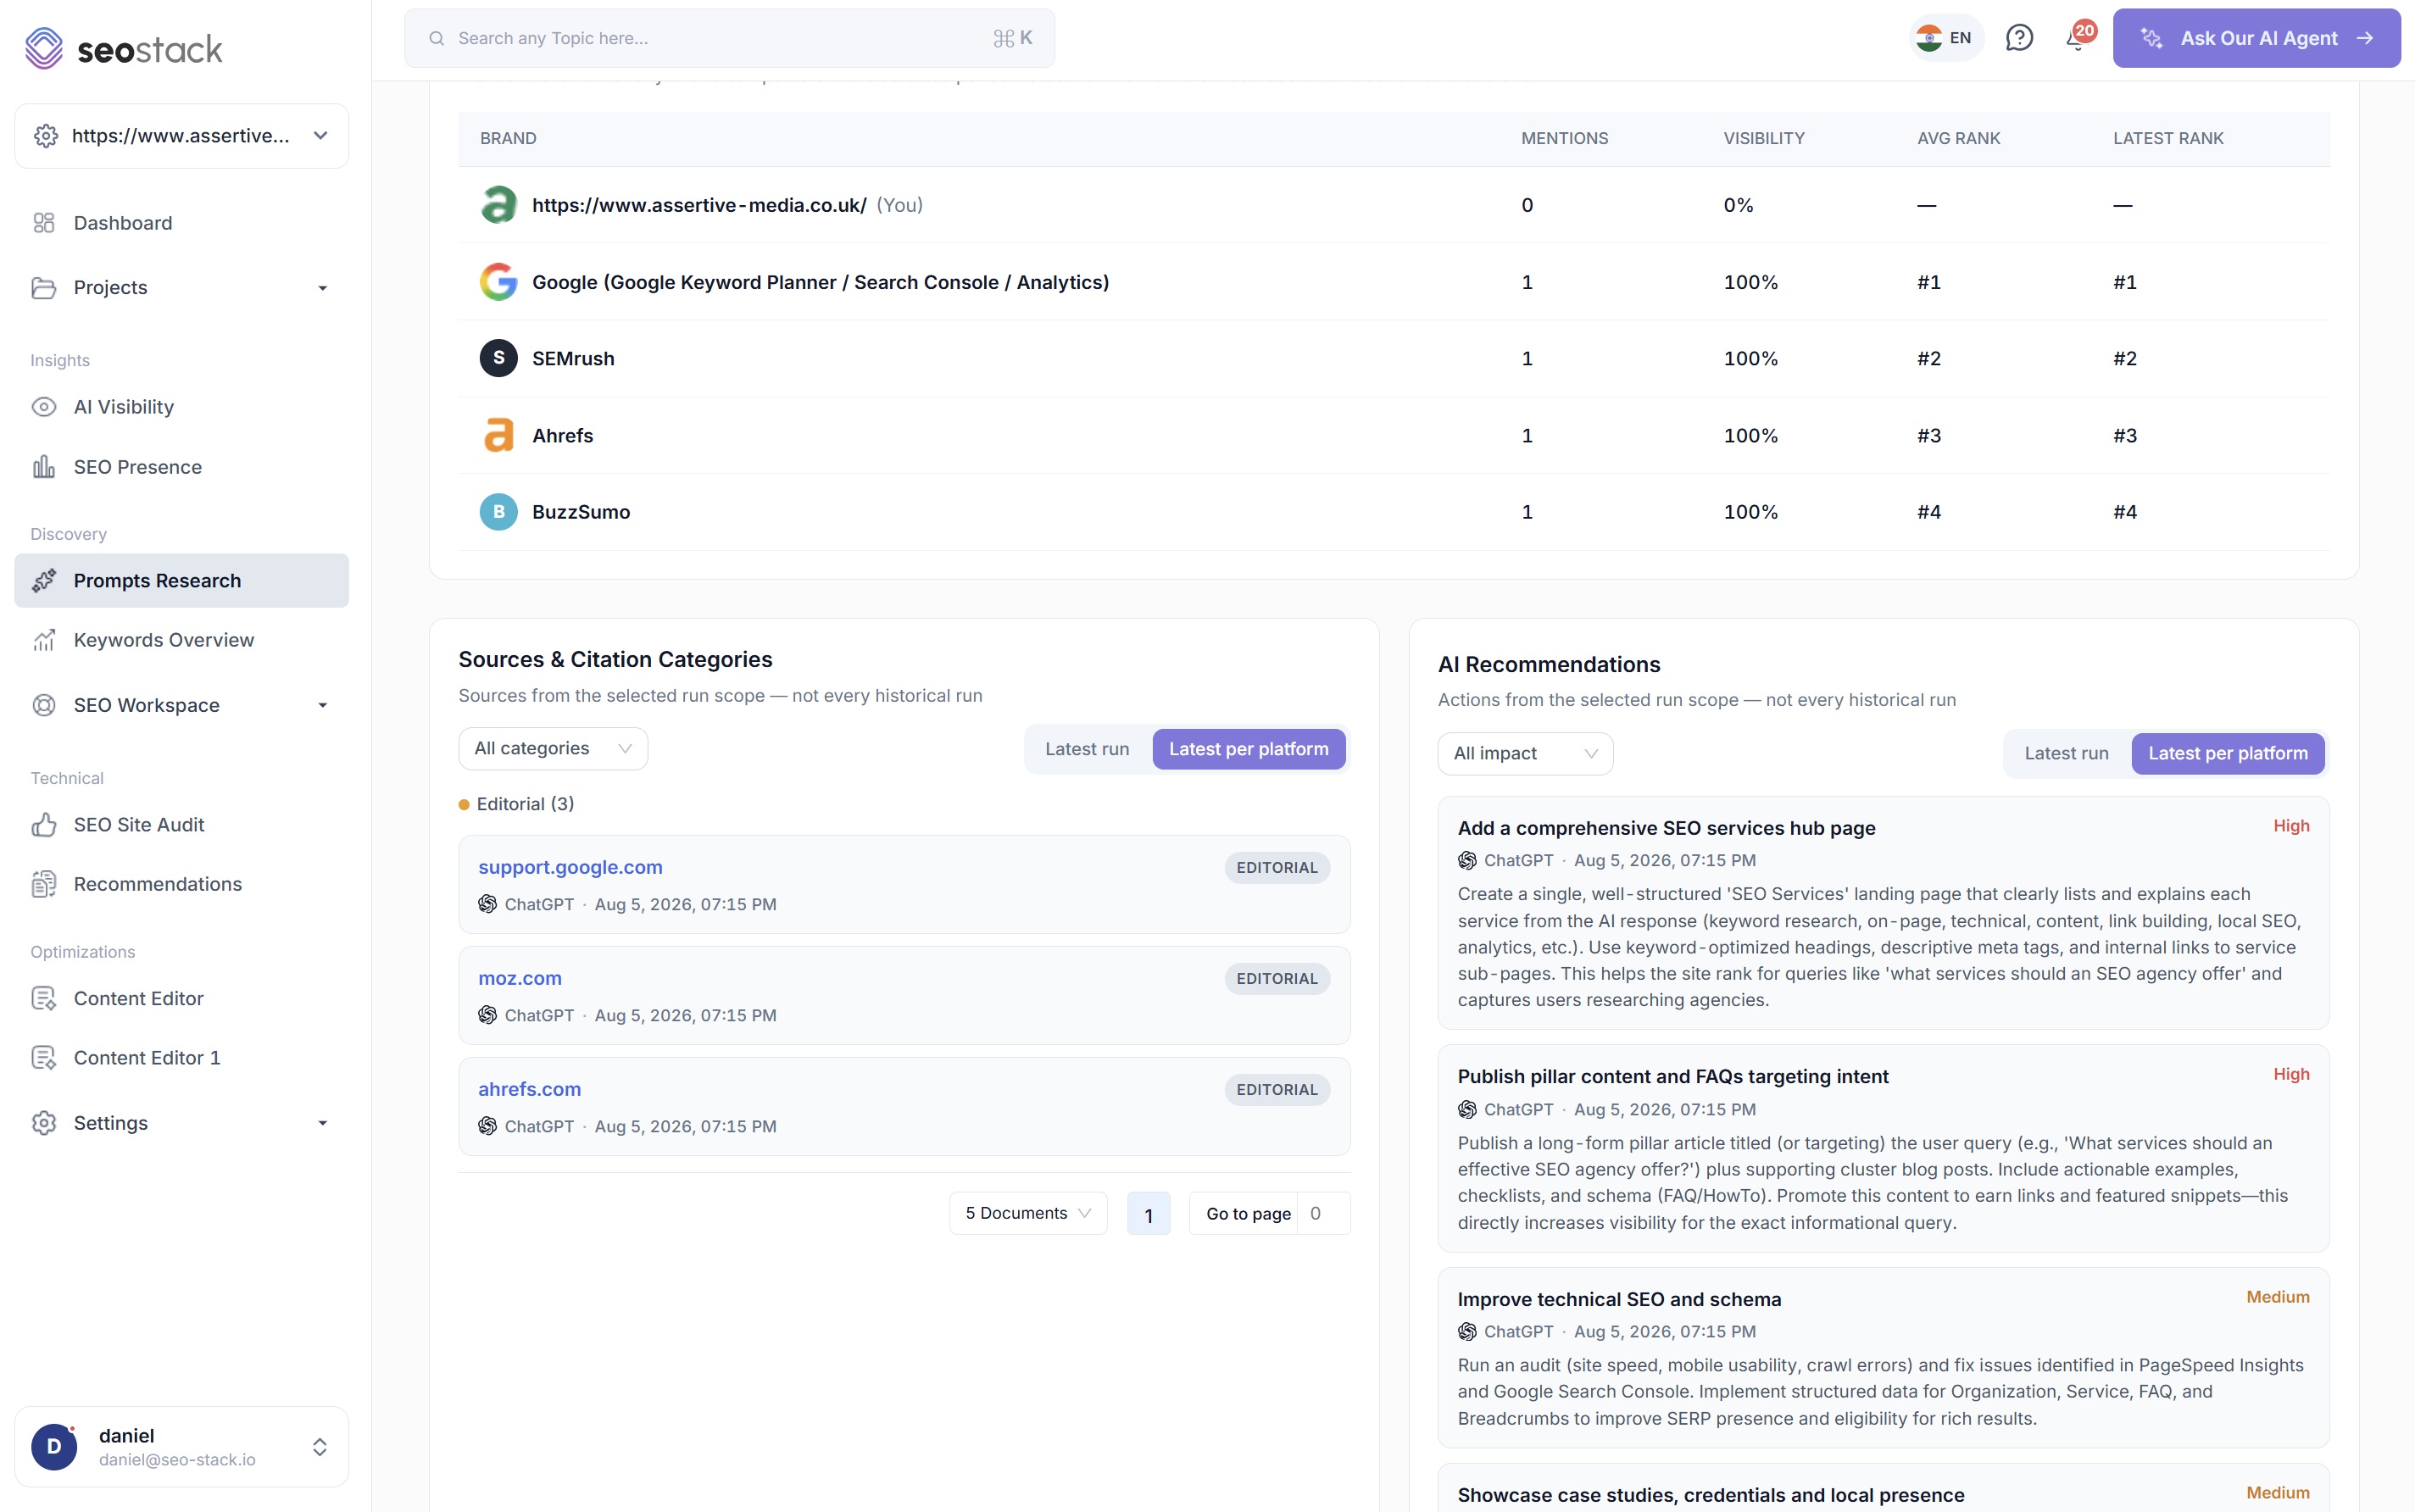
每次运行都会记录模型引用的域名并归入分类。这决定了你是只知道自己被漏掉了,还是知道谁被选中了。
可见度分数告诉你结果,来源列表告诉你原因。如果模型在回答“SEO 代理商应该提供哪些服务”时用了三个编辑类来源,你就知道拿下这条提示词是内容覆盖的问题,而不是落地页的问题。
而当你自己的域名确实出现时,你可以看到是哪个页面拿到的、在哪个平台、什么时间,这样你就能把那个页面做对的地方继续放大。
出版物、博客和行业媒体。通常是占比最大的一类,靠报道和数字公关来影响,而不是靠你自己的网站。
官方文档和支持内容。在操作类和定义类提示词上被高度信任,所以一个好的文档站点会悄悄赢得引用。
厂商页和产品页,包括竞争对手的。如果某个提示词引用了他们的页面而没有引用你的,那是一个你可以修复的页面问题。
百科类和聚合类来源。模型在提到任何品牌之前,往往先用这类来源来支撑定义。
类别反映的是每次运行实际引用了什么,所以不同提示词的构成也不一样。定义类问题更依赖参考资料和文档,“最佳供应商”这类问题则更依赖编辑类内容。
AI 建议
不是一句「优化你的内容」。而是针对这一个具体问题的书面简报,按影响力排序,依据模型实际给出的答案和实际使用的来源生成。
每条行动都带有「高」或「中」的评级,所以即使一个提示词有八条建议,也能一眼看出从哪里开始。
建议会引用模型在回答中用到的服务、实体和措辞,所以读起来像一份简报,而不是一张清单。
按影响力筛选,并在最近一次运行和各平台最近一次运行之间切换,避免不小心拿 ChatGPT 的回答和 Gemini 的回答做比较。
「用内容编辑器优化」会把提示词直接带入 Content Editor,建议和初稿就在同一个地方。
针对 “一家有效的 SEO 机构应该提供哪些服务?”
ChatGPT · 2026 年 8 月 5 日
做一个结构清晰的“SEO 服务”落地页,清楚列出并说明 AI 回答中提到的每项服务(关键词研究、页面优化、技术优化、内容、外链建设、本地 SEO、数据分析)。使用经过关键词优化的标题、描述性的 meta 标签,以及指向各服务子页面的内链。
ChatGPT · 2026 年 8 月 5 日
围绕该用户查询发布一篇长篇支柱文章,并配上一组支撑性的集群博客文章。加入可操作的示例、清单和 schema(FAQ/HowTo)。这会直接提升该信息型查询的可见度。
ChatGPT · 2026 年 8 月 5 日
做一次审计(网站速度、移动端可用性、抓取错误),修复 PageSpeed Insights 和 Google Search Console 中发现的问题。为 Organization、Service、FAQ 和 Breadcrumbs 部署结构化数据。
ChatGPT · 2026 年 8 月 5 日
加入简短的案例,写清目标、范围和结果,并把资质放在显眼处。真实案例能建立起模型在决定提到哪家机构时所看重的信任信号。
搭建提示词集合
先从你已经知道买家会问的问题入手,再用竞争对手正在赢而你从未追踪过的提示词来扩展。
一次性粘贴一整组,而不是一条条添加。一个值得信任的提示词库是几十条,不是五条。
给提示词打上主题标签,就能按主题看表现,发现自己在定义类上很强、在对比类上却完全缺席。
把重要的标记为追踪,在改动上线后运行分析,并关注出现频率,而不是某一次运行的结果。
把完整的提示词集合及其指标导出到 Sheets、CSV 或 PDF,没有行数限制,可用于汇报材料或你自己的建模。
你能从中得到什么
构建一套能反映真实购买问题的提示词集合
找出答案被竞争对手占据的提示词
针对重要的提示词,带走一条具体、写明的行动建议
连接 Search Console 资源的那一刻,入库就开始了:不用配置 Google Cloud 项目,不用 BigQuery,也不用设计表结构。你只要连接资源,SEO Stack 就会从那天起存下你的每一行数据。