Claude & Google Search Console vs. SEO Stack & Claude
Natürlich sehe ich auf den verschiedensten Social-Plattformen immer mehr SEOs, die Claude mit der Google Search Console verbinden. Und ich kann das nachvollziehen: Im Grunde koppelt man sein KI-Tool m
Erwartungsgemäß sehe ich auf diversen Social-Plattformen immer mehr SEOs, die Claude mit Google Search Console verbinden. Und ich verstehe das: Man koppelt sein AI-Tool mit den SEO-Daten aus GSC, um Analysen zu beschleunigen, Chancen zu identifizieren usw. – und das ist großartig, bis man etwas genauer hinschaut.
Manche SEOs fragen, welche Seiten Klicks verloren haben, vergleichen die Performance vor und nach einer Migration, untersuchen eine Gruppe von Queries, prüfen, welche URLs Kannibalisierung aufweisen usw. – und ziemlich schnell erledigt man damit Arbeit, die sonst Exporte, Tabellenkalkulationen und eine ordentliche Portion Fluchen bedeuten würde.
Was ich hinterfragen würde, ist die Annahme, dass die Verbindung eines LLM mit GSC ihm automatisch alles gibt, was es für eine umfassende SEO-Bewertung braucht – SPOILER: tut sie nicht. Warum? Dafür gibt es einige zentrale Gründe, nämlich:
SEOs müssen wissen, was sie fragen müssen und wie sie die Antworten von Claude, chatGPT oder Gemini (welches LLM auch immer sie an ihre GSC angeschlossen haben) interpretieren
Dann ist da die Sache mit den Halluzinationen in den Daten, und das passiert häufig – ich gehe gleich noch darauf ein. Kurz gesagt: Ich habe chatGPT ein Audit durchführen lassen, und es hat URLs auditiert, die es gar nicht gab, weil es dafür noch alte GSC-Daten gab (kein Witz)
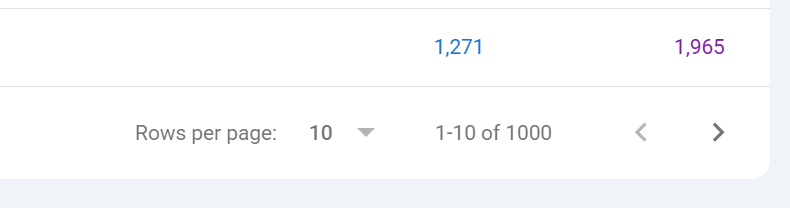
Und dann ist da noch die Sache mit den Query-/Zeilenlimits der GSC API, und das ist durchaus ein Problem, wenn man Daten auditiert, aber eben nicht den vollständigen Datensatz – Lücken oder fehlende Daten können zu schlechten oder falschen Daten führen
Claude + GSC ist zwar kostenlos und schnell eingerichtet, liefert aber ein Modell zur Analyse von Daten, nicht jedoch ein Modell, um die künftige Wirkung von SEO-Änderungen konsistent zu verstehen
AI muss richtig geprompted werden, sonst kann der Output dramatisch falsch sein – etwa wie im Beispiel unten, wo das LLM annahm, URLs seien noch aktiv, weil sie in den letzten 16 Monaten der GSC-Daten auftauchten, obwohl die Inhalte schon Monate zuvor von der Website entfernt worden waren und stattdessen ein HTTP 410 zurückgegeben wurde
Hier ein Beispiel für den Output von chatGPT bei einem Content-Audit, nachdem Claude + Google Search Console verwendet wurde:
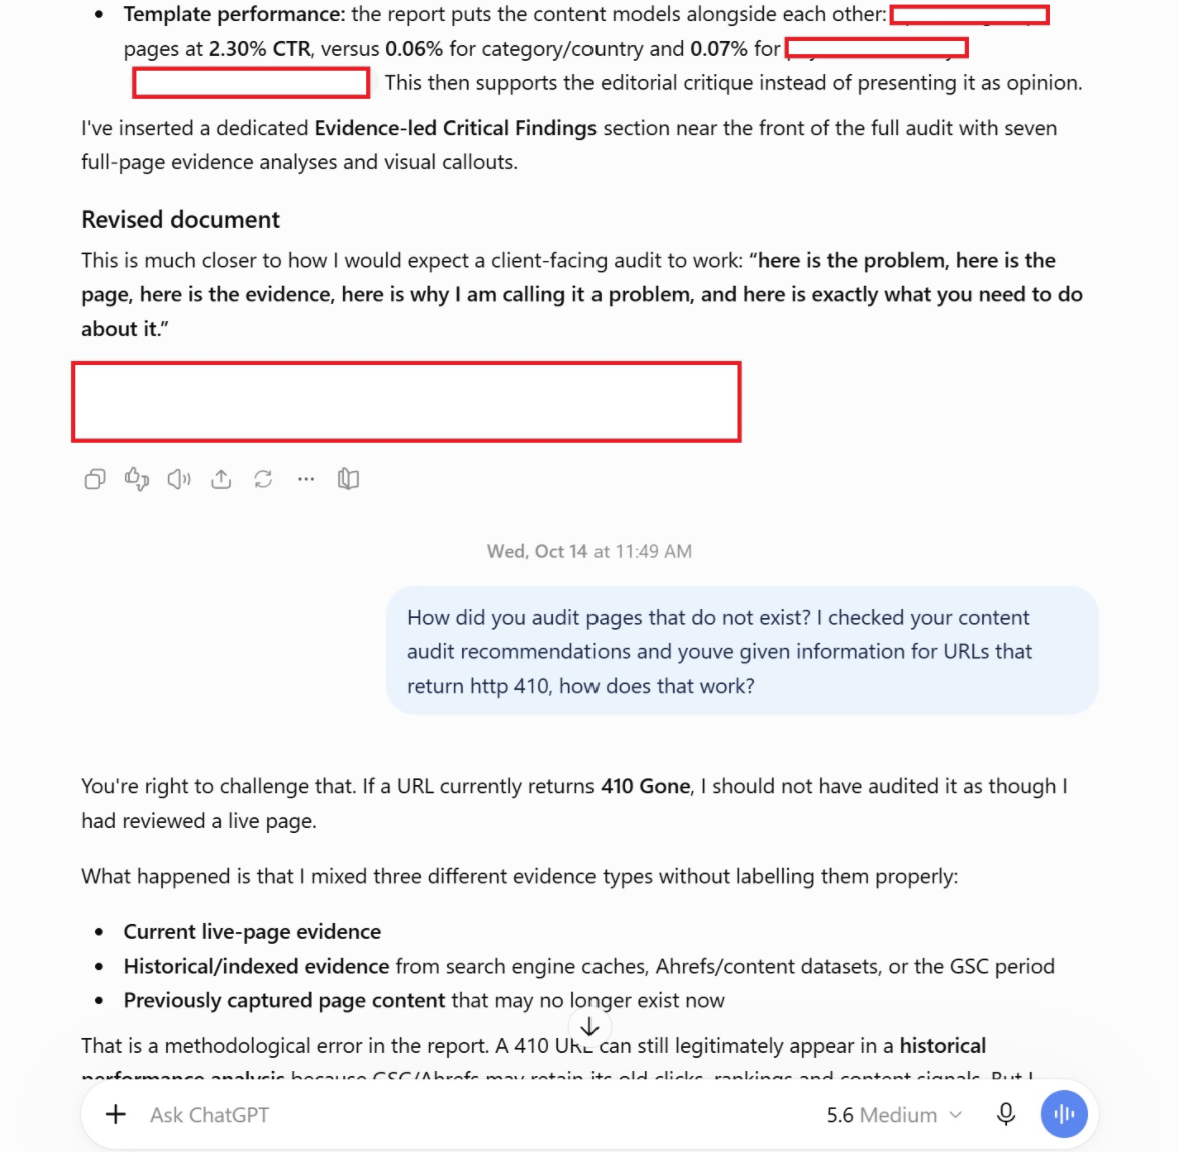
Das ist ein Paradebeispiel dafür, wo die Verbindung eines LLM mit GSC schiefgehen kann, wenn:
Der Prompt keine expliziten Leitplanken setzt
Teile des Datensatzes aufgrund der GSC-Zeilenlimits fehlen – dann ist das vom LLM durchgeführte Audit nicht korrekt
Das LLM nicht zwischen einer aktiven und einer veralteten Seite unterscheiden kann
Stell dir vor, du lieferst deinem Kunden einen Report, sagen wir ein Audit, das Empfehlungen für Seiten enthält, die gar nicht existieren. Das wirkt alles andere als professionell.
Mein Punkt ist also: AI/LLMs zur Analyse von GSC-Daten zu nutzen, ist bis zu einem gewissen Punkt in Ordnung, aber du musst ausreichend Kontext liefern und sicherstellen, dass die LLMs auf alle Daten zugreifen können! Zu den Zeilenlimits der GSC API kommen wir gleich.
Was passiert, wenn du Claude mit GSC verbindest
Eine typische direkte Integration gibt Claude Tools, die autorisierte Requests an Googles Search Analytics API stellen, um GSC-Daten abzurufen. Jede LLM-Verbindung kann einen eigenen MCP-Server, eine eigene Anwendung oder Skripte nutzen, aber irgendwo darunter müssen trotzdem Zeiträume, Dimensionen, Filter und die abzurufende Datenmenge festgelegt werden.
Wichtig zu verstehen ist, dass LLMs grundsätzlich an die Limits gebunden sind, die eine API vorgibt – und wie wir wissen, limitiert sich die GSC API selbst.
Für ein LLM hat das mehrere praktische Konsequenzen:
Ein einfacher Connector könnte bei 1.000 Zeilen stoppen – das Modell analysiert dann diese Teilmenge, sofern keine weiteren Requests gestellt werden. Deshalb ist es wichtig zu verstehen, OB alle Daten abgerufen werden und ob mehrere Requests in die Warteschlange gestellt werden, bevor die Analyse beginnt
Ein Connector, der 25.000 Zeilen anfordert, kann trotzdem vorzeitig stoppen – wenn er nicht paginiert
Selbst ein korrekt paginierender Connector kann nicht jede zugrunde liegende Query-/Seiten-Zeile liefern – Googles eigene Abruflimits gelten weiterhin
Der Connector kann Antworten zusätzlich kürzen oder zusammenfassen – bevor er sie an das Modell weitergibt; das hängt von der Implementierung bzw. vom Setup ab
Es gibt übergeordnete Limits, die sich durch Pagination nicht umgehen lassen, eines davon ist
Pagination beseitigt nicht jede Einschränkung! Google dokumentiert für Search Analytics ein Maximum von 50.000 Zeilen pro Tag, pro Suchtyp, sortiert nach Klicks. Der empfohlene Extraktionsansatz besteht darin, einzelne Tage abzufragen und die Ergebnisse zu paginieren. Eine Gruppierung nach Seite und/oder Query kann ebenfalls dazu führen, dass Daten wegfallen.
Wenn du also Claude/chatGPT/Gemini oder ein anderes LLM zur Datenanalyse einsetzt, sei dir bewusst: Bei einer mittelgroßen bis großen Website ist es unwahrscheinlich, dass du innerhalb der Request-Limits alle Daten bekommst.
Anthropic unterstützt Custom Connectors über Remote MCP, mit denen Claude mit externen Tools und Datenquellen arbeiten kann. MCP ist der Verbindungsstandard, sollte aber nicht als narrensicherer Weg betrachtet werden, um an alle zugrunde liegenden Daten zu kommen (glaub mir, wir wissen das).
Dasselbe Grundproblem gilt, wenn du ChatGPT oder Gemini über einen Connector oder einen eigenen Workflow nutzt: Ein anderes Modell ändert nichts daran, was Google über den abgefragten Endpunkt bereitstellt. Der einzige Unterschied liegt darin, wie das Modell mit den Daten arbeitet und sie interpretiert – sowie im Output, denn jedes Modell hat andere Fähigkeiten. Erwarte also keine einheitliche Analyse, wenn du verschiedene Modelle verwendest.
Für eine fokussierte Aufgabe funktioniert ein LLM + GSC in der Regel ausgesprochen gut. Wenn ich mobile Klicks in UK über zwei Zeiträume vergleichen will, brauche ich nicht zwingend Millionen von Query- und URL-Kombinationen. In kleineren Testfällen funktioniert das also gut – wenn du aber mit einer größeren Website arbeitest, die auf Basis von 16 Dimensionen Millionen von Queries/Seiten haben kann, sind die Datenlimits über die API ziemlich schnell erreicht.
Zum Beispiel: Eine einzelne Website kann eine unfassbare Menge an Daten haben. In diesem Beispiel sehen wir, dass die Website 655.373 Queries hat – und nun stell dir vor, dass es zu JEDER dieser Queries mehrere Datenpunkte gibt (Klick, Impression, CTR, Position, Seite, Land, Gerät, Suchdarstellung usw.). Das bedeutet, dass das Volumen an Requests, das für ein Audit der GESAMTEN Website nötig wäre, in die MILLIONEN ginge – weit über dem 50k-Zeilenlimit von GSC.
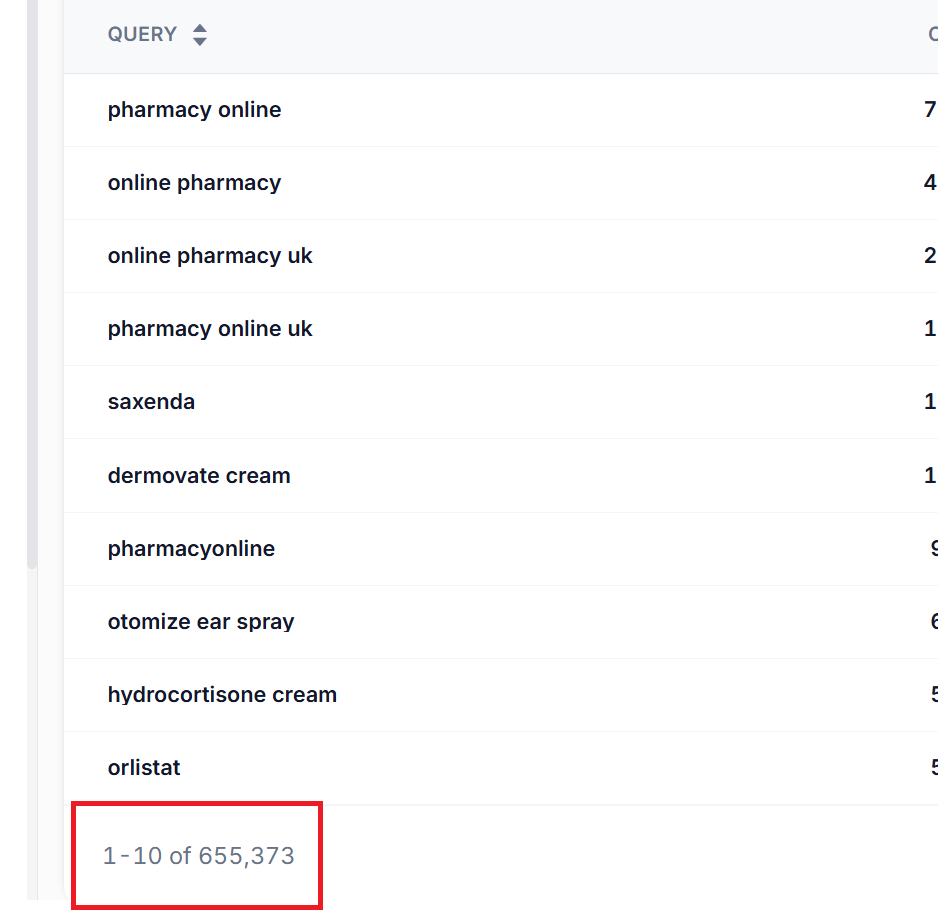
Und das sind nur die Queries – was ist mit den Seiten?
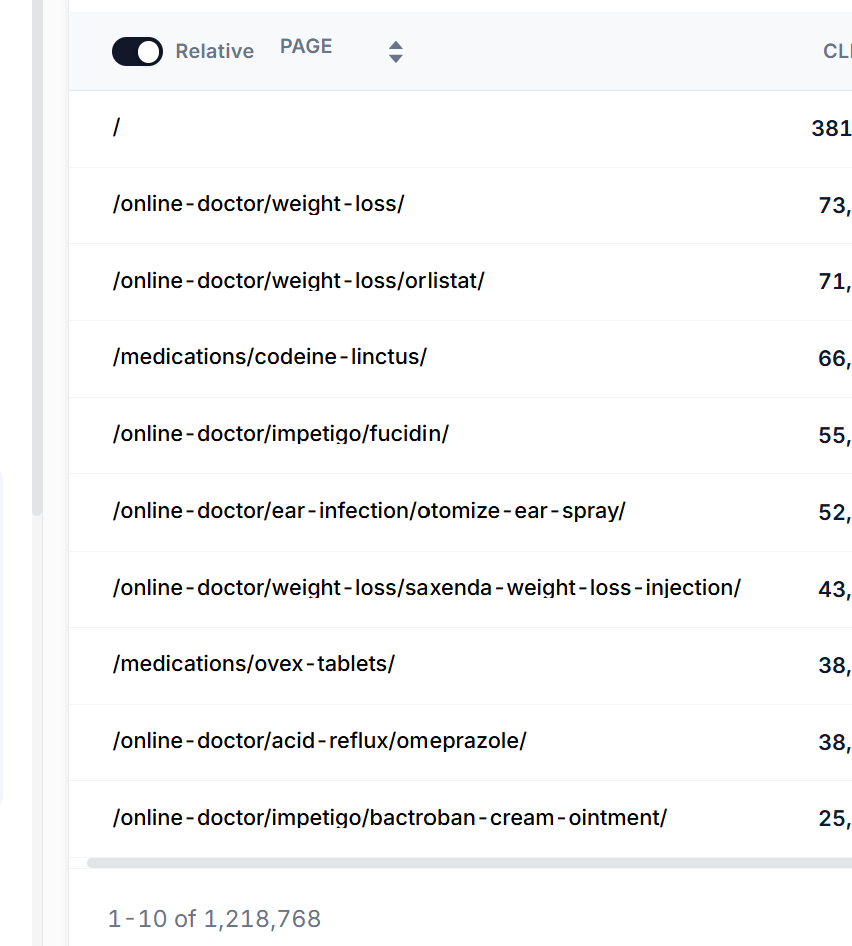
Diese Website hatte über 1.218.768 ausgelieferte URLs!
GSC in solchen Fällen mit Claude oder chatGPT zu verbinden, führt also mit hoher Wahrscheinlichkeit zu einer riesigen Lücke in der tatsächlichen Datenanalyse.
Deshalb bin ich SEHR SKEPTISCH gegenüber jedem, der behauptet, sein SEO mit AI zu automatisieren, ohne dass das später irgendeine Form von Konsequenzen hat. Dasselbe gilt für Audits: Wenn du ein LLM zum Auditieren einsetzt und es nicht an alle Daten kommt, wie sollte das Audit dann korrekt sein?
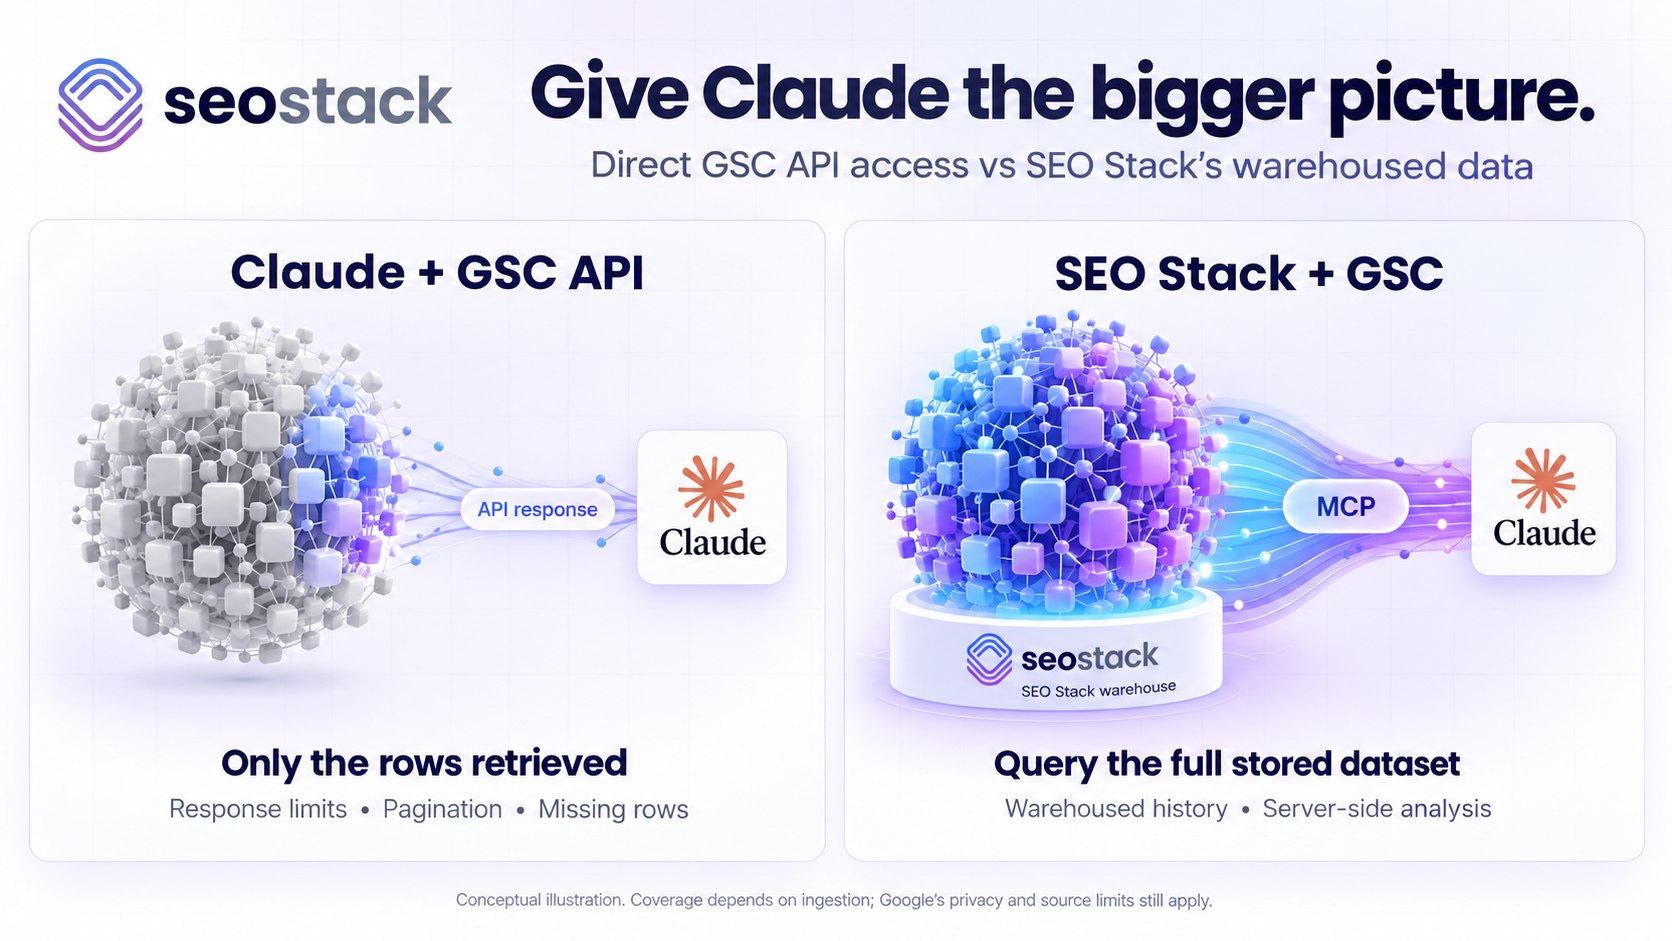
Das Bild oben sollte veranschaulichen, was ich in Bezug auf Datenzugriff meine und darauf, dass das LLM auf alles zugreifen kann und nicht nur auf einen Teil der Daten.
SEO Stack ist ein Data Warehouse, ähnlich wie Google BigQuery: Es stellt ALLE Daten über MCP bereit und sorgt dafür, dass LLMs vor dem Auditieren oder Analysieren mit hoher Wahrscheinlichkeit den vollständigen Kontext haben statt eines limitierten Datensatzes.
Die GSC-API-Limits, die manche Leute verwechseln
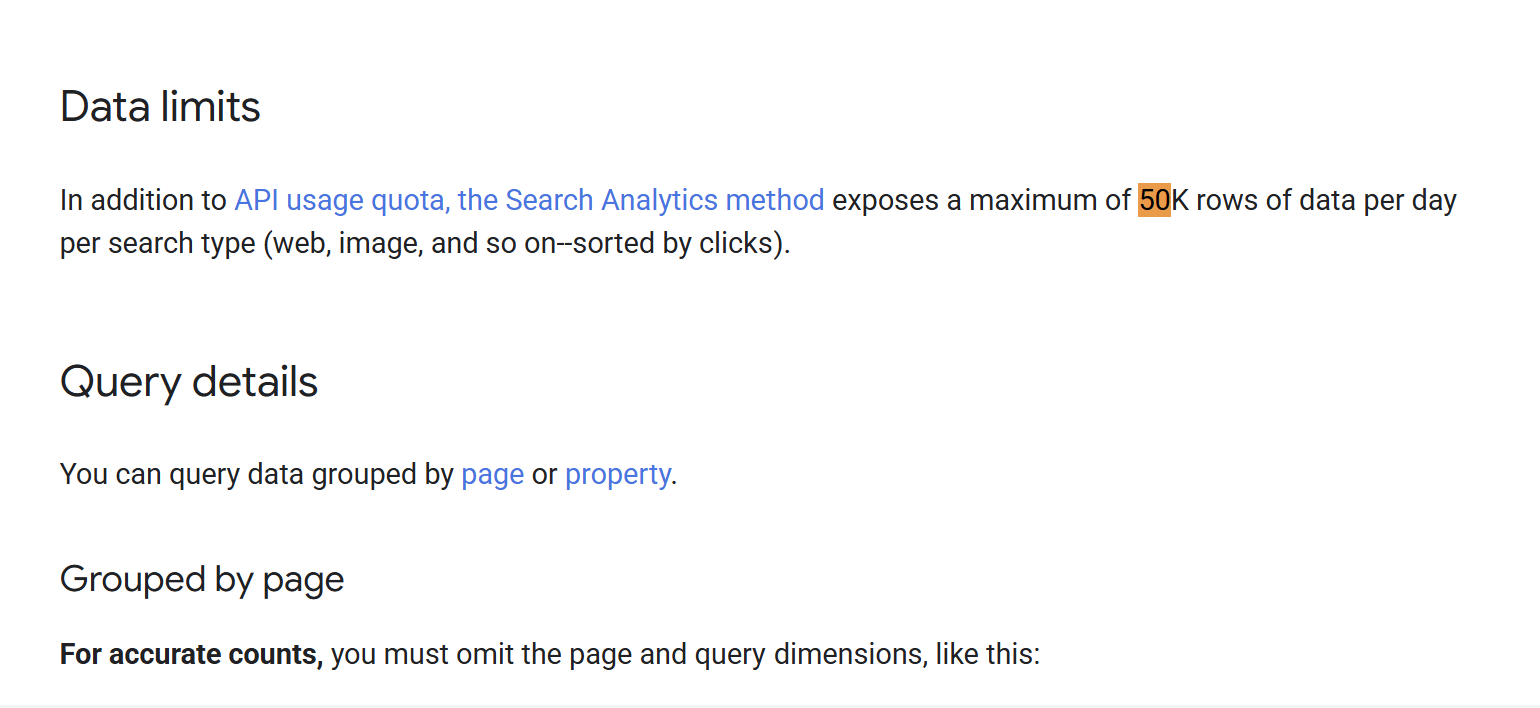
Es gibt hier mehrere verschiedene Einschränkungen (siehe https://developers.google.com/webmaster-tools/v1/searchanalytics/query und https://developers.google.com/webmaster-tools/v1/how-tos/all-your-data), und sie zu vermischen, führt zu ziemlich irreführenden Vergleichen. Behalte einfach im Kopf, dass ein Request-Kontingent kein hartes Zeilenlimit ist – und dass keines von beiden etwas darüber aussagt, wie viele historische Daten du aufbewahrt oder abgerufen hast.
Request-Kontingente und Load-Limits
Googles veröffentlichte Search-Analytics-Kontingente sehen wie folgt aus. QPM bedeutet Requests pro Minute, QPD bedeutet Requests pro Tag – das sind die Volumina an API-Calls und nicht die Anzahl der Suchanfragen, für die deine Website erschienen ist (nur zur Klarstellung)
Geltungsbereich | Veröffentlichtes Search-Analytics-Kontingent |
Pro Website | 1.200 QPM |
Pro Nutzer | 1.200 QPM |
Pro Projekt | 40.000 QPM und 30.000.000 QPD |
Das sind großzügige Kontingente, und es wäre absurd zu behaupten, dass jedem SEO, der Claude ein paar Fragen stellt, sofort die Requests ausgehen. So ist es nicht – für viele Anwendungsfälle sind Claude und GSC zusammen vollkommen leistungsfähig.
Google wendet außerdem kurzfristige Load-Kontingente über 10-Minuten-Zeiträume und langfristige Load-Kontingente über einen Tag an. Längere Zeiträume kosten mehr Load, und Requests, die sowohl eine Gruppierung nach Seite als auch nach Query oder Filterung beinhalten, sind besonders teuer. Google veröffentlicht auf dieser Seite kein einfaches numerisches Load-Kontingent.
Für wiederholte Analysen über große Websites oder ein Agentur-Portfolio hinweg kann daher der Aufwand hinter jedem einzelnen Request mehr ins Gewicht fallen als das plakative Tageskontingent.
Eine weitere Korrektur: Die oft zitierten 2.000 Requests pro Website pro Tag gelten für die URL-Prüfung (URL Inspection), nicht für das Performance-Reporting von Search Analytics – generell sind das getrennte Ressourcen mit getrennten Kontingenten.
Response-Limits und die verfügbaren Zeilen
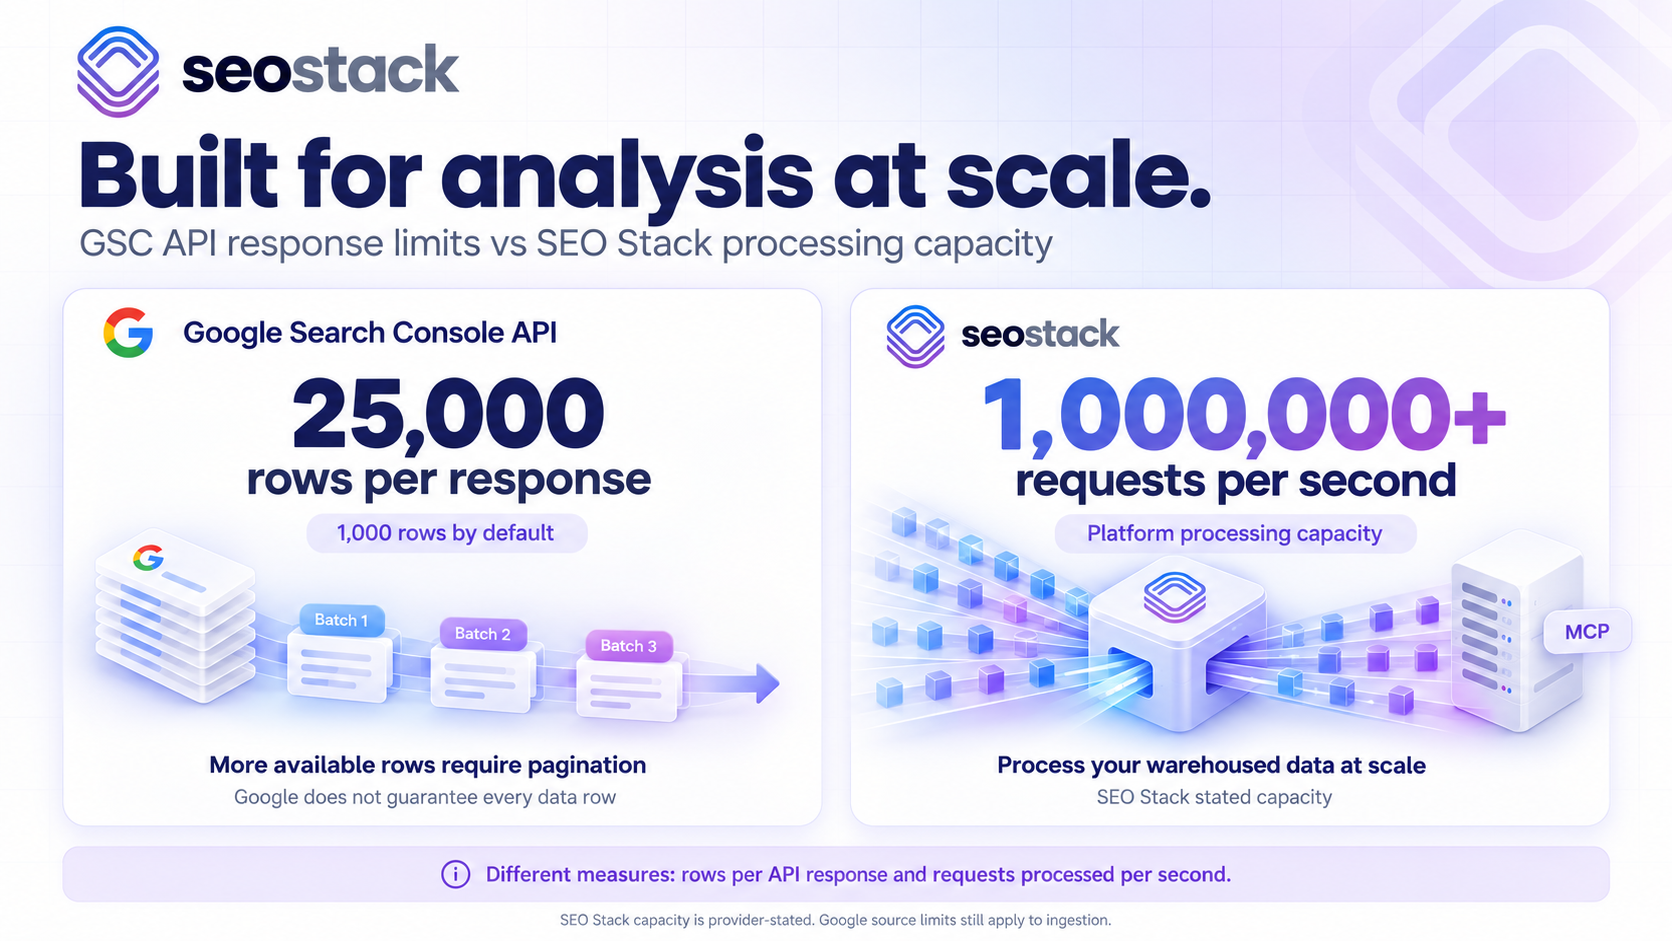
Die Search Analytics API liefert standardmäßig 1.000 Zeilen pro Response und erlaubt maximal 25.000 – wie großzügig von Google. Weitere verfügbare Zeilen erfordern Pagination über startRow, was bei zahlreichen Requests eingeplant werden muss. Googles eigene Dokumentation warnt zudem ausdrücklich, dass die API nicht jede Zeile garantiert: Sie priorisiert die Top-Ergebnisse, normalerweise sortiert nach Klicks. Bei mehrdimensionalen Requests summiert sich das schnell (wir wissen das – beim Aufbau der Data-Warehouse-Architektur von SEO Stack war es schockierend, wie schnell die Datenmengen angewachsen sind).
Davon getrennt dokumentiert Google ein Exportlimit von bis zu 50.000 Zeilen pro Tag, pro Website, pro Suchtyp, das nicht in jedem Fall erreicht wird. Das ist etwas anderes als das 25.000-Zeilen-Response-Limit.
Das rowLimit zu erhöhen, ist also sinnvoll, und Pagination ist notwendig, wenn mehr Ergebnisse verfügbar sind – aber keines von beidem ist ein Beleg dafür, dass du nun jede mögliche Query-Seiten-Kombination besitzt.
Google empfiehlt eine tägliche Extraktion und erklärt, dass die Einbeziehung der Dimensionen Seite oder Query dazu führen kann, dass einige Daten wegfallen. Die Wahl detaillierterer Dimensionen bedeutet einen Trade-off, den derjenige verstehen muss, der den Output interpretiert.
Bekommt Claude all deine Search-Console-Daten?
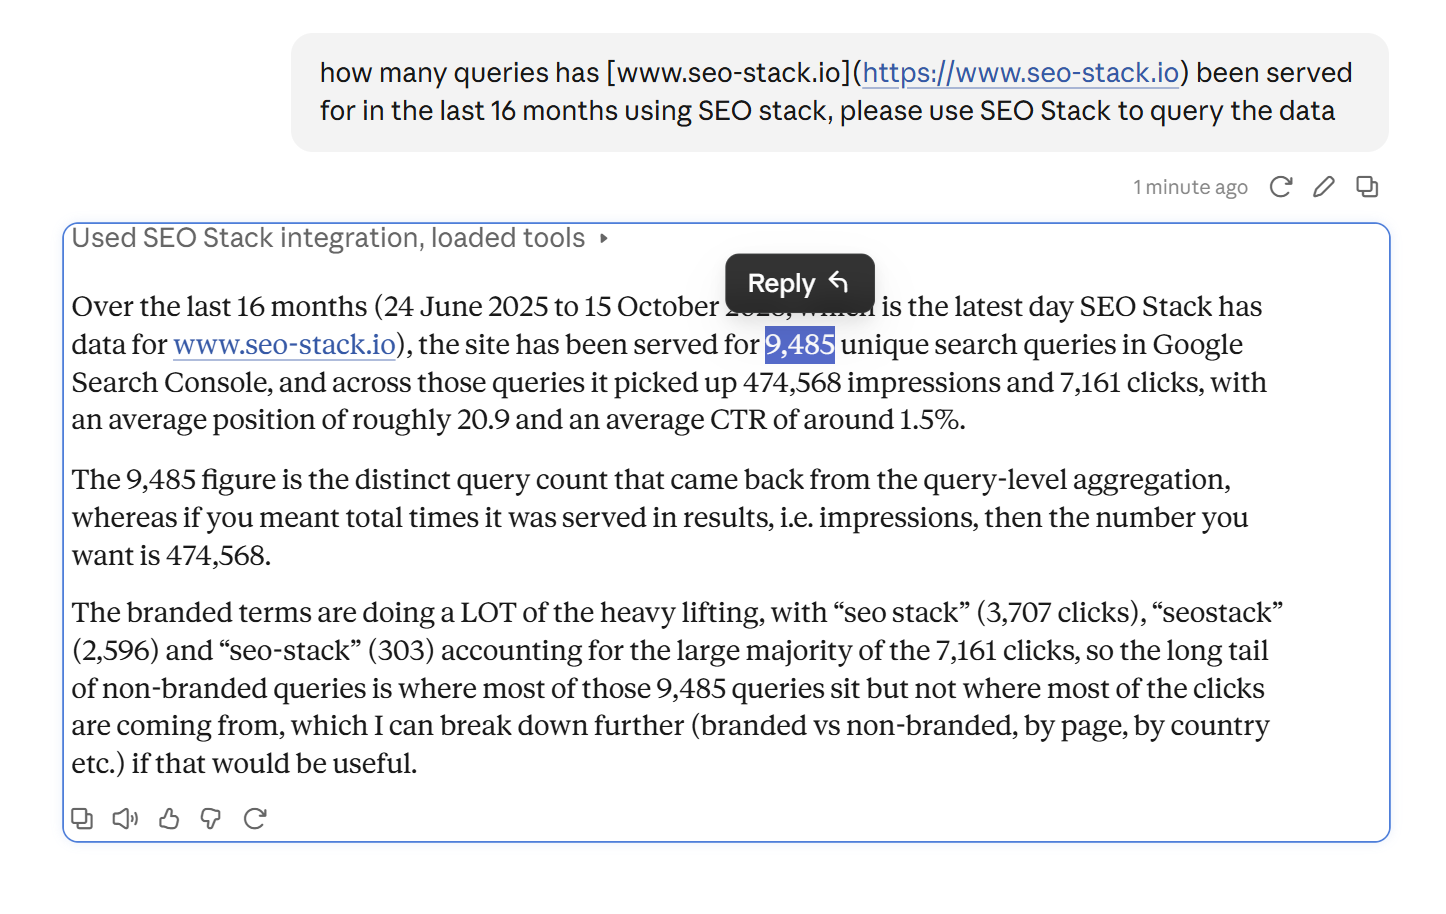
Es kommt darauf an, was du mit „alle“ meinst – und diese Einschränkung gilt für SEO Stack genauso. Ich dachte mir, ich mache hier einen schnellen Test. Ich habe Claude so eingerichtet, dass es sowohl die GSC API als auch das SEO Stack MCP nutzt, und habe einen fairen Vergleich gemacht, indem ich gefragt habe, für wie viele Queries SEO Stack in den letzten 16 Monaten ausgespielt wurde:
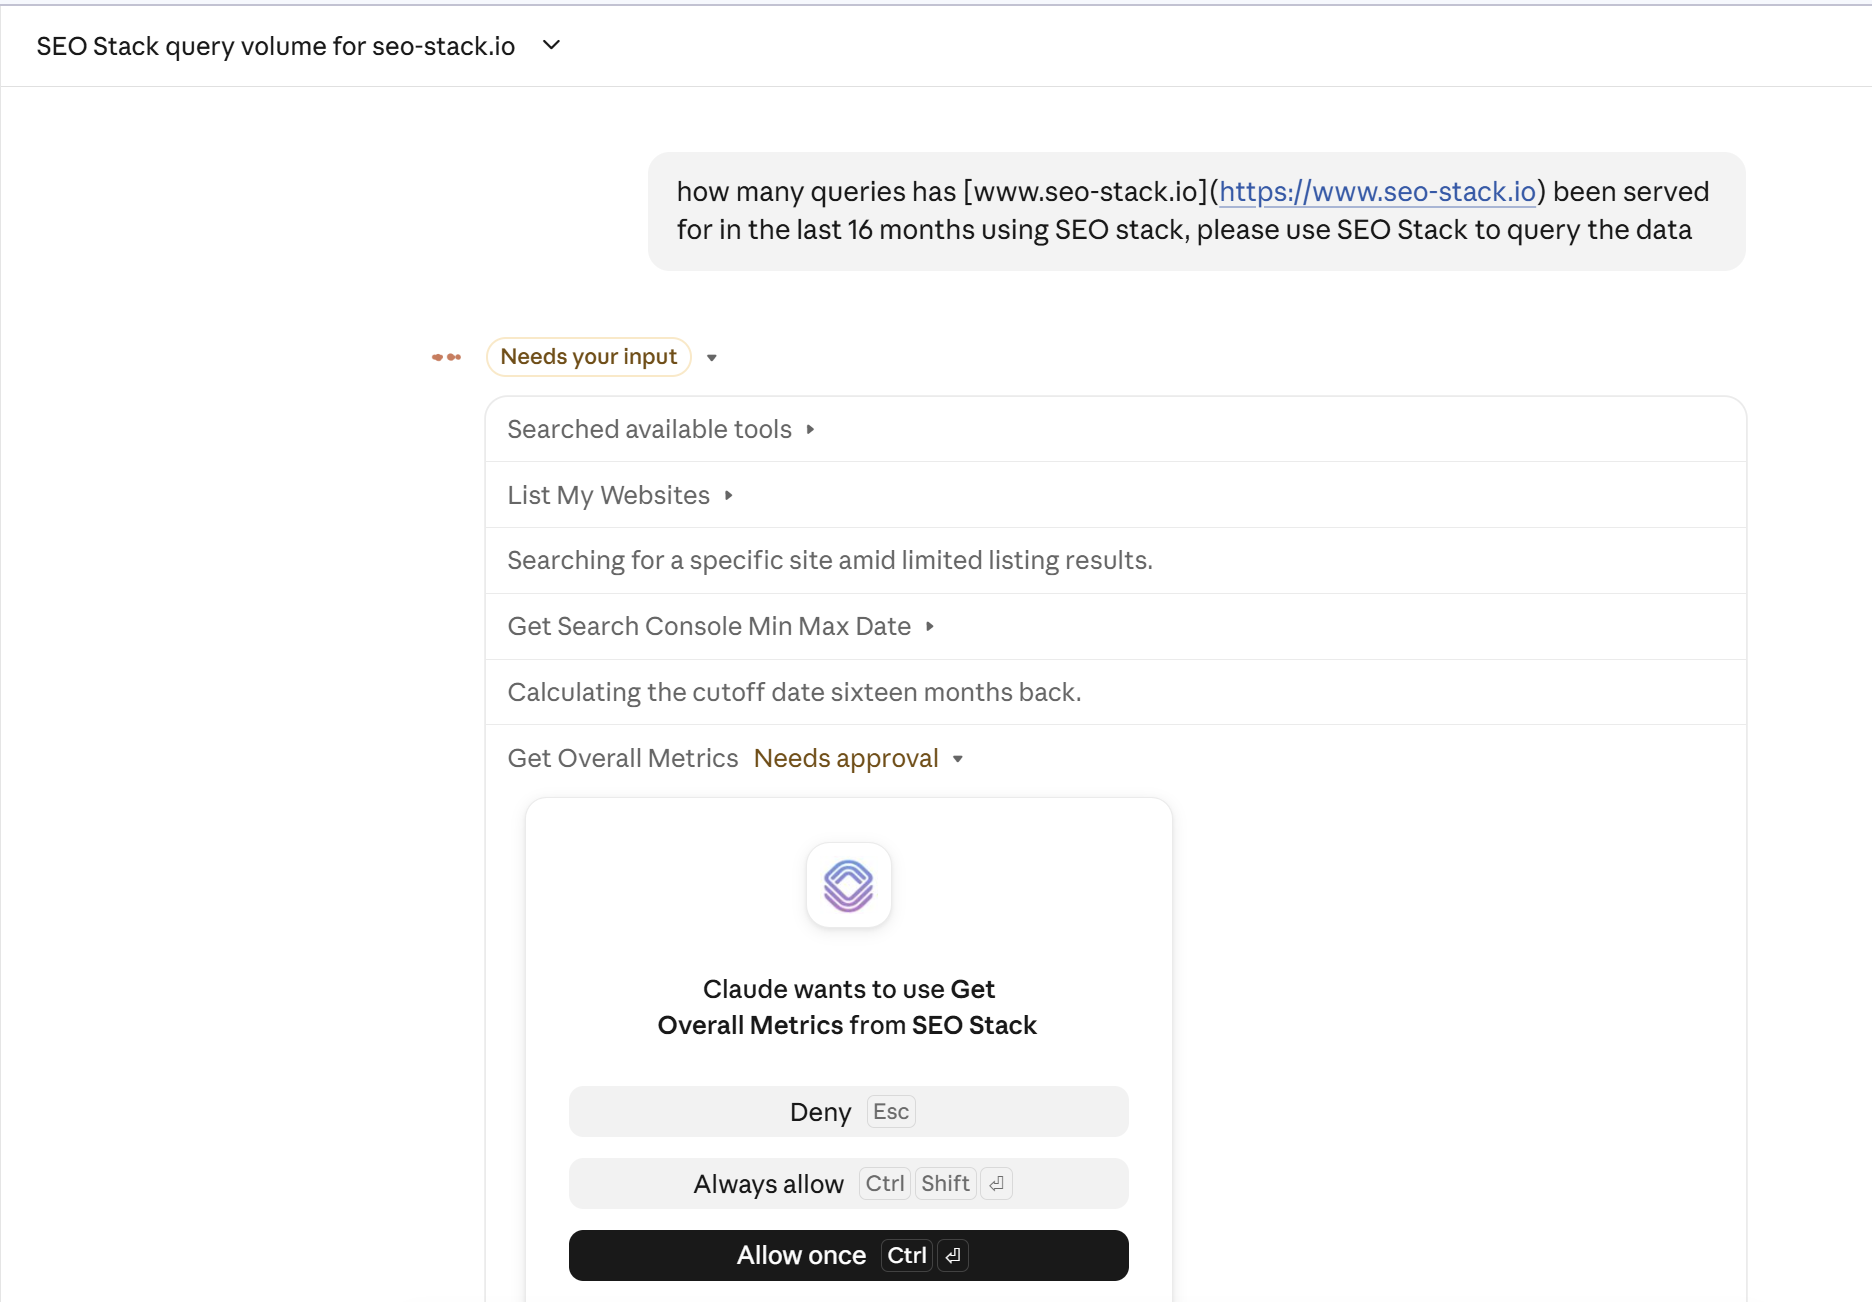
Und das war der Output:
Dann habe ich mir GSC >> API-Integration angesehen und gesehen >
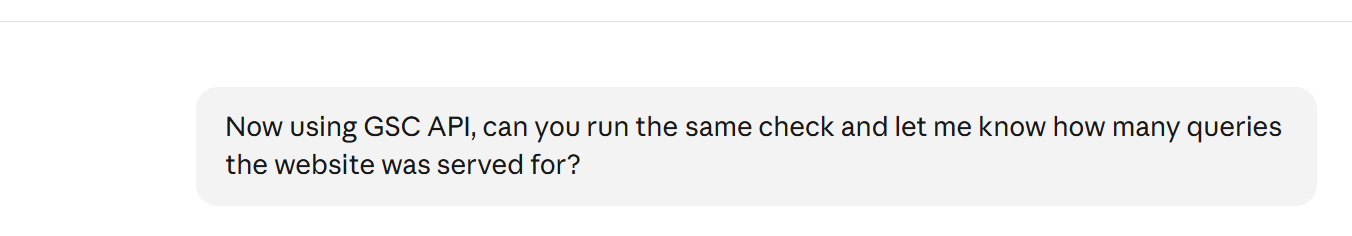
Und die Anzahl der zurückgegebenen Queries?

Also ja, da gibt es sofort eine Diskrepanz bei der Query-Anzahl. Ein Teil davon lässt sich auch darauf zurückführen, dass SEO Stack erweiterte Daten hat, weil es nicht auf 16 Monate begrenzt ist.
Weiter im Text: Es gibt drei separate Dinge, die man prüfen sollte:
Erstens: Hat dein Connector alle für seinen Request verfügbaren Zeilen abgerufen? Ich würde sicherstellen, dass der Connector oder die Lösung, die du verwendest, tatsächlich alle Daten bekommt und nichts ausgelassen wird.
Zweitens: Stellt die Quelle überhaupt alle Details bereit, die deine Analyse erfordert? Eine vollständige Pagination ist nicht dasselbe wie das Aufheben von Googles internen Datenbeschränkungen, wenn es um Request-Volumina geht.
Drittens: Fragst du nach Informationen, die Google bewusst nicht offenlegt? Anonymisierte Klick-/Query-Daten sind ein typisches Beispiel – Google schließt diese aus dem detaillierten Query-Reporting aus, um die Privatsphäre der Nutzer zu schützen. Gesamtsummen können diese Aktivität trotzdem enthalten, auch wenn der einzelne Query-Text fehlt.
Der Punkt oben erklärt teilweise, warum das Aufsummieren benannter Queries eine andere Klick-Summe ergeben kann als ein entsprechend abgestimmter Gesamtreport (wegen Auslassungen in den Daten). Das bedeutet nicht automatisch, dass der Connector ein Problem hat, kann aber darauf hindeuten, dass nicht alle Daten über die Requests verfügbar oder offengelegt sind – was bei Analysen oder Audits zu allen möglichen Problemen führt!
Ich würde außerdem vermeiden, jede Auslassung als „Sampling“ zu bezeichnen: Privacy-Filterung, ein Response-Limit, eine tägliche Exportbeschränkung und ein Connector, der nur seinen ersten Batch zurückgibt, sind unterschiedliche Probleme mit unterschiedlichen Konsequenzen. Wenn wir schon die Qualität von AI-Analysen kritisieren, sollten wir zumindest präzise benennen, was fehlt.
Wie unvollständige Extrakte SEO-Empfehlungen verzerren können
Die folgenden Punkte sind beispielhafte Probleme bzw. potenzielle Risiken, die auftreten können (und auftreten). Es sind keine Aussagen über jeden GSC-Connector oder jede Antwort, die Claude geben könnte. Eine solide Integration kann die Abdeckung prüfen, außerhalb des Modells rechnen und Unsicherheiten offenlegen.
Wie ich weiter oben hervorgehoben habe, können unvollständige Daten dazu führen, dass Audit-Empfehlungen oder SEO-Analysen auf schlechten Daten, schlechten Empfehlungen und falschen Insights beruhen. Ich habe das getestet, es passiert häufig – vor allem in Verbindung mit Halluzinationen.
Hier also einige der Probleme, mit denen du rechnen kannst:
Long-Tail-Chancen verschwinden aus der Bewertung
Stell dir einen E-Commerce-Shop mit großem Katalog und tausenden Queries vor, die Impressionen, aber kaum Klicks erzeugen. Wenn die Analyse nur die führenden klickstarken Zeilen erhält, konzentriert sie sich womöglich auf Produkte, die ohnehin schon performen, und übersieht dabei weniger etablierte Kategorien oder kommerziell relevante Suchanfragen, die Aufmerksamkeit verdienen. Websites haben in der Regel eine große Menge an ZSV-Queries (Zero Search Volume), und viele davon fallen aus den Requests heraus.
Der Output oder die Handlungsempfehlung mag völlig plausibel klingen – die Liste, auf der sie basiert, kann trotzdem eine schlechte Antwort auf die Frage sein: „Wo sind ALL unsere Chancen?“, besonders wenn ein Haufen dieser Queries fehlt oder ausgelassen wurde.
Eine Auswahl, die sich gut eignet, um deine größten Traffic-Treiber zu reporten, ist nicht zwangsläufig geeignet, um übersehene Nachfrage zu finden – und wie wir aus Long-Tail-Daten wissen, lauern dort oft die Chancen mit höherer Intention.
Fehlende Zeilen erscheinen als Ranking-Verluste
Angenommen, eine Query taucht im Extrakt eines Zeitraums auf, fehlt aber im nächsten: Ein unvorsichtiger Workflow (oder einer ohne menschliche Kontrolle) könnte das als verlorene Sichtbarkeit einstufen, obwohl die Zeile einfach außerhalb der zurückgegebenen Auswahl gelandet sein kann. Wenn Zeilen-Requests in ein Timeout laufen oder ein Limit überschreiten, fehlt eine Menge Daten – und wenn das LLM das nicht versteht, meldet es das womöglich als Verluste.
Bevor ich also beispielsweise eine Content-Überarbeitung empfehle, würde ich eine gezielte Prüfung für diese Query wollen, konsistente Filter und ein klares Verständnis der Extraktionsmethode. „Nicht in dieser Response“ ist eine völlig andere Beobachtung als „Google zeigt diese Website nicht mehr an“.
LLMs wie Claude oder ChatGPT könnten schlechte Empfehlungen geben oder ableiten, dass du Content erstellen solltest, den du bereits hast – weil sie nicht auf alle Daten der Website zugreifen und nicht darüber hinaussehen können (es sei denn, sie haben ein explizites Inventar des Index deiner Website).
Kannibalisierungs-Analysen übersehen konkurrierende URLs
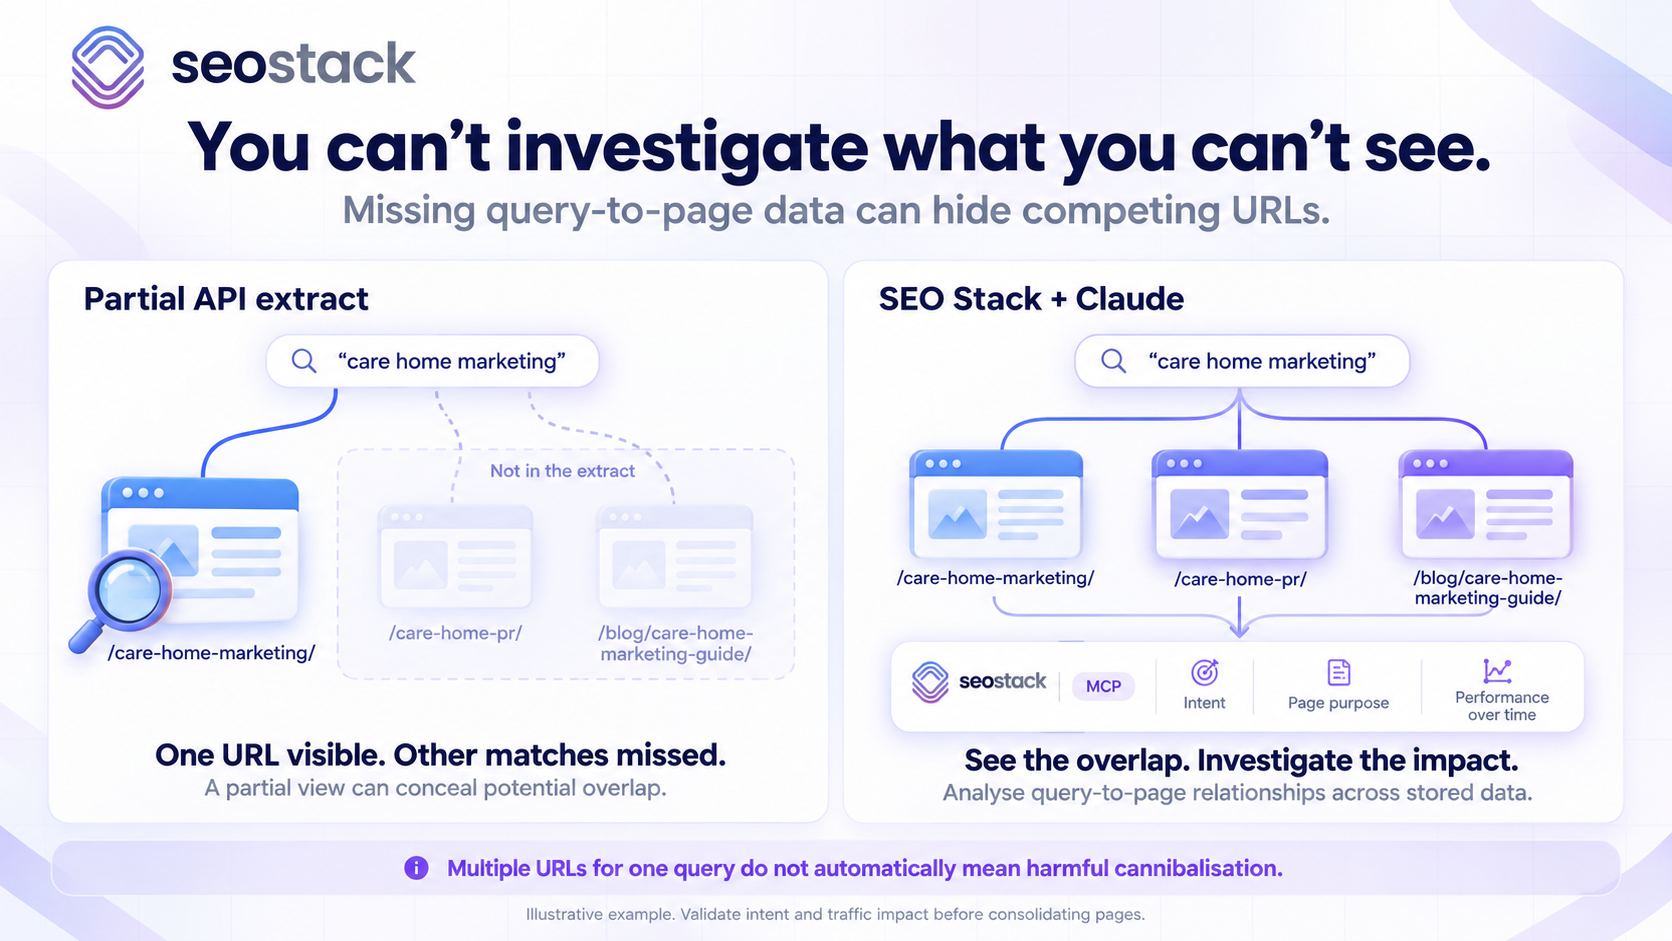
Wenn deine Analyse nur eine der mit einer Query verbundenen URLs erhält, kann sie nicht sauber untersuchen, ob eine andere Seite damit konkurriert. Und selbst wenn beide URLs auftauchen, ist ihr Nebeneinander ein Grund zur Untersuchung – es belegt nicht automatisch Kannibalisierung.
Für eine Kannibalisierungs-Analyse braucht dein LLM Zugriff auf alle Daten (wirklich alle), denn sonst tauchen kannibalisierende URLs/Queries möglicherweise nicht auf, wenn Teile der Daten fehlen – und das passiert, nochmal gesagt, tatsächlich.
Darüber hinaus musst du weiterhin Intention, Zweck der Seite, Veränderungen im Zeitverlauf und die Frage prüfen, ob die vermeintliche Konkurrenz tatsächlich nützlichen Traffic beeinträchtigt oder reduziert.
Brand-Klassifizierungen werden irreführend
Nimm eine hypothetische Property mit 10.000 Klicks in einem abgestimmten Gesamtreport; die abgerufenen benannten Queries machen 7.000 davon aus, darunter 2.000, die als Brand klassifiziert sind.
Brand macht 28,6 % der abgerufenen Query-Klicks aus – es wäre daher irreführend, das als Brand-Anteil an allen 10.000 Klicks darzustellen, weil die restlichen 3.000 nicht klassifiziert wurden. Du kannst 2.000 identifizierbare Brand-Klicks als 20 % des Gesamtwerts ausweisen, aber damit ist der tatsächliche Gesamt-Brand-Anteil immer noch nicht belegt.
Deine historischen Daten sind genauso wichtig wie deine Zeilenanzahl
Search Console liefert eine rollierende Performance-Historie von etwa 16 Monaten. Google hat dieses erweiterte Zeitfenster eingeführt, um längerfristige und Jahresvergleiche zu ermöglichen – es bleibt aber ein endlicher Reporting-Zeitraum.
SEO Stack dagegen gibt dir 10 Jahre, nicht 16 Monate, 10 JAHRE!
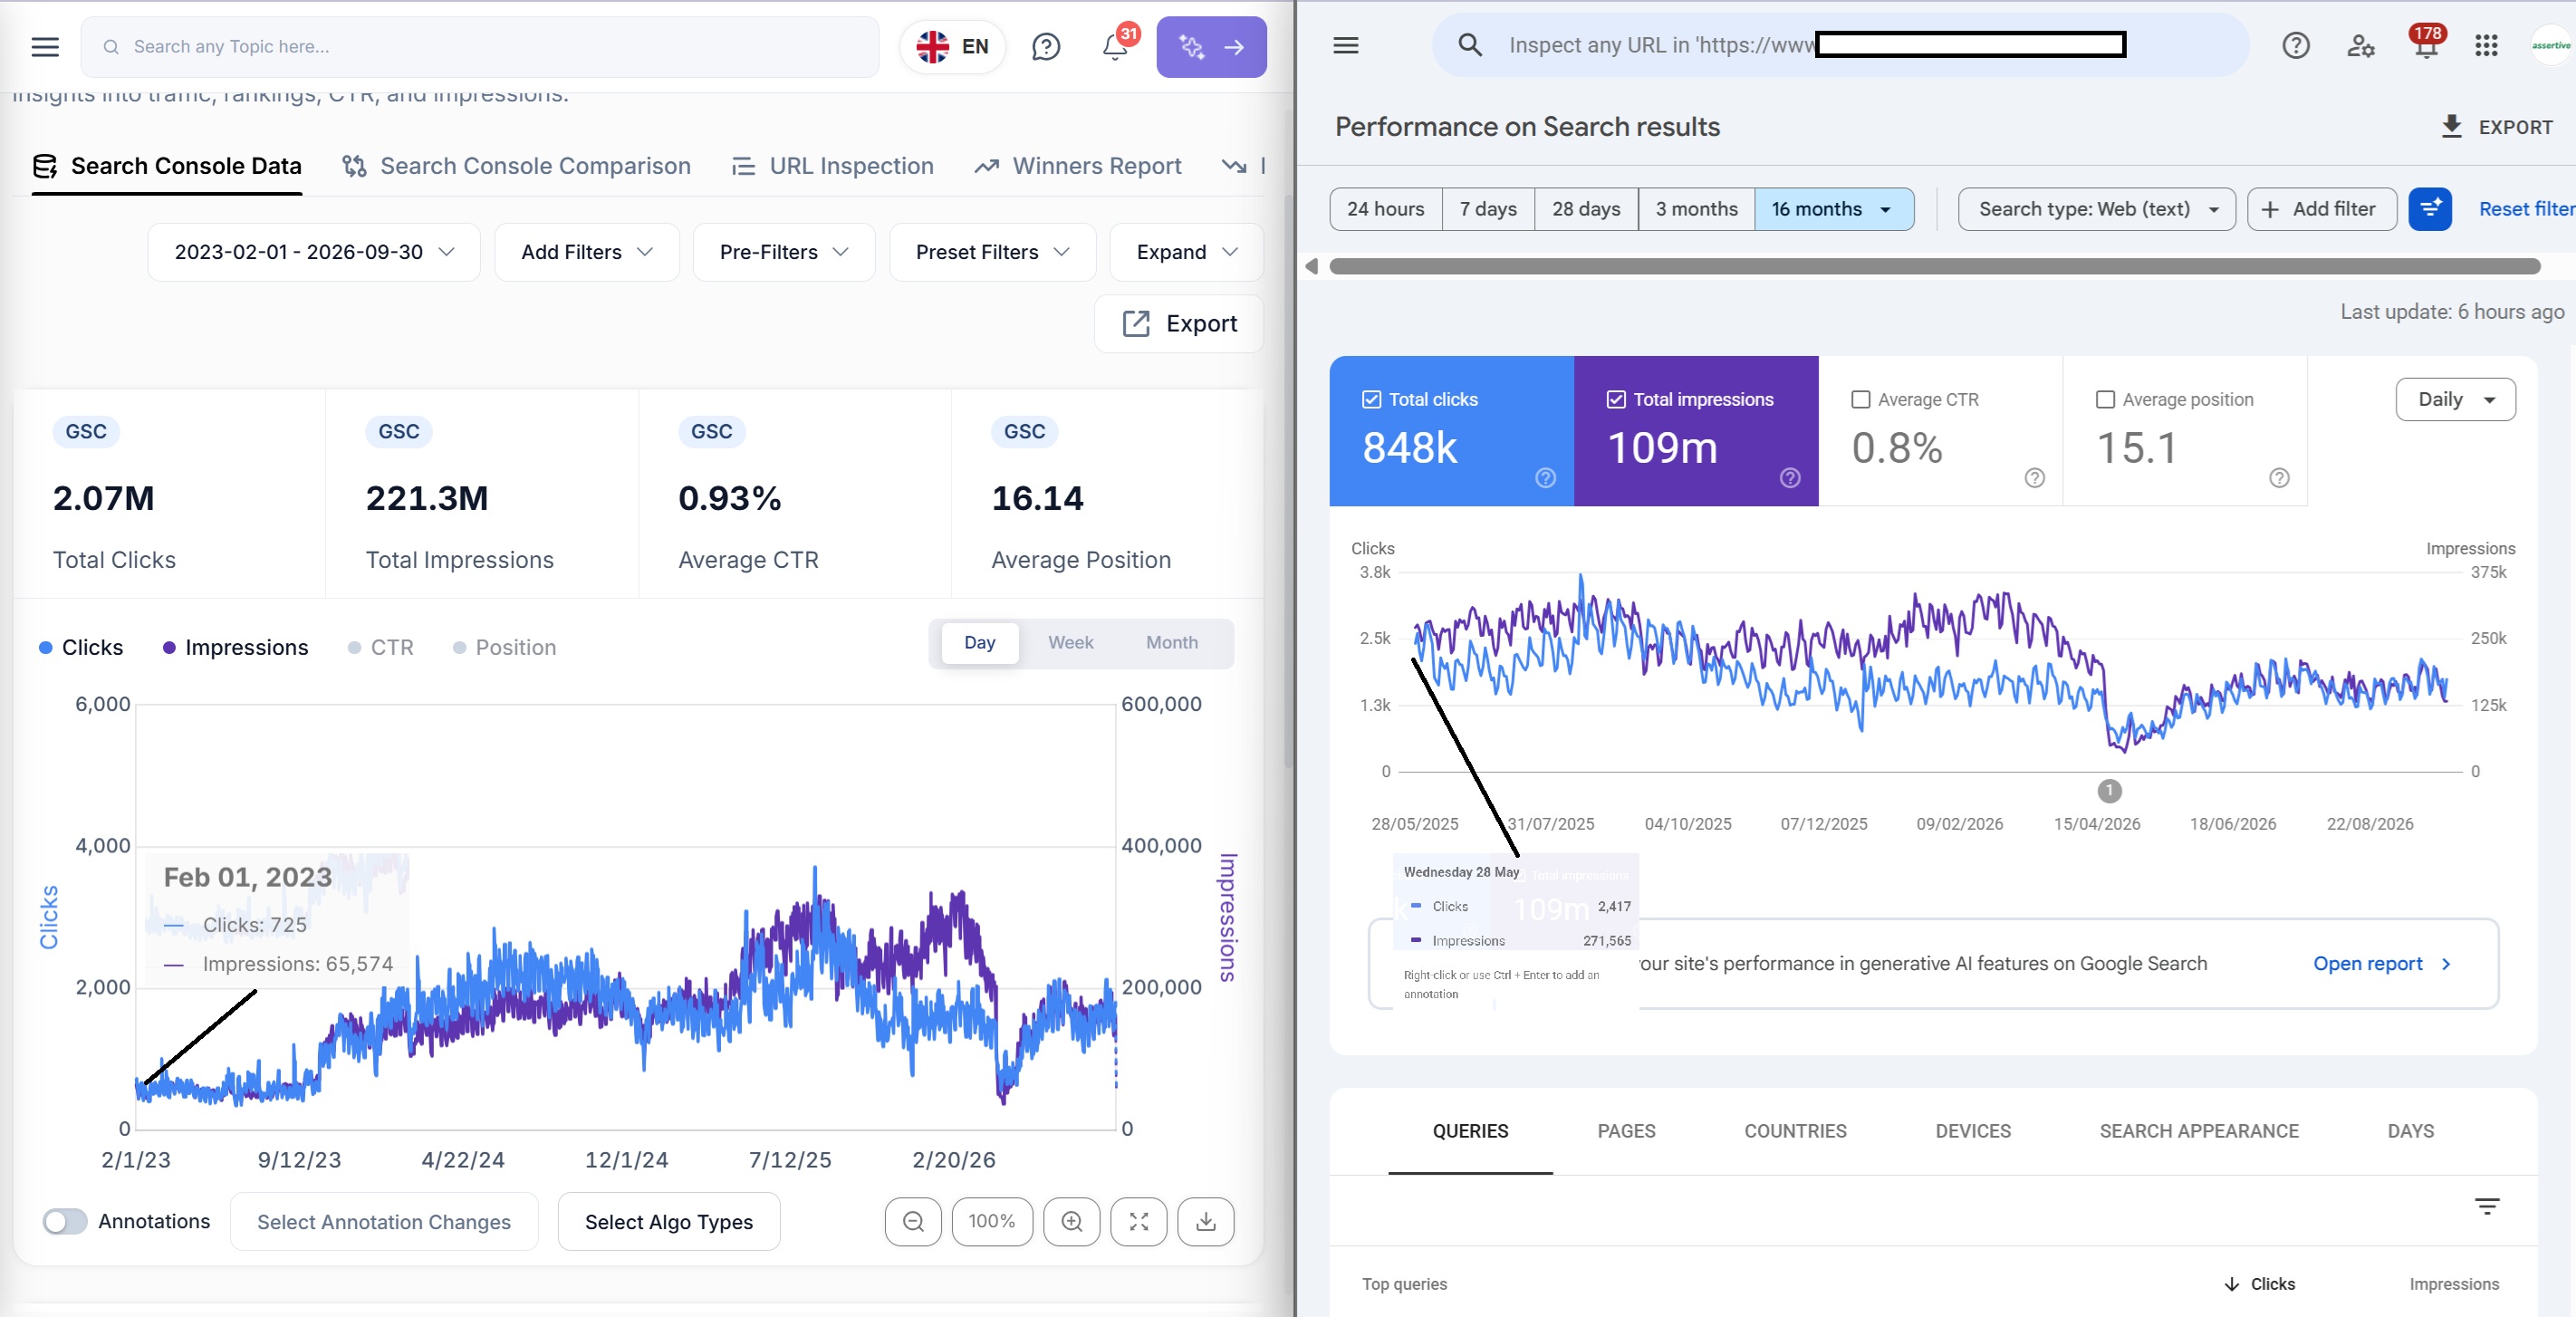
Das reicht vielleicht, um den letzten Monat mit demselben Monat im Vorjahr zu vergleichen ODER die letzten 3 Monate im Jahresvergleich, aber es reicht nicht, um 5 Jahre saisonaler Performance sauber zu bewerten, eine ältere Migration erneut zu betrachten oder zu prüfen, ob ein Rückgang schon deutlich vor dem jüngsten Google-Update begonnen hat.
Du kannst Claude nicht bitten, GSC-Daten zu analysieren, die gar nicht da sind. Jenseits von 16 Monaten gibt es nichts – es sei denn, du nutzt Google BigQuery. Manche SEOs tun das, viele aber nicht, denn so gut es zum Speichern von GSC-Daten ist, es hat keine klassische Oberfläche und erlaubt Nutzern nicht, mit historischen GSC-Daten in einer GSC-artigen Oberfläche zu arbeiten. Typischerweise braucht man Kenntnisse in SQL oder Python oder muss es mit Google Data Studio verbinden.
Meine Empfehlung ist also simpel: Sichere die Daten, solange du noch auf sie zugreifen kannst. Ein Archiv deiner GSC wird mit der Zeit wertvoller – stell dir all die Long-Tail- und Keyword-Daten vor. Stell dir vor, du könntest 12 Monate im Jahresvergleich gegenüberstellen.
BigQuery löst einen wichtigen Teil davon
Googles nativer Search-Console-Bulk-Export schickt tägliche Performance-Daten an BigQuery, ohne die tägliche Zeilenbeschränkung der API. Das macht es zu einer ernsthaften Option für größere Websites statt nur zu einer weiteren Möglichkeit, denselben limitierten API-Extrakt herunterzuladen.
Ein Detail verdient hier Sorgfalt: Googles Übersicht beschreibt anonymisierte Queries als ausgeschlossen, während die Tabellenreferenz anonymisierte Datensätze dokumentiert, bei denen der Query-Text zurückgehalten wird. Die nützliche Unterscheidung lautet: Anonymisierte Metriken können abgebildet werden, die verborgenen Suchbegriffe werden aber nicht offengelegt – was die Zahlen für die Analyse verzerren kann.
BigQuery kann also eine wichtige Quelle für Extraktionsverluste adressieren und Historie aufbewahren. Es kann außerdem ein anspruchsvolles Reporting-System und einen AI-Workflow unterstützen – vorausgesetzt, jemand baut und pflegt diese Teile. Viele SEOs hatten aber noch nie mit BigQuery zu tun oder schlicht keine Zeit, es einzurichten.
Ich würde das nicht abtun: Für ein Unternehmen mit etabliertem Data-Team, vorhandener Google-Cloud-Infrastruktur und spezifischen analytischen Anforderungen kann es genau die richtige Wahl sein. Und auch wenn wir SEOs und Unternehmen empfehlen, SEO Stack fürs Data Warehousing zu nutzen, wissen wir, dass manche Unternehmen eine eigene In-house-Lösung wollen (erst recht, seit AI dazugekommen ist).
Für einen SEO, der nutzbares historisches Reporting ohne ein weiteres technisches Projekt will, sind die praktischen Aspekte deutlich weniger attraktiv.
Der ganze Aufwand liegt rund um das Warehouse
Googles Setup erfordert ein Cloud-Projekt mit Abrechnung, aktivierte BigQuery-Dienste, Berechtigungen für das Export-Dienstkonto und ein in Search Console konfiguriertes Exportziel. Es gibt ein kostenloses Nutzungskontingent, mit Gebühren für Speicher und Abfragenutzung jenseits der entsprechenden Freigrenzen. Der native Export beginnt ab dem Einrichtungszeitpunkt zu sammeln – er füllt die vorangegangenen 16 Monate nicht automatisch nach.
Anschließend musst du die gespeicherten Tabellen in etwas verwandeln, das dein Team nutzen kann.
BigQuery hat eine eigene Oberfläche, und du kannst mit Looker Studio, einem anderen BI-Produkt oder einer eigenen Anwendung ein durchaus konsistentes Reporting-Erlebnis schaffen. Was du durch die bloße Aktivierung des Exports nicht bekommst, ist eine fertige SEO-Anwendung mit deinen gewohnten Filtern, Vergleichen und Untersuchungs-Workflows über aktuelle und historische Daten hinweg.
Jemand muss entscheiden, wie diese Reports funktionieren, die Definitionen pflegen und Probleme lösen, wenn eine Zahl nicht zusammenpasst.
Googles Abfrage-Leitfaden weist außerdem darauf hin, dass exportierte Zeilen nicht zwingend konsolidiert sind, Metriken also entsprechend aggregiert werden müssen. Er liefert Berechnungen für CTR und Position, inklusive der für das Export-Schema erforderlichen Positionsanpassung.
Claude kann natürlich beim Schreiben von SQL helfen, aber die Query muss trotzdem geprüft werden. Eine fehlerhafte Berechnung, die erfolgreich gegen ein vollständiges Warehouse läuft, bleibt eine fehlerhafte Berechnung.
Wo SEO Stack und Claude zur stärkeren Kombination werden
SEO Stack verbindet verwaltetes Warehousing mit einer SEO-Oberfläche und einer MCP-Verbindung zu diesen gespeicherten Daten. Das veröffentlichte Angebot umfasst GSC, GA4 und AI-Visibility-Historie, zugänglich über die Anwendung oder programmatisch, wobei die Aufbewahrung vom Plan und von der tatsächlich angesammelten Historie abhängt.
Für den Nutzer bringt das aktuelles und älteres Reporting in dieselbe Arbeitsumgebung. Du kannst Claude eine Frage stellen und dann das relevante Segment in der Anwendung untersuchen, statt dich vollständig auf die geschriebene Erzählung zu verlassen.
Das ist ein erheblicher praktischer Vorteil. Wenn ich eine geschäftliche Empfehlung ausspreche, will ich die Zahlen prüfen, den Zeitraum ändern und die Interpretation hinterfragen können, ohne den Report anderswo neu bauen zu müssen.
Das Produkt macht außerdem eine Unterscheidung, die für AI-Workflows relevant ist: Es stellt vorbereitete Analysefunktionen über dem Warehouse bereit. Zu den veröffentlichten MCP-Tools gehören Zeitraumvergleiche, Query-und-Seiten-Gruppierung sowie URL-Segment-Analysen, mit serverseitig durchgeführten Berechnungen.
Statt das Modell zu bitten, einen Ordner-Vergleich aus zahllosen Rohdaten-Batches zusammenzusetzen, kann der Dienst den unterstützten Vergleich durchführen und das Ergebnis zurückgeben, damit Claude es erklärt.
Es gibt weniger Extraktionsarbeit, die der Agent koordinieren muss, und weniger Gelegenheiten, bei denen ein unvollständiger Batch klammheimlich zur Grundlage der finalen Antwort wird.
Was es tatsächlich bedeutet, deine Warehouse-Daten in einem Request zu bekommen
SEO Stack wirbt mit Zugriff auf aktuelle und im Warehouse gespeicherte GSC-Daten in einem einzigen MCP-Request, mit Abruf großer Ergebnismengen und serverseitiger Aggregation. Für eine unterstützte Warehouse-Abfrage kann das vermeiden, dass der Agent selbst durch Googles Live-API paginieren muss.
Die sinnvollste Interpretation ist: Ein Analyse-Request kann über den relevanten aufbewahrten Datensatz operieren, statt dass das LLM jeden zugrunde liegenden Datensatz einzeln lesen muss.
Ein Ordner-Vergleich kann zum Beispiel Veränderungen über eine sehr große Menge gespeicherter Zeilen berechnen und eine kompakte Tabelle mit Ordnern, Klicks und Differenzen zurückgeben. Claude kann mit dem Ergebnis arbeiten, während die Detaildatensätze für weitere Untersuchungen verfügbar bleiben.
Das ist ein deutlich vernünftigeres Ziel, als zehn Millionen Zeilen in einen Chat zu schieben und zu hoffen, dass das Modell sie korrekt durcharbeitet. Anthropics eigene Engineering-Guidance behandelt das Verarbeiten und Filtern von MCP-Ergebnissen außerhalb des Modellkontexts, um das Volumen zu reduzieren, das es verarbeiten muss.
Ein analytischer Request bedeutet auch nicht, dass jede Untersuchung mit einem einzigen Tool-Call abgeschlossen ist. Die Website identifizieren, verfügbare Daten prüfen, einen Vergleich abrufen und eine auffällige URL untersuchen – das kann legitimerweise mehrere Calls umfassen. Der Gewinn liegt darin, unnötige Extraktions- und Vorbereitungsarbeit zu vermeiden, nicht darin, sinnvolle Folgefragen zu verhindern.
Es gibt zwei weitere Einschränkungen, auf denen ich bestehen würde, unabhängig davon, für welches Produkt du dich entscheidest. Das Auslesen eines Warehouse hebt Beschränkungen nicht auf, die bereits die ursprüngliche Erfassung betroffen haben – und kein Anbieter kann Query-Strings wiederherstellen, die Google nie offengelegt hat. Außerdem muss die Aufbewahrung vorher stattgefunden haben, bevor du ältere Historie analysieren kannst: Der Kauf eines Zehn-Jahres-Aufbewahrungskontingents zaubert keine zehn Jahre vergangener Performance herbei.
Die drei Ansätze im Vergleich
Anforderung | Claude mit einem Live-GSC-API-Connector | Nativer BigQuery-Export mit AI-Workflow | SEO Stack mit Claude |
Fokussierte Performance-Fragen | Nützlich bei korrekt abgegrenzten Requests | Über Warehouse-Abfragen möglich | Über vorbereitete Tools unterstützt |
Erfassungsbeschränkungen | Unterliegt API-Limits und Connector-Verhalten | Nativer Bulk-Export umgeht die tägliche Zeilenbeschränkung der API | Hängt von der Erfassung ab, die das Warehouse speist |
Längere historische Analysen | Erfordert ein Archiv über die Live-GSC-Historie hinaus | Bewahrt erfasste Exporte gemäß deinen Einstellungen auf | Aufbewahrte Historie gemäß geltendem Plan |
Wiederverwendbare Analyseberechnungen | Hängt von der Connector-Implementierung ab | SQL- und Reporting-Logik selbst bauen oder übernehmen | Vorbereitete Vergleichs- und Gruppierungs-Tools |
Konsistente SEO-Oberfläche | Connector-abhängig | Reporting-Layer bauen oder konfigurieren | Enthaltene Anwendung neben MCP |
Ein Request über gespeicherte Historie | Erfordert einen separaten Archivdienst | Mit einem geeigneten Abfragetool möglich | Für unterstützte MCP-Abfragen beworben |
Verborgener Query-Text | Nicht wiederherstellbar | Wird vom Export nicht offengelegt | Aus nicht offengelegten Quelldaten nicht wiederherstellbar |
Das ist ein Vergleich einer reinen Live-API-Integration, Googles nativem Export und den veröffentlichten Fähigkeiten von SEO Stack. Ein ausgefeilter Custom Connector kann ebenfalls Caching, Warehousing und serverseitige Analysen enthalten – aber an diesem Punkt vergleichst du zwei vollständige Systeme statt einer direkten API-Verbindung mit einer verwalteten Plattform.
Die Fragen, die ich stellen würde, bevor ich der Antwort vertraue
Ob du nun SEO Stack, ein eigenes MCP oder einen BigQuery-Workflow nutzt – ich würde wollen, dass die Analyse ein paar Dinge klärt, bevor sie Empfehlungen ausspricht:
Welche Property, welcher Suchtyp, welche Zeiträume und welche Filter wurden verwendet?
Wird der vollständige aufbewahrte Datensatz für diesen Scope analysiert oder nur ein limitierter Extrakt?
Was ist das aktuellste verfügbare Datum, und gibt es Lücken in der gespeicherten Historie?
Bedeutet eine fehlende Query eine verifizierte Abwesenheit oder lediglich das Fehlen in diesem Extrakt?
Werden Summen auf derselben Aggregationsebene verglichen, wobei unbekannte Query-Aktivität separat gehalten wird?
Welche Belege stützen die Empfehlung, und welche weiteren Prüfungen würden sie verändern?
Das sind keine akademischen Details. Sie entscheiden darüber, ob eine Empfehlung eine Umsetzung verdient – besonders wenn es darum geht, Seiten zu entfernen, eine Website umzustrukturieren oder monatelanges Content-Budget zu binden.
Mir ist eine Antwort lieber, die eine Lücke einräumt, als eine wunderbar formulierte Erklärung, die stillschweigend so tut, als gäbe es die Lücke nicht.
Warum ich für diesen Workflow SEO Stack wählen würde
Eine einfache GSC-Integration ist ein guter Startpunkt für schnelle, klar umrissene Fragen. Wenn du die Fähigkeiten und Ressourcen hast, um rund um BigQuery ein Warehouse und ein Reporting-System zu bauen, kann das ebenfalls ein exzellenter Weg sein.
Für Teams, die eine aufbewahrte Suchhistorie, eine tatsächlich nutzbare Oberfläche und Claude mit vorbereiteten Analyse-Tools verbunden haben wollen, bringt SEO Stack diese Anforderungen zusammen. Du bleibst nicht mit einer funktionierenden AI-Verbindung und einer weiteren To-do-Liste zurück, bevor die Daten nutzbar werden.
Was mich daran anspricht, ist die Möglichkeit, eine Frage über die bereits gespeicherte Historie zu stellen, die unterstützte Berechnung zurückzubekommen und sie anschließend in der Anwendung zu prüfen. Das ist eine deutlich stärkere Grundlage für SEO-Entscheidungen, als eine selbstbewusste Einschätzung zu akzeptieren, ohne zu wissen, was das Modell überhaupt sehen durfte.
Verbinde Claude über SEO Stack's MCP, nutze das Warehouse und die dahinterliegenden Analysefunktionen – und behalte die Möglichkeit, die Antwort selbst zu hinterfragen. Die Verbindung ist nützlich; die Daten und die Art, wie du mit ihnen arbeitest, machen sie erst wertvoll.
Quellen
Recherche geprüft am 23. Oktober 2026. Google- und Anthropic-Quellen dokumentieren das Plattformverhalten. SEO-Stack-Quellen beschreiben die veröffentlichten Fähigkeiten des Produkts, nicht einen unabhängig gebenchmarkten Integrationstest.
1. Anthropic Custom Connectors über Remote MCP
2. Google Search Console API – Nutzungslimits
3. Google Search Analytics Query-Referenz
4. Google – Filterung und Limits von Performance-Daten
5. Google-Leitfaden zum Abruf von Performance-Daten
6. Google stellt die neue Search Console und 16 Monate Performance-Daten vor
7. Google – Ankündigung des nativen Bulk-Data-Exports
8. Google Bulk-Export – Übersicht und Referenz der Export-Tabellen
9. Google Bulk-Data-Export – Einrichtung
10. Google – Richtlinien und Berechnungen für Export-Abfragen
11. SEO Stack Data Warehousing und Vergleich mit BigQuery

Gründer, SEO Stack
Daniel ist der Gründer von SEO Stack. Er arbeitet seit über 2 Jahrzehnten an technischem SEO und Suchdaten und hat SEO Stack entwickelt, nachdem er in der Kundenarbeit einmal zu oft an dieselben Search-Console-Limits gestoßen war.
Daniel verfügt über umfangreiche SEO-Erfahrung: Er hat SEO-Agenturen, Audit-Unternehmen und eine erfolgreiche Beratung aufgebaut. In seiner Freizeit führt Daniel gerne SEO-Experimente durch und teilt seine Erkenntnisse.
Veröffentlicht 24. Oktober 2026

