如何查看已不再被 Google 索引的页面的流量——GSC 中的页面未编入索引原因
Google Search Console 会告诉你哪些页面没有被收录,但当你在排查流量下滑时,每个收录状态下的 URL 数量能说明的问题有限。那些

Google Search Console 会告诉你哪些页面没有被收录,但当你在排查流量下滑时,每个未收录原因下的 URL 数量能提供的信息其实很有限。
这些 URL 在点击量或展示量上究竟贡献了多少?
我们都在 GSC 里见过:进入 indexing > pages,可以看到各种未收录原因以及部分 URL 示例,但这些 URL 在过去一段时间里到底贡献了多少呢?
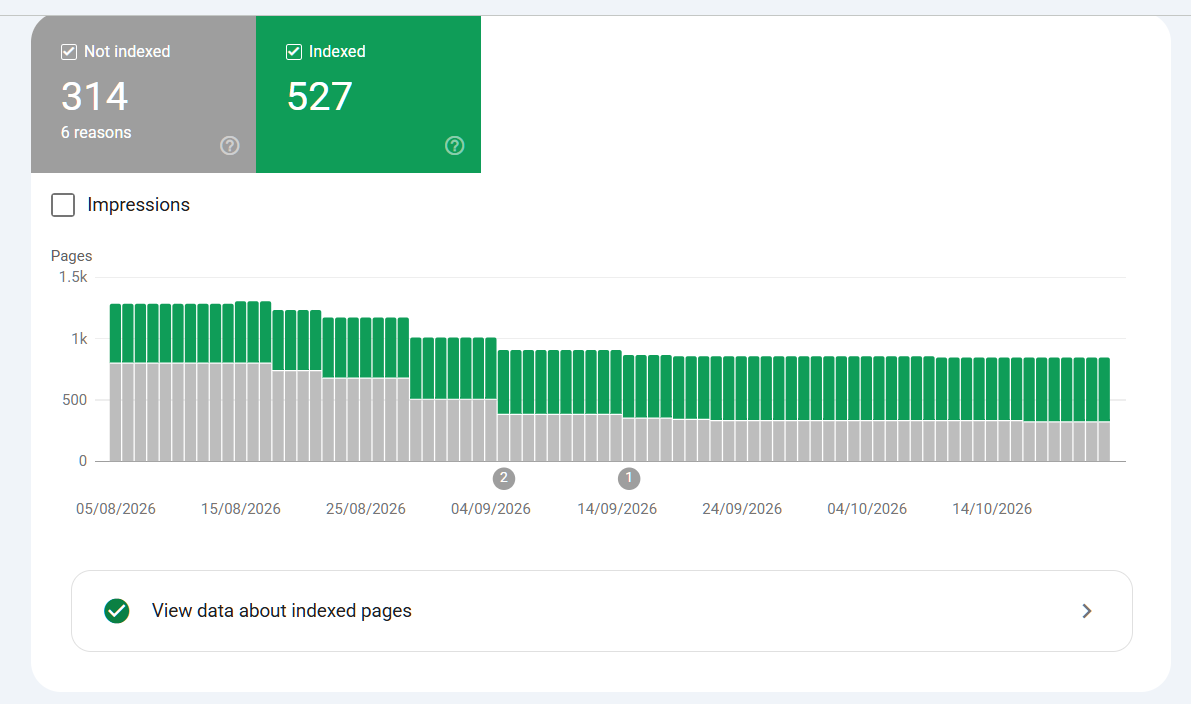
这些未收录页面原因中的 URL 是否带来过点击?它们是否在相关搜索中有排名?是商业上重要的页面消失了,还是你看到的只是一些旧参数、重复 URL 以及本来就不该被收录的页面?
你会惊讶于有多少点击流失在那些仍然有效、但已不再被收录的 URL 上 —
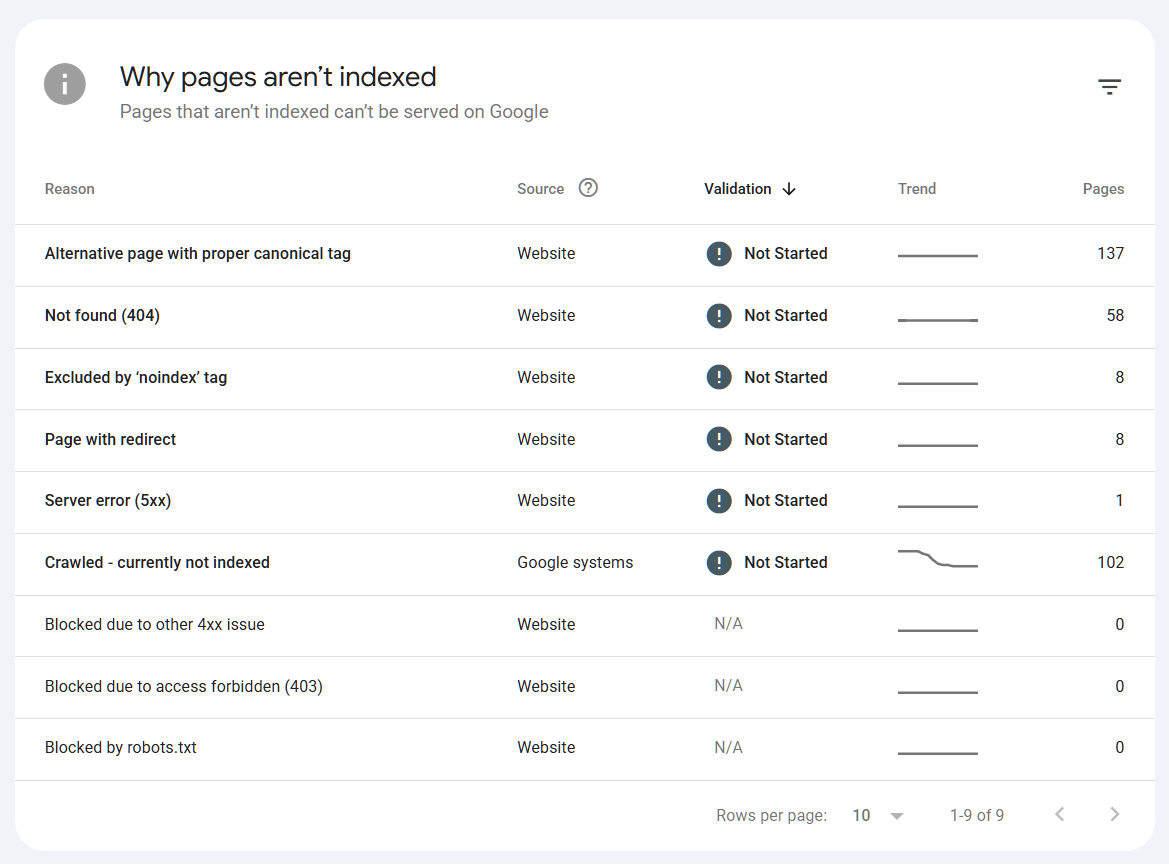
不过,你常常会发现 NOT FOUND 的 URL 是一座“历史”点击的宝库,这些点击因为客户/公司里某个人删除了 URL 而流失。
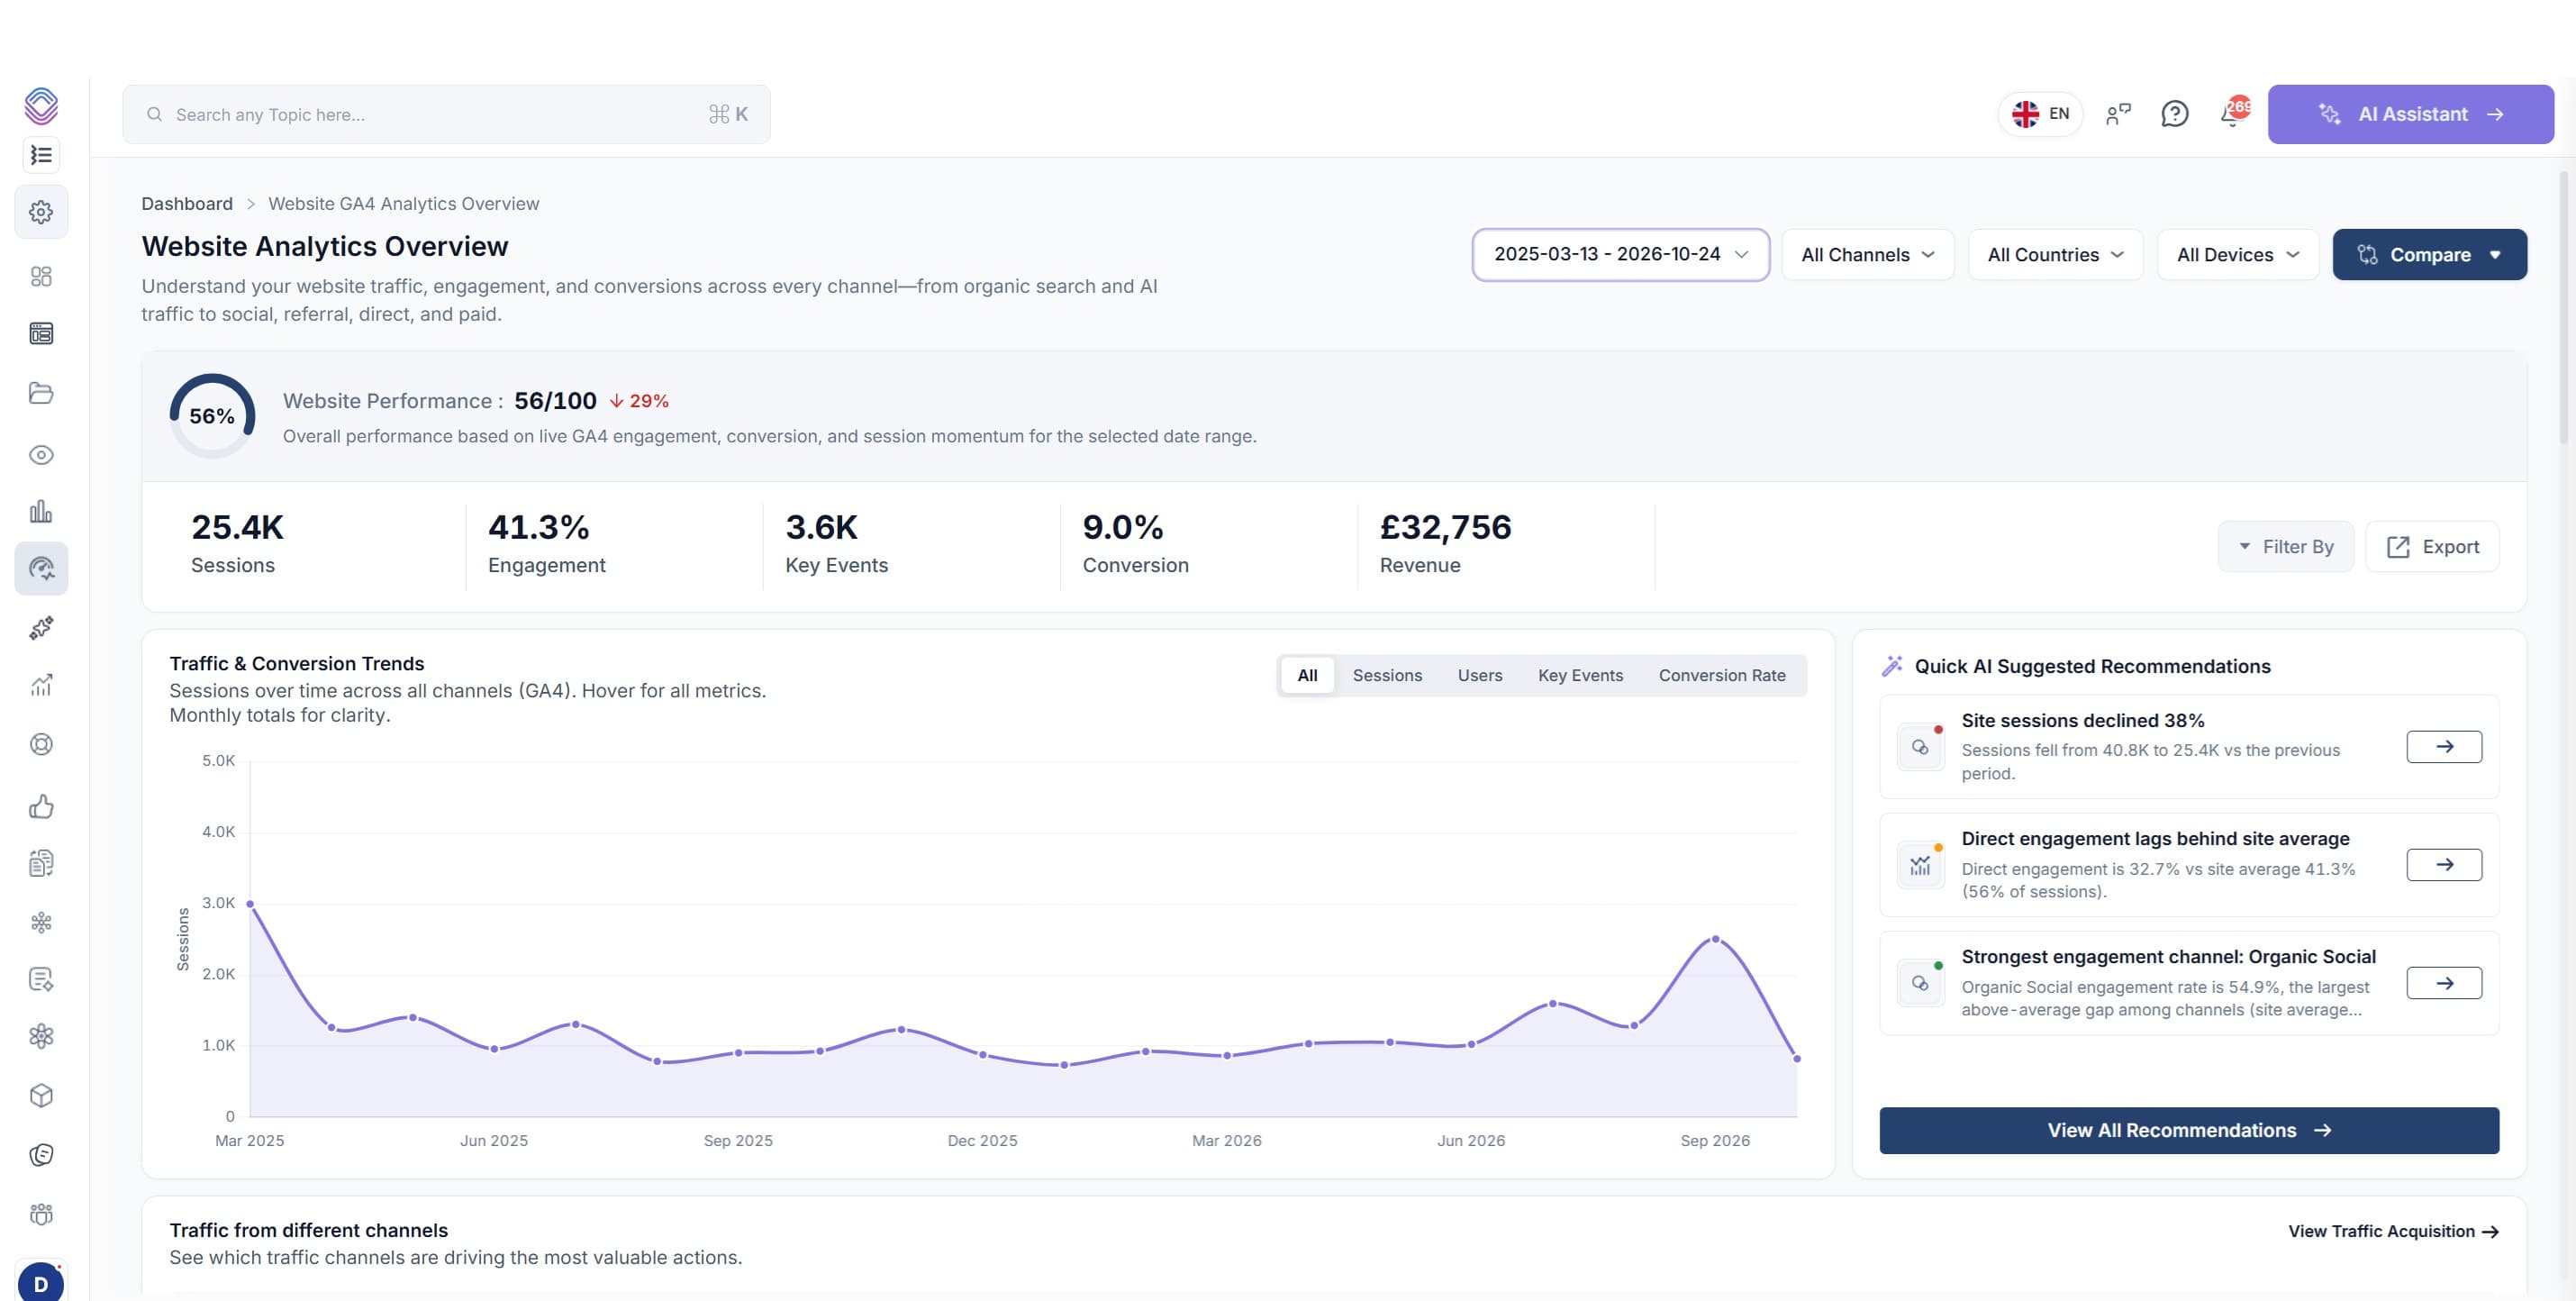
我们在一次审计中分析了一个客户网站,发现他们 12% 的点击仅仅因为删除内容却没有做相应跳转而流失!下面你看到的是 727 个 not found URL 的真实数据,其中 400 个 URL 产生过 1 次或更多点击。
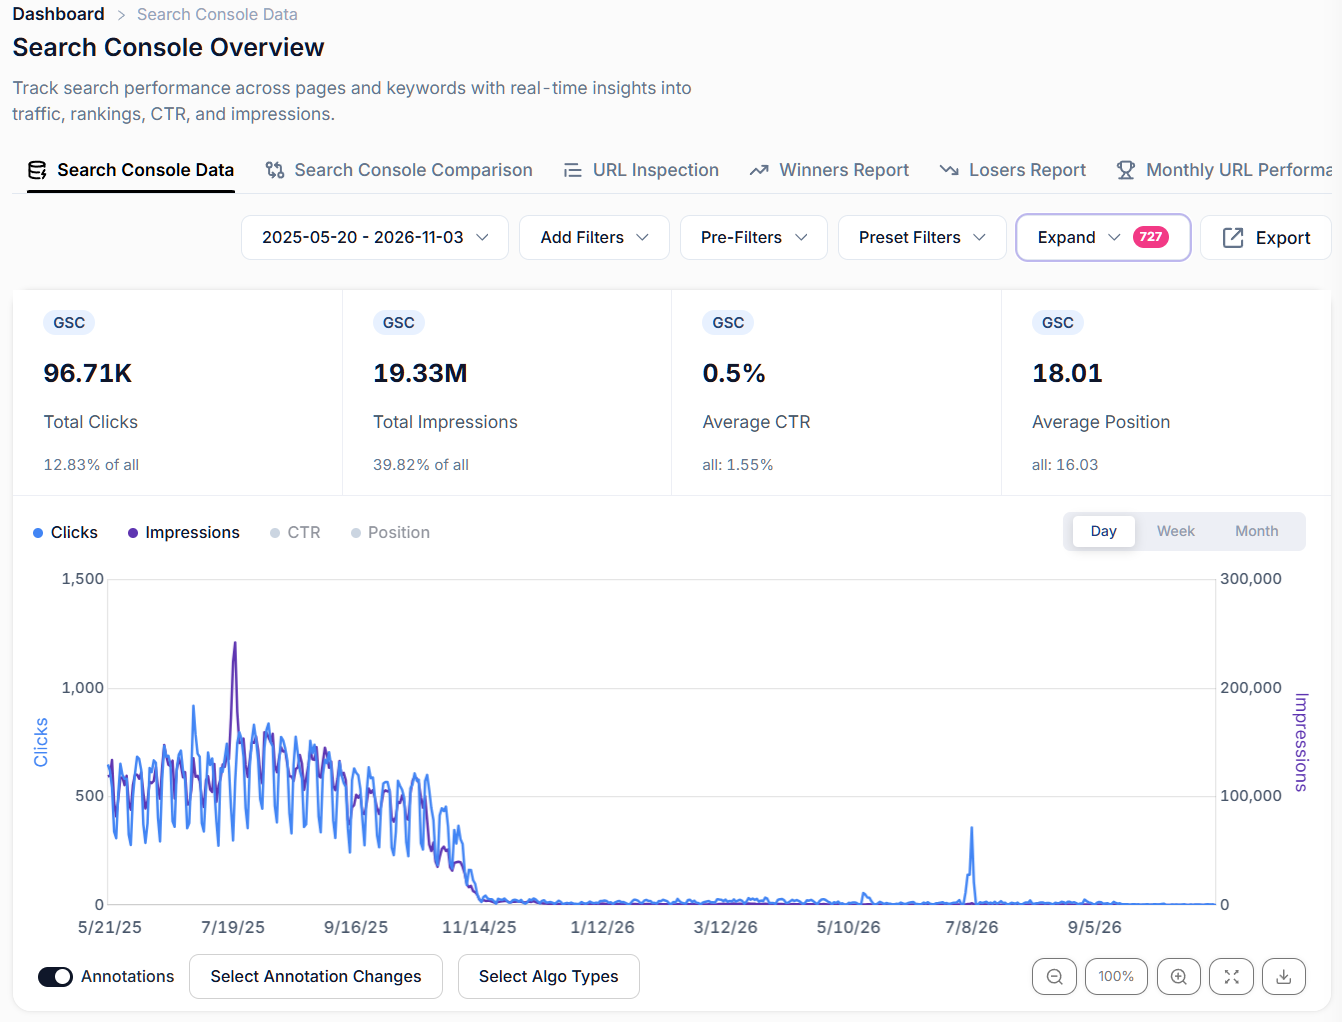
如果你只看他们的 GSC 数据,你会看到这样的情况 >
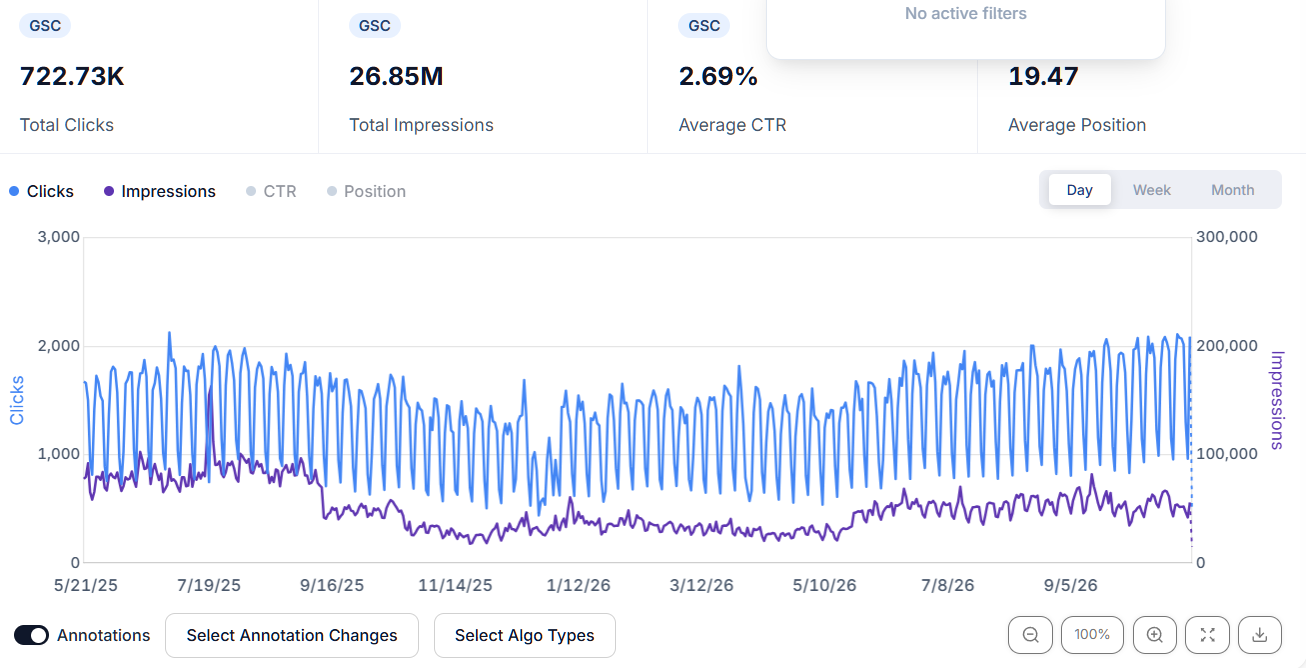
注意到那个下滑了吗?
这是通过分析客户所有未收录页面原因带来的点击损失,快速且轻松地发现的。
这里有一点需要说明:500 个毫无贡献的被排除 URL,和 5 个曾经带来点击、展示和新业务的已删除页面,二者的差别非常大!
使用 SEO Stack,你可以把每个未收录页面原因下的 URL 取出来,作为批量精确匹配筛选条件应用,查看它们的历史搜索表现。然后你可以把每组保存到自定义筛选文件夹中,这样在不同收录原因之间切换时,就不用每次都重新导出和粘贴。
下面介绍具体做法、需要关注什么,以及如何用这些数据判断哪些问题真正值得你花时间处理。
为什么要查看未收录页面的历史表现?
一个页面现在没有被收录,并不意味着它从未被收录过,或从未带来过流量。
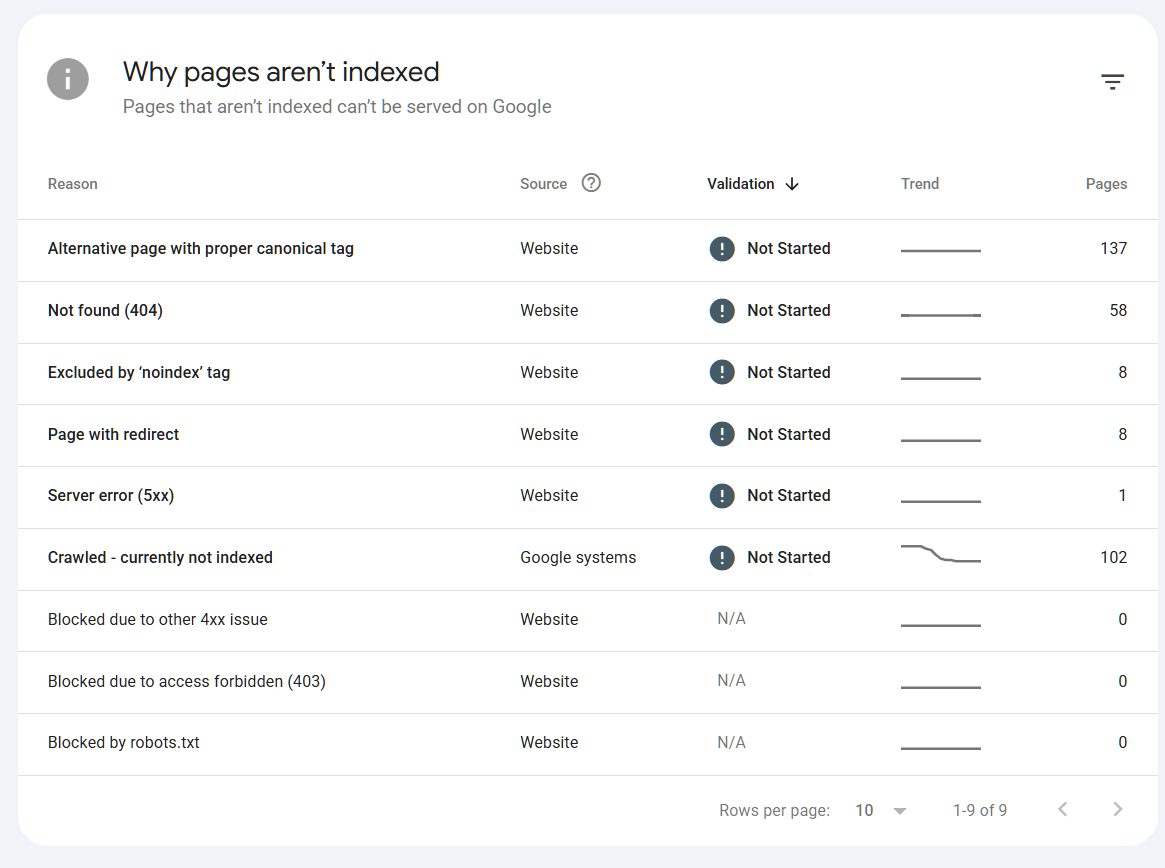
一个被删除的分类页可能多年来一直在带来点击;一组因误加 noindex 指令而受影响的 URL,此前可能贡献了相当比例的自然流量(一段时间内的点击和展示)。现在做了跳转的页面,可能在迁移前表现很好,而替代页面却没能接住同样的可见度——或者根本没有恢复。
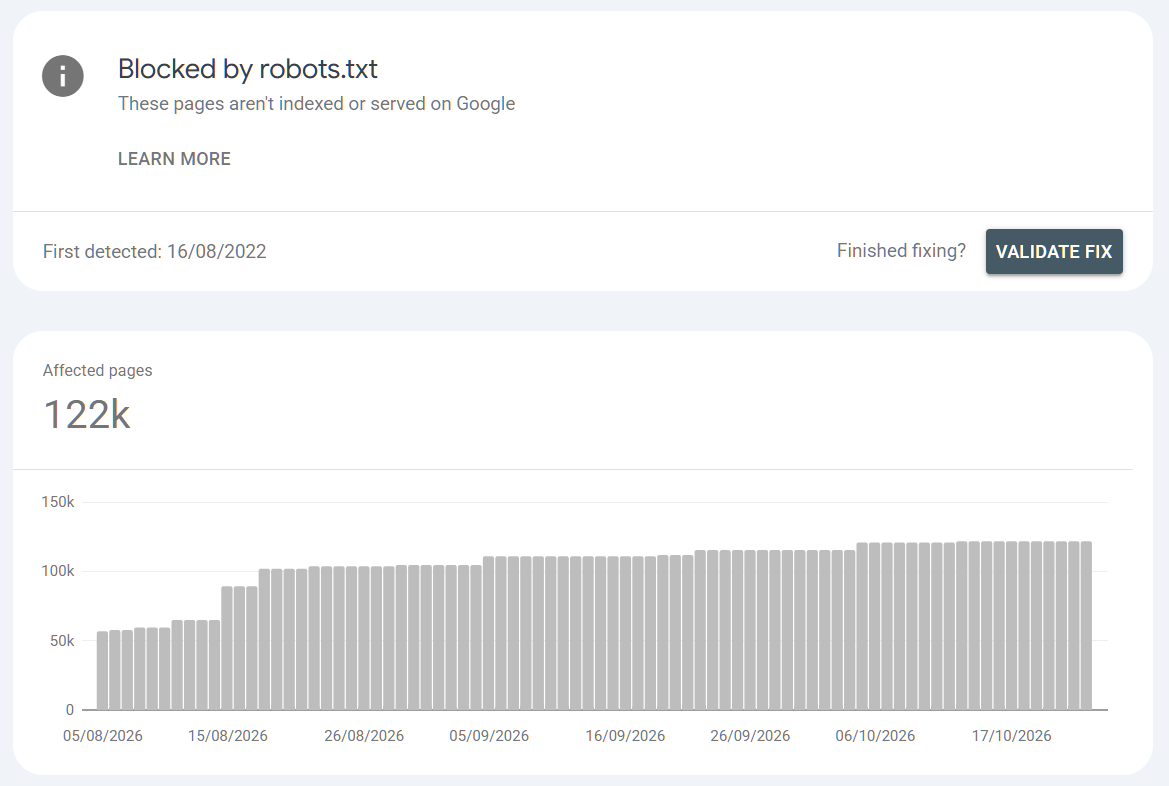
这些情况我们都见过,我们甚至见过客户错误地配置 robots.txt 指令,他们看到被屏蔽的 URL 大量增加,却没意识到这对点击和展示的损害——这种事确实会发生,而且并不罕见!
同样地,对于某些未收录页面原因,你可能会发现整个排除分组几乎没有任何贡献。
这同样很有价值,它能帮你避免花费数小时去“修复”那些本来就没有明确理由被收录的 URL。
目的是把收录原因和实际表现关联起来,这样你就能根据这些 URL 过去做了什么、现在应该做什么来确定工作优先级。
你的目标并不是让每个 URL 都进入 Google 索引。跳转页、重复页和有意排除的页面,本来就应该在索引之外。Google 自己的指南也做了这样的区分:一个未被收录的 URL 并不自动等于错误。
第 1 步:在 Google Search Console 中打开页面收录报告
选择你要排查的资源,然后进入:
Indexing → Pages → Examples
你会看到 Google 报告的各种原因,以及受影响的 URL 数量。
点击进入你想优先分析的原因。例如:
Crawled – currently not indexed(已抓取 — 当前未编入索引)
Not found (404)(未找到 404)
Alternate page with proper canonical tag(带有适当规范标记的备用网页)
Page with redirect(网页会重定向)
Excluded by ‘noindex’ tag(被“noindex”标记排除)
请注意,页面未被收录的原因可能有很多种!
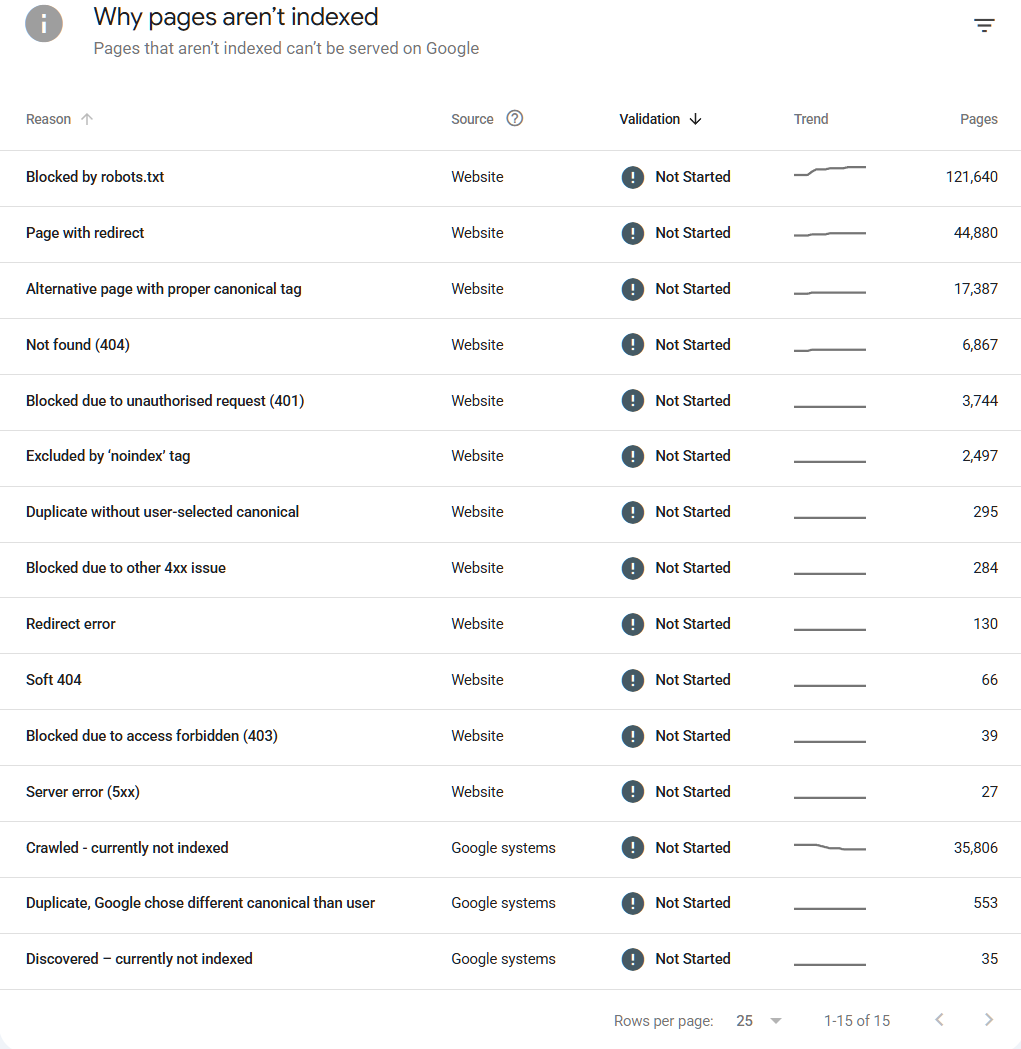
从与你排查目标最相关的分组开始。如果流量是在网站重建后下滑的,那么 404 和重定向分组显然是首先要看的地方。如果重要的在线页面似乎正在从搜索结果中消失,那就从这些页面被报告的收录原因入手。
请记住,报告中提供的 URL 示例是有限的。在较大的网站上,你导出的内容可能只是该原因下受影响分组的一部分,而不是计入该原因的全部 URL。
第 2 步:导出 URL 并复制 URL 列
在所选的收录原因内,点击 Export(右上角)
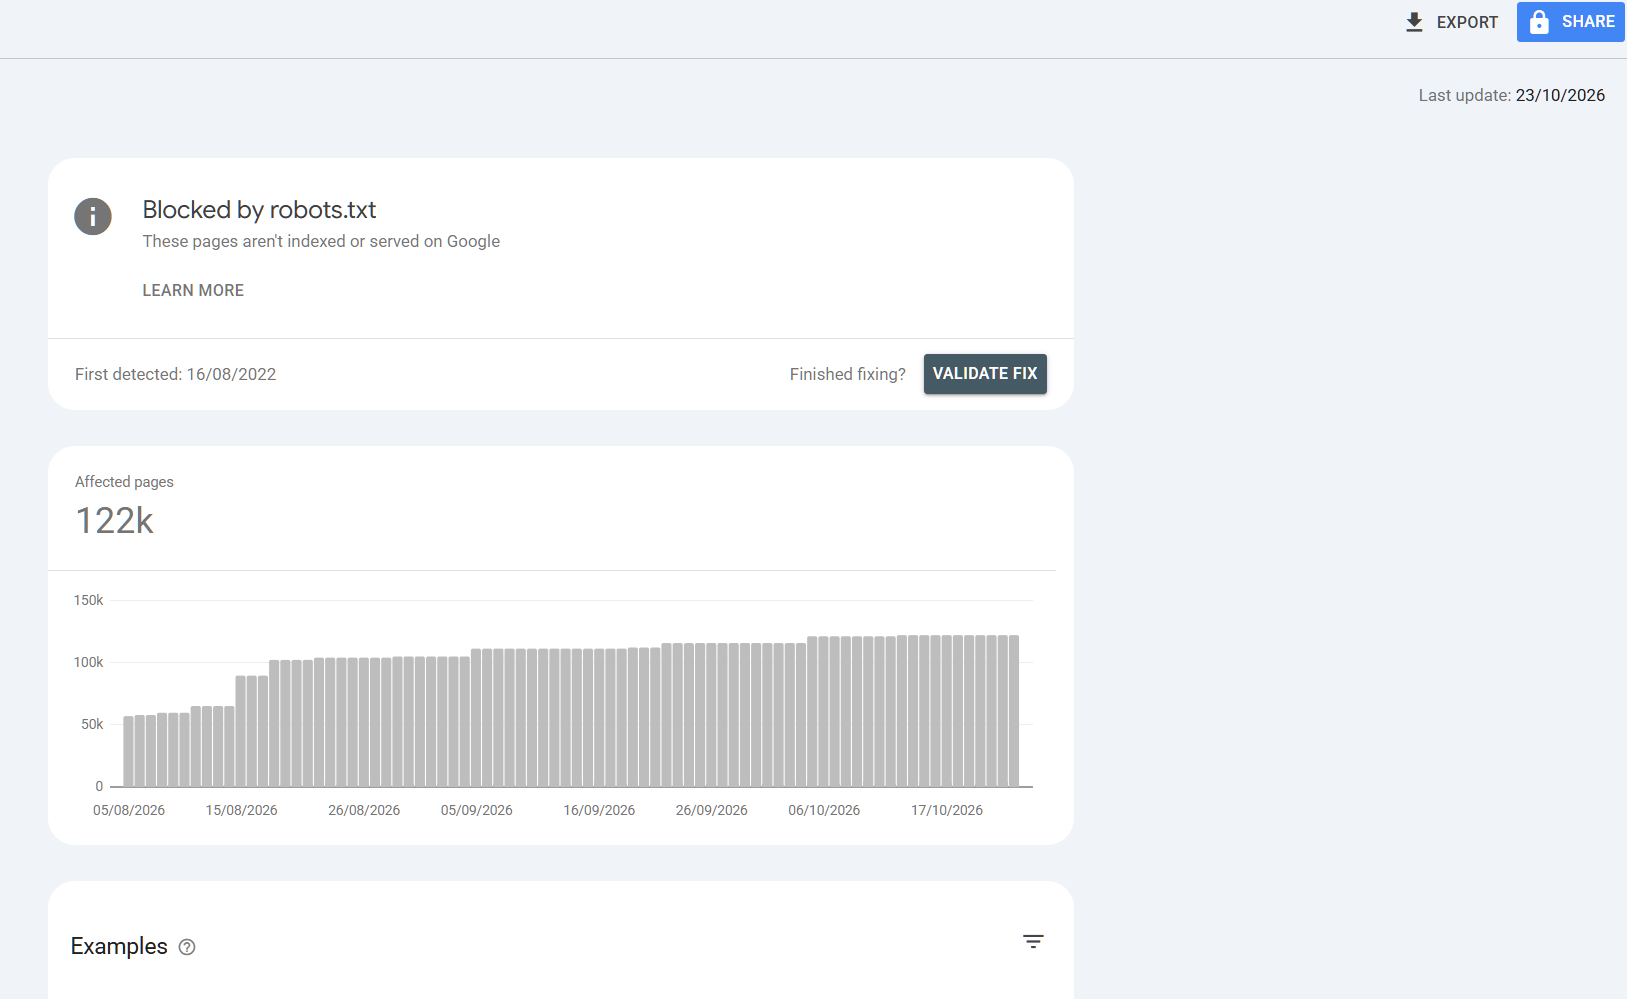
你可以导出到 Google Sheets 或下载 CSV,打开导出文件并复制 URL 列中的网址。
只复制 URL 本身,不要包含列标题和最后抓取日期。保持每行一个 URL,你可以选中整列(跳过第一行)
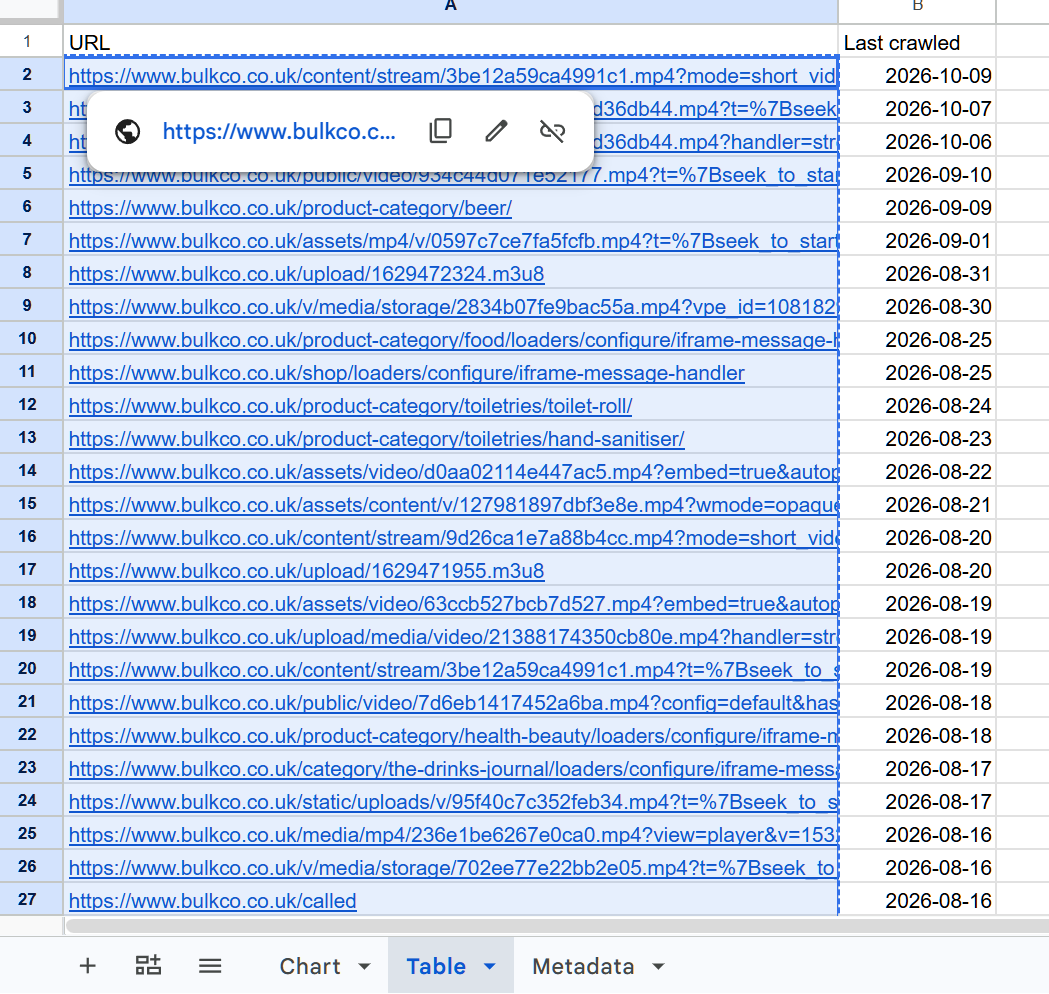
使用导出时的完整 URL,包括参数和结尾斜杠。你接下来要匹配的是具体的 URL,改动它们会改变筛选结果。
同时也值得检查一下你实际导出了什么内容:一份既包含真实产品分类,又混杂媒体文件、参数和奇怪的生成路径的列表,需要你做一些判断。
大多数情况下,选取前 1000 个 URL 并复制到剪贴板即可。
第 3 步:在 SEO Stack 中打开 Search Console Data
在 SEO Stack 中进入同一个网站资源,打开 Search Console Data。
选择你想要排查的日期范围。
对于这项工作,先从你账户中可用的最长相关时间段开始,在 SEO Stack 中这被称为 first data point(首个数据点)。像最近 28 天这样的短时间范围,对一个很久之前就停止产生点击的页面几乎说明不了什么,我建议直接选择 first data point 以获得最大时间跨度:
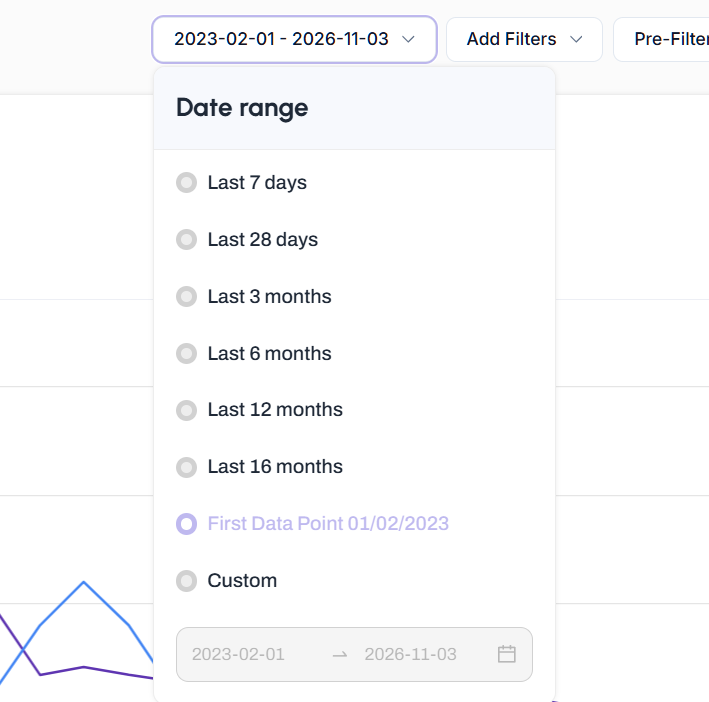
更长的历史数据能让你看出这些 URL 此前是否有表现、它们的可见度是否逐步下滑,以及是否存在一个点击明显消失的时间节点。
可用的历史数据取决于该资源保留的数据量。延长日期范围并不能重建那些从未被存储的历史数据。
第 4 步:使用 SHOULD → EXACT 添加批量 PAGES 筛选条件
点击 Add Filters,然后选择 Page。
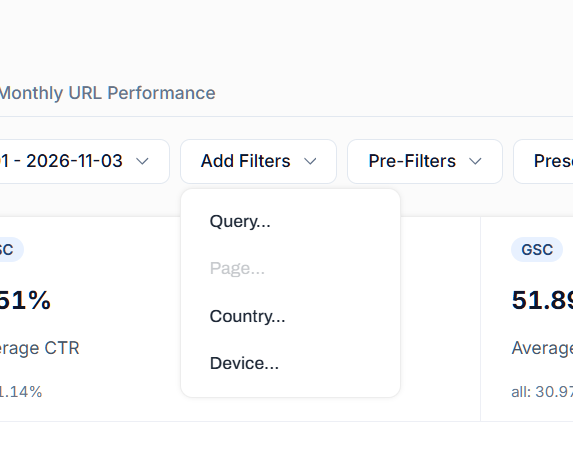
将筛选条件设置为:
设置项 | 选择 |
|---|---|
筛选维度 | Page / PAGES |
运算符 | SHOULD |
匹配类型 | EXACT |
批量 | 启用 |
将复制的 URL 粘贴到文本框中,每行一个 URL,然后点击 Apply。
效果应该是这样的(如果需要,可以关闭区分大小写)
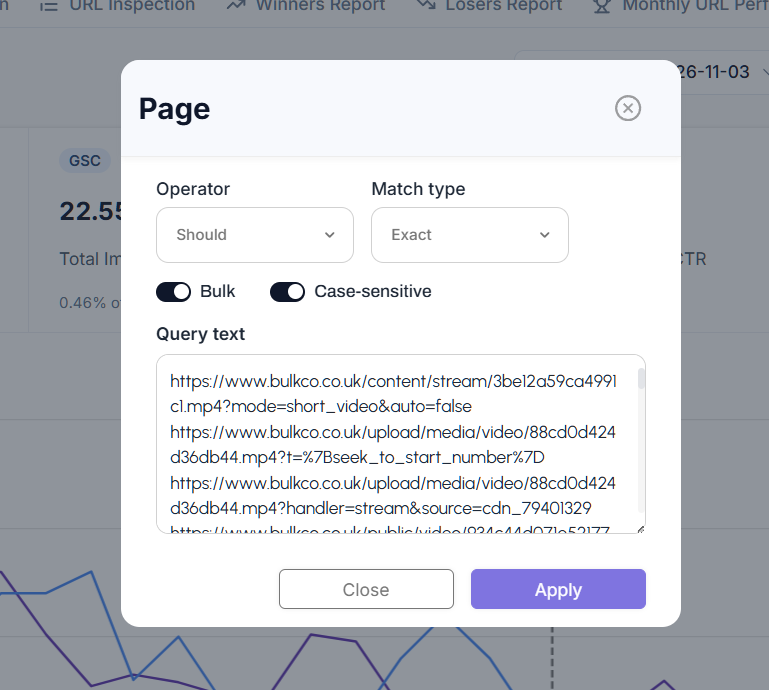
SHOULD → EXACT 是关键所在。
SHOULD 允许结果匹配列表中的任意一个 URL,EXACT 则表示必须精确匹配某个具体的 URL 值,而不是仅仅包含其中一部分。
所以,如果你粘贴了 100 个 URL,就是在要求 SEO Stack 返回 URL 一 或 URL 二 或 URL 三的表现数据,依此类推。
你并不是要求某个页面同时匹配全部 100 个 URL。
你也不是在使用宽泛的「包含」筛选,那可能会把共用同一路径的其他页面也拉进来。
如果你的网站使用的 URL 路径对字母大小写敏感,请检查区分大小写的设置,并清除任何可能无意中限制结果的无关筛选条件。
第 5 步:查看该分组的历史表现
应用筛选后,图表和指标会显示匹配 URL 的可用表现数据。
重点关注:
总点击量和展现量。
所选时间段内这些页面占整体点击量的比例。
表现随时间的变化情况。
哪些具体页面有数据记录。
哪些查询词带来了可见度和点击。
在视频示例中,归入 Crawled – currently not indexed 的那组 URL 录得 115 次点击和约 22,550 次展现,占所选时间段内全部点击的 0.21%。
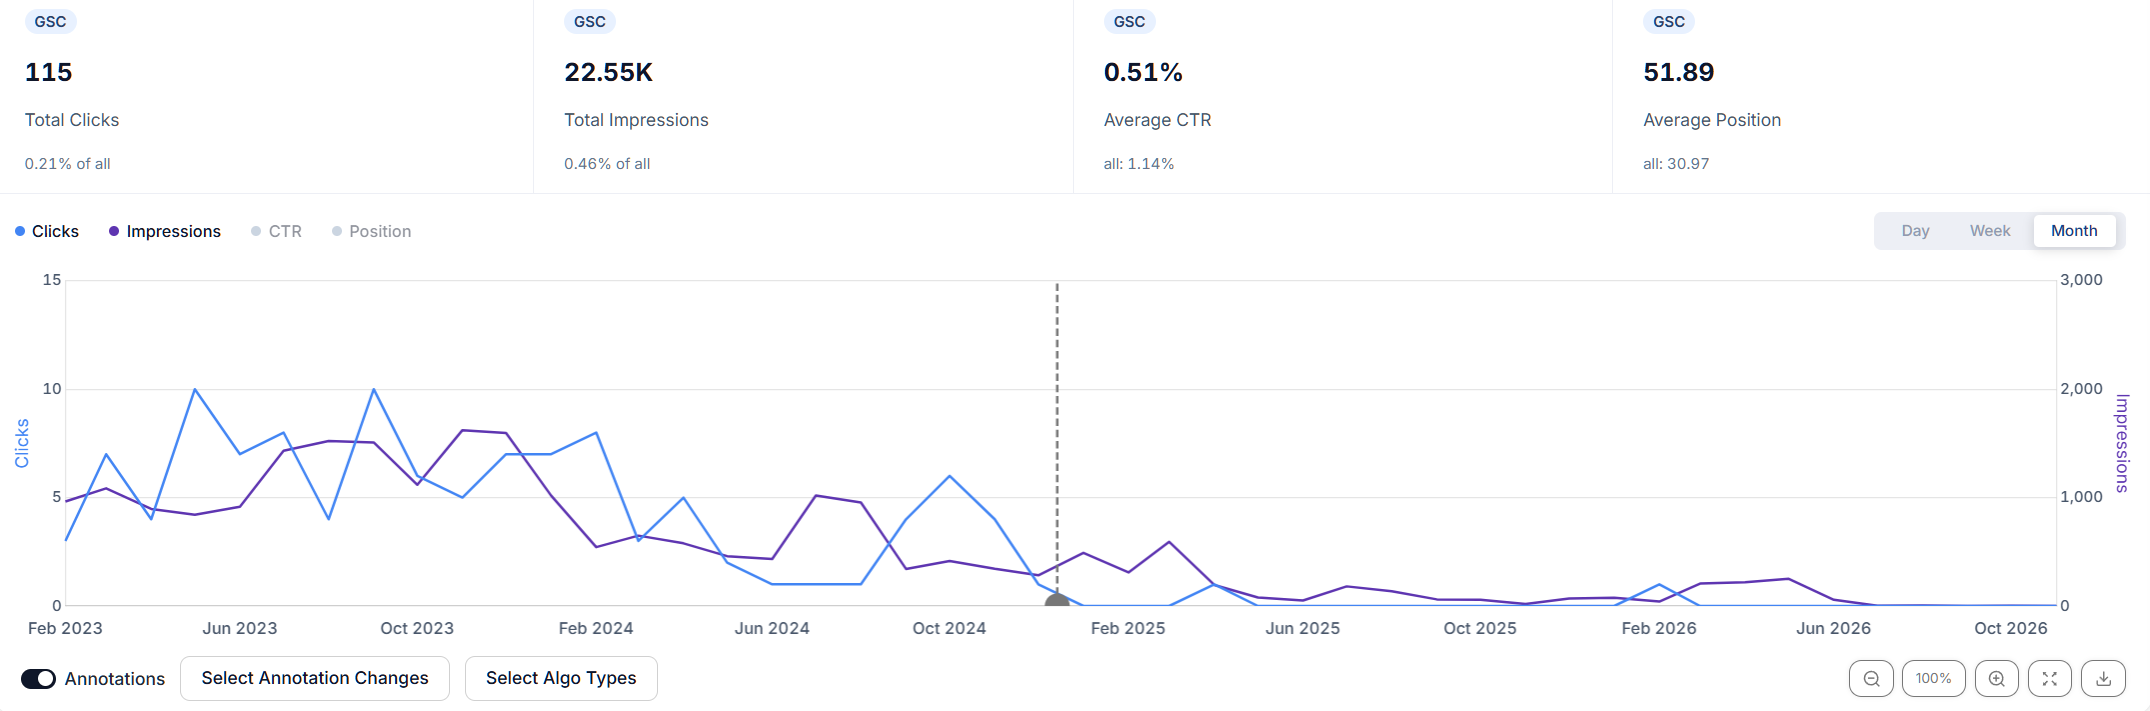
图表显示,它们的点击活动大多集中在时间轴的早期,后期非常少。
这比单纯统计被排除的 URL 数量有用得多。我们可以看到,这一组的历史贡献相对较小,然后再去调查其中是否有个别页面值得关注。
这并不意味着网站因为该索引原因损失了当前流量的 0.21%。
这个百分比描述的是该分组在所选日期范围内录得的贡献。它不是对可恢复流量的测算,图表本身也无法说明表现下滑的原因。
你是把今天导出的 URL 列表套用到历史表现数据上。你并没有重建每个 URL 在历史上每一天的索引状态。
第 6 步:将分组保存到自定义筛选文件夹
应用筛选后,把它保存为预设。
创建一个名称清晰的文件夹,例如:
GSC Non Indexed Reasons
然后用对应的原因保存当前筛选:
Crawled – currently not indexed
对其他分组重复该流程。导出下一个原因,复制其 URL,替换现有的页面筛选,并保存到同一个文件夹中。
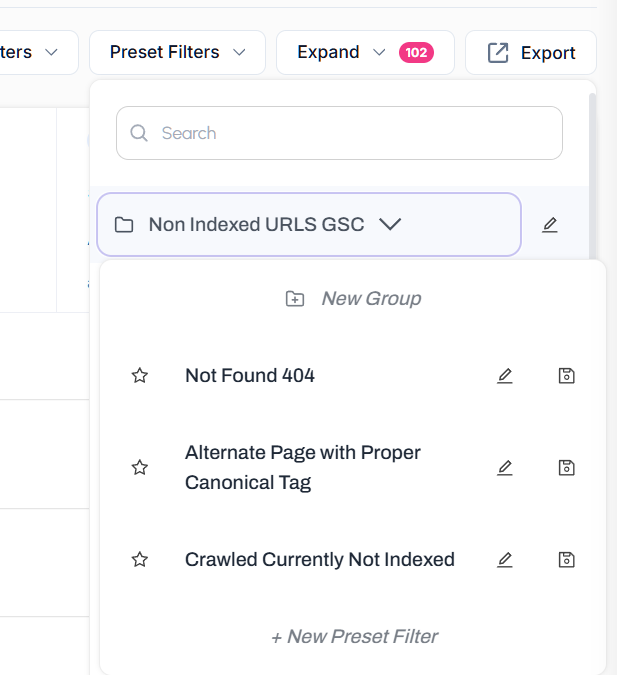
你的文件夹里可能包含:
Crawled – currently not indexed
Discovered – currently not indexed
Not found (404)
Alternate page with proper canonical tag
Page with redirect
Excluded by 'noindex' tag
之后你就可以在 Preset Filters 中切换这些分组,无需重复设置即可调出它们的表现数据。
这些保存的是 URL 列表。如果你希望它们反映最新的 GSC 排除情况,就要在这些分组发生变化时刷新导出并更新筛选。在筛选名称中加上导出日期,也有助于保留某个特定的快照。
如何从结果中发掘机会
找出曾经带来流量的已删除页面
当网站在页面被删除后流量下滑时,404 分组尤其有用。
应用这些 URL,打开 Pages 标签页,寻找过去的表现优异者。然后查看这些页面是什么内容、它们曾在哪些搜索中出现,以及网站是否仍在满足那部分需求。
如果某个有用的分类被误删,恢复它可能是合理的。如果它被迁移了,检查是否应该重定向到替代页面。如果内容已永久下线且没有相关替代内容,返回 404 可能完全恰当。
不要为了清空报告就把所有页面都重定向到首页。
检查替代页面是否承接了流量
旧 URL 在重定向后失去点击,本身并不能证明迁移失败。
也要看目标页面。
它们是否在相同的搜索中获得了可见度?它们是否是相关的替代内容?是不是旧 URL 已停止产出,而新 URL 贡献又很少?
对比两端有助于你找出哪些迁移或内容整合需要进一步审视。
在嘈杂的分组中找出重要的在线页面
一个庞大的排除分组里可能包含大量你并不在意的 URL,以及少数你非常在意的 URL。
历史点击有助于浮现出过去的表现优异者。展现量和查询词也能揭示那些从未转化为多少点击的相关可见度。
然后评估页面本身。它们有用吗?它们是否服务于独立的搜索意图?它们有内部链接吗?Google 能否访问其主体内容?它们是否应该被索引?
一个页面不必有点击历史才值得调查。新的商业页面本来就还没有这类历史。
区分影响不大的清理工作和真正重要的工作
如果某个分组由过时 URL 构成,没有相关的历史表现,也没有被内部链接或收录进站点地图,那么可能几乎没有什么需要处理的。
这对审计或与客户沟通来说是个有用的结论。
你可以说明哪些排除看起来是有意为之,哪些需要观察,哪些影响到了具有明确商业目的的页面。
不过,「没有点击记录」需要结合上下文看待。在断定某个 URL 从未产生任何贡献之前,先检查日期范围、URL 匹配方式和规范化目标页面。Google 通常会把表现数据归属到规范 URL,这会导致重复 URL 自身几乎没有数据。
如何针对每种未索引原因使用此方法
同样的筛选流程适用于各种原因。变化的是你向结果提出的问题。
未索引原因 | 需要调查什么 |
|---|---|
Crawled – currently not indexed | 找出有历史点击或相关展现的有用在线页面。审查它们的内容、渲染输出、重复情况、内部链接和预期用途。仅凭这个标签无法断定存在内容质量问题。 |
Discovered – currently not indexed | 识别需要调查的重要 URL,尤其是新的商业页面。审查可发现性、内部链接、站点地图和服务器行为。不要指望每个新发现的 URL 都有历史表现数据。 |
Not found (404) | 找出曾经带来流量的页面。确定它们应当被恢复、重定向到相关替代页面,还是保持移除状态。检查内部链接和站点地图中需要更新的引用。 |
Soft 404 | 审查有价值的页面是否存在内容缺失、模板为空或类似错误的输出。决定它们应当提供一个有用的在线页面,还是返回恰当的移除响应。 |
Page with redirect | 将旧 URL 的表现与其目标页面进行对比。在替代页面未承接到相关流量的地方,调查可见度的损失。 |
Redirect error | 优先处理受影响的有价值 URL,检查重定向路径是否存在循环、目标失效或链条过长的问题。 |
Alternate page with proper canonical tag | 检查目标规范页面的表现。如果整合方式正确且首选页面表现良好,备用 URL 通常无需做恢复工作。 |
Duplicate without user-selected canonical | 审查应由哪个版本代表该内容。对比各变体的表现,并统一规范化信号、内部链接和站点地图 URL。 |
Duplicate, Google chose different canonical than user | 将你指定的首选 URL 与 Google 选择的版本进行对比。调查重要内容是否被整合到了不合适的页面上。 |
Excluded by 'noindex' tag | 区分有意排除和误操作排除。当模板或部署可能无意中引入了 noindex 时,过去的表现优异者是值得优先处理的对象。 |
Blocked by robots.txt | 检查有价值的公开页面是否被误屏蔽。审查受影响的路径和当前的抓取规则。 |
Server error (5xx) | 识别受影响的商业页面和过去的表现优异者,然后用当前的检测手段和服务器日志调查可用性。 |
Blocked due to unauthorised request (401) | 确定身份验证是否是有意设置的。调查那些本应无需登录即可访问的公开页面。 |
Blocked due to access forbidden (403) | 检查安全规则、防火墙设置或权限配置是否阻止了对重要公开页面的访问。 |
Blocked due to other 4xx issue | 确认返回的是哪种响应并调查原因,优先处理有用的页面和过去的表现优异者。 |
将索引原因与当前的检查结合起来看。例如,Google 把重定向错误与普通的重定向页面分开记录,而 robots.txt 屏蔽属于抓取限制,并不是把某个 URL 移出搜索结果的可靠方式。
用 AI Assistant 分析筛选出的 URL
你也可以让 SEO Stack 的 AI Assistant 协助调查这些 URL 及其可用的表现数据。
给它一个明确的任务,例如:
分析这些来自 GSC“已抓取 – 尚未编入索引”导出的 URL。找出哪些此前带来的点击最多、表现在何时开始下滑,以及哪些报告中的查询词有贡献。把数据显示的事实与可能的解释区分开,并标注出需要进一步检查的地方。
对于 404 导出:
检查这些 404 URL,找出此前表现最好的页面。列出它们的历史点击、展示次数和相关查询词,然后列出需要做哪些检查,以判断恢复页面还是做相关重定向更合适。
这能为调查提供一个起点。在决定做哪些改动之前,你仍然需要检查当前的页面、替代页面和技术设置。
这些能直接在 Google Search Console 里完成吗?
你可以在 GSC 中逐个调查 URL,用正则匹配一组页面,或者导出表现数据后在电子表格里与排除清单做关联。
所以做出类似的分析是可行的。GSC 支持用正则筛选多个 URL,不过要写出精确匹配的表达式,需要做好转义并加上定位符。
SEO Stack 让这个流程快得多:复制导出的 URL,应用 PAGES → SHOULD → EXACT,查看它们的表现,并把这个分组保存下来以便复用。
在排查下滑时,这让你不再停留在“Google 没有收录这些页面”,而是开始追问:哪些 URL 真正重要、发生了什么变化,以及在哪里存在值得去恢复可见度的机会。

SEO Stack 创始人
Daniel 是 SEO Stack 的创始人。他在技术 SEO 和搜索数据领域深耕二十余年,在客户项目中一次又一次撞上 Search Console 的同样限制后,他着手打造了 SEO Stack。
Daniel 拥有丰富的 SEO 经验,创办过 SEO 代理机构、审计业务以及一家发展良好的咨询公司。业余时间里,Daniel 喜欢做 SEO 实验并分享实验结果。
发布于 2026年11月3日