用 AI 技能与工作流实现 SEO 工作流自动化
你肯定在社交媒体上刷到过这些吧?它们简直无处不在!但是,拿到一套 agent kit 固然不错,可要真正做好 AI SEO,你需要的是一整套完整的基础设施
在你开始读这篇文章之前,我不希望你觉得它啰嗦或冗长,这篇文章的目的是帮助你自动化 SEO 工作流——给你的 AI AGENT 或 AI 平台配备相关的 SEO Stack 技能来执行 SEO,并利用学习/递归学习来改善从分析、审计到落地实施的 SEO 成果。
简单来说,读完这篇文章,你将:
能够搭建并部署你的第一个 AI SEO Agent(如果你还没有的话)
能够下载并安装这些技能(给你的 AI agent 或 LLM,例如 Claude、ChatGPT)
创建必要的工作流和 cron 任务来自动化 SEO/分析/报告
赋予 agent 直接在网站上实施改动的能力,并记录所做的工作以实现自我学习/递归 SEO
你能从中获得什么?
加快分析、审计、SEO 分析、竞争对手分析的速度
部署自主运行的 SEO 活动——非常适合小型站点、兴趣站点、排名出租(rank and rent)
节省时间、金钱,并扩大 SEO 产出规模
把 AI 用于分析、创作、产出、部署和报告
继续往下读,值得!
你肯定在社交媒体上刷到过这些吧?
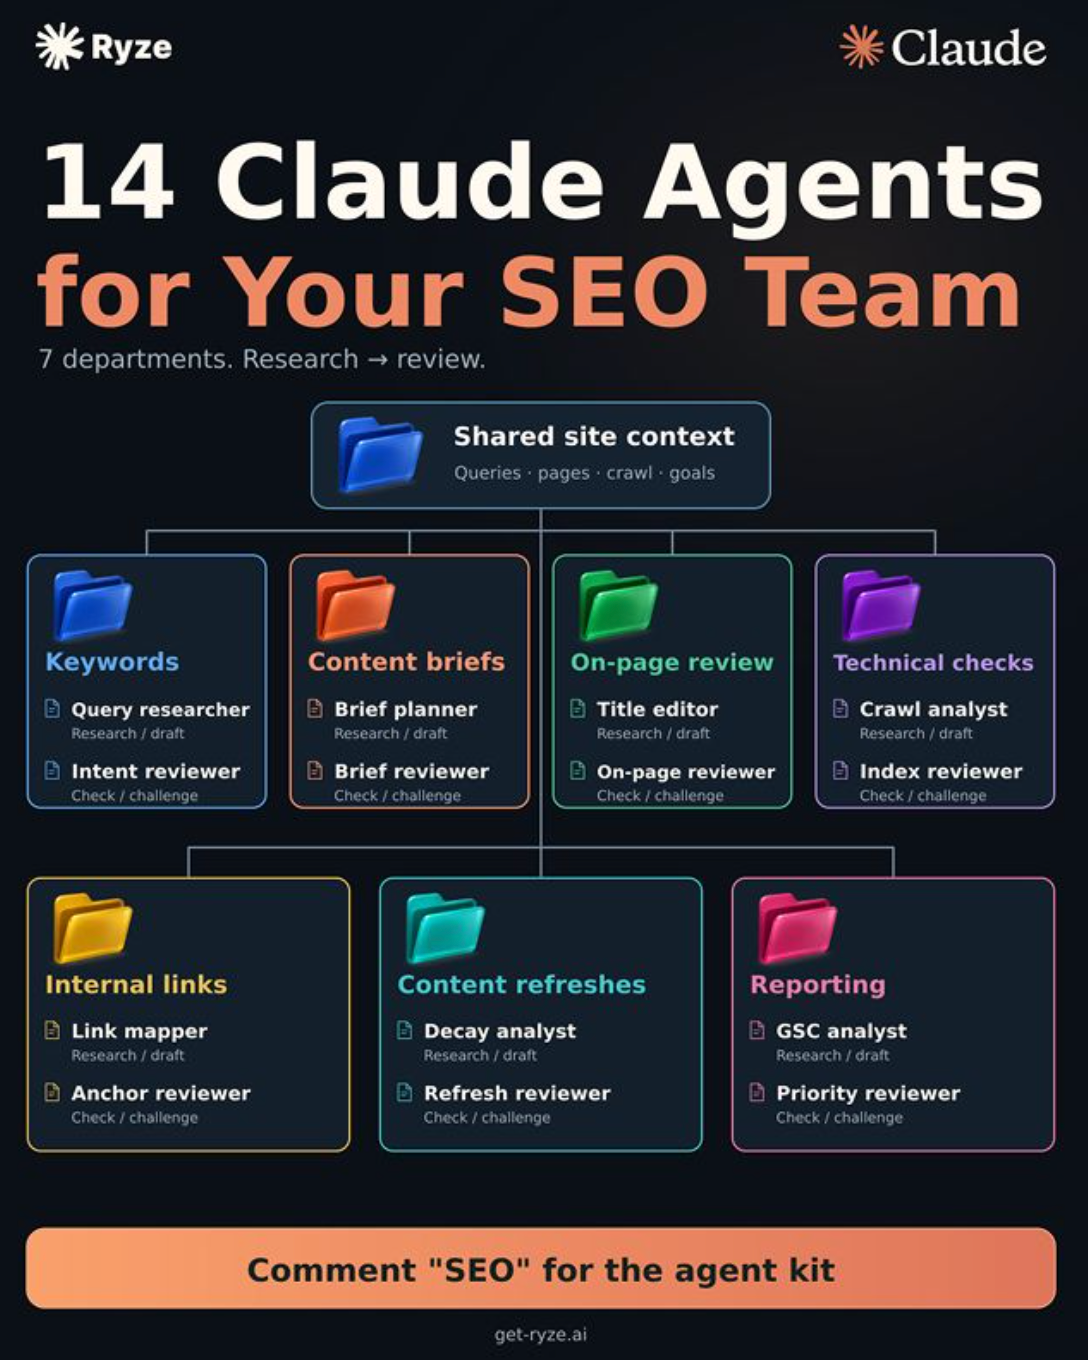
它们到处都是!
但是,拿到一套 agent 工具包固然不错,你还需要一套完整的基础架构才能让 AI SEO 自动化真正跑起来。在这篇文章里,我会讲解/演示你需要什么,以及如何真正搭建一套更"放手"的自动化 SEO 工作流。
我们先来讲几件在考虑 AI SEO 自动化时需要注意的事情。关键是要记住,要让这件事跑通,涉及多个组成部分:
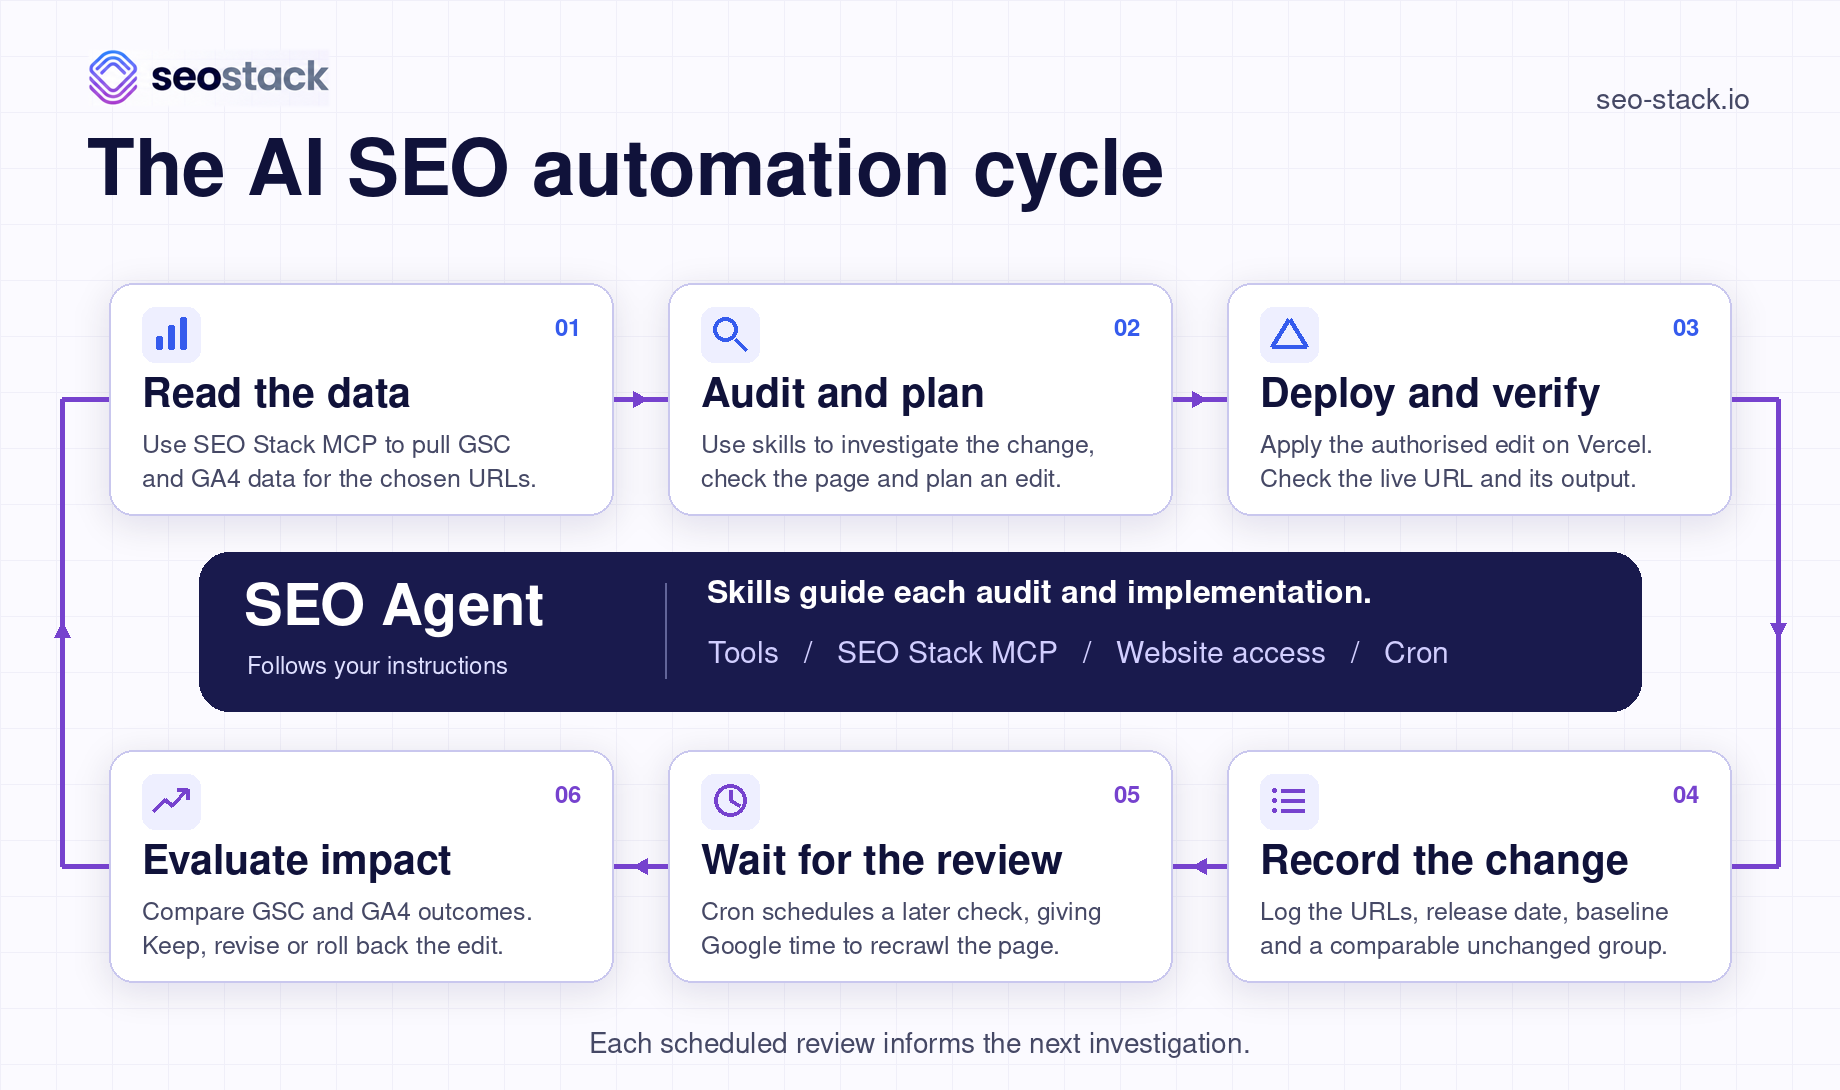
选择一个 agent
1. 你需要选择一个 agent。你可以选择 Hermes 或 Open Claw 这类工具,也可以使用 Claude 桌面版或 ChatGPT 桌面版。你的 agent 需要有基础架构,然后还需要为它配一个模型。
举个例子,你可以把 Hermes 与 Claude Opus 或 Sonnet 搭配使用。你需要选择一个支持长上下文、且能力足以支撑你所需分析深度的 agent。
如果你想从零开始搭建一个 agent,我们写了一篇文章并做了一个视频来帮你上手!
如何用 GSC + GA4 数据为 Slack 构建一个 SEO AI Agent
如果你想快速过一遍搭建流程,这里是视频
给 agent 配备技能
2. 有了 agent 之后,你需要给它一系列技能。这些技能可能是 agent 需要关注的具体事项,比如 Google Search Console 数据、排名和关键词机会。你的 agent 会继承一套技能集,但你同时还要让它了解 SEO 的流程。
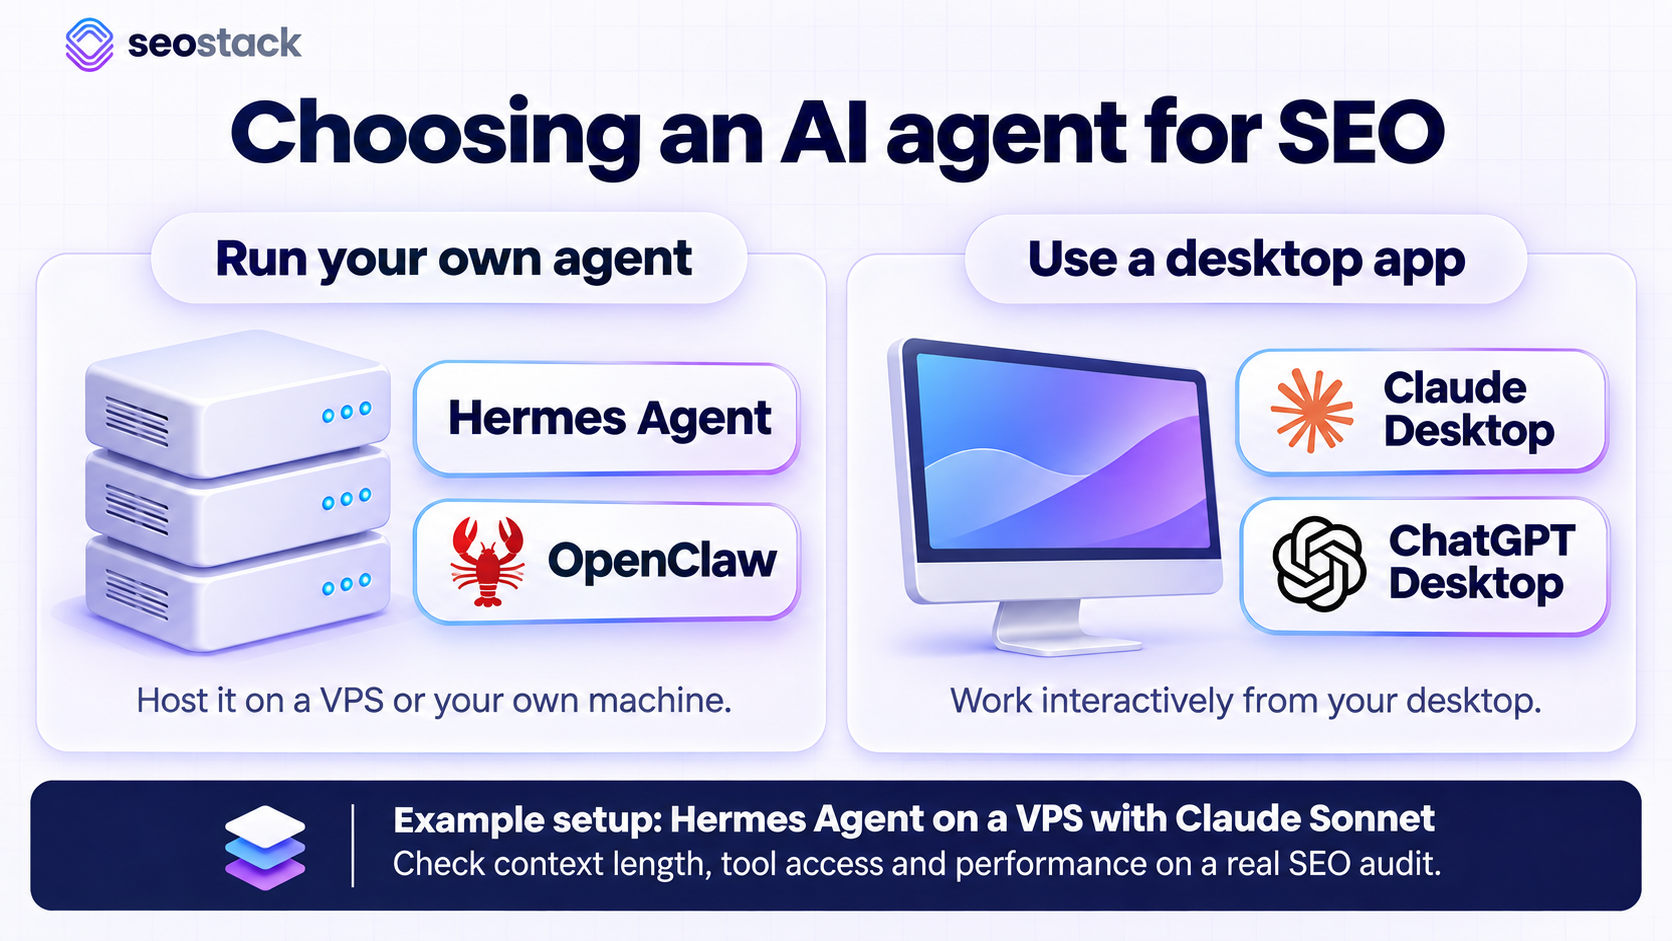
agent 应当明白:它分析数据后给出建议,然后决定进行实施。接着你显然还要确保 agent 理解——如果它对某个页面做了改动,就需要等待该页面在 Google Search Console 数据中体现出影响。
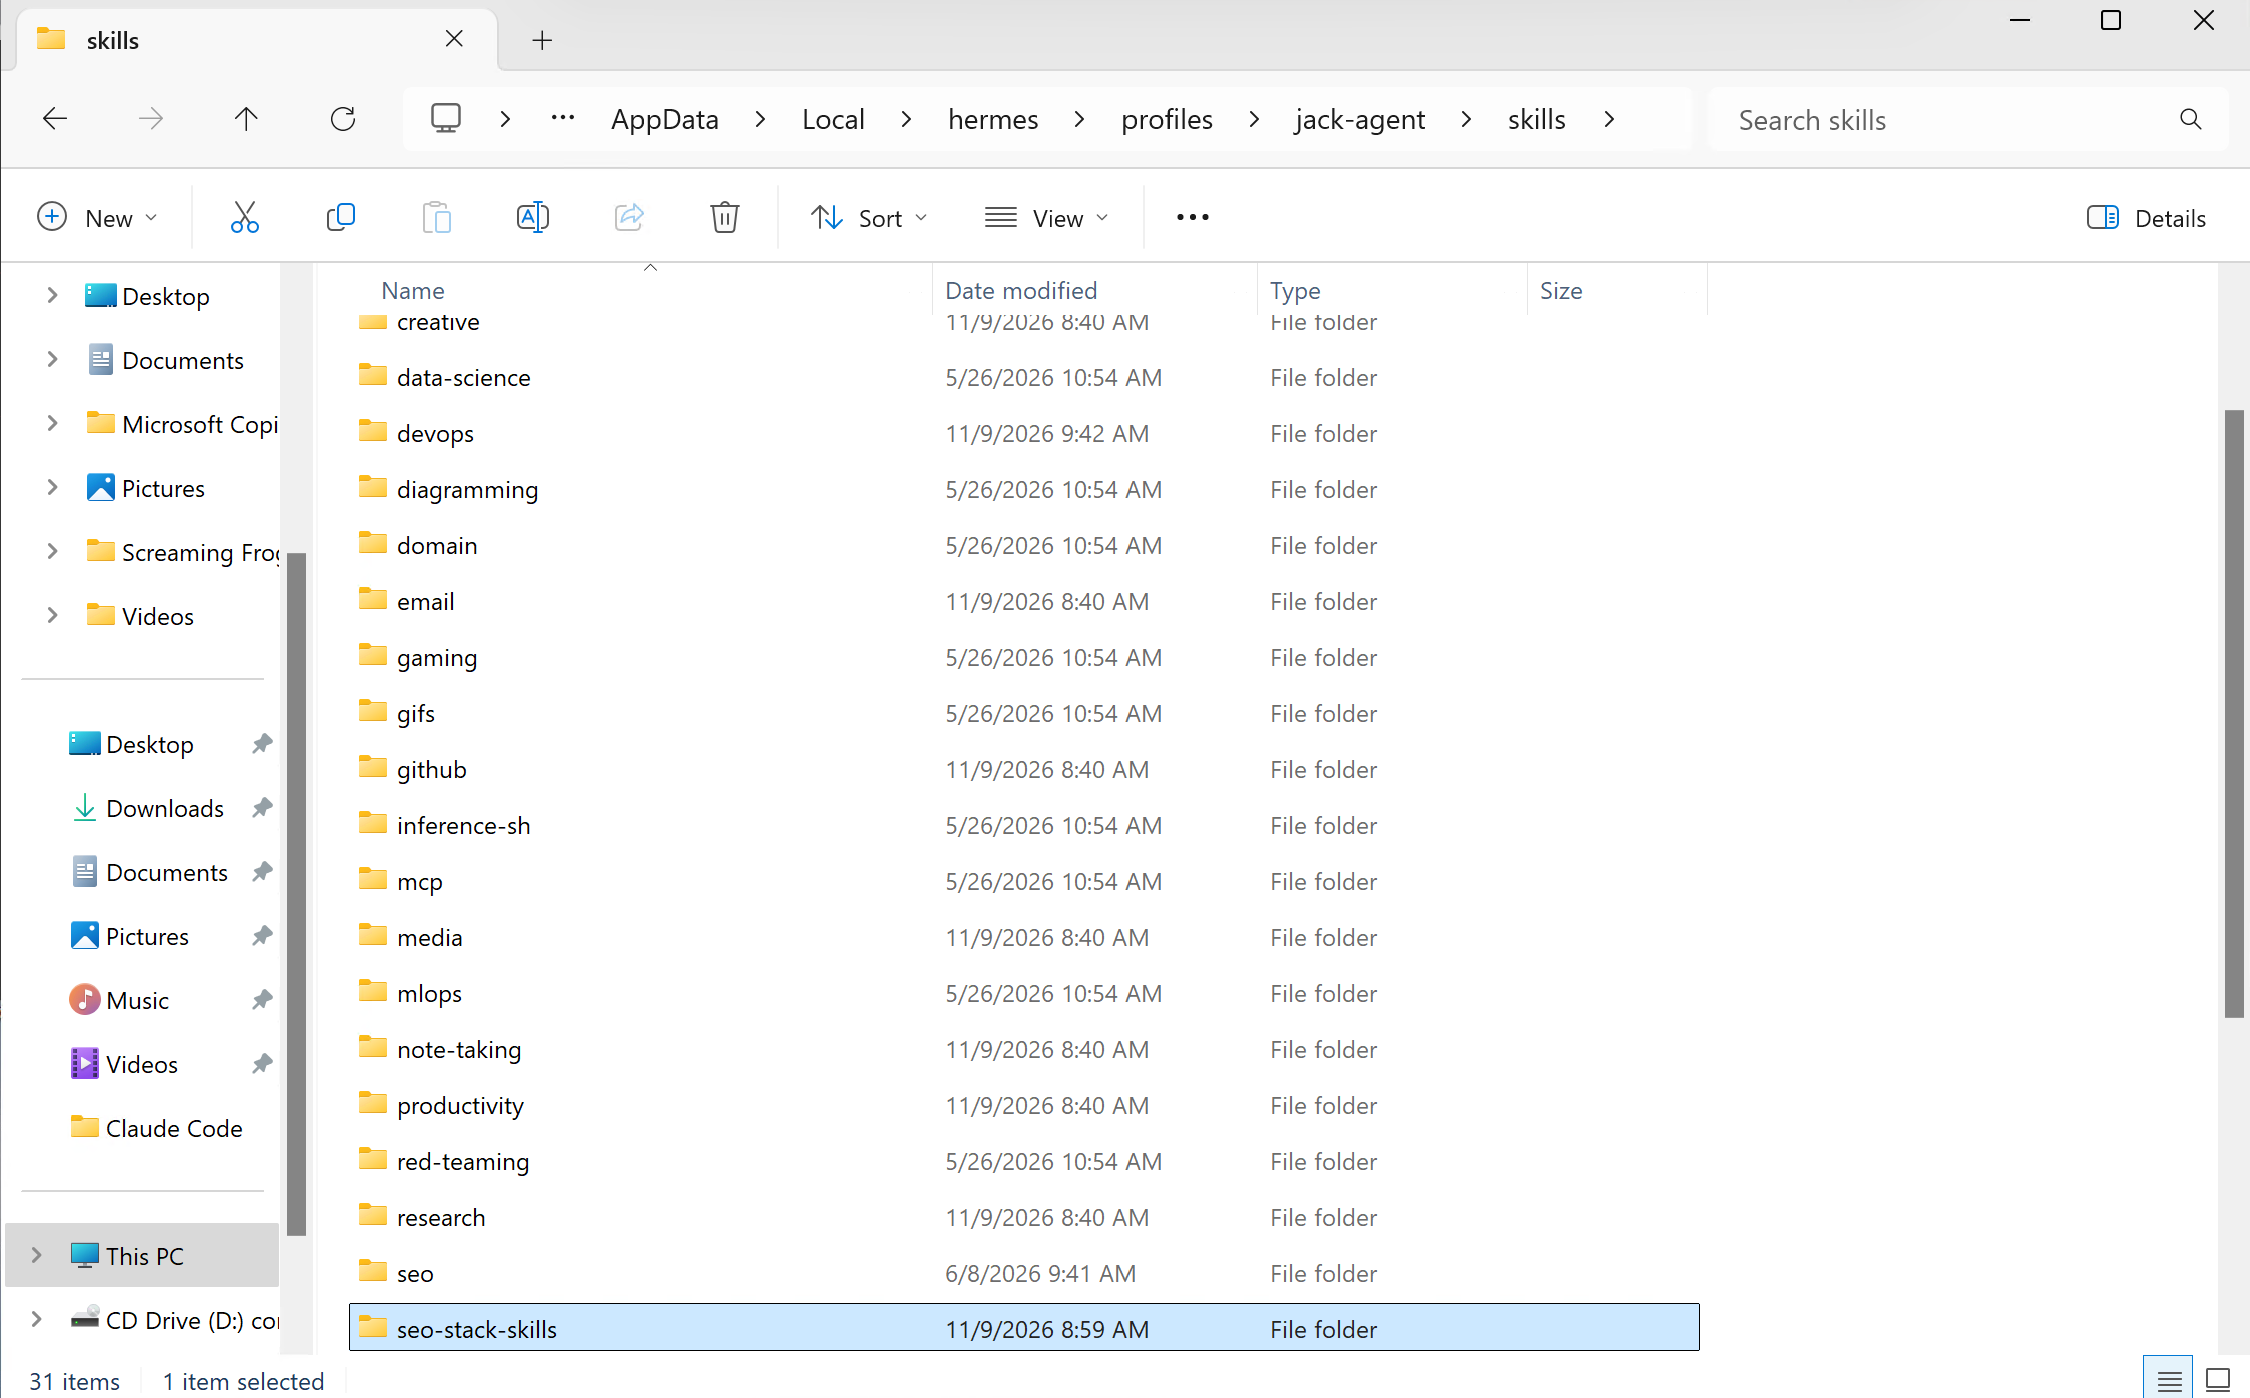
AI/AI SEO Agent 通常从安装包或子文件夹中继承技能,像 Nous Research 的 Hermes 这类 agent 允许你从 NPX/git 仓库安装技能,或者你也可以直接下载技能并解压到相应文件夹——下图是一个带有 skills 文件夹的 Hermes agent:
举个例子,如果一个 agent 在 11 月 1 日改动了一段内容、重写了标题,或者给页面增加了更多内链,那么从改动发生到产生影响之间存在滞后。agent 需要理解应当有一个等待期。
接下来你需要给 agent 配置 MCP 访问权限。MCP 访问让 agent 能够使用 SEO Stack 和 Ahrefs 这类工具。你授予的 MCP 访问取决于你的工具栈,对于一套好的 SEO AI 自动化/工作流,一般你会需要:
用于第一方数据的 MCP(Google Search Console、GA4、本地工具、CRM)
用于第三方数据的 MCP(AHREFS、DataForSEO、SEMRUSH、SERanking、AlsoAsked)
SEO 活动需要有数据源来做分析,还需要一个执行机制,让 AI agent 能够直接把改动推送上线(或者,你也可以继续自己掌控这个流程)。
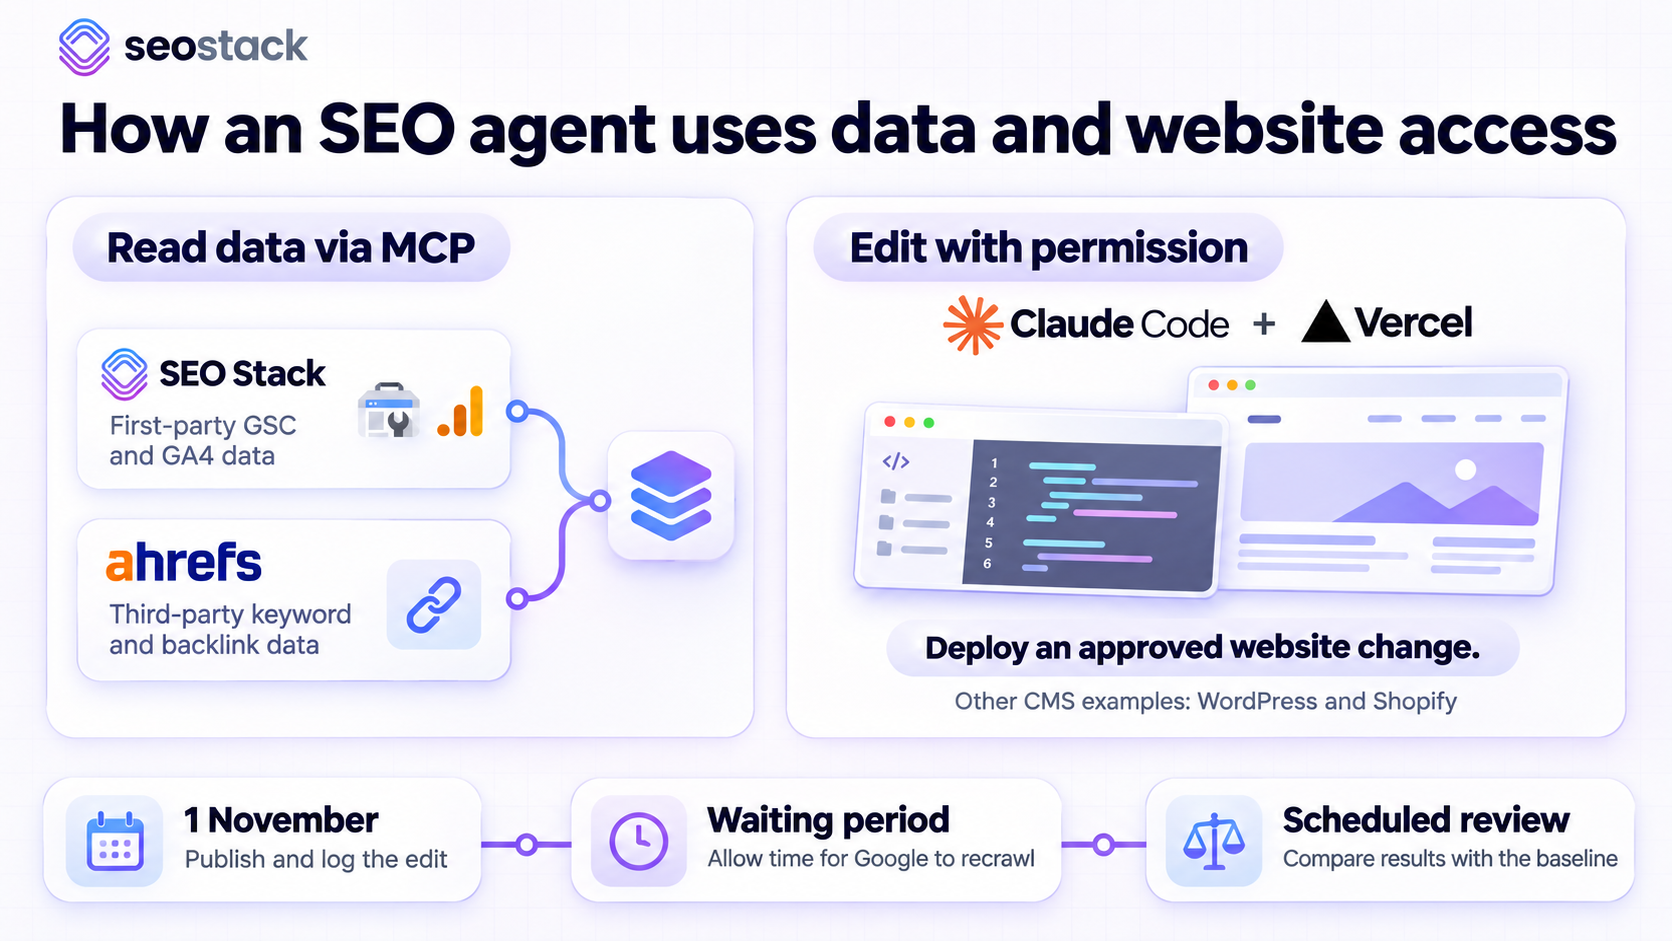
这里重要的一点是,做 AI 自动化你需要若干个 MCP 来获取第一方和第三方数据。比如 SEO Stack 的 MCP 可以让 agent 获得对 GA4 和 GSC 数据的 AI 可见性,然后你可能还有另一个 MCP 对接 Ahrefs、SERanking、Semrush 或其他工具。
配置好 MCP 访问之后,你需要决定 agent 是否可以直接在网站上实施改动。如果你用的是 WordPress、Shopify 或其他 CMS,你可以设置成让 agent 直接实施。我也向很多想做这些事情的人推荐 Claude Code 搭配 Vercel。
它非常好用,让 agent 能以灵活的方式直接控制和管理站点,而不受 CMS 平台可能带来的限制。
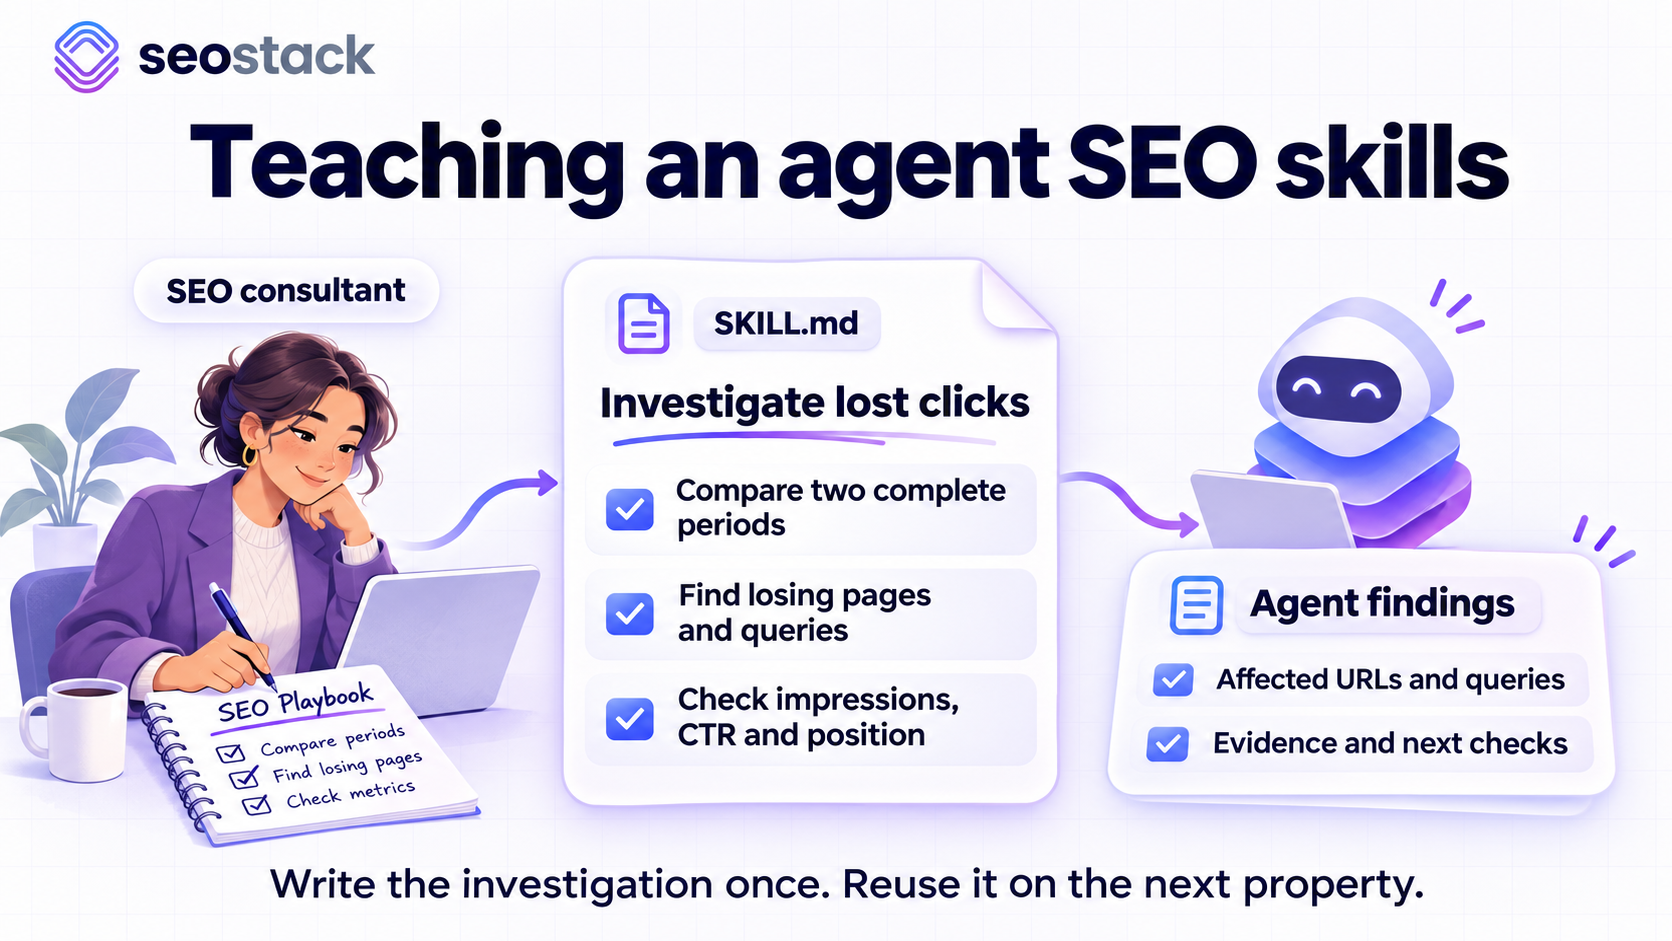
这些是一个 agent 需要具备的核心要素:
- 技能
- 指导
- 记忆与上下文
- 获取数据、执行操作和落地实施的能力
具备这些之后,你显然就能拥有一套自主的 AI SEO 工作流。它还可以延伸到诸如把你的 AI SEO agent 接入 Slack,向你汇报排名变化、注释,以及它能从数据中看到的任何情况。在这篇文章中,我会进一步展示并带你走一遍这个流程。
第 1 步:创建或部署你的 agent
首先,你需要决定使用什么 agent/模型,就本次实践而言,我们推荐:
Nous Research 的 Hermes Agent —— https://hermes-agent.nousresearch.com/
在 Database Mart 这类服务商上部署一台便宜的 VPS —— https://www.databasemart.com/
当然你也可以使用已有的 agent 或 AI/LLM 平台(SEO Stack 技能同样可以部署到上面)。
再说一次,正如我在上面放的链接,如果你之前没做过/还没做,这里是搭建自有 agent 的分步指南:
第 2 步:给你的 agent 配备 SEO 技能
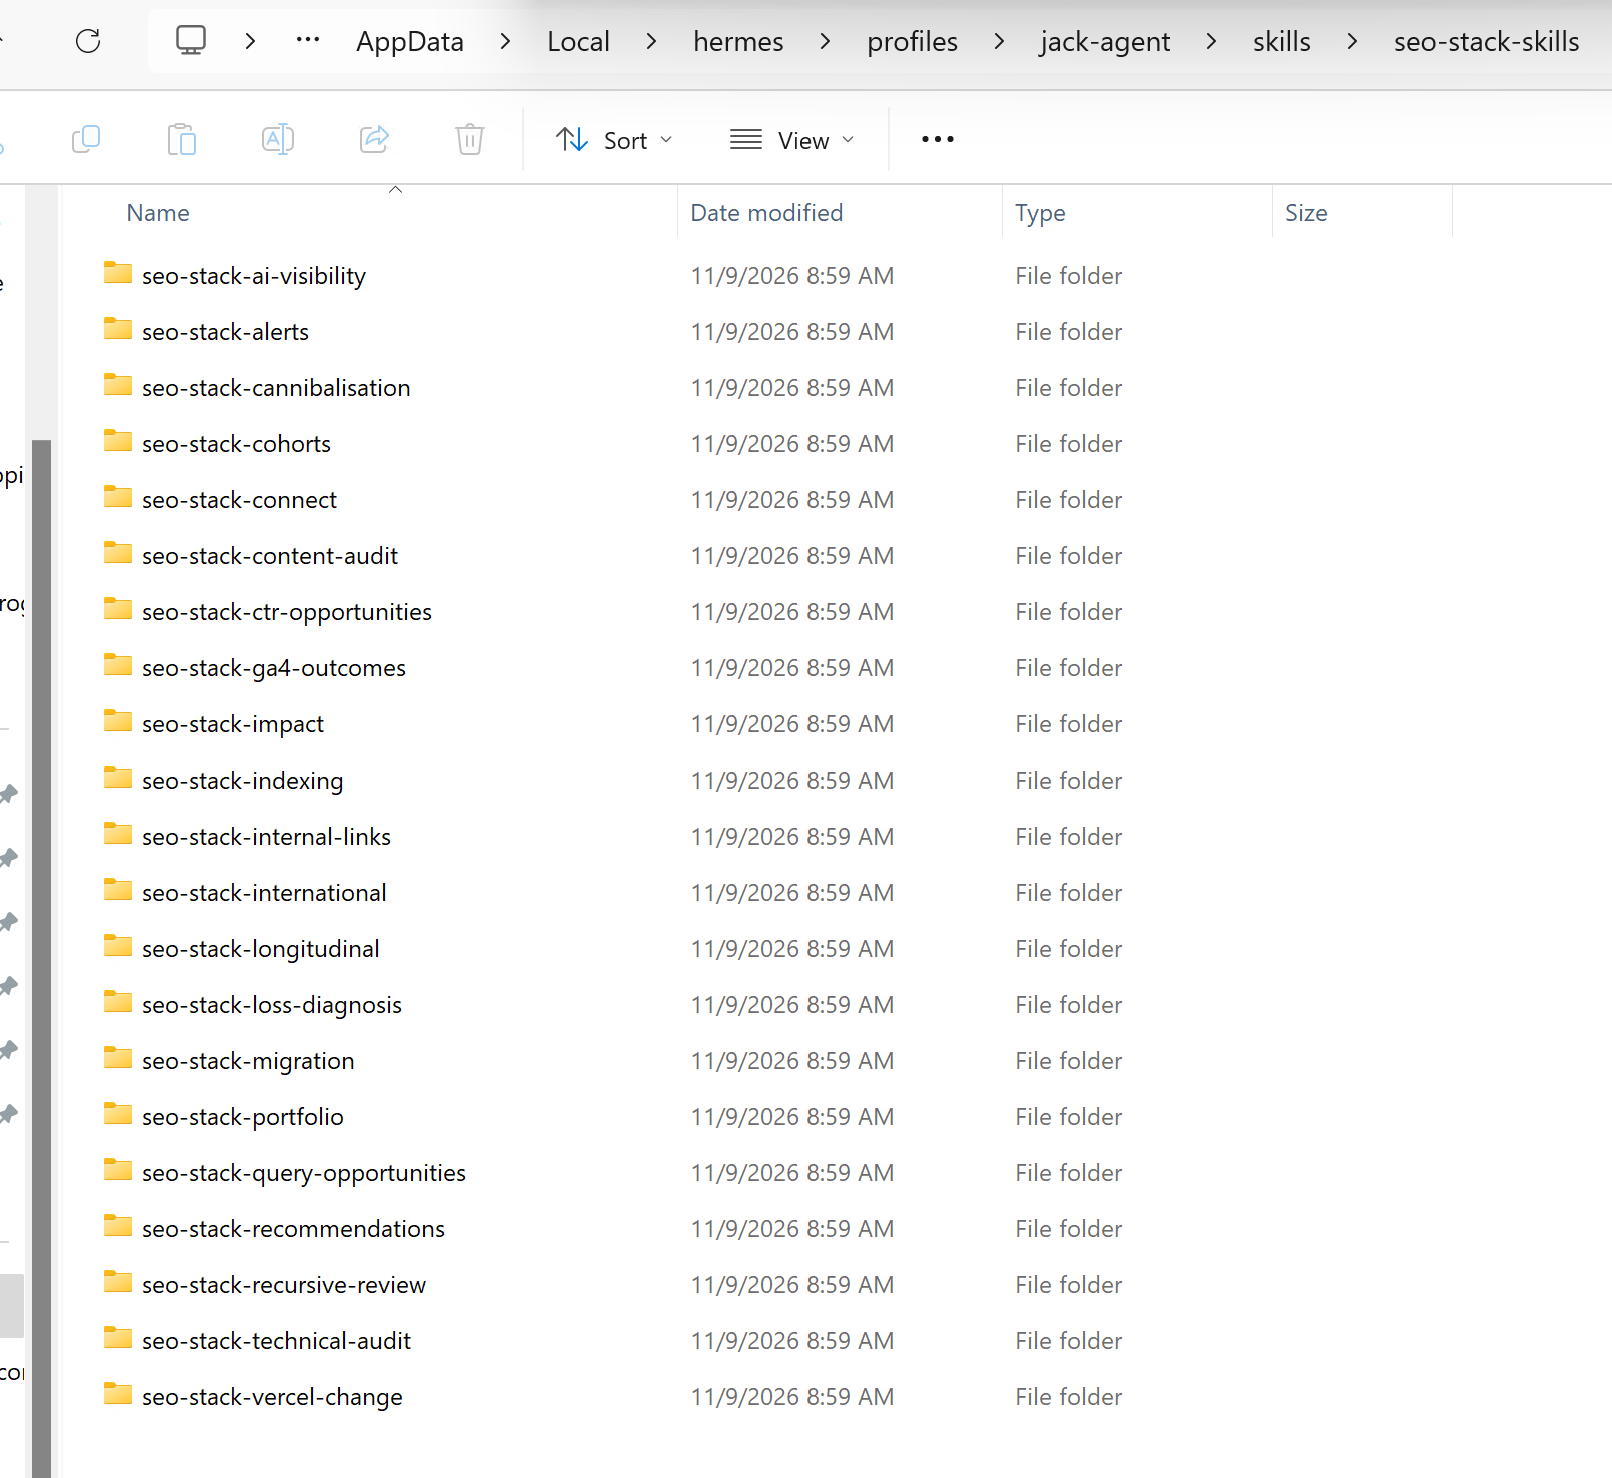
接下来的关键一步,是给你的 agent 配备执行 SEO 任务所需的技能。我们为 SEO Stack 用户提供可用于 SEO 自动化的定制技能,包括:
你可以从这里下载 SEO Stack 技能包:
下载 SEO Stack agent 技能包
第 3 步:在现有 agent/你的新 agent 中安装技能
把下载的文件解压一次,并将整个 seo-stack-skills 目录放在 agent 可以读取的位置。在 skills/ 内部,每个 seo-stack-* 文件夹都有自己的 SKILL.md。这些单独的文件夹要放进客户端的 skills 目录。
具体做法取决于你使用的平台,例如 HERMES 在默认配置文件夹内有一个 skills 文件夹,你创建的其他配置文件也同样如此:
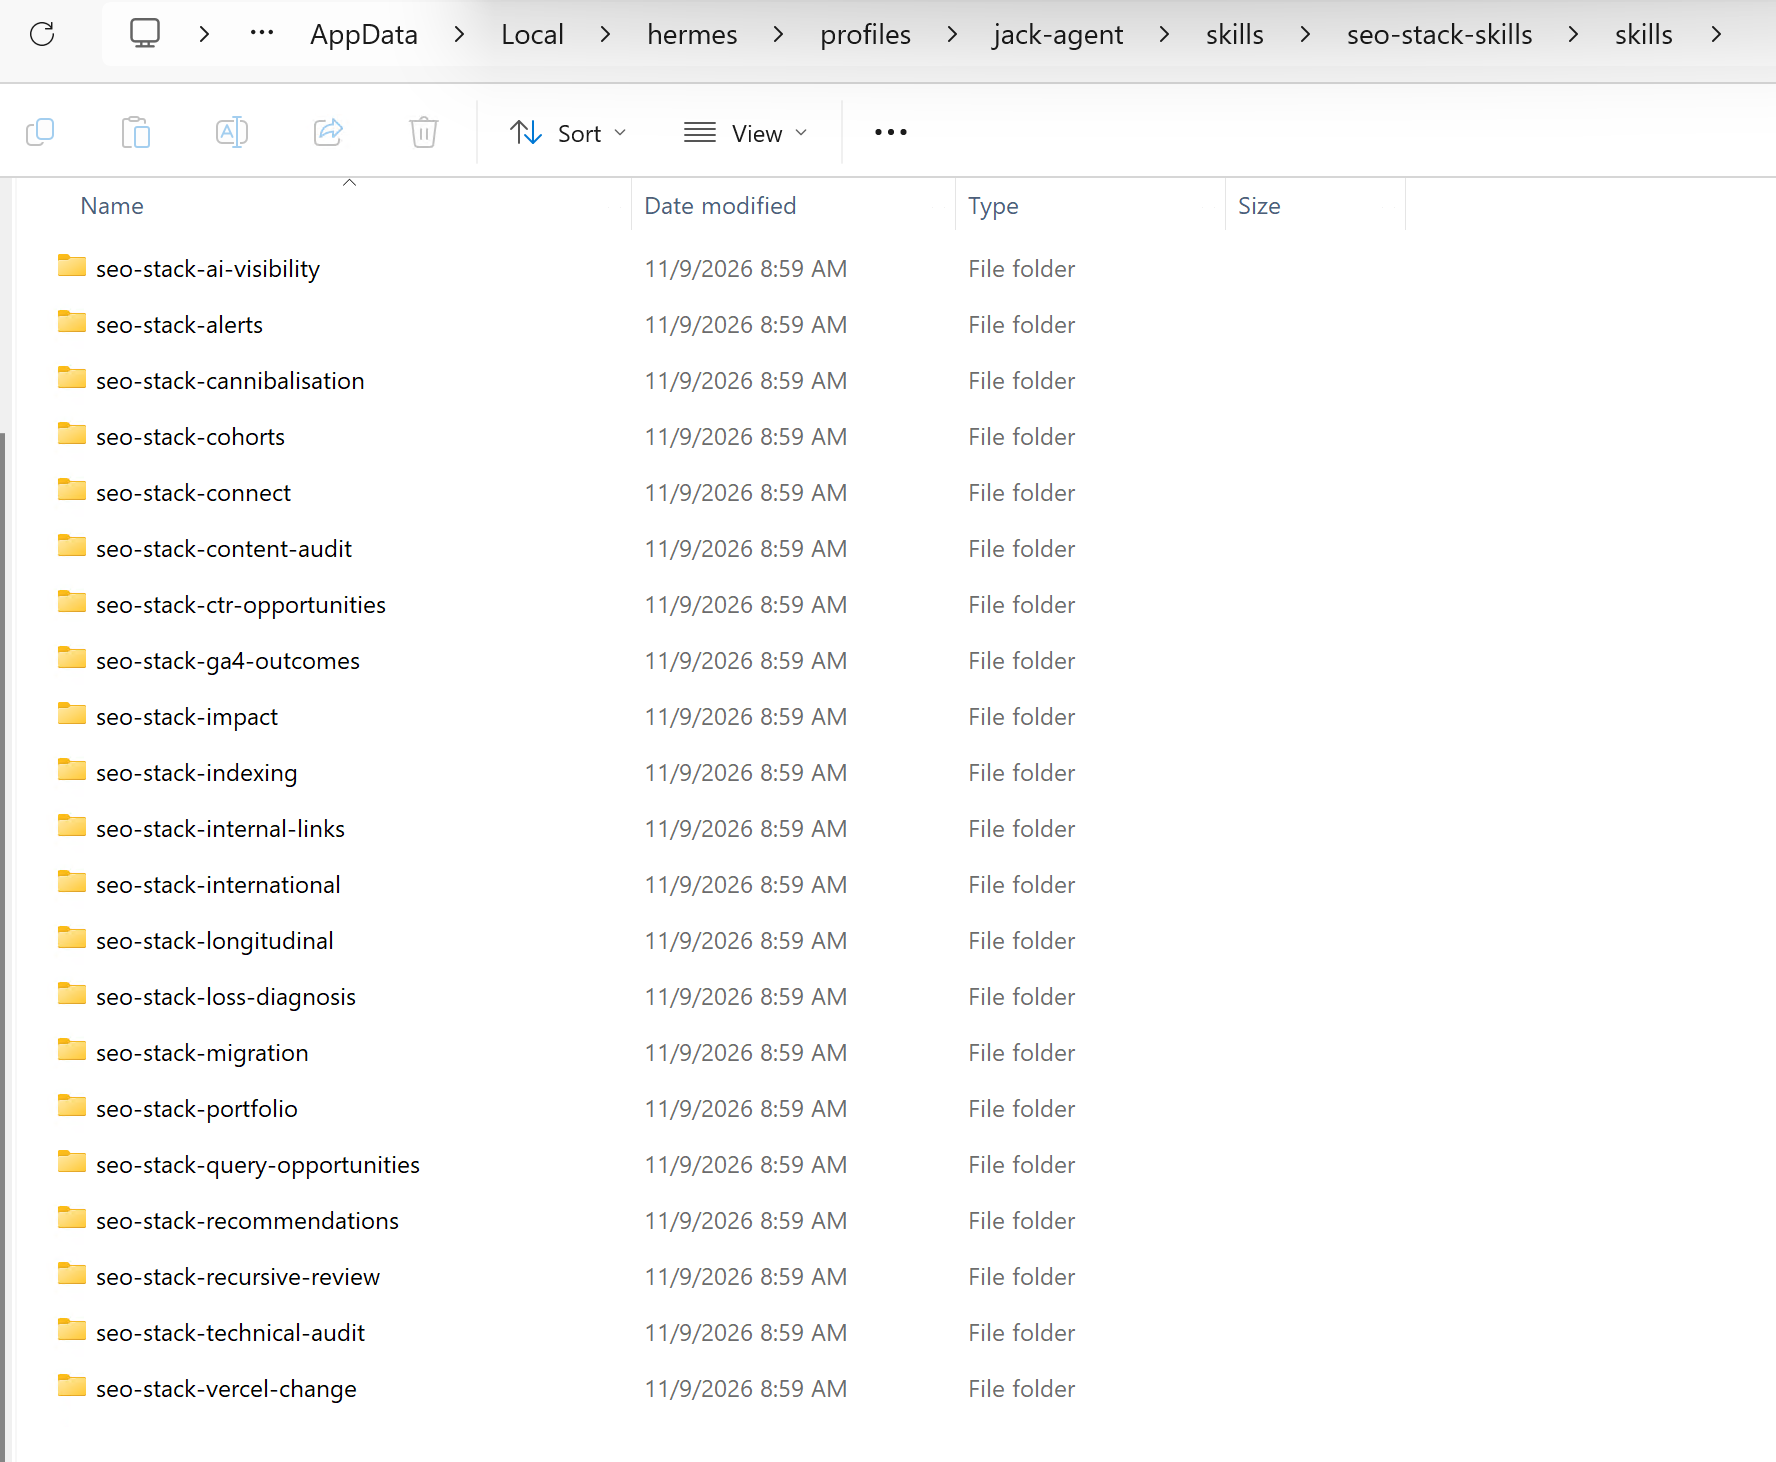
共享的 docs/、scripts/ 和 examples/ 保持在原始检出目录中不动。告诉 agent 你把它放在哪里。在云端聊天中,如果没有本地检出目录,就直接提供这些共享参考文件。
要进行实时读取,你还需要一个已授权的 SEO Stack 资源及其 MCP 连接。现有 agent 可以复用已有的可用连接。如果是新建的,在 SEO Stack 中打开 MCP,获取生产环境连接信息,并把密钥保存到客户端的凭据设置中。
下面的示例使用了我们 Hermes 指南中的 bearer-key 端点。使用范围仅限于该 agent 应当看到的客户的凭据,并注意 SEO Stack 密钥是以其账户持有人身份进行认证的。SEO Stack 设置指南
VPS 或现有 RDP 机器上的 Hermes
在运行 Hermes 的机器上执行 hermes profile show YOUR_PROFILE。打开该配置文件的 skills 文件夹,把各个技能文件夹复制进去。用文件资源管理器完全可以完成。在标准 Linux 安装中,命名配置文件使用 ~/.hermes/profiles/YOUR_PROFILE/skills/,默认配置文件使用 ~/.hermes/skills/。在 Windows 上,使用 Hermes 为该安装报告的路径。
对于新的 MCP 连接,把 MCP_SEOSTACK_API_KEY 存入该配置文件的私有 .env。在其 config.yaml 中添加以下条目,并合并到已有的 mcp_servers 部分:
mcp_servers:
  seostack:
    url: https://api.seo-stack.io/api/mcp
    headers:
      Authorization: "Bearer ${MCP_SEOSTACK_API_KEY}"
开启一个新会话。运行 hermes -p YOUR_PROFILE skills list 和 hermes -p YOUR_PROFILE mcp test seostack。你应当能看到这些技能以及发现的服务器工具。然后执行下面的实时资源测试。如果该配置文件同时还运行着一个网关,也要把配置应用到该网关并通过它进行测试。CLI 连接成功,并不排除某个定时任务 worker 加载了不同的配置文件或持有过期的 MCP 会话。Hermes 配置文件 · Hermes 上的 SEO Stack
Claude Desktop 或网页版 Claude
安装很简单,最省事的办法就是直接下载上面的 ZIP 文件,在聊天中交给 Claude,然后让它安装以便长期使用:
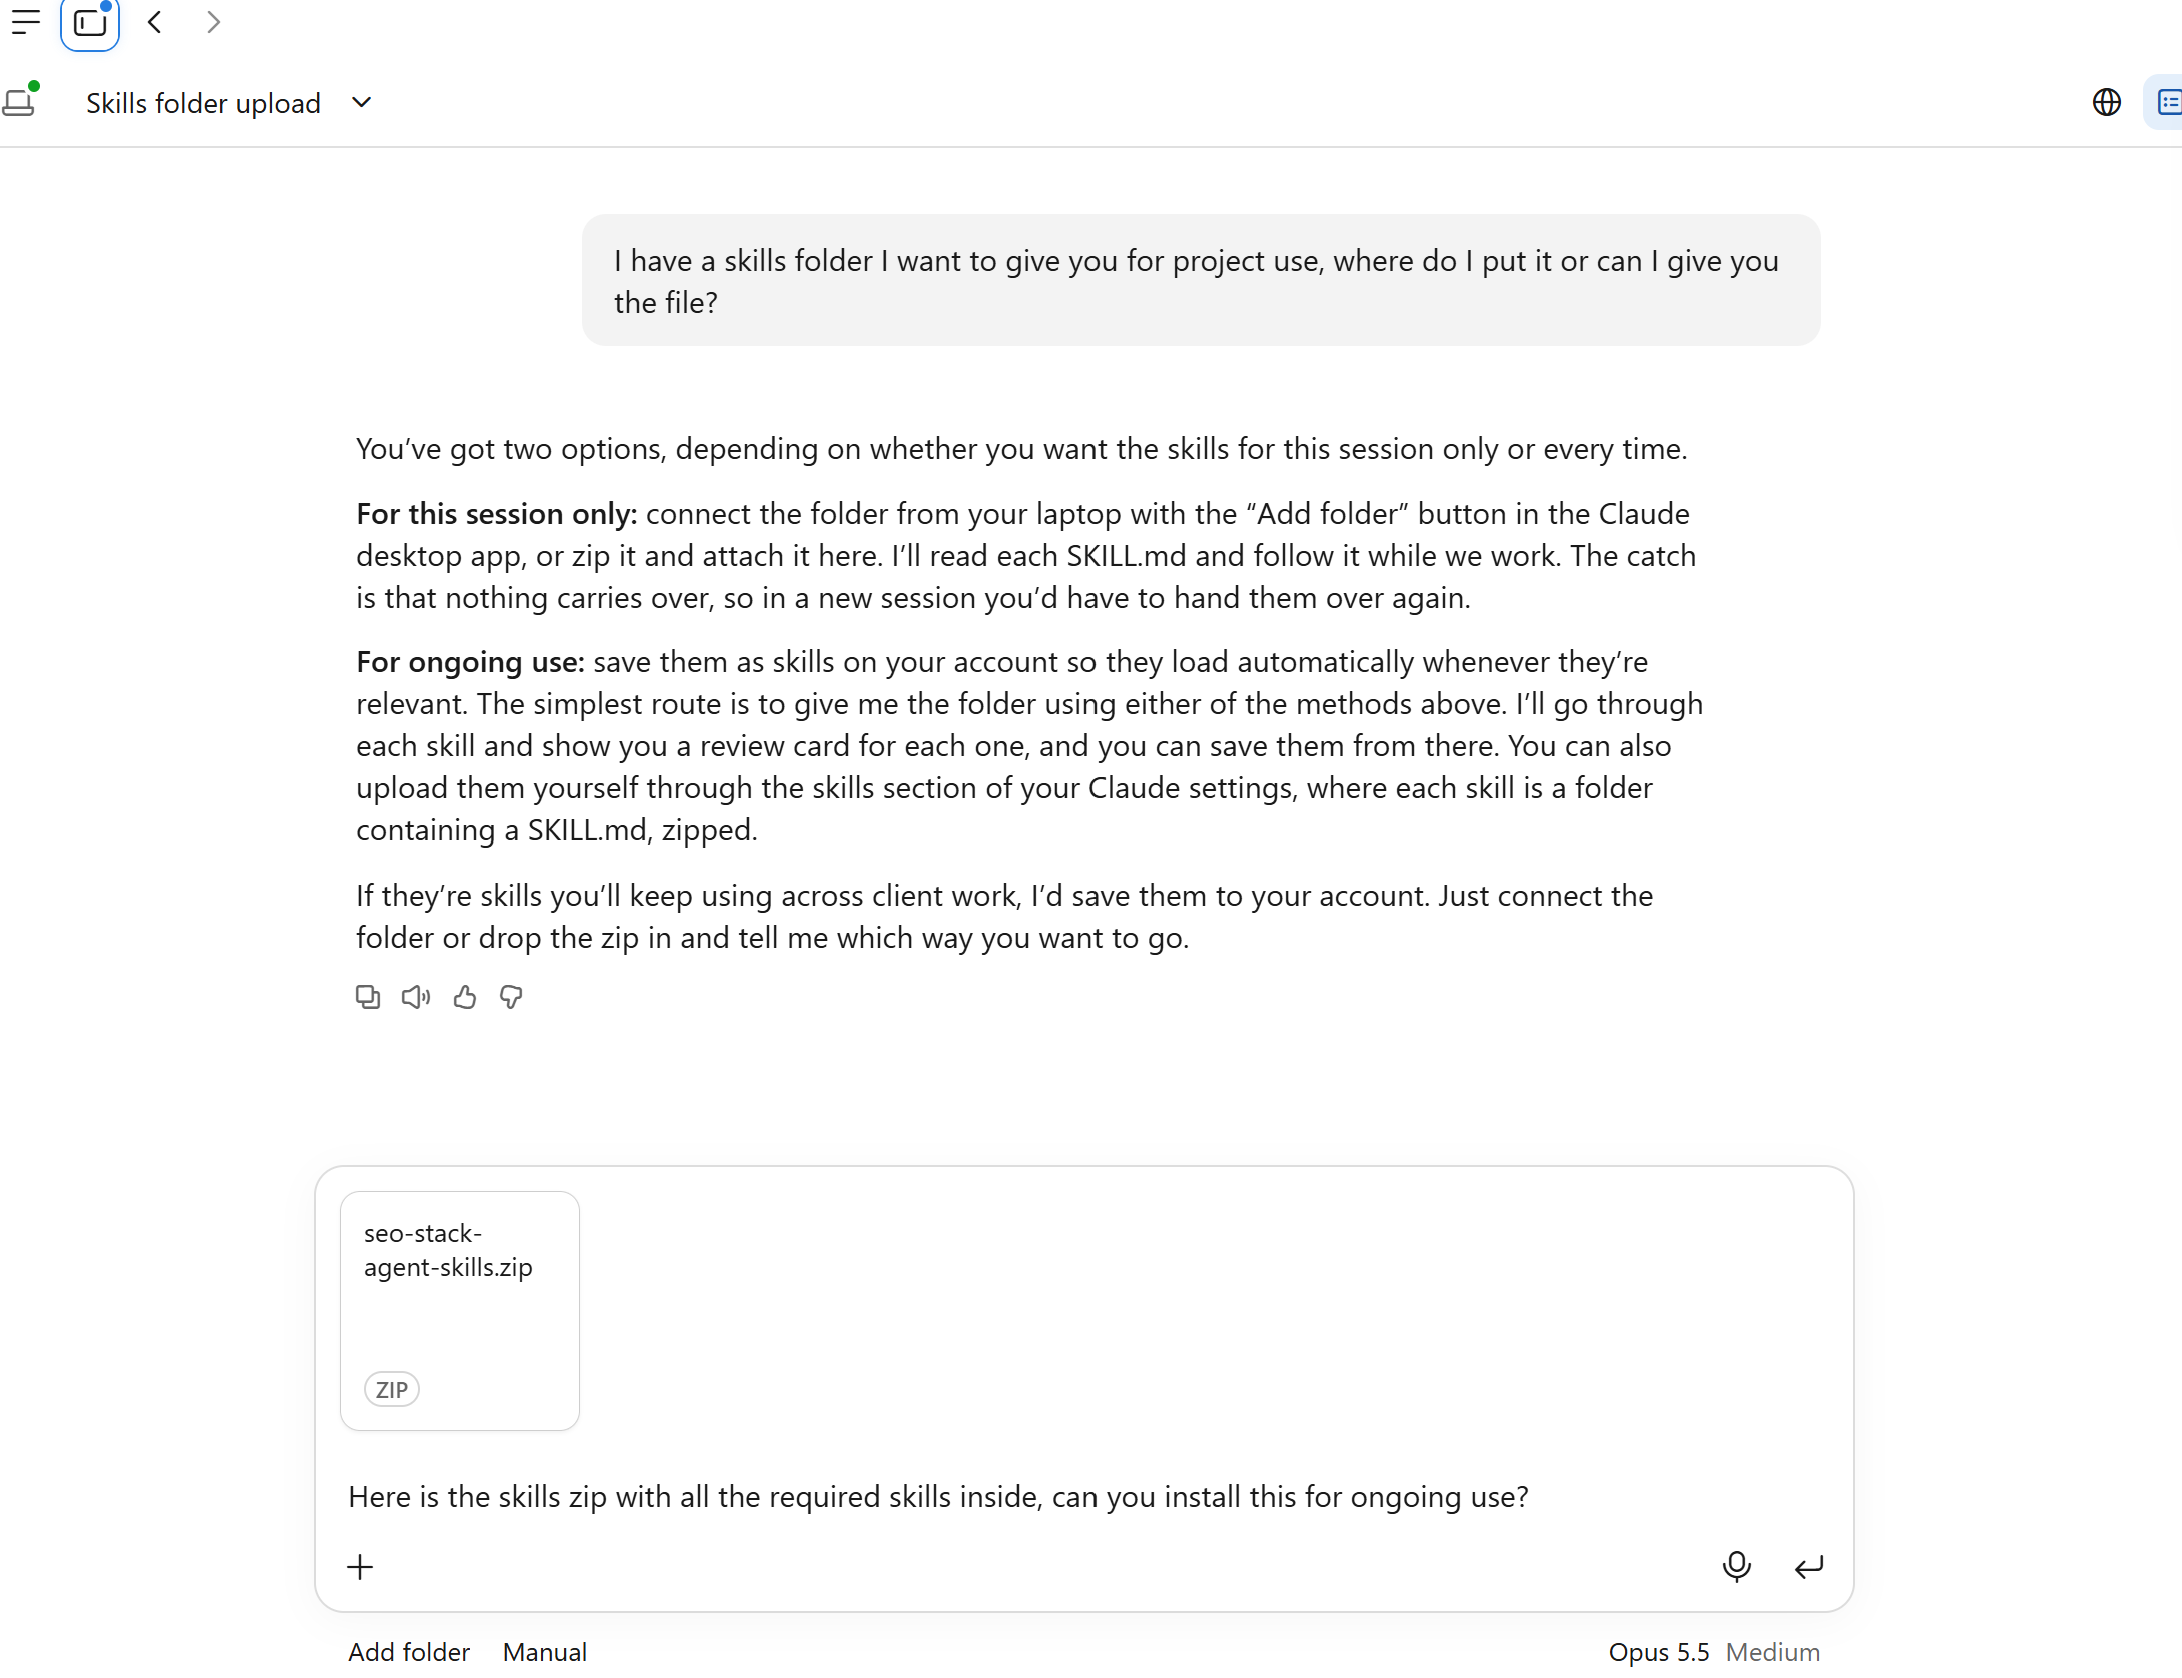
随后你会看到它开始安装,接着就可以保存该插件:
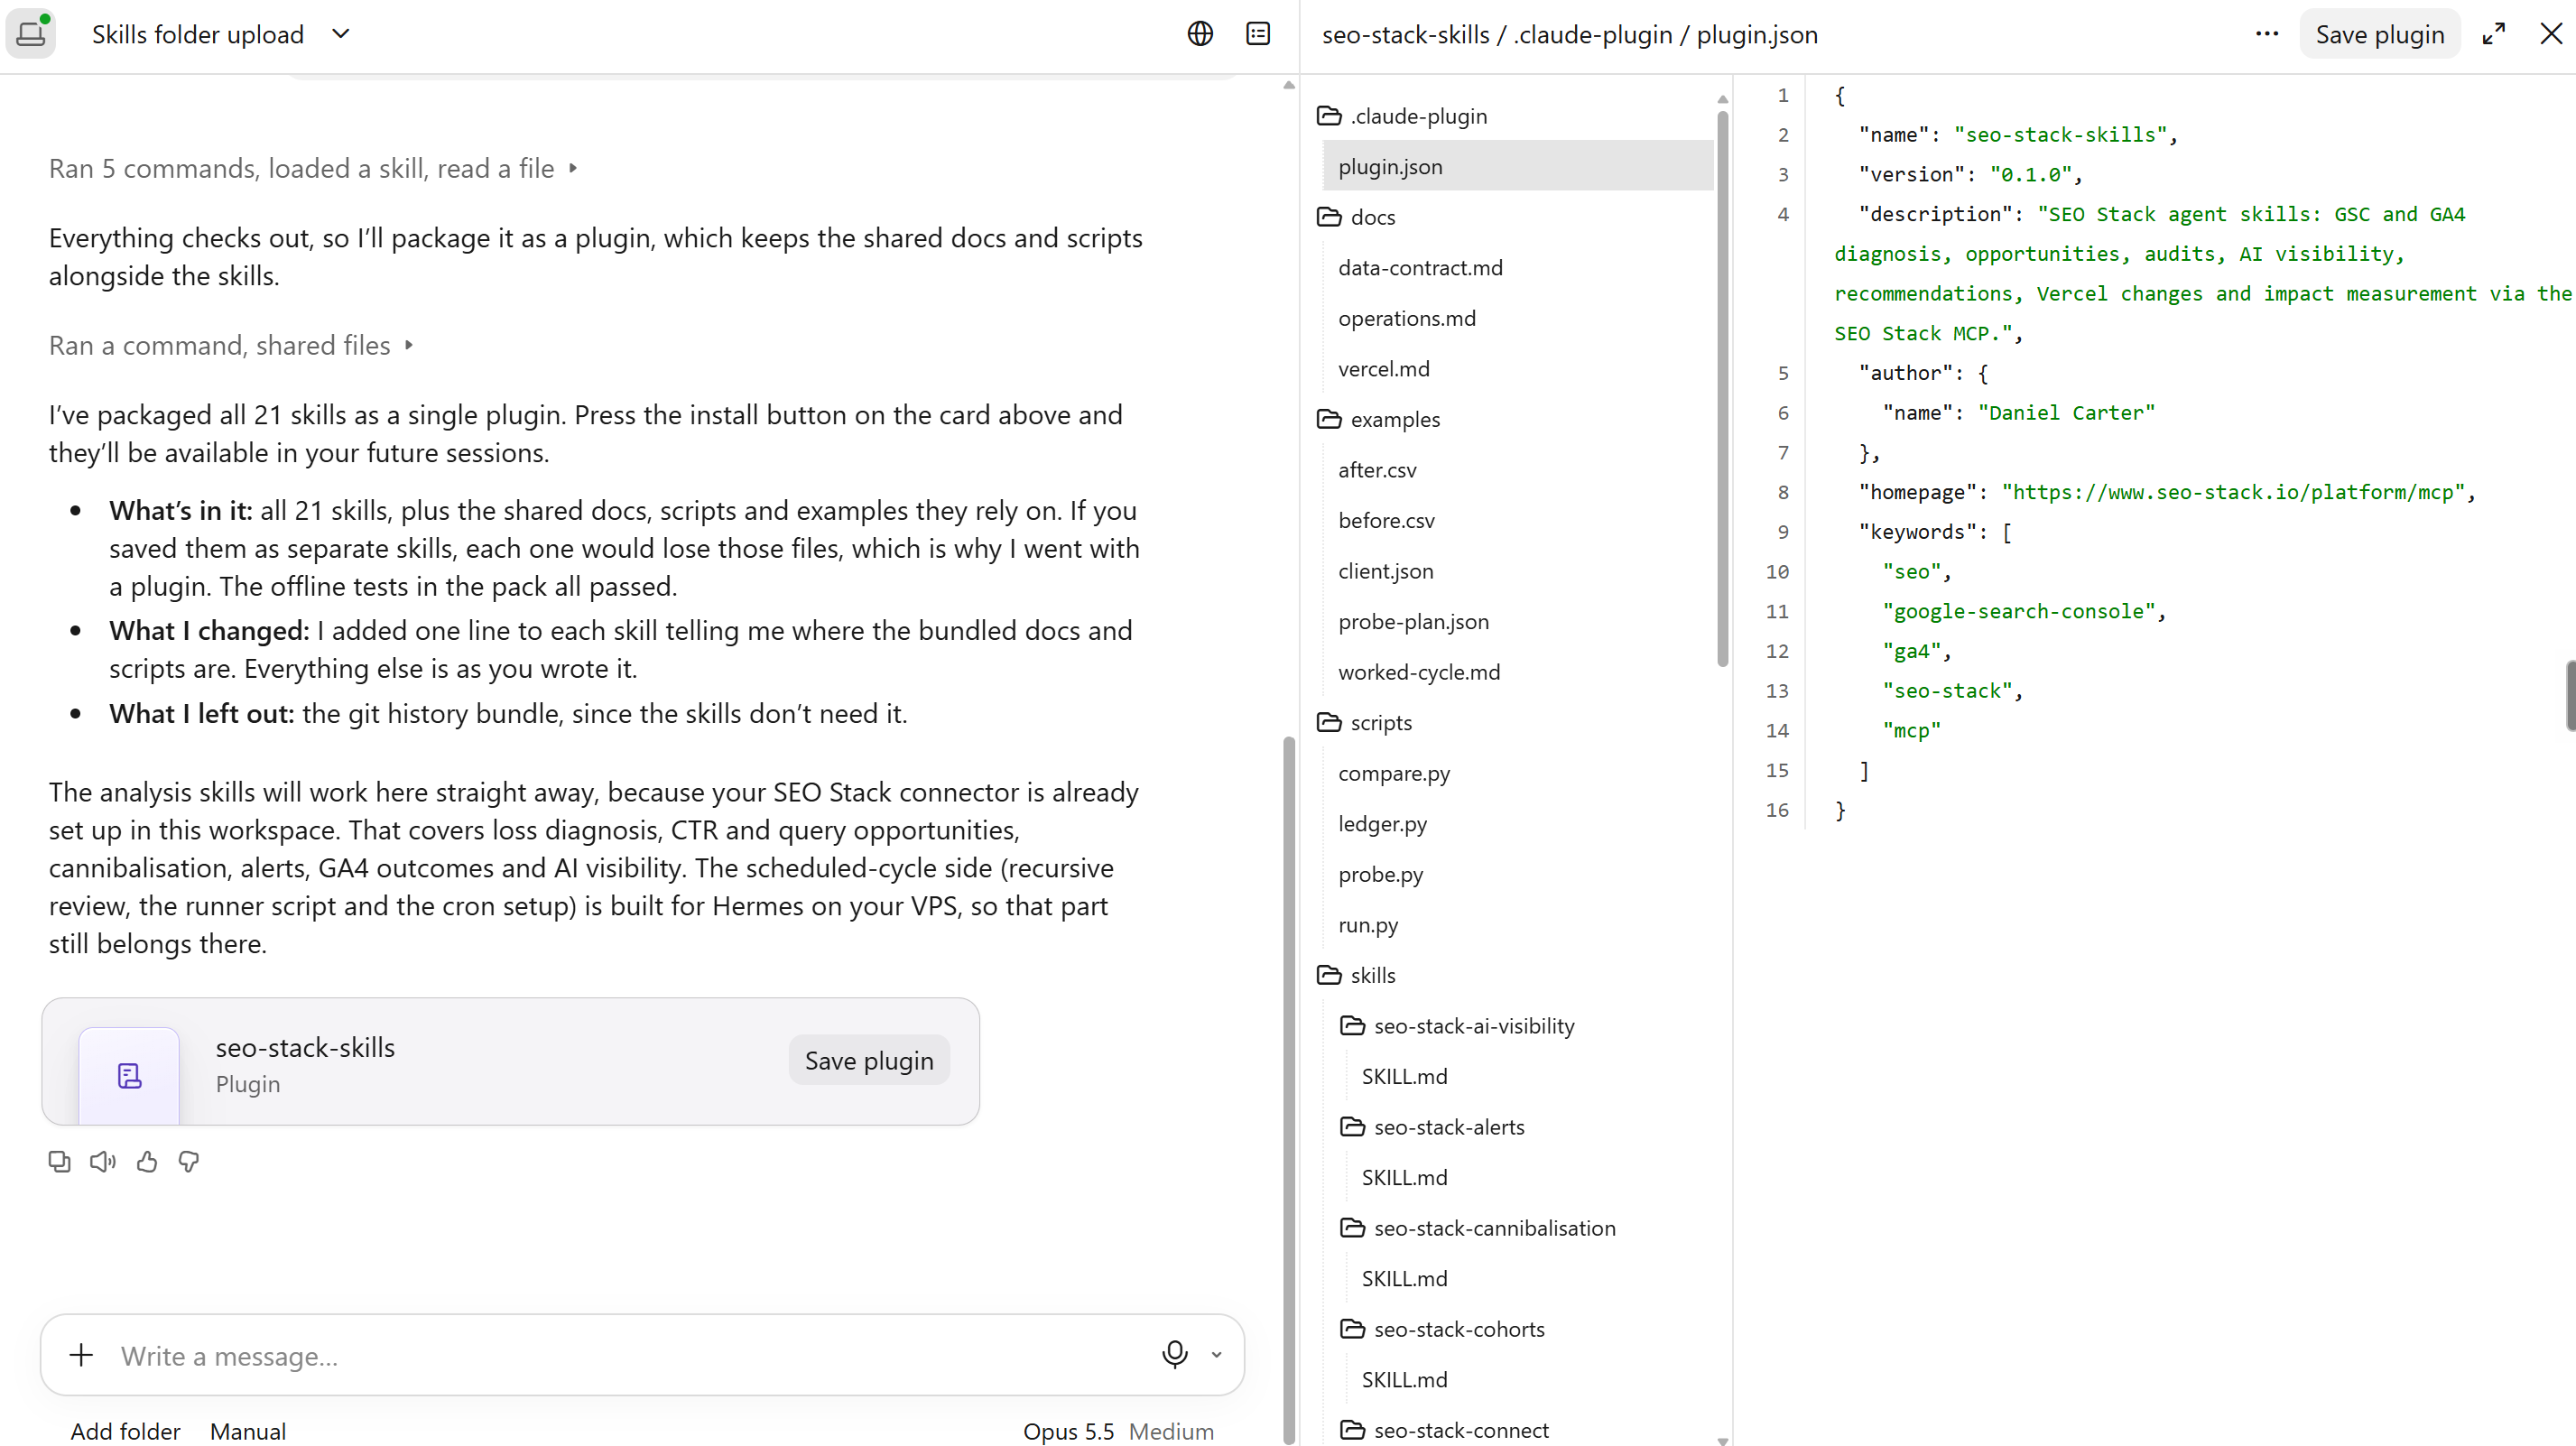
完成之后,你只需把 Claude 连接到 SEO Stack 的 MCP
在 Claude 的功能设置中启用代码执行和文件创建。先从两个技能开始:seo-stack-connect 和 seo-stack-loss-diagnosis。把每个技能文件夹分别打包成 ZIP,保持文件夹及其 SKILL.md 在一起。在 Customize → Skills 中,使用 + → Create skill → Upload a skill,上传每个 ZIP 并启用。把技能包中的 docs/data-contract.md 附加到项目或对话中,这样 Claude 才能读取通用的测量说明。Claude 自定义技能安装
打开一个 Chrome 标签页/浏览器标签页,访问 >
https://app.seo-stack.io/mcp
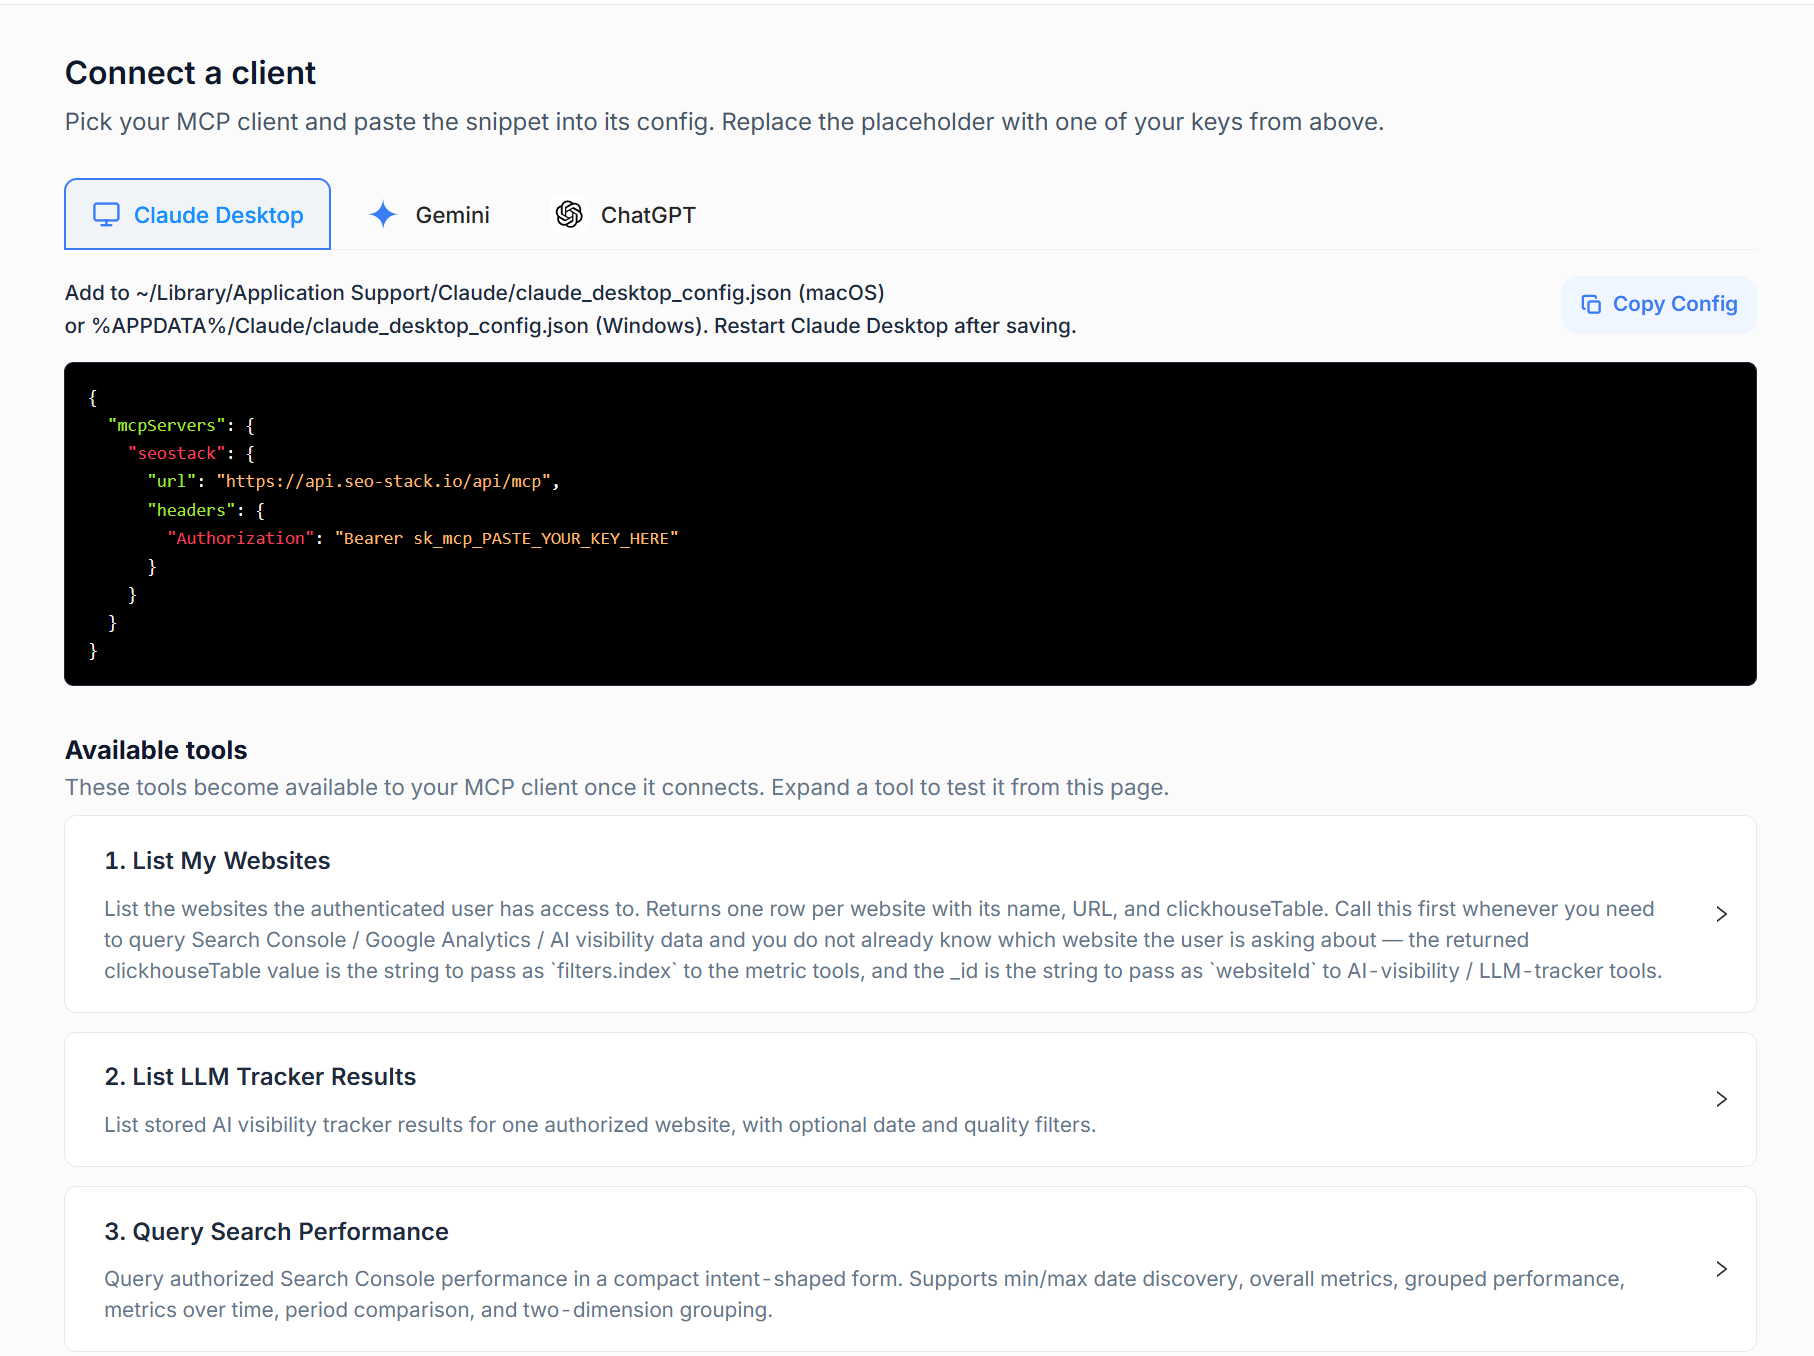
在这里你可以创建连接/创建 API KEY。
你需要创建一个 MCP 密钥,然后给它取个名字 >
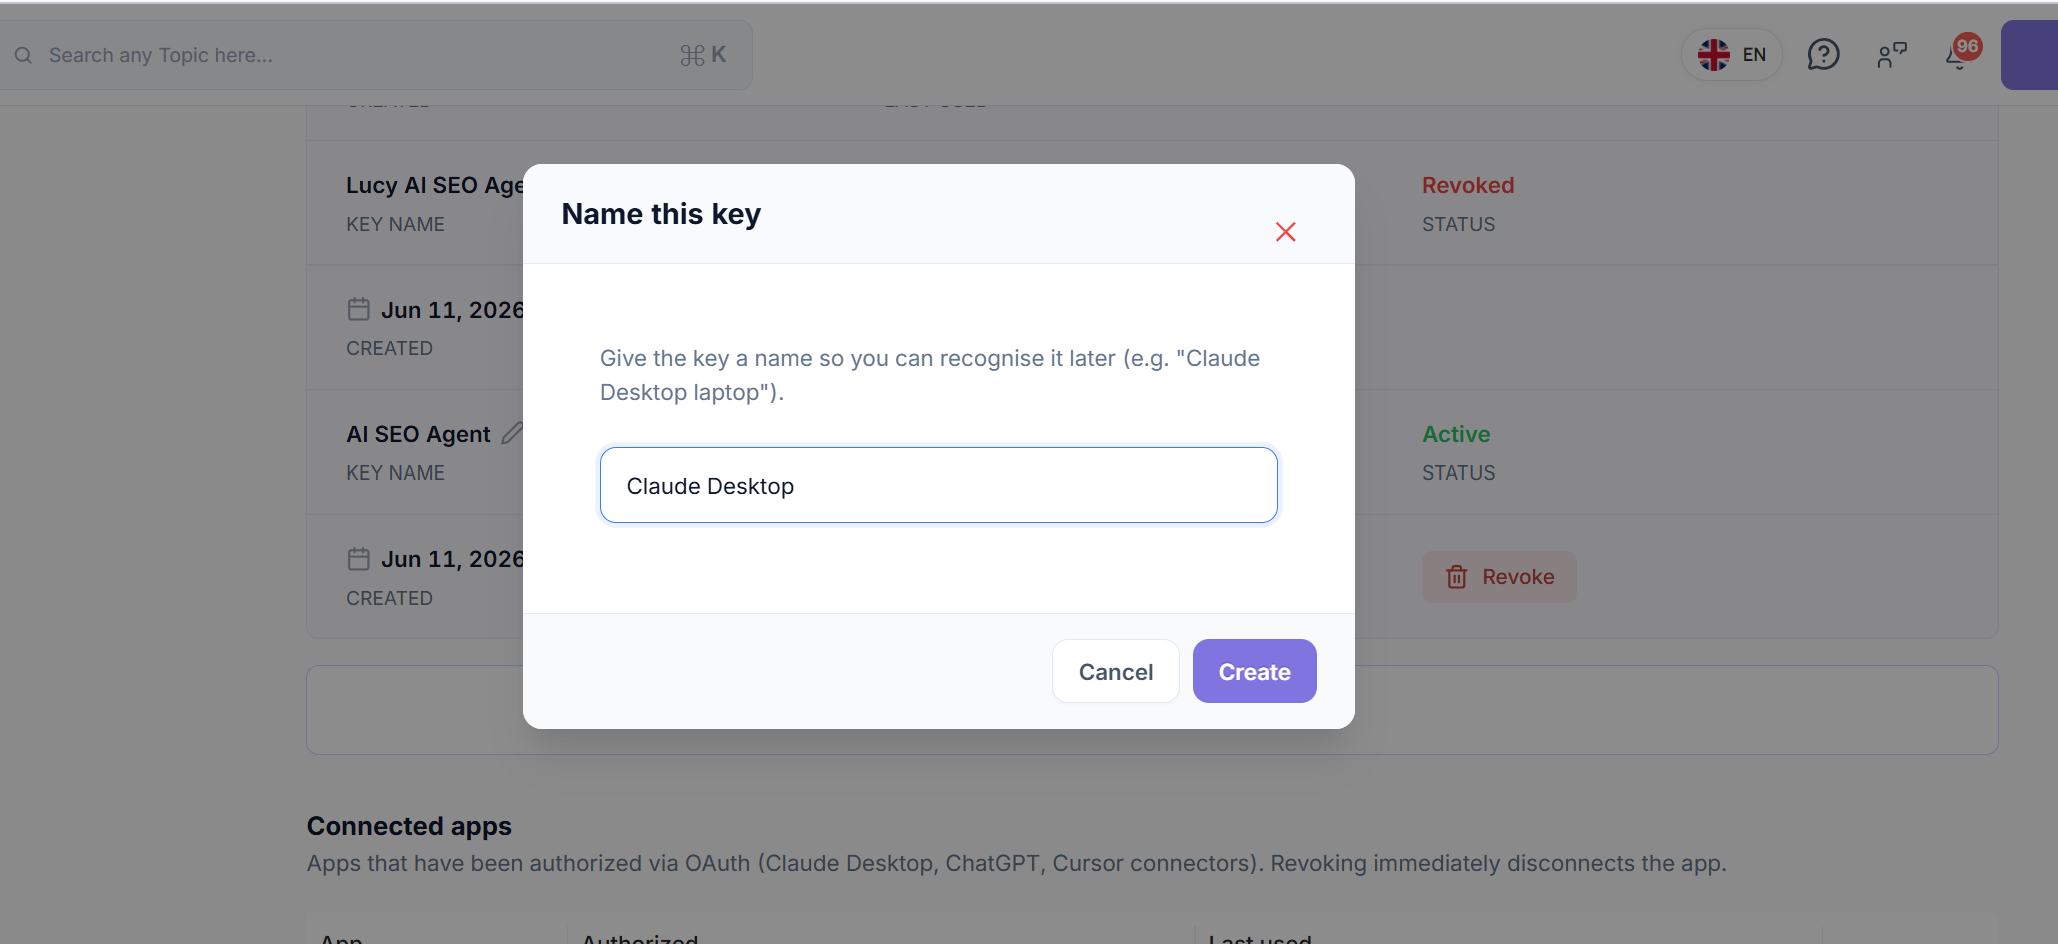
然后回到 Claude Desktop,进入 SETTINGS。
在 Customize → Connectors 下,使用 SEO Stack MCP URL 添加一个自定义连接器。
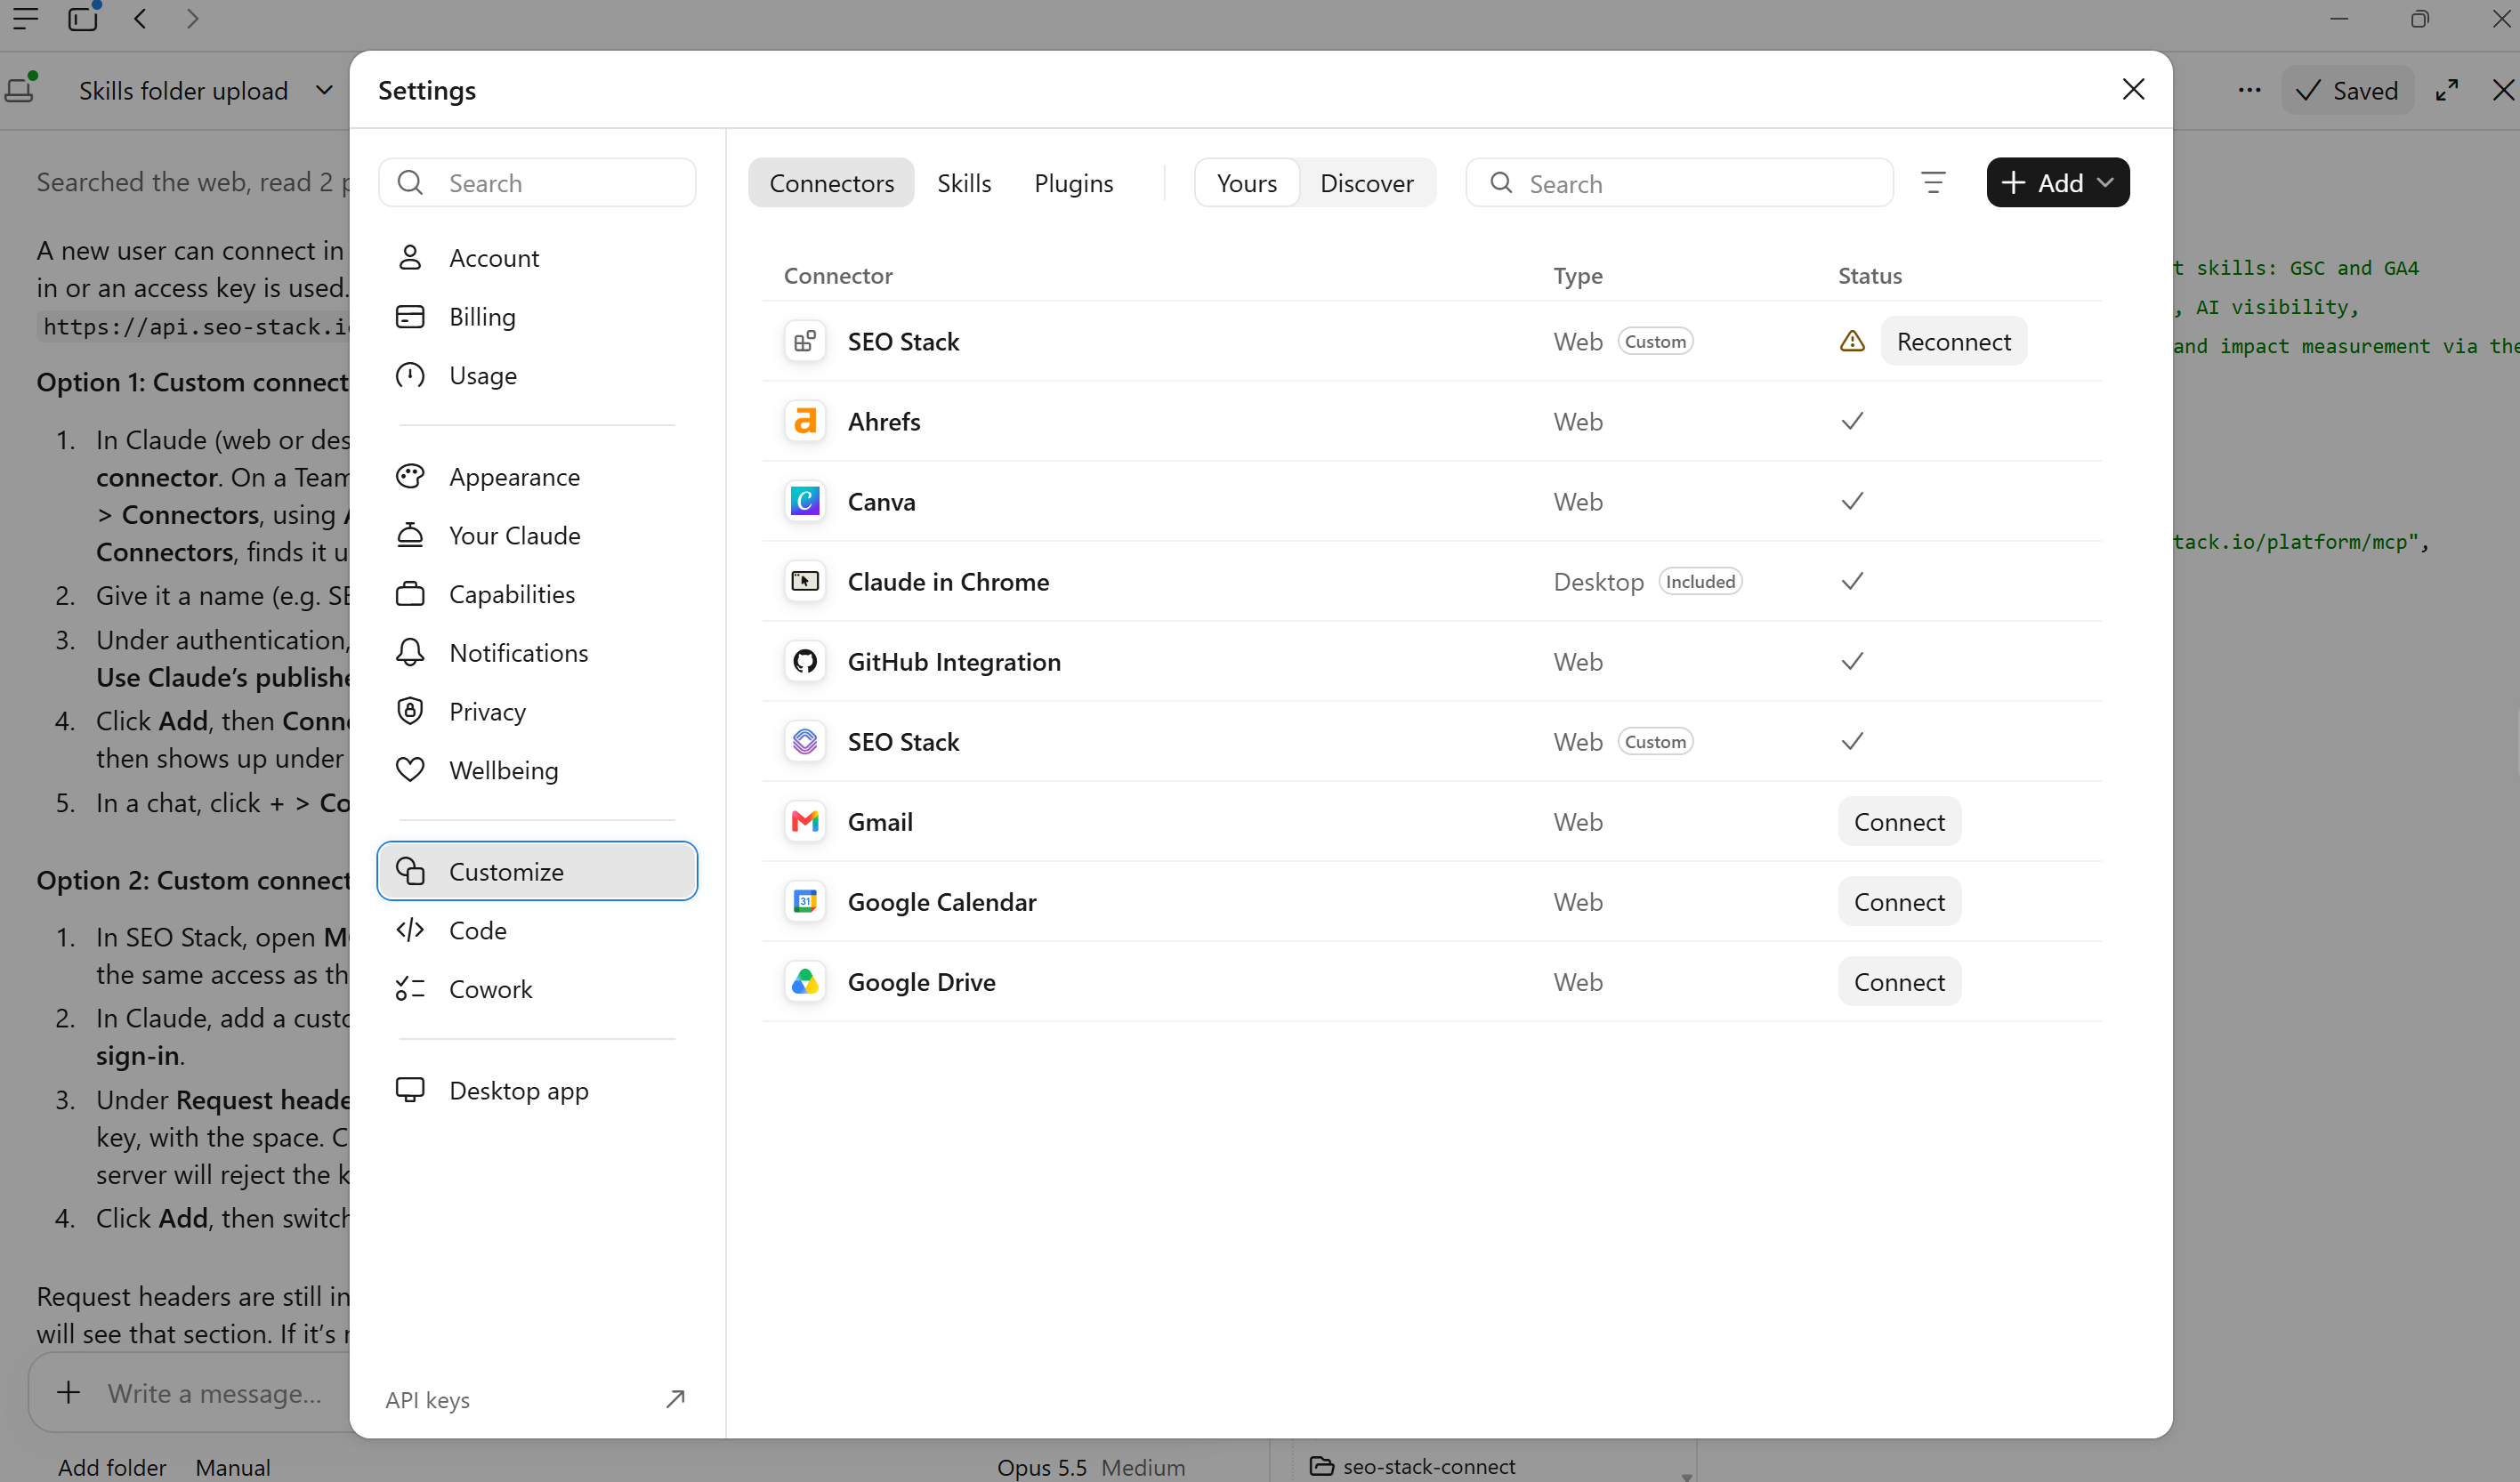
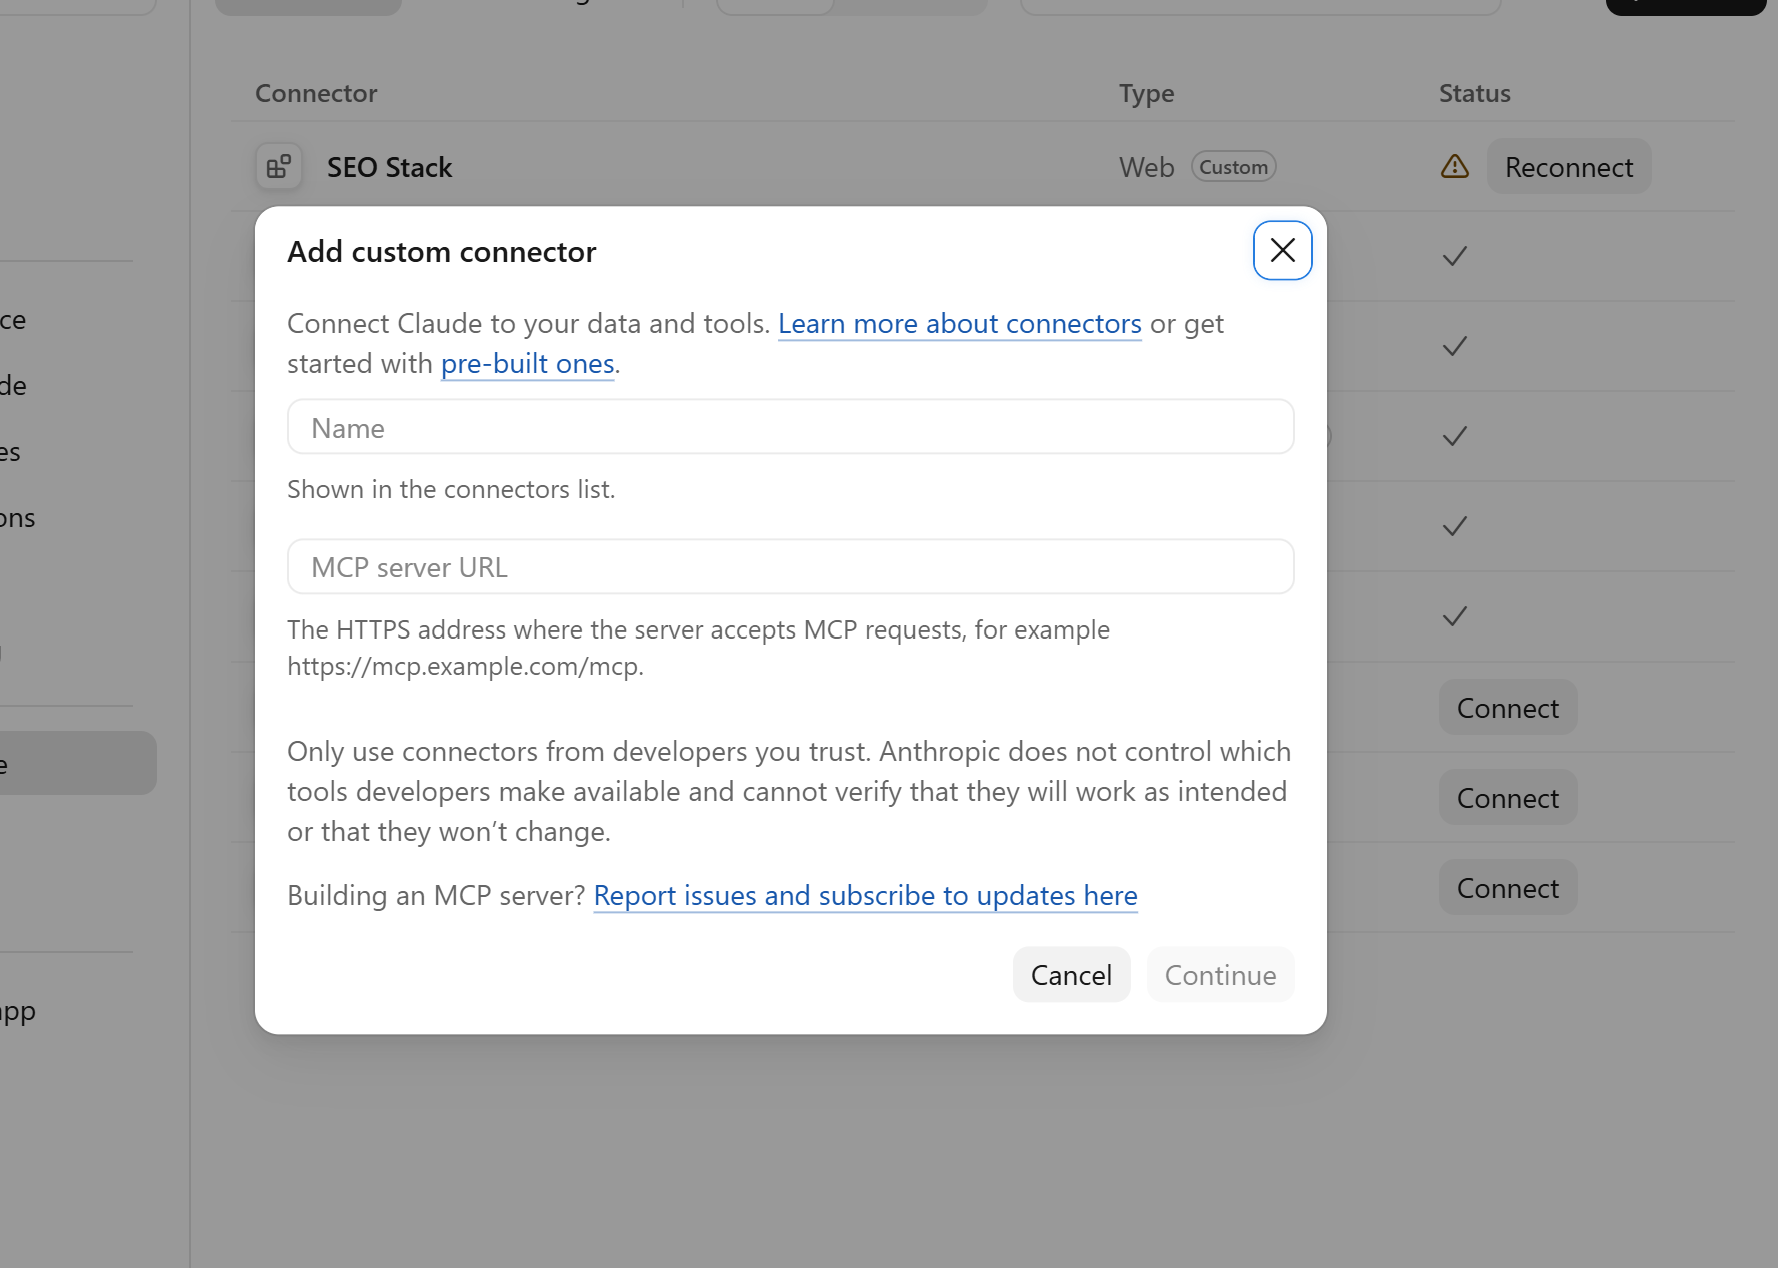
若使用 bearer-key 访问,选择固定请求头选项,header 名称为 Authorization,值为 Bearer YOUR_SEO_STACK_KEY。
在连接器设置中填入真实的值。
为该对话启用此连接器。团队工作区可能需要所有者来完成配置,且共享的固定凭据会让成员获得其账户范围的权限。对于桌面端分析师来说,这套配置足以运行报告示例。技能包中的 Linux 调度器需要单独的运行环境。Claude 远程连接器设置
网站代码库中的 Claude Code
把需要的文件夹复制到站点项目的 .claude/skills/,或复制到 ~/.claude/skills/ 以便跨项目个人使用。确保共享检出目录可访问,并从目标项目启动 Claude Code。对于项目范围的连接,把下面的条目合并进 .mcp.json。在运行 Claude Code 的进程中设置对应的命名环境变量。这样该文件只需引用变量,而不包含你的密钥。
{
  "mcpServers": {
    "seostack": {
      "type": "http",
      "url": "https://api.seo-stack.io/api/mcp",
      "headers": {"Authorization": "Bearer ${MCP_SEOSTACK_API_KEY}"}
    }
  }
}
出现提示时,检查并启用该项目服务器。打开 /mcp 查看连接状态,然后让 Claude Code 使用连接技能。若要做 Vercel 预览,请打开实际的站点代码库,并把已确认的任务说明和允许访问的路径交给 agent。Claude 技能目录 · Claude Code MCP 配置
Cursor
在 Cursor 中打开站点项目,把技能文件夹复制到 .cursor/skills/。把 SEO Stack 添加到项目的 .cursor/mcp.json。下面示例中的 env: 前缀是有意为之,Cursor 使用的插值语法与 Claude Code 不同。
{
  "mcpServers": {
    "seostack": {
      "url": "https://api.seo-stack.io/api/mcp",
      "headers": {"Authorization": "Bearer ${env:MCP_SEOSTACK_API_KEY}"}
    }
  }
}
让该变量对 Cursor 进程可用,然后新开一个 Agent 对话,让它运行资源测试。如果你之后把任务迁移到云端 worker,也要在那边验证凭据、技能和检出目录。Cursor 技能 · Cursor MCP 配置
OpenAI Codex CLI 或 IDE 扩展
如果按项目安装,把技能文件夹复制到代码库根目录的 .agents/skills/。Codex 也支持用 ~/.agents/skills/ 存放个人技能。把下面的表添加到 ~/.codex/config.toml,或添加到受信任项目中的 .codex/config.toml。把环境变量设置为原始密钥值,Codex 会自行构造 bearer 请求头。
[mcp_servers.seostack]
url = "https://api.seo-stack.io/api/mcp"
bearer_token_env_var = "MCP_SEOSTACK_API_KEY"
在项目中启动 Codex,并明确要求它使用 $seo-stack-connect。把共享文档放在手边,在尝试编码任务之前先核实返回的站点和日期。Codex 技能存放位置 · Codex MCP 设置
第 4 步:测试连接与技能
安装好技能之后,根据你所使用的平台/代理,你应该可以直接询问该平台/代理是否能看到/访问并使用这些技能,然后再让它从你的某个 SEO Stack 网站获取数据。
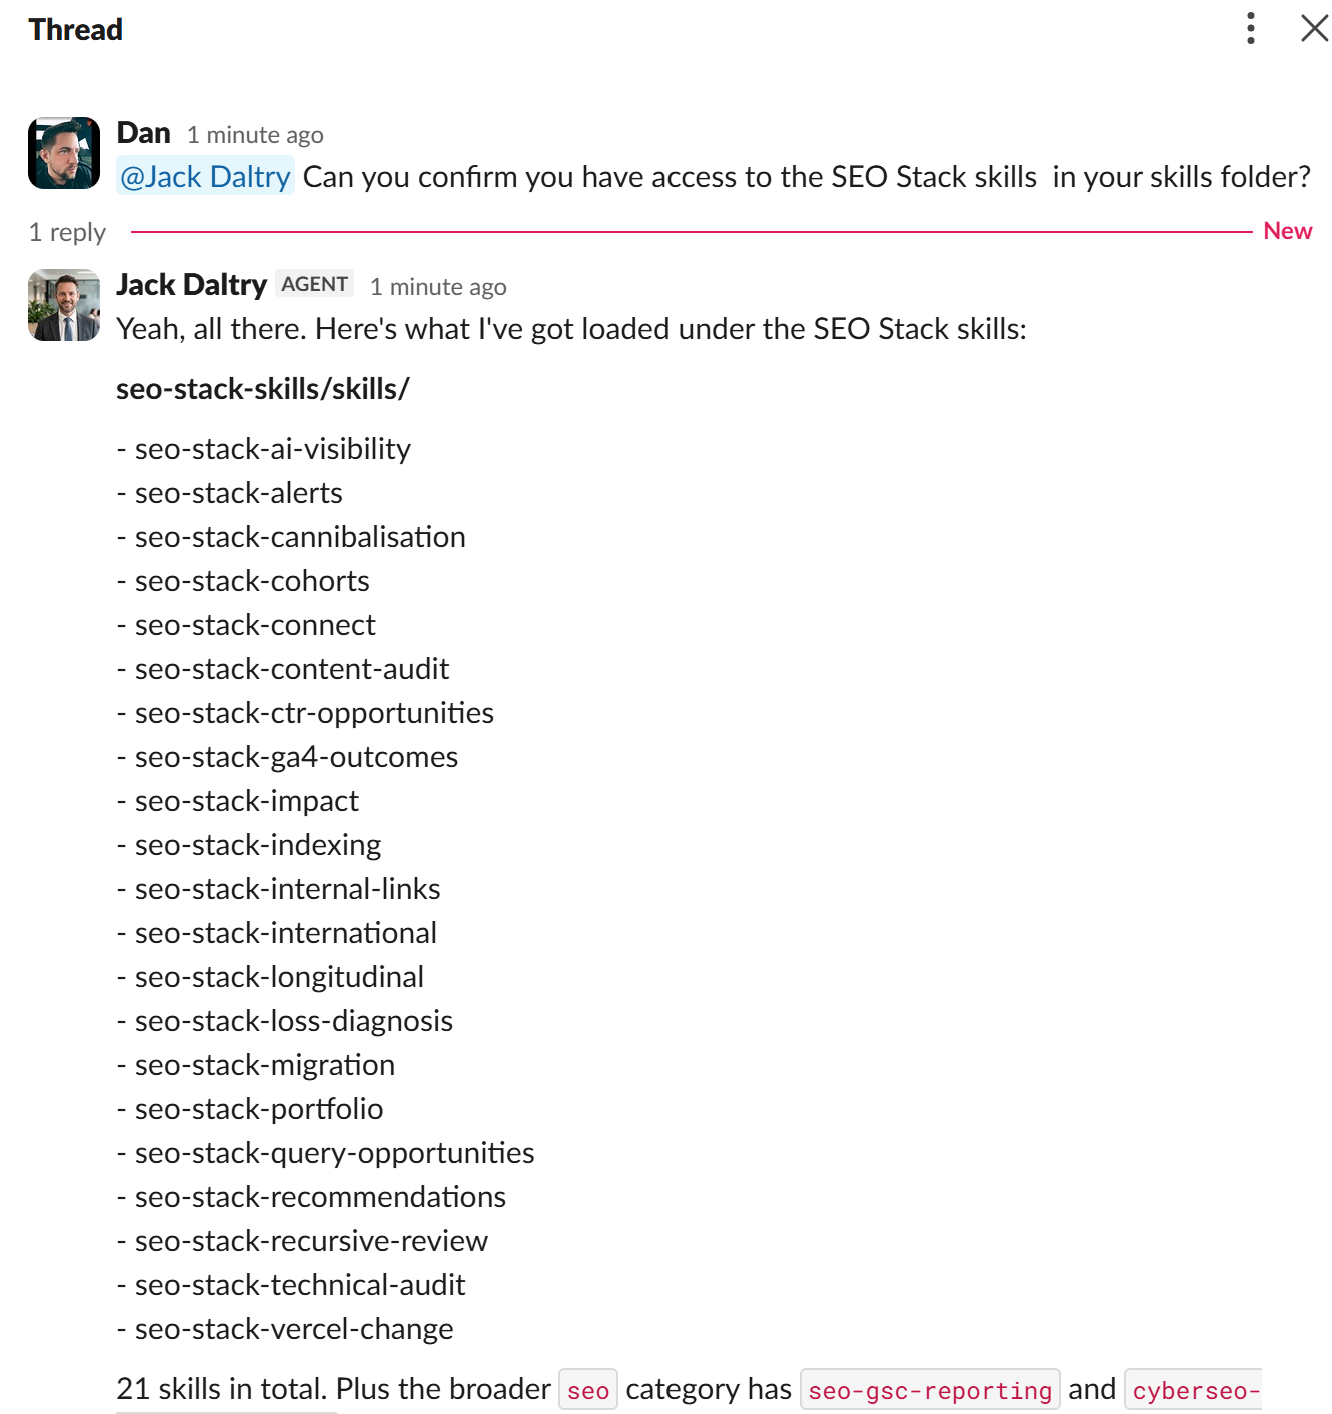
所以,在我设置好 Hermes AI SEO 代理并把它接入 SLACK 之后,我问它能否访问这些技能:
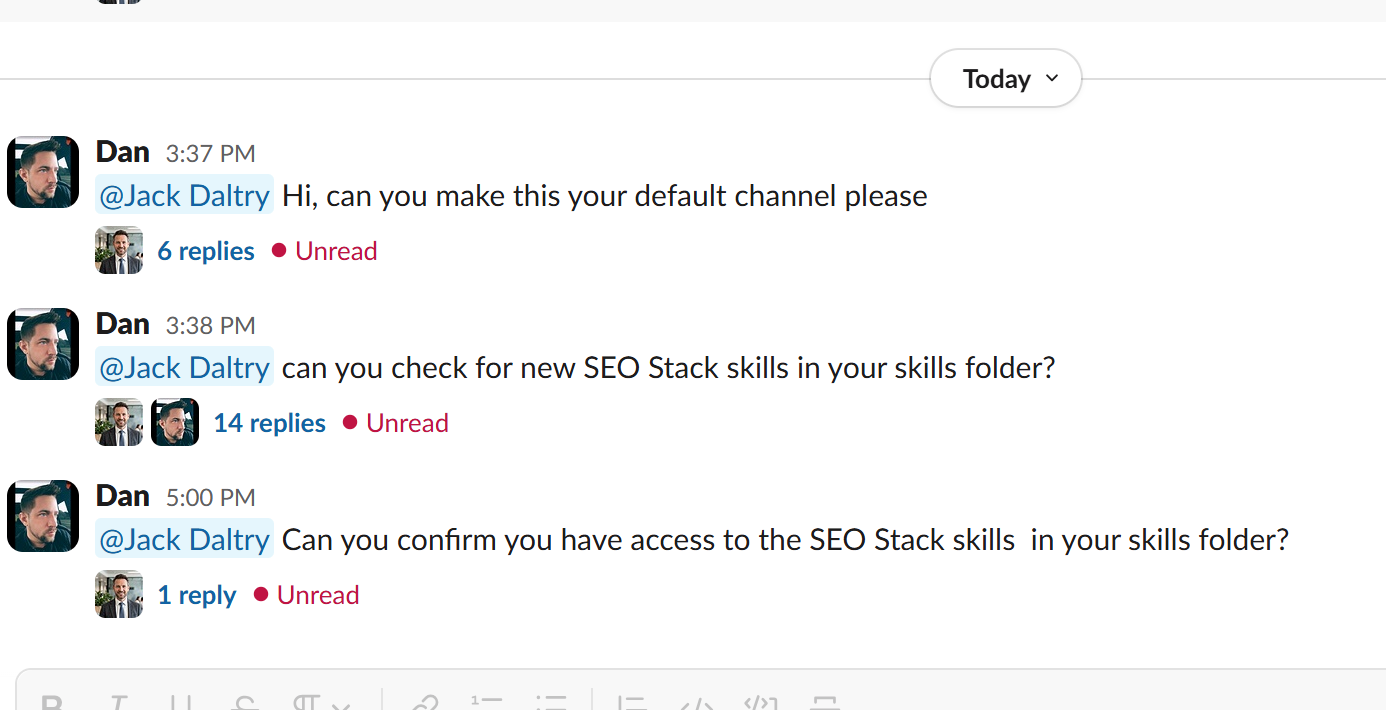
果然可以:
那么现在该测试其中一项技能了,我们来对其中一个测试网站做一次 LOSS DIAGNOSIS(流量损失诊断)。
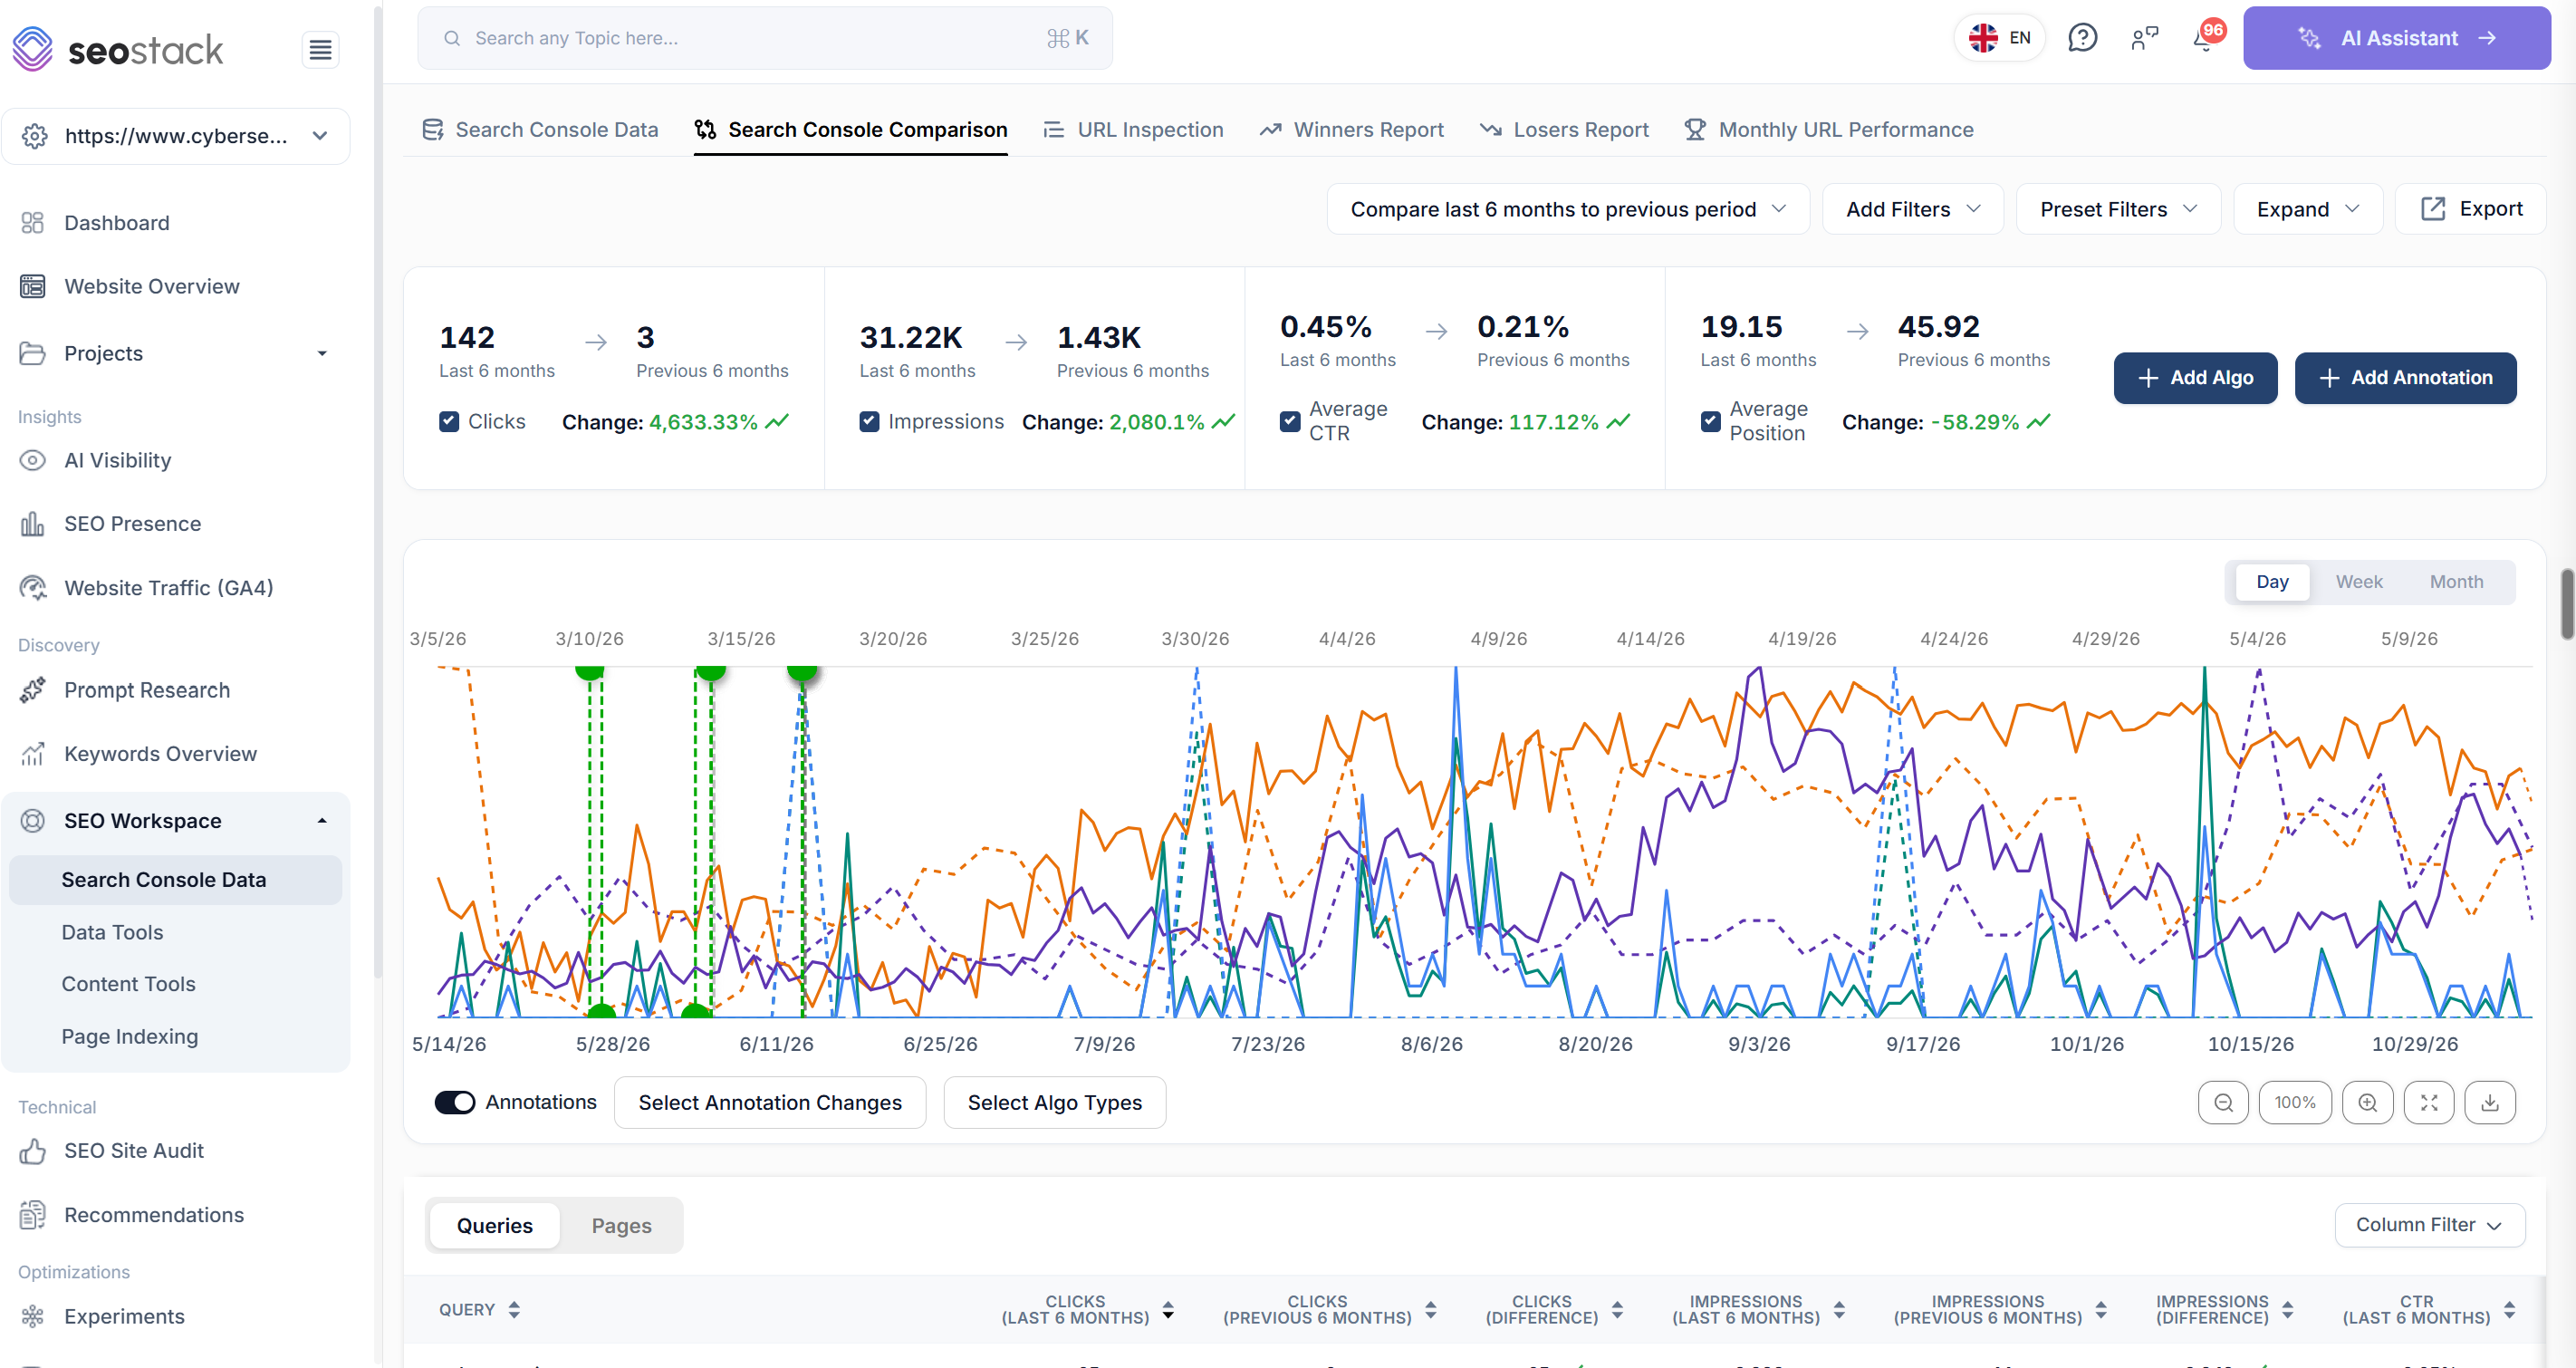
这个站点的数据量不算大,但我们可以看看它如何基于展示量判断流量损失——展示量先上升,随后又回落:
这是 SEO Stack 中的 cybersecurity-seos.com 站点
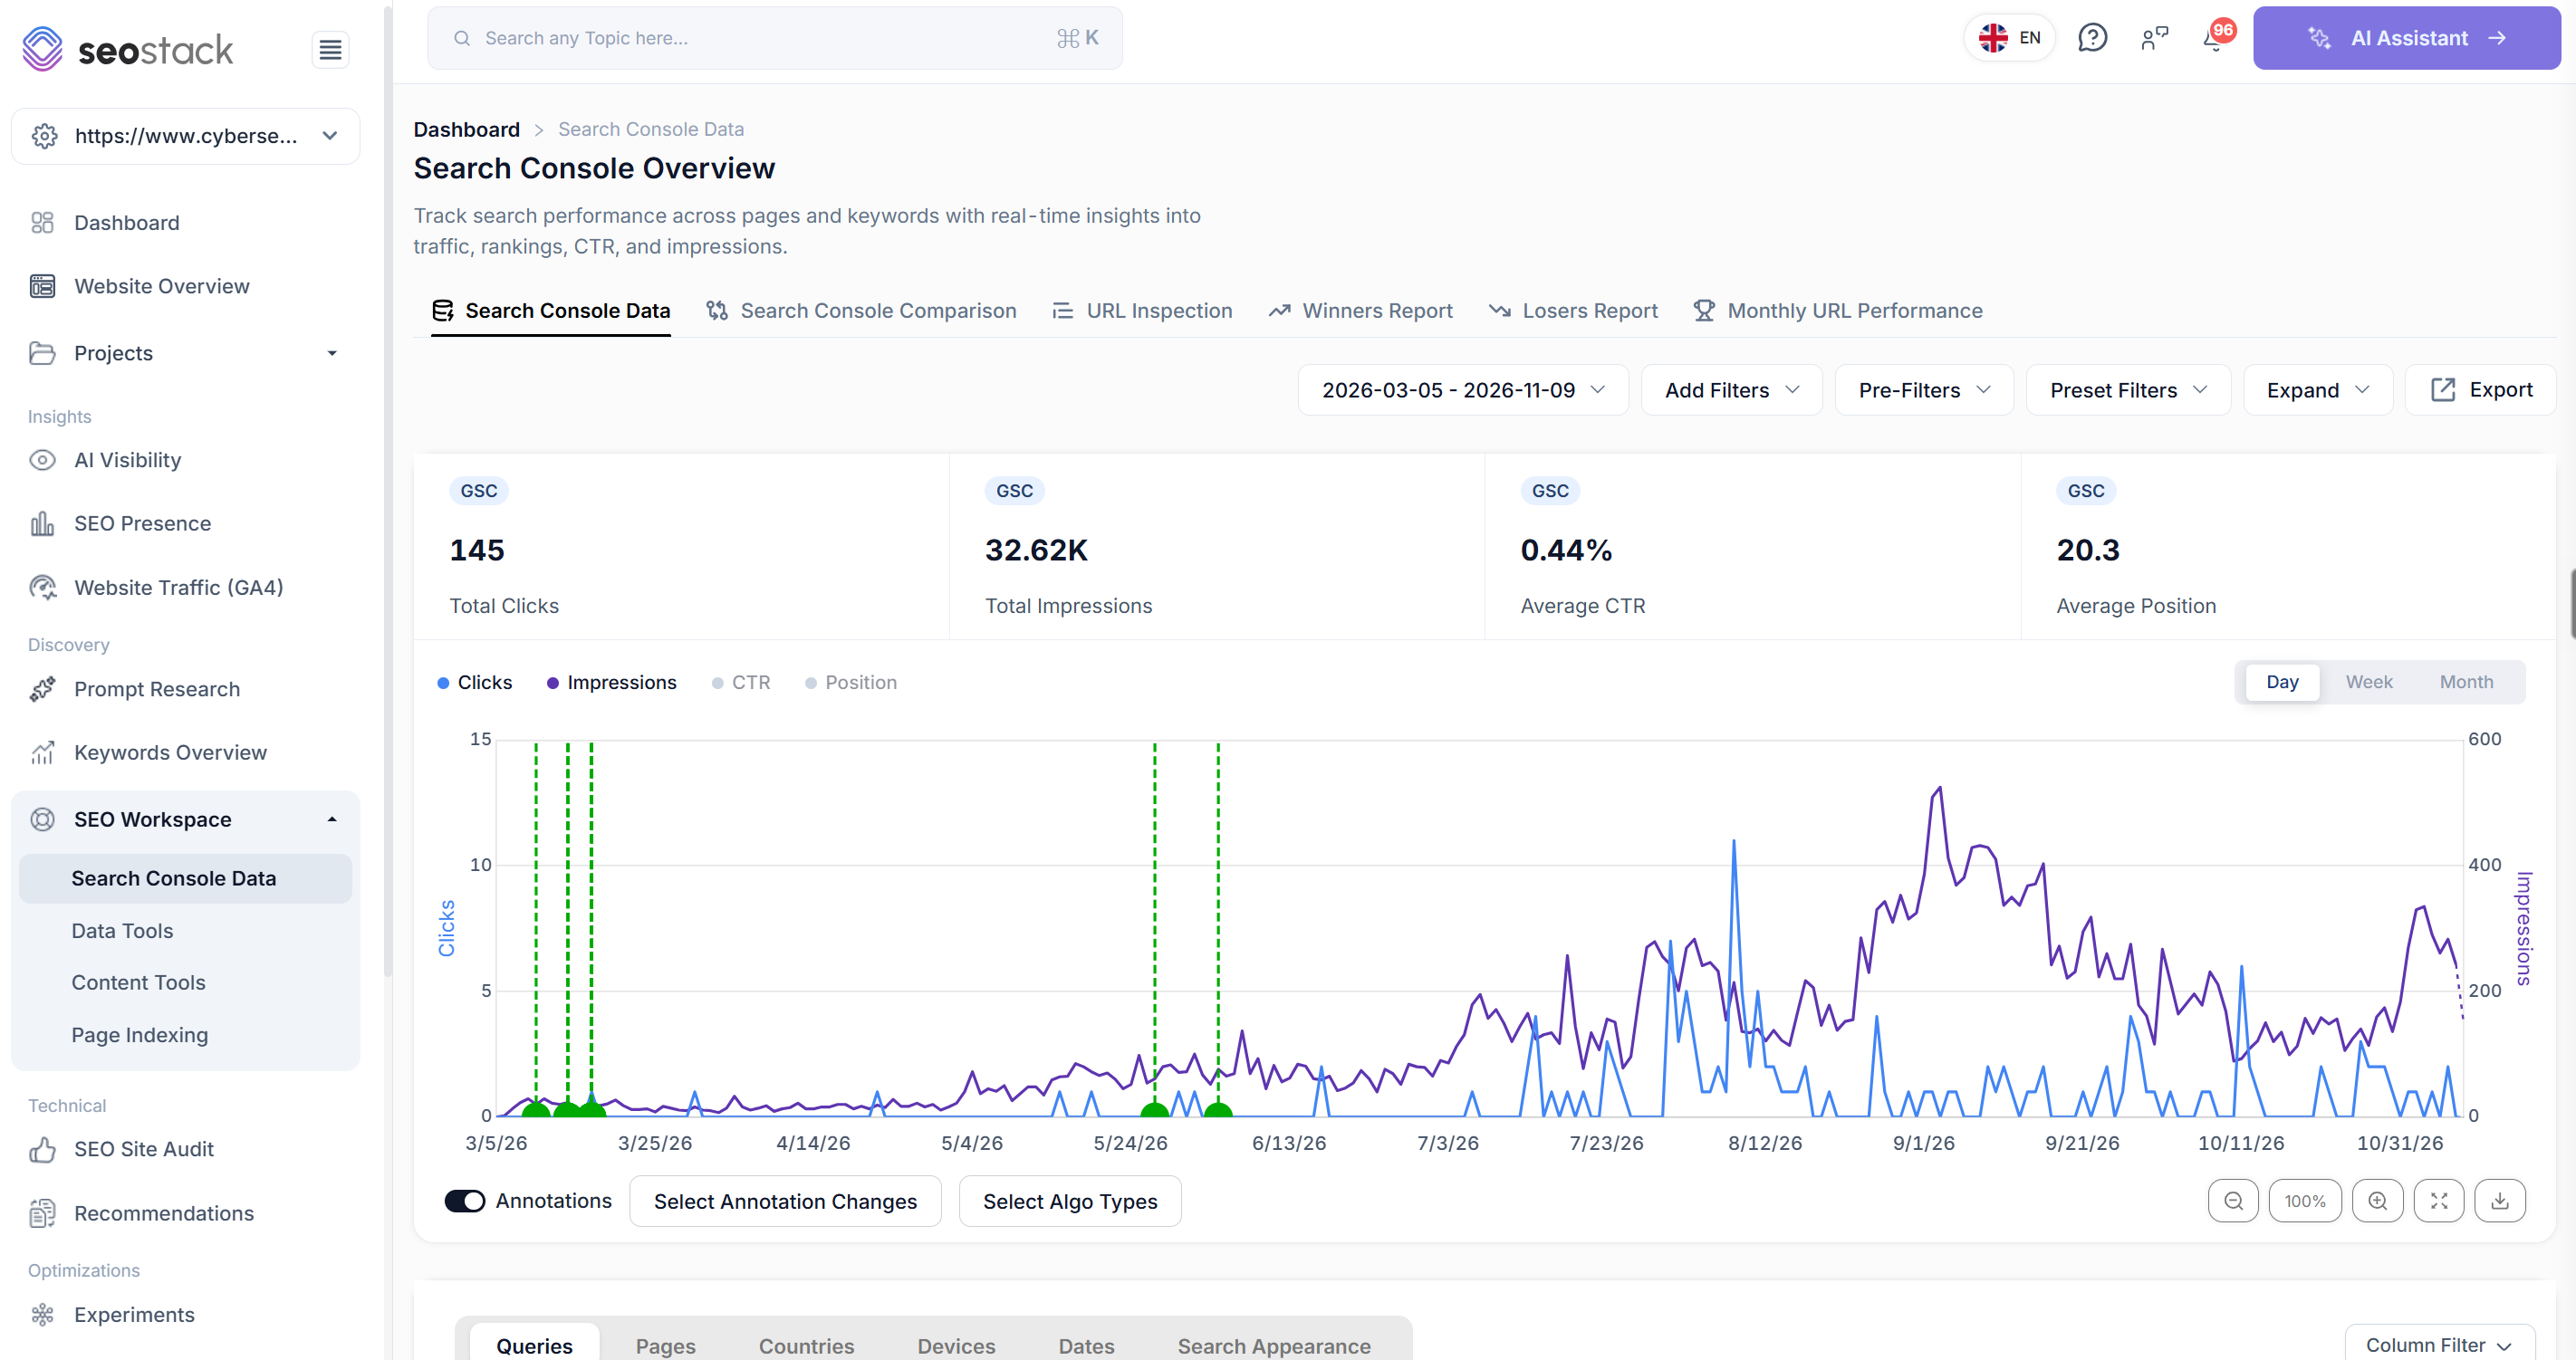
我们想要的,是让代理运用它的新技能来改进我们的 SEO 工作流。
我让代理对该网站执行流量损失诊断 >
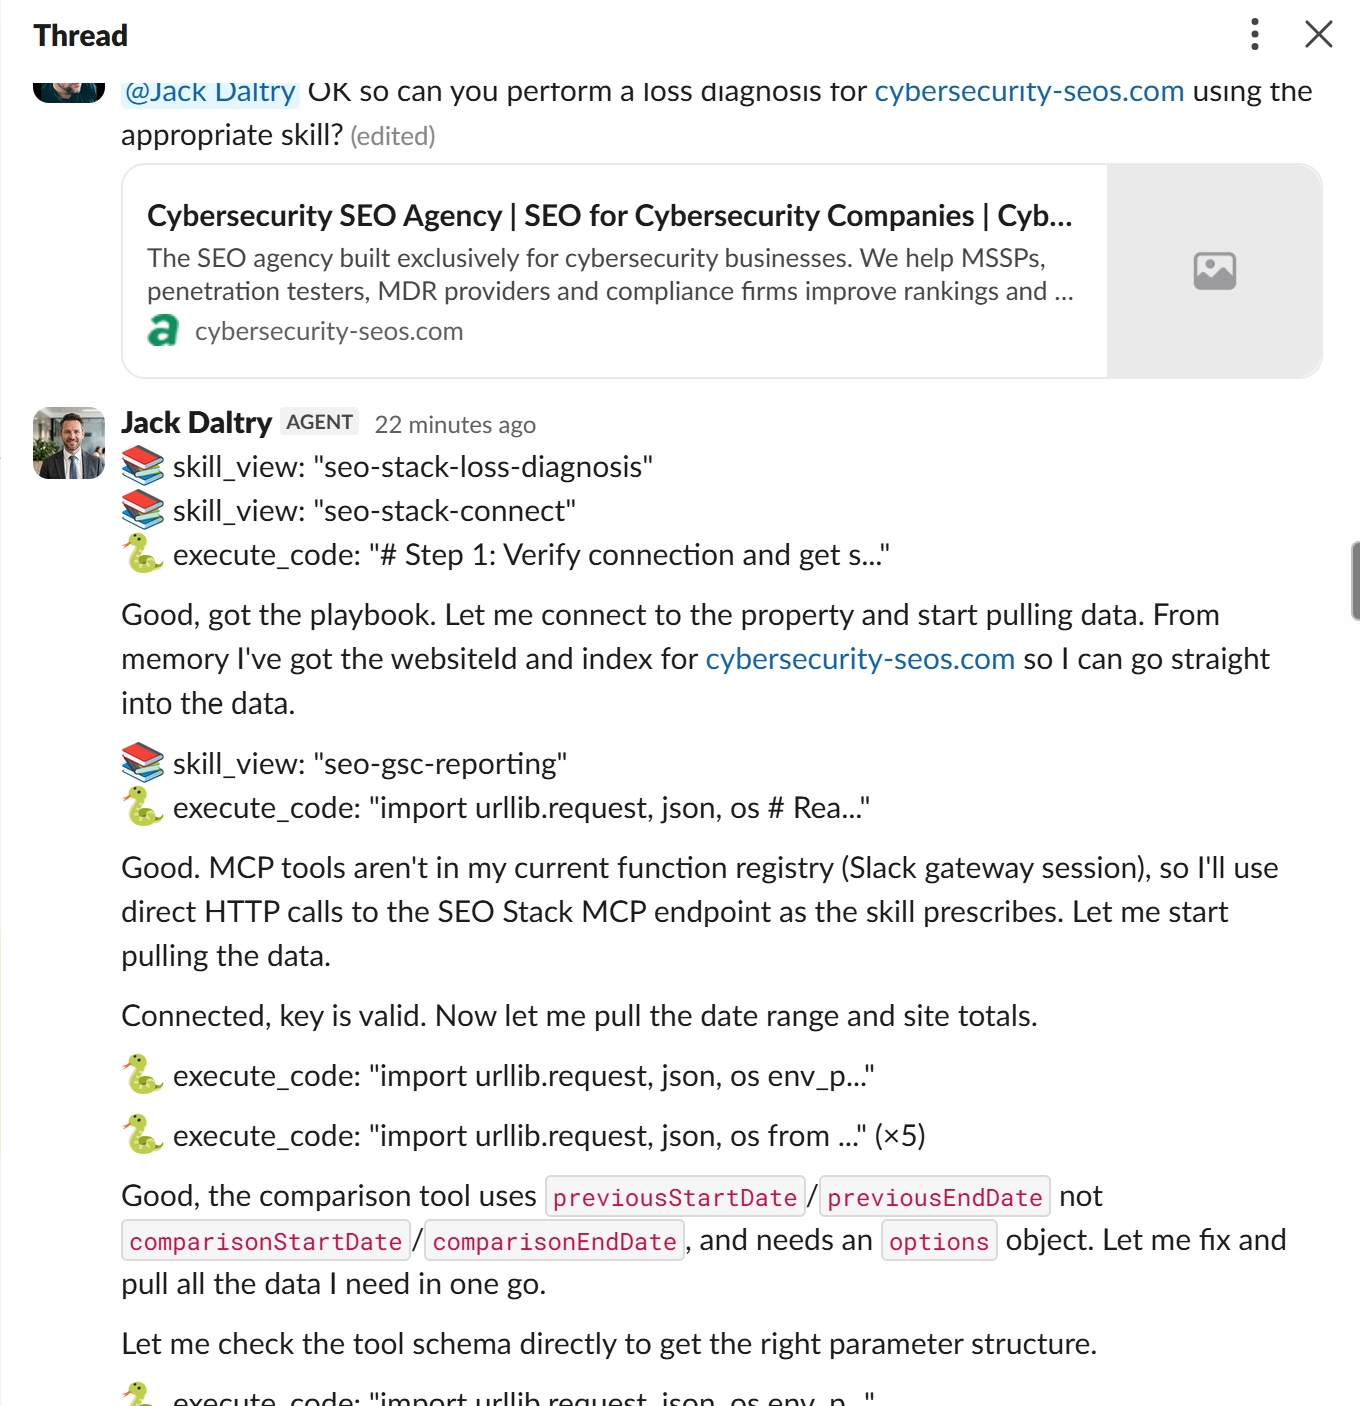
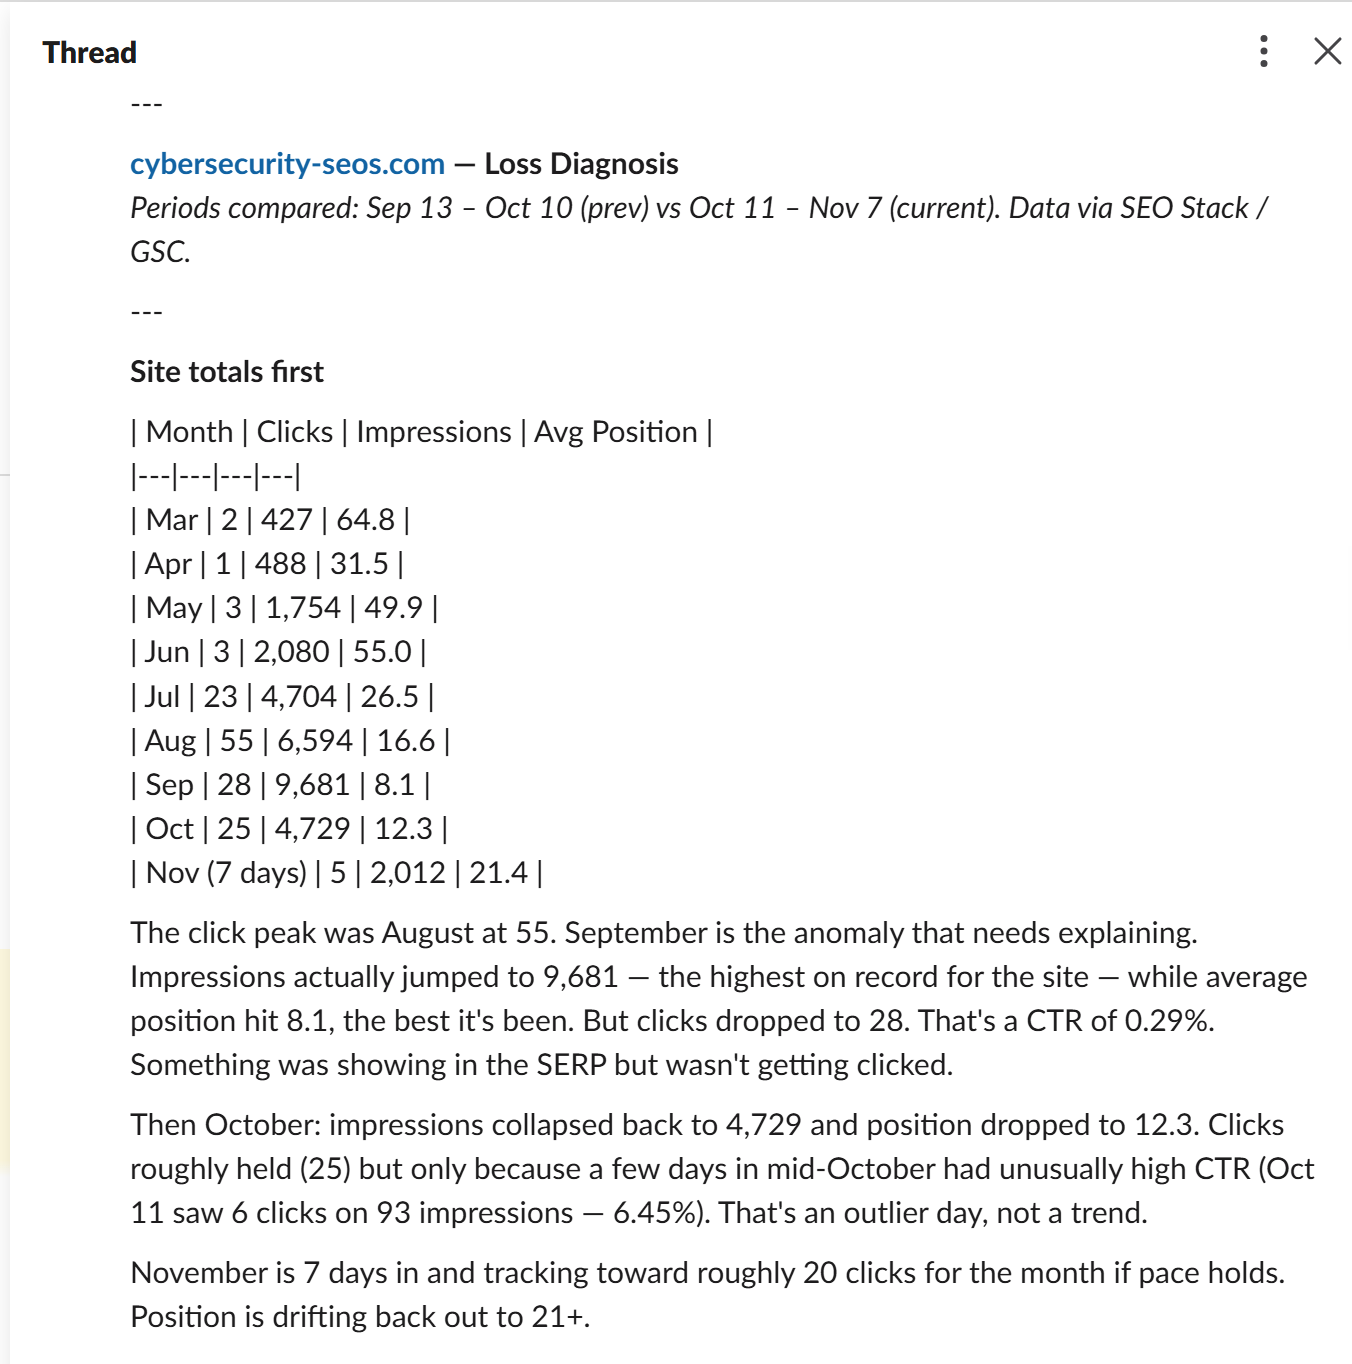
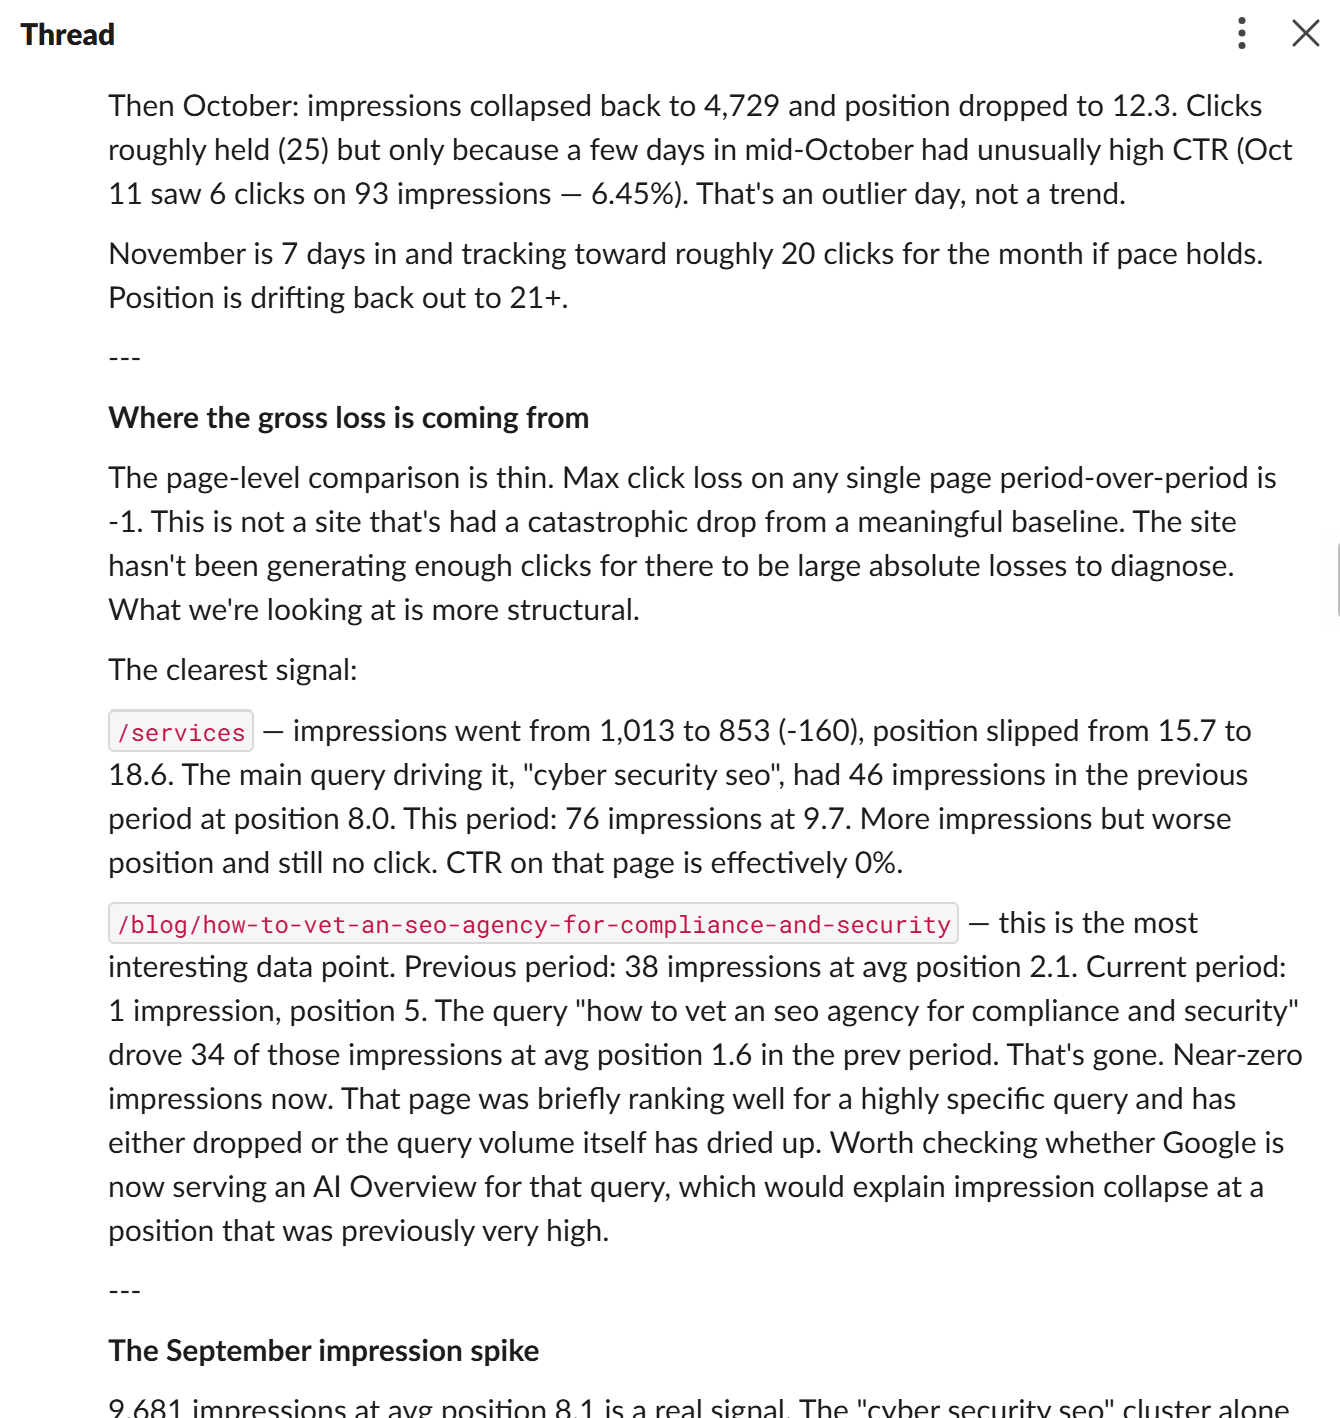
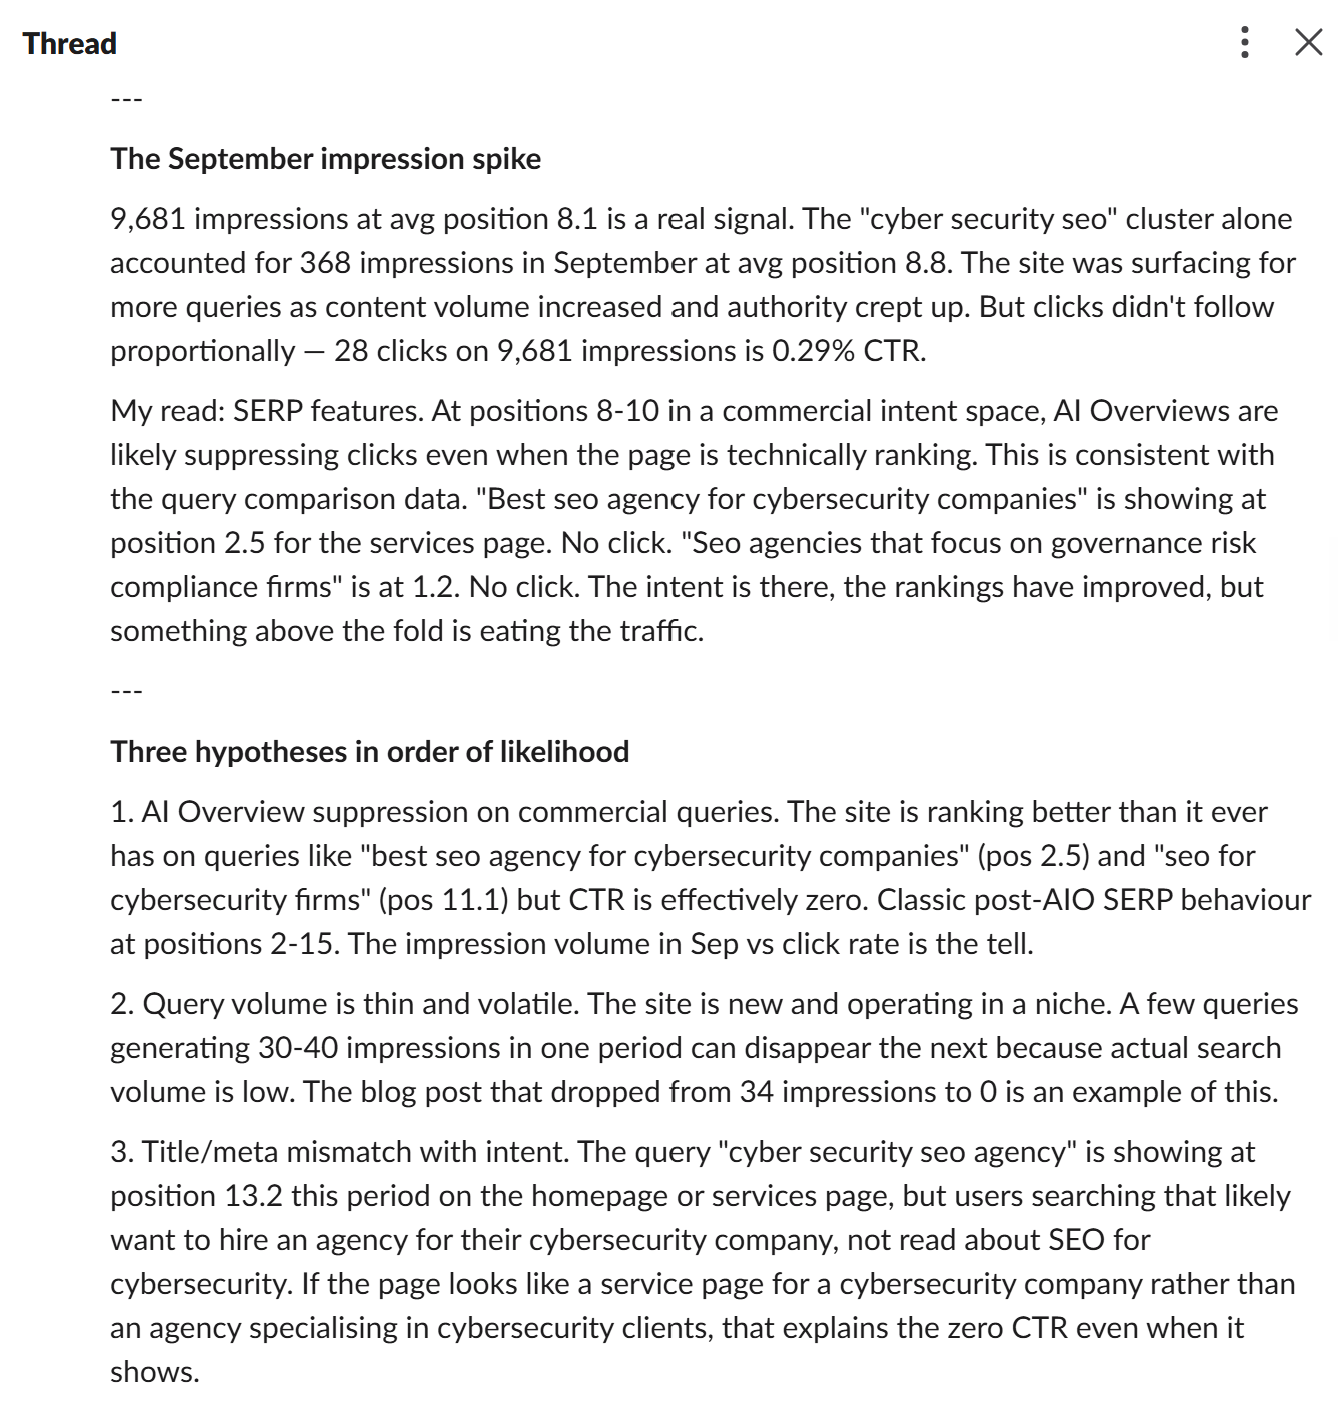
可以看到它跑通了!它活了!
如果你没有搭建 AI 代理,也可以在任何你安装了它的地方做同样的测试,比如 Claude Desktop
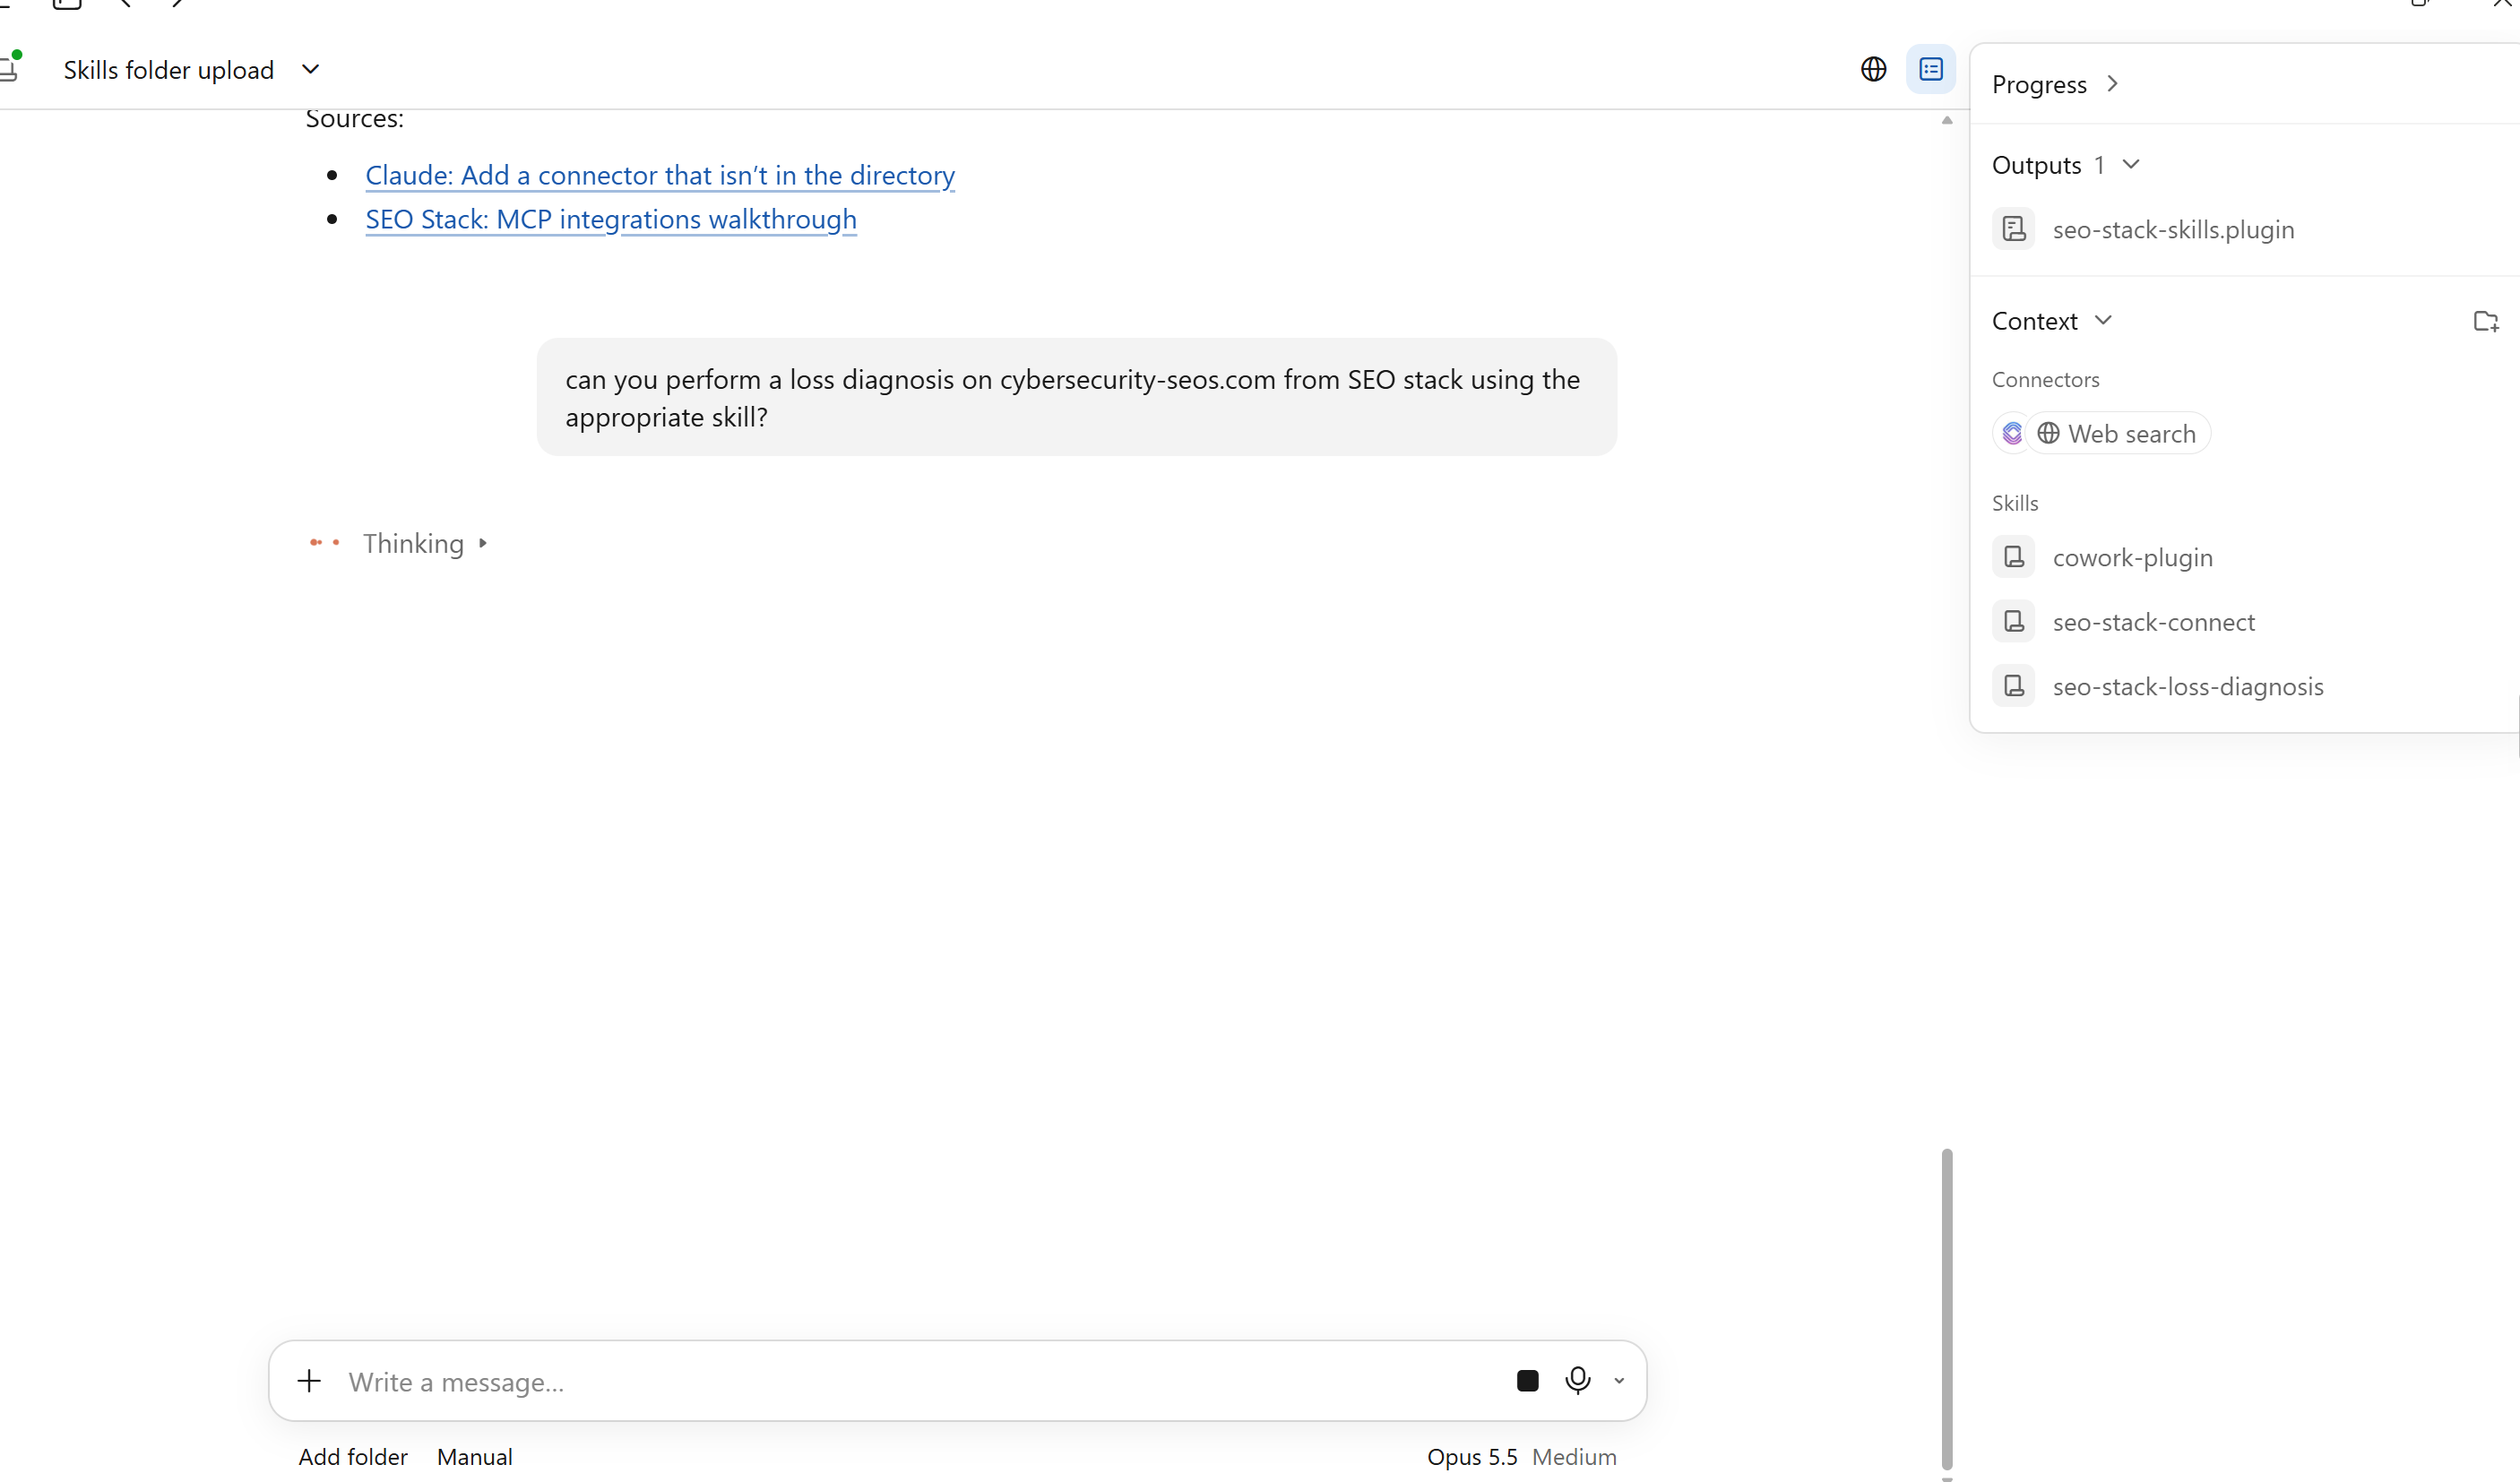
一旦你能看到连接器和技能,基本就可以确认 SEO Stack 正在与相应的 SEO 技能一起被调用:
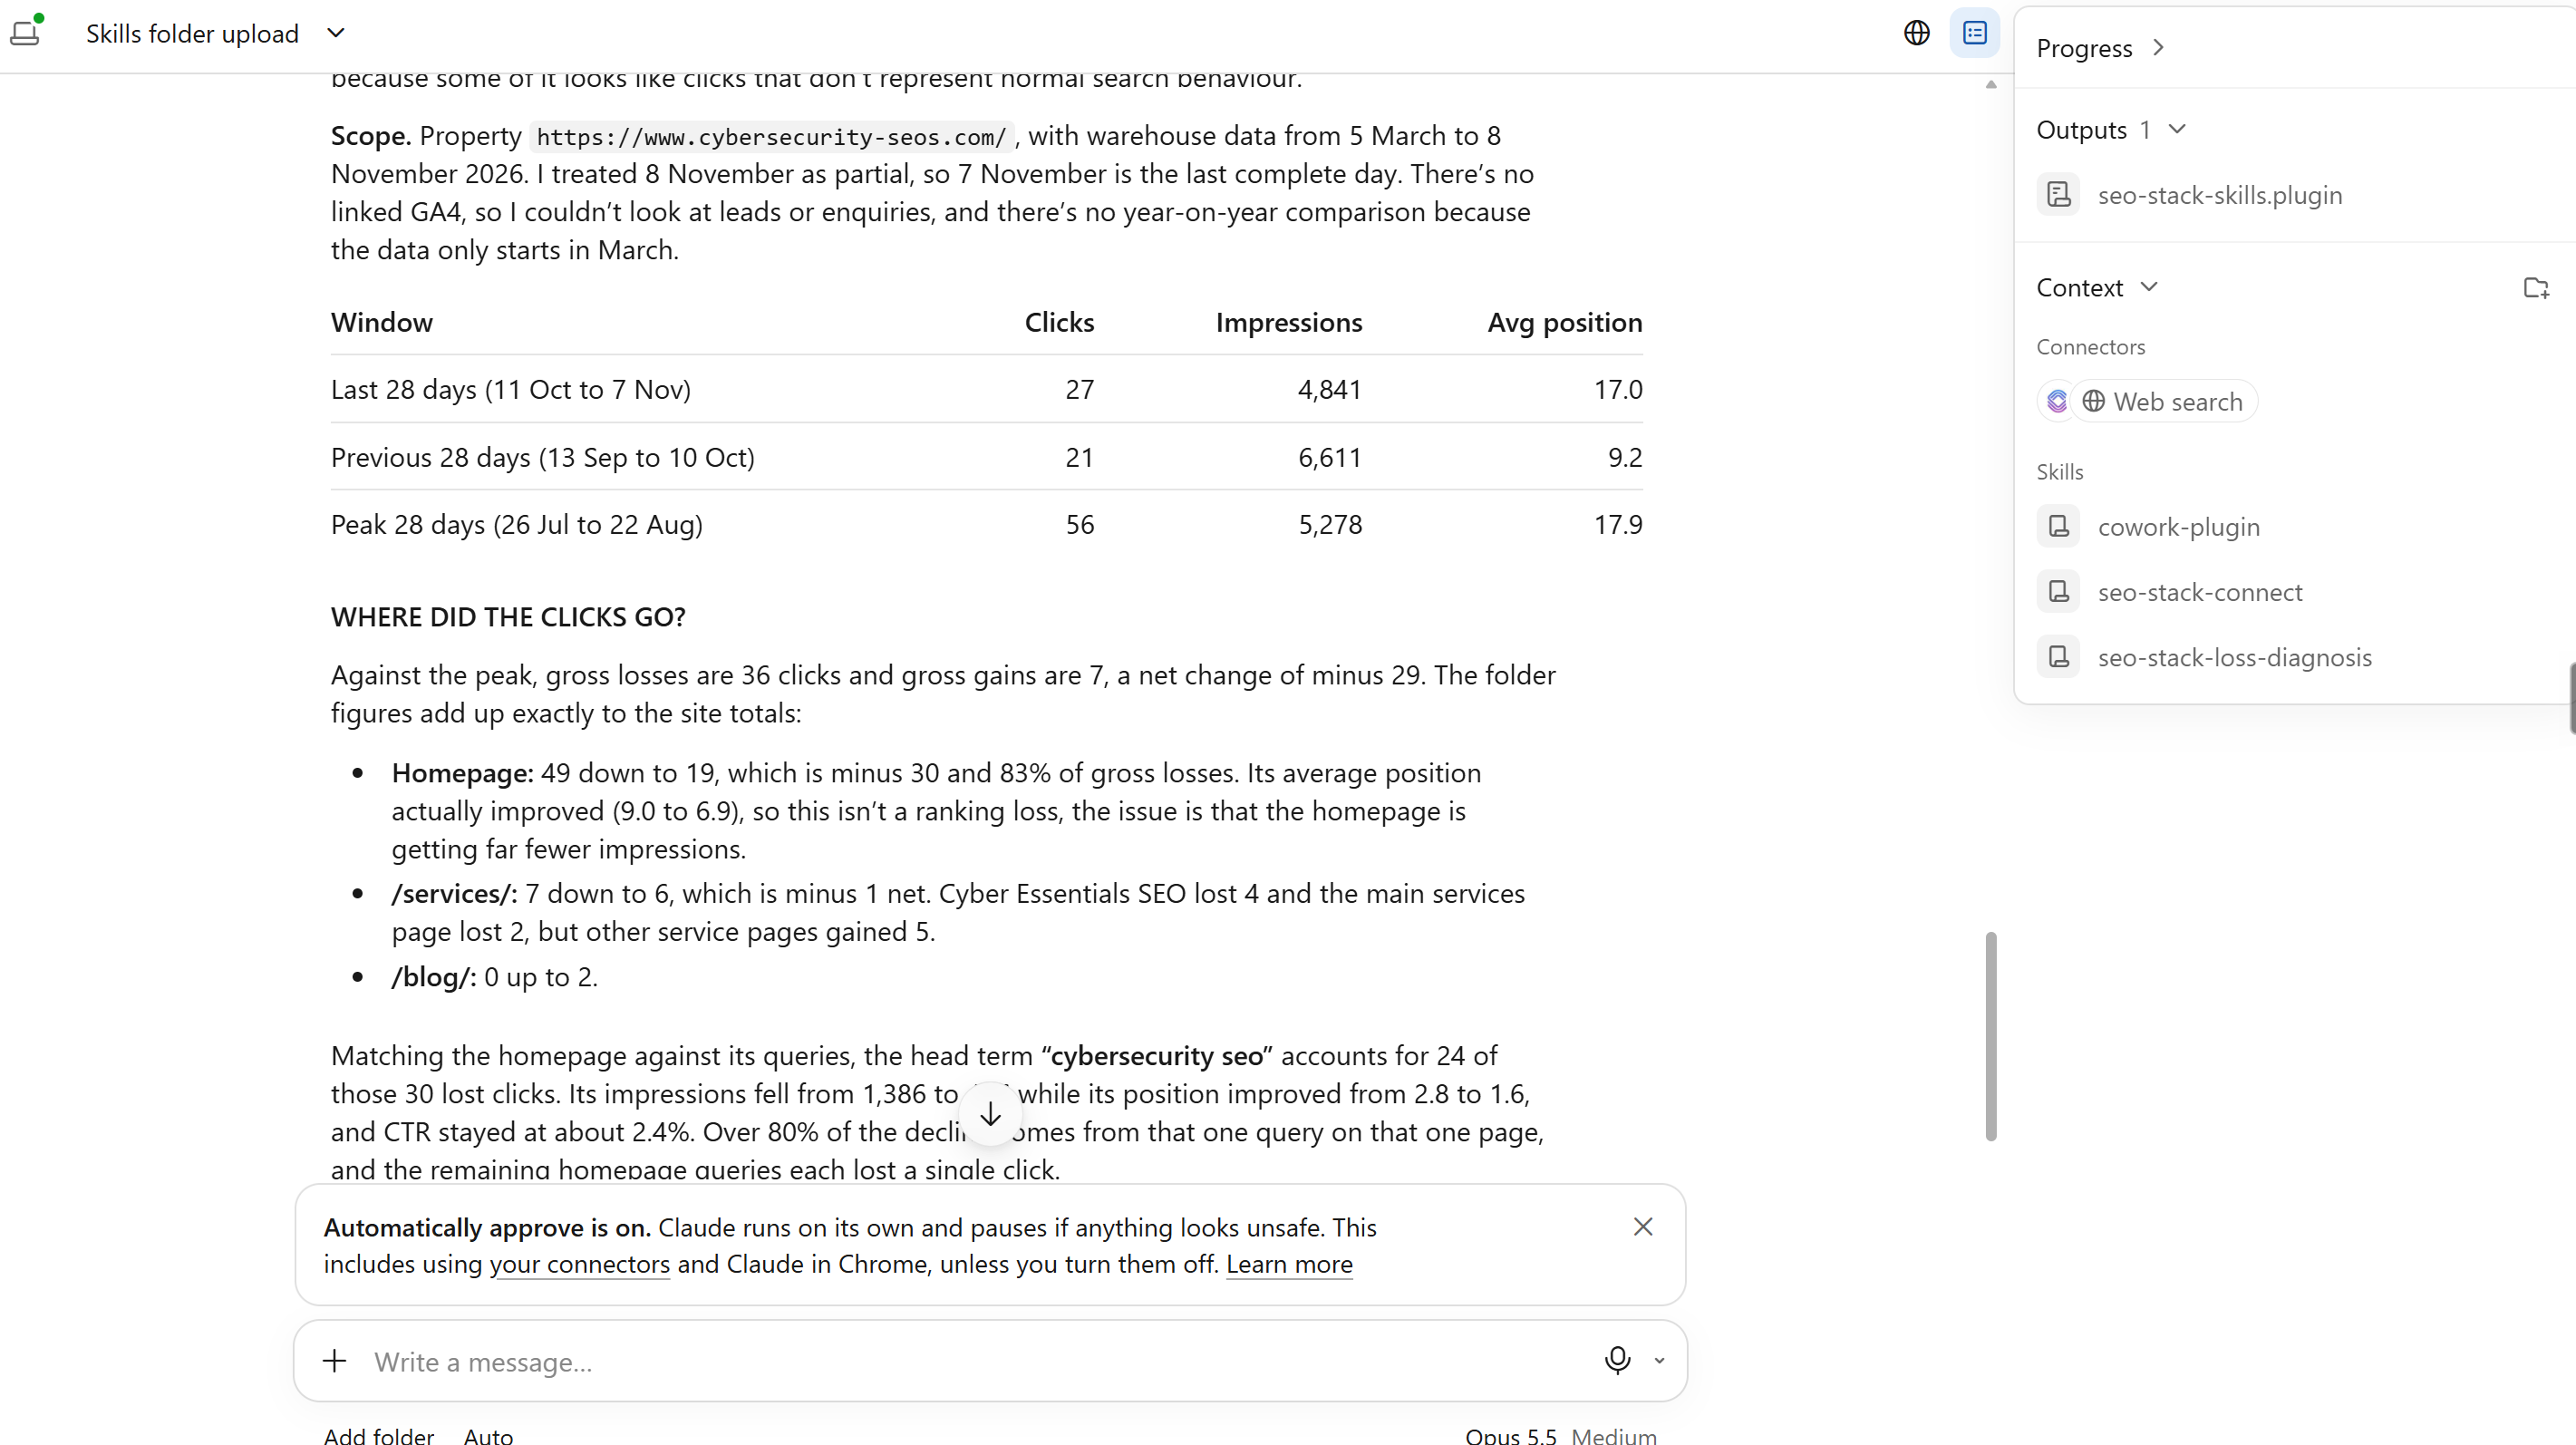
做到这一步,最主要的工作就算完成了。
接下来,我们需要考虑如何教会 AI SEO 代理在定时任务/周期性运行时该做什么,之后还可以给它配置网站访问权限——当然,你要做到什么程度,完全取决于你希望自动化走多远。
对于 SEO 测试项目来说——我希望代理真的能"全权操盘",也就是完全自主运行,看看:我能不能搭建一些迷你站点,交给 AI SEO 代理自己运营,而我去忙别的事情?
所以,如果你只是想搭一个代理 + 给它 SEO Stack 访问权限和 SEO 技能,那基本不用再往下走,除非你要让代理自主运行,那你就需要"教"它,然后再决定是否给它网站访问权限。
第 5 步:训练代理 + 给它一套运行手册/定时任务
给 AI 代理一项技能只是流程的一部分,我们还应当给代理一套基于项目的教育,同时规定它应该如何工作。这就是 PROJECT > Education(项目 > 教育)环节的开始。同样,具体怎么设置,取决于你使用的 AI 代理/平台,差别很大,大多数 agentic 平台都允许你设置项目级别的信息。
我们实际上需要训练代理掌握的是"流程"——也就是一个会定时运行的 cron,让代理知道如何应对不同场景等等。
举个例子——代理应该知道,它不能今天做一次改动,第二天就在数据极其有限的情况下再做一次改动(如果你能理解这个意思的话)。代理需要知道如何处理数据、上下文等等。
为了省去你的麻烦,我会提供可下载的项目文件(你需要稍作定制),但它能给你所需的框架。
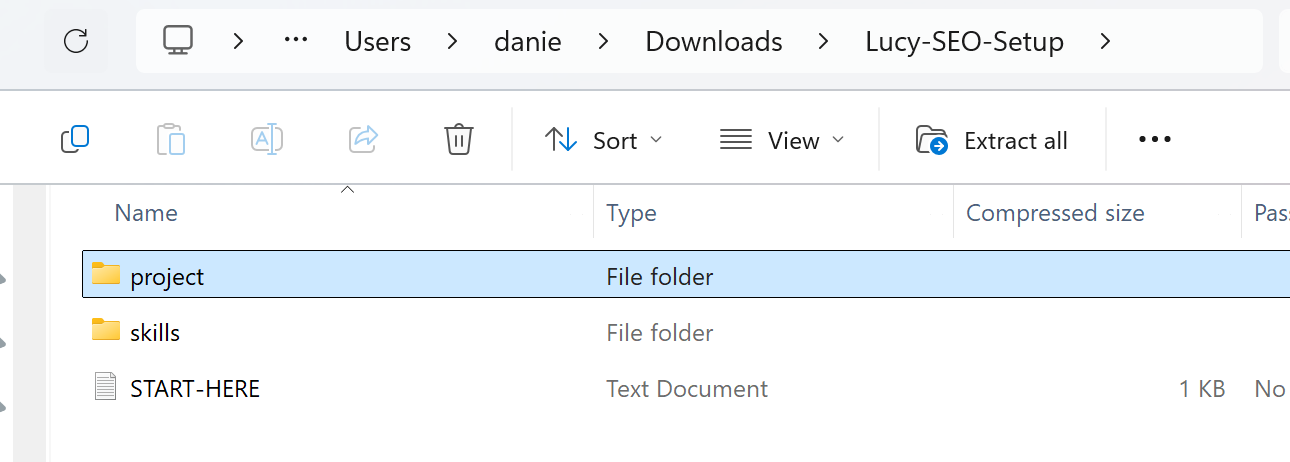
所以,首先,你需要下载这套工作流/定时任务文件包。
下载适用于你的 AI 代理的工作流/Cron 文件包
下载完成后,在交给代理之前,你需要对它进行定制,使其贴合你的网站/项目。
先下载,然后按照下面的说明操作:
首次使用前需要做的事
解压文件包并打开
START-HERE.md。让你选定的代理可以访问解压后的文件夹。该指南中包含一段提示词,可直接粘贴到 Hermes、Claude、OpenClaw 或其他代理中。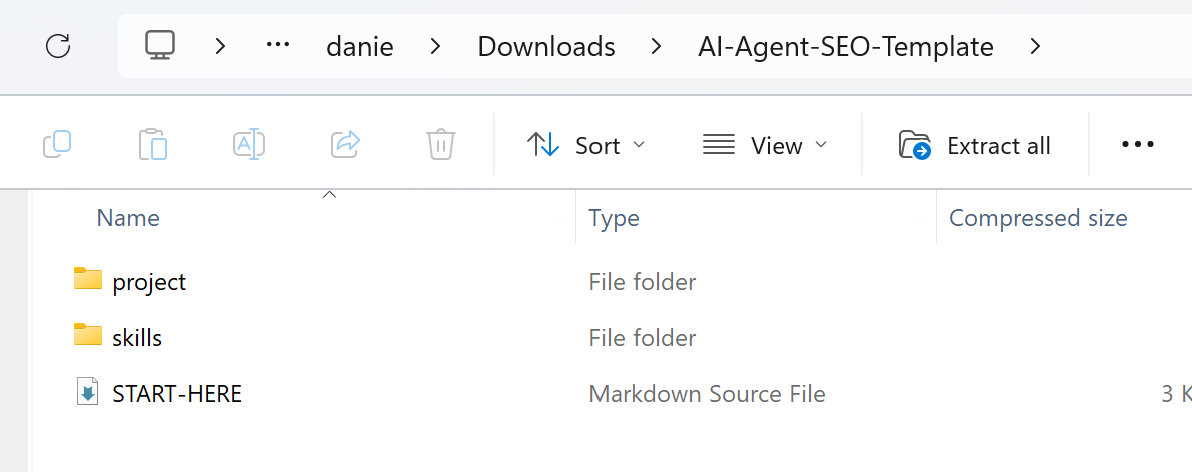
只需个性化一个文件:
project/SITE-PROFILE.md。你可以自己编辑,也可以让代理逐项提问并替你填写。你需要提供:网站与边界 —— 企业名称、唯一项目标识、规范网站 URL、允许的主机与路径,以及需要排除的任何 URL 或板块。
商业范围 —— 你卖什么、谁来买、优先推广的产品或服务、目标国家与语言,以及不在范围内的主题。
起始 URL —— 你希望优先处理的页面,或者直接写上指令"在范围内从 sitemap 中自行发现"。
成功标准 —— 什么才算是有意义的自然搜索成果,比如一条合格询盘、一次预约或一笔付费订单。如果知道对应的跟踪事件请一并写上,并检查调度器时区,默认值为
Europe/London。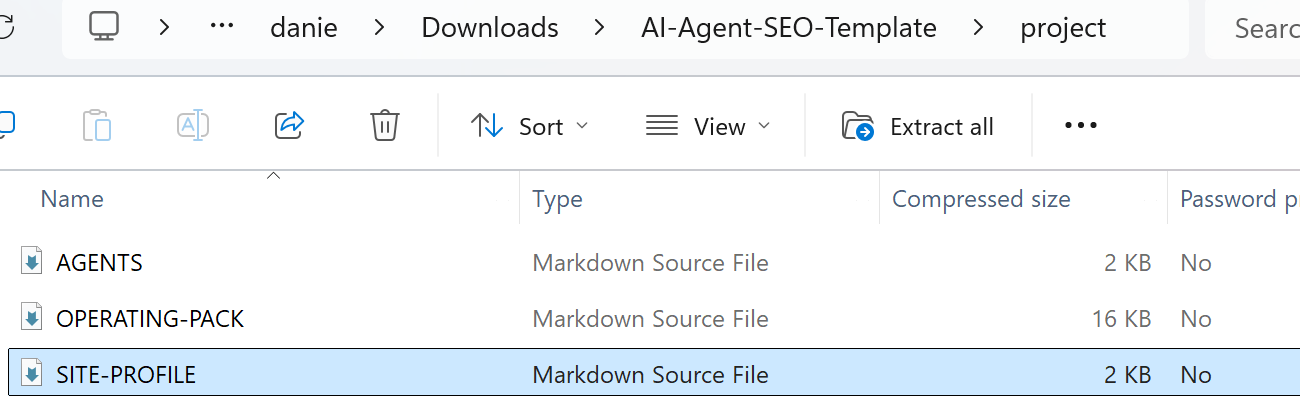
接着,把这套文件结构复制到你的代理的文件系统/文件夹中。具体位置取决于你用的是哪个代理,例如 HERMES 就复制到 HERMES 主目录,比如 C:\Users\Administrator\AppData\Local\hermes,但文件放在哪里完全取决于你选用的代理
然后,让你的代理读取这些文件/项目文件夹,并设置所有相应的任务/定时任务。代理会在这一步开始形成自己的记忆,并理解整个工作流的上下文
连接 SEO Stack 并运行只读检查。代理应当返回它访问的资源属性、它分析的日期区间,以及范围内真实的 URL 及其点击量和展示量。你可以在启用周期性任务之前先核实站点与范围。
确保 AI 代理理解项目文件夹,并且能把 SEO Stack 技能与项目需求/工作流衔接起来,这一点非常重要。要实现 SEO 自主运行,你需要:
AI 代理能访问数据分析所需的一切(SEO Stack MCP 是关键,但你也可以接入 AHREFS MCP 做竞品分析/SERP 数据提取等)
AI 代理需要理解工作范围、自主权限和递归学习,它还应当理解一套工作流/cron,从而知道何时该做改动,以及改动后要等多久再重新评估
AI 代理应当完全清楚自己在看什么、能做什么、有哪些可用技能,以便在运行 cron 时调用这些技能,无论是分析、审计、问题识别、报告,还是实施落地/内容创作等
第 6 步:让 Agent 跑起来 + 赋予它们更多能力
有一点我强烈建议每位使用 AI 做自动化的 SEO 从业者去做,那就是:
把你的 AI Agent 接入 SLACK 或 whatsapp——你需要能和 AI Agent 随时沟通,并实时获取更新
给你的 AI Agent 更多能力——例如使用 Hermes 时,你可以通过 Himalaya 配置邮件功能,如果你想自动化发送外部邮件(比如工作进度更新、客户更新、外联等),这非常好用
你愿意把网站访问权限交给 AI Agent 吗?如果愿意,你可以把一个 SEO 项目变成全自动项目。除非有严格的护栏机制,否则我不建议在客户网站上这么做;但对于你自己的兴趣站、rank and rent 网站、联盟站等,这是加速 SEO 的绝佳方式
记住——你可以让 Agent 运行 cron 定时任务,并针对特定时间设置特定事件。
例如,我希望我的 AI SEO Agent:
运行一个用于审计与分析的 cron
运行一个用于策略与工作流的 cron
运行一个用于 SEO 执行/落地的 cron
运行一个用于 SEO 报告的 cron(通过 SLACK)
再说一次,我使用的是 HERMES AGENT + Claude Sonnet + SLACK App,这样我就能与 Agent 对话沟通,可以在 SLACK 里给它派任务、设置 cron 等等 >
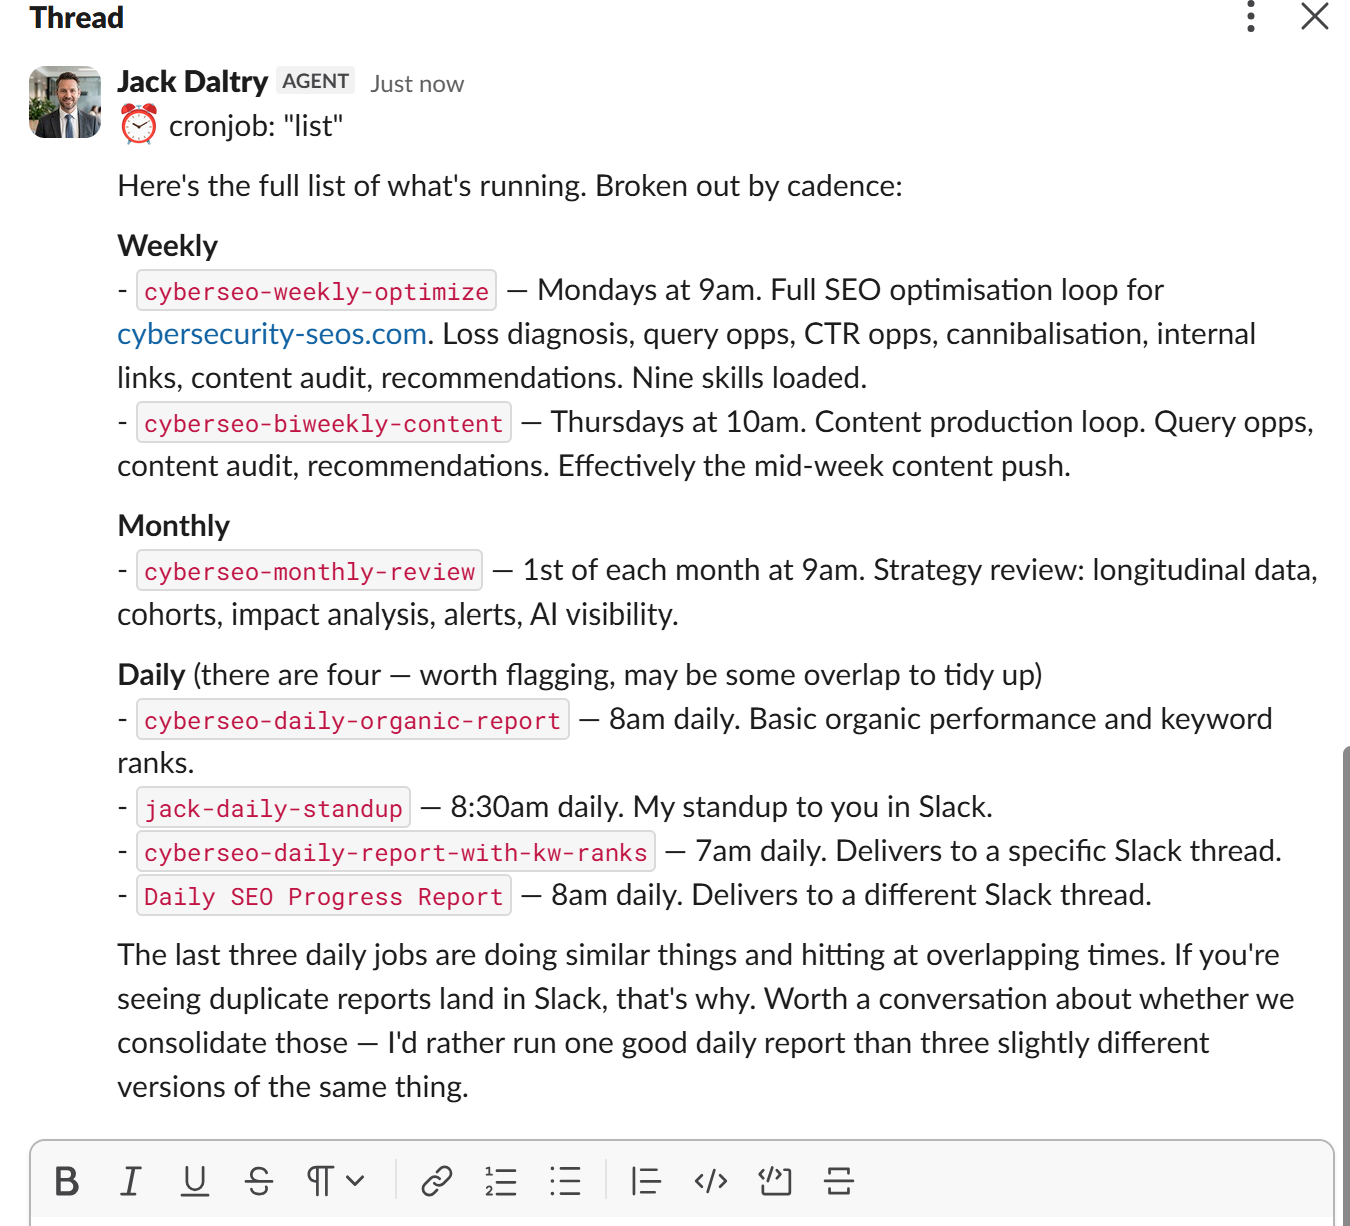
然后我设置了用于报告的 cron,因为 SEO Stack 支持 GSC + GA4 + AI Visibility,我的 Agent 可以真正做到全面覆盖的报告。
所以,如果你希望你的 AI SEO Agent 汇报:
排名
网站标注(annotations)
排名变化及其对展示、点击、ctr、位置的影响
实验结果
GA4 互动数据
AI Visibility
你都可以快速轻松地拿到。
第 7 步:用能部署变更的 AI Agent 让 SEO 更加自主
在学习和采用 AI 的过程中,我做的一件事就是用 vibe coding 的方式折腾网站。我的首选组合是 Claude Code + Git + Vercel。你可以在 Claude Code 里快速轻松地 vibe code 出网站,部署到 Vercel,还可以让 Claude Code 构建一个后端 API,让 Hermes 这类 Agent 能够连接网站并直接推送变更。
这很有趣也很让人兴奋,因为你知道一个 AI Agent 真的拥有完全的自主权:它能分析数据、生成内容、直接部署到网站,还能通过 SEO Stack 的 MCP 运行实验、对变更做基准对比等等。
我的 AI SEO Agent「Jack」负责 Cybersecurity SEOs 网站,并定期进行部署 >
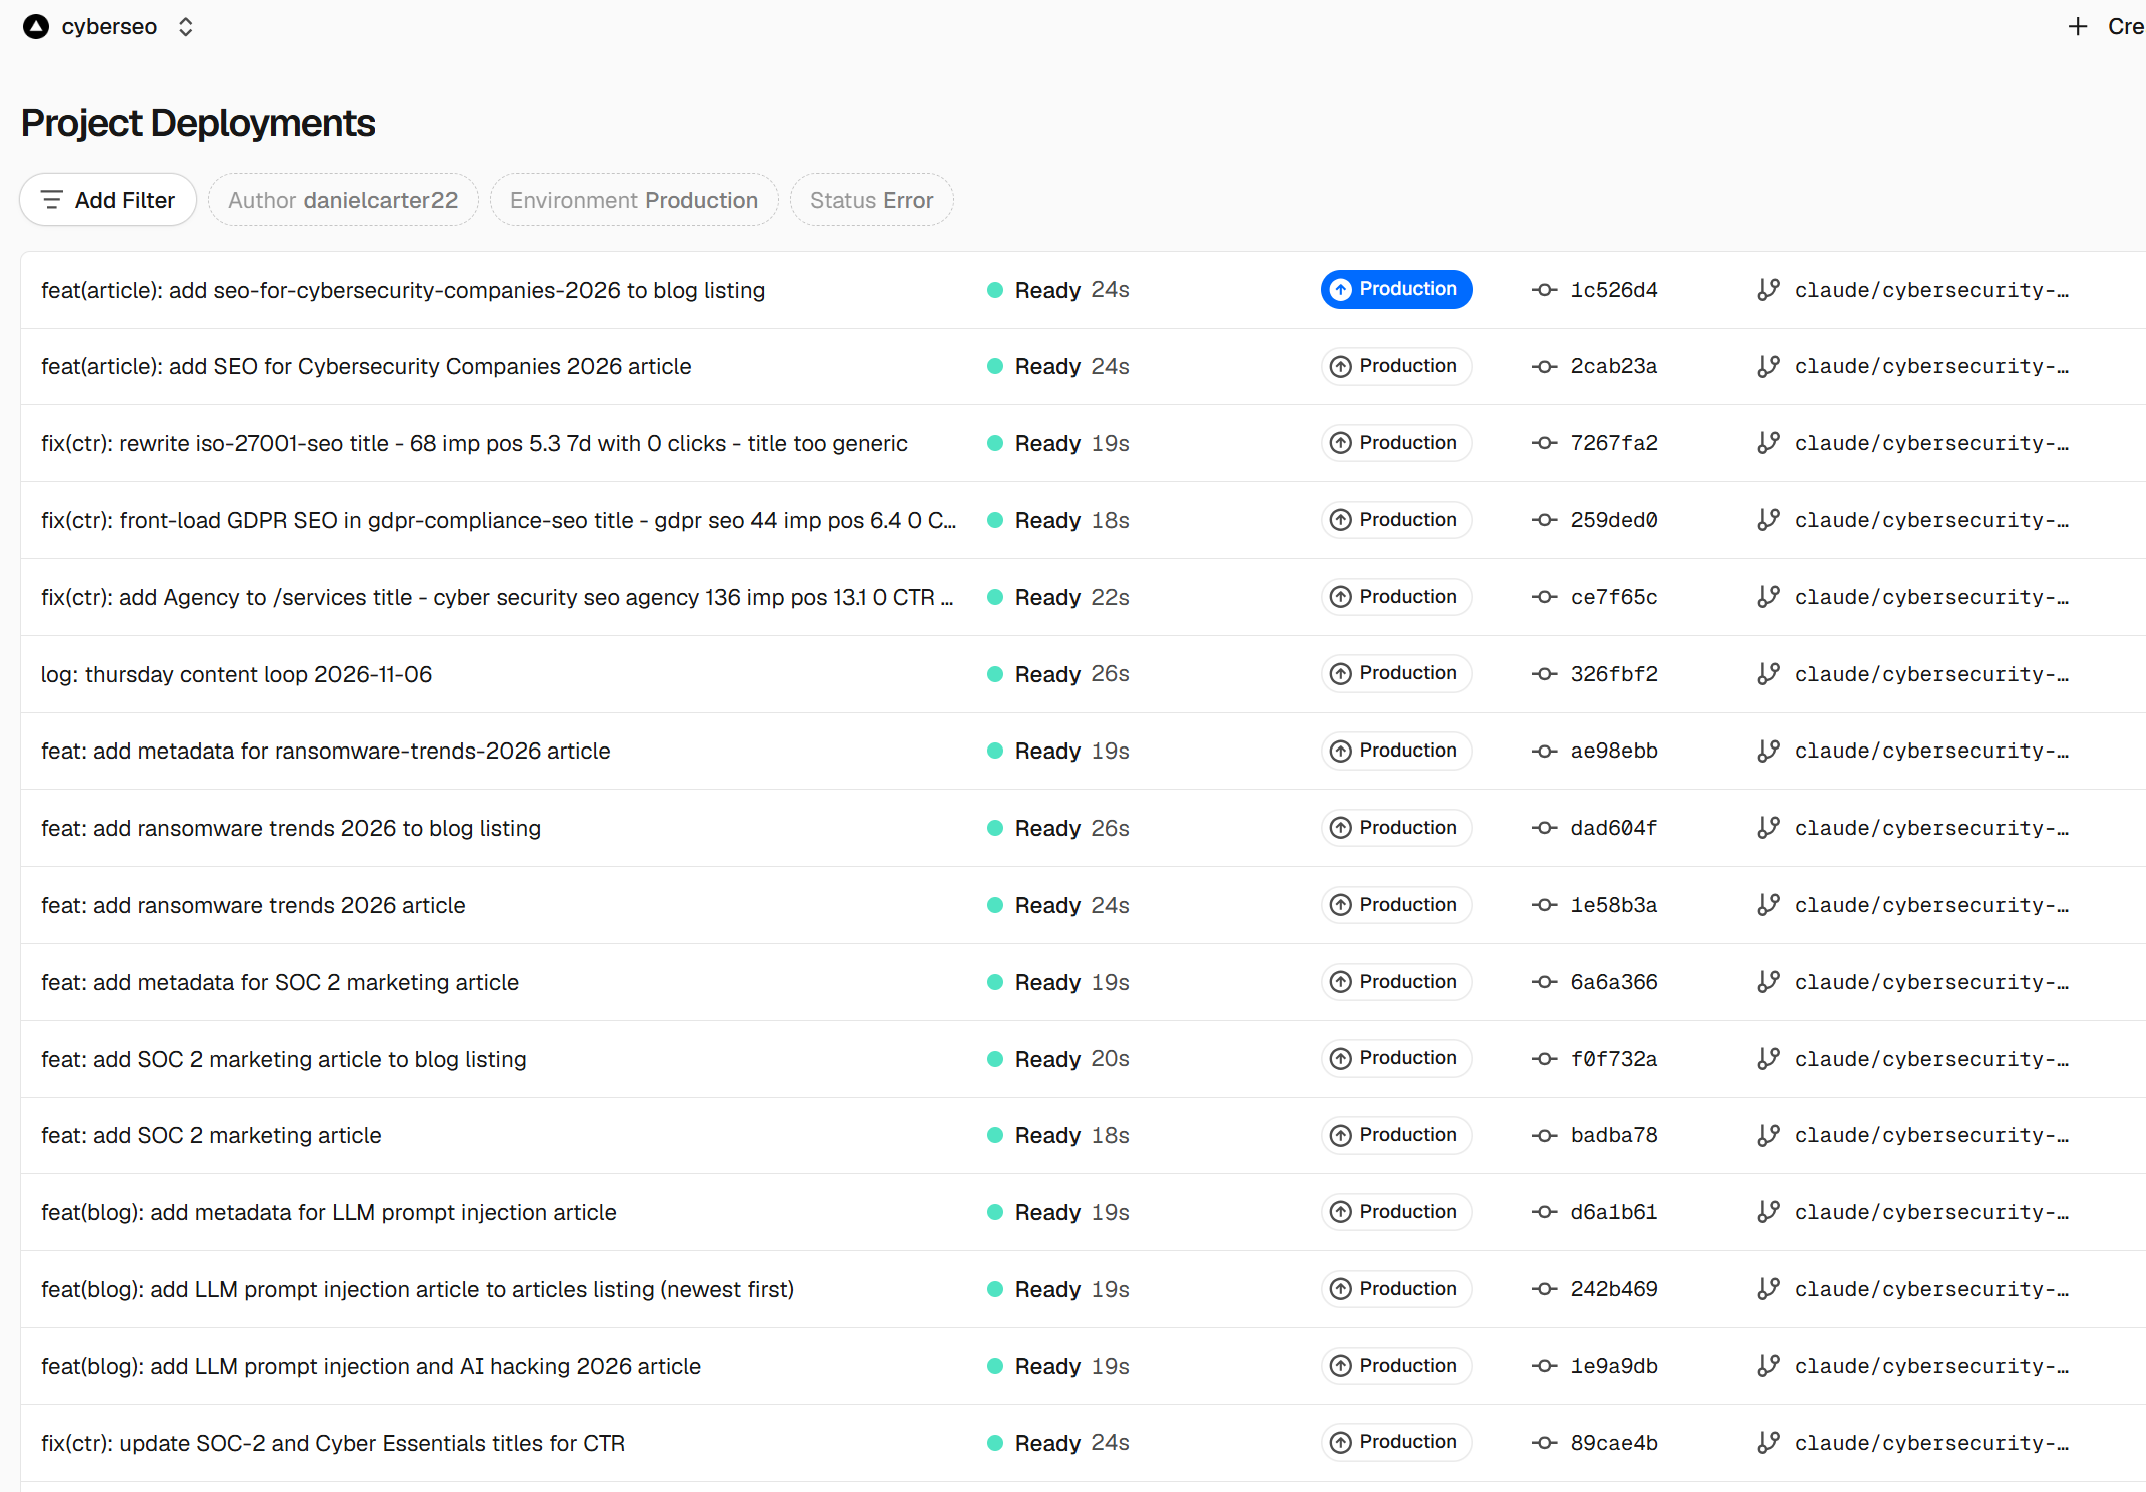
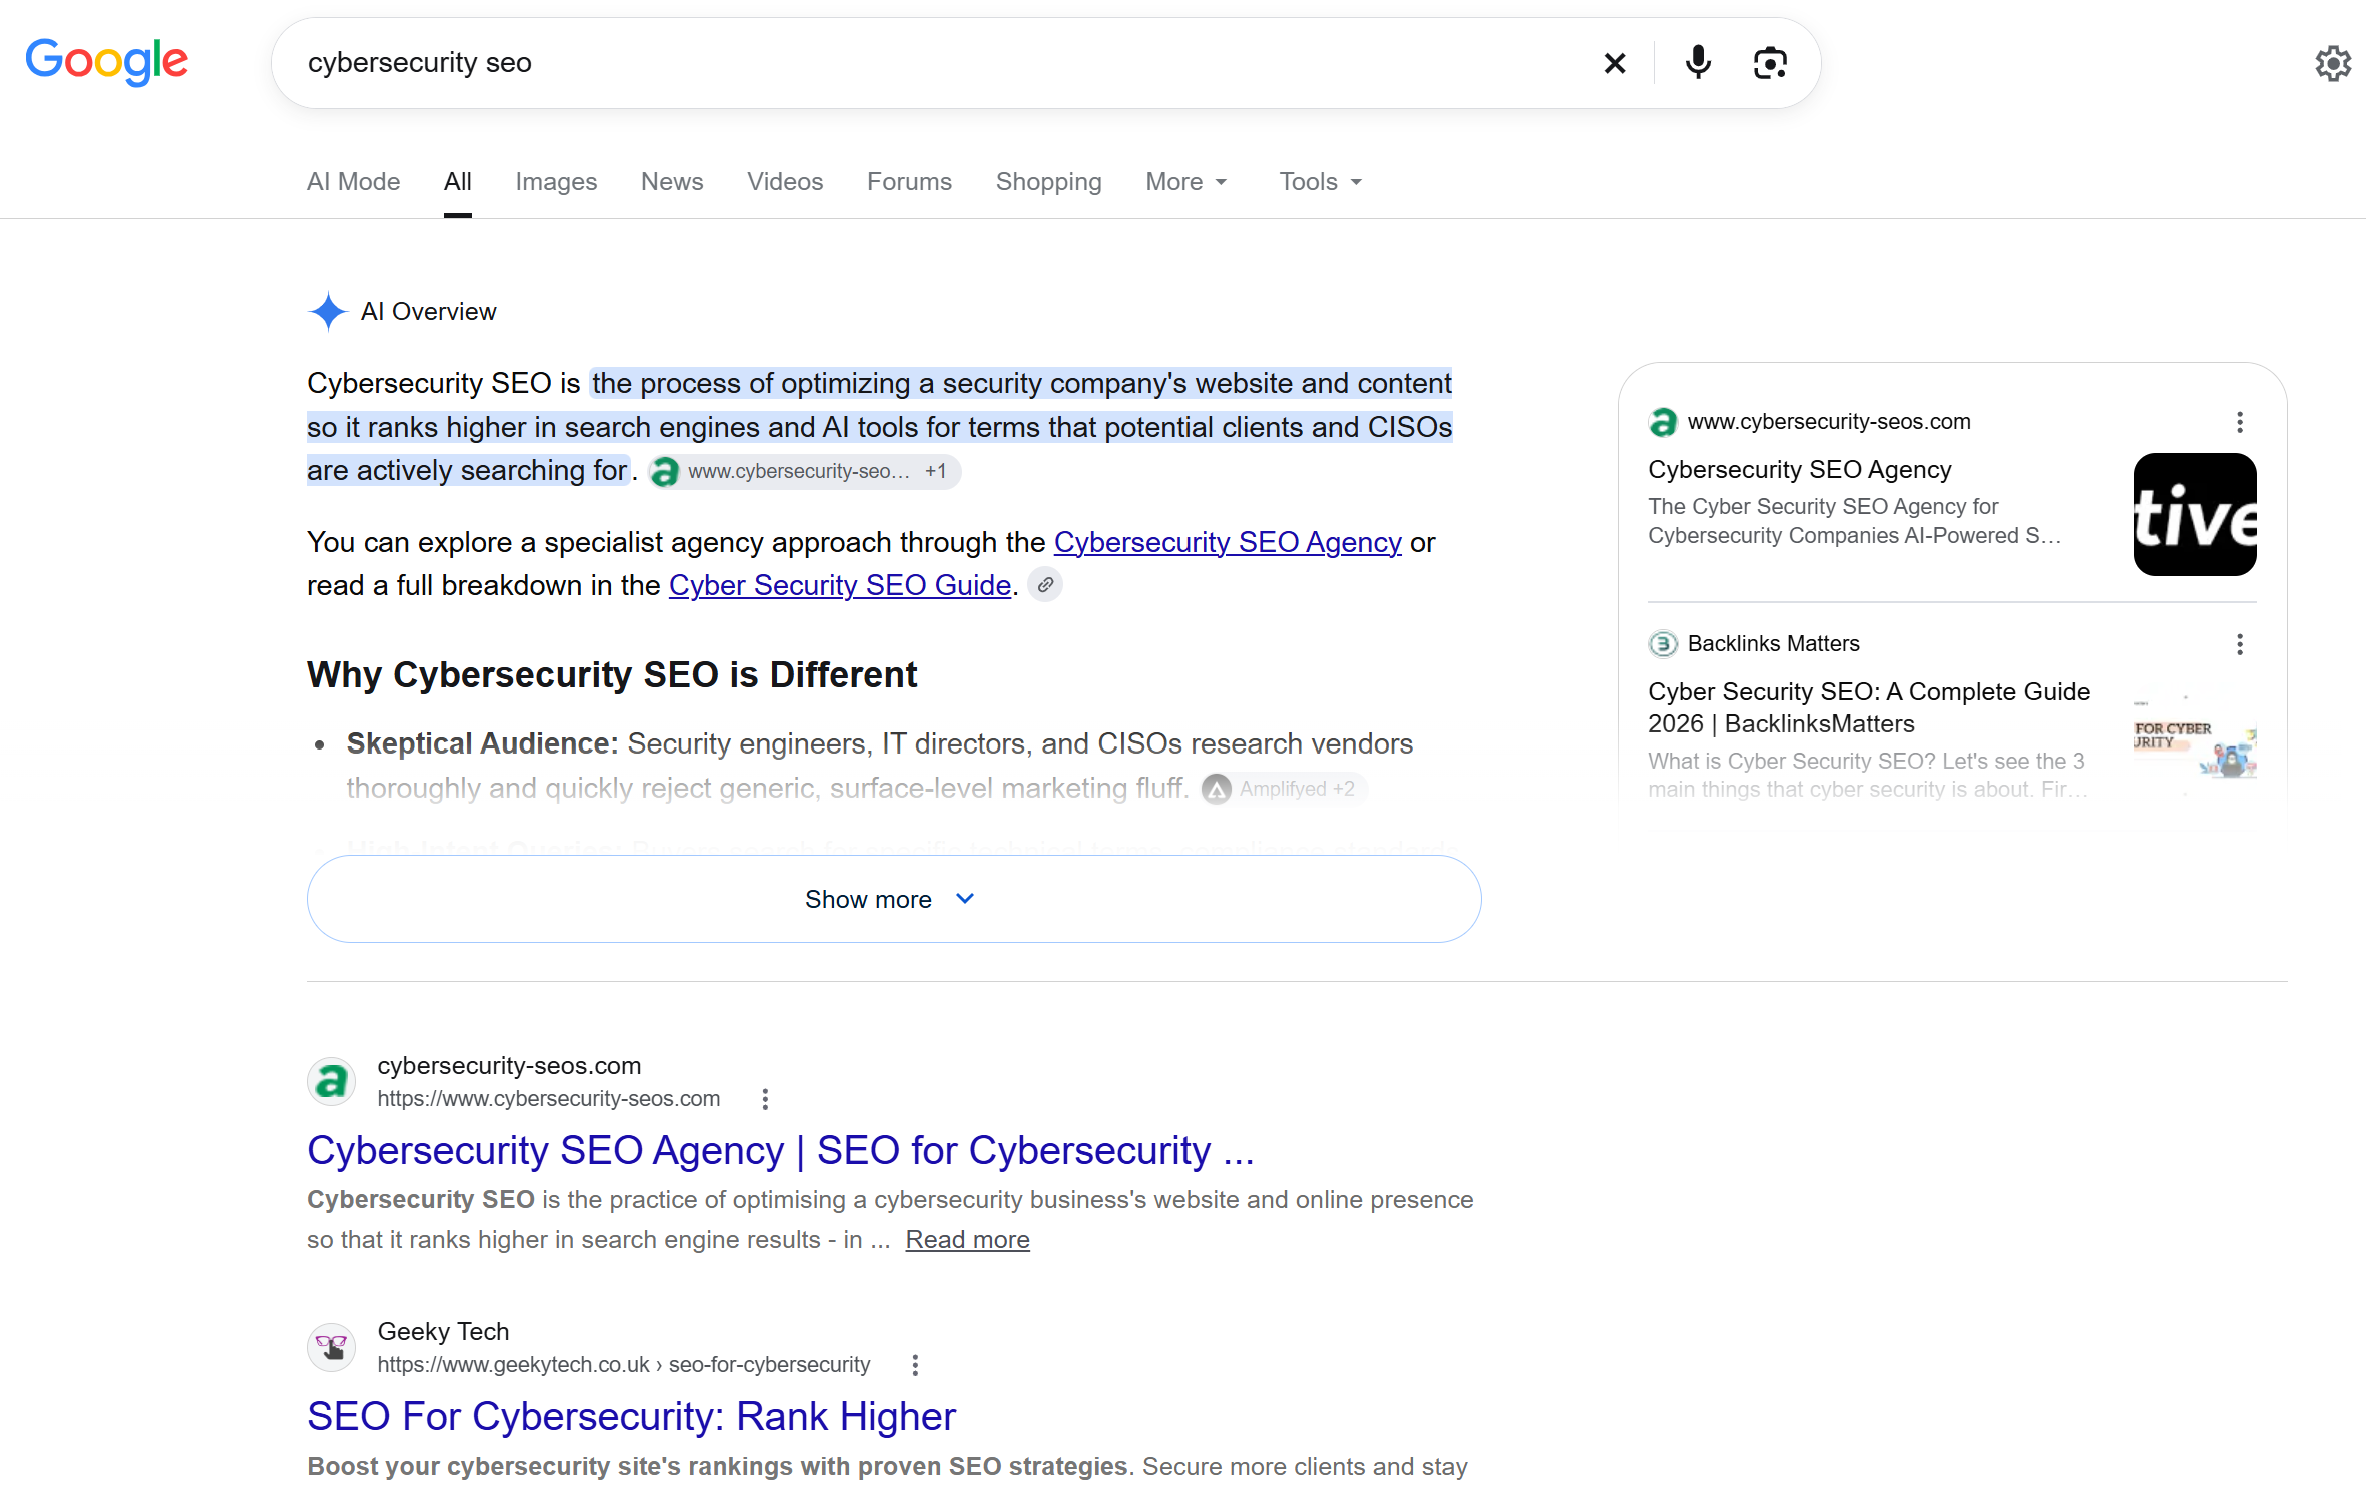
借助这个 AI Agent,我们确实拿到了一些成果,例如在 Google 上我们在 Cybersecurity SEO 以及一大批相关词上做到了 #1 >
而且没错,虽然流量不算大,但在一个完全没有人类掌舵的网站上,我们确实拿到了一些点击和询盘 >
这一切都是通过我们自己搭建、训练、授予 MCP 访问权限,并让它在一个测试网站上自由运行的 AI AGENT 实现的。
针对 SEO 问题的 AI SEO 自动化示例(工作流)
SEO 问题 | 我会让 Agent 做什么 | SEO Stack 技能 |
|---|---|---|
网站点击在上升,但销售团队说询盘在下降。 | 在 SEO Stack 里把 |
|
上个月自然点击下滑。客户想知道流量去哪了。 | 按总点击损失对目录排序,并单独汇报增长部分。如果 |
|
平均排名在提升,流量却在倒退。 | 对比两个时间段都存在的查询词,然后单独分析消失掉的查询词。失去一大批排名较低词的可见度,会让剩下的平均值看起来更好看。告诉我哪些词掉出了,以及它们过去带来多少点击。 |
|
月度报告把品牌词搜索的激增算作 SEO 的功劳。 | 建立一个品牌词筛选规则,包含公司名、产品名和常见拼写错误。对比品牌词与非品牌词点击,然后标注所有已知推广活动的日期。这样你就能告诉客户,有多少增长来自本来就在搜索他们的人,而不必猜测是什么触发了这些搜索。 |
|
某个页面在主要词上排名依然不错,但点击的人变少了。 | 在可比位置上,检查相同查询词、设备和市场的 CTR。如果下滑确实成立,把受影响的词拉出来做一次实时 SERP 检查。在让人去重写标题之前,我想先看看 Google 在该结果上方展示了什么,以及它实际显示的是哪个标题。 |
|
每周一早上都会触发流量告警。 | 检查最近一个完整的数据日期,并做同星期几的同口径对比。给告警设置一个最小点击损失量,而不只是百分比阈值。一个页面从 4 次点击掉到 2 次,大概不值得把客户经理叫醒。 |
|
一篇指南在一个购买意图查询上持续压过服务页面。 | 拉取按周的「查询词 × 页面」数据,找出这篇指南是从什么时候开始占据更大展示份额的。检查两个 URL 的合计点击,并查看分别指向它们的链接。如果这篇指南把问题回答得很好,那么在显眼位置加一个通往服务页的链接,可能比合并页面更有用。 |
|
内容规划提议为一个网站已经有排名的主题新建页面。 | 在该资源的现有查询词和 URL 数据中搜索这个拟定主题。打开现有表现最好的页面,确认它已经覆盖了哪些内容。有时候整份简报最后归结为:在一个已经吸引到正确受众的页面上,补充价格、资格条件或一个实例演算。 |
|
一篇常青指南已经连续六个月流量下滑。 | 找出导致下滑的查询词。是这篇指南在仍有展示量的词上掉了位置,还是被另一个页面取代,或者每年都会出现同样的下滑?把需要处理的章节和仍在带来流量的章节交给写作者。 |
|
有人想把所有零点击的页面全部删掉。 | 把内容清单与 GSC 历史数据、页面年龄、内链以及可获取的 GA4 结果数据关联起来。标记出近期发布的 URL、季节性页面,以及在客户旅程后段才会用到的页面。删除候选名单里应当只包含确有理由下线的 URL。「90 天零点击」作为删掉半个网站的理由,实在太单薄了。 |
|
GSC 里有数千个 URL 处于 已抓取 — 目前尚未编入索引 状态。 | 把原因导出数据放进 SEO Stack 的 PAGES → SHOULD → EXACT,然后把这些 URL 与最新一次抓取结果做匹配。其中有多少是已下架产品?有多少是仍在站点地图里、可被索引的服务页面?给每一组一个数量、若干示例 URL,以及一个处理、观察还是忽略的结论。 |
|
一个商业页面有数百个内链,大多数锚文本是「阅读更多」之类。 | 把爬虫的入链导出数据给 Agent,包含来源 URL 和链接路径。按 DOM 位置给锚文本分组,并检查几个示例。如果大部分来自某个重复出现的卡片组件,那你就找到了这个模式的源头,以及需要审查的具体组件。 |
|
新的服务页面上线了,但站内几乎没有链接指向它们。 | 把上线清单与抓取结果和站点地图做对比。对每个内链薄弱的页面,找出一篇现有文章或服务页,在那里链接到目标页确实对读者有帮助。返回来源 URL、需要修改的那句话,以及目标页。这是编辑可以直接完成的工作。 |
|
一次模板发布改动了整个板块的 canonical。 | 抽样受影响的 URL 及相邻页面,检查 HTML,记录每个页面实际返回的 canonical。把输出结果追溯到共用模板。在获得授权的 Vercel 访问权限下,Agent 可以准备一个修复方案,并在发布前于预览环境中对多条路由进行验证。 |
|
迁移仪表盘显示流量正在恢复,但几个重要页面看起来仍然没有起色。 | 把新旧 URL 映射表给 Agent。将每个旧 URL 的基线与其新旧地址的合计流量做对比,然后测试重定向和最终落地地址。优先处理那些高价值旧页面——它们现在被解析到了分类页、首页或 404。 |
|
美国版页面总是出现在英国的搜索结果中。 | 将英国和美国的 URL 配对,按国家筛选 GSC 数据,查看在相同查询词上随时间出现的是哪个页面。检查 canonical、互指的 hreflang、重定向目标和内链。如果英国站的导航指向了美国页面,那这一点应该和 hreflang 证据一起写进工单。 |
|
改版后移动端询盘下降,但自然搜索进入量保持稳定。 | 按落地页和设备对比成功提交量,然后在一个受影响的移动端页面上检查表单和跟踪代码。是表单失效,是成功事件没触发,还是完成表单的访客变少了?这是三件不同的事,需要交给三个不同的人。 |
|
客户认为是算法更新导致了下滑。 | 把更新日期、网站发布记录和 SEO Stack 标注叠加到日级趋势图上。找出第一个受影响的日期,并对比模板、国家和设备。如果下滑只局限于某个模板,且从它上线那天早上开始,开发人员就有了具体的排查方向。 |
|
代理商新增了跟踪提示词之后,AI 可见度立刻下降。 | 按模型和市场匹配,用原有的提示词重新计算提及率和引用率。给新增提示词单独建立基线。这样你就能说清楚:是你原本就在跟踪的那些问题上可见度下降了,还是扩充后的集合里本来就包含了更难的问题。 |
|
一次标题改动上线后点击上涨 20%,这个结果正要被写进案例研究。 | 取出发布日期、被修改的 URL 和原始查询词集合。在相同的完整时间段内,把它们和类似但未改动的页面做对比。如果那些页面也涨了 20%,我就不会把这个提升写进案例研究。 |
|
在没人知道第一次改动是否有效之前,Agent 就不停地继续修改。 | 让定时任务先读取实验台账。如果这些 URL 已经处于观察期,就检查线上的实施情况和约定的复核日期。等数据量足够后,先记录这次改动是保留、修订还是回退,再开启下一个测试。 |
|
一份代理商报告显示某个客户的自然流量为零。没人知道是网站出了问题还是报告出了问题。 | 用生成该报告的同一个 Agent 配置,执行一次真实的资源级 GSC 读取。检查最新可用日期,并单独测试 GA4。连接失败应当在报告中标记为数据缺失,这样客户经理才能去排查真正的问题。 |
|
你实际上给了智能体什么?
打开下载包,查看 skills/seo-stack-loss-diagnosis/SKILL.md。这是一份可读的指令集,用于排查流失的点击。你可以看到智能体应该对比哪些时间段、应该下钻到多深,以及答案中应该包含哪些证据。如果你的代理机构有自己特定的排查方式,这就是一份你可以检查并改写的东西。
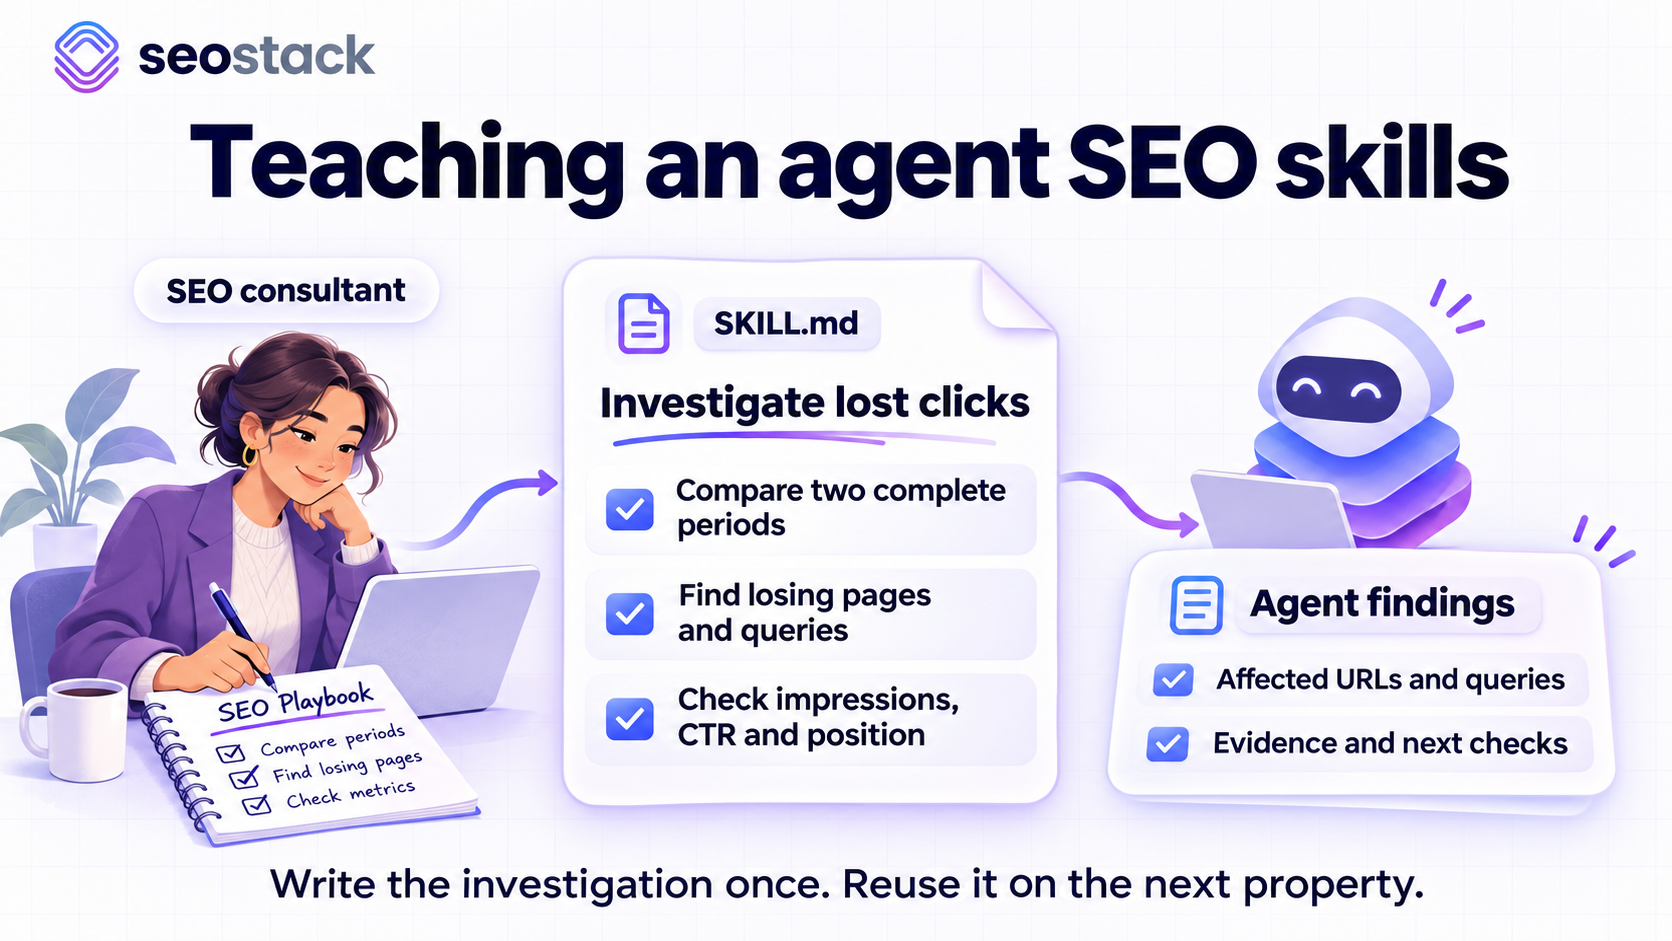
数据来自另一条连接。MCP(Model Context Protocol)让智能体调用 SEO Stack 中的工具。例如,它可以请求按 URL 分段聚合的 GSC 表现数据、对比两个时间段、在查看某个查询词的同时查看该词对应的页面,或者为已关联的媒体资源请求受支持的 GA4 指标。你的账户、该媒体资源可用的历史数据,以及向该智能体开放的工具,共同决定了它能取到什么。安装一个 Markdown 文件,给的是流程;连接 SEO Stack,给的是数据访问权限。SEO Stack MCP 目录
工作流是你把这些流程串起来的方式。一条每日预警可能引出一次流失排查,再引出一条建议。cron 不过是启动任务的定时计划。至于智能体能否提交 pull request 或把修改发布到网站上,那是另一个决定,涉及你的 Git 仓库、Vercel 项目以及你授予它的权限。
SEO Stack 中的目录是个方便的地方,可以查看单个工具需要什么输入。搜索表现类工具使用站点的数据索引;AI visibility 类工具使用其 website ID,而提示词历史则需要你正在排查的那条提示词的 tracker ID。 MCP 操作指南
先追踪流失的点击,再决定改什么
看看下载包里附的这个小例子。这些都是虚构的 URL 和数据。你可以用 examples 文件夹里的两个 CSV 自己复现这组对比。
URL | 上期点击 | 本期点击 | 变化 |
|---|---|---|---|
/services/a | 120 | 75 | −45 |
/legacy | 15 | 0 | −15 |
/guides/b | 80 | 100 | +20 |
/new | 0 | 8 | +8 |
合计 | 215 | 183 | −32 |
仪表盘告诉你站点少了 32 次点击,而服务页一个就少了 45 次。如果我在决定把客户的预算花在哪里,后面这个数字更值得关注。两个下滑的 URL 合计流失 60 次点击,其中服务页占 75%。站点其他地方则增加了 28 次。完全有可能出现这种情况:商业模板页出了严重问题,而新发的博客文章让总体数字看起来还挺体面。
这正是我会把三项技能组合起来用的地方。Cohorts 定义我想追踪的那一组对象,比如所有英国地区的服务页、排除品牌词查询。流失诊断从站点到目录再到 URL 层层下钻,然后查看该 URL 背后的查询词。纵向分析让智能体能够判断每年这个时候需求是否通常会下滑——前提是数仓里有足够的历史数据。如果我把最近三天的数据交给一个尚未完成数据摄取的媒体资源,这三项分析都可以解释得头头是道,却完全没用。连接检查永远排在第一位。
关于那个服务页,我们还知道什么?展示量从 4,000 降到 3,800,而 CTR 从 3% 降到 1.97%。按原来的 CTR,3,800 次展示本应带来约 114 次点击,实际只有 75 次。这给了我们排查 CTR 变化的理由,但离建议换个新标题还差得远。更宽泛查询词带来的展示量涌入,也可能拉低平均值,即便原有商业词的 CTR 一点没变。
这一阶段可用的实用提示词:
针对下滑的那个服务页,对比两个时期都出现的查询词。展示点击、展示量、CTR 和排名,然后分别查看移动端和桌面端。把新出现和消失的查询词分组列出。给我确切的日期、URL 和筛选条件,以便我在 SEO Stack 中复现这组对比。如果查询词行只能解释页面总量的一部分,把差额展示给我。
假设移动端的下滑集中在三个高价值词上。关键词自噬技能可以检查是否有某篇指南在这些搜索中取代了服务页出现。我会想要一份按周的「查询词 × URL」拆解、两个 URL 的合并表现,以及对两个页面各自内容的审视。两个 URL 在同一个词上都拿到展示,几乎说明不了其中任何一个是否需要做重定向。如果 URL 归属稳定、且在可比的查询词和排名上流失仍在持续,CTR 机会技能可以把该页面与相关同类页面做对比,SEO 人员再去看实际的搜索结果页。
这次流失给业务造成损失了吗?
把同一个 URL 拿到 GA4 里看。对于一个获客类站点,我会调取可比日期内的 Google 自然搜索着陆会话数和成功提交的咨询表单数。先搞清楚这个事件实际记录的是什么。一个在表单校验之前就触发的按钮点击,对「咨询」的定义未免过于慷慨。
在媒体资源和工具都支持的情况下,SEO Stack 可以把 GA4 指标和 GSC 指标一并返回。确认渠道,以及该行代表的是着陆页还是页面上的任意活动。如果你手上只有全渠道会话数,就把这个口径写进报告。把那个数字和十个 GSC 查询词关联起来,只会产生同一个数字的十份副本,关于哪个关键词带来了成交则毫无证据可言。Google 关于联合使用 Analytics 与 Search Console 的指南
对读报告的数字营销人来说,这个区别很重要。如果搜索点击和自然进入量双双下滑,但咨询转化率保持稳定,那么流失的获客值得深入排查。如果进入量稳住了,成功咨询却一夜之间消失,我会先去测试表单、同意管理(consent)变更和 GA4 事件,而不是先去安排内容。我们的 CSV 示例里没有 GA4 数据,所以它的商业影响仍是个未解问题。
其他技能在哪里派上用场
我不会每天早上对每个媒体资源都跑完全部 21 项技能。一次迁移需要一份新旧 URL 的映射表。一次内链审计需要知道链接在源页面中的位置。一份每月的代理机构报告需要知道每个媒体资源归属哪个客户,以及结果交付给谁。下面是这套技能包与这些工作的对应关系。下表中的名称对应去掉公共前缀 seo-stack- 之后的文件夹名。
任务 | 技能 | 事后你能交给别人的东西 |
|---|---|---|
确定哪些东西可被测量 |
| 已验证的媒体资源、可用日期范围、一次成功的指标读取,以及一个可复用的筛选条件,附带应被纳入和排除的示例 URL。 |
排查搜索表现的变化 |
| 一条带日期的预警,含受影响的目录、它对总流失的贡献、查询词证据,以及在历史数据允许时与过往季节性表现的对比。 |
判断哪里值得投入内容工作 |
| 针对某个现有 URL 的具体决定:扩写这一部分、让这两个页面区分开、测试这段摘要,或者干脆别动它。GSC 能反映你已经有曝光的需求;要研究你毫无可见度的市场,则需要另找数据源。 |
审计抓取、索引与内链 |
| 受影响的 URL、一个可复现的故障、问题的来源页面或模板,以及开发修复后可以运行的验证方法。提供相应的导出数据、爬取结果或渲染后的 HTML。 |
检查迁移或国际化上线 |
| 新旧 URL 的表现对比、遗漏的重定向、错误的跳转目标,或值得排查的语言地区配对,并附上国家与查询词证据。 |
理解商业结果与 AI 搜索结果 |
| 经过验证的着陆页转化结果,或者在同一批被追踪的提示词和模型上对提及与引用的对比。两者各有各的计量单位。 |
推动落地并评估上线效果 |
| 拟议的修改、URL 范围、验收测试、已验证的发布,以及基于约定指标做出的后续决定。 |
在多个客户账户间推进工作 |
| 到期待复盘的进行中实验、按客户划分的待办事项,以及对哪些媒体资源数据无法核验的明确记录。 |
更好地利用未收录页面导出数据
这里有一项工作,你不用给智能体任何网站代码权限就能试。从 GSC 的网页编入索引报告中导出某一类原因,比如已抓取 — 尚未编入索引。在 SEO Stack 的 Search Console Data 中,把这份 URL 列表放到 PAGES → SHOULD → EXACT。你希望匹配其中任意一条完整 URL。把该分组保存在 GSC Non Indexed Reasons 之下,用原因作为子分组名称。这样你就有了一份列表,等有人处理过之后还能回头核对。
把带日期的导出文件和一份包含 HTTP 状态、可索引性、canonical、是否在站点地图中以及内部入链的最新抓取数据交给索引技能。让它描述主要的 URL 类型,并针对每一类判断给出示例。一个已经下线、现在返回 404、没有内部链接且是刻意移除的 URL,与一个在线、自引用 canonical、收录在站点地图中但导航从不链接的服务页面,对你时间的占用理由完全不同。历史 GSC 点击可以告诉你某个 URL 过去曾带来流量。要确认 Google 当前对某个具体 URL 的报告情况,请使用网址检查工具。
内部链接技能可以让调查更进一步。如果抓取工具显示该服务页面有 400 条入链,让智能体按来源页面和 DOM 位置做分组。其中有多少是卡片里重复出现的同一个“阅读更多”链接?有多少是正文内容中的相关链接?要求给出来源 URL、目标去向、现有句子和建议锚文本。开发人员可以直接落实这些。而“优化内部链接”下个季度还会留在表格里。
监控 AI 回答中的可见度
在追踪提示词时,对比集合和答案本身同样重要。假设一家代理商在 10 月份向一个原本以品牌类问题为主的集合中新增了 40 条非品牌提示词。整体提及率因此下降。在有人告诉客户品牌可见度下滑之前,先让 AI visibility 技能在相同模型和市场下,比较原有提示词的已完成运行结果。把提及和带链接的引用分开报告,保留实际被引用的 URL,并说明每个百分比是由多少次运行得出的。新增的提示词可以有自己的基线。SEO Stack AI 与提示词报告工具
授权智能体编辑 Vercel 网站
有三个有用的停止点。在 recommend 模式下,SEO 会拿到一份简报,包含准确的 URL、证据和建议的改动。在 preview 模式下,具备相应 Git 权限的智能体可以在分支上工作、提交 pull request 并检查 Vercel 预览。Production 适用于网站所有者已明确授权相关改动和发布方式的站点。SEO Stack 密钥提供分析数据访问权限,而 Git 和 Vercel 决定谁能改动网站。
做标题实验时,我会记录当前渲染出的标题、建议的措辞、受影响的 URL,以及一个应当保持原标题不变的相邻页面。为检查这个相邻页面多花几秒钟是值得的。在 Next.js 中看起来只改一个页面的编辑,可能最后改的是共享布局。在预览环境中确认实际的 HTML、canonical 和目标主机名,发布后再在线上域名上核对同样这几项。一个已批准的 pull request 有一个日期。面向真实用户的部署可能是另一个日期。衡量时请以后者为准。Vercel 预览与晋级发布指南
在实验台账中记录发布、基线、URL、对比组和下次复核日期。在 SEO Stack 中,注释可以覆盖单个页面、一个 URL 分组或整个站点。当可用的 MCP 工具只能读取注释时,智能体可以把文本交给你在应用内添加,并在本地保留发布记录。使用 SEO Stack 的注释与对比功能
现在假设改动之后,该服务页面从 75 次点击恢复到 90 次。这是 20% 的增长。但同期未作改动的类似服务页面从 100 次点击涨到了 120 次。按这个对比,被编辑的页面本来也大约会有 90 次点击。我可能会保留新标题,因为它对服务的描述更准确,但我不会在客户汇报里写“标题优化带来 20% 提升”。
这种复核就是这个技能包里递归的含义。下一次运行会查找已经在测量中的工作,检查是否已积累足够的完整数据,并在对同一分组提出新的改动建议之前记录一个结论。复核窗口由你根据流量规模、改动内容以及 Google 合理处理该改动所需的时间来决定。一个低流量的服务页面所需的时间,可能远长于一个繁忙的分类页模板。
你的第一次实测,以及你的第一个定时任务
选一个你熟悉的资源。把它的准确名称和解压后仓库的位置告诉智能体,然后提问:
对 [property] 使用 seo-stack-connect 和 seo-stack-loss-diagnosis。用 SEO Stack MCP 找到匹配的站点。把最近七个完整天与之前七天做对比。返回两个日期区间、站点点击量和展示量,以及绝对点击损失最大的五个 URL。为每个 URL 展示改动前后的点击量。另外单独尝试读取一次 GA4 会话数,并说明其渠道范围。如果数据不可用,告诉我是哪次读取失败了。不要对网站做任何改动。
在 SEO Stack 中打开同一个资源,对齐搜索类型、筛选条件和日期,然后核对两个站点总量和其中一个具体 URL。一份工具清单只能验证发现能力。一组你能复现的数字,验证的东西要多得多。
对于 Hermes,在投入周期性任务之前,先把同样的读取操作调度执行一次。下面的示例适用于 VPS 上的 Bash 终端。替换前几行中的三个值。如果该配置的网关未启动,先启动它。
SEO_PROFILE='your-profile'
SEO_SITE='your-property'
SEO_REPO='/absolute/path/to/seo-stack-skills'

hermes -p "$SEO_PROFILE" gateway status
hermes -p "$SEO_PROFILE" cron create "2m" \
  "Read $SEO_REPO/docs/data-contract.md. Use SEO Stack MCP for $SEO_SITE. Compare the last seven complete days with the previous seven. Give exact dates, site clicks and the five losing URLs with before and after clicks. Record a failed read explicitly." \
  --skill seo-stack-connect --skill seo-stack-loss-diagnosis \
  --name "SEO Stack property test" --deliver local
在该配置的 cron/output/ 中查看报告。如果手动执行的结果没问题,而定时任务读不到站点,请在重新生成凭据之前,检查定时任务所用的配置、服务账号、可用工具和网关会话。如果两次读取都正常,你就有了一个合理的基础来做每周流量损失报告。Hermes 定时任务 · 定时任务故障排查
如果要长期运行一个项目,这个技能包里包含一个 Linux 运行器。把 examples/client.json 复制到私有存储中,设置资源、Hermes 配置和一个可写的绝对路径状态目录,并从 recommend 模式开始。在检出目录中运行 python3 scripts/run.py /path/to/client.json weekly --dry-run 来查看指令内容。去掉 --dry-run 即可执行真实任务。docs/operations.md 中的示例展示了如何调度每日告警、每周调查以及对进行中实验的复核。每个任务只用一个调度器。内置的运行器会调用 Hermes 并使用 Linux 文件锁,因此单靠在 Cursor 或 Claude Desktop 中安装技能是无法运行它的。
在代理商账户上,我会用一些相当普通的问题来评判第一个月的成果。有多少条告警指向了某人可以验证的故障或机会?另一位 SEO 能否在不再次要求智能体解释的情况下复现这些结论?客户的开发人员是否拿到了 URL、明确的改动内容和测试方法?以及,到了复核日期时,有没有人去查看优质流量或咨询量发生了什么变化?
我会从你现在已经花时间手工制作的那份报告开始。你知道哪些数字应该对得上、哪些客户有季节性低谷、哪个 GA4 事件自上次网站重建以来一直统计错了东西。这让你能更好地判断智能体的工作质量。等它能可靠地完成这项工作,再把下一项交给它。

SEO Stack 创始人
Daniel 是 SEO Stack 的创始人。他在技术 SEO 和搜索数据领域深耕二十余年,在客户项目中一次又一次撞上 Search Console 的同样限制后,他着手打造了 SEO Stack。
Daniel 拥有丰富的 SEO 经验,创办过 SEO 代理机构、审计业务以及一家发展良好的咨询公司。业余时间里,Daniel 喜欢做 SEO 实验并分享实验结果。
发布于 2026年11月9日