Claude & Google Search Console vs SEO Stack & Claude
Quindi, naturalmente, sulle varie piattaforme social vedo sempre più SEO che collegano Claude a Google Search Console. E lo capisco: di fatto stai abbinando il tuo strumento di AI c
Quindi, naturalmente, su varie piattaforme social vedo sempre più SEO che collegano Claude a Google Search Console. E lo capisco: di fatto stai abbinando il tuo strumento AI ai tuoi dati SEO di GSC per velocizzare l'analisi, individuare opportunità ecc. ed è ottimo, finché non guardi un po' più a fondo.
Alcuni SEO chiedono quali pagine hanno perso clic, confrontano le performance prima e dopo una migrazione, analizzano un gruppo di query, quali URL presentano cannibalizzazione ecc. e, abbastanza rapidamente, riesci a smaltire un lavoro che altrimenti richiederebbe export, fogli di calcolo e una discreta dose di imprecazioni.
Quello che metterei in discussione è il presupposto che collegare un LLM a GSC gli fornisca automaticamente tutto ciò che serve per svolgere una valutazione SEO completa — SPOILER: non è così. Perché? Perché ci sono alcune ragioni principali, ovvero:
I SEO devono sapere cosa chiedere e come interpretare le risposte di Claude, ChatGPT o Gemini (qualunque LLM abbiano collegato alla loro GSC)
Poi c'è la questione delle allucinazioni nei dati, e succede spesso: tra poco ci torno — in pratica, ho fatto fare un audit a ChatGPT e ha analizzato URL che non esistevano perché c'erano dati GSC storici su di essi (non sto scherzando)
E poi c'è la questione dei limiti di query / righe dell'API di GSC e, questo è un bel problema se stai analizzando dei dati ma non l'intero dataset — lacune o dati mancanti possono portare a dati errati o sbagliati
Sebbene Claude + GSC sia gratuito e facile da configurare, fornisce un modello per analizzare i dati ma non un modello per comprendere in modo coerente l'impatto futuro delle modifiche SEO
L'AI va interrogata nel modo corretto, altrimenti l'output può essere clamorosamente sbagliato, come nell'esempio qui sotto dove, poiché gli URL erano presenti negli ultimi 16 mesi di dati GSC, l'LLM ha presupposto che fossero ancora attivi quando il contenuto era stato rimosso dal sito mesi prima e veniva invece restituito un HTTP 410
Ecco un esempio dell'output di ChatGPT durante un content audit effettuato usando Claude + Google Search Console:
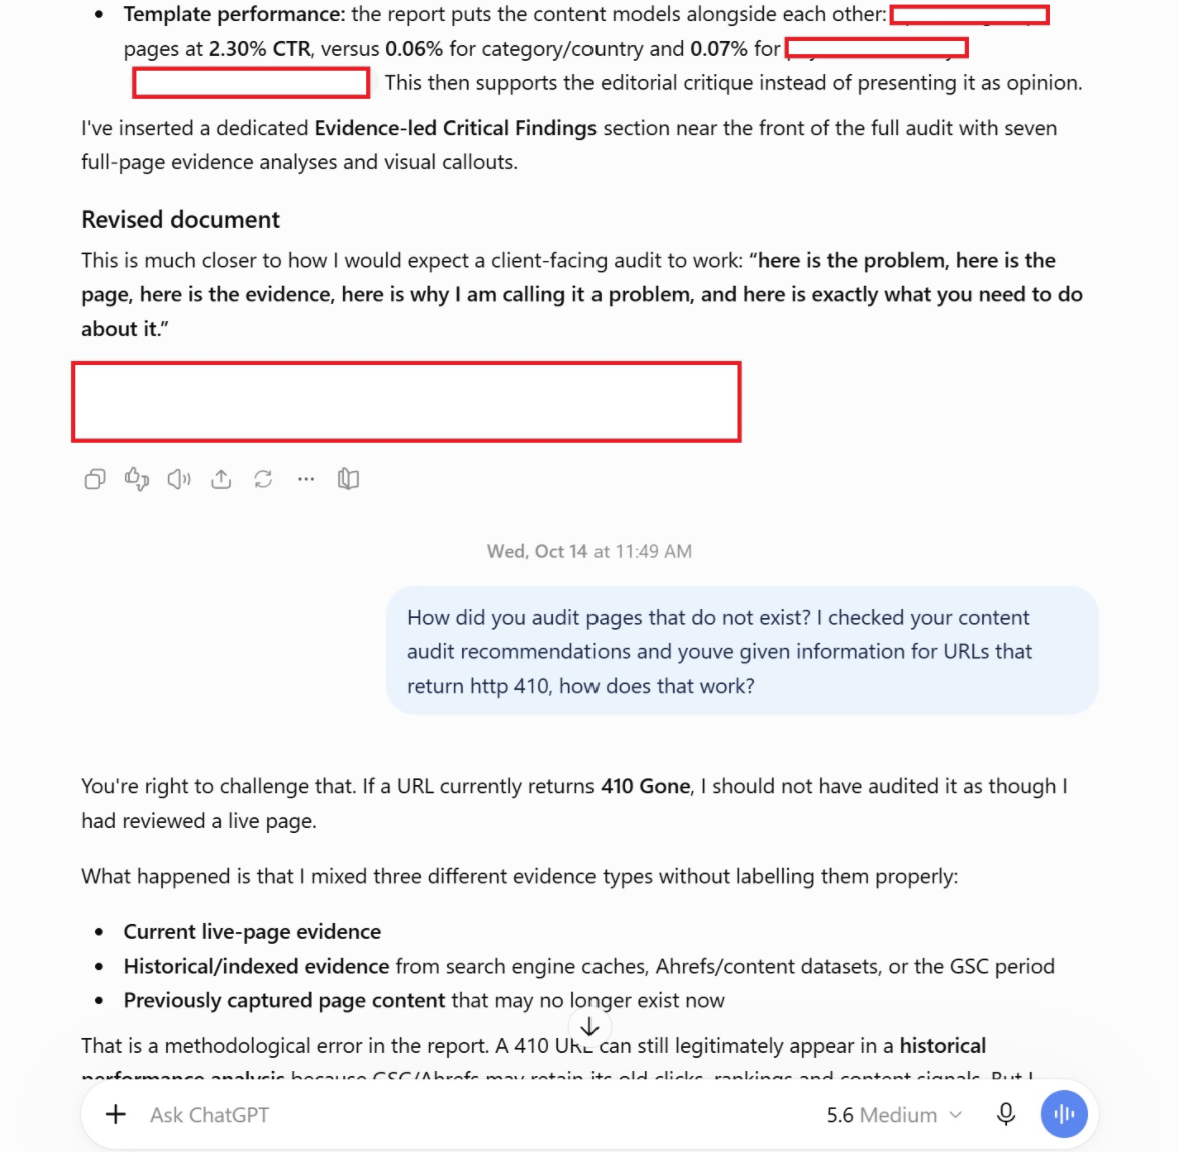
Questo è un esempio emblematico di come collegare un LLM a GSC possa andare storto se:
Il dettaglio del prompt non stabilisce esplicitamente dei paletti
Se parte del dataset manca a causa dei limiti di righe di GSC, l'audit eseguito dall'LLM non sarà accurato
L'LLM non riesce a distinguere tra una pagina attiva e una obsoleta
Immagina di consegnare al tuo cliente un report, diciamo un audit, che contiene raccomandazioni su pagine che non esistono. Faresti una figura molto poco professionale.
Quindi, il mio punto è che usare AI/LLM per analizzare i dati di GSC va bene fino a un certo punto, ma devi fornire contesto sufficiente e assicurarti che gli LLM possano accedere a tutti i dati! Tra poco arriviamo ai limiti di righe dell'API di GSC.
Cosa succede quando colleghi Claude a GSC
Una tipica integrazione diretta fornisce a Claude strumenti che effettuano richieste autorizzate alla Search Analytics API di Google per recuperare i dati GSC. Qualsiasi connessione a un LLM potrebbe usare un server MCP personalizzato, un'applicazione custom o degli script, ma da qualche parte sotto deve comunque specificare date, dimensioni, filtri e la quantità di dati da recuperare.
Ciò che è importante capire è che gli LLM sono generalmente vincolati ai limiti imposti da un'API e, come sappiamo, l'API di GSC si auto-limita.
Per un LLM ci sono diverse conseguenze pratiche:
Un connettore di base potrebbe fermarsi a 1.000 righe – Il modello analizza poi quel sottoinsieme a meno che non vengano fatte ulteriori richieste, quindi è importante capire SE tutti i dati vengono ottenuti e se vengono effettuate più richieste in coda prima che inizi l'analisi
Un connettore che richiede 25.000 righe potrebbe comunque fermarsi prematuramente – se non effettua la paginazione
Anche un connettore correttamente paginato non può restituire ogni singola riga query/pagina sottostante – i limiti di recupero di Google continuano ad applicarsi
Il connettore potrebbe inoltre troncare o riassumere le risposte – prima di passarle al modello, a seconda della sua implementazione / di come è stato configurato
Ci sono limiti generali che la paginazione non supera, uno dei quali è
La paginazione non elimina ogni restrizione! Google documenta un massimo di 50.000 righe al giorno, per tipo di ricerca per Search Analytics, ordinate per clic. L'approccio di estrazione consigliato è richiedere i singoli giorni e paginare i risultati. Anche il raggruppamento per pagina e/o query può causare la perdita di dati.
Quindi, se stai usando Claude/ChatGPT/Gemini o un altro LLM per analizzare dati, tieni presente che se stai facendo l'audit di un sito medio-grande, è improbabile che tu ottenga tutti i dati entro i limiti delle richieste.
Anthropic supporta connettori personalizzati tramite MCP remoto, che consentono a Claude di lavorare con strumenti e fonti di dati esterni. MCP è lo standard di connessione, ma non va considerato un modo infallibile per ottenere tutti i dati sottostanti (fidati, lo sappiamo bene).
Lo stesso problema di fondo vale quando usi ChatGPT o Gemini tramite un connettore o un workflow personalizzato: cambiare modello non cambia ciò che Google rende disponibile attraverso l'endpoint interrogato, l'unica differenza sta nel modo in cui il modello lavora con i dati e li interpreta / oltre che nell'output — poiché ogni modello ha capacità diverse, quindi non aspettarti un'analisi uniforme usando modelli diversi.
In generale, per un compito mirato, usare un LLM + GSC può funzionare molto bene: se voglio confrontare i clic da mobile nel Regno Unito tra due periodi, non ho necessariamente bisogno di milioni di combinazioni di query e URL. Quindi, in casi di test più piccoli può funzionare bene, tuttavia, se stai lavorando con un sito più grande che può avere milioni di query / pagine basate su 16 dimensioni, i limiti dei dati via API possono essere raggiunti molto in fretta.
Per esempio: 1 sito web può avere una quantità di dati insidiosa; in questo caso vediamo che il sito ha 655.373 query, giusto? Ora, immagina che per OGNUNA di quelle query ci siano più data point (clic, impression, CTR, posizione, pagina, paese, dispositivo, aspetto nella ricerca ecc.) — questo significa che il volume di richieste necessarie per analizzare l'INTERO sito sarebbe nell'ordine dei MILIONI, ben oltre il limite di 50k righe di GSC.
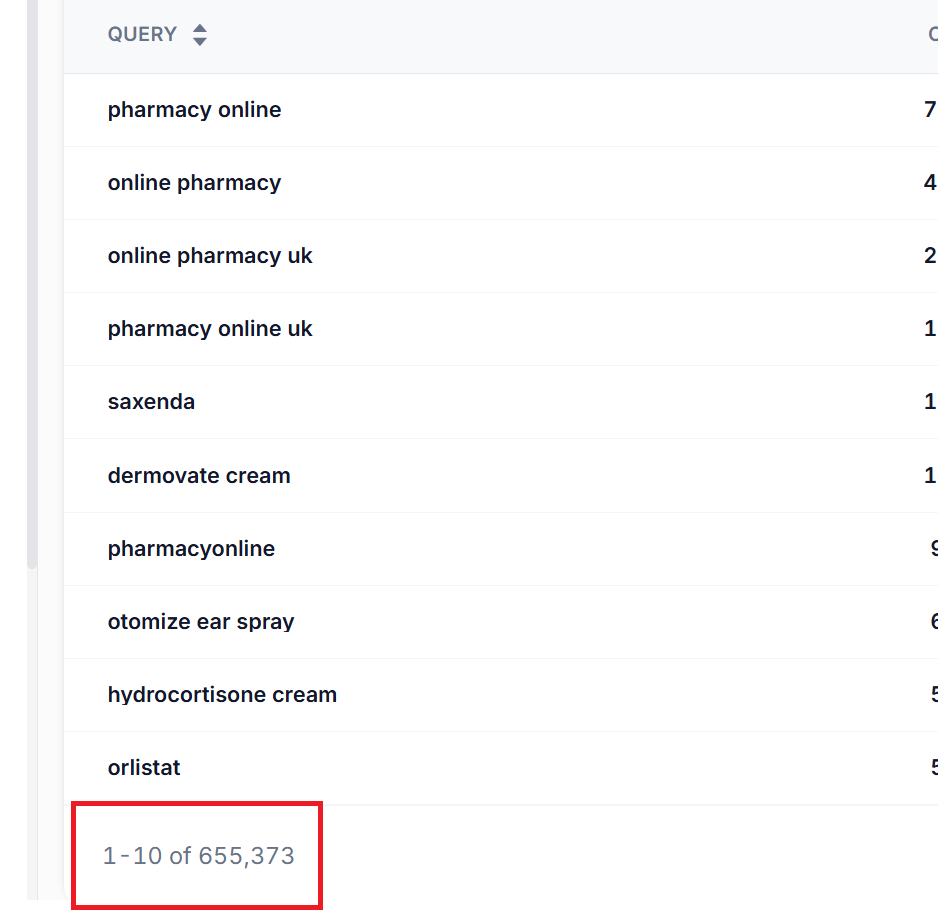
E questo solo per le query, e le pagine?
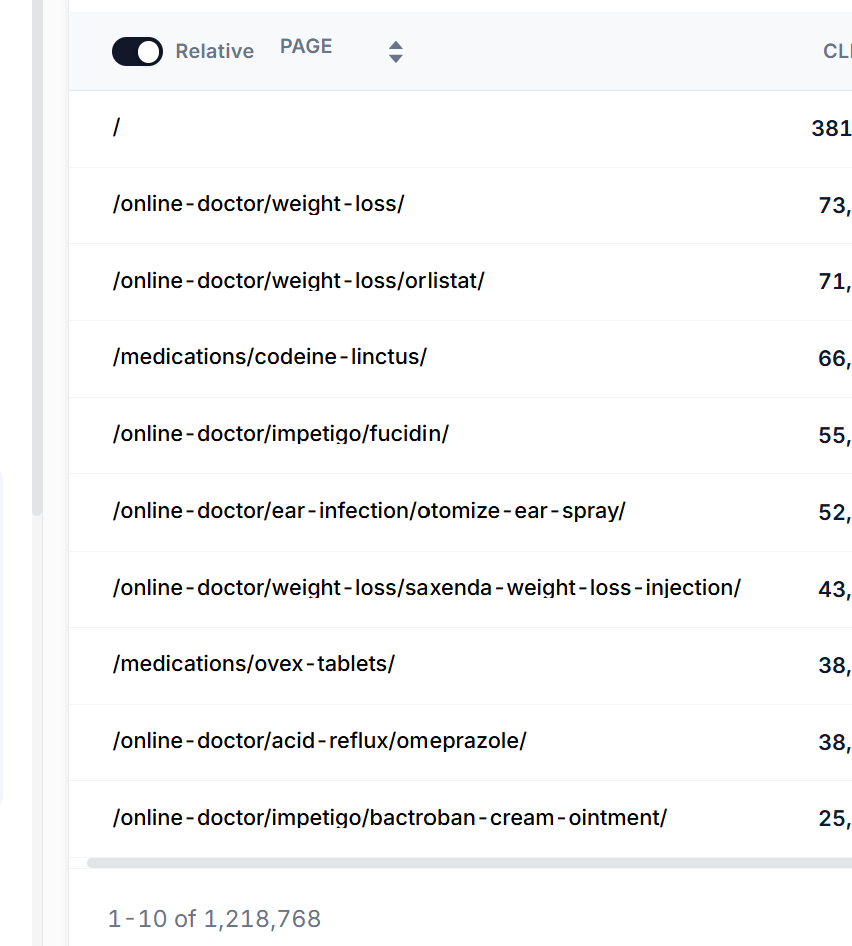
Questo sito ha servito oltre 1.218.768 URL!
Quindi, collegare GSC a Claude o ChatGPT in casi come questo porterà probabilmente a un enorme vuoto nell'analisi reale dei dati.
Ecco perché sono MOLTO SCETTICO nei confronti di chi afferma di automatizzare la propria SEO con l'AI senza qualche forma di ripercussione più avanti; lo stesso vale per gli audit: se usi un LLM per fare un audit e non riesce a ottenere tutti i dati, come potrebbe mai essere accurato?
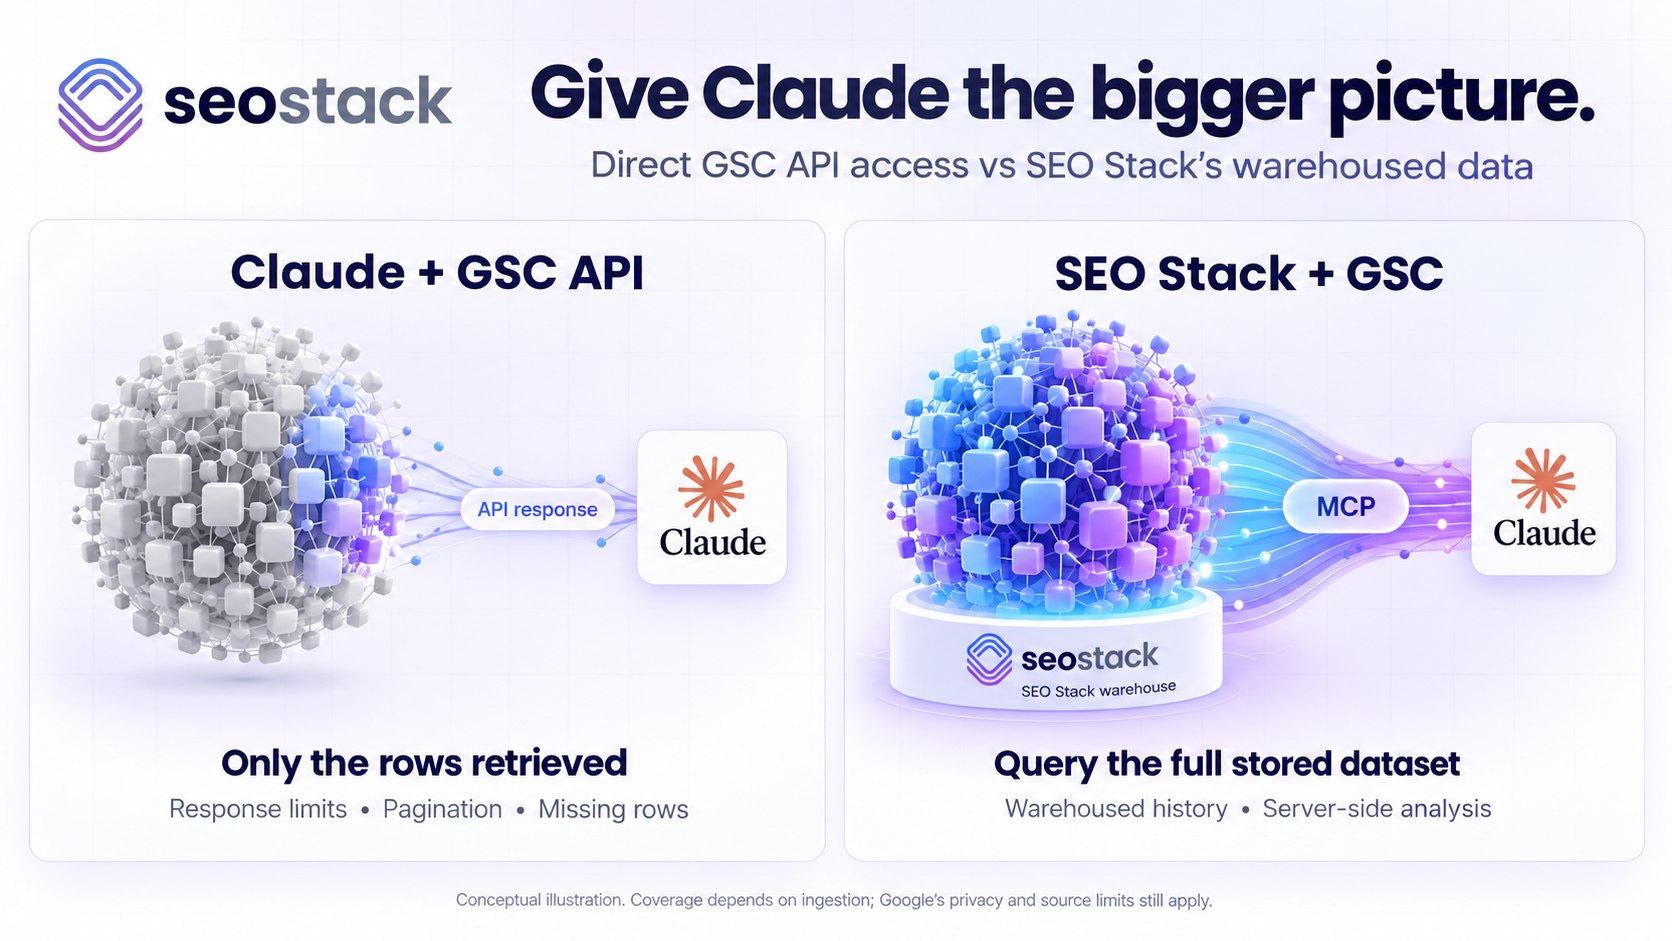
L'immagine qui sopra dovrebbe illustrare quello che sto dicendo riguardo all'accesso ai dati e al garantire che l'LLM possa accedere a tutto e non solo a una parte dei dati.
SEO Stack è un data warehouse, come Google BigQuery: fornisce TUTTI i dati via MCP e fa sì che gli LLM abbiano con tutta probabilità il contesto completo anziché un dataset limitato prima di fare audit o analisi.
I limiti dell'API di GSC che alcuni confondono
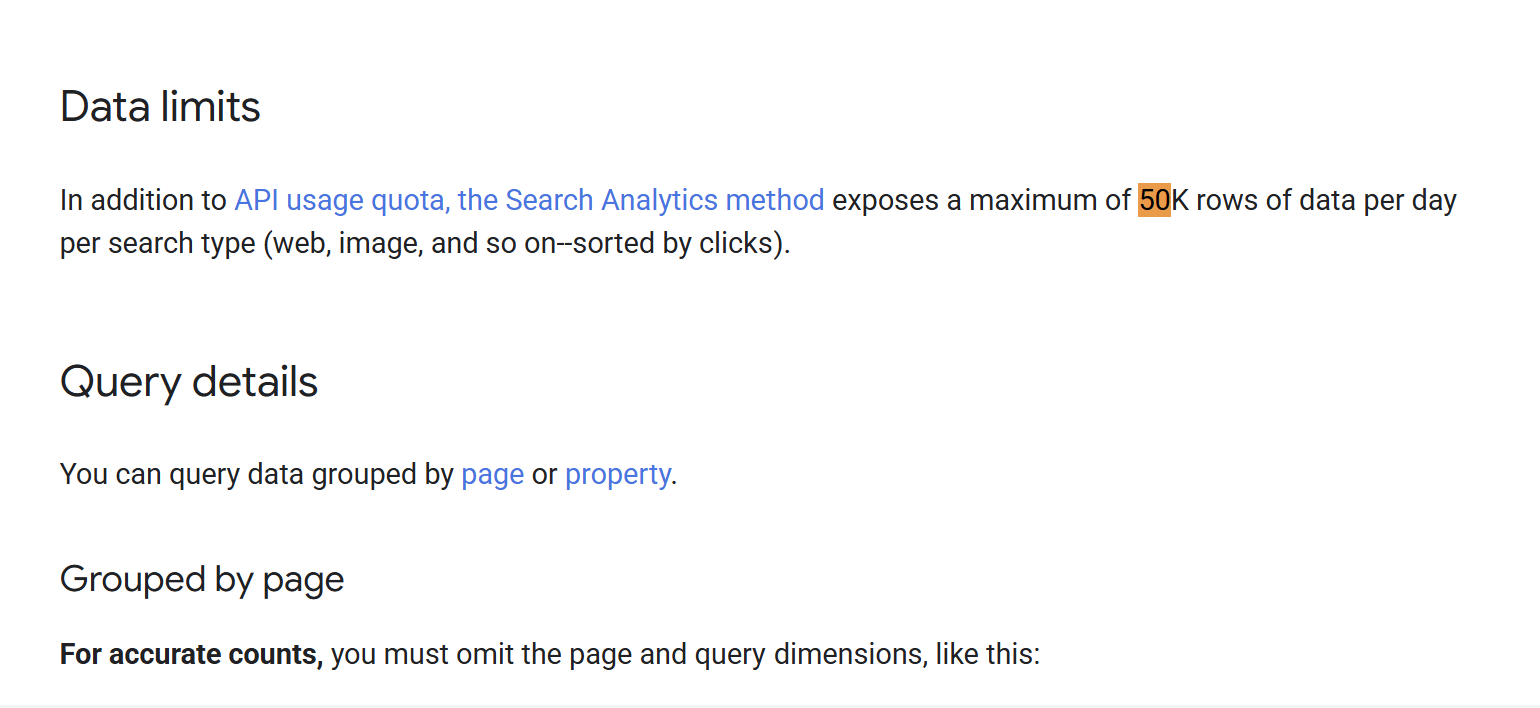
Qui ci sono diverse restrizioni distinte (vedi https://developers.google.com/webmaster-tools/v1/searchanalytics/query e https://developers.google.com/webmaster-tools/v1/how-tos/all-your-data) e, di conseguenza, mescolarle tra loro produce confronti piuttosto fuorvianti. Tieni solo presente che una quota di richieste non è un limite rigido di righe, e nessuna delle due cose ti dice quanti dati storici hai conservato o a cui hai avuto accesso.
Quote di richieste e limiti di carico
Le quote pubblicate da Google per Search Analytics sono le seguenti; QPM significa richieste al minuto, QPD significa richieste al giorno: si tratta del volume di chiamate API, e non del numero di query di ricerca per cui il tuo sito è comparso (per essere chiari)
Ambito | Quota pubblicata per Search Analytics |
Per sito | 1.200 QPM |
Per utente | 1.200 QPM |
Per progetto | 40.000 QPM e 30.000.000 QPD |
Sono limiti piuttosto generosi: sarebbe ridicolo sostenere che ogni SEO che pone qualche domanda a Claude esaurirà immediatamente le richieste disponibili. Non è così: per molti casi d'uso, Claude e GSC insieme sono perfettamente all'altezza.
Google applica inoltre quote di carico a breve termine su finestre di 10 minuti e quote di carico a lungo termine su base giornaliera. Intervalli di date più ampi comportano un carico maggiore, e le richieste che coinvolgono sia il raggruppamento sia il filtraggio per pagina e query sono particolarmente onerose. Google non pubblica un limite di carico numerico semplice su quella pagina.
Per analisi ripetute su siti di grandi dimensioni o su un portfolio di agenzia, il lavoro richiesto da ogni singola richiesta può quindi contare più del limite giornaliero dichiarato.
Un'altra precisazione: le spesso citate 2.000 richieste per sito al giorno riguardano il Controllo URL, non il reporting delle performance di Search Analytics; in generale si tratta di risorse separate con quote separate.
Limiti di risposta e righe disponibili
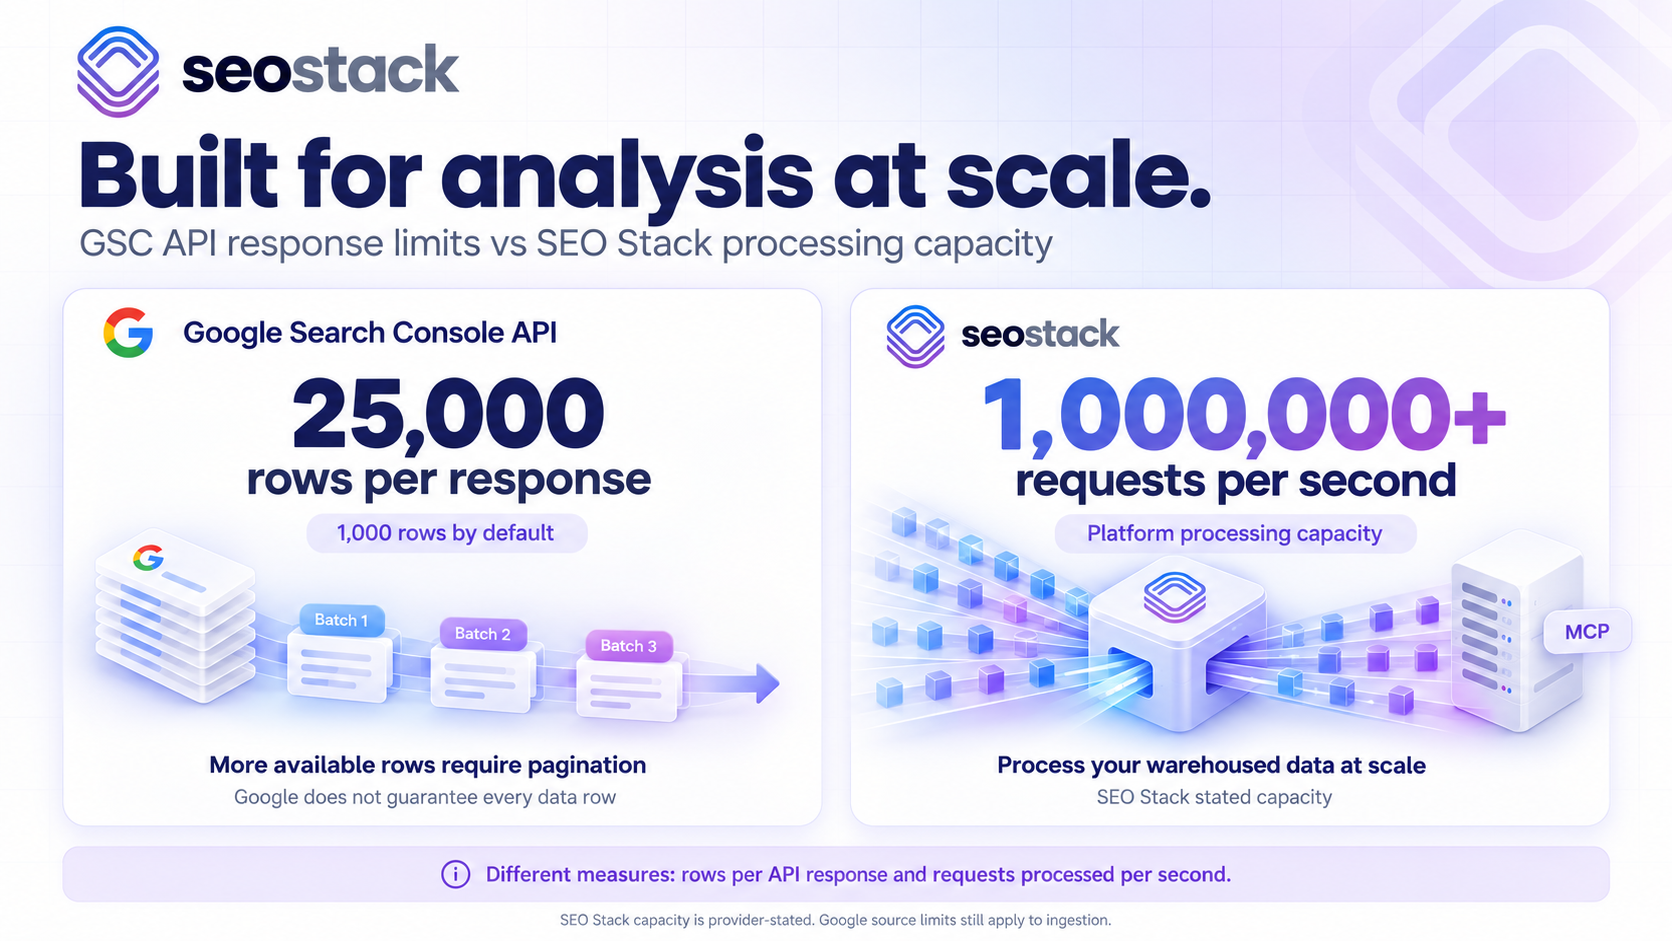
L'API Search Analytics restituisce per impostazione predefinita 1.000 righe per risposta e consente un massimo di 25.000 - così generoso da parte di Google. Le righe disponibili oltre questo limite richiedono la paginazione tramite startRow, elemento da considerare quando si effettuano molte richieste. La documentazione di G avverte anche esplicitamente che l'API non garantisce ogni riga: dà priorità ai risultati principali, di norma ordinati per clic, e per le richieste multidimensionali questo può accumularsi rapidamente (lo sappiamo: quando abbiamo costruito l'architettura del data warehouse di SEO Stack è stato impressionante vedere quanto velocemente crescessero i volumi di dati).
Separatamente, Google documenta un limite di esportazione fino a 50.000 righe al giorno, per sito, per tipo di ricerca, che potrebbe non essere raggiunto in ogni caso. È una cosa diversa dal limite di 25.000 righe per risposta.
Quindi, aumentare rowLimit è utile e la paginazione è necessaria quando ci sono più risultati disponibili, ma nessuna delle due cose dimostra che ora possiedi ogni possibile combinazione di query e pagina.
Google consiglia un'estrazione giornaliera e spiega che includere le dimensioni pagina o query può causare la perdita di alcuni dati. Scegliere dimensioni più dettagliate comporta un compromesso che chi interpreta l'output deve comprendere.
Claude ottiene tutti i tuoi dati di Search Console?
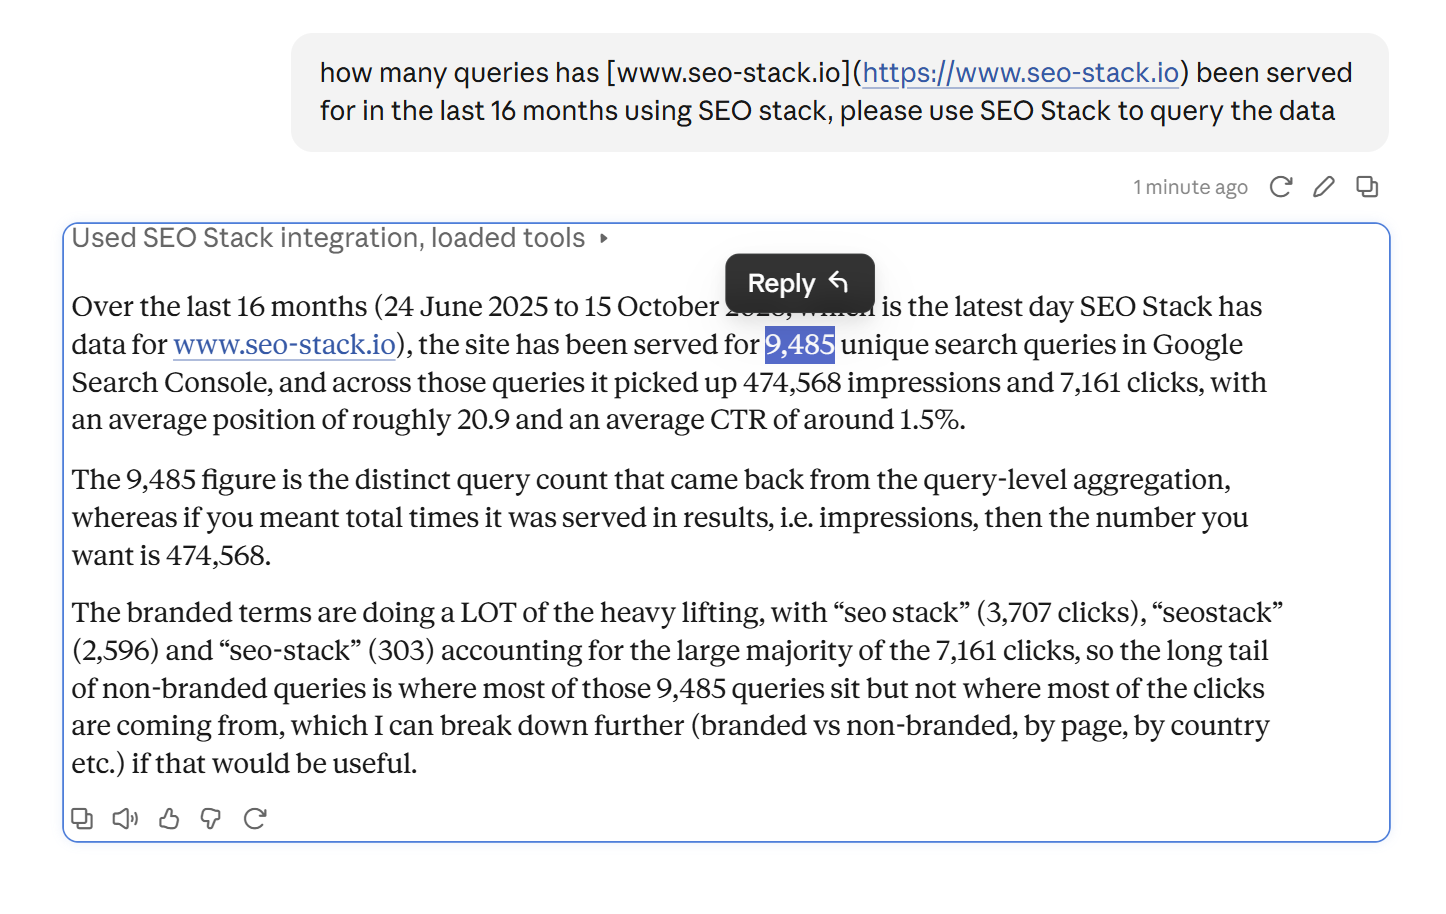
Dipende da cosa intendi per tutti, e questa precisazione vale anche per SEO Stack. Ho pensato quindi di fare un rapido test. Ho configurato Claude per usare l'API di GSC e l'MCP di SEO Stack, e ho fatto un confronto equo chiedendo per quante query SEO Stack è stato mostrato negli ultimi 16 mesi:
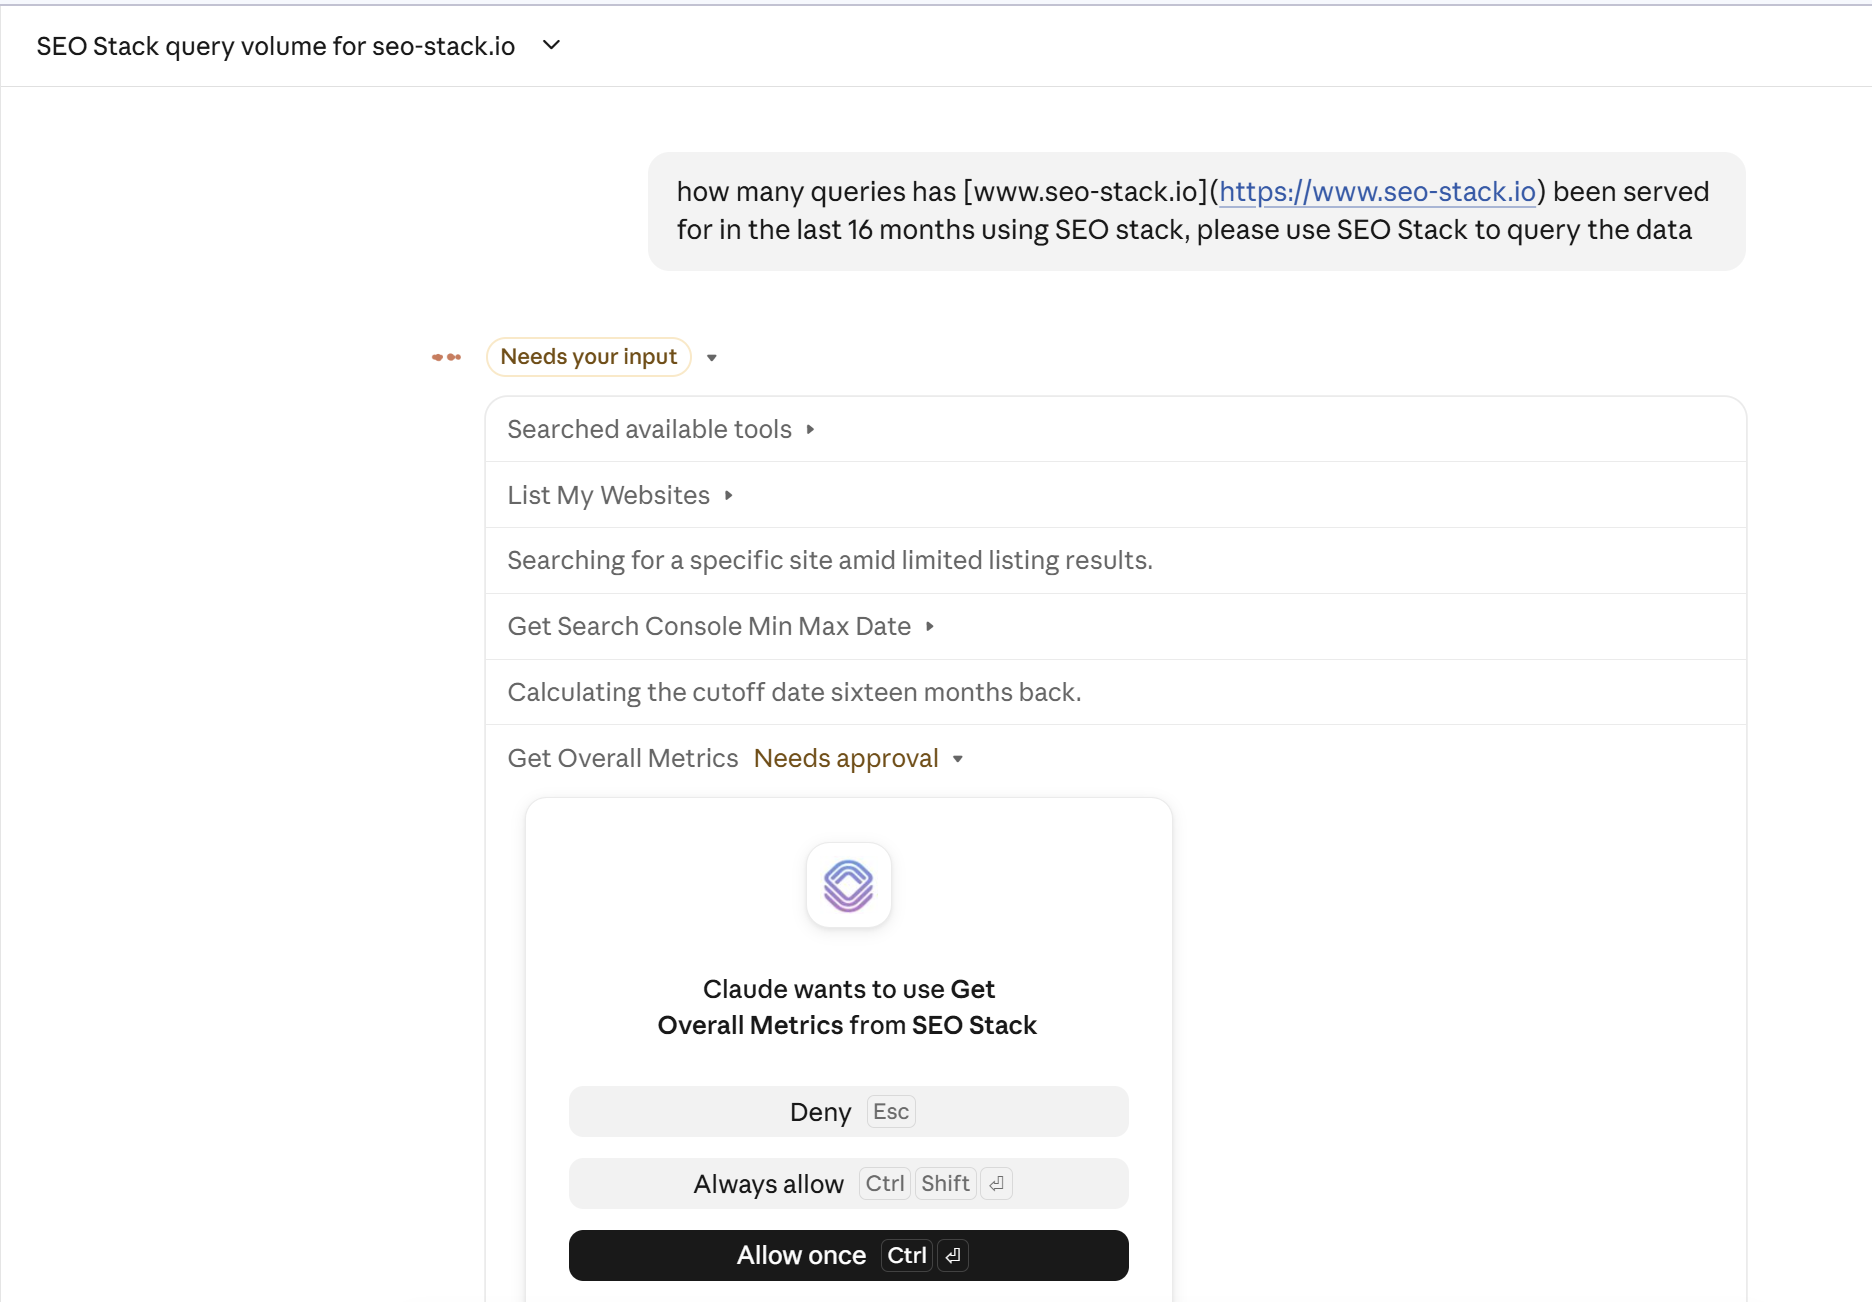
Ed ecco l'output:
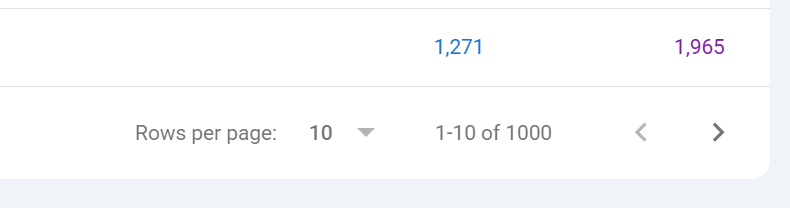
Poi, guardando GSC >> Integrazione API ho visto >
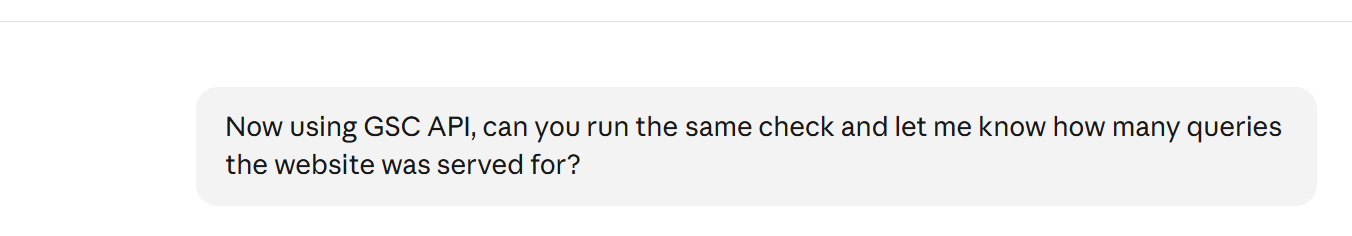
E il numero di query restituite?

Quindi sì, c'è subito una discrepanza nel conteggio delle query; in parte è attribuibile anche al fatto che SEO Stack dispone di dati estesi, perché non è limitato a 16 mesi.
Andando avanti, ci sono tre aspetti distinti che vale la pena verificare:
Primo: il tuo connettore ha recuperato tutte le righe disponibili per quella richiesta? Qualunque connettore o soluzione tu stia usando, devi assicurarti che stia ottenendo tutti i dati e che nulla venga tralasciato.
Secondo: la fonte espone tutto il livello di dettaglio richiesto dalla tua analisi? Completare la paginazione non equivale a rimuovere le restrizioni interne di Google sui dati quando si parla di volumi di richieste.
Terzo: stai chiedendo informazioni che Google deliberatamente non divulga? I dati su clic/query anonimizzati sono un esempio tipico: Google li esclude dal reporting dettagliato delle query per tutelare la privacy degli utenti. I totali complessivi possono includere quell'attività anche se il testo della singola query è assente.
Quanto sopra spiega in parte perché sommare le query nominate può dare un totale di clic diverso da quello di un report complessivo correttamente allineato (a causa di omissioni nei dati). Non significa automaticamente che il connettore abbia un problema, ma può indicare che non tutti i dati sono disponibili o esposti nelle richieste, con ogni sorta di conseguenza quando si eseguono analisi o audit!
Eviterei anche di chiamare ogni omissione "sampling": filtraggio per privacy, limite di risposta, restrizione giornaliera all'esportazione e un connettore che restituisce solo il primo batch sono problemi diversi, con implicazioni diverse. Se vogliamo criticare la qualità dell'analisi dell'AI, dovremmo quantomeno essere precisi su cosa manca.
Come le estrazioni incomplete possono distorcere le raccomandazioni SEO
Quelli che seguono sono problemi/rischi potenziali a titolo esemplificativo che possono verificarsi (e si verificano); non sono affermazioni valide per ogni connettore GSC o per ogni risposta che Claude può dare. Un'integrazione solida può verificare la copertura, calcolare al di fuori del modello e dichiarare l'incertezza.
Come ho evidenziato prima, dati incompleti possono portare raccomandazioni di audit o analisi SEO a basarsi su dati errati, con consigli sbagliati e insight scorretti. L'ho testato: succede spesso, soprattutto con le allucinazioni.
Ecco quindi alcuni dei problemi che puoi aspettarti:
Le opportunità long-tail scompaiono dalla valutazione
Immagina un sito ecommerce con un catalogo ampio e migliaia di query che generano impression ma pochissimi clic. Se l'analisi riceve solo le righe principali che generano clic, potrebbe concentrarsi su prodotti già performanti, trascurando categorie meno consolidate o ricerche commercialmente rilevanti che meriterebbero attenzione. In genere i siti hanno un grande volume di query ZSV (zero search volume) e molte di queste possono restare fuori dalle richieste.
L'output o le indicazioni possono sembrare del tutto ragionevoli, ma l'elenco su cui si basano potrebbe comunque essere una risposta scadente alla domanda "Dove sono TUTTE le nostre opportunità?", soprattutto se un gran numero di quelle query manca o è stato omesso.
Una selezione utile per riportare i principali driver di traffico non è necessariamente adatta a individuare la domanda trascurata e, come sappiamo dai dati long-tail, è spesso lì che si nascondono le opportunità a intento più alto.
Le righe mancanti diventano apparenti perdite di posizionamento
Supponiamo che una query compaia nell'estrazione di un periodo ma sia assente in quella successiva: un workflow poco attento (o privo di supervisione umana) potrebbe classificarla come visibilità persa, quando la riga potrebbe semplicemente essere rimasta fuori dalla selezione restituita. Se le richieste di righe vanno in timeout o superano un limite, mancherà una grande quantità di dati e, se l'LLM non lo capisce, potrebbe riportarlo come perdita.
Quindi, per esempio, prima di consigliare una revisione dei contenuti vorrei una verifica mirata su quella query, filtri coerenti e una chiara comprensione del metodo di estrazione. "Non presente in questa risposta" è un'osservazione molto diversa da "Google non mostra più questo sito".
LLM come Claude o ChatGPT potrebbero fare raccomandazioni sbagliate o suggerirti di creare contenuti che hai già, perché non accedono a tutti i dati del sito e non riescono a vedere oltre (a meno che non dispongano di un inventario esplicito dell'indice del tuo sito).
Le analisi di cannibalizzazione non rilevano gli URL in competizione
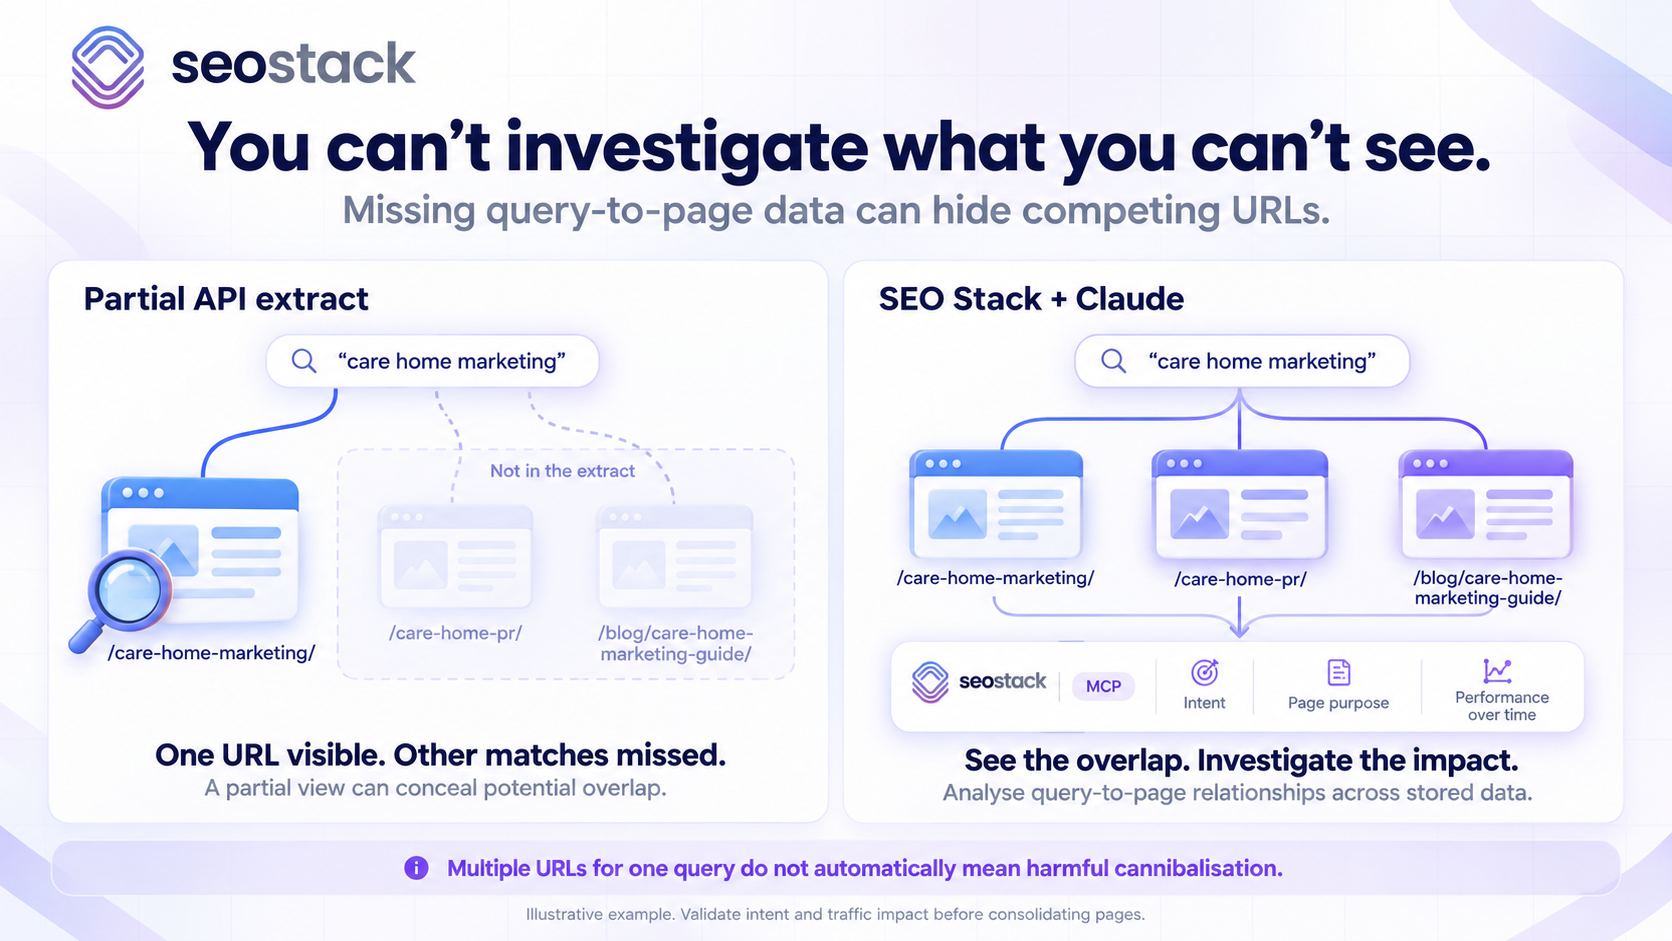
Se la tua analisi riceve solo uno degli URL associati a una query, non può verificare correttamente se un'altra pagina è in competizione con essa. Anche quando entrambi gli URL compaiono, la loro coesistenza è un motivo per indagare, non stabilisce automaticamente che ci sia cannibalizzazione.
Per l'analisi della cannibalizzazione, il tuo LLM ha bisogno di accedere a tutti i dati (proprio tutti) perché altrimenti gli URL/query che cannibalizzano potrebbero non comparire laddove parte dei dati manca: anche questo, di nuovo, succede.
In aggiunta, devi comunque esaminare l'intento, lo scopo della pagina, i cambiamenti nel tempo e se la presunta competizione stia effettivamente impattando o riducendo traffico utile.
Le classificazioni di brand diventano fuorvianti
Considera una proprietà ipotetica con 10.000 clic in un report complessivo corrispondente: le query nominate recuperate rappresentano 7.000 clic, di cui 2.000 classificati come brand.
Il brand rappresenta il 28,6% dei clic delle query recuperate, perciò sarebbe fuorviante presentare quel dato come la quota di brand su tutti i 10.000 clic, perché i restanti 3.000 non sono stati classificati. Puoi riportare 2.000 clic di brand identificabili come il 20% del totale, ma questo non stabilisce comunque la reale quota di brand complessiva.
I tuoi dati storici contano quanto il numero di righe
Search Console fornisce uno storico delle performance mobile di circa 16 mesi; Google ha introdotto quella finestra estesa per supportare confronti di lungo periodo e anno su anno, ma resta comunque un periodo di reporting finito.
SEO Stack invece ti offre 10 anni, non 16 mesi, 10 ANNI!
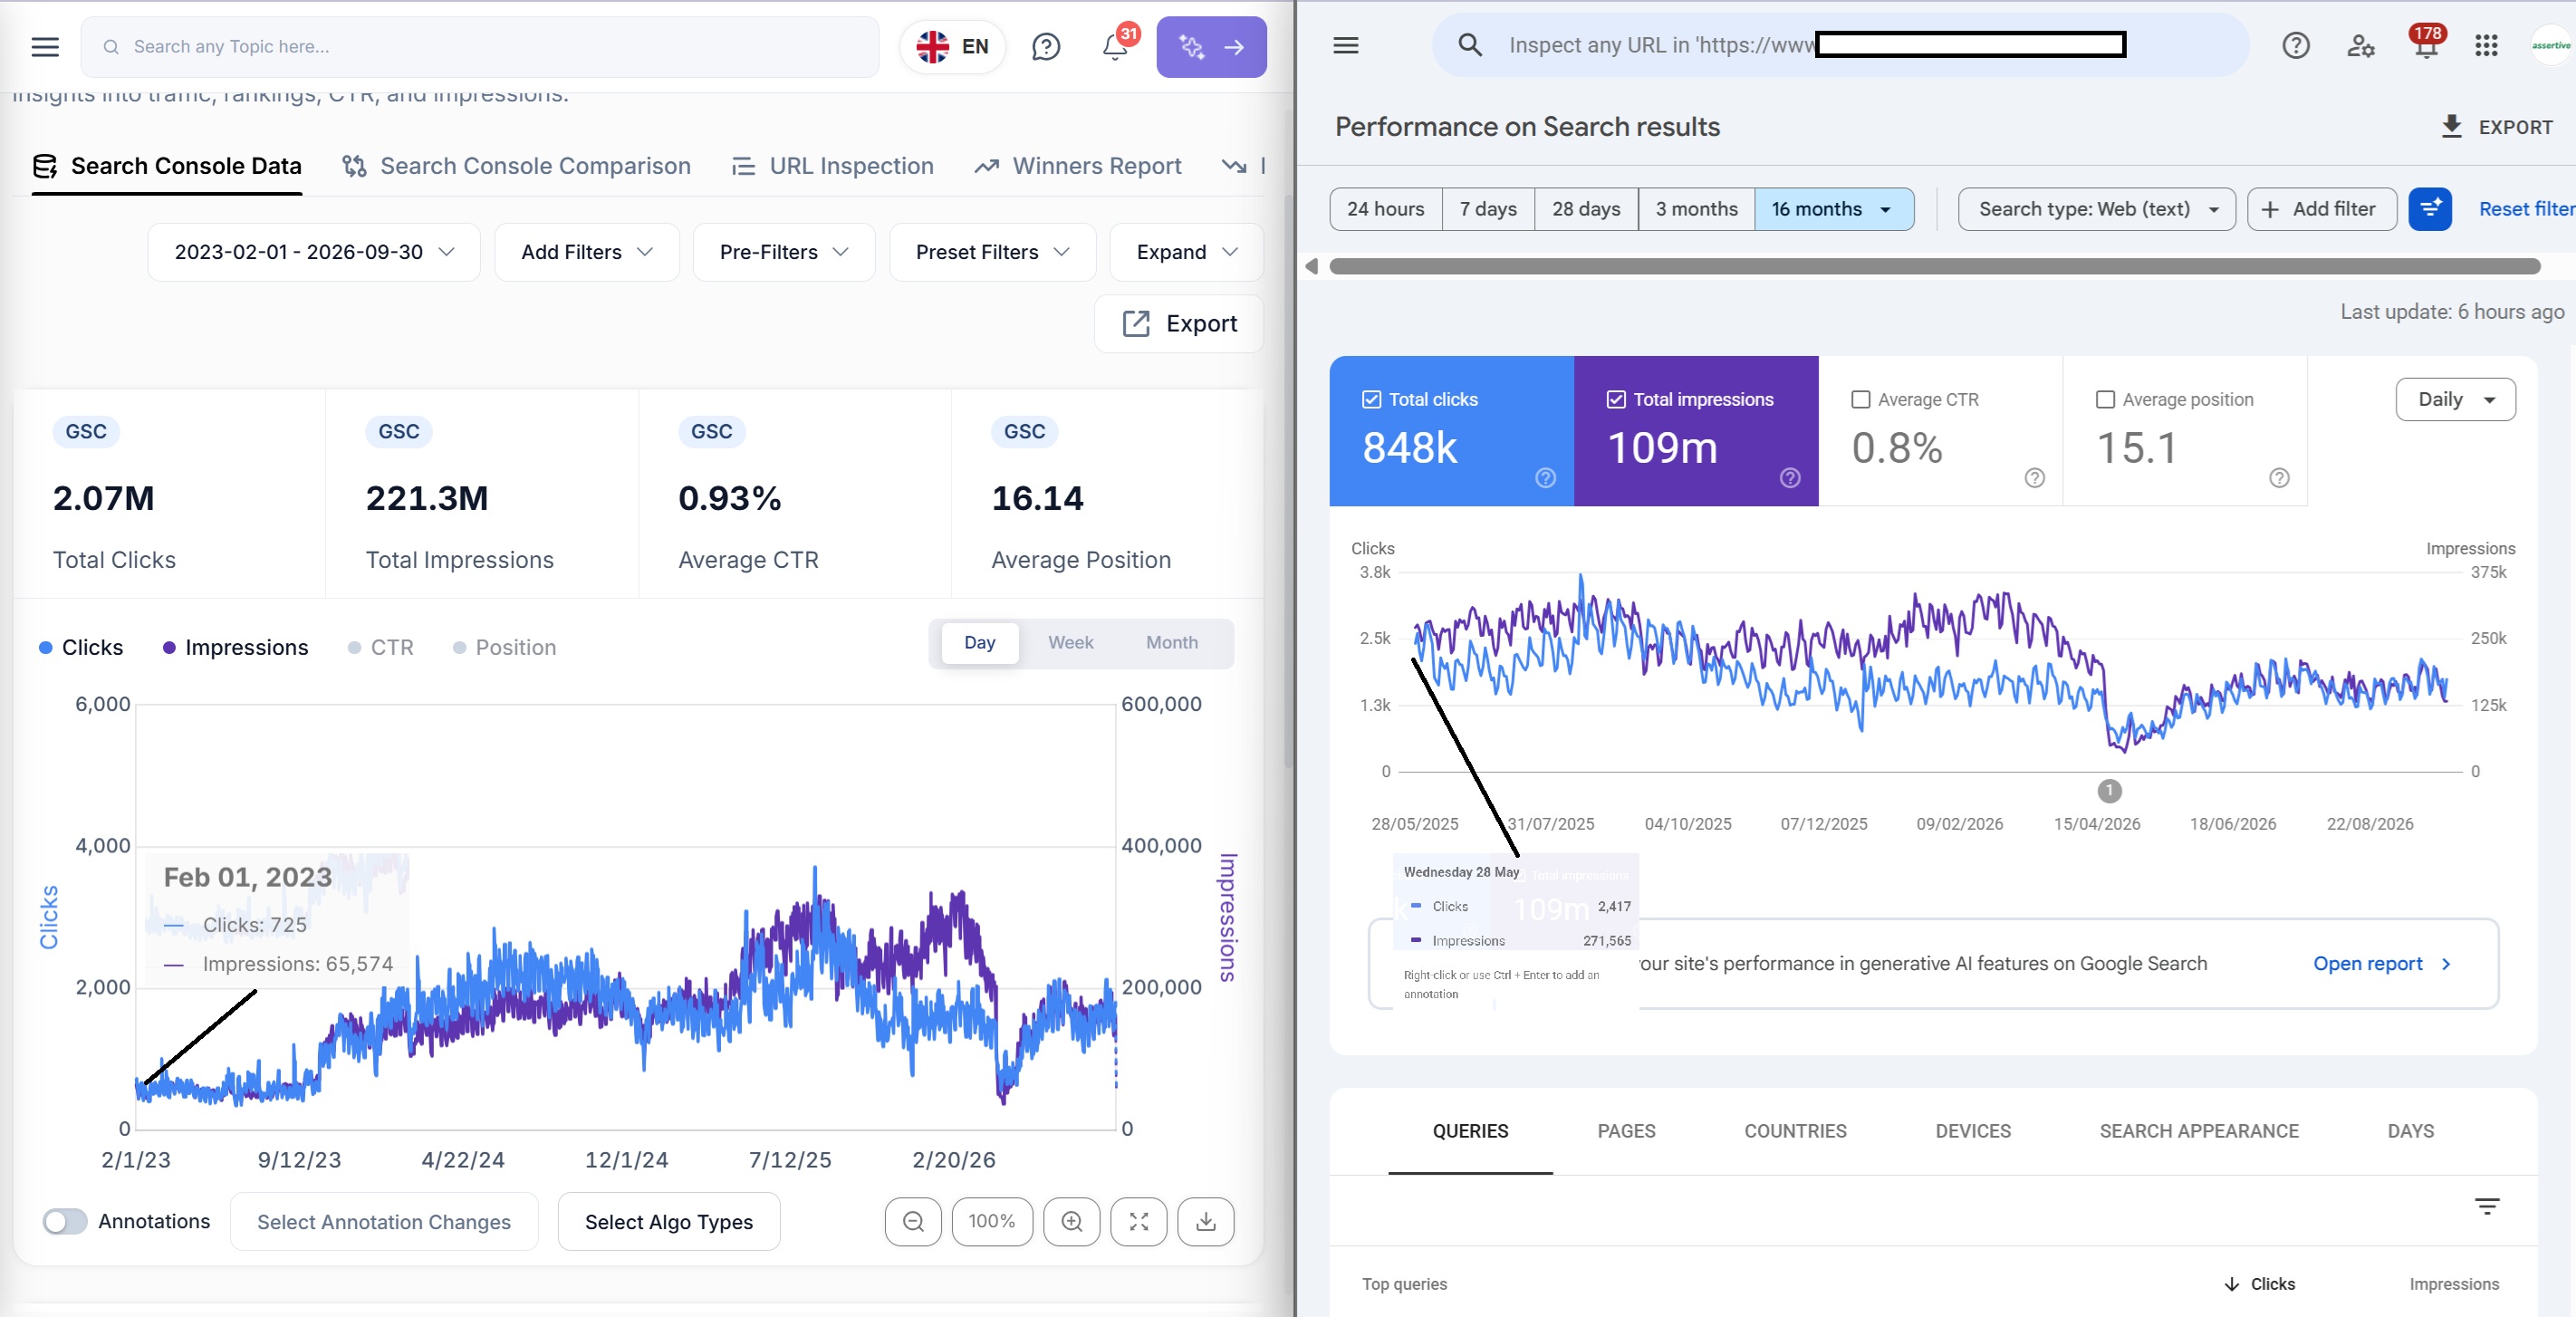
Può bastare per confrontare il mese scorso con lo stesso mese dell'anno precedente OPPURE gli ultimi 3 mesi anno su anno ma, non basta per valutare adeguatamente 5 anni di performance stagionali, rivedere una migrazione più datata o esaminare se un calo è iniziato ben prima dell'ultimo aggiornamento di Google.
Non puoi chiedere a Claude di analizzare dati GSC che non ci sono: oltre i 16 mesi non c'è nulla, a meno che tu non usi Google BigQuery, cosa che alcuni SEO fanno, ma molti no perché, sebbene sia ottimo per archiviare i dati di GSC, non ha una UI tradizionale e non permette agli utenti di interagire con i dati storici di GSC in un'interfaccia in stile GSC: serve tipicamente conoscere SQL, Python oppure integrarlo con Google Data Studio.
Quindi la mia raccomandazione è semplice: conserva i dati finché puoi ancora accedervi. Un archivio del tuo GSC diventa più prezioso col tempo: immagina tutti i dati di long-tail e di keyword, immagina poter confrontare 12 mesi anno su anno.
BigQuery risolve una parte importante del problema
L'esportazione in blocco nativa di Search Console di Google invia i dati giornalieri di performance a BigQuery senza il limite giornaliero di righe dell'API. Questo lo rende un'opzione seria per i siti più grandi, invece di essere semplicemente un altro modo per scaricare la stessa estrazione limitata dell'API.
C'è però un dettaglio che merita attenzione: la panoramica di Google descrive le query anonimizzate come escluse, mentre il riferimento alle tabelle documenta record anonimizzati con il testo della query omesso. La distinzione utile è che le metriche anonimizzate possono essere rappresentate, ma i termini di ricerca nascosti non vengono rivelati, il che può distorcere i numeri dell'analisi.
BigQuery può quindi affrontare un'importante fonte di perdita in estrazione e conservare lo storico. Può anche supportare un sistema di reporting sofisticato e un workflow AI, a condizione che qualcuno costruisca e mantenga quelle parti - ma molti SEO non hanno mai lavorato con BigQuery o semplicemente non hanno avuto il tempo di configurarlo.
Non lo liquiderei: per un'azienda con un team dati consolidato, un'infrastruttura Google Cloud già esistente e requisiti analitici specifici, potrebbe essere esattamente la scelta giusta - e benché consigliamo a SEO e aziende di usare SEO Stack per il data warehousing, sappiamo che alcune aziende vogliono una soluzione interna (ancor di più da quando è arrivata l'AI).
Per un SEO che vuole un reporting storico utilizzabile senza avviare l'ennesimo progetto tecnico, gli aspetti pratici sono decisamente meno attraenti.
La seccatura è tutto ciò che sta attorno al warehouse
La configurazione di Google richiede un progetto Cloud con fatturazione attiva, i servizi BigQuery abilitati, i permessi per il service account di esportazione e una destinazione di export configurata in Search Console. C'è un livello di utilizzo gratuito, con costi per lo storage e per l'uso delle query oltre le soglie previste. L'export nativo inizia a raccogliere dati da quel momento in avanti, non recupera automaticamente i 16 mesi precedenti.
Poi devi trasformare le tabelle archiviate in qualcosa che il tuo team possa usare.
BigQuery ha una propria interfaccia e puoi creare un'esperienza di reporting perfettamente coerente con Looker Studio, un altro prodotto BI o un'applicazione personalizzata. Ciò che non ottieni semplicemente abilitando l'export è un'applicazione SEO già pronta con i filtri, i confronti e i flussi di indagine a cui sei abituato, applicati sia ai dati recenti sia a quelli storici.
Qualcuno deve decidere come funzionano quei report, mantenere le definizioni e gestire i problemi quando un numero non torna.
Le linee guida di Google sulle query indicano inoltre che le righe esportate non sono necessariamente consolidate, quindi le metriche richiedono un'aggregazione adeguata. Google fornisce i calcoli per CTR e posizione, inclusa la correzione della posizione richiesta dallo schema di export.
Claude può aiutare a scrivere SQL, ovviamente, ma la query va comunque verificata. Un calcolo errato eseguito con successo su un warehouse completo resta un calcolo errato.
Dove SEO Stack e Claude diventano una combinazione più forte
SEO Stack combina un warehousing gestito con un'interfaccia SEO e una connessione MCP a quei dati archiviati. L'offerta pubblicata include lo storico di GSC, GA4 e AI visibility, accessibile tramite l'applicazione o in modo programmatico, con una conservazione che dipende dal piano e dallo storico effettivamente accumulato.
Per l'utente, questo porta il reporting recente e quello più datato nello stesso ambiente di lavoro. Puoi porre una domanda a Claude e poi indagare il segmento rilevante nell'applicazione, invece di affidarti interamente alla narrazione che ha scritto.
È un vantaggio pratico significativo. Se sto formulando una raccomandazione commerciale, voglio poter ispezionare i numeri, cambiare il periodo e mettere in discussione l'interpretazione senza dover ricostruire il report altrove.
Il prodotto introduce anche una distinzione che conta per i workflow AI: fornisce funzioni di analisi già pronte sopra il warehouse. Gli strumenti MCP pubblicati includono confronti tra periodi, raggruppamento di query e pagine e analisi per segmento di URL, con i calcoli eseguiti lato server.
Invece di chiedere al modello di assemblare un confronto tra cartelle a partire da numerosi batch di dati grezzi, il servizio può eseguire il confronto supportato e restituire il risultato perché Claude lo spieghi.
C'è meno lavoro di estrazione da coordinare per l'agente, e meno occasioni perché un batch incompleto diventi silenziosamente la base della risposta finale.
Cosa significa davvero ottenere i tuoi dati archiviati in una sola richiesta
SEO Stack pubblicizza l'accesso ai dati GSC correnti e archiviati in un'unica richiesta MCP, con recupero di risultati di grandi dimensioni e aggregazione lato server. Per una query supportata sul warehouse, questo può evitare all'agente di dover paginare da solo attraverso l'API live di Google.
L'interpretazione più utile è che una singola richiesta di analisi può operare sull'intero dataset conservato rilevante, invece di costringere l'LLM a leggere ogni singolo record sottostante.
Per esempio, un confronto tra cartelle può calcolare le variazioni su un insieme molto ampio di righe archiviate e restituire una tabella compatta di cartelle, clic e differenze. Claude può lavorare sul risultato, mentre i record di dettaglio restano disponibili per l'indagine.
È un obiettivo molto più sensato che spingere dieci milioni di righe in una chat sperando che il modello le elabori accuratamente. Le stesse linee guida di ingegneria di Anthropic parlano di elaborare e filtrare i risultati MCP al di fuori del contesto del modello per ridurre il volume che deve consumare.
Una singola richiesta analitica non significa nemmeno che ogni indagine si concluda con una sola chiamata allo strumento. Identificare il sito, verificare le date disponibili, recuperare un confronto ed esaminare un URL sospetto possono legittimamente richiedere più chiamate. Il guadagno sta nell'evitare lavoro di estrazione e preparazione inutile, non nell'impedire domande di approfondimento utili.
Ci sono altre due precisazioni su cui insisterei, qualunque prodotto si scelga. Leggere un warehouse non elimina le restrizioni che hanno riguardato la raccolta originale, e nessun fornitore può recuperare le query che Google non ha mai divulgato. Inoltre, la conservazione deve essere già avvenuta prima di poter analizzare uno storico più lungo: acquistare una conservazione di dieci anni non fa comparire dal nulla dieci anni di performance passate.
Confronto tra i tre approcci
Requisito | Claude con un connettore API GSC live | Export nativo su BigQuery con un workflow AI | SEO Stack con Claude |
Domande mirate sulle performance | Utile con richieste delimitate correttamente | Possibile tramite query sul warehouse | Supportate tramite strumenti già pronti |
Restrizioni di raccolta | Soggetto ai limiti dell'API e al comportamento del connettore | L'export bulk nativo evita il limite giornaliero di righe dell'API | Dipende dalla raccolta che alimenta il warehouse |
Analisi storica più estesa | Richiede un archivio oltre lo storico live di GSC | Conserva gli export raccolti secondo le tue impostazioni | Storico conservato in base al piano applicabile |
Calcoli di analisi riutilizzabili | Dipende dall'implementazione del connettore | Devi costruire o adottare SQL e logica di reporting | Confronti pronti e strumenti di raggruppamento |
Interfaccia SEO coerente | Dipende dal connettore | Devi costruire o configurare un livello di reporting | Applicazione inclusa insieme a MCP |
Una singola richiesta sull'intero storico conservato | Richiede un servizio di archiviazione separato | Possibile con uno strumento di query adeguato | Dichiarata per le query MCP supportate |
Testo delle query nascoste | Non recuperabile | Non divulgato dall'export | Non recuperabile da dati di origine non divulgati |
Questo è un confronto tra un'integrazione API solo live, l'export nativo di Google e le capacità dichiarate di SEO Stack. Un connettore personalizzato sofisticato può includere anche caching, warehousing e analisi lato server, ma a quel punto stai confrontando due sistemi completi, non una connessione API diretta con una piattaforma gestita.
Le domande che farei prima di fidarmi della risposta
Che tu usi SEO Stack, un MCP personalizzato o un workflow BigQuery, vorrei che l'analisi chiarisse alcuni punti prima di produrre raccomandazioni:
Quale property, tipo di ricerca, date e filtri ha usato?
Sta analizzando l'intero dataset conservato per quello scope, o un estratto limitato?
Qual è la data più recente disponibile, e ci sono lacune nello storico conservato?
Una query mancante significa un'assenza verificata, o semplicemente un'assenza da questo estratto?
I totali vengono confrontati allo stesso livello di aggregazione, tenendo separata l'attività delle query sconosciute?
Quali evidenze supportano la raccomandazione, e quali ulteriori verifiche la cambierebbero?
Non sono dettagli accademici. Determinano se una raccomandazione merita di essere implementata, soprattutto quando comporta la rimozione di pagine, la ristrutturazione di un sito o l'impegno di mesi di budget per i contenuti.
Preferisco una risposta che riconosca una lacuna piuttosto che una spiegazione scritta benissimo che finge in silenzio che la lacuna non esista.
Perché sceglierei SEO Stack per questo workflow
Un'integrazione GSC di base è un buon punto di partenza per domande rapide e ben definite. Se hai le competenze e le risorse per costruire un warehouse e un sistema di reporting attorno a BigQuery, anche quella può essere un'ottima strada.
Per i team che vogliono uno storico di ricerca conservato, un'interfaccia realmente utilizzabile e Claude collegato a strumenti analitici già pronti, SEO Stack mette insieme questi requisiti. Non ti ritrovi con una connessione AI funzionante e un'altra lista di cose da fare prima che i dati diventino utili.
Quello che mi convince è poter porre una domanda su tutto lo storico già conservato, ottenere il calcolo supportato e poi ispezionarlo nell'applicazione. È una base molto più solida per le decisioni SEO rispetto ad accettare una valutazione sicura di sé senza sapere cosa il modello abbia potuto vedere.
Collega Claude tramite l'MCP di SEO Stack, usa il warehouse e le funzioni di analisi che ci stanno dietro, e mantieni la possibilità di interrogare tu stesso la risposta. La connessione è utile, ma sono i dati e il modo in cui ci lavori a renderla davvero preziosa.
Fonti
Ricerca verificata il 23 ottobre 2026. Le fonti Google e Anthropic documentano il comportamento delle piattaforme. Le fonti SEO Stack descrivono le capacità dichiarate del prodotto, non un test di integrazione sottoposto a benchmark indipendente.
1. Connettori personalizzati Anthropic con MCP remoto
2. Limiti di utilizzo dell'API di Google Search Console
3. Riferimento alle query di Google Search Analytics
4. Filtri e limiti dei dati sulle performance di Google
5. Guida di Google al recupero dei dati sulle performance
6. Google presenta il nuovo Search Console e i 16 mesi di dati sulle performance
7. Annuncio dell'export bulk nativo di Google
8. Panoramica dell'export bulk di Google e riferimento alle tabelle di export
9. Configurazione dell'export bulk dei dati di Google
10. Linee guida e calcoli per le query di export di Google
11. Data warehousing di SEO Stack e confronto con BigQuery
12. Strumenti MCP e API di SEO Stack e accesso per agenti AI

Fondatore, SEO Stack
Daniel è il fondatore di SEO Stack. Ha trascorso oltre due decenni lavorando su SEO tecnica e dati di ricerca, e ha creato SEO Stack dopo essersi scontrato, una volta di troppo, con i soliti limiti di Search Console nel lavoro con i clienti.
Daniel ha una vasta esperienza in ambito SEO: ha costruito agenzie SEO, attività di audit e una consulenza di grande successo. Nel tempo libero, si diverte a condurre esperimenti SEO e a condividerne i risultati.
Pubblicato 24 ottobre 2026


