Claude y Google Search Console vs SEO Stack y Claude
Así que, como era de esperar, en las distintas plataformas sociales veo cada vez a más SEOs conectando Claude a Google Search Console. Y lo entiendo: básicamente estás emparejando tu herramienta de IA c
Así que, naturalmente, en las distintas plataformas sociales veo cada vez más SEOs que conectan Claude a Google Search Console. Y lo entiendo: básicamente estás emparejando tu herramienta de IA con tus datos SEO de GSC para acelerar el análisis, identificar oportunidades, etc., y eso está genial hasta que lo miras un poco más de cerca.
Algunos SEOs preguntan qué páginas perdieron clics, comparan el rendimiento antes y después de una migración, investigan un grupo de consultas, qué URLs tienen canibalización, etc., y, bastante rápido, despachas un trabajo que de otro modo implicaría exportaciones, hojas de cálculo y una buena cantidad de palabrotas.
Lo que yo cuestionaría es la suposición de que conectar un LLM a GSC le da automáticamente todo lo que necesita para llevar a cabo una evaluación SEO completa: SPOILER, no es así. ¿Por qué? Porque hay varias razones principales, a saber:
Los SEOs necesitan saber qué preguntar y cómo interpretar las respuestas de Claude, ChatGPT o Gemini (sea cual sea el LLM que hayan conectado a su GSC)
Luego está el tema de las alucinaciones en los datos, y ocurre mucho; lo desarrollaré en breve: básicamente, hice que ChatGPT realizara una auditoría y auditó URLs que no existían porque había datos heredados en GSC sobre ellas (sin broma)
Y luego está el asunto de los límites de consultas / filas de la API de GSC y, esto es bastante problemático si estás auditando datos pero no el conjunto de datos completo: los huecos o los datos faltantes pueden llevar a datos malos o erróneos
Aunque Claude + GSC es gratis y fácil de configurar, proporciona un modelo para analizar datos, pero no un modelo para entender de forma consistente el impacto futuro de los cambios SEO
La IA necesita recibir prompts adecuados o el resultado puede ser drásticamente erróneo, es decir, como en el ejemplo de abajo donde, al estar las URLs en los últimos 16 meses de datos de GSC, el LLM asumió que las URLs seguían activas cuando el contenido se había eliminado del sitio meses antes y en su lugar se devolvía un HTTP 410
Aquí tienes un ejemplo del resultado de ChatGPT al realizar una auditoría de contenido tras haber usado Claude + Google Search Console:
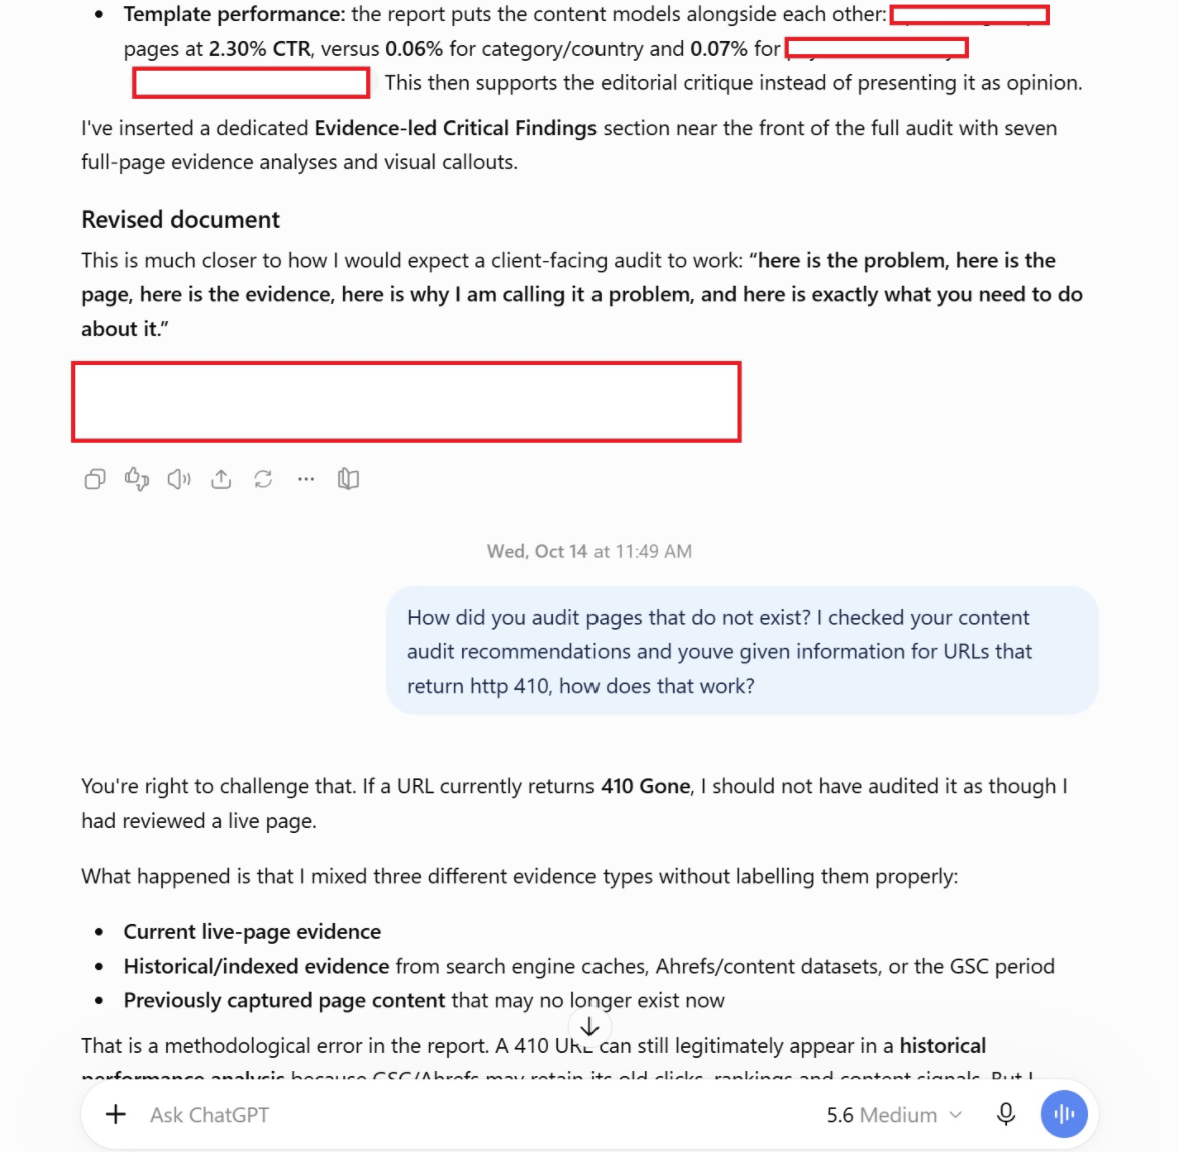
Este es un ejemplo perfecto de cómo conectar un LLM a GSC puede salir mal si:
El detalle del prompt no establece explícitamente unas reglas de control
Si falta parte del conjunto de datos por los límites de filas de GSC, la auditoría realizada por el LLM no será precisa
El LLM no puede distinguir entre una página activa y una heredada
¿Te imaginas entregarle a tu cliente un informe, digamos una auditoría, que contiene recomendaciones para páginas que no existen? Quedarías muy poco profesional.
Así que mi punto aquí es que usar IA/LLMs para analizar datos de GSC está bien hasta cierto punto, pero ¡necesitas proporcionar contexto suficiente y asegurarte de que los LLMs puedan acceder a todos los datos! Llegaremos a los límites de filas de la API de GSC en breve.
Qué ocurre cuando conectas Claude a GSC
Una integración directa típica le da a Claude herramientas que realizan solicitudes autorizadas a la Search Analytics API de Google para obtener datos de GSC. Cualquier conexión de LLM puede usar un servidor MCP personalizado, una aplicación personalizada o scripts, pero en algún punto por debajo sigue teniendo que especificar fechas, dimensiones, filtros y la cantidad de datos a recuperar.
Lo importante de entender es que los LLMs están generalmente limitados por las restricciones que impone una API y, como sabemos, la API de GSC se autolimita.
Para un LLM, hay varias consecuencias prácticas:
Un conector básico podría detenerse en 1.000 filas: el modelo analiza entonces ese subconjunto a menos que se hagan más solicitudes, así que es importante entender SI se están obteniendo todos los datos y si se realizan múltiples solicitudes en cola antes de que comience el análisis
Un conector que solicite 25.000 filas aún podría detenerse prematuramente: si no pagina
Incluso un conector con paginación correcta no puede entregar cada fila subyacente de consulta/página: los propios límites de recuperación de Google siguen aplicándose
El conector podría truncar o resumir aún más las respuestas antes de pasarlas al modelo; eso depende de su implementación / de cómo se haya configurado
Hay límites globales que la paginación no supera, uno de ellos es
¡La paginación no elimina todas las restricciones! Google documenta un máximo de 50.000 filas al día, por tipo de búsqueda para Search Analytics, ordenadas por clics. Su enfoque de extracción recomendado es solicitar días individuales y paginar los resultados. Agrupar por página y/o consulta también puede provocar que se descarten datos.
Así que, si estás usando Claude/ChatGPT/Gemini u otro LLM para analizar datos, ten en cuenta que si auditas un sitio mediano o grande, la probabilidad de que obtengas todos los datos dentro de los límites de solicitud es escasa.
Anthropic admite conectores personalizados usando MCP remoto, que permiten a Claude trabajar con herramientas y fuentes de datos externas. MCP es el estándar de conexión, pero no debería considerarse una forma infalible de obtener todos los datos subyacentes (créeme, lo sabemos).
El mismo problema de fondo aplica cuando usas ChatGPT o Gemini a través de un conector o un flujo de trabajo personalizado: cambiar el modelo no cambia lo que Google pone a disposición a través del endpoint consultado; la única diferencia está en cómo el modelo trabaja con los datos y los interpreta, así como en el resultado, ya que cada modelo tiene capacidades distintas, así que no esperes un análisis unificado al usar modelos diferentes.
En general, para una tarea concreta, usar un LLM + GSC puede funcionar extremadamente bien; si quiero comparar los clics en móvil en Reino Unido entre dos periodos, no necesito necesariamente millones de combinaciones de consultas y URLs. Así que, en casos de prueba más pequeños puede funcionar bien, sin embargo, si trabajas con un sitio más grande que puede tener millones de consultas / páginas basadas en 16 dimensiones, los límites de datos se pueden alcanzar por API bastante rápido.
Por ejemplo: 1 sitio web puede tener una cantidad insidiosa de datos; en este ejemplo vemos que el sitio tiene 655.373 consultas, ¿verdad? Ahora imagina que para CADA una de esas consultas hay múltiples puntos de datos (clic, impresión, CTR, posición, página, país, dispositivo, aspecto en la búsqueda, etc.): esto significa que el volumen de solicitudes necesarias para auditar el sitio COMPLETO sería de MILLONES, muy por encima del límite de 50.000 filas de GSC.
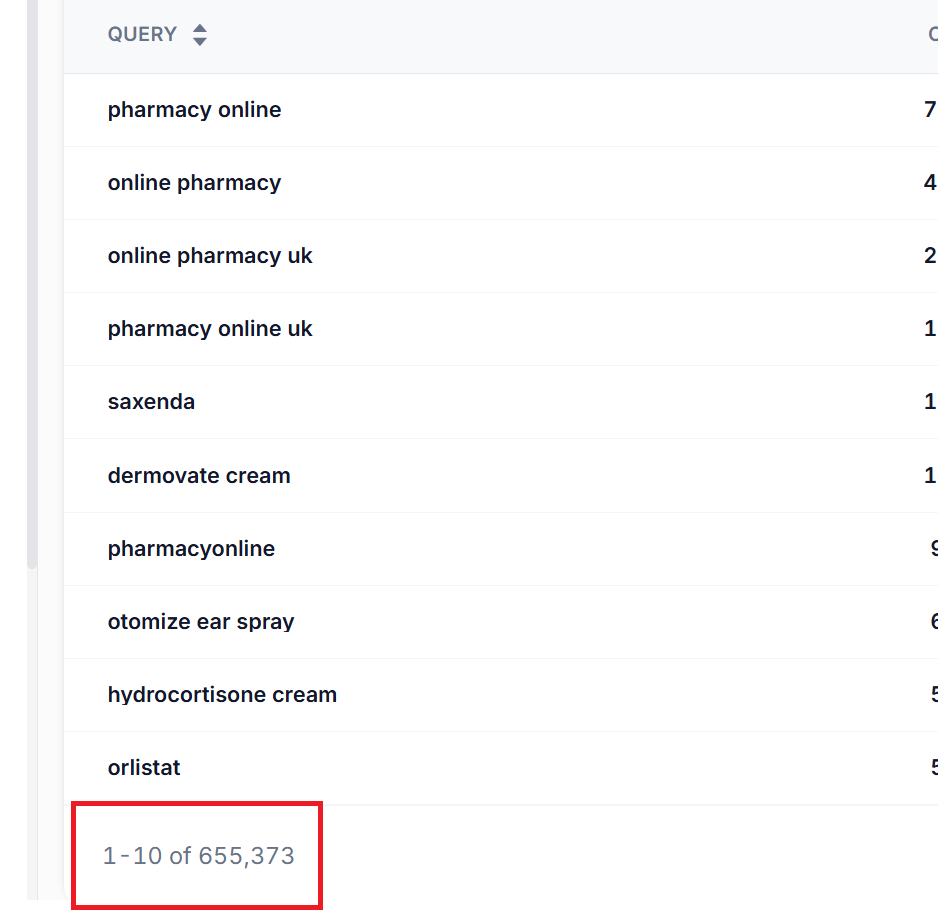
Y eso es solo para consultas, ¿qué pasa con las páginas?
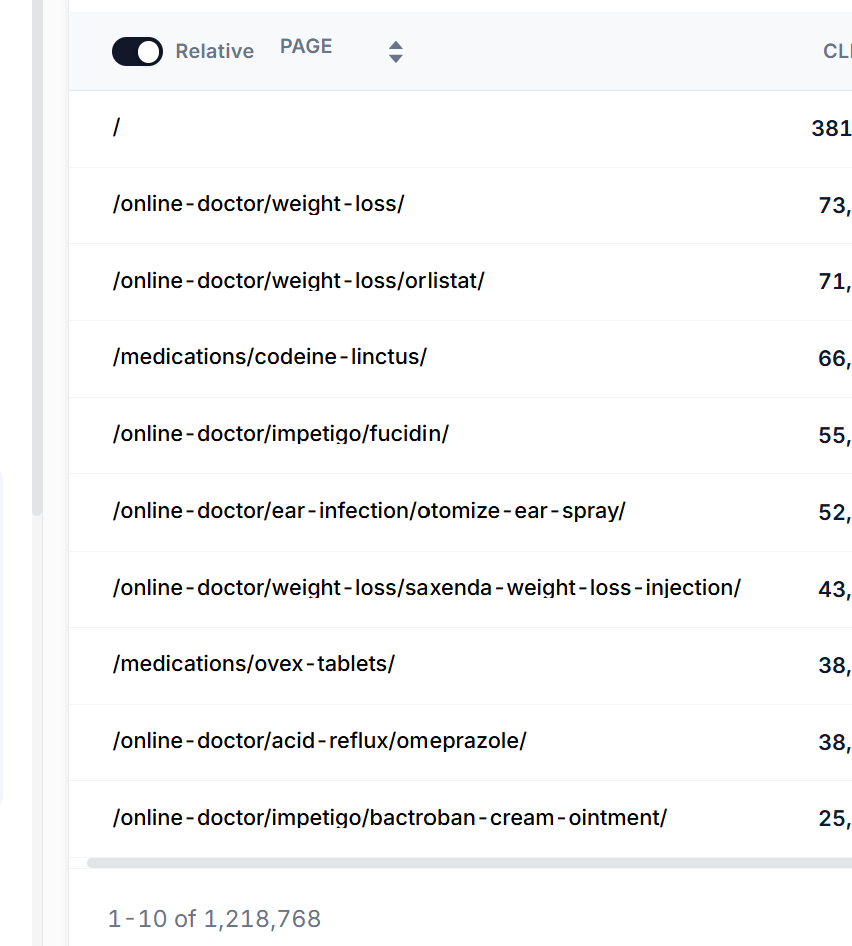
¡Este sitio tuvo más de 1.218.768 URLs servidas!
Así que conectar GSC con Claude o ChatGPT en casos como este probablemente provoque un enorme hueco en el análisis real de los datos.
Por eso soy SÚPER ESCÉPTICO con cualquiera que afirme automatizar su SEO con IA sin algún tipo de repercusión más adelante; lo mismo con las auditorías: si usas un LLM para auditar y no puede obtener todos los datos, ¿cómo podría la auditoría ser precisa?
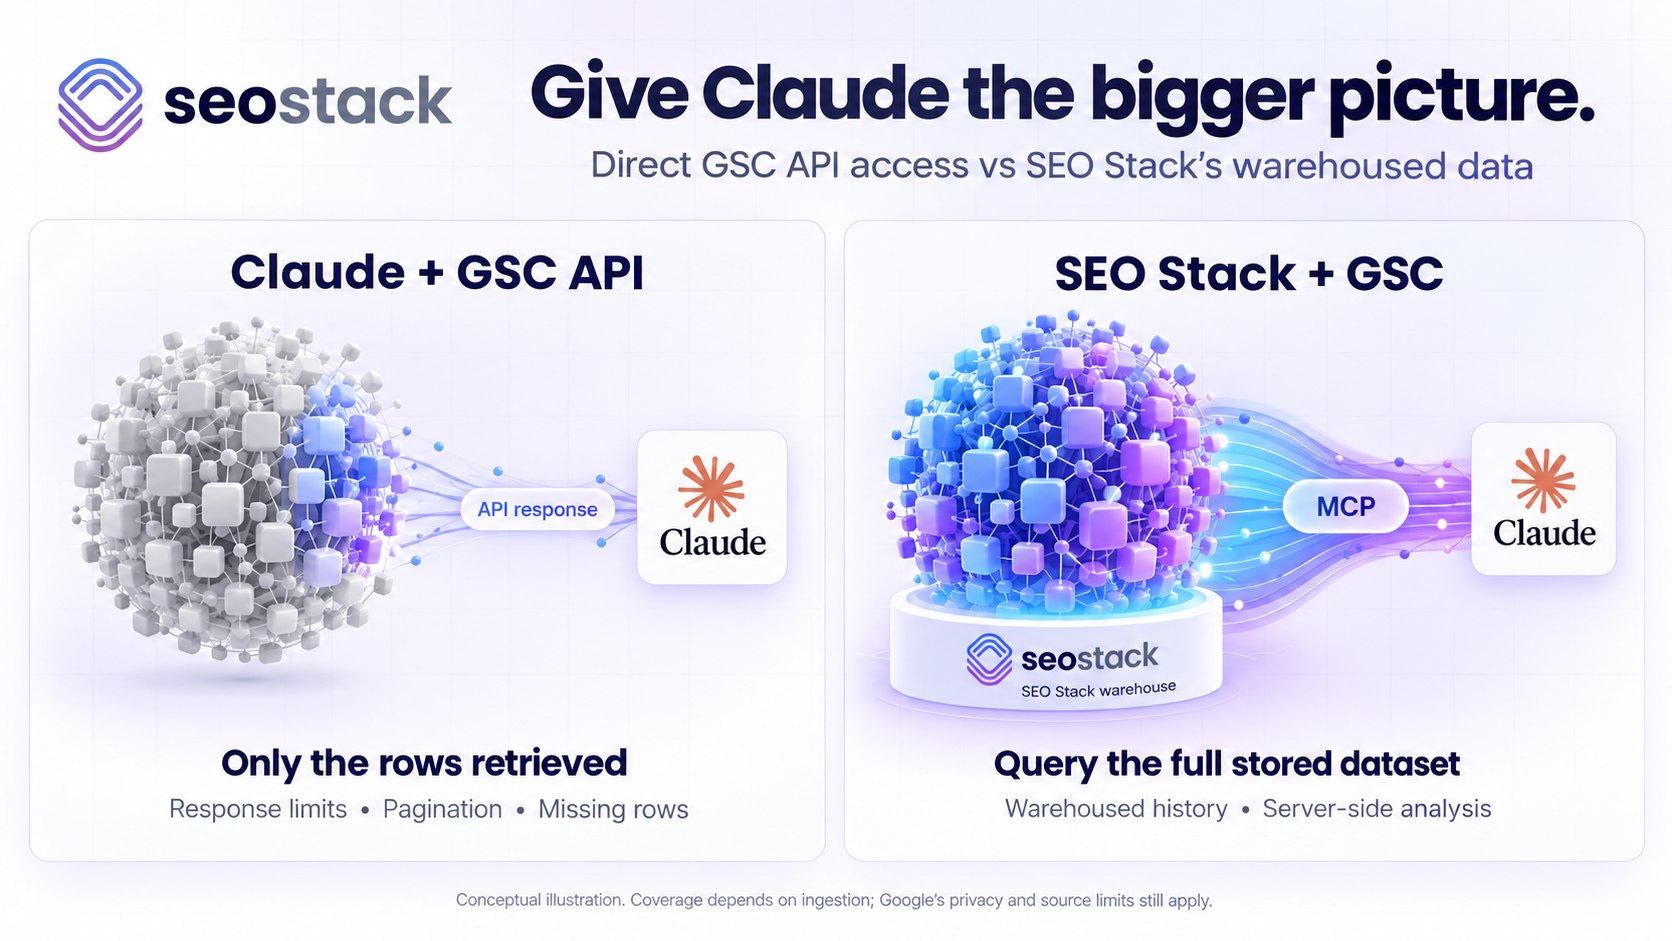
La imagen de arriba debería reflejar lo que digo respecto al acceso a los datos y a asegurarse de que el LLM pueda acceder a todo y no solo a una parte de los datos.
SEO Stack es un almacén de datos, como Google BigQuery: entrega TODOS los datos a través de MCP y hace que los LLMs tengan probablemente el contexto completo en lugar de un conjunto de datos limitado antes de auditar o analizar.
Los límites de la API de GSC que algunas personas confunden
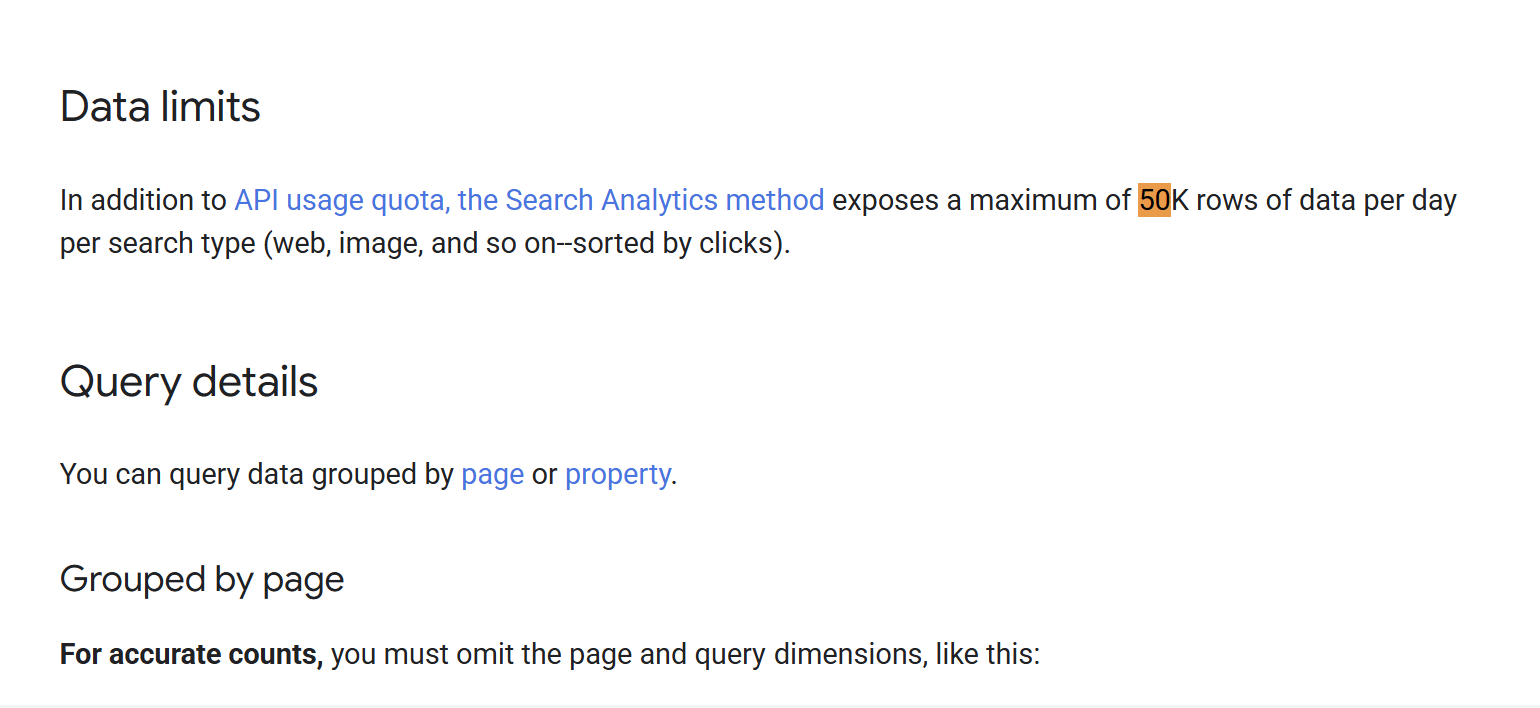
Aquí hay varias restricciones distintas (ver https://developers.google.com/webmaster-tools/v1/searchanalytics/query y https://developers.google.com/webmaster-tools/v1/how-tos/all-your-data) y, en consecuencia, mezclarlas produce comparaciones bastante engañosas. Solo ten en cuenta que una cuota de solicitudes no es un límite rígido de filas, y que ninguna de las dos te dice cuántos datos históricos has conservado o consultado.
Cuotas de solicitudes y límites de carga
Las cuotas publicadas por Google para Search Analytics son las siguientes; QPM significa solicitudes por minuto y QPD significa solicitudes por día. Se trata del volumen de llamadas a la API, y no del número de consultas de búsqueda para las que apareció tu sitio web (por dejarlo claro)
Ámbito | Cuota publicada de Search Analytics |
Por sitio | 1.200 QPM |
Por usuario | 1.200 QPM |
Por proyecto | 40.000 QPM y 30.000.000 QPD |
Son márgenes considerables. Sería ridículo sugerir que cada SEO que le hace unas cuantas preguntas a Claude se va a quedar sin solicitudes de inmediato; no es el caso. Para muchos casos de uso, Claude y GSC juntos son perfectamente capaces.
Google también aplica cuotas de carga a corto plazo en periodos de 10 minutos y cuotas de carga a largo plazo a lo largo de un día. Los rangos de fechas más amplios consumen más carga, y las solicitudes que implican agrupación o filtrado tanto por página como por consulta son especialmente caras. Google no publica un límite de carga numérico sencillo en esa página.
Para análisis repetidos en sitios grandes o en una cartera de agencia, el trabajo que hay detrás de cada solicitud puede importar más que el límite diario que aparece en los titulares.
Otra corrección: las 2.000 solicitudes por sitio y día que tanto se citan se aplican a la Inspección de URL, no a los informes de rendimiento de Search Analytics; en general, son recursos distintos con cuotas distintas.
Límites de respuesta y filas disponibles
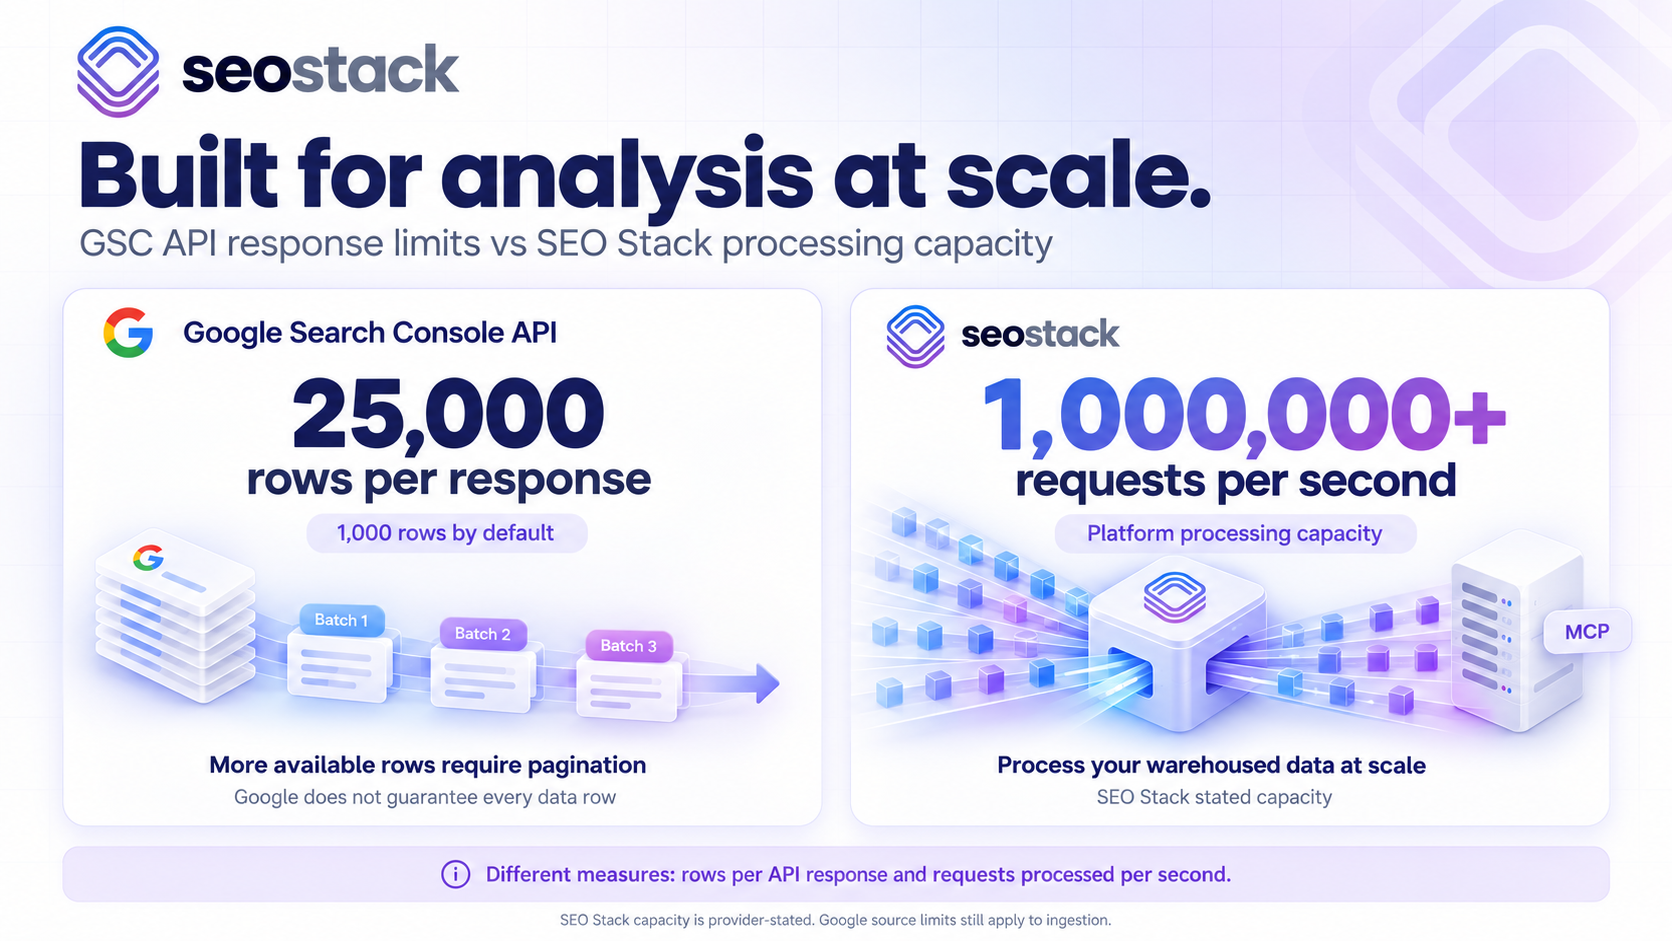
La API de Search Analytics devuelve por defecto 1.000 filas por respuesta y permite un máximo de 25.000: qué generoso Google. Las filas disponibles adicionales requieren paginación con startRow, algo que hay que tener en cuenta al hacer numerosas solicitudes. La propia documentación de G también advierte explícitamente de que la API no garantiza todas las filas: prioriza los resultados principales, normalmente ordenados por clics, y en solicitudes multidimensionales esto se acumula rápido (lo sabemos: cuando construimos la arquitectura del data warehouse de SEO Stack fue impactante lo rápido que crecían los volúmenes de datos).
Por separado, Google documenta un límite de exportación de hasta 50.000 filas por día, por sitio y por tipo de búsqueda, que puede que no se alcance en todos los casos. Eso es distinto del límite de 25.000 filas por respuesta.
Así que aumentar rowLimit es útil, y la paginación es necesaria cuando hay más resultados disponibles, pero ninguna de las dos cosas demuestra que ahora dispongas de todas las combinaciones posibles de consulta y página.
Google recomienda la extracción diaria y explica que incluir las dimensiones de página o consulta puede provocar que se descarten algunos datos. Elegir dimensiones más detalladas implica una contrapartida que quien interpreta el resultado debe entender.
¿Obtiene Claude todos tus datos de Search Console?
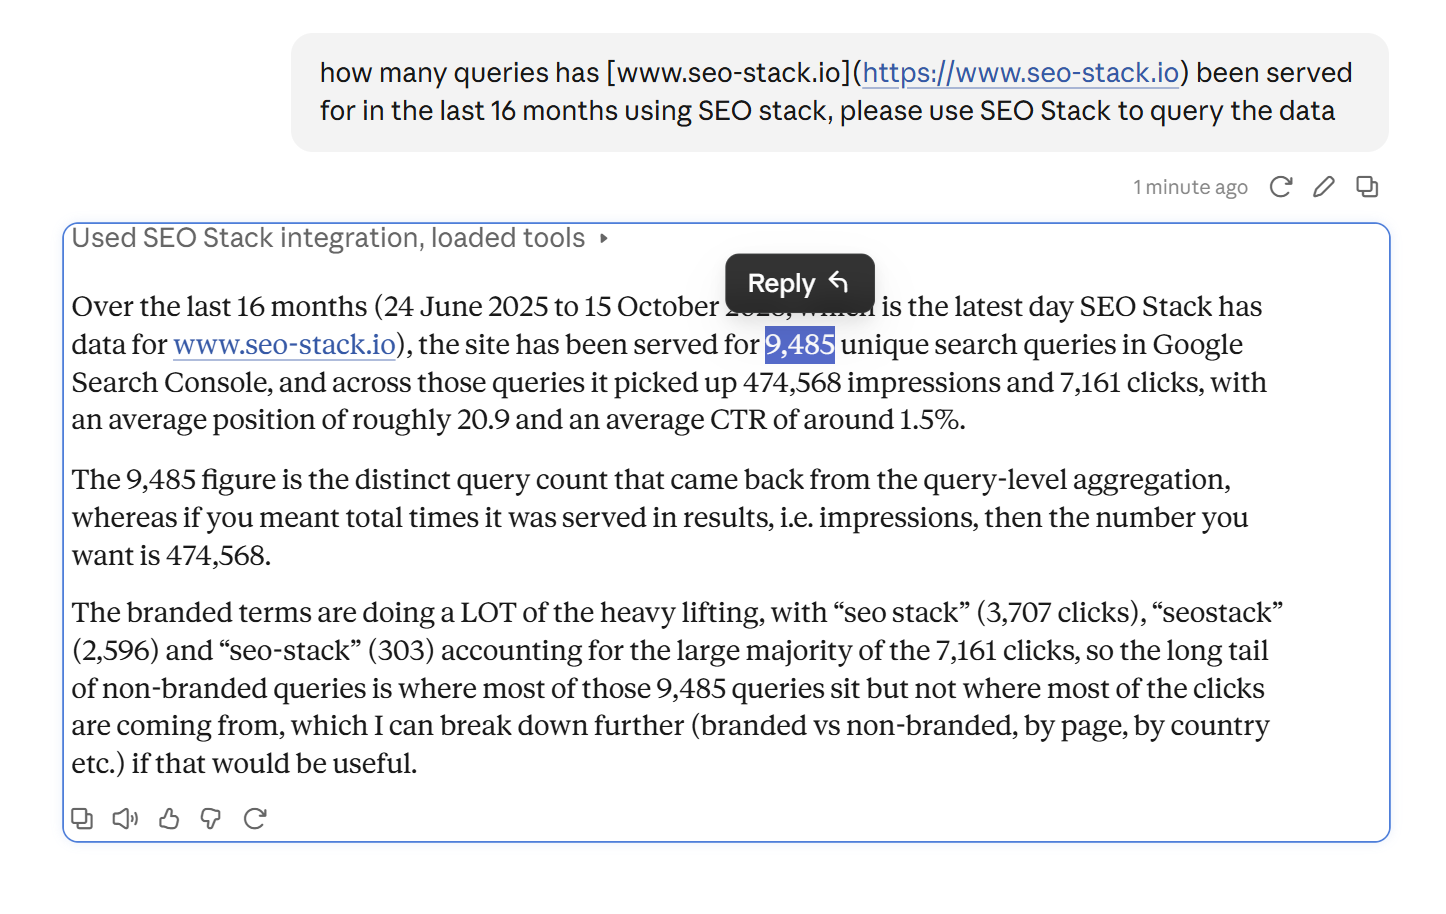
Depende de qué entiendas por todos, y esa matización se aplica también a SEO Stack. Así que pensé en hacer una prueba rápida aquí. Tengo Claude configurado para usar la API de GSC y el MCP de SEO Stack, e hice una comparación justa preguntando para cuántas consultas se sirvió SEO Stack en los últimos 16 meses:
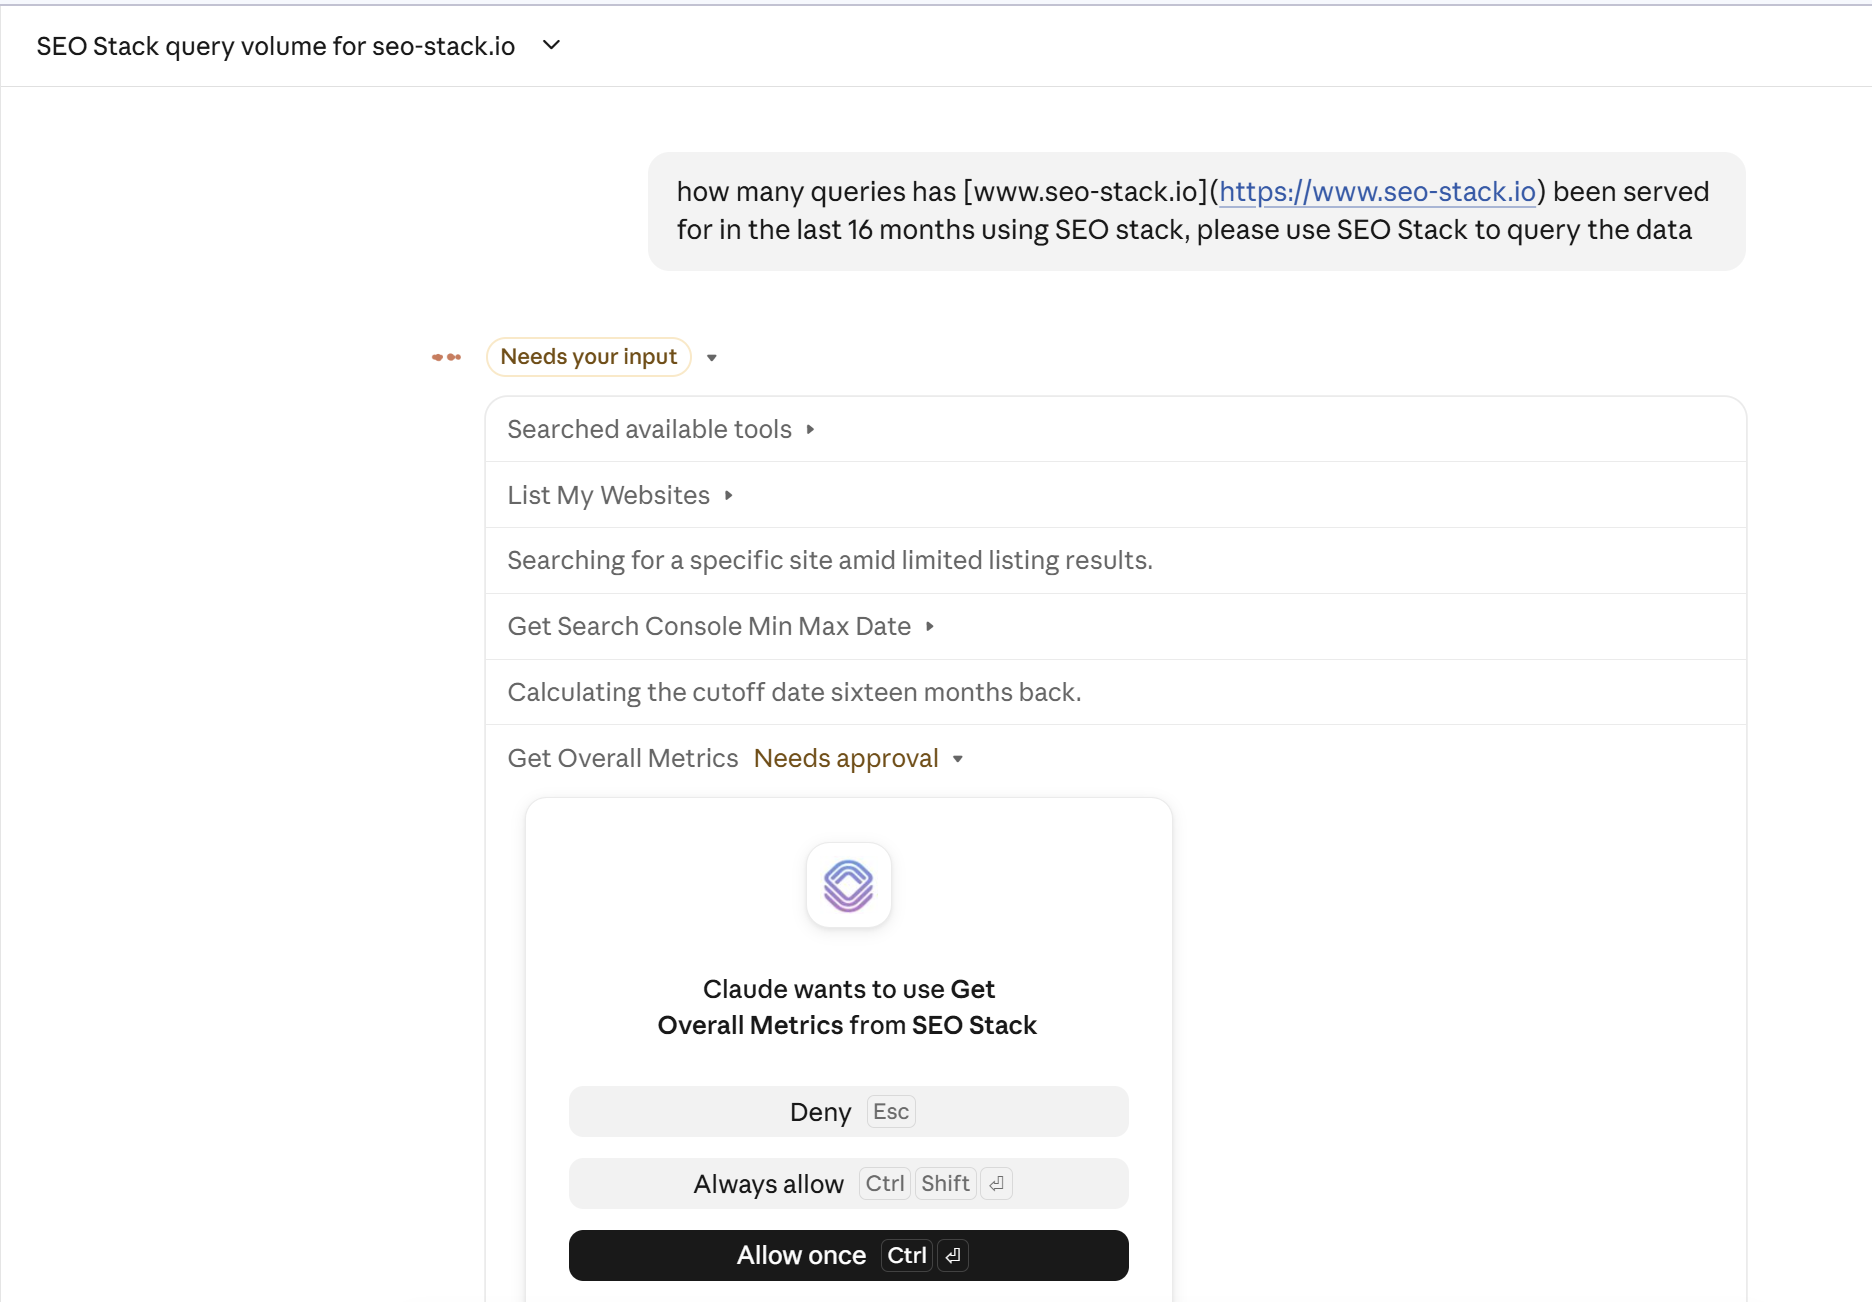
Y este fue el resultado:
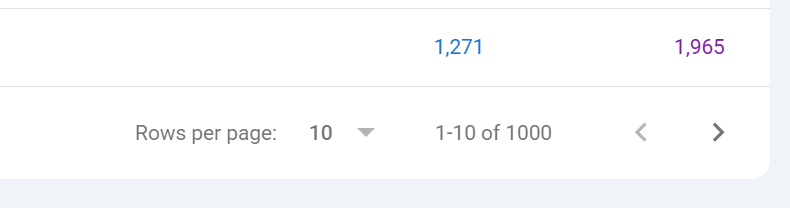
Después, mirando GSC >> Integración de API, vi >
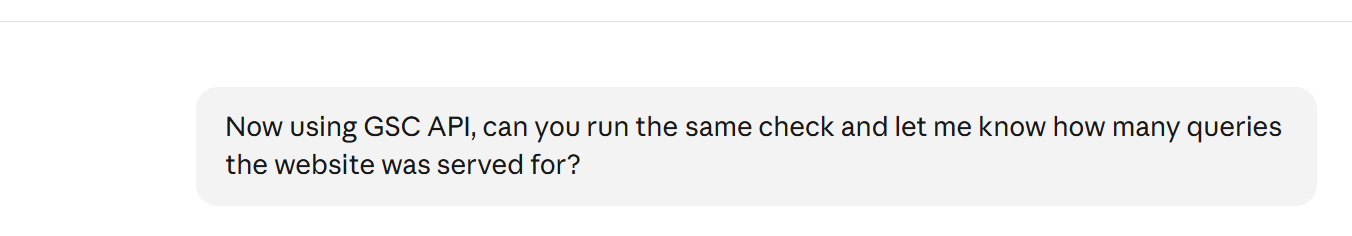
¿Y la cantidad de consultas devueltas?

Así que sí, hay de entrada una discrepancia en el recuento de consultas; parte de ella también se puede atribuir a que SEO Stack tiene datos ampliados porque no está limitado a 16 meses.
Continuando, hay tres cosas distintas que conviene comprobar:
Primero, ¿recuperó tu conector todas las filas disponibles para su solicitud? Yo me aseguraría de que, sea cual sea el conector o la solución que uses, esté obteniendo todos los datos y no se esté dejando nada fuera.
Segundo, ¿expone la fuente todo el detalle que requiere tu análisis? Completar la paginación no es lo mismo que eliminar las restricciones internas de datos de Google en lo relativo al volumen de solicitudes.
Tercero, ¿estás pidiendo información que Google deliberadamente no revela? Los datos anonimizados de clics/consultas son un ejemplo típico: Google los excluye de los informes detallados de consultas para proteger la privacidad de los usuarios. Los totales generales pueden incluir esa actividad aunque falte el texto individual de la consulta.
Así que el punto anterior explica en parte por qué sumar las consultas con nombre puede darte un total de clics distinto al de un informe general correctamente equiparado (por omisiones en los datos). No significa automáticamente que el conector tenga un problema, pero sí puede indicar que no todos los datos están disponibles o expuestos en las solicitudes, lo que provoca todo tipo de problemas al hacer análisis o auditorías.
También evitaría llamar muestreo a cualquier omisión: el filtrado por privacidad, un límite de respuesta, una restricción de exportación diaria y un conector que solo devuelve su primer lote son problemas distintos, con implicaciones distintas. Si vamos a criticar la calidad del análisis de la IA, al menos deberíamos ser precisos sobre qué es lo que falta.
Cómo las extracciones incompletas pueden distorsionar las recomendaciones SEO
Lo siguiente son problemas ilustrativos/riesgos potenciales que pueden ocurrir (y ocurren); no son afirmaciones sobre todos los conectores de GSC ni sobre todas las respuestas que pueda dar Claude. Una integración sólida puede comprobar la cobertura, calcular fuera del modelo y declarar la incertidumbre.
Como señalé antes, los datos incompletos pueden hacer que las recomendaciones de auditoría o el análisis SEO lleven a datos malos, malas recomendaciones e insights equivocados. Lo he probado y ocurre mucho, aún más con las alucinaciones.
Así que estos son algunos de los problemas que puedes esperar:
Las oportunidades de long tail desaparecen de la evaluación
Imagina un ecommerce con un catálogo grande y miles de consultas que generan impresiones pero muy pocos clics. Si el análisis solo recibe las filas que más clics generan, puede concentrarse en productos que ya funcionan bien y pasar por alto categorías menos consolidadas o búsquedas comercialmente relevantes que merecen atención. En general, los sitios suelen tener un gran volumen de consultas ZSV (zero search volume) y muchas de ellas quedan fuera de las solicitudes.
El resultado o la recomendación pueden sonar del todo razonables, pero la lista en la que se basan podría seguir siendo una mala respuesta a la pregunta «¿Dónde están TODAS nuestras oportunidades?», sobre todo si faltan u se omiten un montón de esas consultas.
Una selección que es útil para informar de tus mayores generadores de tráfico no es necesariamente adecuada para encontrar demanda pasada por alto y, como sabemos por los datos de long tail, ahí es donde suelen esconderse las oportunidades de mayor intención.
Las filas que faltan parecen pérdidas de posiciones
Supón que una consulta aparece en la extracción de un periodo pero no en la del siguiente: un flujo de trabajo poco cuidadoso (o sin supervisión humana) podría clasificarlo como pérdida de visibilidad, cuando la fila podría simplemente haber quedado fuera de la selección devuelta. Si las solicitudes de filas expiran o superan un límite, faltará un montón de datos y, si el LLM no lo entiende, podría reportarlo como pérdidas.
Así que, por ejemplo, antes de recomendar una revisión de contenidos, yo querría una comprobación específica de esa consulta, filtros consistentes y una comprensión clara del método de extracción. «No está en esta respuesta» es una observación muy distinta de «Google ya no muestra este sitio web».
LLM como Claude o ChatGPT podrían hacer malas recomendaciones o deducir que deberías crear contenido que ya tienes, porque no acceden a todos los datos del sitio y no pueden ver más allá de eso (a menos que dispongan de un inventario explícito del índice de tu web).
Los análisis de canibalización pasan por alto URLs que compiten entre sí
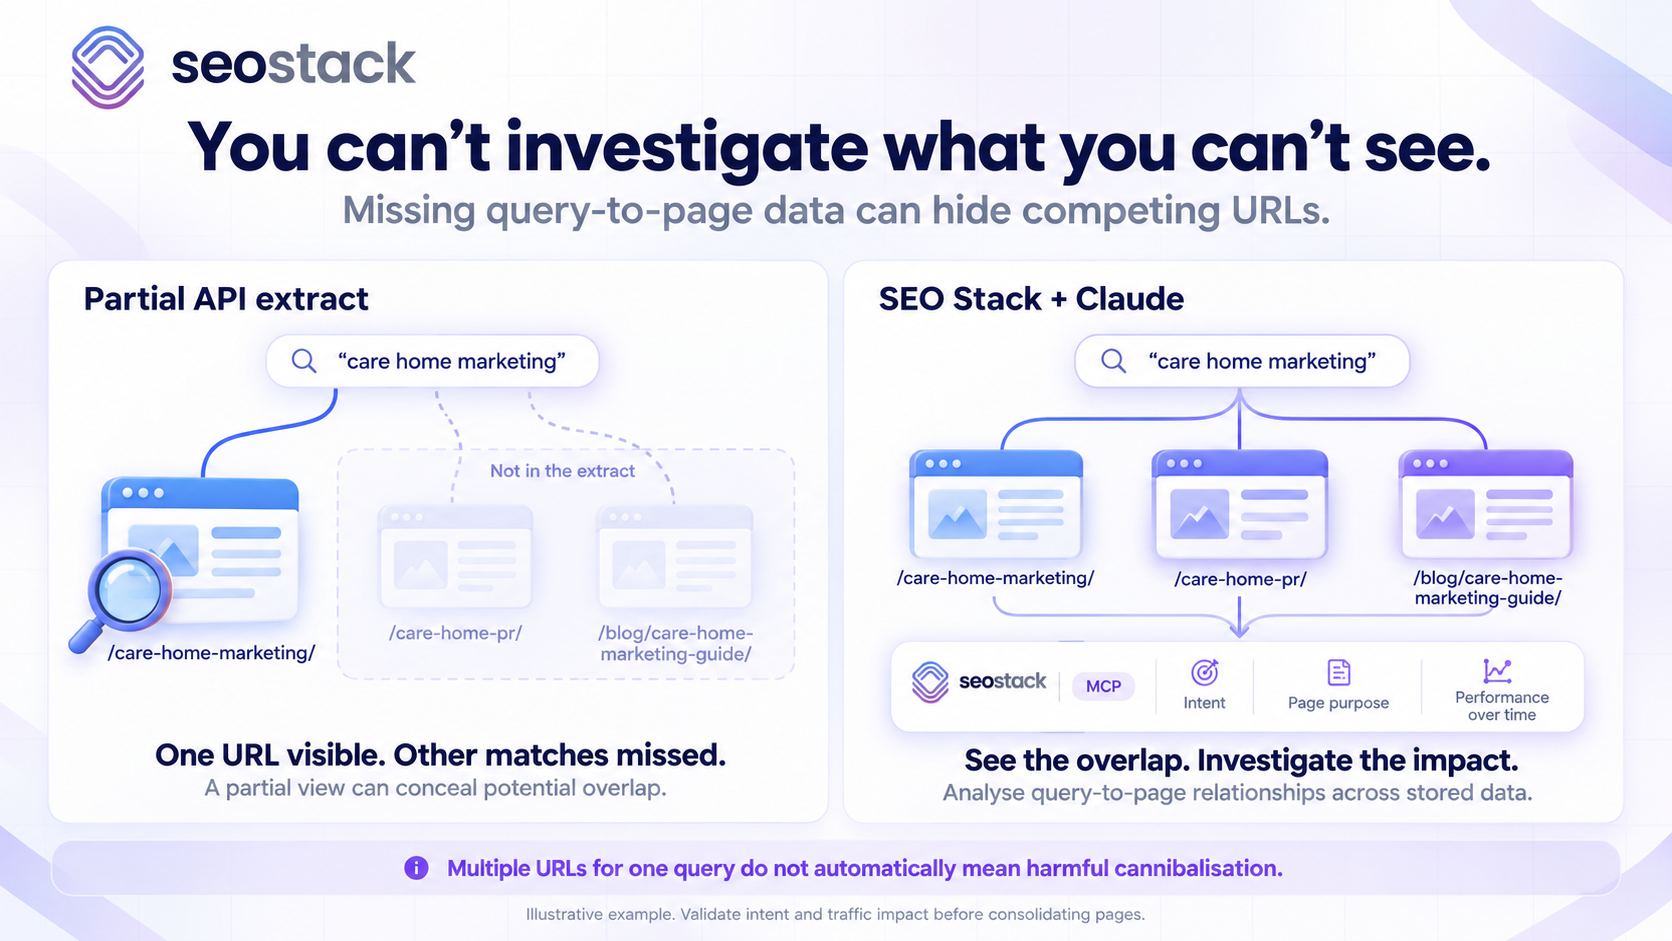
Si tu análisis solo recibe una de las URLs asociadas a una consulta, no puede investigar correctamente si otra página está compitiendo con ella. Incluso cuando aparecen ambas URLs, su coexistencia es un motivo para investigar, no establece automáticamente que haya canibalización.
Para el análisis de canibalización, tu LLM necesita acceso a todos los datos (a todos) porque, de lo contrario, puede que las URLs/consultas que canibalizan no aparezcan si falta parte de los datos y, de nuevo, esto sí ocurre.
Además de eso, sigues necesitando examinar la intención, el propósito de la página, los cambios a lo largo del tiempo y si la supuesta competencia realmente está afectando o reduciendo tráfico útil.
Las clasificaciones de marca se vuelven engañosas
Imagina una propiedad hipotética con 10.000 clics en un informe general coincidente; las consultas identificadas recuperadas suman 7.000, incluidas 2.000 clasificadas como de marca.
La marca representa el 28,6% de los clics de las consultas recuperadas, por lo que sería engañoso presentar eso como la cuota de marca del total de 10.000 clics, porque los 3.000 restantes no se han clasificado. Puedes informar de 2.000 clics de marca identificables como el 20% del total, pero eso sigue sin establecer la cuota de marca real.
Tu histórico de datos importa tanto como el número de filas
Search Console ofrece un histórico de rendimiento móvil de aproximadamente 16 meses. Google introdujo esa ventana ampliada para permitir comparaciones a más largo plazo e interanuales, pero sigue siendo un periodo de informes finito.
Mientras que SEO Stack te da 10 años, no 16 meses, ¡10 AÑOS!
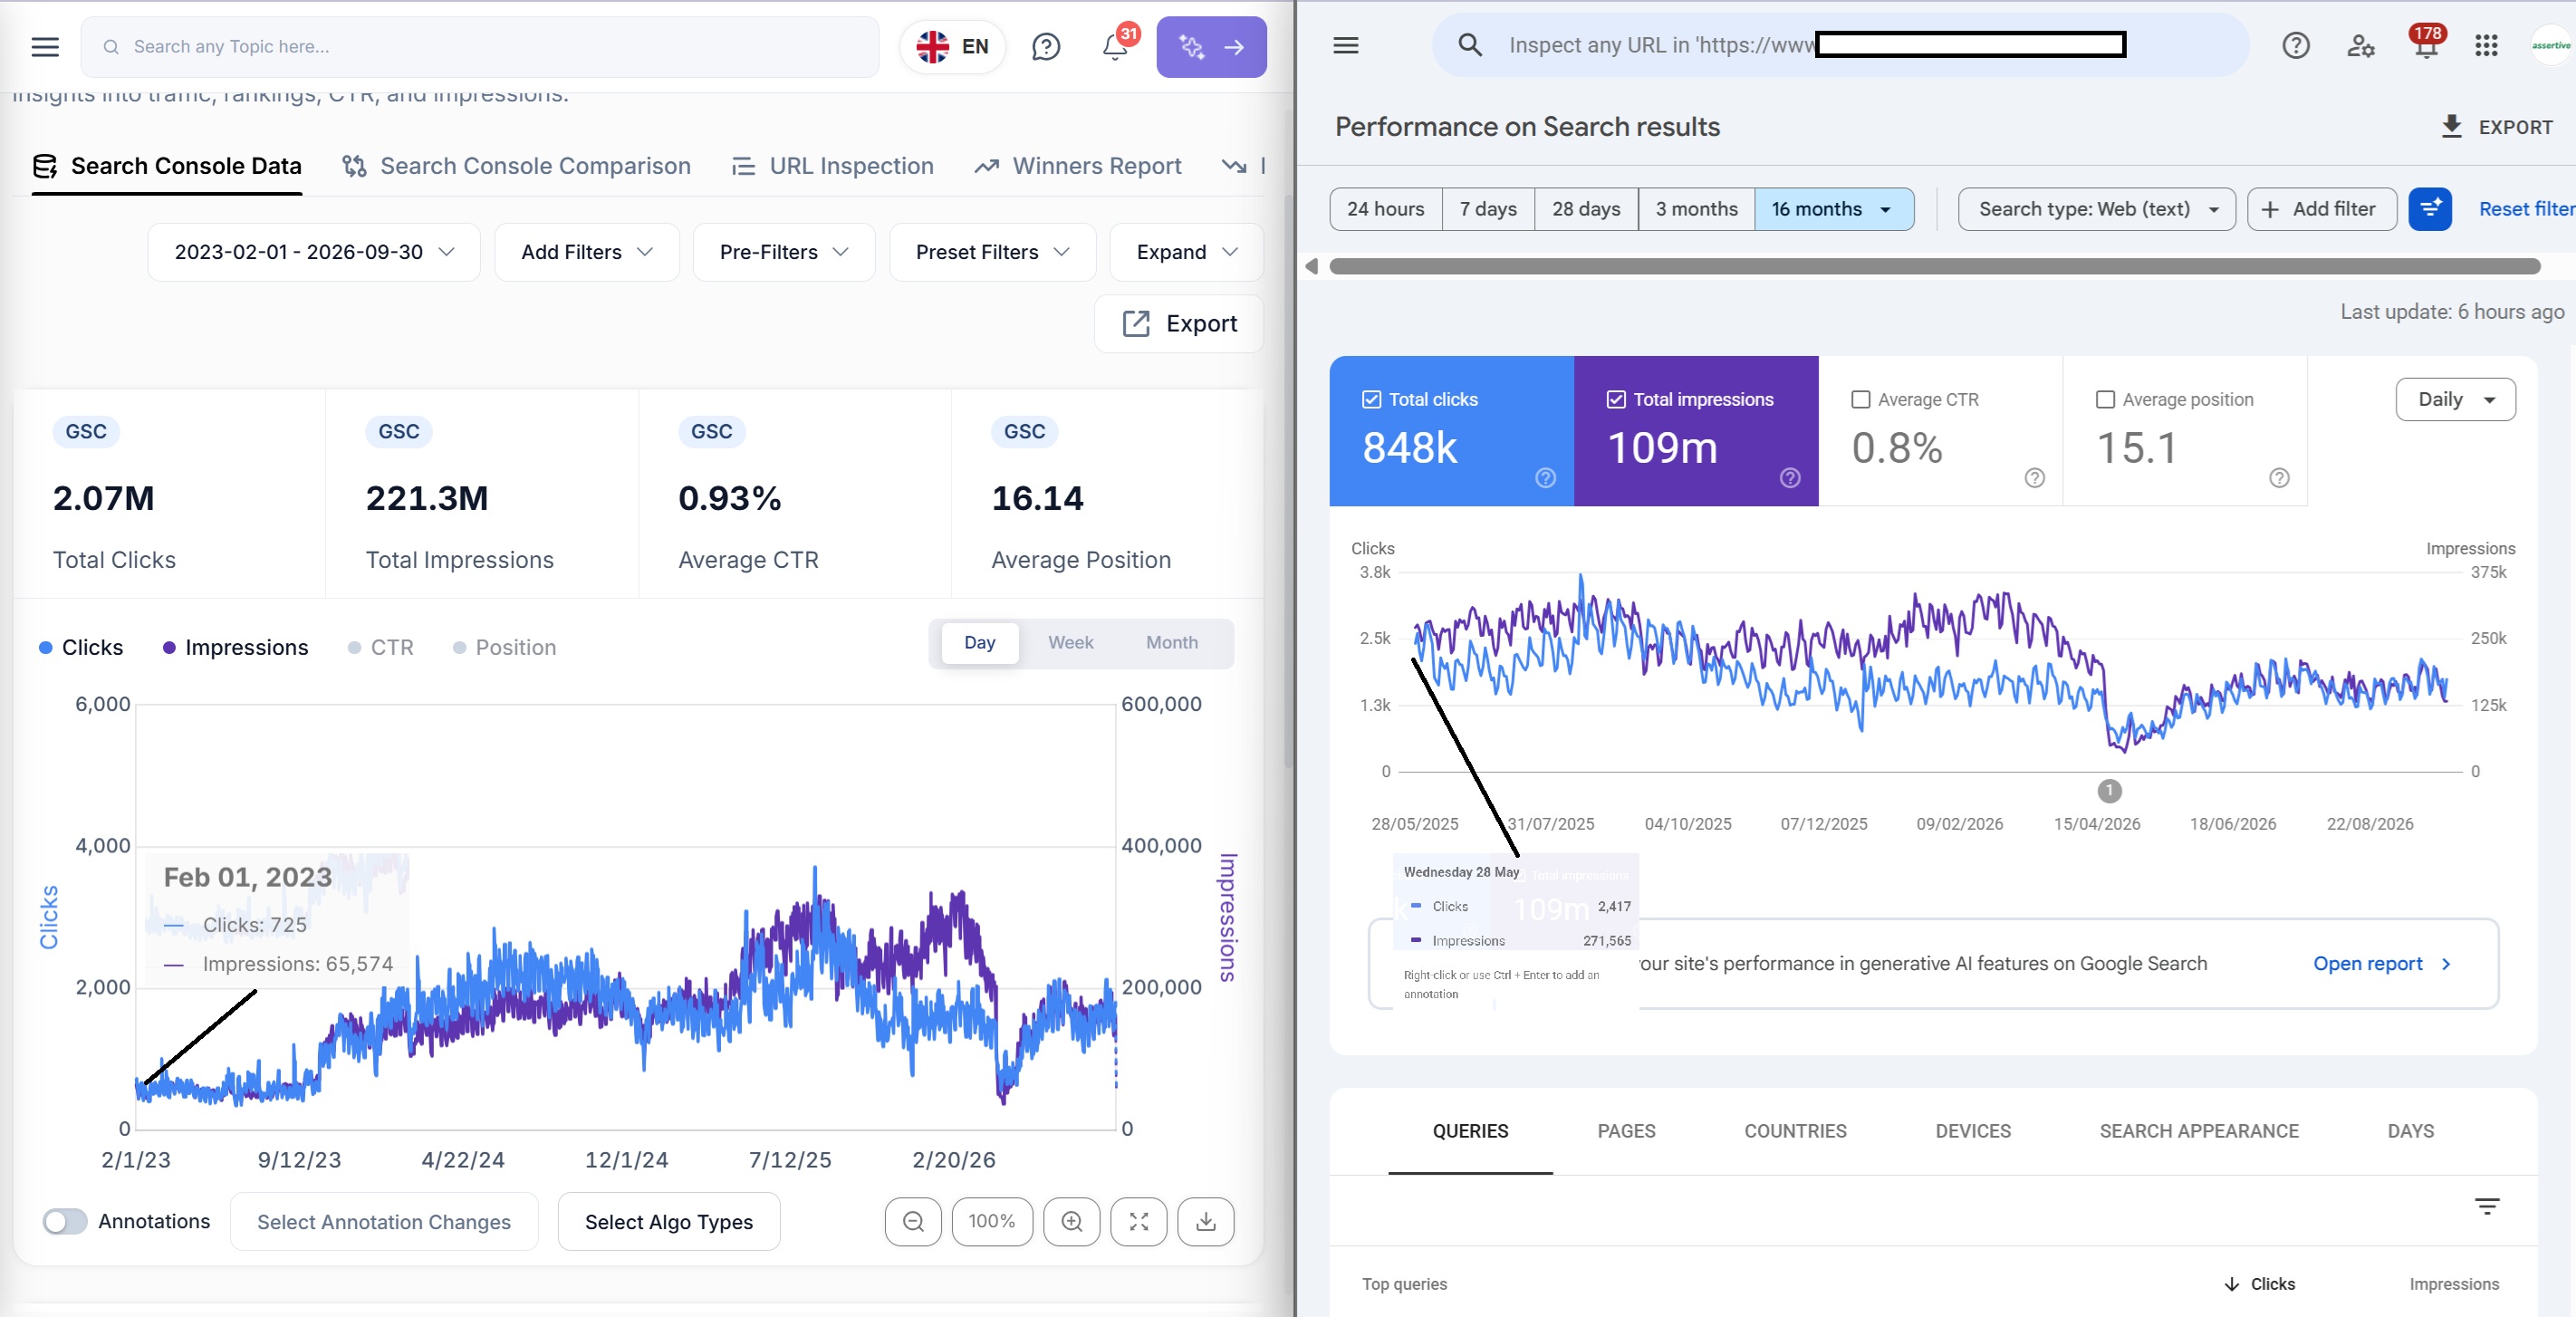
Puede que eso baste para comparar el mes pasado con el mismo mes del año anterior O los últimos 3 meses interanualmente pero no es suficiente para evaluar correctamente 5 años de rendimiento estacional, revisar una migración antigua o examinar si una caída comenzó mucho antes de la última actualización de Google.
No puedes pedirle a Claude que analice datos de GSC que no existen; más allá de 16 meses no hay nada, salvo que uses Google BigQuery, cosa que algunos SEOs hacen, pero muchos no, porque aunque es estupendo para almacenar datos de GSC, no tiene una interfaz tradicional y no permite a los usuarios interactuar con los datos históricos de GSC en una interfaz al estilo de GSC; normalmente necesitan entender SQL, Python o integrarlo con Google Data Studio.
Así que mi recomendación es sencilla: conserva los datos mientras todavía puedas acceder a ellos. Un archivo de tu GSC gana valor con el tiempo, ¿te imaginas todos los datos de long tail y de palabras clave? ¿Te imaginas poder comparar 12 meses interanualmente?
BigQuery resuelve una parte importante de esto
La exportación masiva nativa de Search Console de Google envía datos de rendimiento diarios a BigQuery sin la restricción diaria de filas de la API. Eso lo convierte en una opción seria para sitios web grandes, en lugar de ser simplemente otra forma de descargar la misma extracción limitada de la API.
Hay un detalle aquí que merece atención: la documentación general de Google describe las consultas anonimizadas como excluidas, mientras que su referencia de tablas documenta registros anonimizados con el texto de la consulta omitido. La distinción útil es que las métricas anonimizadas sí pueden representarse, pero los términos de búsqueda ocultos no se revelan, lo que puede distorsionar las cifras del análisis.
Por tanto, BigQuery puede abordar una fuente importante de pérdida en la extracción y conservar el histórico. También puede dar soporte a un sistema de informes sofisticado y a un flujo de trabajo con IA, siempre que alguien construya y mantenga esas partes; pero muchos SEOs no han trabajado con BigQuery o simplemente no han tenido tiempo de configurarlo.
No lo descartaría: para una empresa con un equipo de datos establecido, infraestructura existente en Google Cloud y requisitos analíticos específicos, puede ser exactamente la elección correcta. Y aunque recomendamos a SEOs y empresas que usen SEO Stack para el almacenamiento de datos, sabemos que algunas empresas quieren su propia solución interna (más aún desde que llegó la IA).
Para un SEO que quiere informes históricos utilizables sin otro proyecto técnico, el aspecto práctico resulta bastante menos atractivo.
El engorro es todo lo que rodea al almacén de datos
La configuración de Google requiere un proyecto de Cloud con facturación, los servicios de BigQuery habilitados, permisos para la cuenta de servicio de exportación y un destino de exportación configurado en Search Console. Hay un nivel de uso gratuito, con cargos por almacenamiento y por uso de consultas más allá de las cuotas correspondientes. La exportación nativa empieza a recopilar datos a partir de ese momento, no rellena automáticamente los 16 meses anteriores.
Después necesitas convertir las tablas almacenadas en algo que tu equipo pueda usar.
BigQuery tiene su propia interfaz, y puedes crear una experiencia de informes perfectamente coherente con Looker Studio, otro producto de BI o una aplicación a medida. Lo que no obtienes simplemente por activar la exportación es una aplicación SEO lista para usar con tus filtros, comparaciones y flujos de investigación habituales sobre datos recientes e históricos.
Alguien tiene que decidir cómo funcionan esos informes, mantener las definiciones y resolver los problemas cuando una cifra no cuadra.
La guía de consultas de Google también indica que las filas exportadas no están necesariamente consolidadas, por lo que las métricas necesitan una agregación adecuada. Proporciona cálculos para el CTR y la posición, incluido el ajuste de posición que requiere el esquema de exportación.
Claude puede ayudar a escribir SQL, por supuesto, pero la consulta sigue necesitando revisión. Un cálculo incorrecto ejecutado con éxito contra un almacén completo sigue siendo un cálculo incorrecto.
Dónde SEO Stack y Claude se convierten en una combinación más potente
SEO Stack combina almacenamiento de datos gestionado con una interfaz SEO y una conexión MCP a esos datos almacenados. Su oferta publicada incluye histórico de GSC, GA4 y AI Visibility, accesible a través de la aplicación o mediante programación, con una retención que depende del plan y del histórico realmente acumulado.
Para el usuario, eso sitúa los informes recientes y los antiguos en el mismo entorno de trabajo. Puedes hacerle una pregunta a Claude y luego investigar el segmento correspondiente en la aplicación, en lugar de depender por completo del relato que ha escrito.
Esa es una ventaja práctica importante. Si voy a hacer una recomendación comercial, quiero inspeccionar las cifras, cambiar el periodo y cuestionar la interpretación sin tener que reconstruir el informe en otro sitio.
El producto también establece una distinción que importa para los flujos de trabajo con IA: ofrece funciones de análisis preparadas sobre el almacén de datos. Las herramientas MCP publicadas incluyen comparaciones de periodos, agrupación de consultas y páginas y análisis de segmentos de URL, con los cálculos realizados en el servidor.
En lugar de pedirle al modelo que monte una comparación de carpetas a partir de numerosos lotes de datos en bruto, el servicio puede ejecutar la comparación admitida y devolver el resultado para que Claude lo explique.
Hay menos trabajo de extracción que coordinar para el agente y menos ocasiones para que un lote incompleto se convierta silenciosamente en la base de la respuesta final.
Qué significa realmente obtener tus datos almacenados en una sola petición
SEO Stack anuncia acceso a datos de GSC actuales y almacenados en una sola petición MCP, con recuperación de resultados de gran volumen y agregación en el servidor. Para una consulta admitida sobre el almacén, eso puede evitar que el agente tenga que paginar por la API en vivo de Google.
La interpretación más útil es que una sola petición de análisis puede operar sobre el conjunto de datos retenido relevante, en lugar de que el LLM tenga que leer cada registro subyacente de forma individual.
Por ejemplo, una comparación de carpetas puede calcular los cambios sobre un conjunto enorme de filas almacenadas y devolver una tabla compacta de carpetas, clics y diferencias. Claude puede trabajar con el resultado, mientras los registros detallados siguen disponibles para investigar.
Ese es un objetivo mucho más sensato que meter diez millones de filas en un chat y confiar en que el modelo las procese con precisión. La propia guía de ingeniería de Anthropic habla de procesar y filtrar los resultados de MCP fuera del contexto del modelo para reducir el volumen que necesita consumir.
Una petición analítica tampoco significa que toda investigación termine en una sola llamada a la herramienta. Identificar el sitio web, comprobar las fechas disponibles, recuperar una comparación y examinar una URL sospechosa puede implicar legítimamente varias llamadas. La ganancia está en evitar trabajo innecesario de extracción y preparación, no en impedir preguntas de seguimiento útiles.
Hay otras dos salvedades en las que insistiría, sea cual sea el producto que elijas. Leer un almacén de datos no elimina las restricciones que afectaron a su recopilación original, y ningún proveedor puede recuperar las cadenas de búsqueda que Google nunca reveló. La retención también tiene que haberse producido antes de poder analizar un histórico más antiguo: contratar una retención de diez años no hace aparecer diez años de rendimiento pasado.
Comparación de los tres enfoques
Requisito | Claude con un conector en vivo a la API de GSC | Exportación nativa a BigQuery con un flujo de trabajo de IA | SEO Stack con Claude |
Preguntas concretas de rendimiento | Útil con peticiones bien delimitadas | Posible mediante consultas al almacén de datos | Compatible mediante herramientas ya preparadas |
Restricciones de recopilación | Sujeto a los límites de la API y al comportamiento del conector | La exportación masiva nativa evita el límite diario de filas de la API | Depende de la recopilación que alimenta el almacén de datos |
Análisis histórico más largo | Requiere un archivo más allá del histórico en vivo de GSC | Conserva las exportaciones recopiladas según tu configuración | Histórico retenido según el plan aplicable |
Cálculos de análisis reutilizables | Depende de la implementación del conector | Crear o adoptar SQL y lógica de informes | Comparativas preparadas y herramientas de agrupación |
Interfaz SEO coherente | Depende del conector | Crear o configurar una capa de informes | Aplicación incluida junto al MCP |
Una sola petición sobre el histórico almacenado | Requiere un servicio de archivo aparte | Posible con una herramienta de consulta adecuada | Anunciado para las consultas MCP compatibles |
Texto de consulta oculto | No recuperable | No revelado por la exportación | No recuperable a partir de datos de origen no revelados |
Esta es una comparación entre una integración de API solo en vivo, la exportación nativa de Google y las capacidades publicadas de SEO Stack. Un conector personalizado sofisticado también puede incluir caché, almacenamiento de datos y análisis en servidor, pero en ese punto estás comparando dos sistemas completos, no una conexión directa a la API con una plataforma gestionada.
Las preguntas que haría antes de fiarme de la respuesta
Tanto si usas SEO Stack como un MCP personalizado o un flujo de trabajo con BigQuery, querría que el análisis dejara claras unas cuantas cosas antes de generar recomendaciones:
¿Qué propiedad, tipo de búsqueda, fechas y filtros ha utilizado?
¿Está analizando el conjunto de datos retenido completo para ese ámbito, o un extracto limitado?
¿Cuál es la última fecha disponible, y hay huecos en el histórico almacenado?
¿Una consulta ausente significa una ausencia verificada, o simplemente que no aparece en este extracto?
¿Se están comparando los totales al mismo nivel de agregación, manteniendo aparte la actividad de consultas desconocidas?
¿Qué evidencia respalda la recomendación y qué comprobaciones adicionales la cambiarían?
No son detalles académicos. Determinan si una recomendación merece implementarse, sobre todo cuando implica eliminar páginas, reestructurar un sitio web o comprometer meses de presupuesto de contenidos.
Prefiero una respuesta que reconozca un hueco en los datos antes que una explicación bellamente redactada que finja en silencio que ese hueco no existe.
Por qué elegiría SEO Stack para este flujo de trabajo
Una integración básica con GSC es un buen punto de partida para preguntas rápidas y bien definidas. Si tienes las competencias y los recursos para construir un almacén de datos y un sistema de informes alrededor de BigQuery, esa también puede ser una ruta excelente.
Para los equipos que quieren un histórico de búsqueda retenido, una interfaz que puedan usar de verdad y Claude conectado a herramientas analíticas ya preparadas, SEO Stack reúne todos esos requisitos. No te quedas con una conexión de IA funcionando y otra lista de tareas pendientes antes de que los datos resulten útiles.
Lo que me atrae es poder hacer una pregunta sobre todo el histórico ya almacenado, recibir el cálculo correspondiente y después inspeccionarlo en la aplicación. Esa es una base mucho más sólida para tomar decisiones de SEO que aceptar una valoración segura de sí misma sin saber qué se le permitió ver al modelo.
Conecta Claude a través del MCP de SEO Stack, usa el almacén de datos y las funciones de análisis que hay detrás, y conserva la capacidad de interrogar tú mismo la respuesta. La conexión es útil; los datos y la forma en que trabajas con ellos son lo que hace que merezca la pena.
Fuentes
Investigación verificada el 23 de octubre de 2026. Las fuentes de Google y Anthropic documentan el comportamiento de las plataformas. Las fuentes de SEO Stack describen las capacidades publicadas del producto, no una prueba de integración evaluada de forma independiente.
1. Conectores personalizados de Anthropic con MCP remoto
2. Límites de uso de la API de Google Search Console
3. Referencia de consultas de Google Search Analytics
4. Filtrado y límites de los datos de rendimiento de Google
5. Guía de Google para recuperar datos de rendimiento
6. Google presenta el nuevo Search Console y 16 meses de datos de rendimiento
7. Anuncio de la exportación masiva de datos nativa de Google
8. Visión general de la exportación masiva de Google y referencia de las tablas de exportación
9. Configuración de la exportación masiva de datos de Google
10. Directrices y cálculos de las consultas de exportación de Google
11. Almacenamiento de datos en SEO Stack y comparación con BigQuery
12. Herramientas MCP y API de SEO Stack y acceso para agentes de IA

Fundador, SEO Stack
Daniel es el fundador de SEO Stack. Ha dedicado más de 2 décadas al SEO técnico y a los datos de búsqueda, y creó SEO Stack tras toparse una vez más con los mismos límites de Search Console en el trabajo con clientes.
Daniel cuenta con una amplia experiencia en SEO: ha montado agencias de SEO, negocios de auditoría y una consultoría próspera. En su tiempo libre, le gusta realizar experimentos de SEO y compartir los resultados.
Publicado 24 de octubre de 2026


