Automatiza tu flujo de trabajo SEO con Skills y Workflows de IA
Seguro que, desplazándote por las redes sociales, los has visto. ¡Están por todas partes! Pero una cosa es conseguir un kit de agentes y otra muy distinta es que necesitas una infraestructura COMPLETA para hacer que el SEO con IA

ANTES de que te metas en este artículo, no quiero que te parezca demasiado largo o farragoso. El PROPÓSITO de este artículo es ayudarte a automatizar tu flujo de trabajo SEO dando a tu AGENTE DE IA o plataforma de IA las habilidades relevantes de SEO Stack para ejecutar SEO y para usar aprendizaje / aprendizaje recursivo y así mejorar los resultados SEO, desde el análisis y la auditoría hasta la implementación.
Básicamente, de este artículo, si lo lees entero, sacarás lo siguiente:
Podrás configurar y desplegar tu primer Agente SEO de IA si aún no lo has hecho
Podrás descargar e instalar las skills (para tu agente de IA o LLM, es decir, Claude, ChatGPT)
Crear el flujo de trabajo y el cron necesarios para automatizar SEO / análisis / informes
Dar a un agente la capacidad de implementar cambios en una web y de registrar el trabajo realizado para el autoaprendizaje / SEO recursivo
¿Qué puedes ganar con esto?
Puedes acelerar el análisis, la auditoría, el análisis SEO y el análisis de la competencia
Puedes desplegar campañas SEO autónomas: ideal para minisites, webs de hobby, rank and rent
Puedes ahorrar tiempo, dinero y escalar la producción SEO
Puedes usar IA para análisis, creación, producción, despliegue e informes
Sigue leyendo, merecerá la pena.
Sin duda habrás estado haciendo scroll en redes sociales y habrás visto esto:
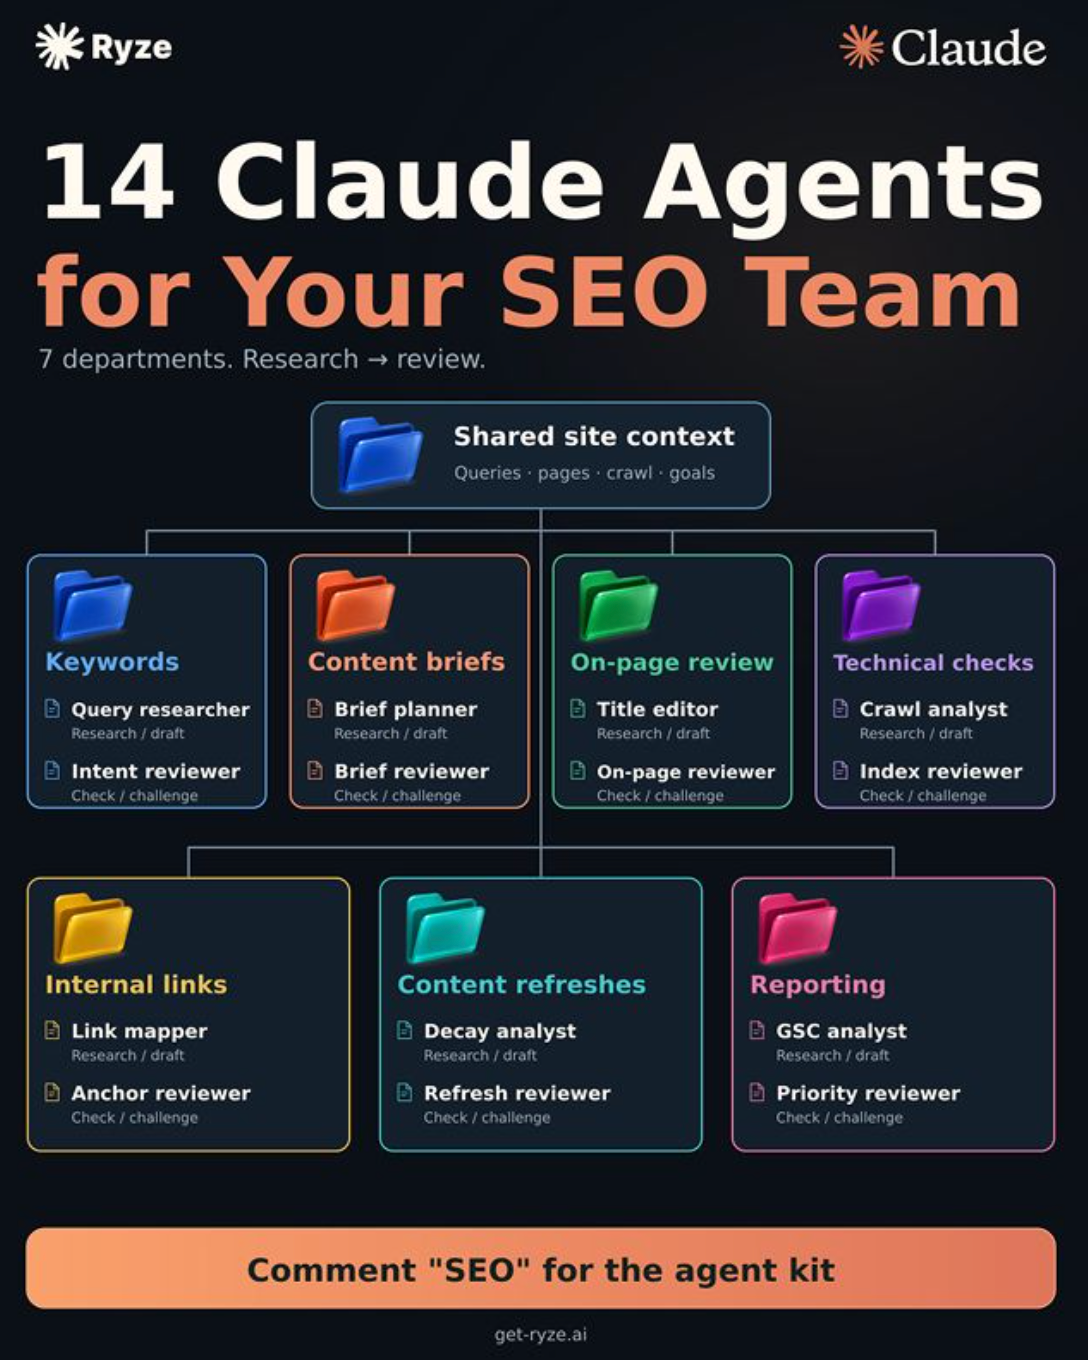
¡Están por todas partes!
Pero una cosa es conseguir un kit de agente y otra muy distinta es que necesitas una infraestructura COMPLETA para que las automatizaciones de SEO con IA funcionen bien. En este artículo voy a explicarte y mostrarte qué necesitas y cómo puedes construir de verdad un flujo de trabajo SEO automatizado que requiera MENOS intervención manual.
Veamos primero algunas cuestiones que debes tener en cuenta cuando te planteas automatizaciones de SEO con IA. Lo clave que hay que recordar es que hay varios componentes para que esto funcione:
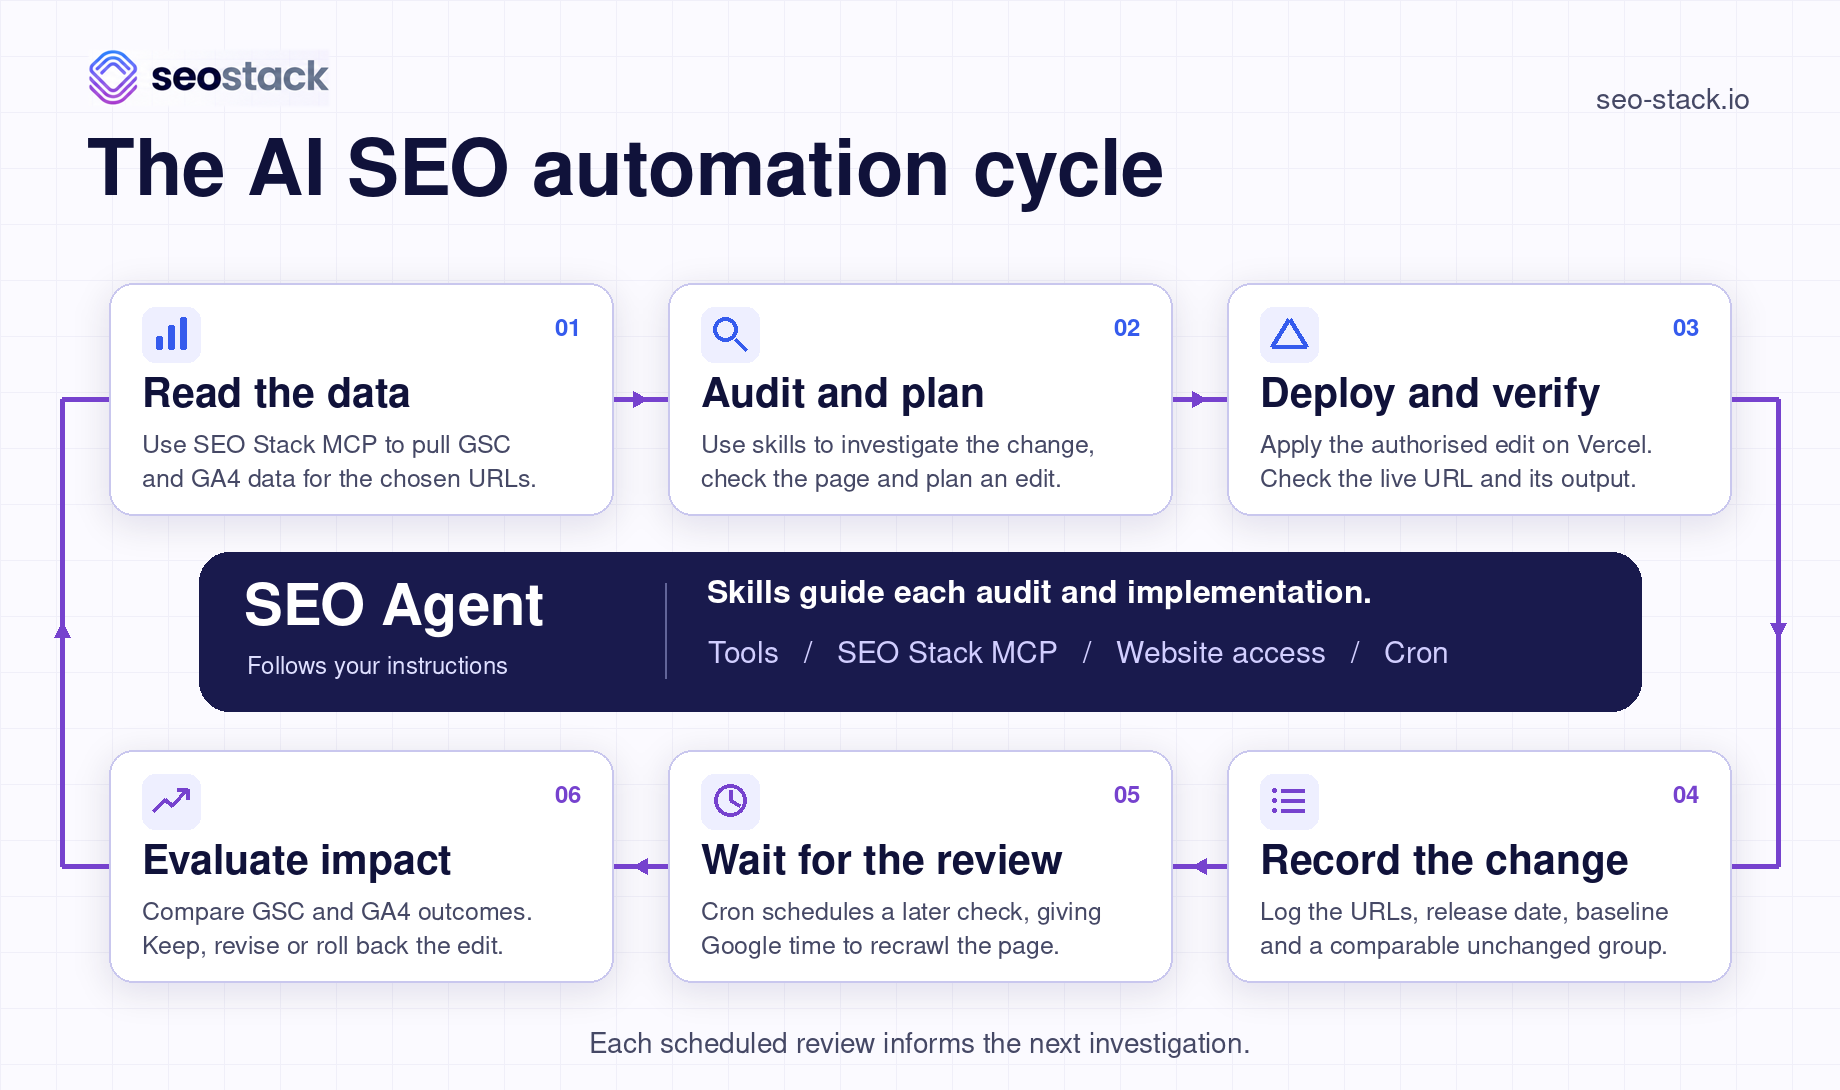
Elegir un agente
1. Necesitas elegir un agente. Puedes optar por algo como Hermes u Open Claw, o puedes usar el escritorio de Claude o el de ChatGPT. Tu agente necesita infraestructura y después necesitas un modelo para él.
Por ejemplo, puedes usar Hermes con Claude Opus o Sonnet. Hay que elegir un agente que soporte contexto largo y que tenga capacidades suficientes para sostener el nivel de análisis que necesitas.
Si quieres montar un agente desde cero, hemos hecho un artículo y un vídeo para ayudarte a empezar.
Cómo construir un Agente SEO de IA para Slack con datos de GSC + GA4
Y aquí tienes el vídeo si quieres hacer la configuración a toda velocidad
Dar skills a un agente
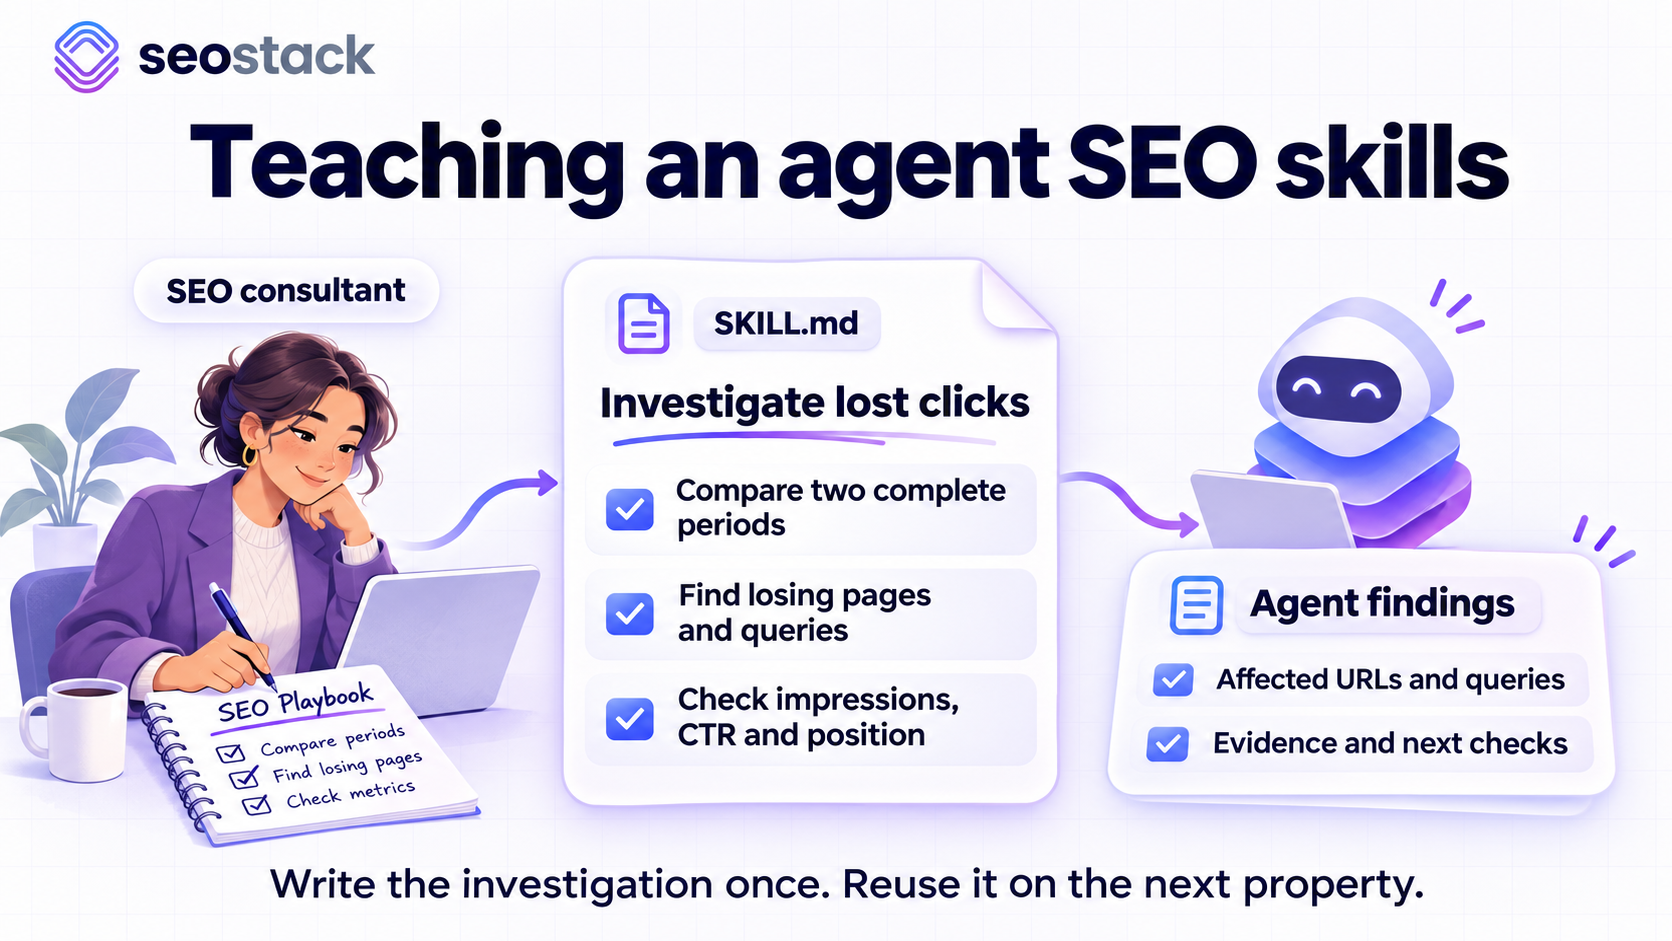
2. Una vez que tengas tu agente, necesitas darle una serie de skills. Las skills pueden ser cosas concretas que el agente revisa, como datos de Google Search Console, rankings y oportunidades de keywords. Tu agente heredará un conjunto de skills, pero también tienes que formarlo sobre el proceso SEO.
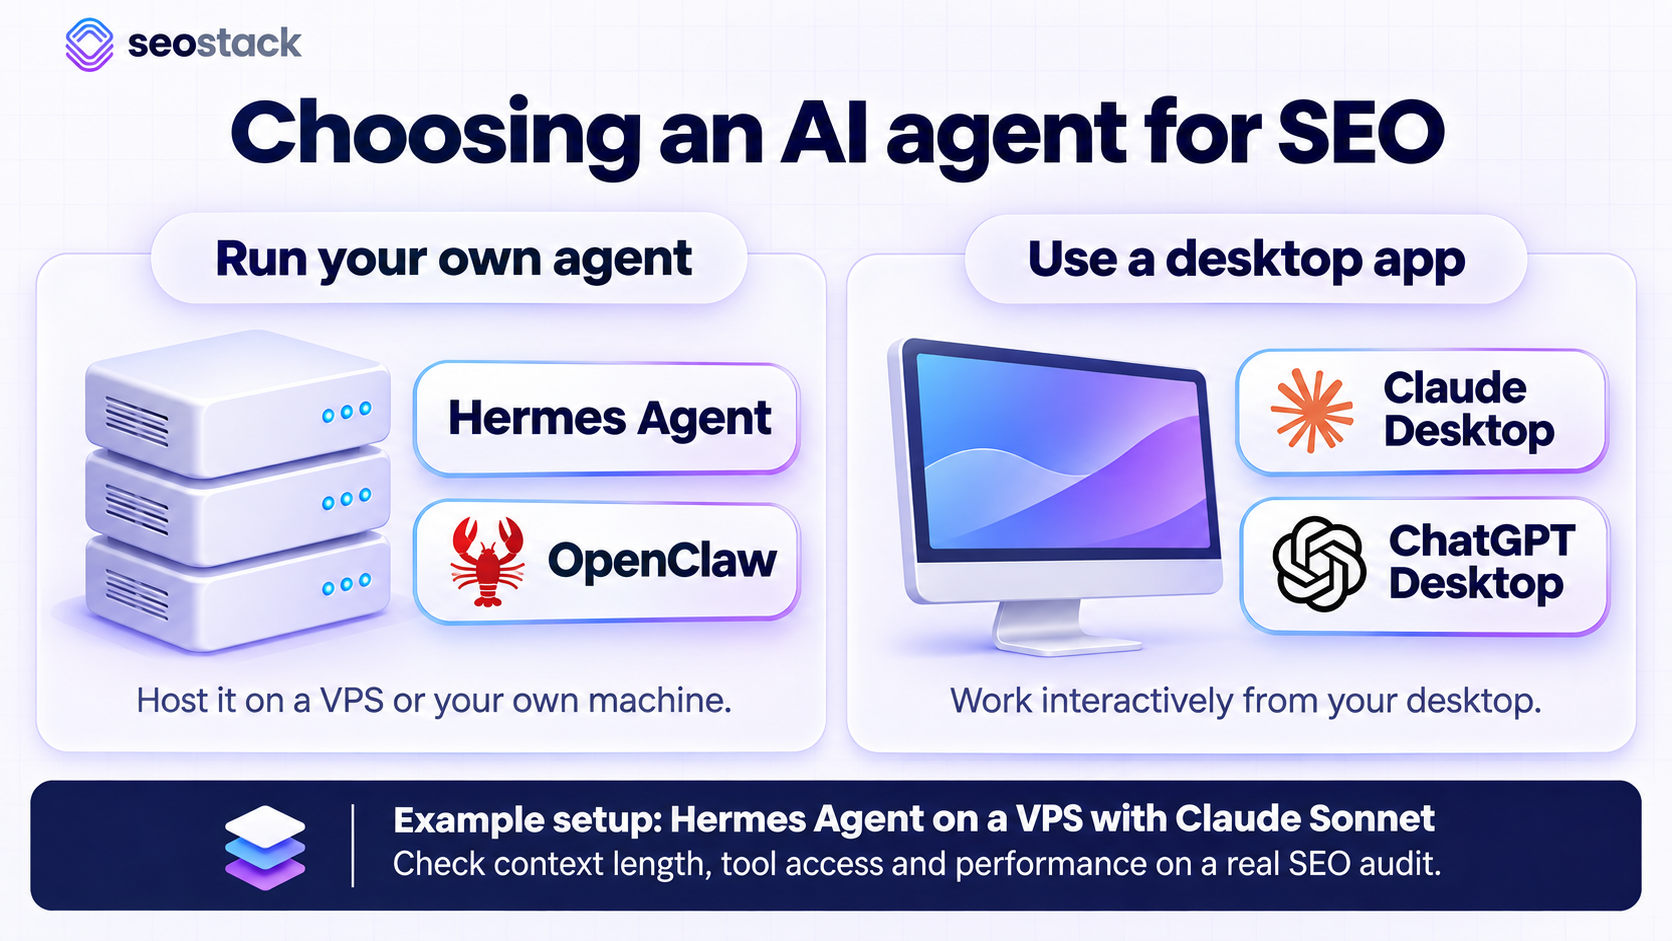
El agente debe entender que si analiza datos, genera una recomendación y luego decide pasar a la implementación. Después, obviamente, hay que asegurarse de que el agente entienda que si hace una implementación en una página, tiene que esperar a que esa página muestre impacto en los datos de Google Search Console.
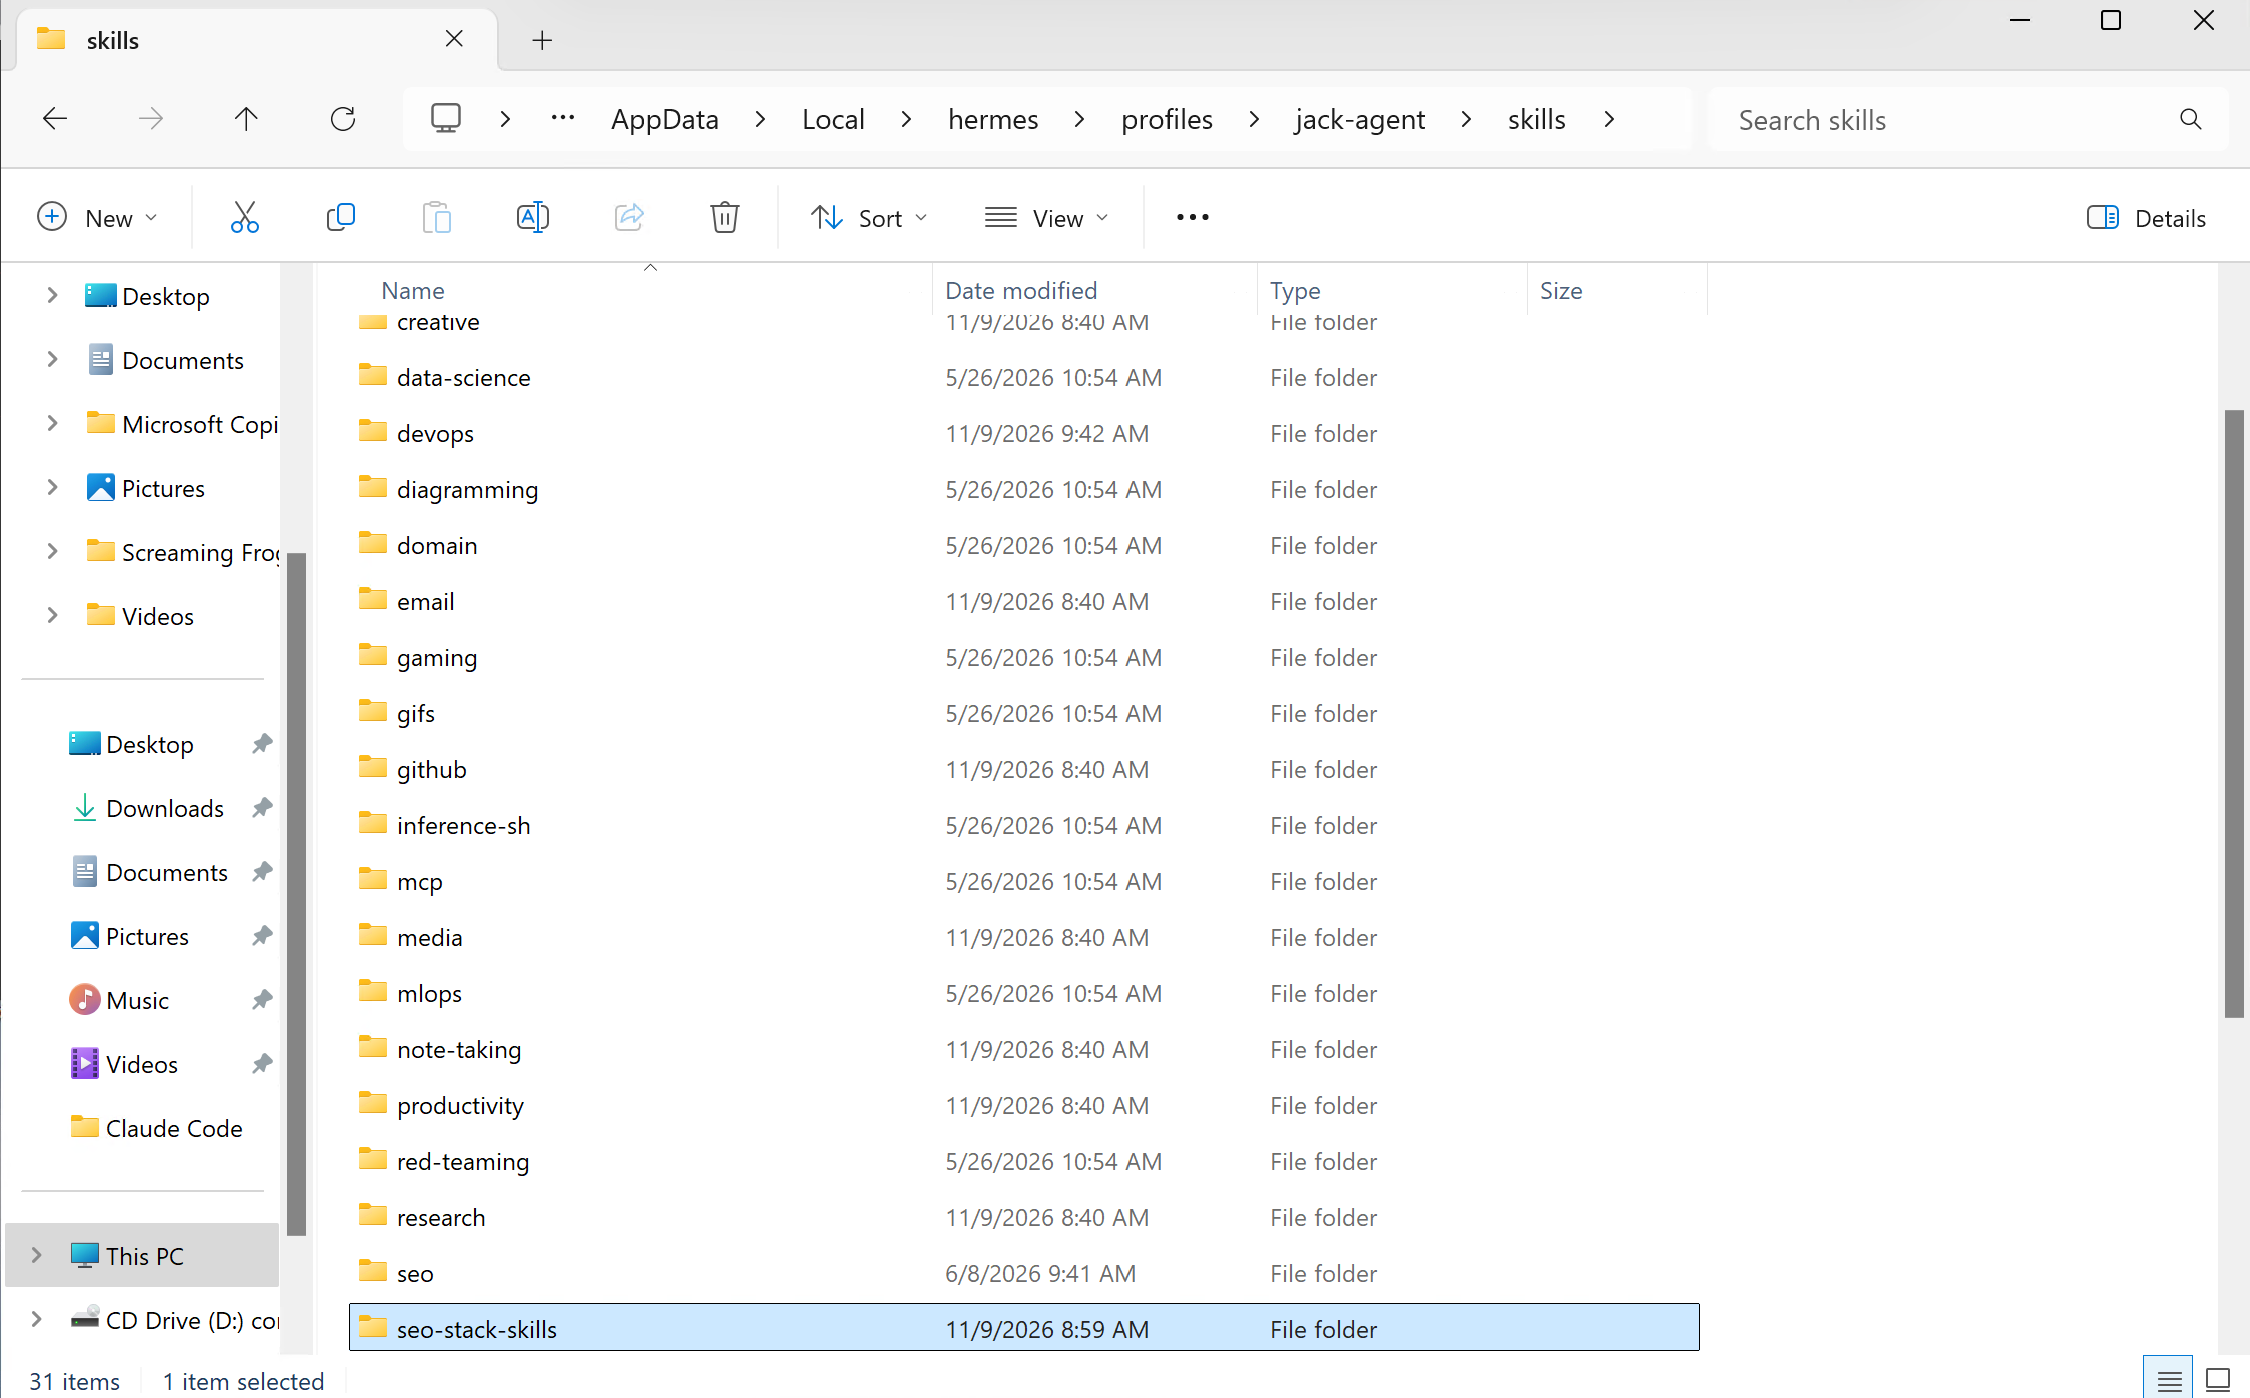
Los agentes de IA / SEO con IA normalmente heredan skills desde una instalación o una subcarpeta. Agentes como Hermes de Nous Research te permiten instalar skills desde un repositorio NPX/git, o simplemente puedes descargar las skills y extraerlas en la carpeta correspondiente. Aquí tienes un agente Hermes con una carpeta de skills:
Por ejemplo, si el 1 de noviembre un agente cambia un bloque de contenido, reescribe el título o añade más enlaces internos a una página, hay un desfase entre el momento en que se hace el cambio y el impacto. El agente tiene que entender que debe haber un periodo de espera.
Después necesitas dar al agente acceso MCP. El acceso MCP permitirá al agente acceder a herramientas como SEO Stack y Ahrefs. El acceso MCP que concedas dependerá de tu stack de herramientas; para una buena automatización / flujo de trabajo de SEO con IA, en general querrás:
MCP para datos de origen (Google Search Console, GA4, herramientas locales, CRM)
MCP para datos de terceros (AHREFS, DataForSEO, SEMRUSH, SERanking, AlsoAsked)
Las campañas SEO necesitan una fuente de datos para el análisis y luego un mecanismo de ejecución donde el agente de IA pueda publicar cambios en directo (o puedes seguir controlando tú mismo ese proceso).
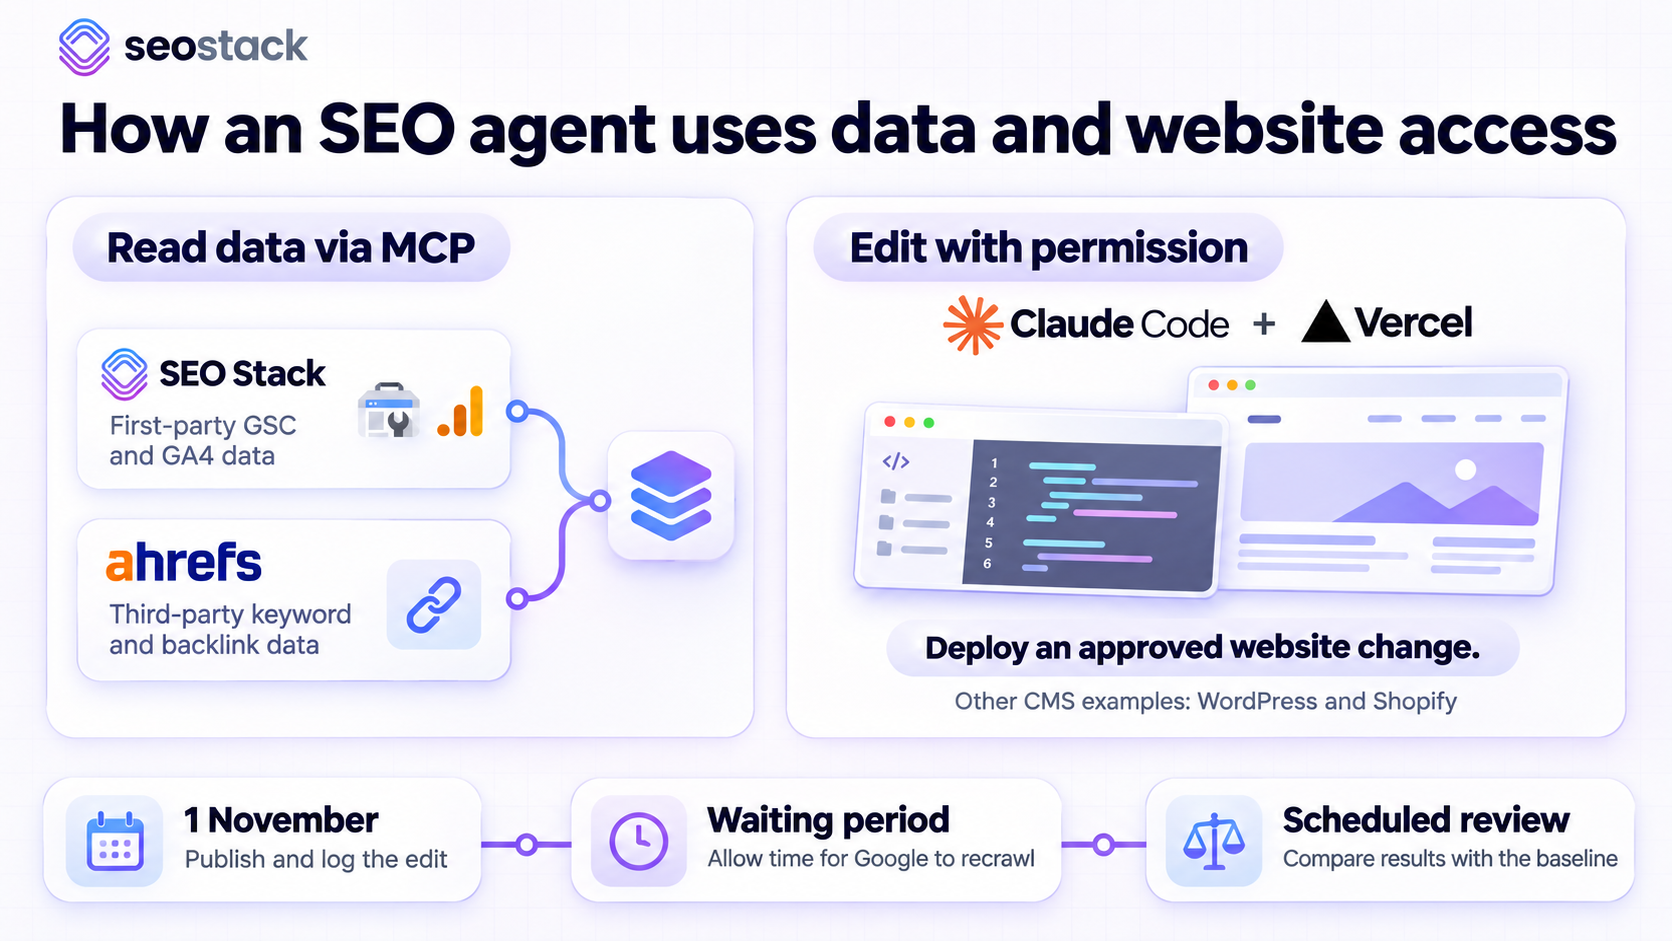
Lo importante aquí es que para una automatización con IA necesitarás unos cuantos MCPs para obtener datos de origen y de terceros. Por ejemplo, el MCP de SEO Stack puede dar al agente visibilidad de IA sobre los datos de GA4 y GSC, y luego puedes tener otro MCP para Ahrefs, SERanking, Semrush u otras herramientas.
Tras dar al agente acceso MCP, tienes que decidir si el agente puede o no implementar directamente en la web. Si trabajas con WordPress, Shopify u otro CMS, puedes configurarlo para que el agente haga la implementación directa. Lo que también recomiendo a mucha gente que quiere hacer este tipo de cosas es Claude Code con Vercel.
Funciona muy bien y ofrece una forma flexible de que los agentes controlen y gestionen un sitio directamente, sin las limitaciones que pueden tener las plataformas CMS.
Estos son los elementos básicos que necesita un agente:
- skills
- guía
- memoria y contexto
- la capacidad de obtener datos, ejecutar acciones y hacer implementaciones
Una vez que tengas eso, obviamente puedes tener un flujo de trabajo SEO autónomo con IA. Eso puede extenderse a cosas como tener tu agente SEO de IA en Slack, informándote de cambios de ranking, de anotaciones y de cualquier cosa que pueda ver en los datos. En este artículo voy a mostrarte y repasar más a fondo este proceso.
Paso 1: Crear o desplegar tu agente
Lo primero es decidir qué agente / modelo vas a usar. Para este ejercicio recomendamos:
Hermes Agent de Nous Research - https://hermes-agent.nousresearch.com/
Desplegar un VPS barato en algo como Database Mart - https://www.databasemart.com/
Por supuesto, puedes usar tu agente o plataforma de IA/LLM ya existente (también puedes desplegar las skills de SEO Stack ahí).
De nuevo, como he puesto el enlace arriba, aquí tienes la guía paso a paso para montar tu propio agente si no lo has hecho antes:
Paso 2: Dar a tu agente skills de SEO
El siguiente paso clave es dar a tu agente las skills que necesita para ejecutar tareas de SEO. A los usuarios de SEO Stack les proporcionamos skills personalizadas que pueden usar para sus automatizaciones SEO, entre ellas:
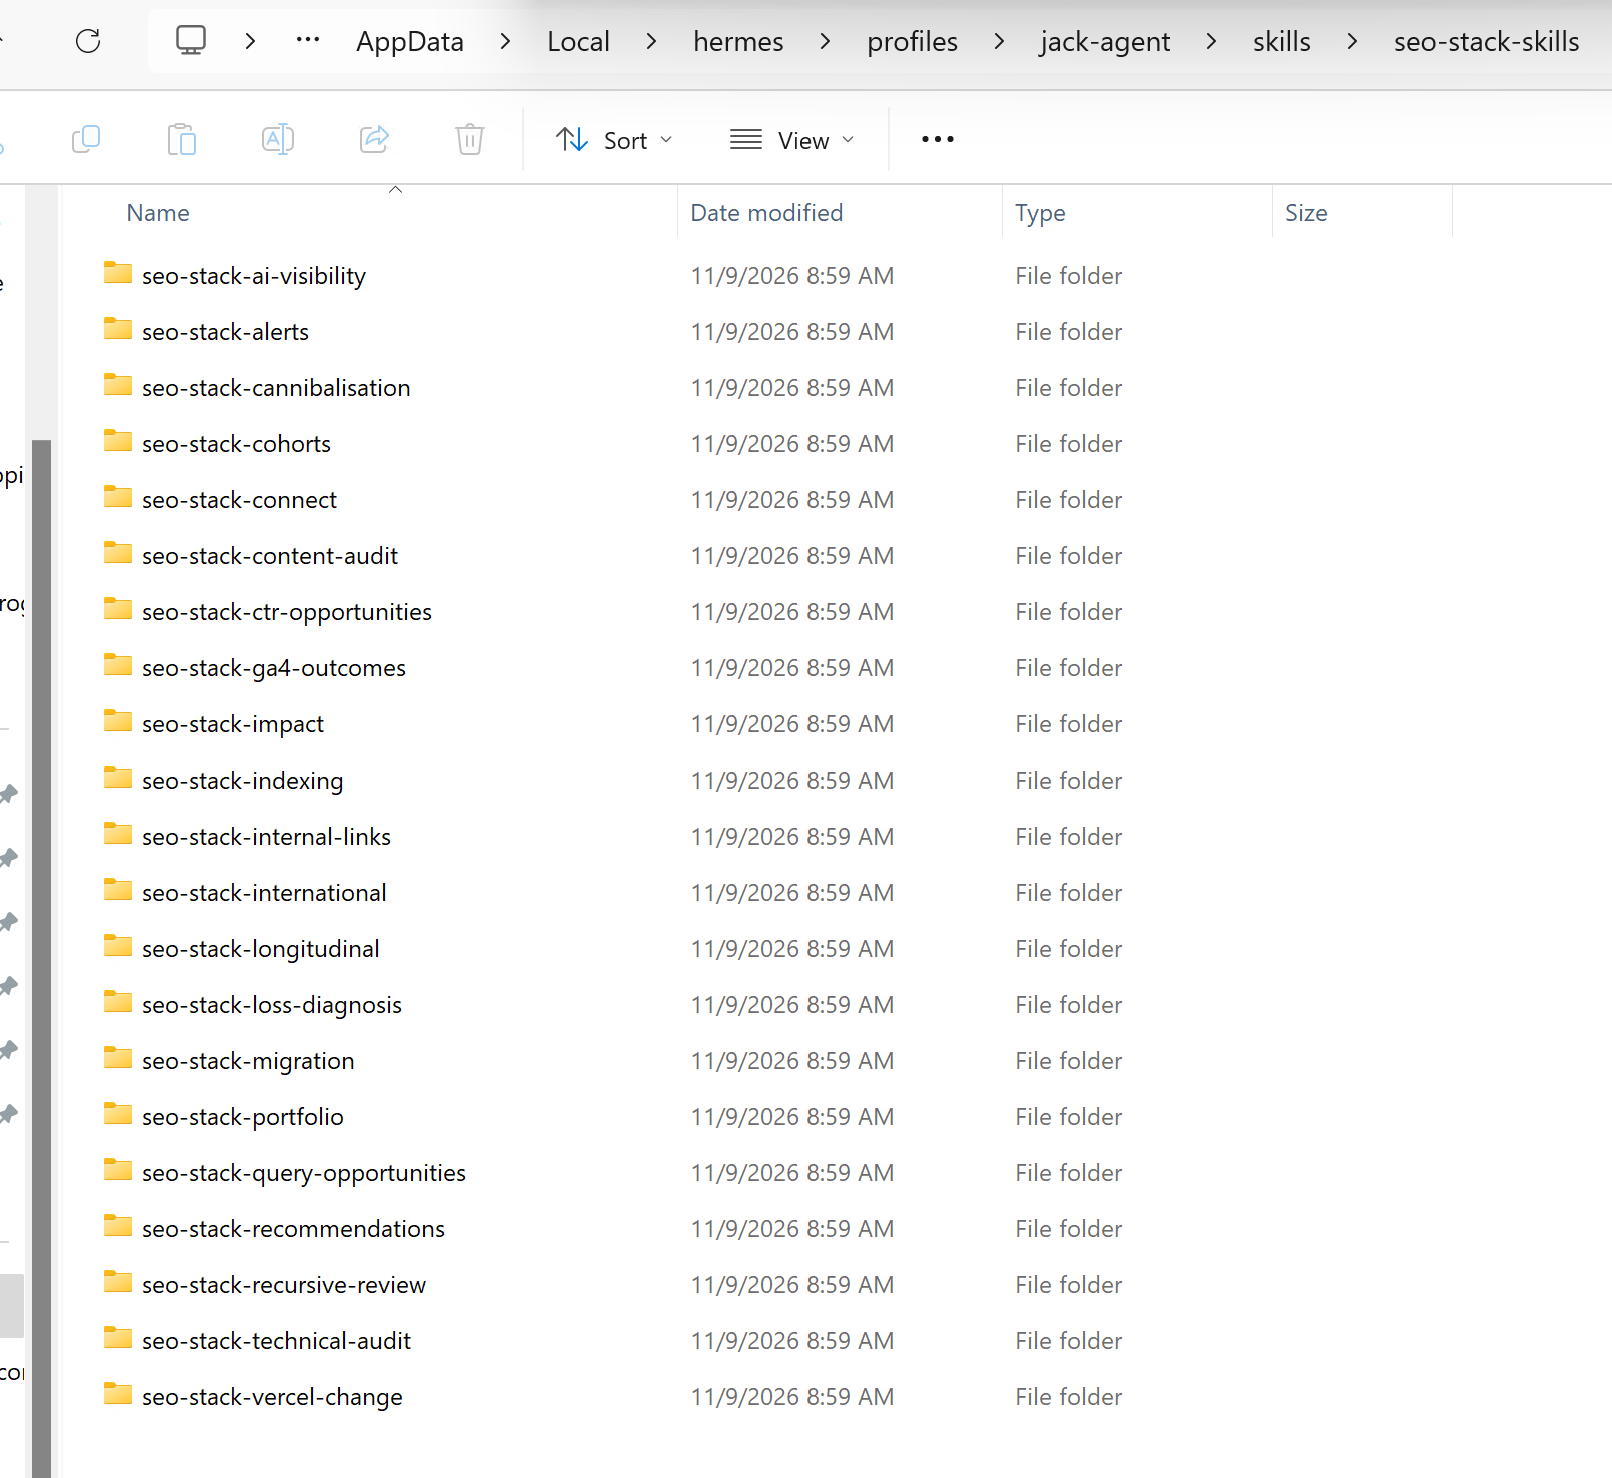
Puedes descargar el pack de skills de SEO Stack aquí:
Descargar las skills de agente de SEO Stack
Paso 3: Instalar las skills en un agente existente o en tu nuevo agente
Descomprime la descarga una sola vez y guarda todo el directorio seo-stack-skills en un lugar al que el agente pueda acceder. Dentro de skills/, cada carpeta seo-stack-* contiene su propio SKILL.md. Esas carpetas individuales son las que van al directorio de skills del cliente.
Esto dependerá de la plataforma que utilices; por ejemplo, HERMES tiene una carpeta de skills dentro de la carpeta del perfil por defecto o de cualquier otro perfil que crees:
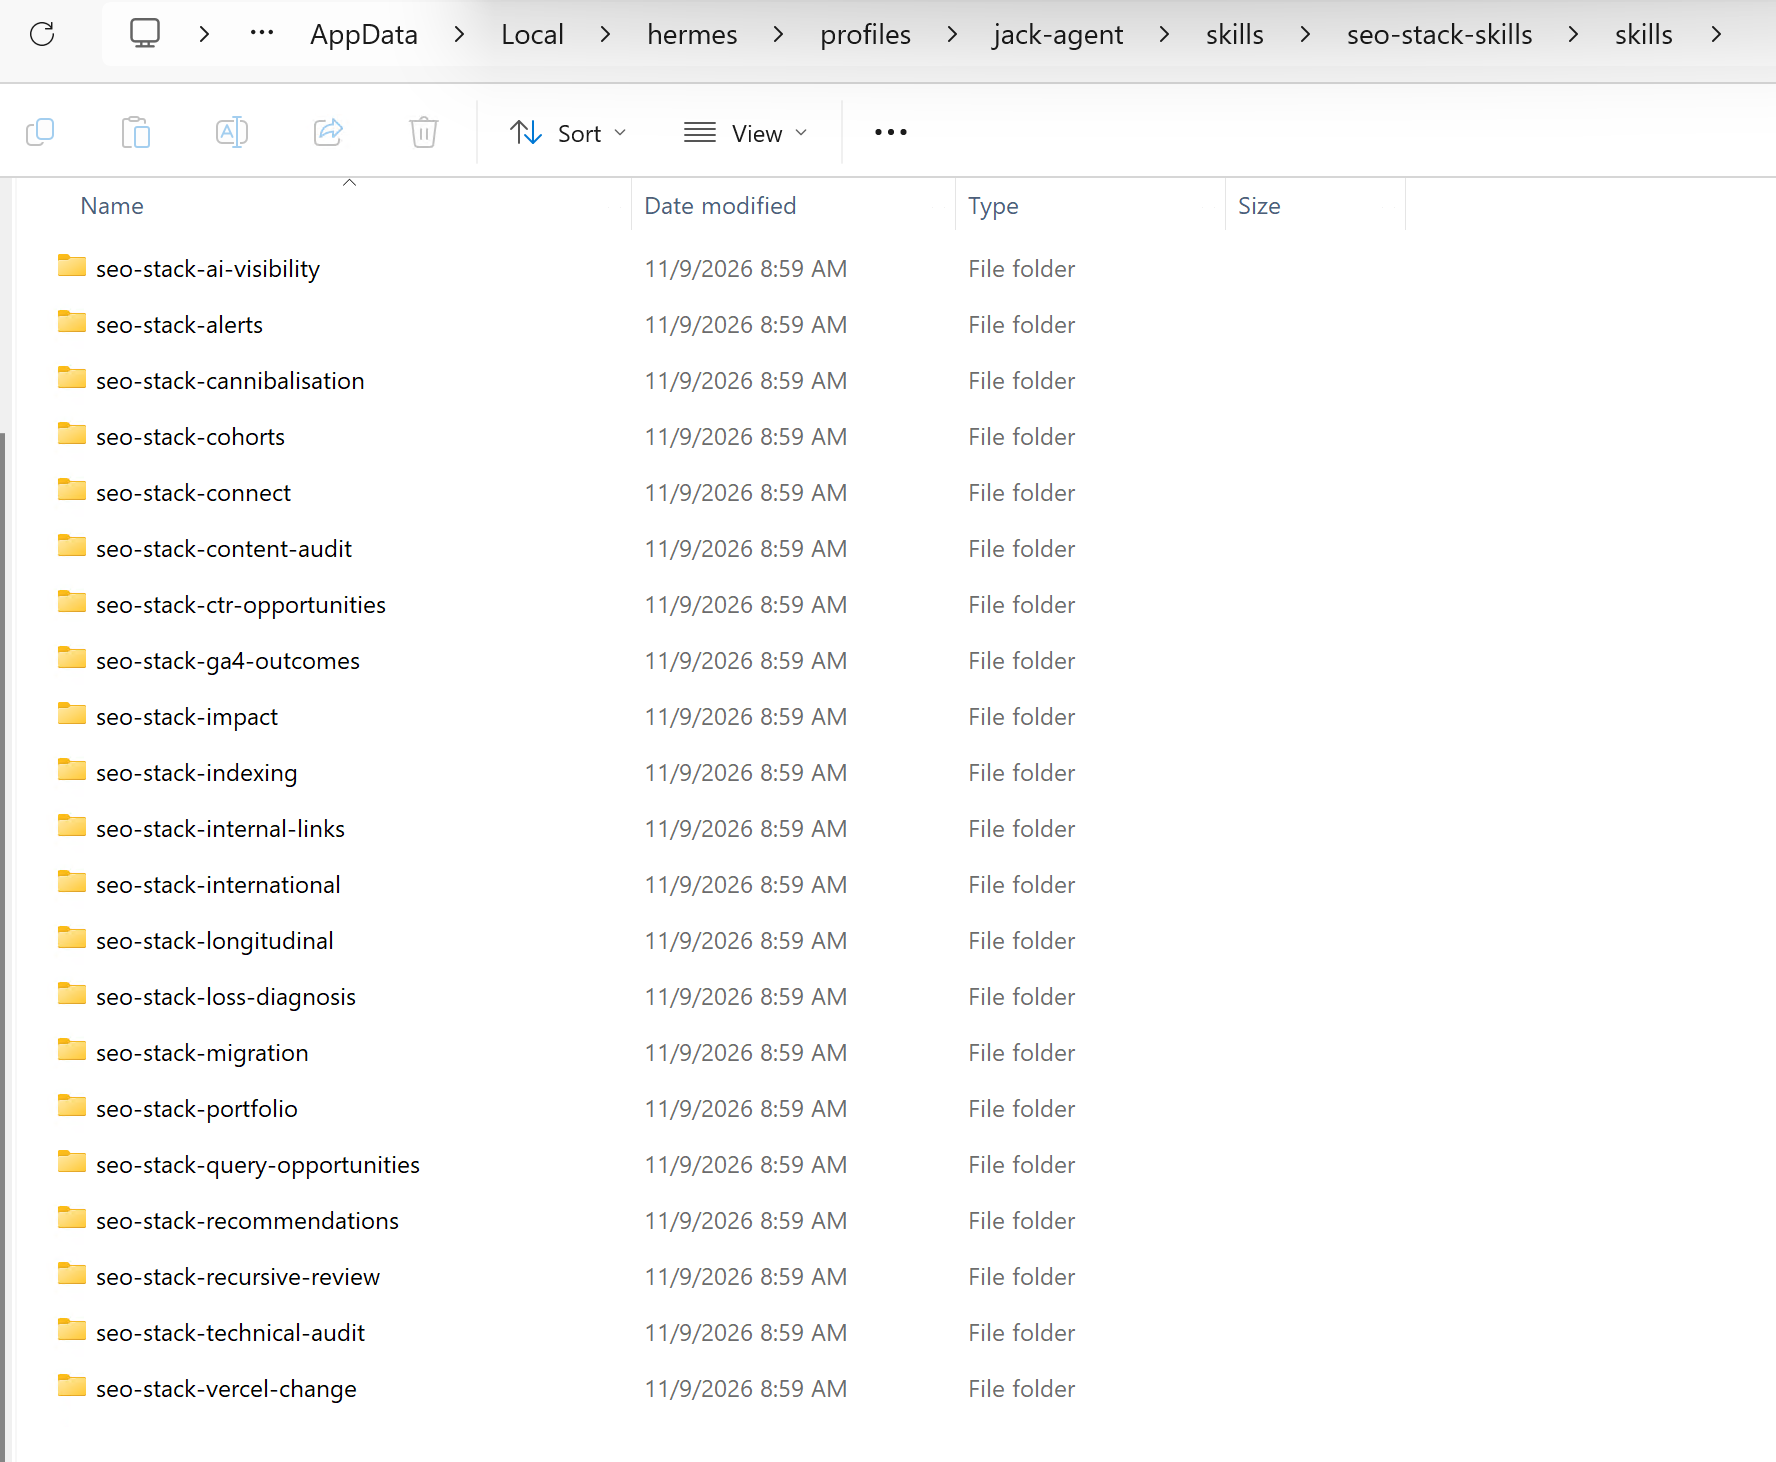
Las carpetas compartidas docs/, scripts/ y examples/ permanecen juntas en el checkout original. Indícale al agente dónde las has colocado. En un chat en la nube, proporciona directamente los archivos de referencia compartidos si el checkout local no está disponible.
Para lecturas en vivo también necesitarás una propiedad autorizada en SEO Stack y su conexión MCP. Los agentes existentes pueden reutilizar una conexión que ya funcione. Para uno nuevo, abre MCP en SEO Stack, obtén los datos de conexión de producción y guarda la clave en los ajustes de credenciales del cliente.
Los ejemplos siguientes usan el endpoint con bearer key de nuestra guía de Hermes. Utiliza una credencial limitada a los clientes que el agente debe ver, teniendo en cuenta que una clave de SEO Stack se autentica como su titular de cuenta. Guía de configuración de SEO Stack
Hermes en un VPS o en una máquina RDP existente
Ejecuta hermes profile show YOUR_PROFILE en la máquina donde corre Hermes. Abre la carpeta skills de ese perfil y copia dentro las carpetas individuales. El Explorador de archivos sirve perfectamente para esto. En una instalación estándar de Linux, un perfil con nombre usa ~/.hermes/profiles/YOUR_PROFILE/skills/ y el perfil por defecto usa ~/.hermes/skills/. En Windows, utiliza la ruta que Hermes indique para esa instalación.
Para una nueva conexión MCP, guarda MCP_SEOSTACK_API_KEY en el archivo .env privado del perfil. Añade la siguiente entrada en su config.yaml, integrándola en cualquier sección mcp_servers existente:
mcp_servers:
  seostack:
    url: https://api.seo-stack.io/api/mcp
    headers:
      Authorization: "Bearer ${MCP_SEOSTACK_API_KEY}"
Abre una sesión nueva. Ejecuta hermes -p YOUR_PROFILE skills list y hermes -p YOUR_PROFILE mcp test seostack. Deberías ver las skills y las herramientas del servidor detectadas. Después, pide la prueba de propiedad en vivo que se indica más abajo. Si este perfil también ejecuta un gateway, aplica la configuración a ese gateway y pruébalo también desde ahí. Una conexión CLI correcta puede convivir con un worker programado que cargue un perfil distinto o que tenga una sesión MCP obsoleta. Perfiles de Hermes · SEO Stack en Hermes
Claude Desktop o Claude en la web
Puedes instalarlo fácilmente; la vía rápida es simplemente descargar el archivo ZIP de arriba, dárselo a Claude en un chat y pedirle que lo instale para su uso continuado:
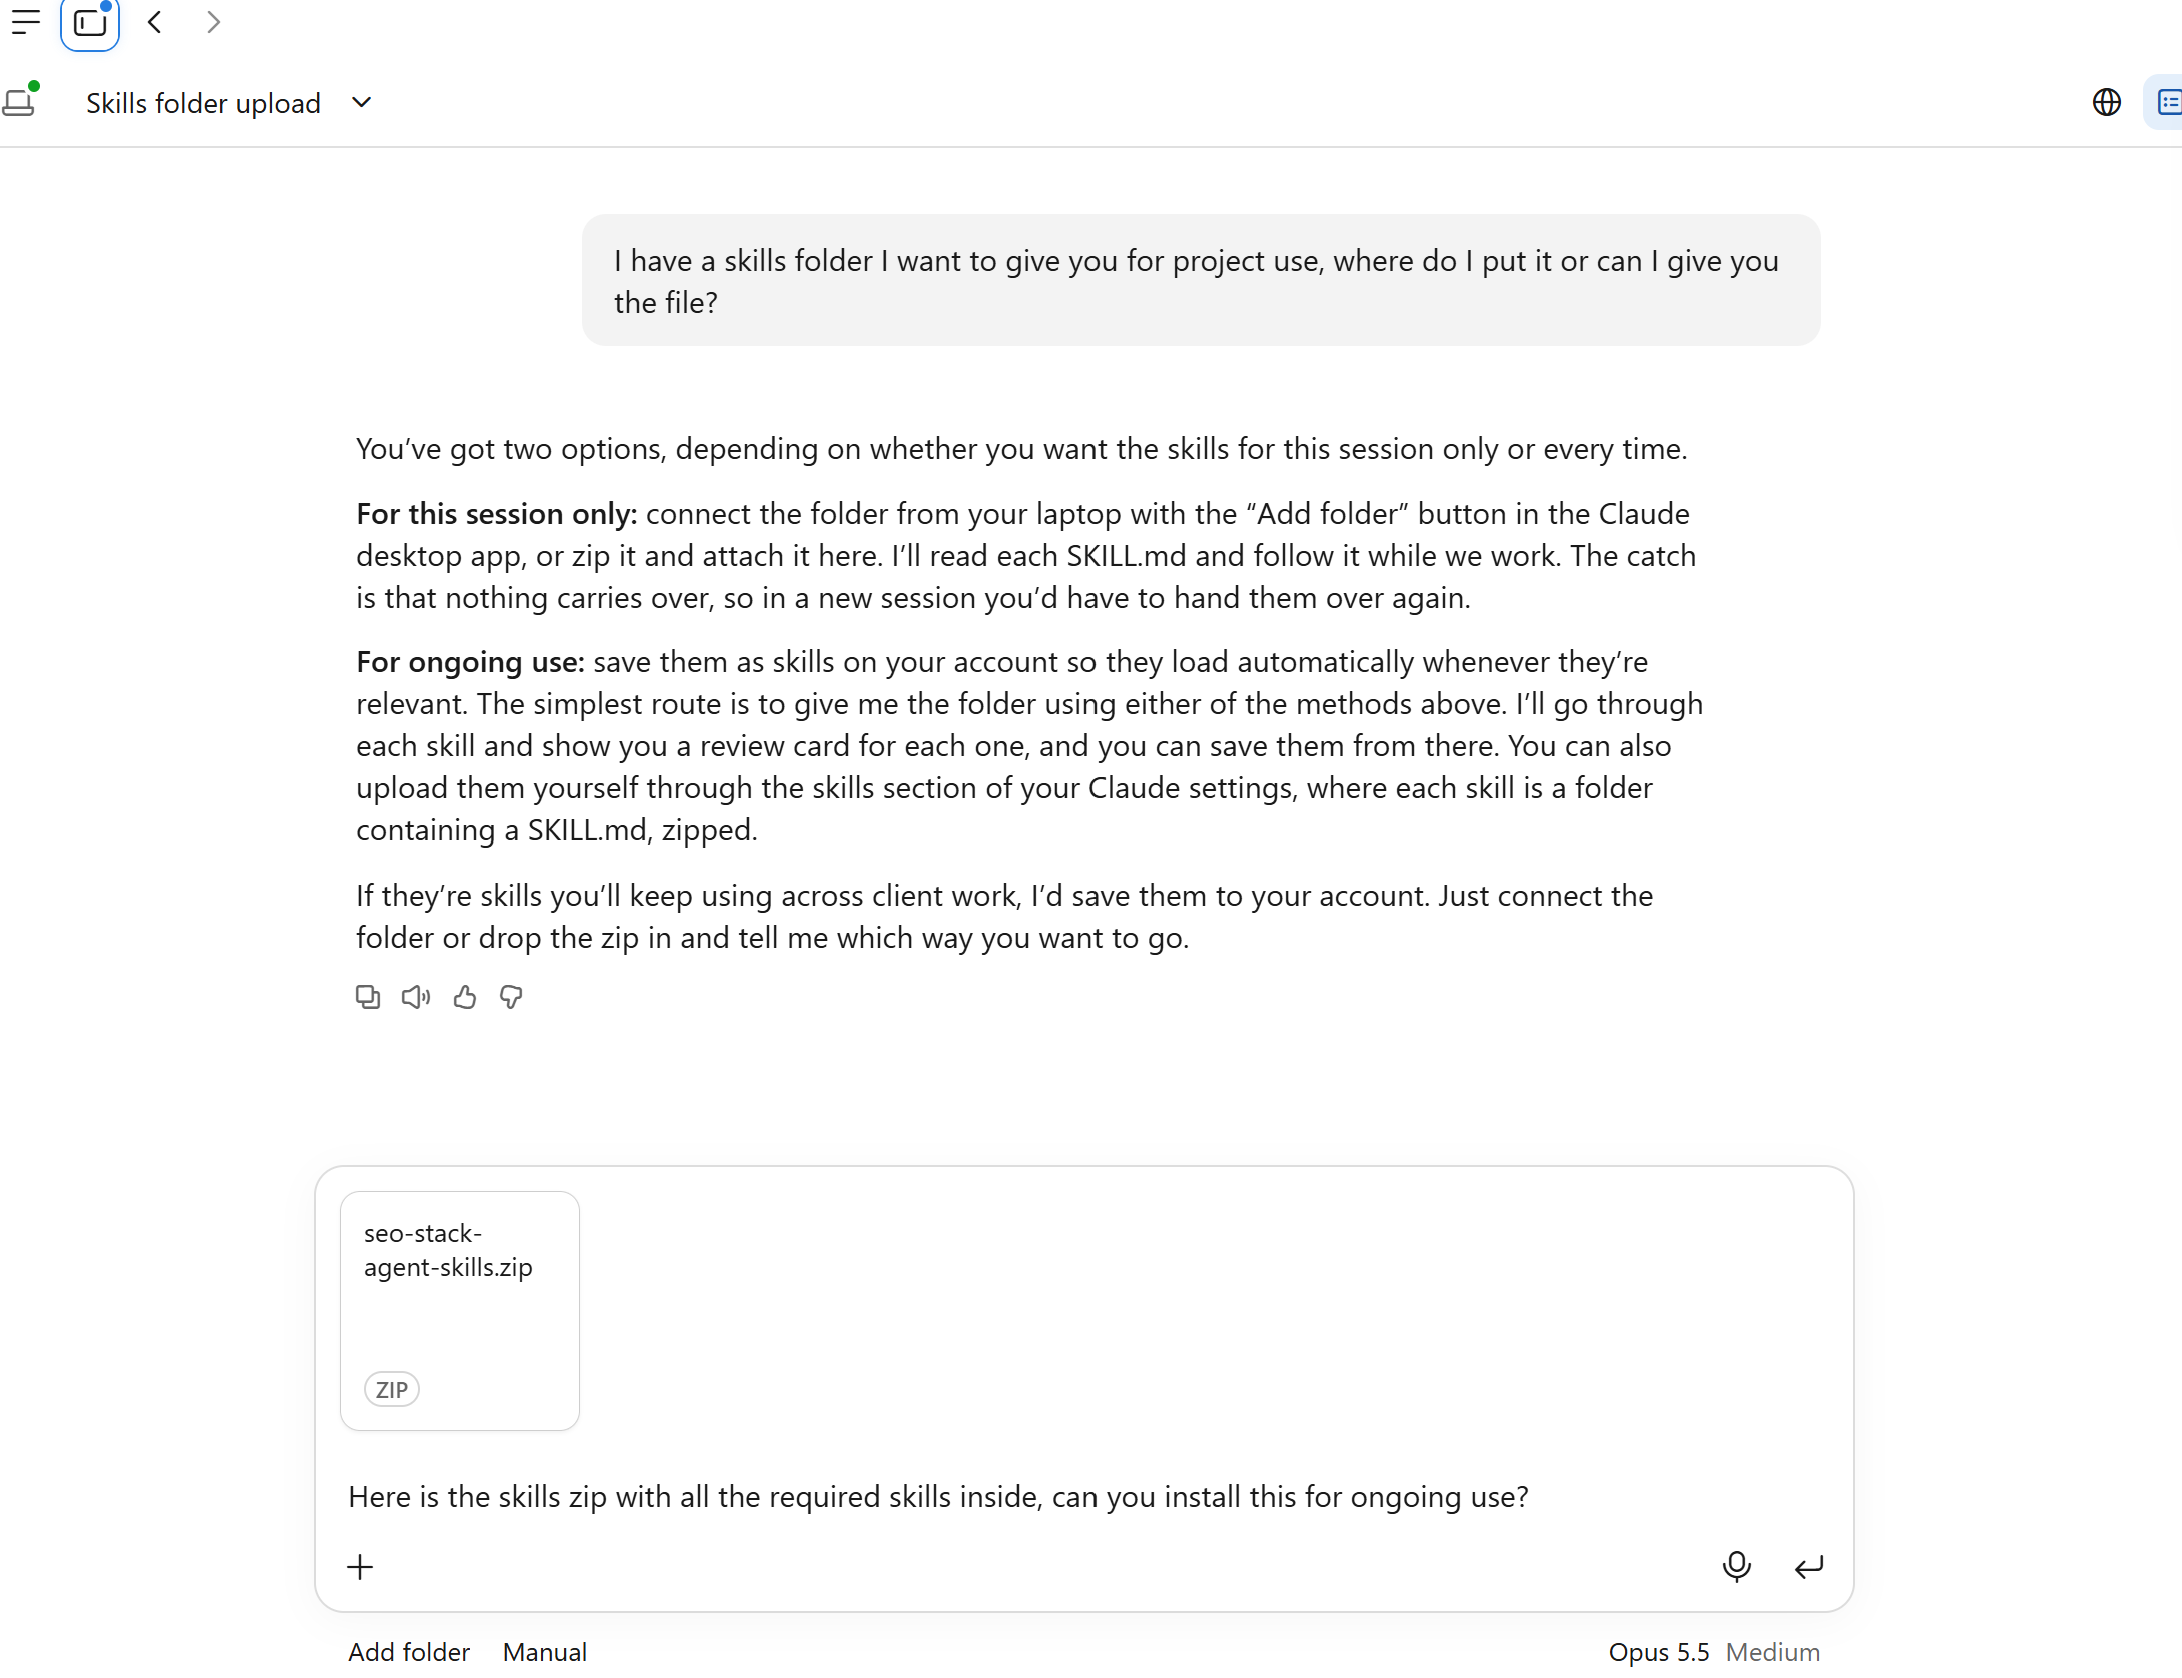
Verás cómo se instala y luego podrás guardar el plugin:
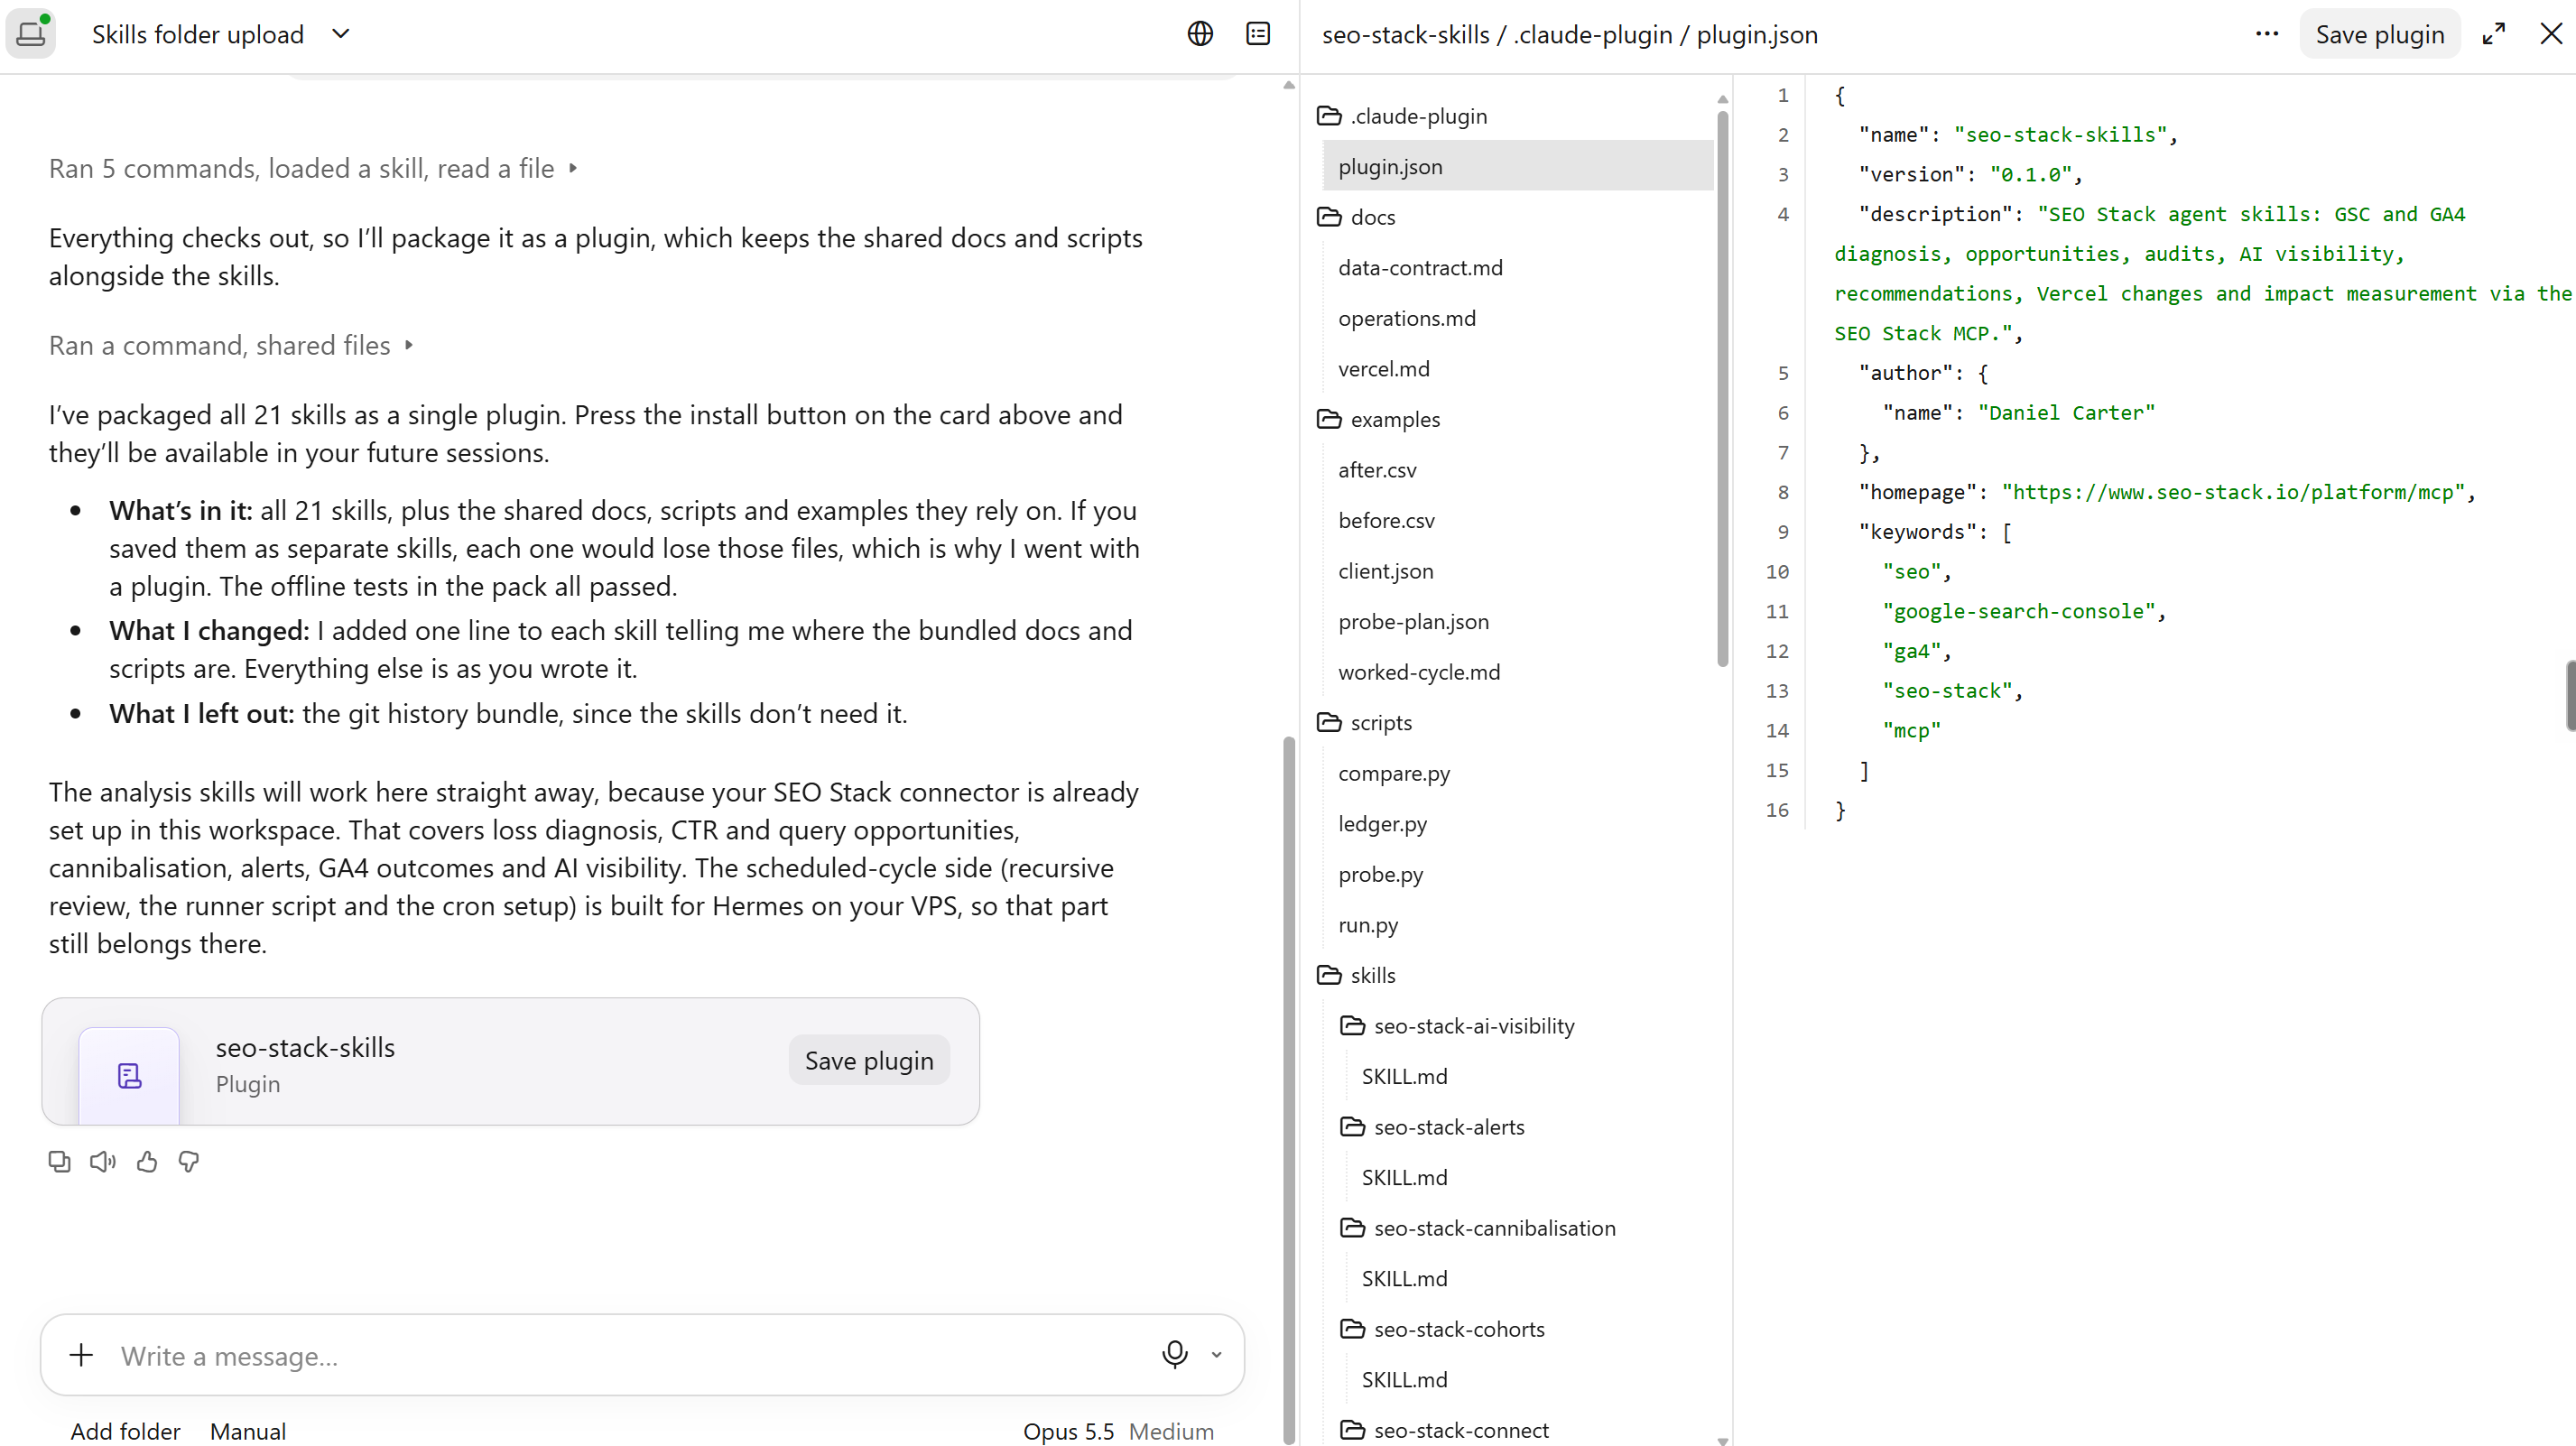
Una vez hecho esto, solo tienes que conectar Claude al MCP de SEO Stack
Activa la ejecución de código y la creación de archivos en las capacidades de Claude. Empieza con dos skills, seo-stack-connect y seo-stack-loss-diagnosis. Comprime cada carpeta de skill por separado, manteniendo juntos la carpeta y su SKILL.md. En Customize → Skills, usa + → Create skill → Upload a skill, sube cada ZIP y actívalo. Adjunta el archivo docs/data-contract.md del pack al proyecto o a la conversación para que Claude pueda leer las instrucciones de medición comunes. Instalación de skills personalizadas en Claude
Abre una pestaña de Chrome o de tu navegador y visita >
https://app.seo-stack.io/mcp
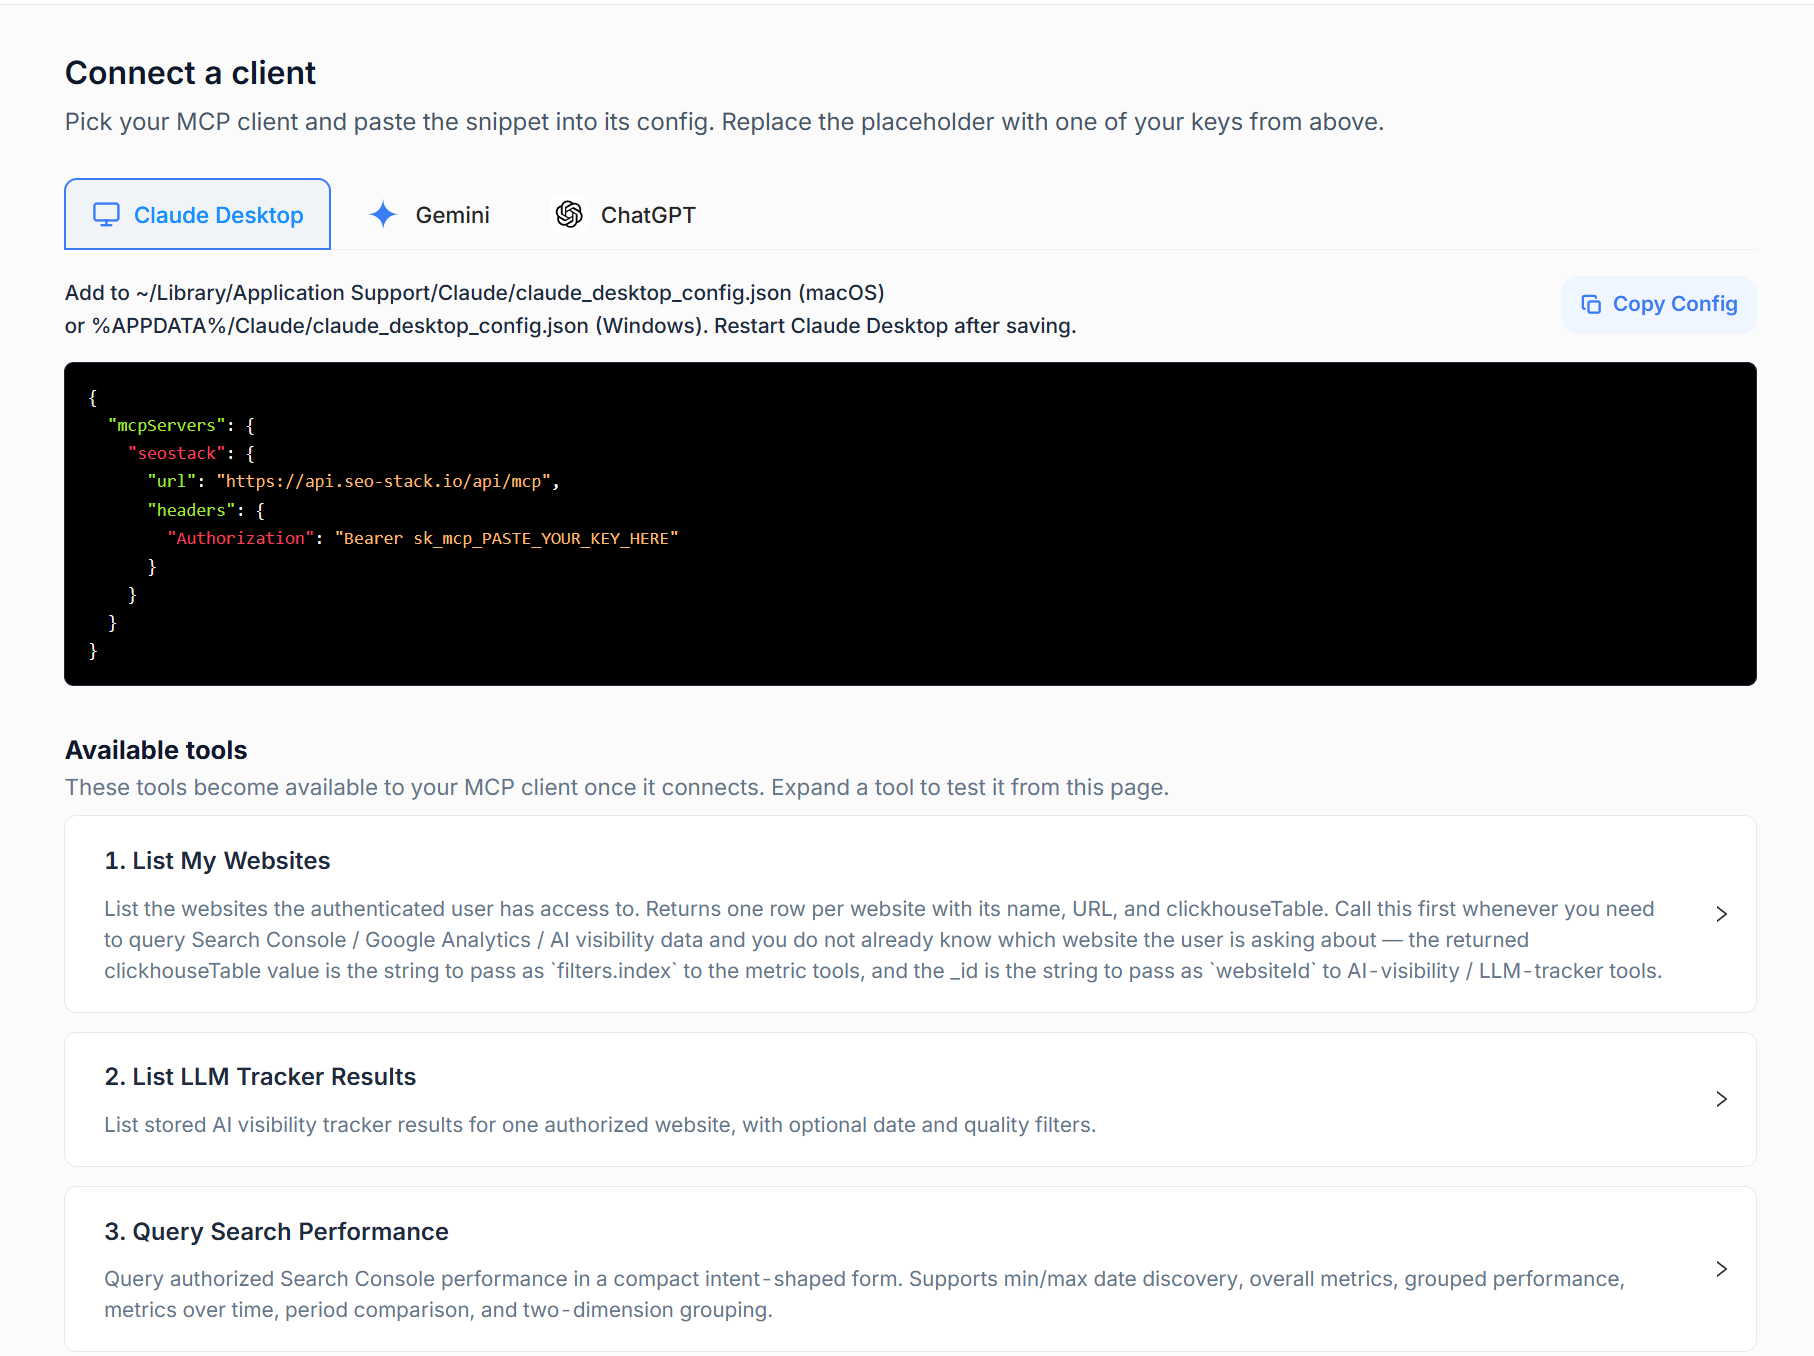
Aquí puedes crear la conexión / crear una API KEY.
Tendrás que crear una clave MCP y luego asignarle un nombre >
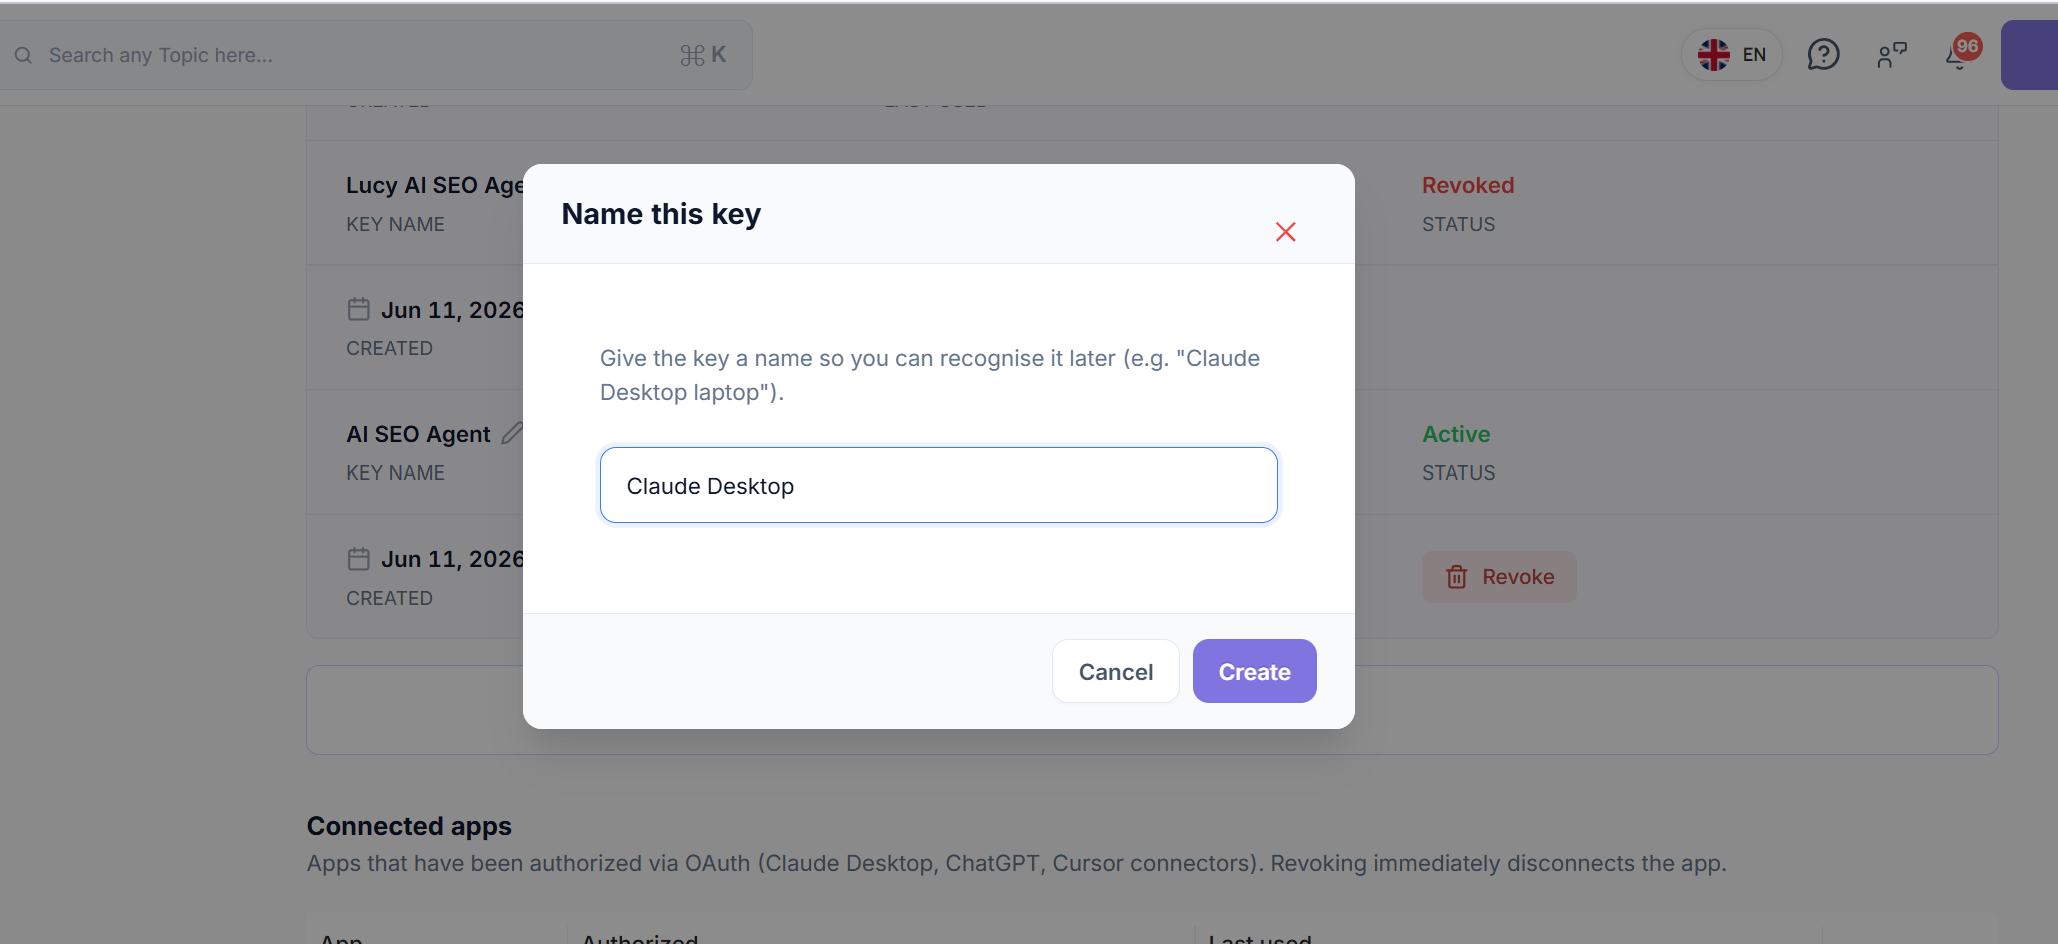
Después vuelve a Claude Desktop y ve a SETTINGS.
En Customize → Connectors, añade un conector personalizado usando la URL del MCP de SEO Stack.
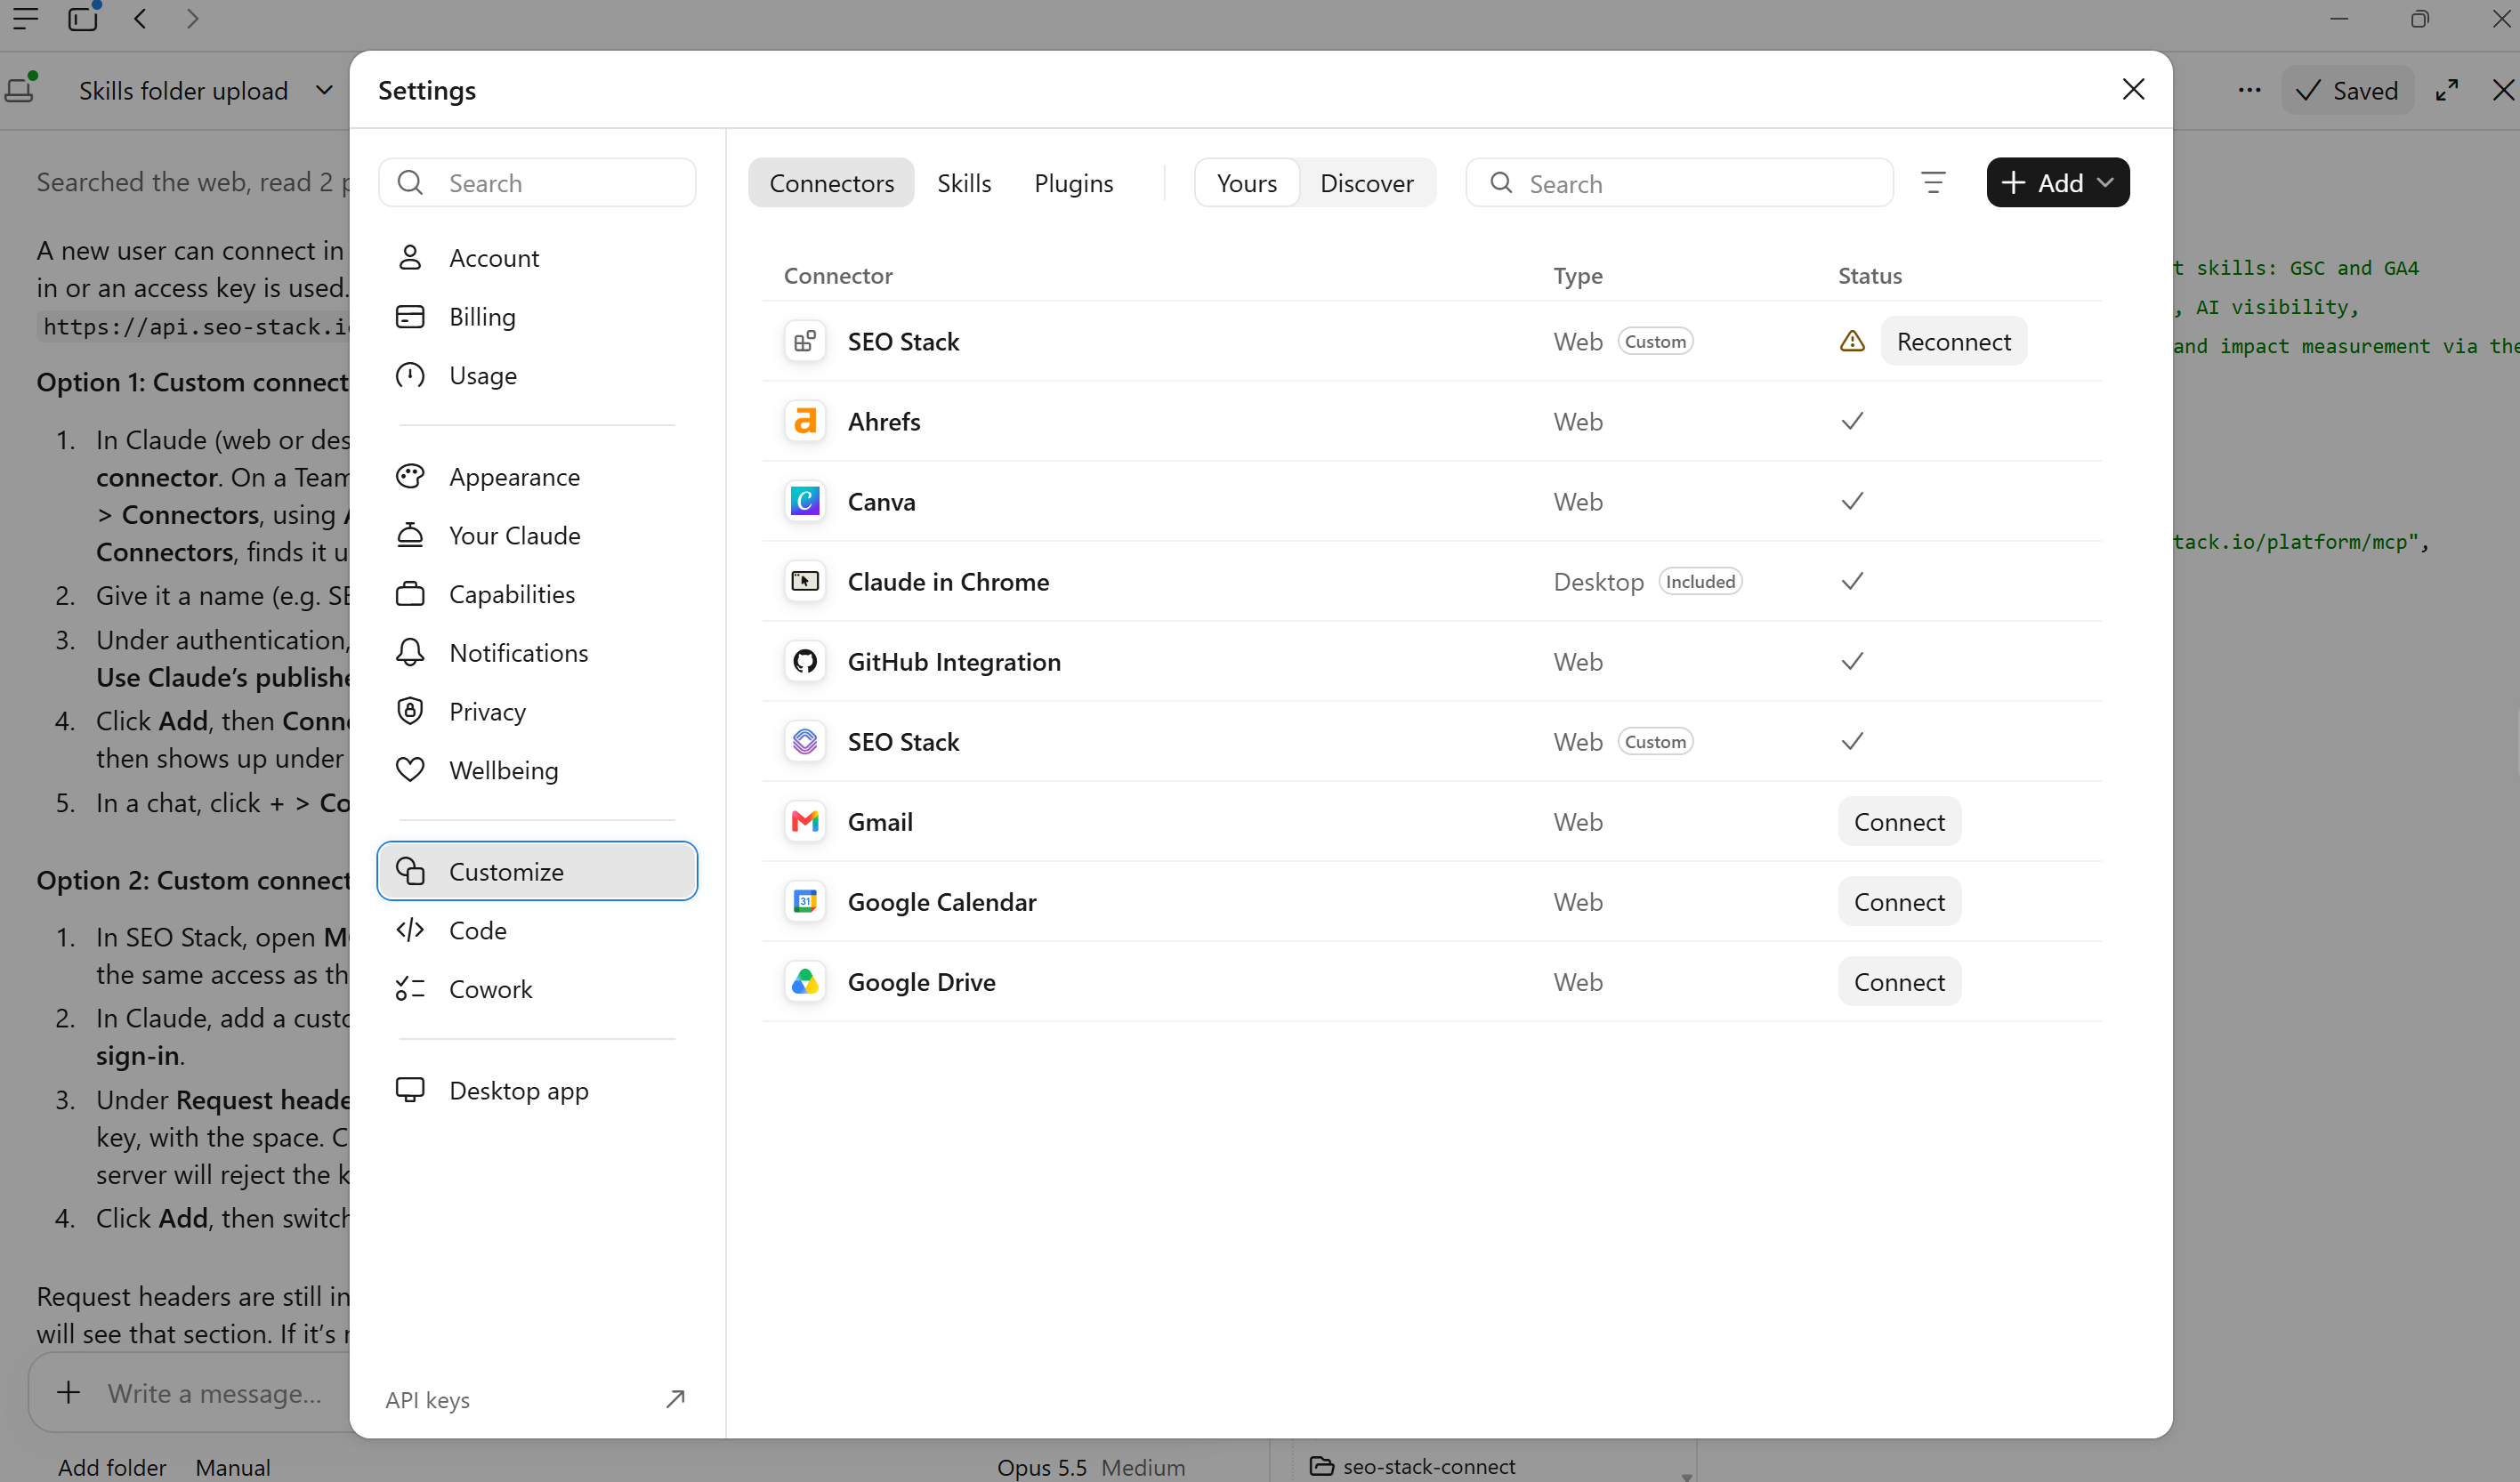
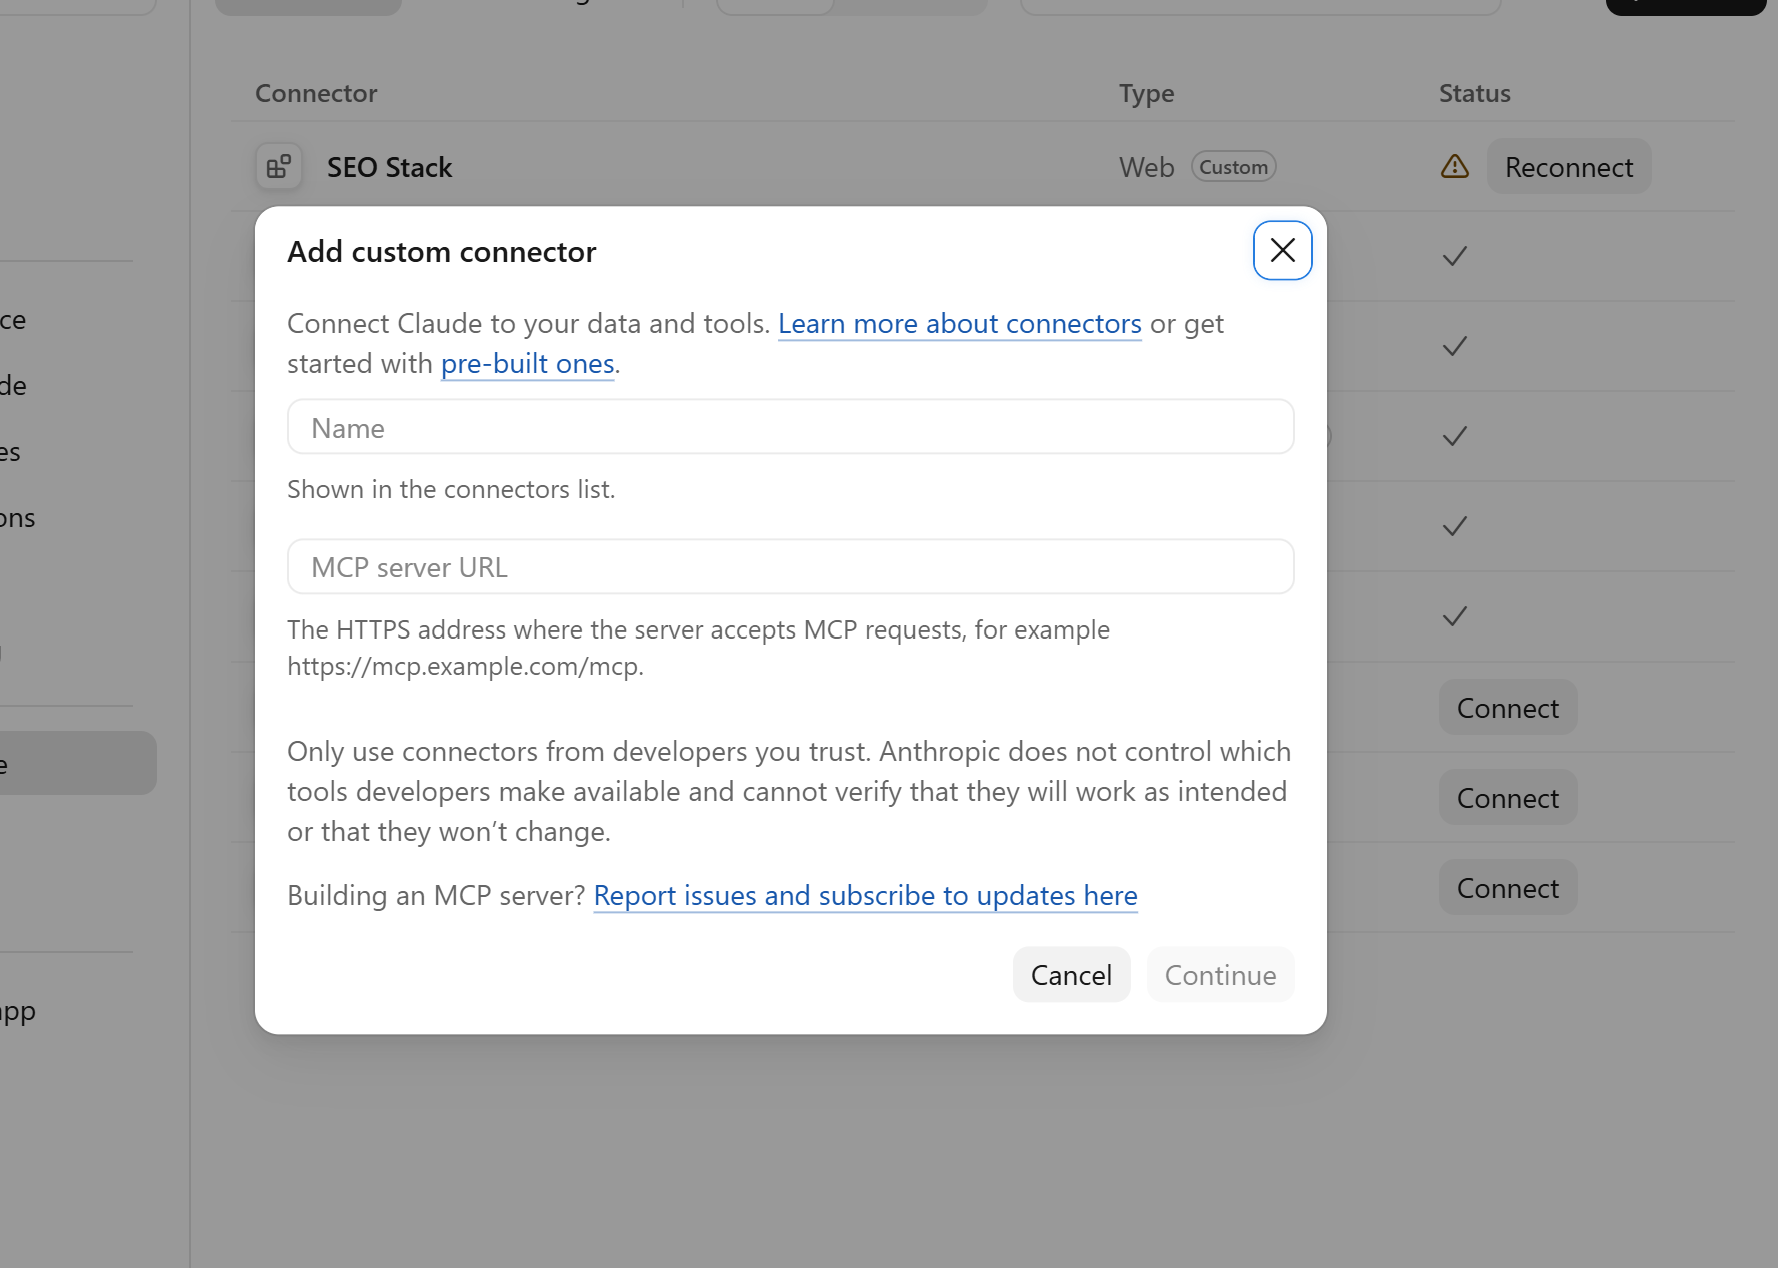
Para el acceso con bearer key, usa la opción de cabecera de petición fija, con el nombre de cabecera Authorization y el valor Bearer YOUR_SEO_STACK_KEY.
Introduce el valor real en los ajustes del conector.
Activa el conector para la conversación. Puede que en los espacios de trabajo de equipo sea necesario que un propietario lo configure, y una credencial fija compartida otorga a los miembros el alcance de esa cuenta. Para un analista de escritorio, esta configuración es suficiente para ejecutar el ejemplo de reporting. El planificador de Linux del pack requiere un runtime aparte. Configuración de conectores remotos en Claude
Claude Code en el repositorio de un sitio web
Copia las carpetas necesarias en .claude/skills/ dentro del proyecto del sitio, o en ~/.claude/skills/ para uso personal en varios proyectos. Haz accesible el checkout compartido e inicia Claude Code desde el proyecto previsto. Para una conexión limitada al proyecto, integra esta entrada en .mcp.json. Define la variable de entorno con ese nombre en el proceso que ejecuta Claude Code. Así el archivo puede referenciar la variable sin contener tu clave.
{
  "mcpServers": {
    "seostack": {
      "type": "http",
      "url": "https://api.seo-stack.io/api/mcp",
      "headers": {"Authorization": "Bearer ${MCP_SEOSTACK_API_KEY}"}
    }
  }
}
Revisa y activa el servidor del proyecto cuando se te pida. Abre /mcp para inspeccionar la conexión y después pide a Claude Code que use la skill de conexión. Para una preview de Vercel, abre el repositorio real del sitio y dale al agente el brief aceptado y las rutas permitidas. Directorios de skills de Claude · Configuración MCP de Claude Code
Cursor
Abre el proyecto del sitio en Cursor y copia las carpetas de skills en .cursor/skills/. Añade SEO Stack al archivo .cursor/mcp.json del proyecto. En el ejemplo siguiente, el prefijo env: es intencionado. Cursor usa una sintaxis de interpolación distinta a la de Claude Code.
{
  "mcpServers": {
    "seostack": {
      "url": "https://api.seo-stack.io/api/mcp",
      "headers": {"Authorization": "Bearer ${env:MCP_SEOSTACK_API_KEY}"}
    }
  }
}
Haz que la variable esté disponible para el proceso de Cursor y abre una nueva conversación de Agent. Pídele que ejecute la prueba de propiedad. Si más adelante trasladas el trabajo a un worker en la nube, verifica allí también sus credenciales, skills y checkout. Skills de Cursor · Configuración MCP de Cursor
OpenAI Codex CLI o extensión de IDE
Para una instalación por proyecto, copia las carpetas de skills en .agents/skills/ en la raíz del repositorio. Codex también admite ~/.agents/skills/ para skills personales. Añade la siguiente tabla a ~/.codex/config.toml, o a .codex/config.toml en un proyecto de confianza. Define la variable de entorno con el valor de la clave en bruto. Codex construye la cabecera bearer.
[mcp_servers.seostack]
url = "https://api.seo-stack.io/api/mcp"
bearer_token_env_var = "MCP_SEOSTACK_API_KEY"
Inicia Codex en el proyecto y pídele explícitamente que use $seo-stack-connect. Ten a mano la documentación compartida y verifica el sitio y las fechas devueltas antes de intentar una tarea de programación. Ubicaciones de las skills de Codex · Ajustes de MCP en Codex
Paso 4: Probar la conexión y las skills
Una vez instaladas las skills, y según la plataforma/agente que utilices, deberías poder simplemente preguntar a la plataforma/agente si puede ver / acceder y usar esas skills, y después pedirle que obtenga datos de uno de tus sitios web en SEO Stack.
Así que, después de configurar mi agente Hermes AI SEO y conectarlo a SLACK, le pregunté si podía acceder a las skills:
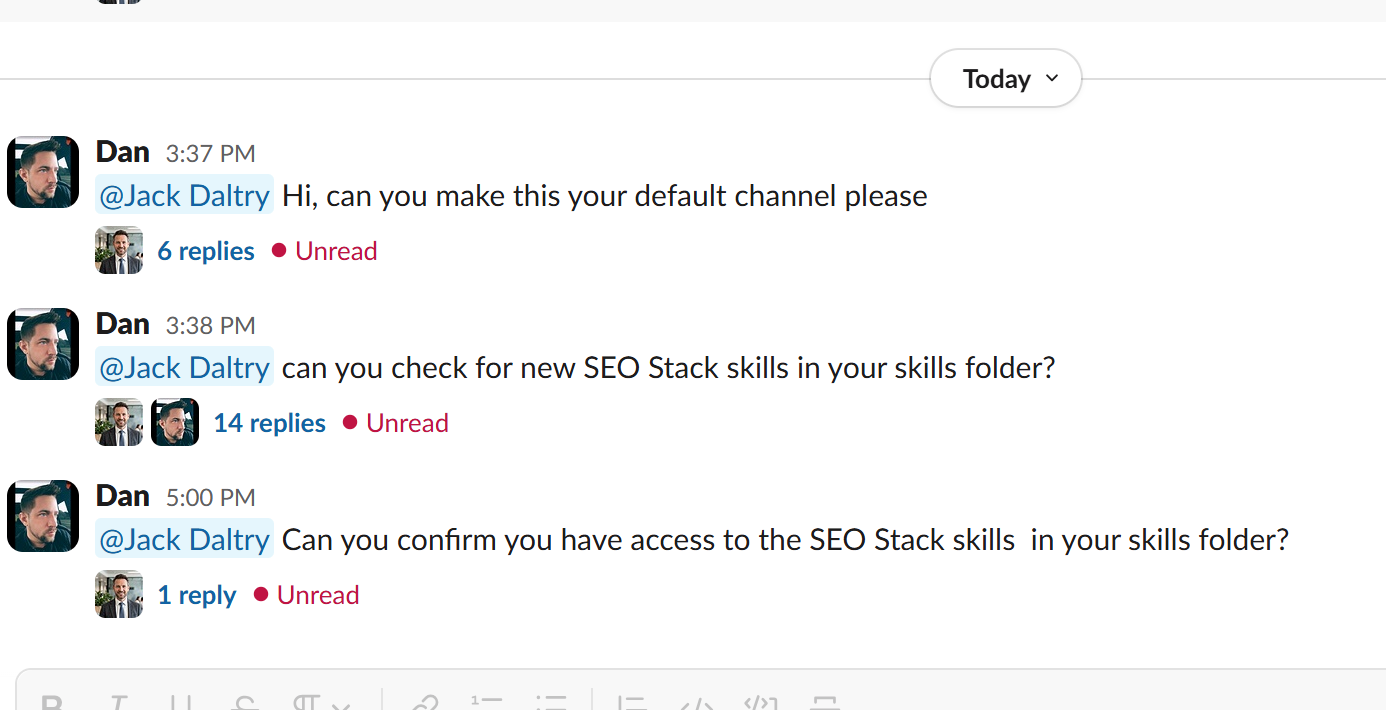
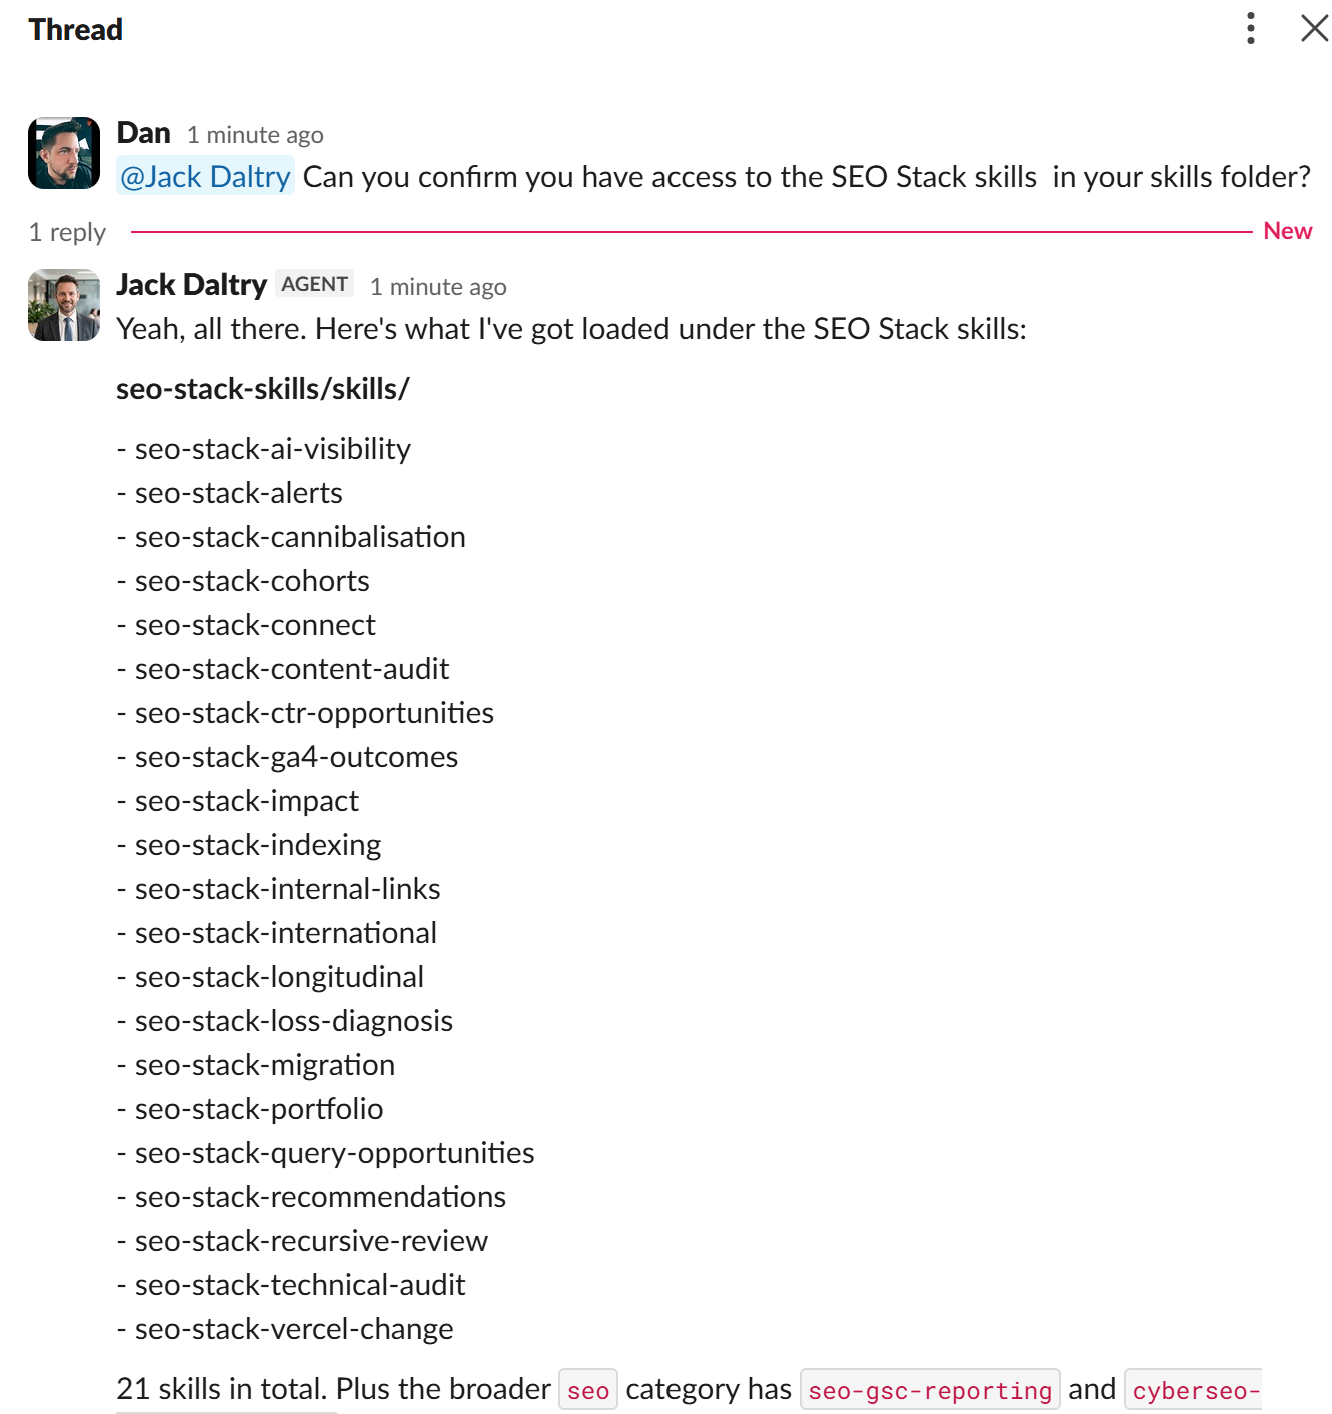
Y efectivamente, podía:
Así que ahora toca probar una de las skills; vamos a probar un LOSS DIAGNOSIS en uno de nuestros sitios de prueba.
No tiene gran cantidad de datos, pero podemos ver qué considera pérdida en base a las impresiones, que como se ve subieron y luego volvieron a caer:
Aquí está el sitio cybersecurity-seos.com en SEO Stack
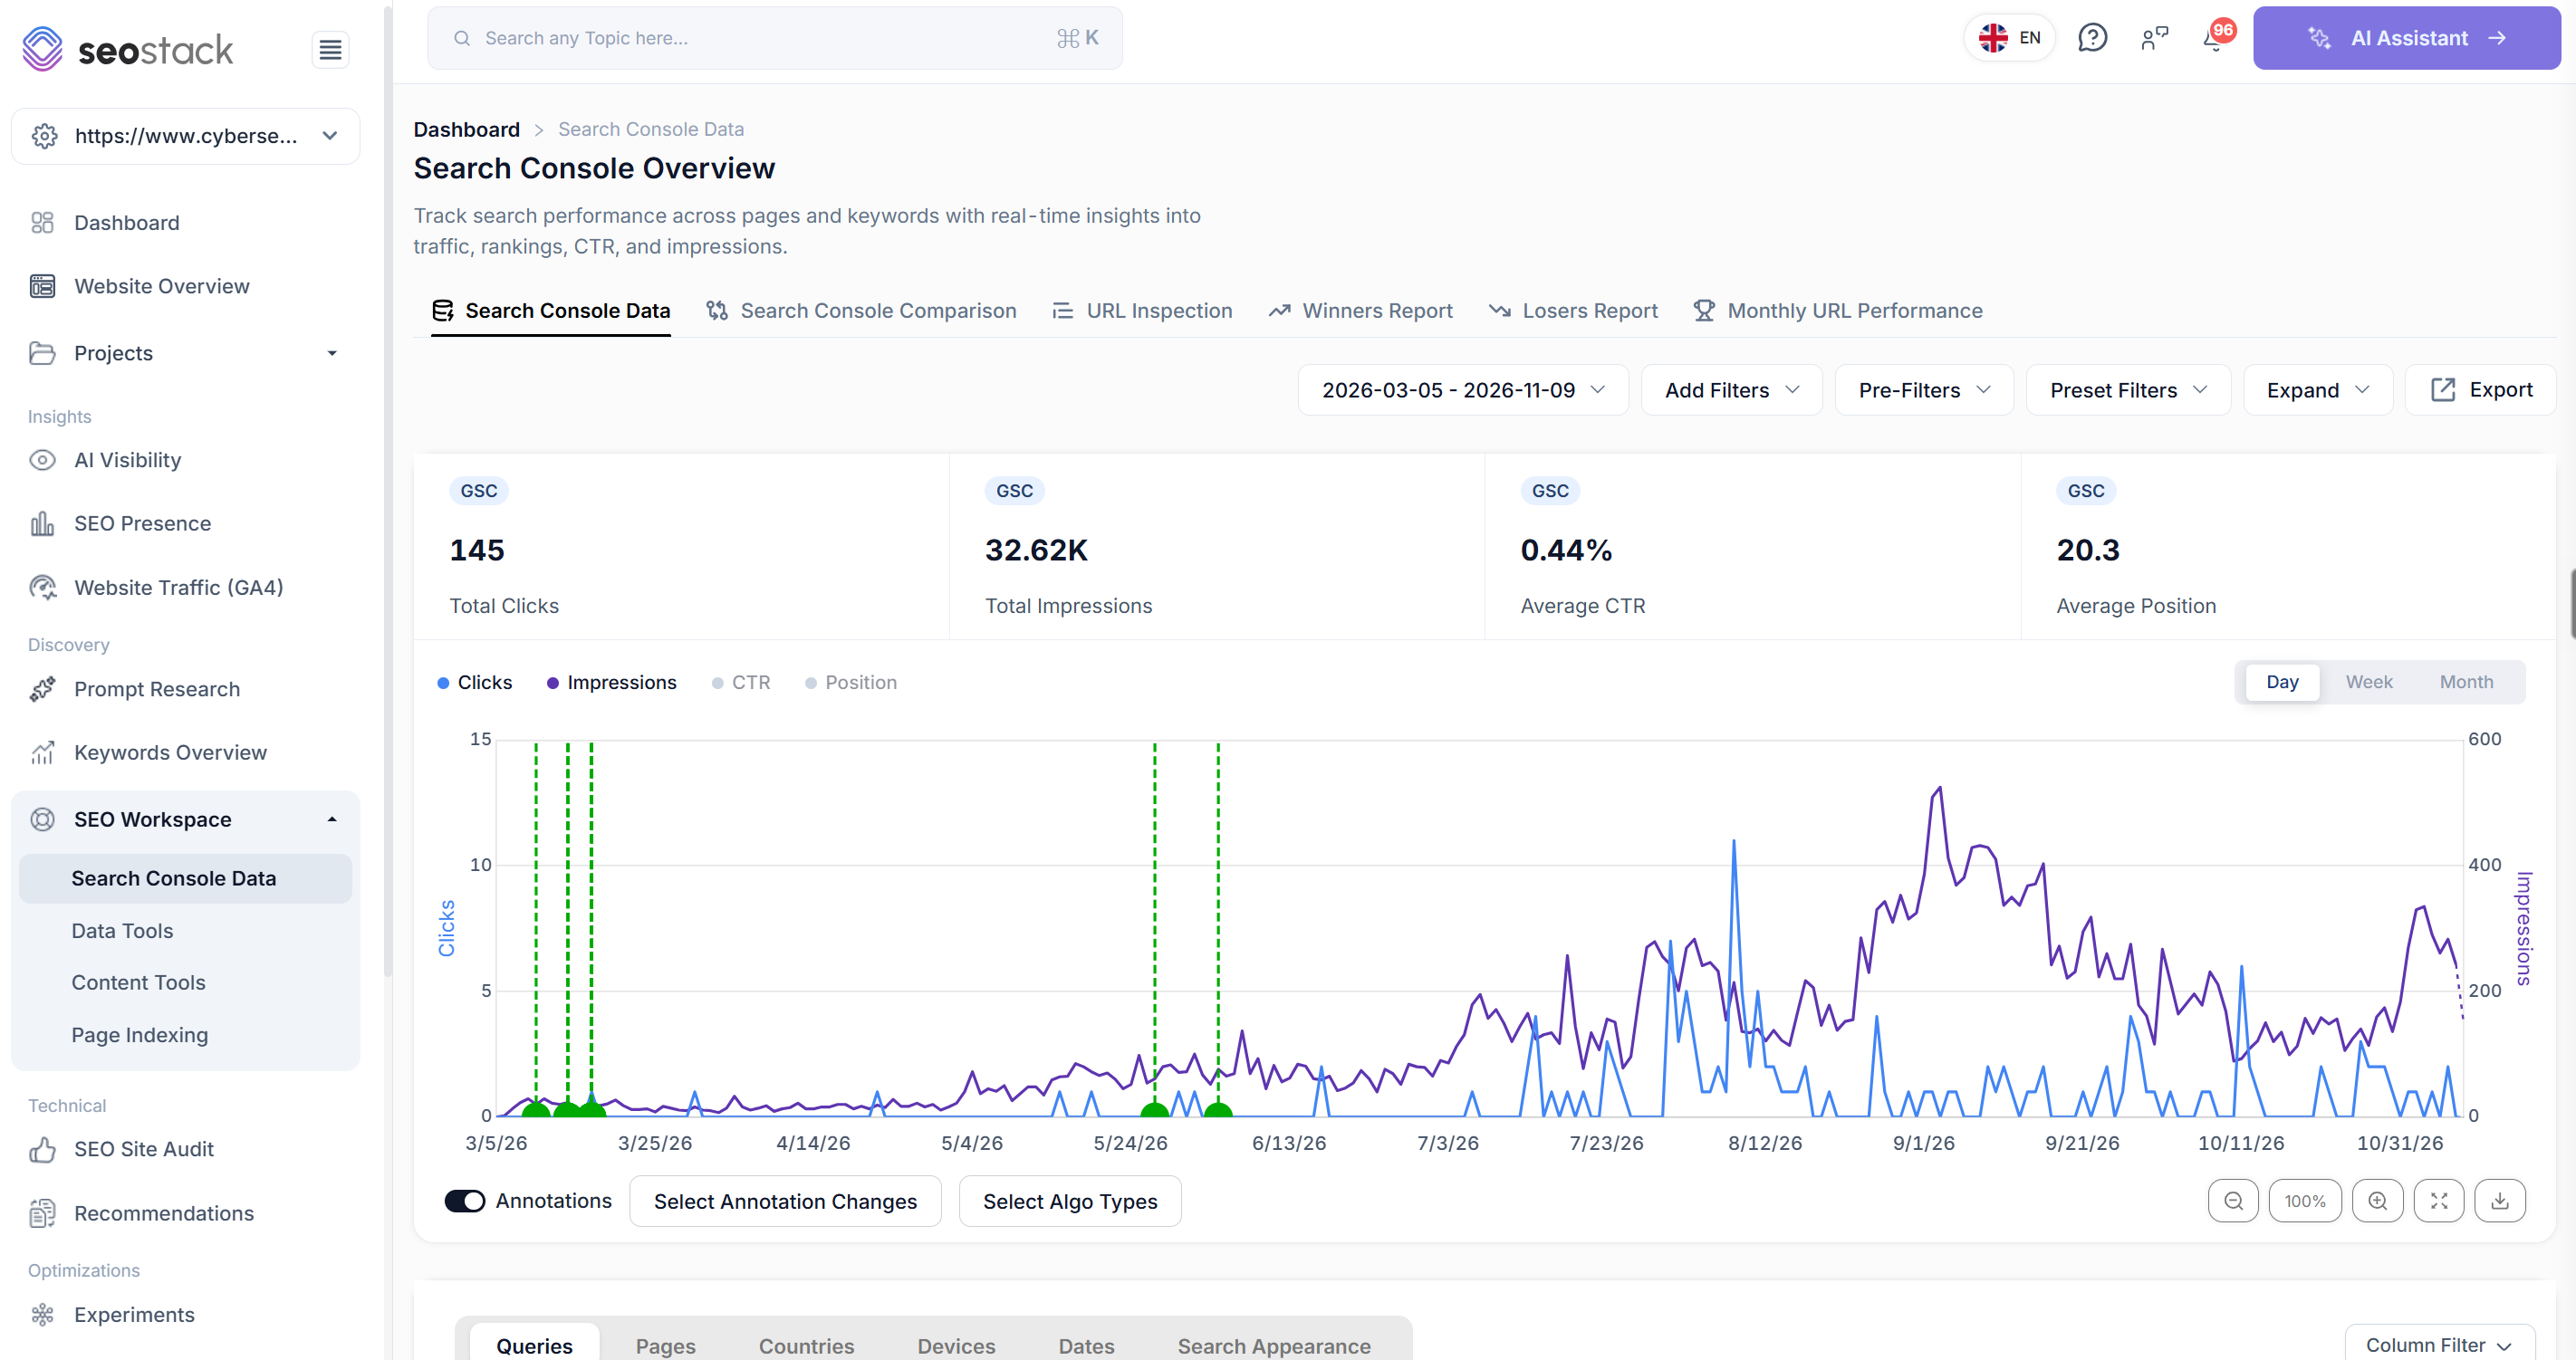
Lo que queremos es que el agente utilice sus nuevas skills para mejorar nuestro flujo de trabajo SEO.
Le pedí al agente que realizara el loss diagnosis del sitio web >
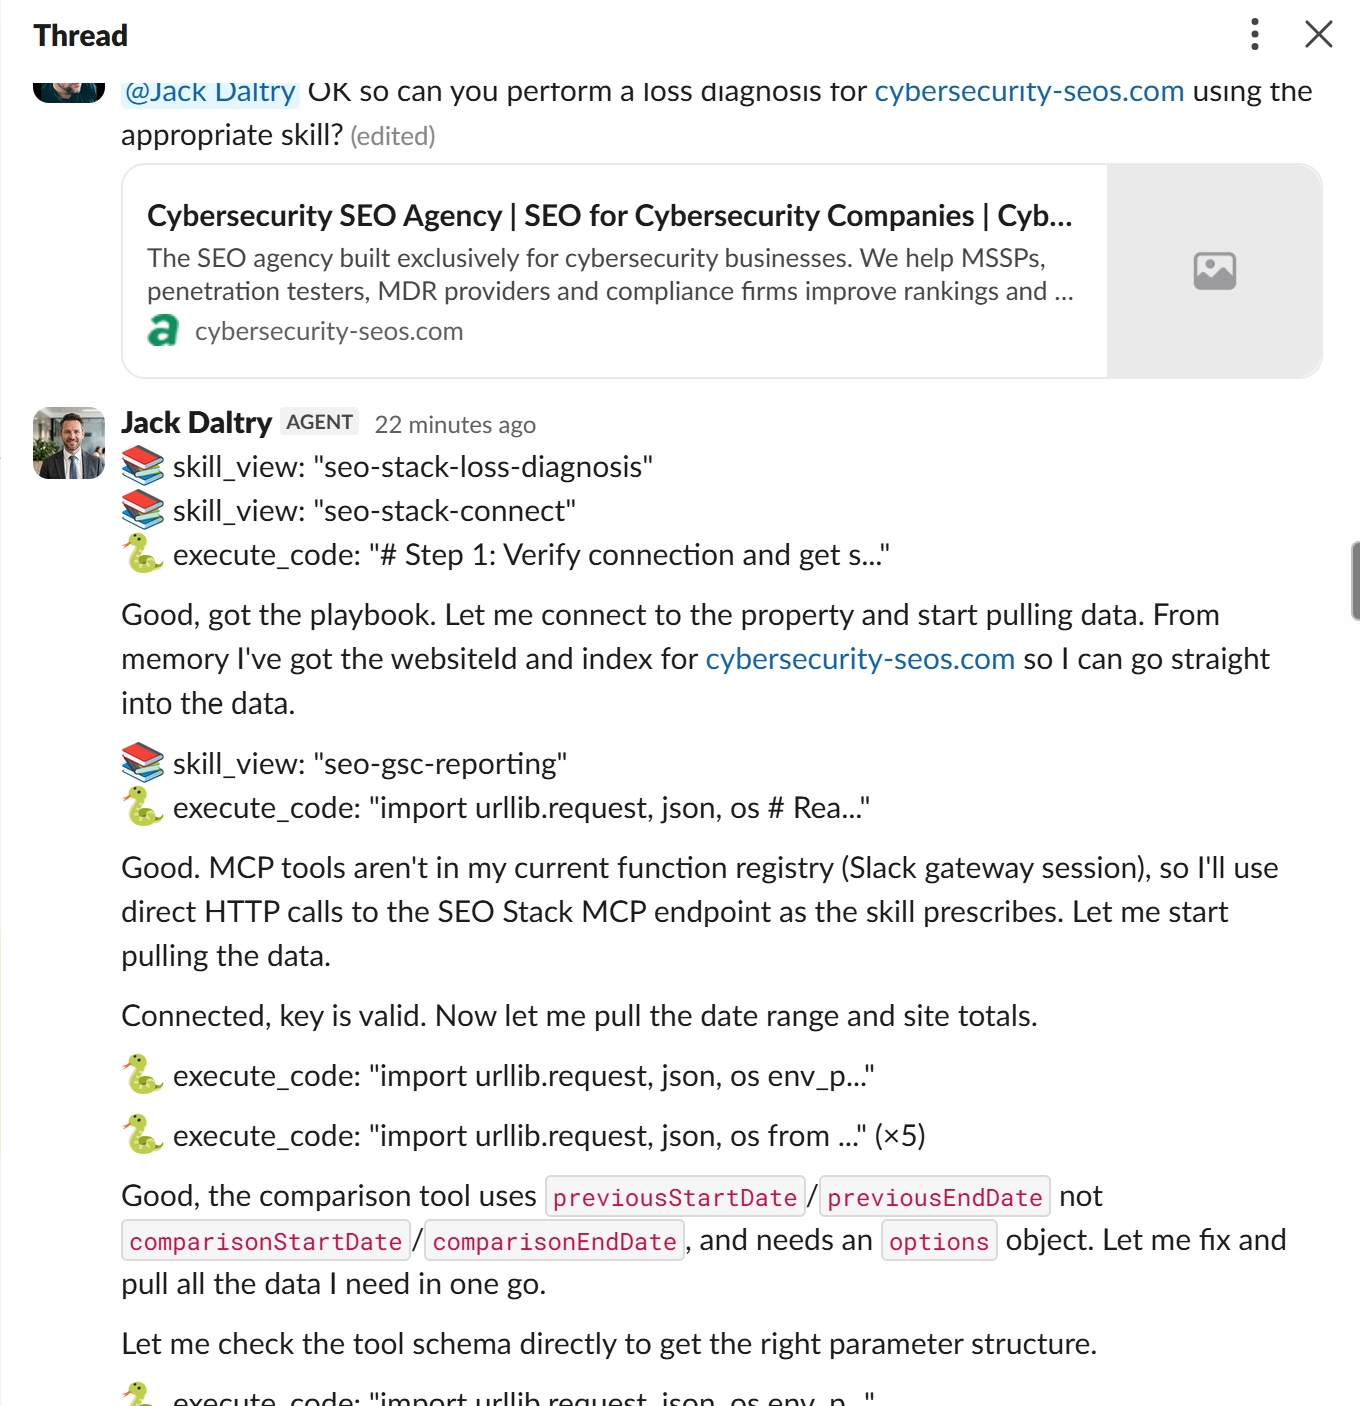
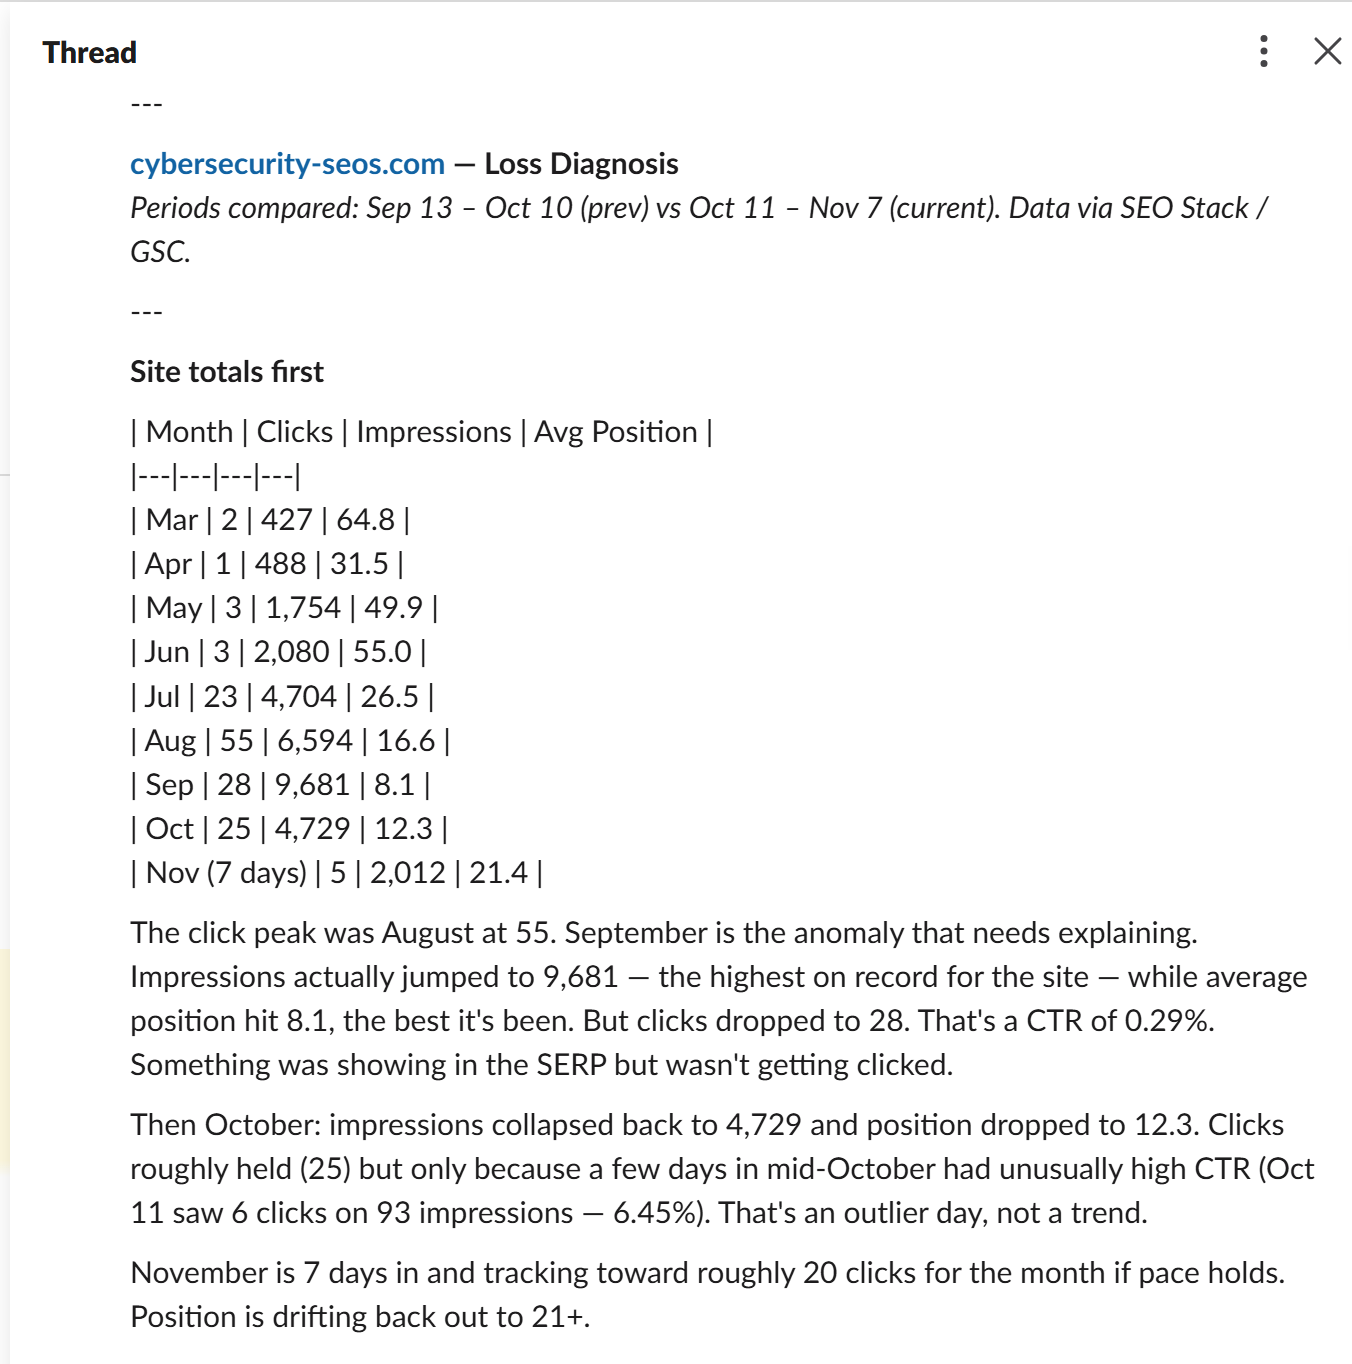
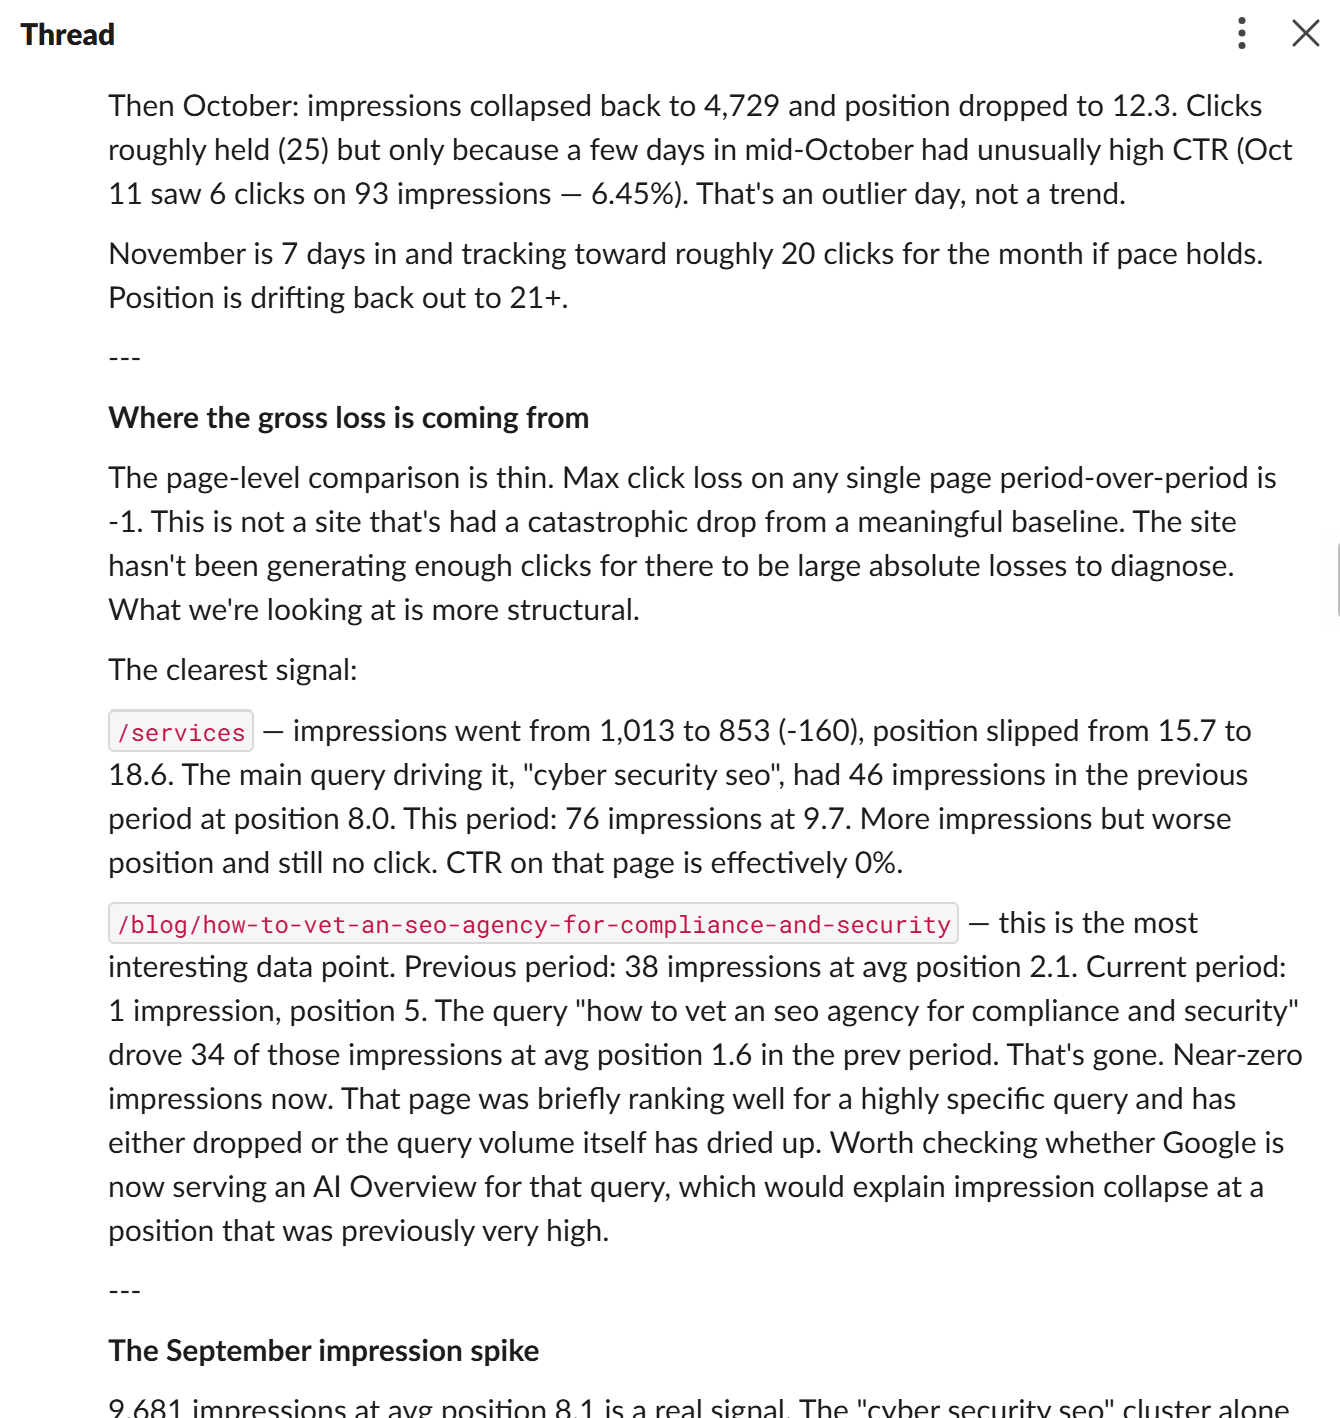
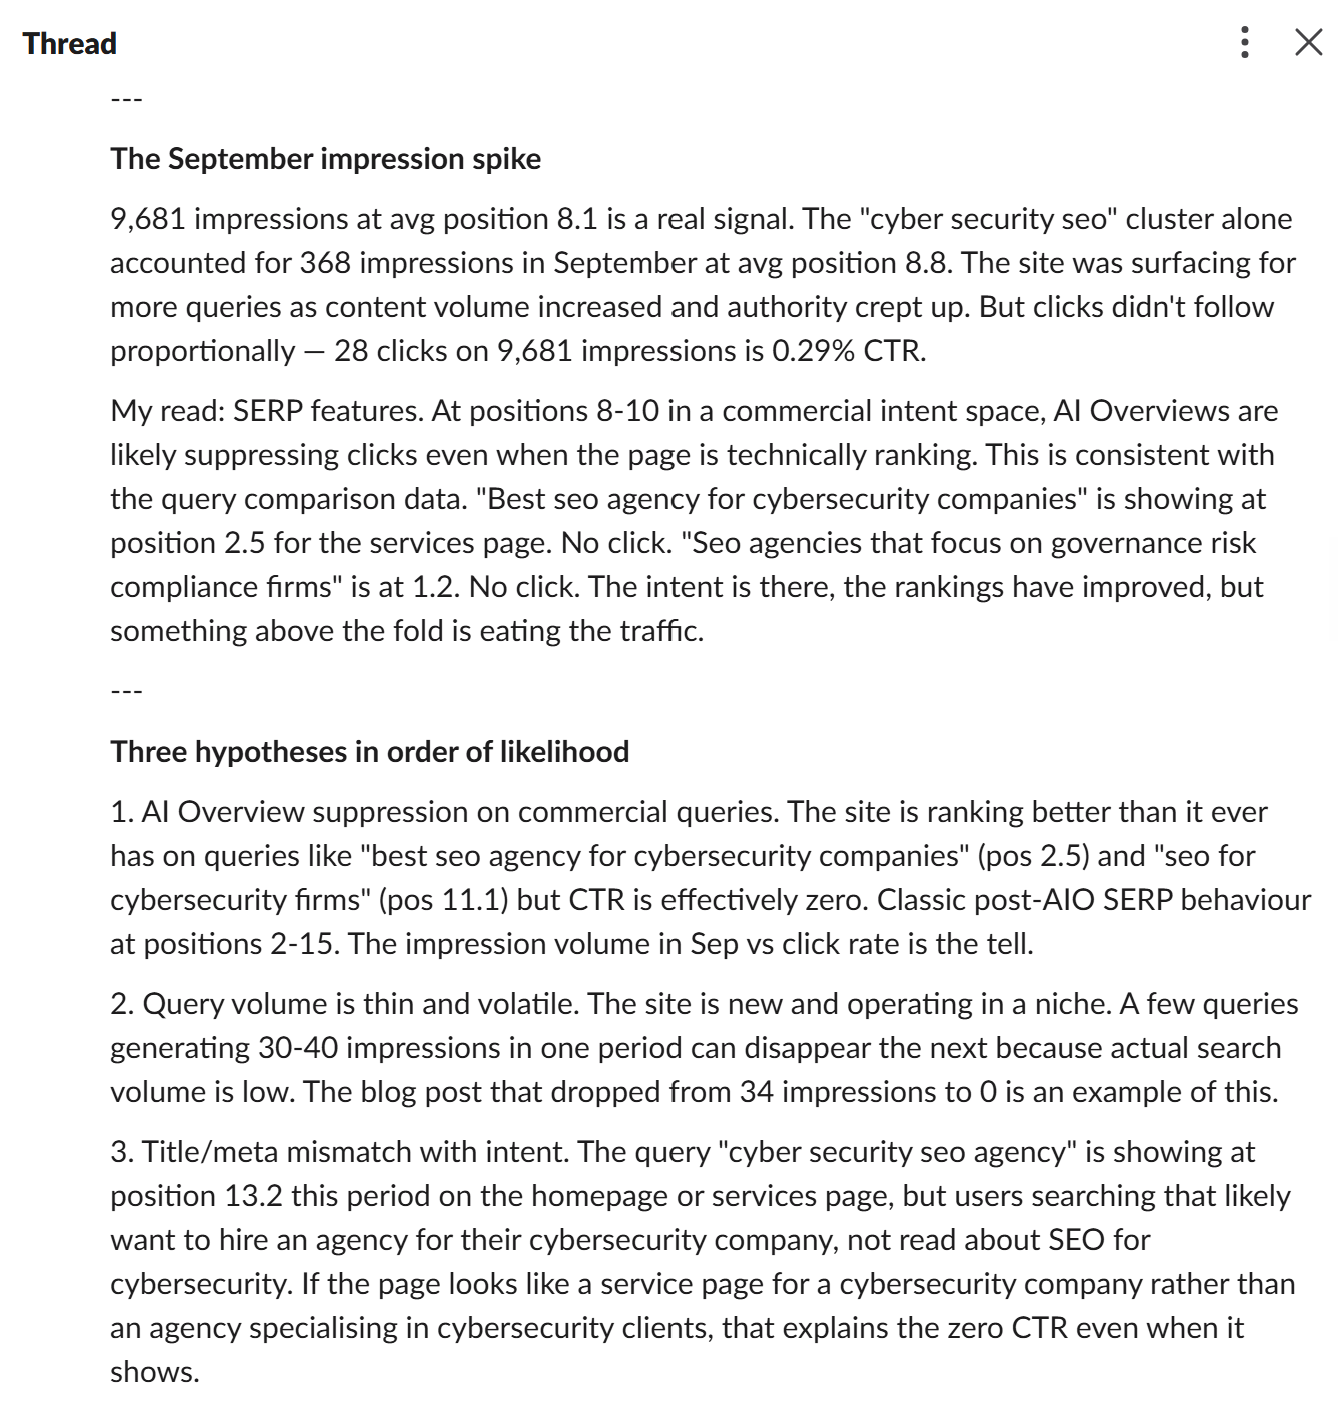
Así que ya ves que funciona. ¡ESTÁ VIVO!
Si no configuraste un agente de IA, puedes hacer la misma prueba allí donde lo hayas instalado, por ejemplo Claude Desktop
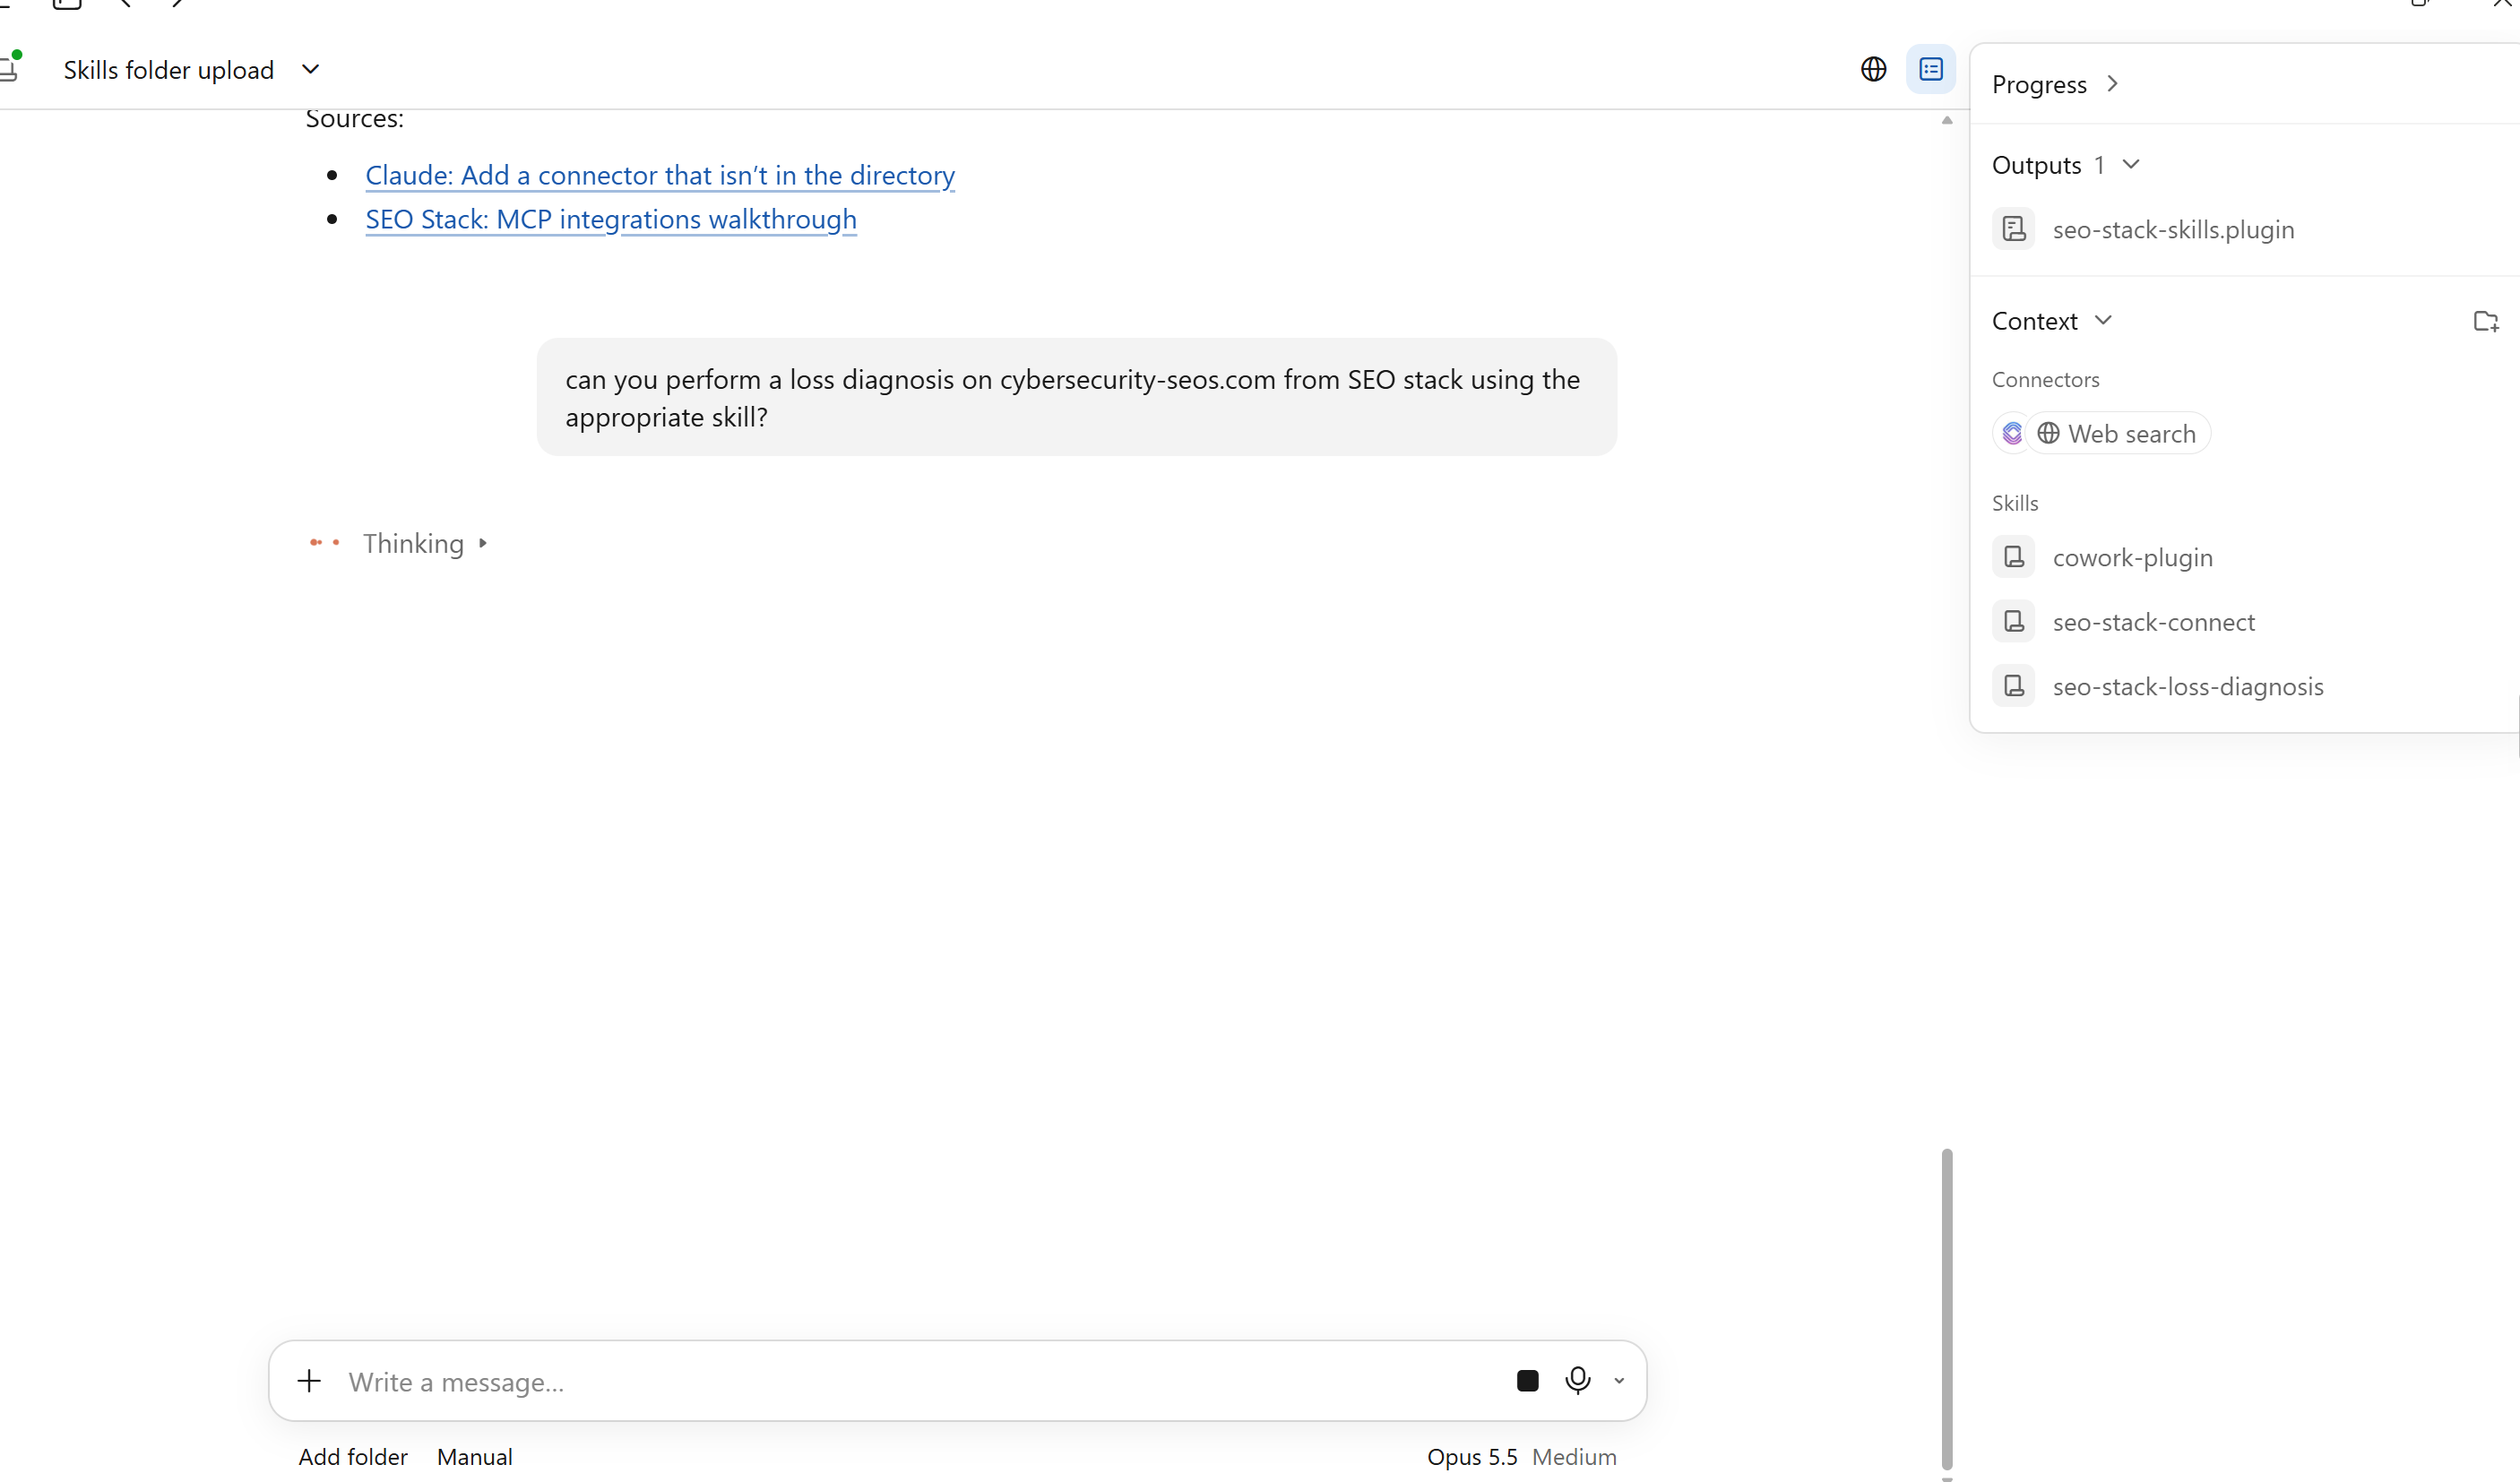
Cuando puedas ver los conectores y las skills, eso suele confirmar que se está usando SEO Stack junto con las skills de SEO correspondientes:
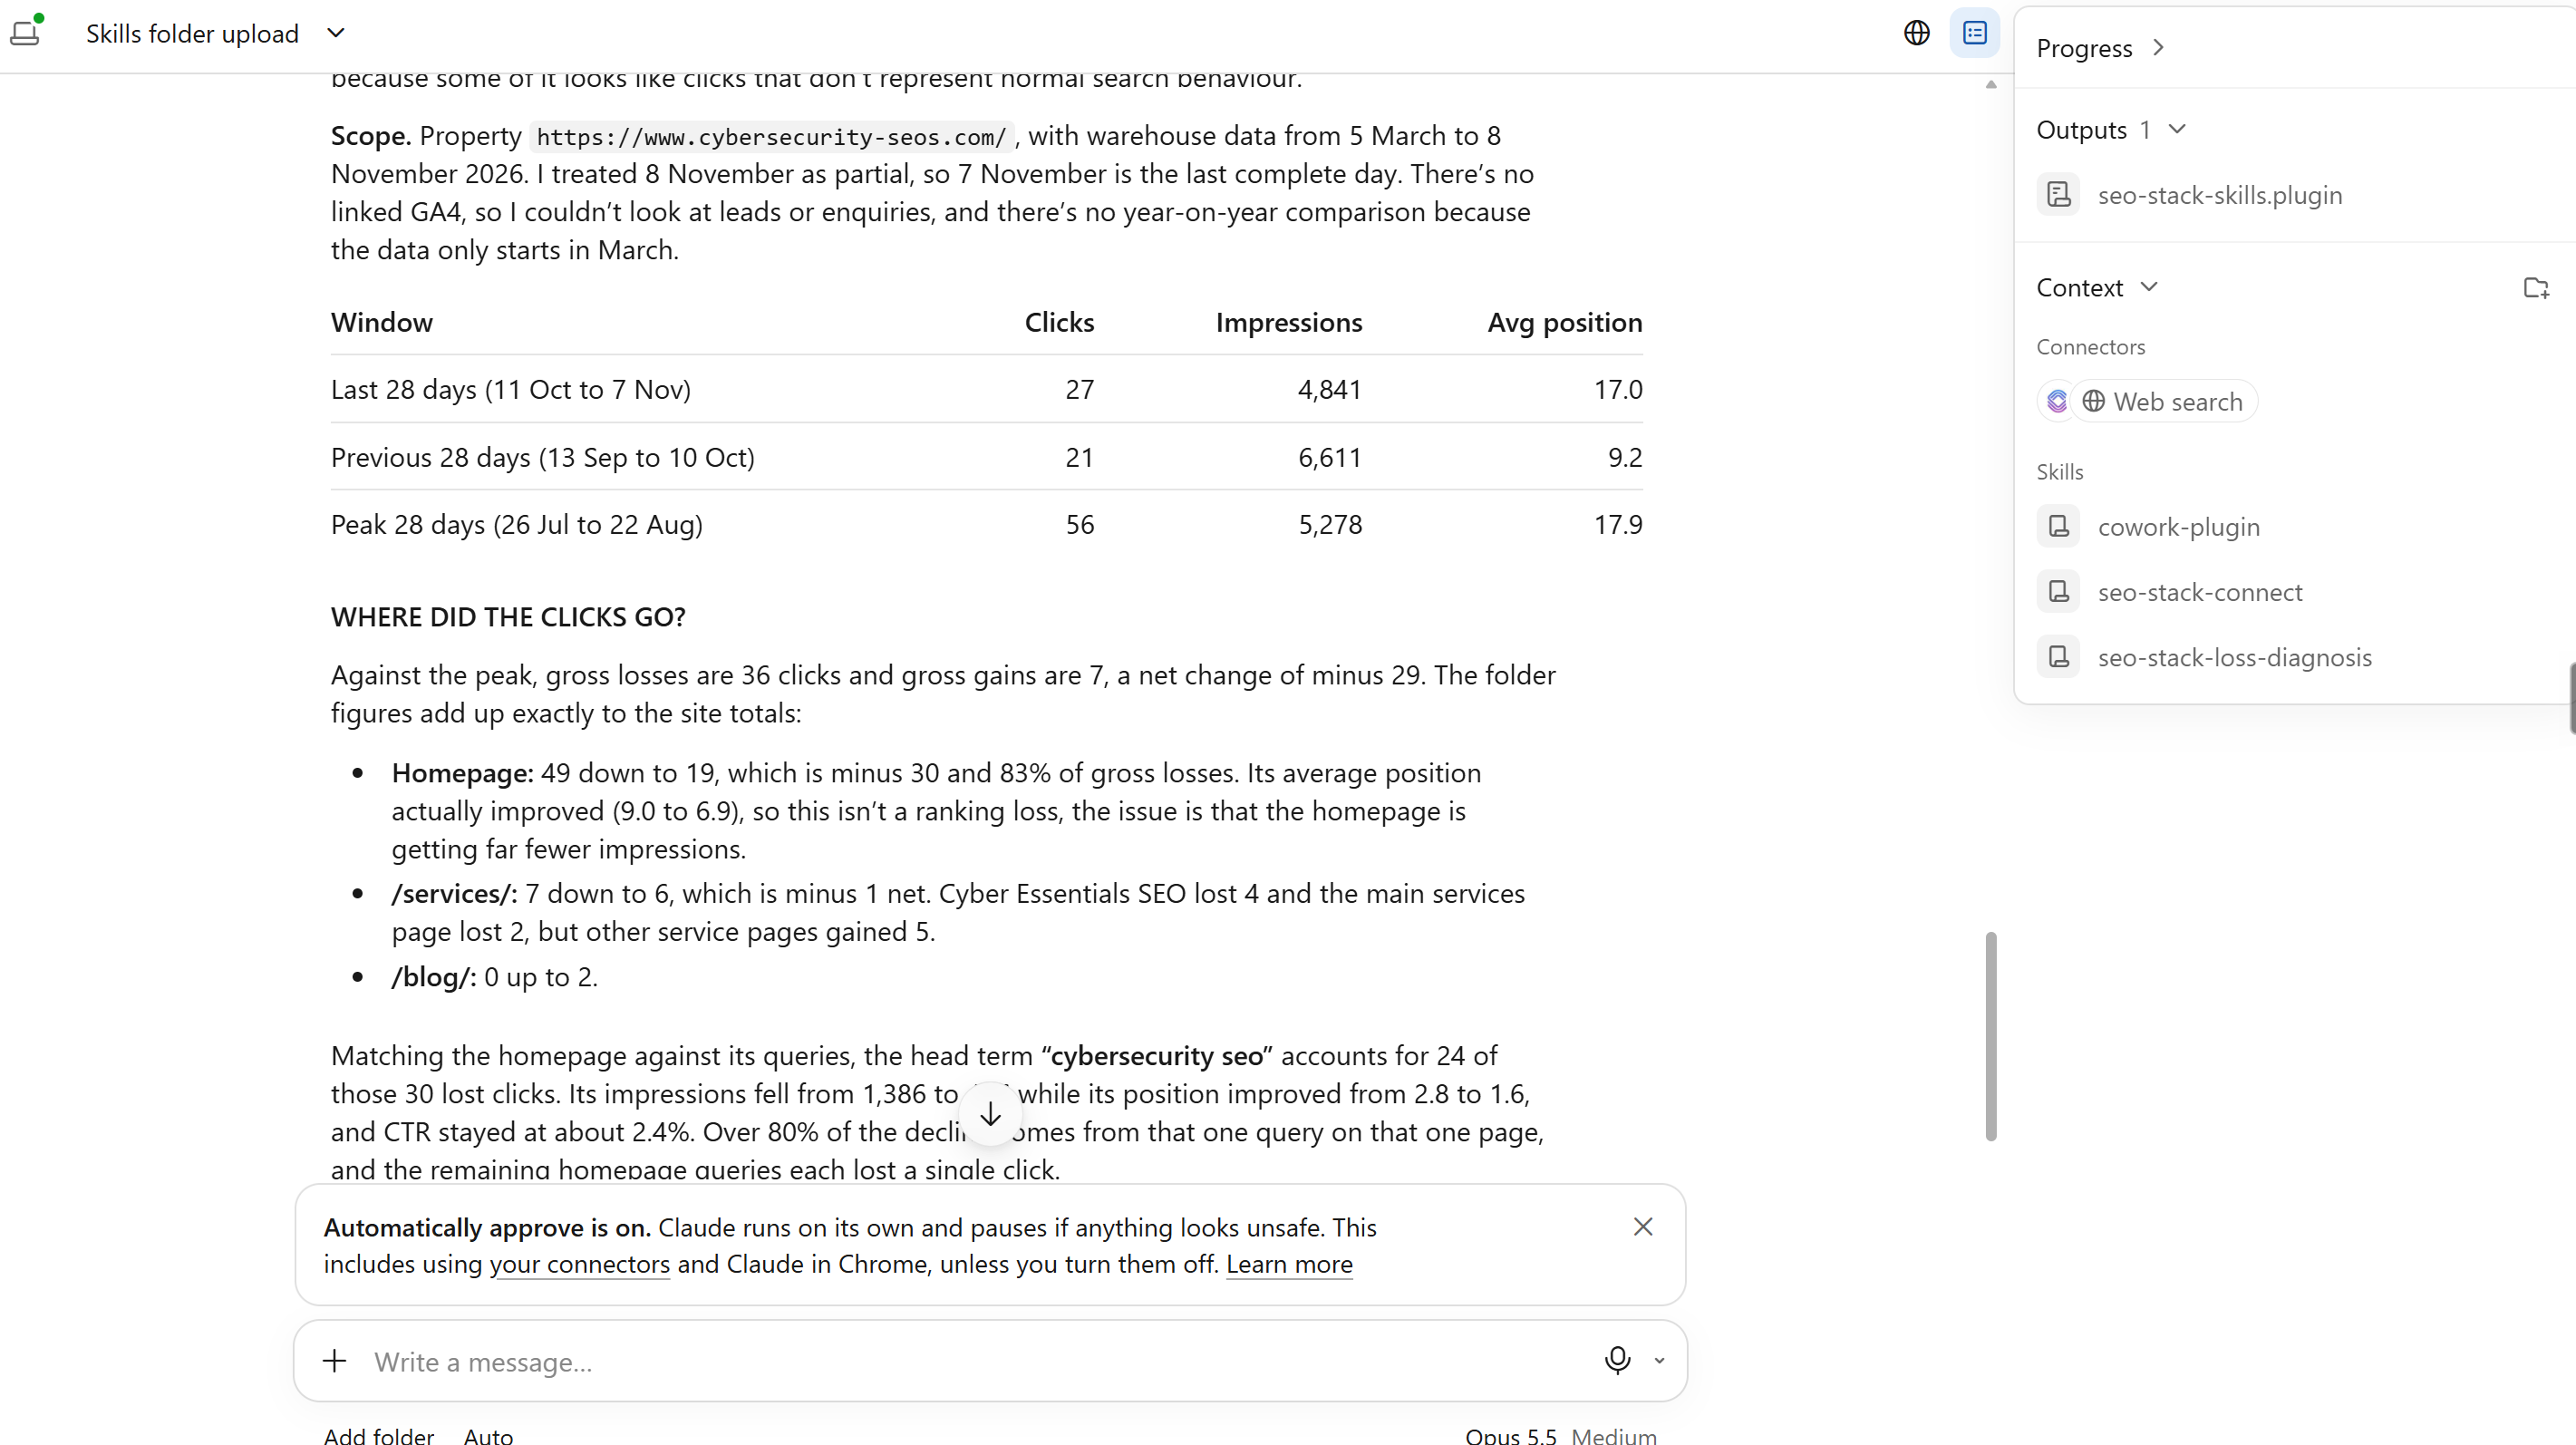
Con esto ya tenemos resuelto lo principal.
Lo siguiente es ver cómo enseñar al AI SEO Agent qué debe hacer de forma recurrente / mediante cron, y también podemos configurarlo para que tenga acceso al sitio web. Hasta dónde llegues con esto depende realmente de hasta dónde quieras llevar tus automatizaciones.
En los proyectos de pruebas SEO quería que los agentes literalmente LLEVARAN EL TIMÓN, es decir, total autonomía, para ver: ¿podría construir minisitios que los agentes de SEO con IA gestionen solos mientras yo me dedico a otras cosas?
Así que, si solo quieres montar un agente y darle acceso a SEO Stack con las skills de SEO, probablemente no necesites ir mucho más allá, salvo que quieras que el agente trabaje de forma autónoma; en ese caso tendrás que ENSEÑARLE y luego decidir si le das acceso al sitio web.
Paso 5: Enseñar a los agentes + darles un pack operativo/crons que ejecutar
Dar una skill a un agente de IA es una parte del proceso, pero también deberíamos darle a nuestros agentes una formación BASADA EN PROYECTOS donde además estipulemos cómo deben trabajar. Aquí empieza el aspecto PROYECTO > Formación. De nuevo, cómo lo configures varía bastante según el agente/plataforma de IA que uses; la mayoría de plataformas agénticas permiten establecer información a nivel de proyecto.
Lo que necesitamos entrenar en nuestro agente es el PROCESO: un cron que se ejecute y que el agente sepa cómo afrontar distintos escenarios, etc.
Por ejemplo, un agente debería saber que no puede hacer un cambio y al día siguiente, con datos limitados, hacer otro cambio (si se entiende lo que quiero decir); un agente necesita saber cómo manejar los datos, los contextos, etc.
Para ahorrarte el dolor de cabeza, voy a facilitar los archivos de proyecto descargables (tendrás que personalizarlos ligeramente), pero te darán el marco que necesitas.
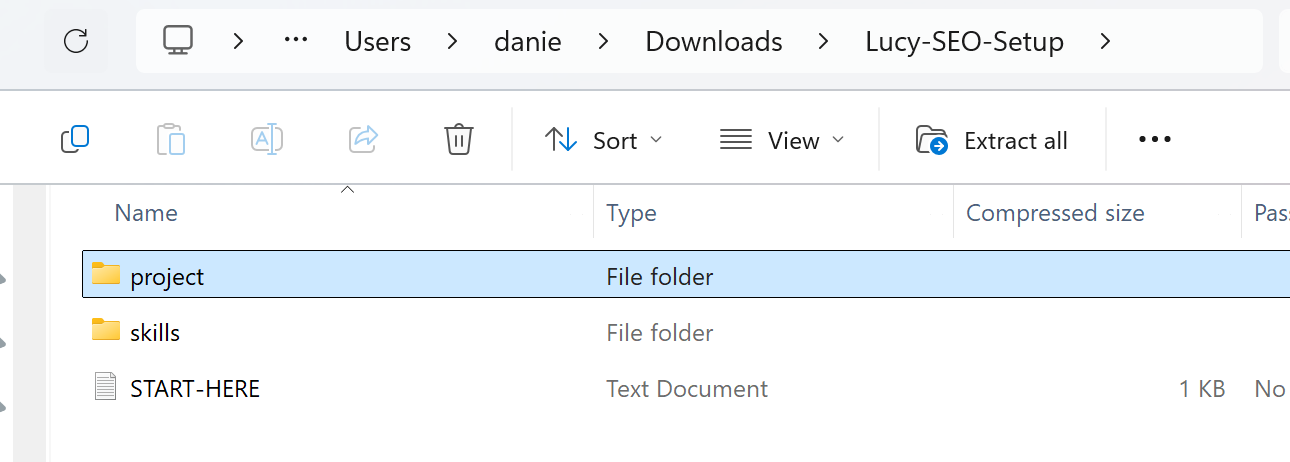
Así que PRIMERO tienes que descargar el pack del workflow/crons.
Descarga el Workflow / Cron Pack para tu agente de IA
Después, una vez descargado y antes de dárselo a tu agente, tienes que personalizarlo para que sea específico de tu web/proyecto.
Descárgalo y sigue las siguientes instrucciones:
Qué deben hacer los usuarios antes del primer uso
Descomprimir el pack y abrir
START-HERE.md. Dar al agente elegido acceso a la carpeta extraída. La guía incluye un prompt que pueden pegar en Hermes, Claude, OpenClaw u otro agente.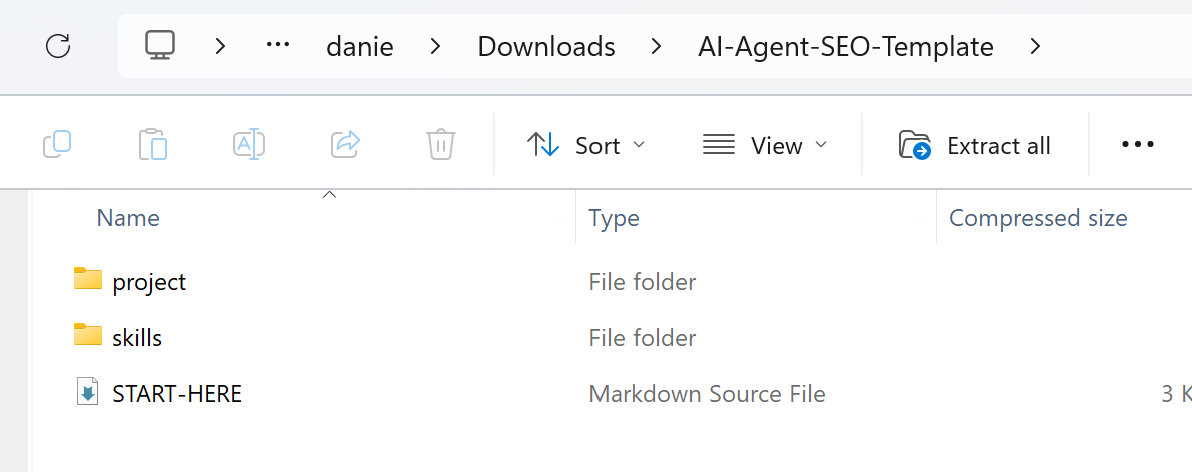
Personalizar un archivo,
project/SITE-PROFILE.md. Pueden editarlo ellos mismos o hacer que el agente les haga las preguntas y lo rellene. Deben aportar:Sitio web y límites: nombre del negocio, clave única del proyecto, URL canónica del sitio, hosts y rutas permitidos, y cualquier URL o sección a excluir.
Alcance comercial: qué venden, quién lo compra, productos o servicios prioritarios, países e idiomas objetivo, y temas fuera del encargo.
URLs de partida: las páginas que quieren priorizar, o la instrucción «Descubrir desde el sitemap dentro del alcance».
Criterios de éxito: qué cuenta como un resultado orgánico relevante, como una consulta cualificada, una cita reservada o un pedido pagado. Incluye el evento de seguimiento si se conoce y comprueba la zona horaria del programador, que por defecto es
Europe/London.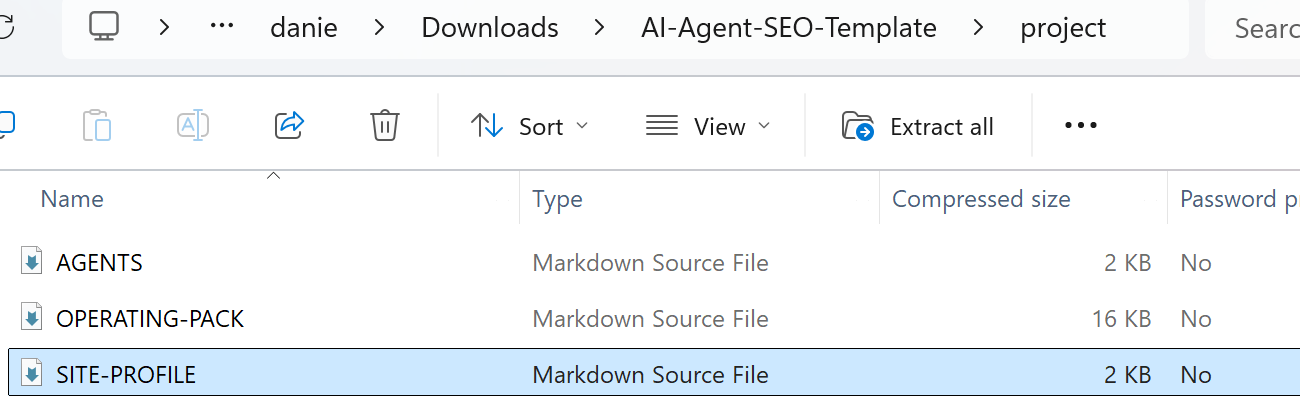
Ahora, copia el sistema de archivos dentro del sistema de archivos / carpeta de tu agente. Esto dependerá del agente que hayas usado; por ejemplo, con HERMES lo copiarías en el directorio principal de HERMES, es decir, C:\Users\Administrator\AppData\Local\hermes, pero dónde pongas los archivos depende realmente del agente que elijas
Ahora tienes que pedirle a tu agente que lea los archivos / la carpeta del proyecto y que configure todas las tareas/crons correspondientes. Aquí es donde el agente empezará a formar su memoria y donde entenderá el contexto del workflow
Conecta SEO Stack y ejecuta la comprobación de solo lectura. El agente debería devolver la propiedad a la que accedió, las fechas que analizó y URLs reales dentro del alcance con clics e impresiones. Los usuarios pueden verificar el sitio y el alcance antes de activar los trabajos recurrentes.
Es MUY IMPORTANTE asegurarse de que el agente de IA entiende la carpeta del proyecto y de que es capaz de conectar las skills de SEO Stack con los requisitos / workflow del proyecto. Para la autonomía SEO necesitas:
Que el agente de IA tenga acceso a todo lo que necesita para el análisis de datos (el MCP de SEO Stack es clave, pero puedes conectar el MCP de AHREFS para análisis de competencia / extracción de datos de SERP, etc.)
Que el agente de IA entienda el alcance del trabajo, la autonomía y el aprendizaje recursivo; también debe entender un workflow / cron que le indique cuándo hacer un cambio y cuánto esperar antes de reevaluar
Que el agente de IA tenga una visión completa de lo que está mirando, lo que puede hacer y qué skills tiene disponibles, para poder usarlas al ejecutar el cron, ya sea análisis, auditoría, identificación, reporting o implementación / creación de contenido, etc.
Paso 6: Poner en marcha los agentes + darles más capacidades
Hay una cosa que recomendaría encarecidamente a cualquier SEO que use IA para automatizaciones, y es lo siguiente:
Mete a tu agente de IA en SLACK o WhatsApp: quieres poder comunicarte con tu agente de IA y recibir actualizaciones en tiempo real
Dale a tu agente de IA otros poderes: por ejemplo, si usas Hermes puedes configurar el correo electrónico con Himalaya, algo genial si quieres automatizar correos salientes para, digamos, actualizaciones de trabajo o de clientes, prospección, etc.
¿Te sientes cómodo dándole a un agente de IA acceso al sitio web? Si lo haces, puedes convertir un proyecto SEO en uno autónomo. No lo recomendaría para sitios de clientes salvo que haya barreras de seguridad estrictas, pero para tus propios sitios de hobby, sitios de rank and rent, afiliación, etc., es una forma estupenda de acelerar el SEO
Recuerda: puedes pedirle a tu agente que ejecute crons y que configure eventos concretos a horas concretas.
Por ejemplo, yo quería que mi agente SEO de IA:
Ejecutara un cron para auditoría y análisis
Ejecutara un cron para estrategia y flujo de trabajo
Ejecutara un cron para ejecución/implementación SEO
Ejecutara un cron para informes SEO (vía SLACK)
De nuevo, estoy usando HERMES AGENT + Claude Sonnet + la app de SLACK para poder hablar y comunicarme con el agente; puedo asignarle tareas, crons y más desde dentro de SLACK >
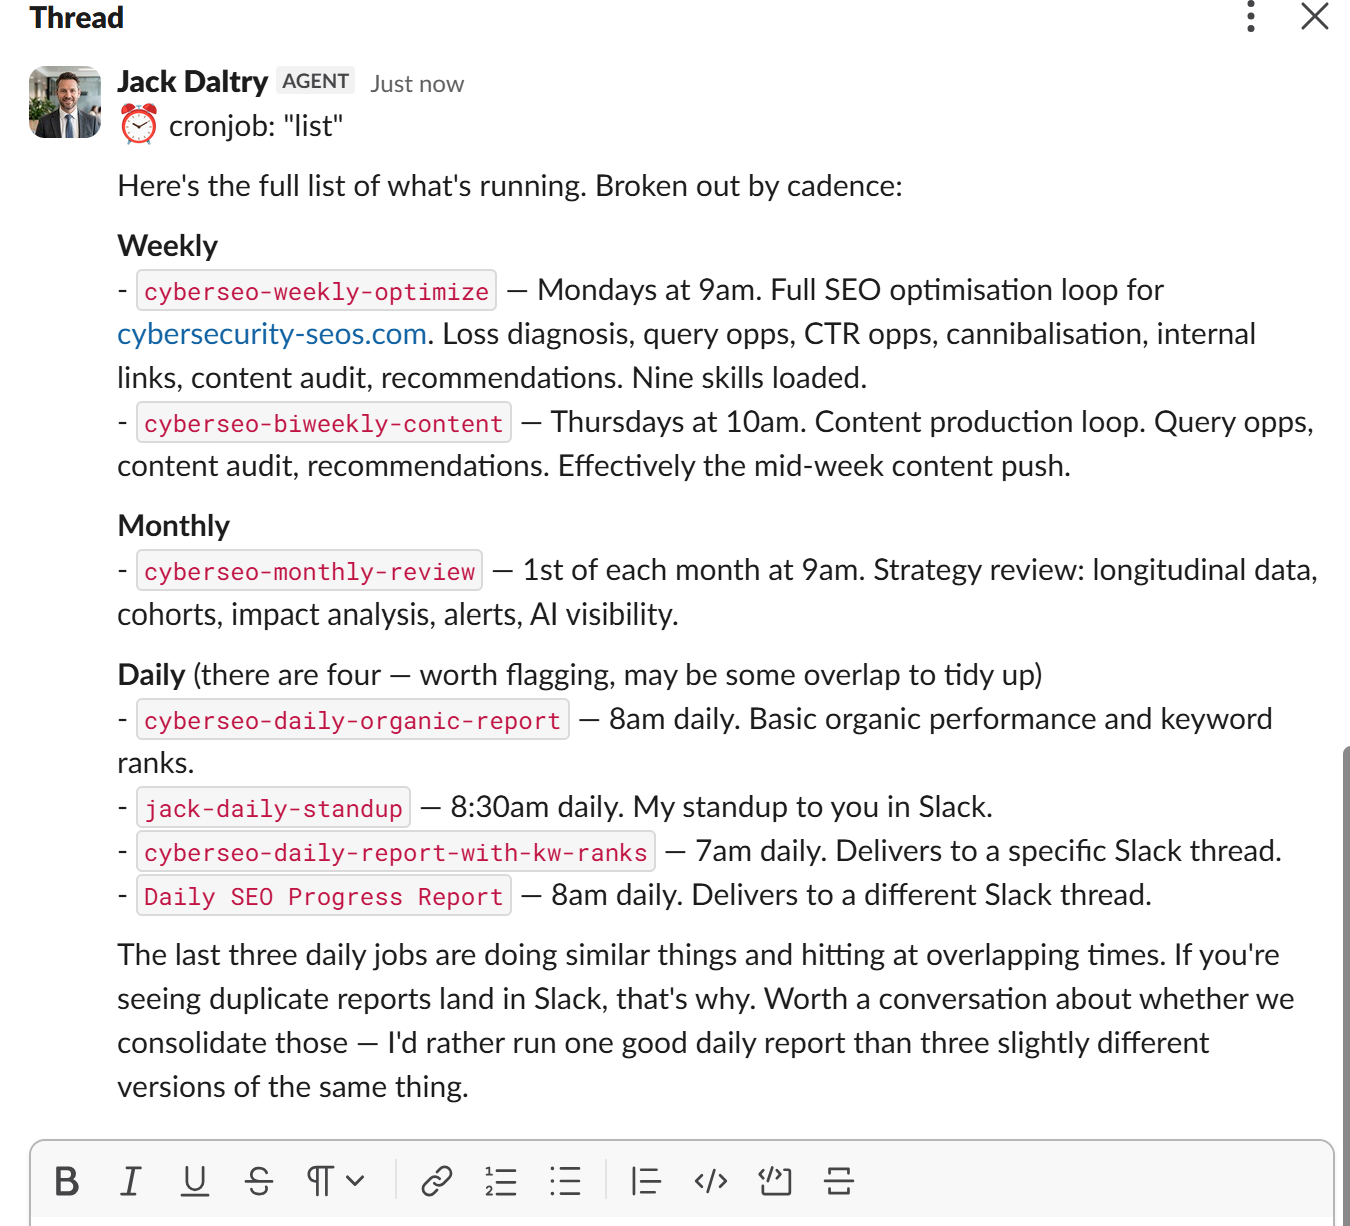
Después configuré crons para los informes y, como SEO Stack admite GSC + GA4 + AI Visibility, mis agentes pueden literalmente informar sobre todo.
Así que, si quieres que tu agente SEO de IA te informe sobre:
Rankings
Anotaciones del sitio web
Cambios de ranking e impacto en impresiones, clics, CTR y posición
Resultados de experimentos
Interacción en GA4
AI Visibility
Puedes conseguirlo todo de forma rápida y sencilla.
Paso 7: Hacer el SEO más autónomo con agentes de IA que despliegan cambios
Una de las cosas que hice mientras aprendía y adoptaba la IA fue trastear con el vibe coding de sitios web. Mi arma preferida es Claude Code + Git + Vercel. Puedes crear sitios web con vibe coding en Claude Code de forma rápida y sencilla, puedes desplegar en Vercel y puedes hacer que Claude Code construya una API de back end que permita a agentes como Hermes conectarse al sitio web y enviar cambios directamente.
Es DIVERTIDO y emocionante saber que un agente de IA tiene literalmente autonomía total: el agente puede analizar datos, generar contenido, desplegar directamente en un sitio web, ejecutar experimentos, comparar cambios con referencias y mucho más usando el MCP de SEO Stack.
Mi agente SEO de IA, Jack, trabaja en el sitio web de Cybersecurity SEOs y hace despliegues con regularidad >
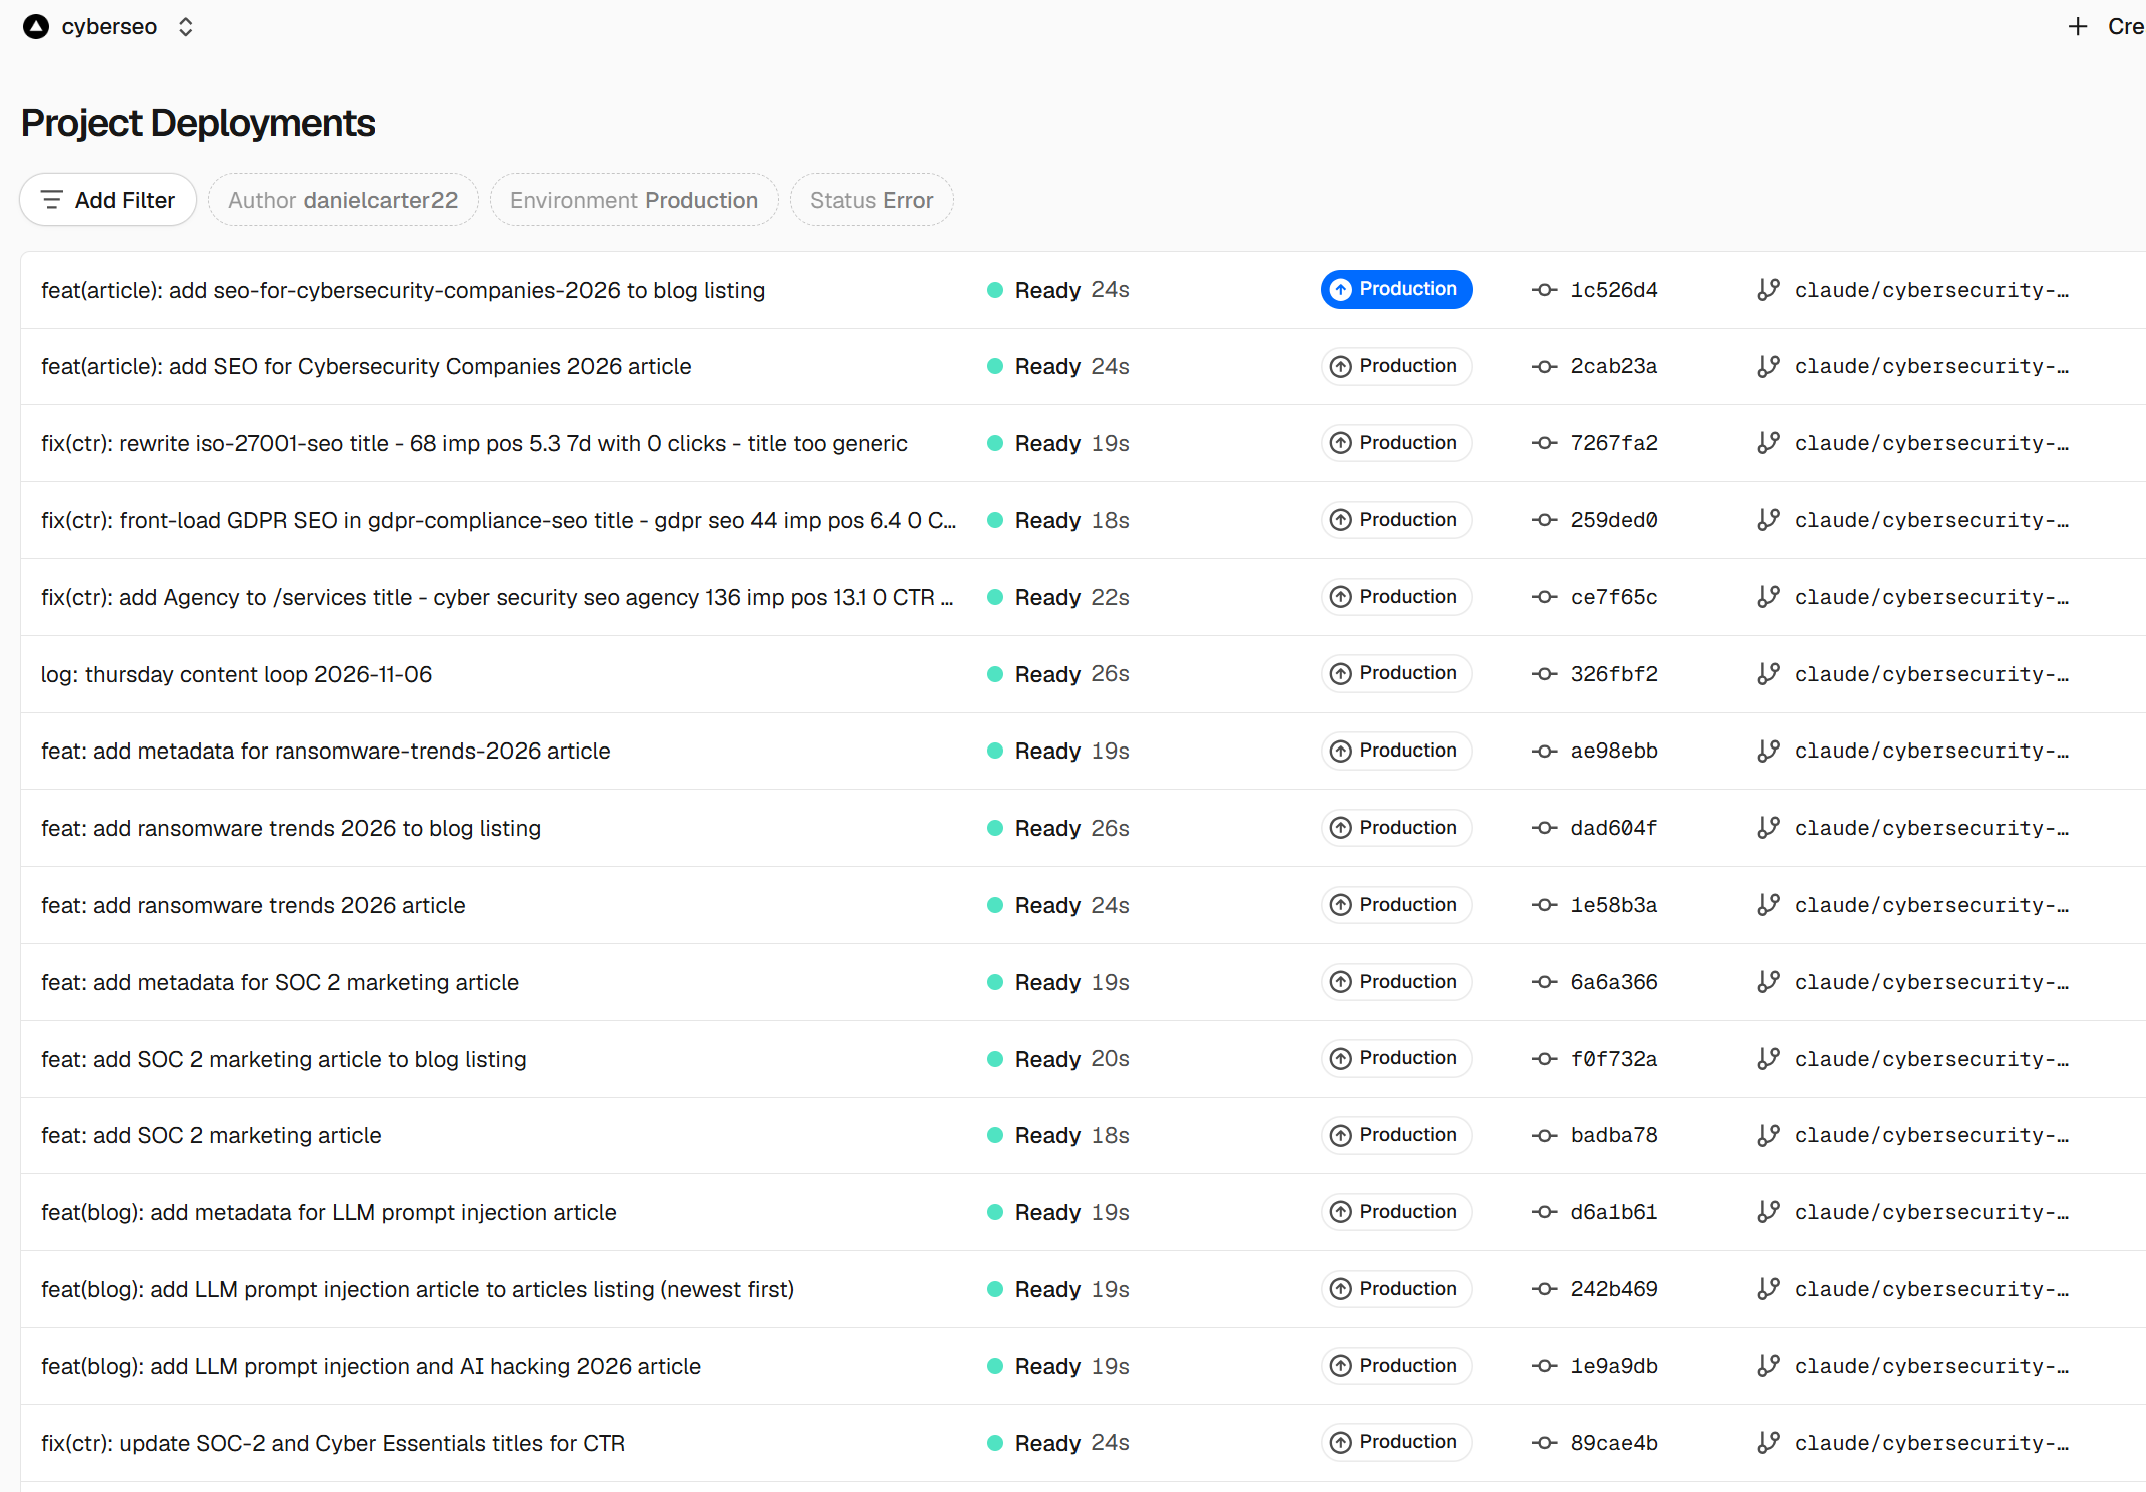
Con el agente de IA conseguimos lograr algunos resultados; por ejemplo, en Google llegamos al puesto nº1 para Cybersecurity SEO y para un montón de otros términos relevantes >
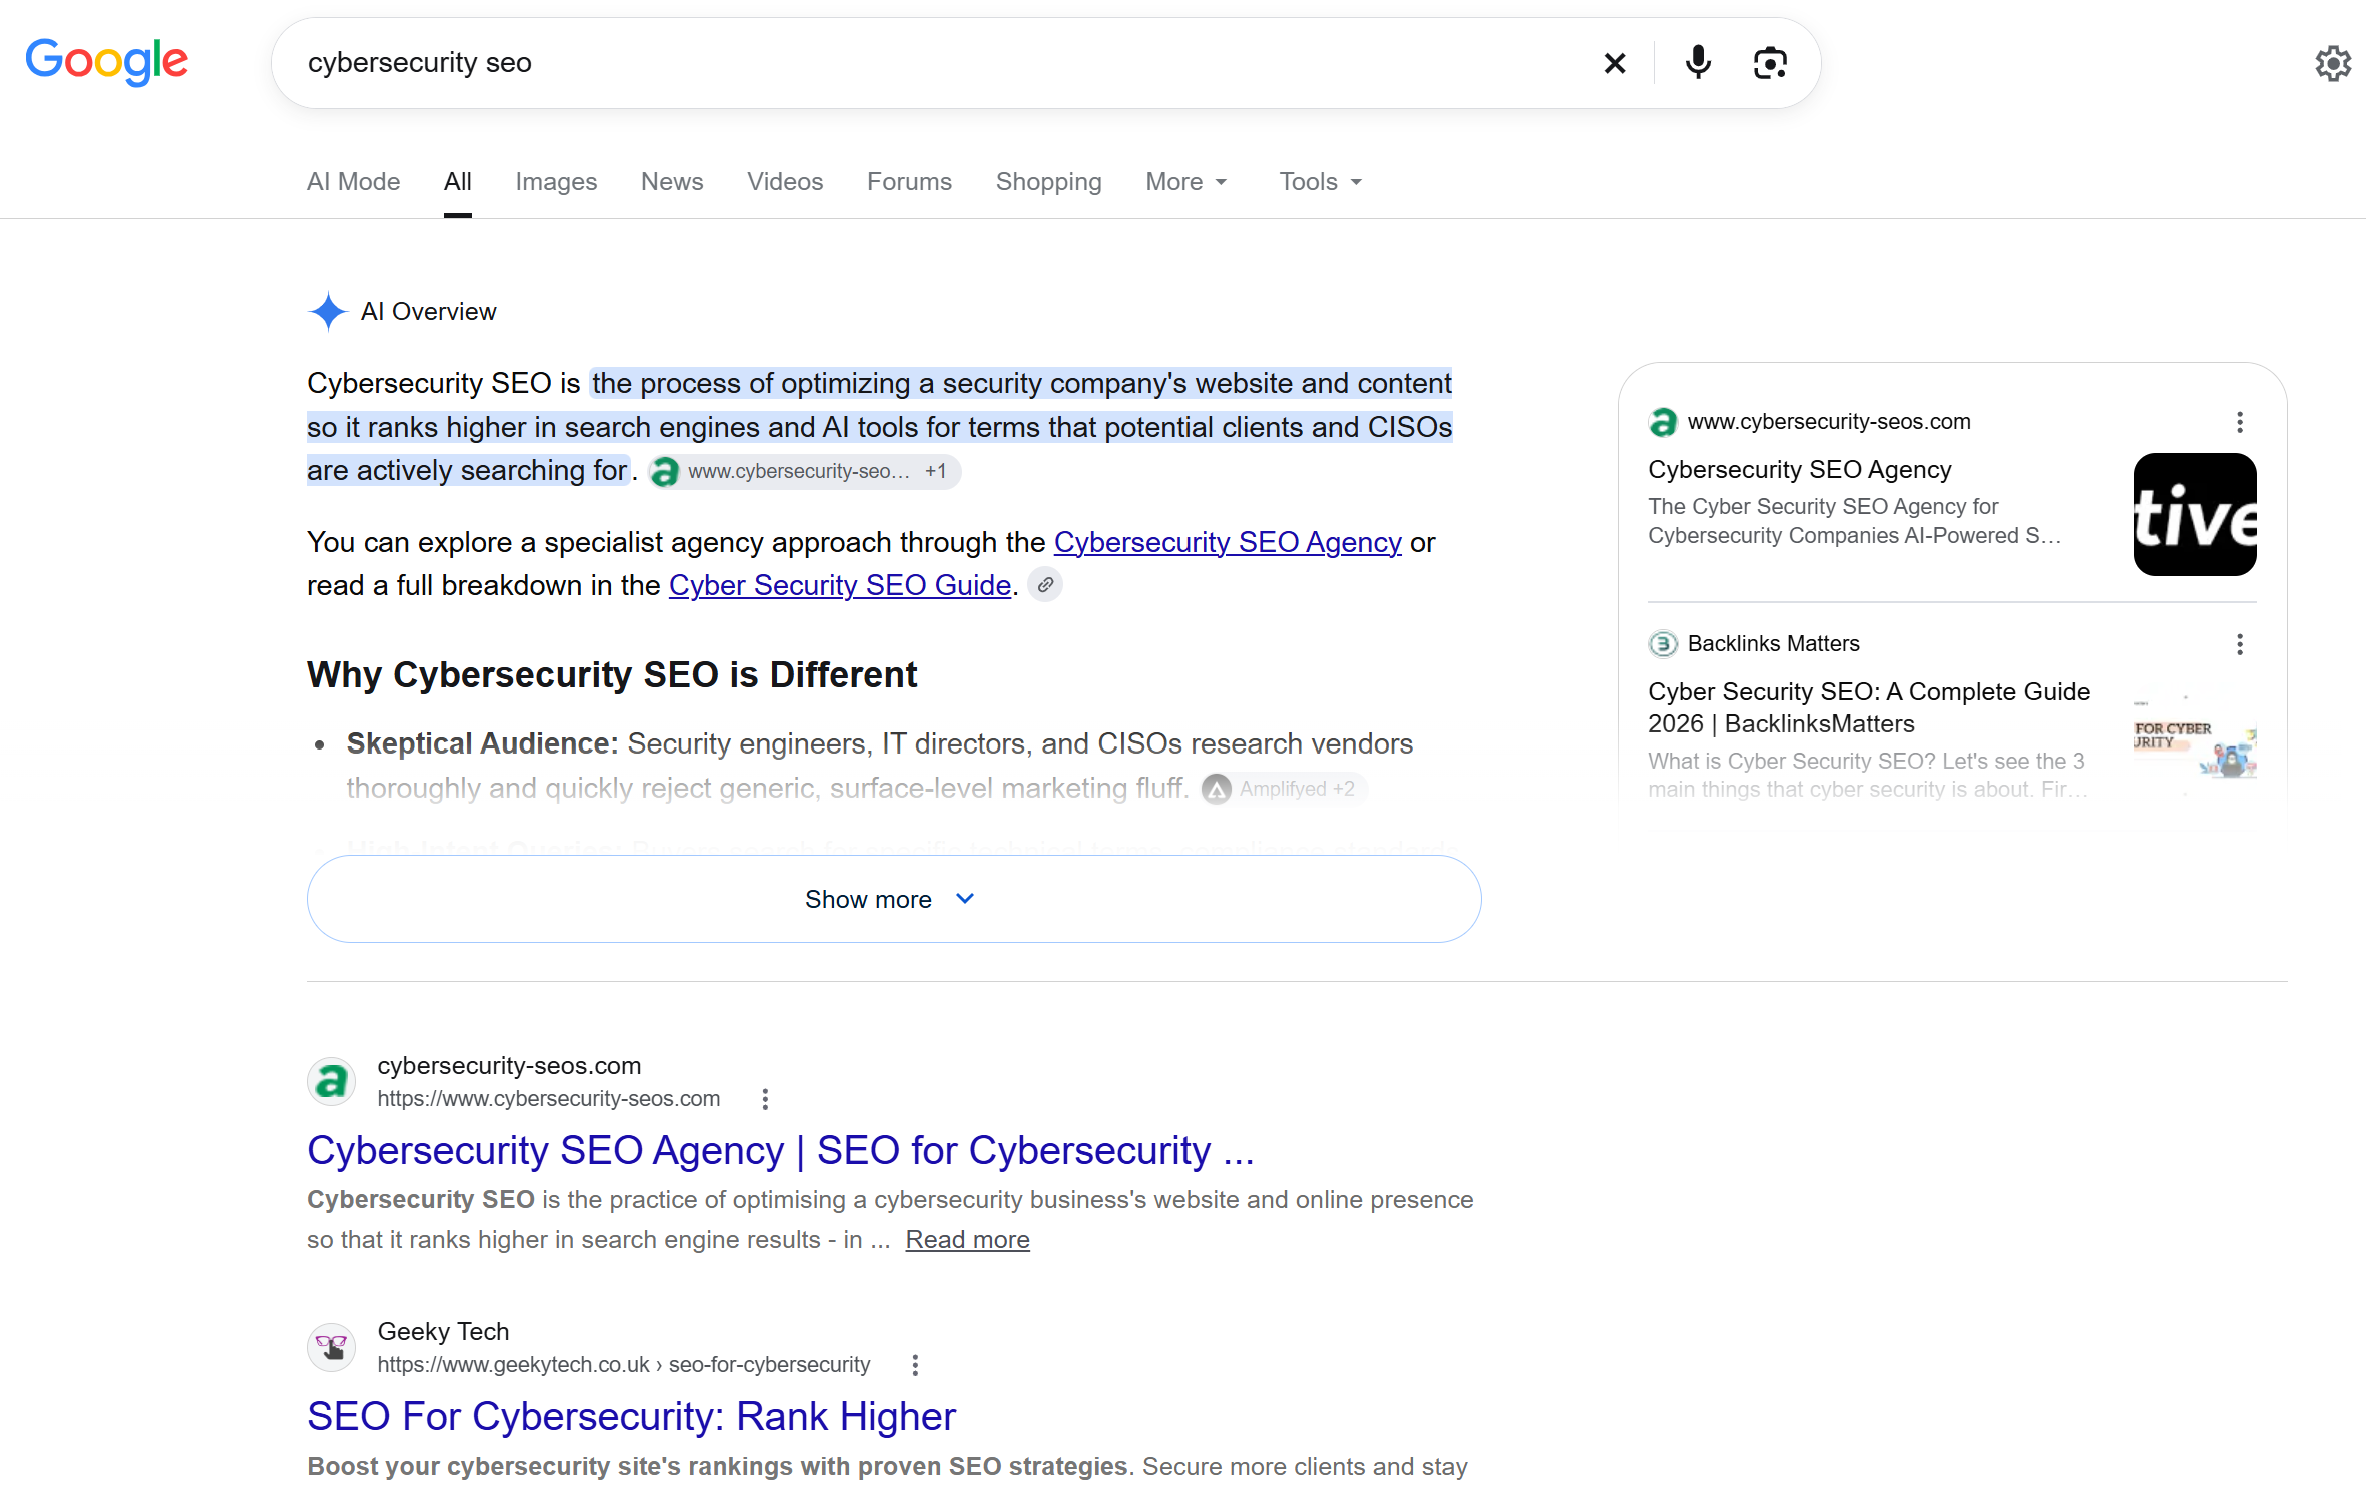
Y sí, aunque no recibimos una cantidad enorme de tráfico, SÍ conseguimos algunos clics y consultas desde un sitio web donde NO HAY NINGÚN HUMANO al timón >
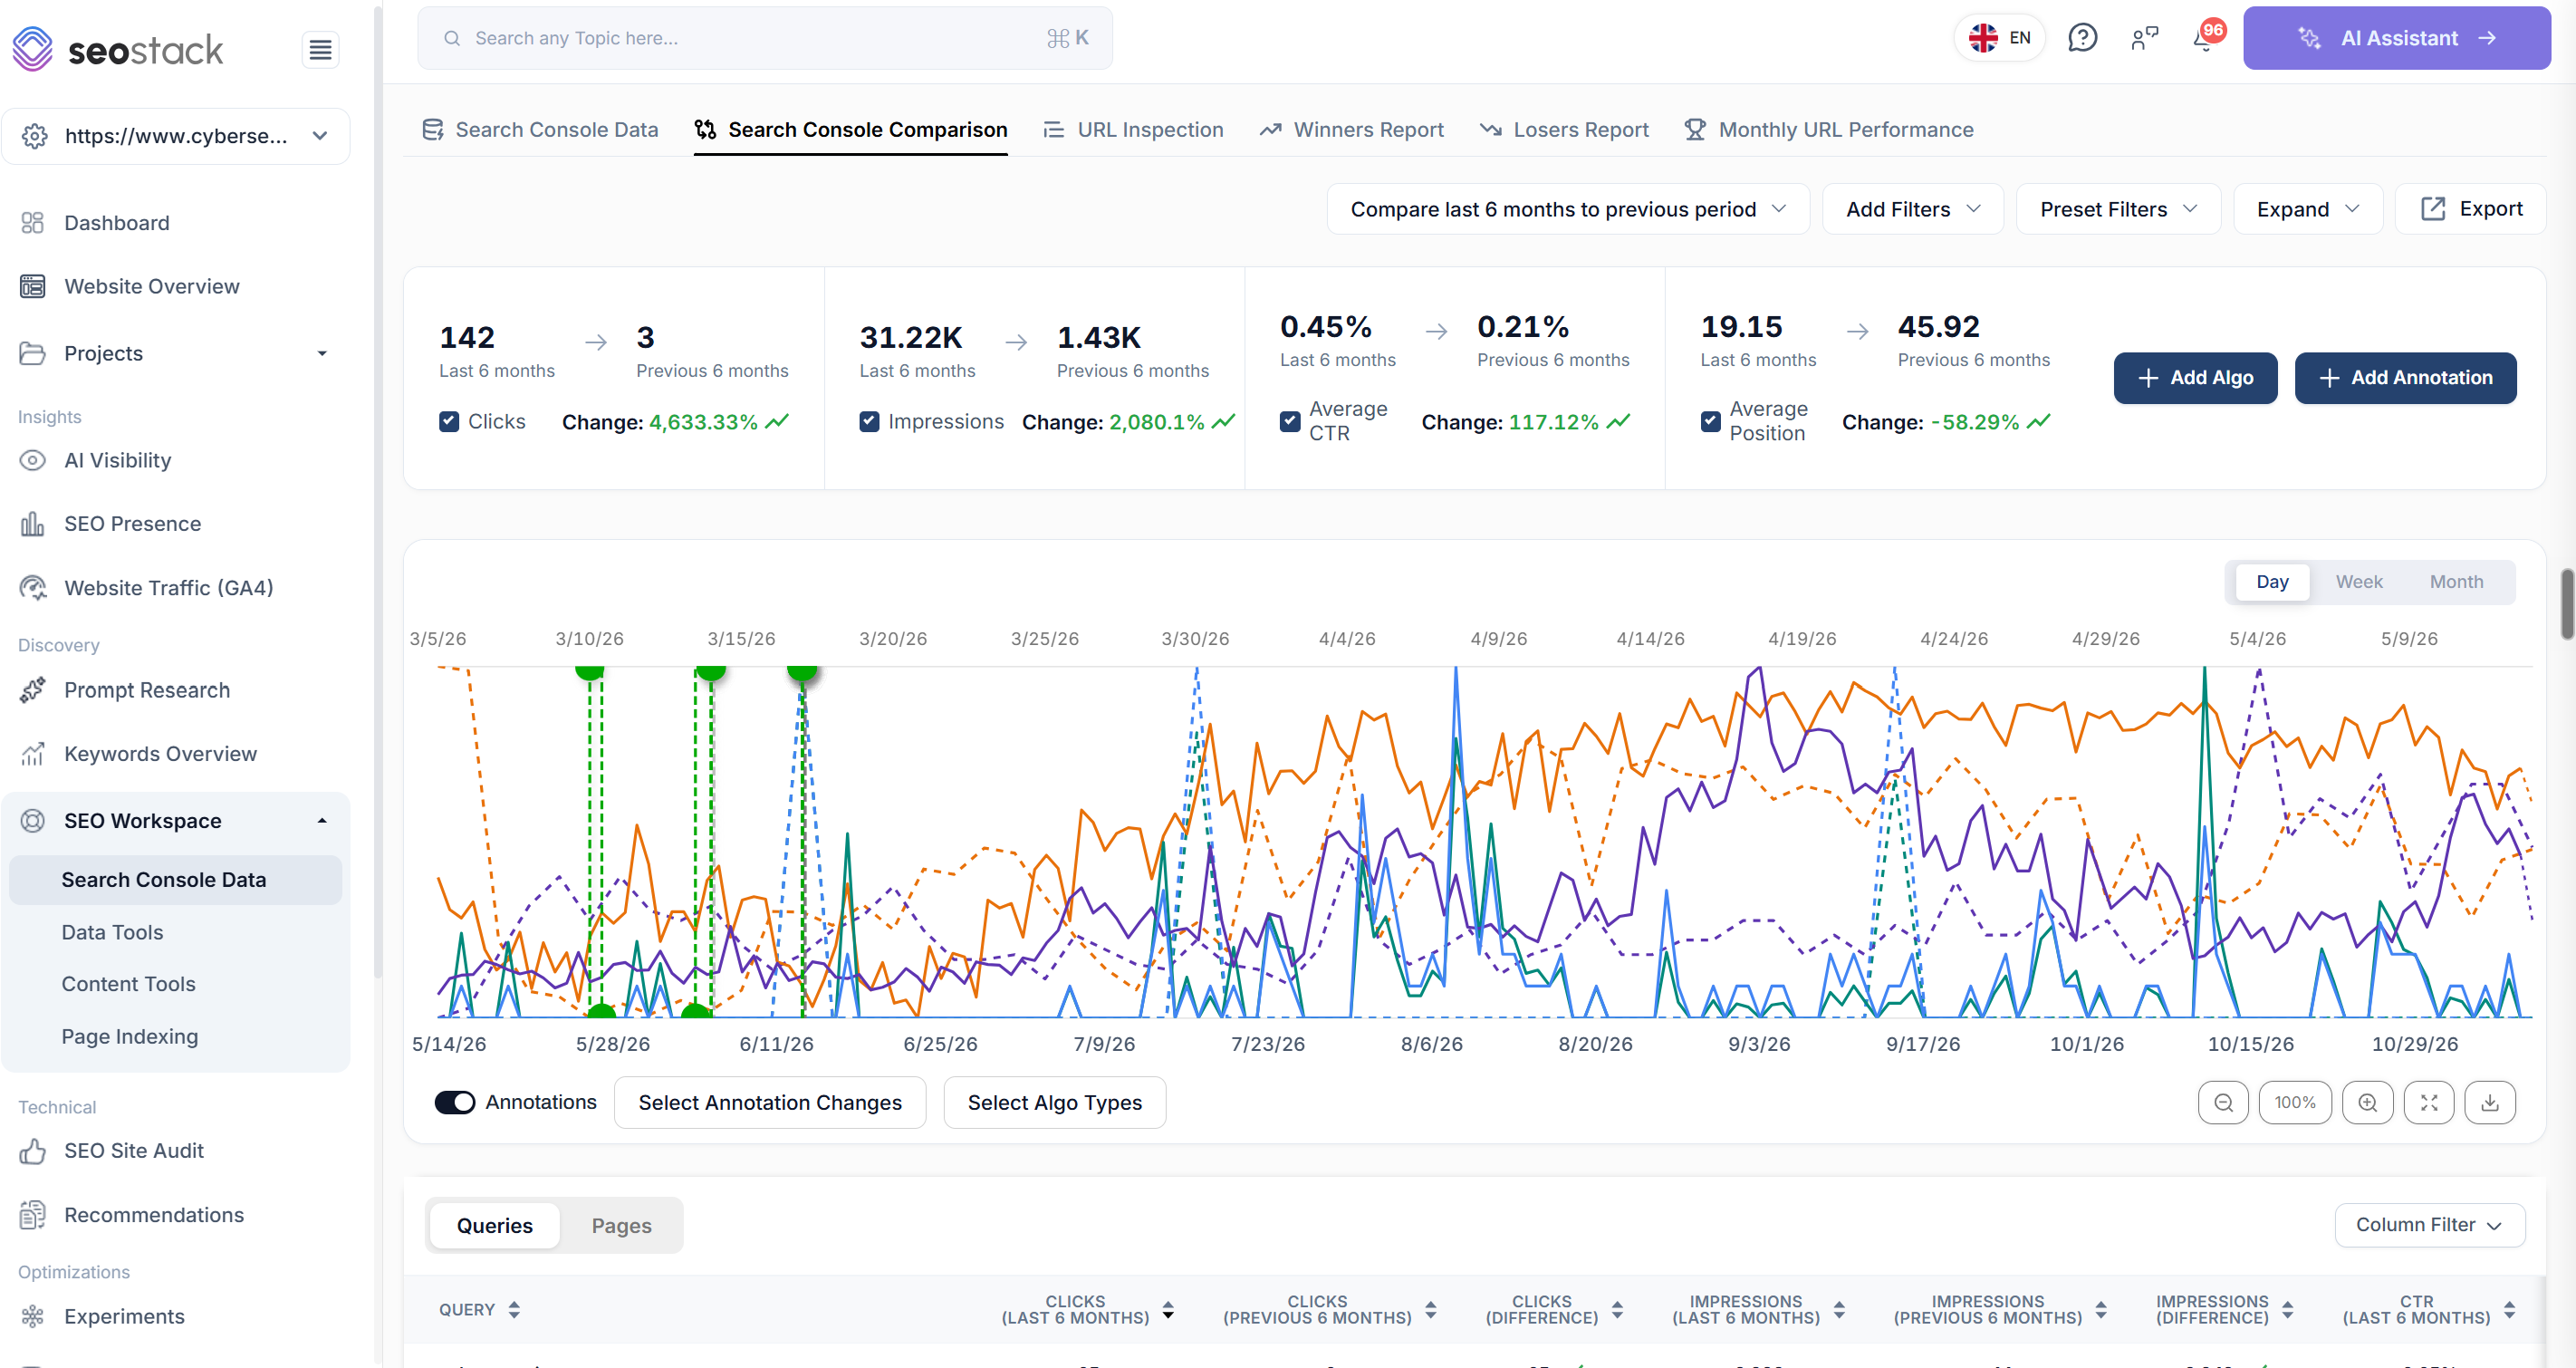
Todo esto se consiguió usando un AGENTE DE IA que construimos, entrenamos, al que dimos acceso MCP y al que dejamos campar a sus anchas con un sitio web de prueba.
Ejemplos de automatización SEO con IA (flujo de trabajo) para problemas de SEO
Problema de SEO | Lo que le encargaría al agente | Skills de SEO Stack |
|---|---|---|
El sitio sube en clics, pero el equipo de ventas dice que las consultas bajan. | Separa |
|
Los clics orgánicos cayeron el mes pasado. El cliente quiere saber adónde se fueron. | Ordena las carpetas por clics brutos perdidos e informa de las ganancias por separado. Si |
|
La posición media ha mejorado mientras que el tráfico ha retrocedido. | Compara las consultas presentes en ambos periodos y analiza por separado las consultas que desaparecieron. Perder visibilidad en un grupo grande de términos peor posicionados puede hacer que la media restante parezca mejor. Muéstrame qué términos se cayeron y cuántos clics solían aportar. |
|
El informe mensual atribuye al SEO un repunte en las búsquedas de marca. | Crea un filtro de marca que incluya el nombre de la empresa, los nombres de producto y las faltas de ortografía habituales. Compara los clics de marca y los de no marca, y marca las fechas de cualquier campaña conocida. Así puedes decirle al cliente qué parte del crecimiento vino de gente que ya los buscaba, sin adivinar qué motivó esas búsquedas. |
|
Una página sigue posicionando bien para sus términos principales, pero hace menos clics la gente. | Comprueba el CTR en las mismas consultas, dispositivo y mercado en posiciones comparables. Si la caída se mantiene, extrae los términos afectados para una comprobación de la SERP en vivo. Querría ver qué muestra Google por encima del resultado y qué título está mostrando realmente antes de pedirle a nadie que lo reescriba. |
|
Salta una alerta de tráfico todos los lunes por la mañana. | Comprueba la última fecha completa de datos y compara días de la semana equivalentes. Asigna a la alerta una pérdida mínima de clics además de un umbral porcentual. Una página que pasa de cuatro clics a dos probablemente no justifique despertar al account manager. |
|
Una guía sigue superando a la página de servicio en una consulta transaccional. | Extrae datos semanales de consulta por página e identifica cuándo la guía empezó a llevarse una mayor cuota de impresiones. Comprueba los clics combinados a ambas URL e inspecciona los enlaces que apuntan a cada una. Si la guía responde bien a la pregunta, un enlace destacado hacia el servicio puede ser más útil que fusionar las páginas. |
|
El plan de contenidos propone una página nueva para algo por lo que el sitio ya posiciona. | Busca el tema propuesto en los datos existentes de consultas y URL de la propiedad. Abre la página existente más fuerte e identifica qué cubre ya. A veces todo el briefing se reduce a añadir precios, criterios de elegibilidad o un ejemplo práctico a una página que ya atrae a la audiencia correcta. |
|
Una guía evergreen lleva seis meses perdiendo tráfico. | Encuentra las consultas responsables de la caída. ¿La guía perdió posición en términos que siguen teniendo impresiones, otra página tomó el relevo, o la misma caída ocurre todos los años? Dale al redactor las secciones que necesitan atención y las secciones que siguen trayendo tráfico. |
|
Alguien quiere borrar todas las páginas con cero clics. | Cruza el inventario de contenidos con el histórico de GSC, la antigüedad de la página, los enlaces internos y los resultados disponibles de GA4. Marca las URL publicadas recientemente, las páginas estacionales y las páginas que se usan más adelante en el recorrido del cliente. La lista de candidatas a borrar debería contener URL que alguien tenga motivos para retirar. «Cero clics en 90 días» es un briefing bastante pobre para eliminar medio sitio. |
|
GSC tiene varios miles de URL en Rastreada: actualmente sin indexar. | Lleva la exportación de motivos a PAGES → SHOULD → EXACT en SEO Stack y después cruza las URL con un rastreo actual. ¿Cuántas son productos retirados? ¿Cuántas son páginas de servicio indexables que siguen en el sitemap? Dale a cada grupo un recuento, URL de ejemplo y una decisión de actuar, observar o ignorar. |
|
Una página comercial tiene cientos de enlaces internos, la mayoría con anclas tipo «Leer más». | Dale al agente la exportación de enlaces entrantes del rastreador, incluida la URL de origen y la ruta del enlace. Agrupa las anclas por ubicación en el DOM e inspecciona unos cuantos ejemplos. Si un componente de tarjeta repetido explica la mayoría, ya has encontrado el origen del patrón y el componente exacto que hay que revisar. |
|
Se publicaron páginas de servicio nuevas, pero casi nada del sitio enlaza a ellas. | Compara la lista de lanzamiento con el rastreo y el sitemap. Para cada página con pocos enlaces, encuentra un artículo o página de servicio existente donde el destino ayude realmente al lector. Devuelve la URL de origen, la frase que editar y el destino. Ese es un trabajo que un editor puede terminar. |
|
Una publicación de plantilla cambió las canónicas en toda una sección. | Toma una muestra de las URL afectadas y de páginas vecinas, inspecciona el HTML y registra la canónica que realmente devuelve cada una. Rastrea la salida hasta la plantilla compartida. Con acceso autorizado a Vercel, el agente puede preparar una única corrección y verificarla en preview en varias rutas antes de publicar. |
|
Un panel de migración dice que el tráfico se está recuperando. Varias páginas importantes siguen pareciendo muertas. | Dale al agente el mapa de URL antiguas a nuevas. Compara la línea base de cada URL antigua con el tráfico combinado a sus direcciones antigua y nueva, y después prueba la redirección y el destino final. Prioriza las páginas antiguas valiosas que ahora terminan en una categoría, la home o un 404. |
|
La página de EE. UU. sigue apareciendo en búsquedas del Reino Unido. | Empareja las URL del Reino Unido y de EE. UU., filtra GSC por país y comprueba qué página aparece para las mismas consultas a lo largo del tiempo. Inspecciona canónicas, hreflang recíproco, destinos de redirección y enlaces internos. Si la navegación del Reino Unido apunta a la página de EE. UU., eso debe ir en el ticket junto con las pruebas de hreflang. |
|
Las consultas desde móvil cayeron tras un rediseño, mientras que las entradas orgánicas se mantuvieron estables. | Compara los envíos exitosos por landing page y dispositivo, y después comprueba el formulario y el tracking en una página móvil afectada. ¿Falla el formulario, falla el evento de éxito, o lo completan menos visitantes? Son tres trabajos distintos para tres personas distintas. |
|
El cliente cree que una actualización del algoritmo causó la caída. | Superpón las fechas de actualizaciones, las publicaciones del sitio y las anotaciones de SEO Stack sobre la tendencia diaria. Encuentra la primera fecha afectada y compara plantillas, países y dispositivos. Una caída limitada a una plantilla desde la mañana en que se desplegó le da al desarrollador algo concreto que investigar. |
|
La AI Visibility cayó justo después de que la agencia añadiera nuevos prompts monitorizados. | Recalcula las tasas de mención y de citación usando los prompts originales, emparejados por modelo y mercado. Dale a los prompts nuevos su propia línea base. Así podrás decir si la visibilidad cayó en las preguntas que ya monitorizabas o si el conjunto ampliado simplemente contiene preguntas más difíciles. |
|
Se publicó un cambio de título, los clics subieron un 20% y el resultado va directo a un caso de estudio. | Recupera la fecha de publicación, las URL editadas y el conjunto original de consultas. Compáralos con páginas similares sin cambios en los mismos periodos completos. Si esas páginas también ganaron un 20%, yo dejaría la afirmación de mejora fuera del caso de estudio. |
|
El agente sigue haciendo más ediciones antes de que nadie sepa si la primera funcionó. | Haz que la tarea programada lea primero el registro de experimentos. Si esas URL ya están en revisión, comprueba la implementación en vivo y la fecha de revisión acordada. Cuando haya datos suficientes, registra si hay que mantener, revisar o revertir el cambio antes de abrir otra prueba. |
|
Un informe de agencia muestra cero tráfico orgánico para un cliente. Nadie sabe si se rompió el sitio o el reporting. | Ejecuta una lectura real de GSC a nivel de propiedad desde el mismo perfil de agente que genera el informe. Comprueba la última fecha disponible y prueba GA4 por separado. Una conexión fallida entra en el informe como datos faltantes, para que el account manager investigue el problema correcto. |
|
¿Qué le estás dando realmente al agente?
Abre la descarga y mira dentro de skills/seo-stack-loss-diagnosis/SKILL.md. Es un conjunto legible de instrucciones para investigar clics perdidos. Puedes ver qué periodos debería comparar el agente, hasta qué nivel debería profundizar y qué evidencia corresponde incluir en la respuesta. Si tu agencia tiene una forma concreta de hacer esa investigación, aquí tienes algo que puedes inspeccionar y adaptar.
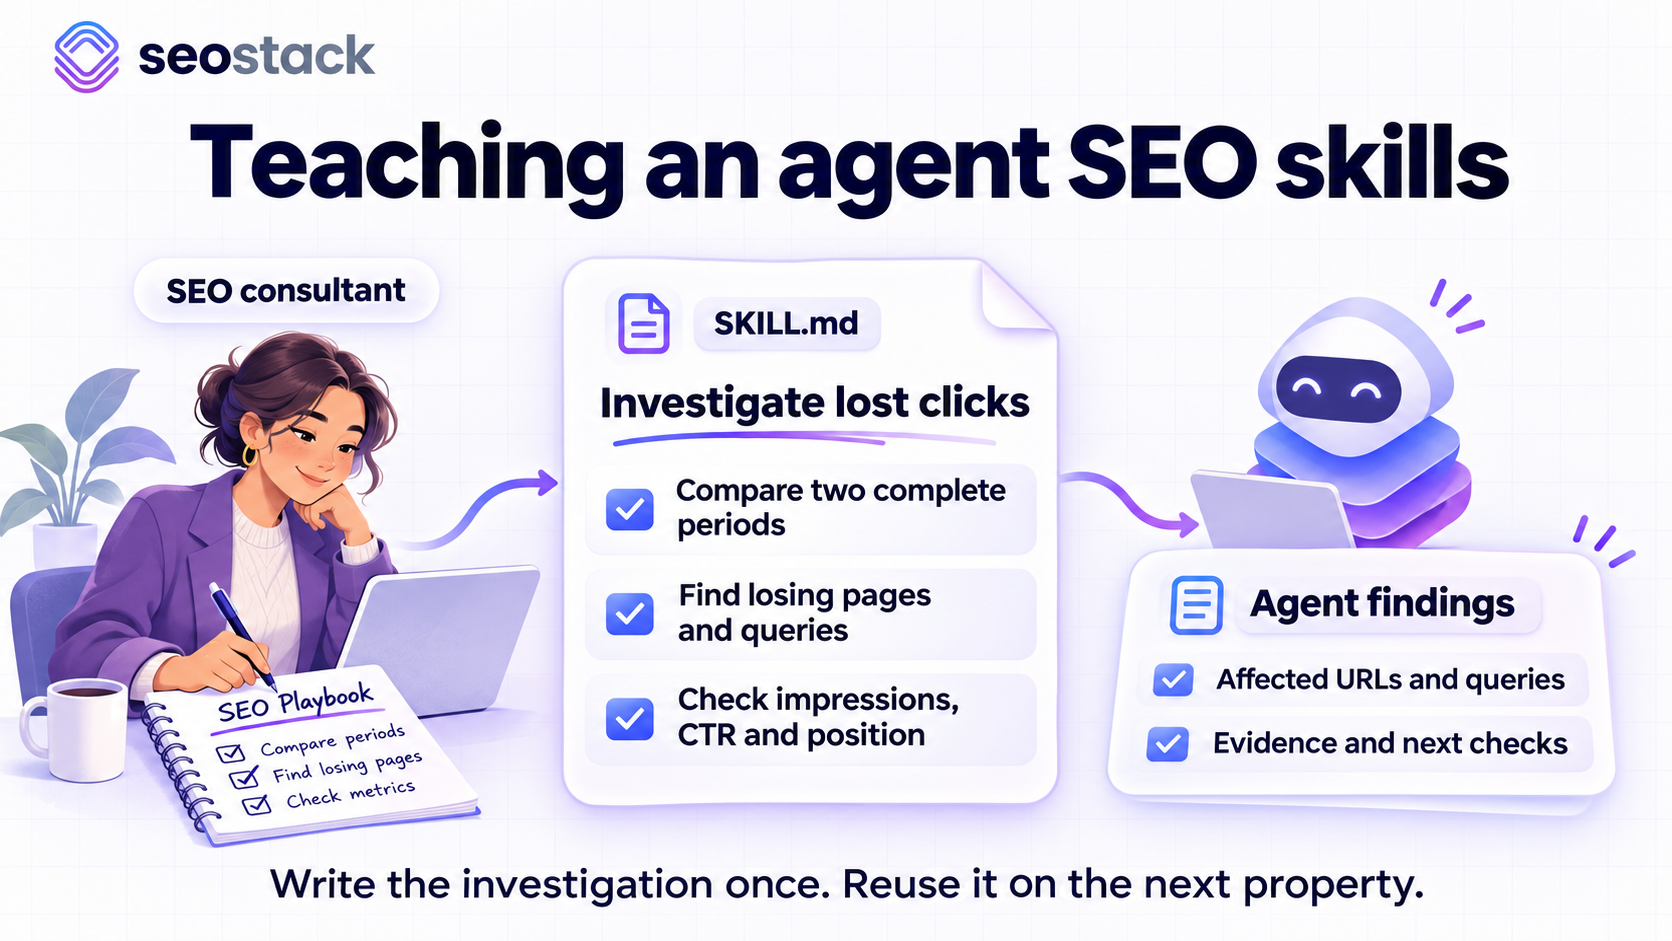
Los datos vienen de una conexión aparte. MCP (Model Context Protocol) permite al agente llamar a herramientas de SEO Stack. Por ejemplo, puede solicitar el rendimiento de GSC agrupado por segmento de URL, comparar dos periodos, examinar una consulta junto con las páginas que aparecen para ella, o solicitar las métricas de GA4 admitidas para una propiedad vinculada. Tu cuenta, el histórico disponible de la propiedad y las herramientas expuestas a ese agente concreto determinan qué puede recuperar. Instalar un archivo Markdown le da el procedimiento. Conectar SEO Stack le da acceso a las cifras. Catálogo MCP de SEO Stack
Un workflow es la forma de encadenar esos procedimientos. Una alerta diaria puede desembocar en una investigación de pérdidas, que puede desembocar en una recomendación. Un cron es simplemente la programación que lanza el trabajo. Que el agente pueda abrir una pull request o publicar una edición en un sitio web es una decisión aparte, que implica tu repositorio Git, tu proyecto de Vercel y los permisos que le concedas.
El catálogo de SEO Stack es un buen sitio para comprobar qué entrada admite cada herramienta concreta. Las herramientas de rendimiento en búsqueda usan el índice de datos del sitio. Las herramientas de AI Visibility usan su website ID, y el historial de prompts necesita el tracker ID del prompt que estás investigando. Guía paso a paso de MCP
Sigue los clics perdidos antes de decidir qué editar
Toma el pequeño ejemplo incluido en la descarga. Son URLs y cifras ficticias. Puedes reproducir la comparación tú mismo con los dos CSV de la carpeta de ejemplos.
URL | Clics anteriores | Clics actuales | Variación |
|---|---|---|---|
/services/a | 120 | 75 | −45 |
/legacy | 15 | 0 | −15 |
/guides/b | 80 | 100 | +20 |
/new | 0 | 8 | +8 |
Total | 215 | 183 | −32 |
Un dashboard te dice que el sitio perdió 32 clics; la página de servicio por sí sola perdió 45. Si estoy decidiendo dónde invertir el dinero de un cliente, ese segundo número merece atención. Las dos URLs en caída perdieron 60 clics entre ambas, de los cuales la página de servicio supone el 75%. En otras partes el sitio ganó 28. Es perfectamente posible tener un problema serio en una plantilla comercial mientras los nuevos posts del blog hacen que las cifras de titular parezcan bastante decentes.
Aquí es donde yo combinaría tres skills. Cohorts define el grupo que quiero seguir, quizá todas las páginas de servicio del Reino Unido excluyendo consultas de marca. Loss diagnosis trabaja del sitio a la carpeta y de ahí a la URL, y después mira las consultas detrás de esa URL. Longitudinal analysis le da al agente una forma de comprobar si la demanda suele caer en esta época del año, siempre que el almacén tenga suficiente histórico. Si le doy los últimos tres días de una propiedad que aún no ha terminado de ingerirlos, los tres análisis pueden estar magníficamente explicados y ser completamente inútiles. La comprobación de la conexión va primero.
¿Qué más sabemos de esa página de servicio? Las impresiones cayeron de 4.000 a 3.800, mientras que el CTR pasó del 3% al 1,97%. Con su CTR anterior, 3.800 impresiones habrían producido unos 114 clics. En realidad obtuvo 75. Eso nos da una razón para investigar el cambio de CTR, aunque todavía nos deja lejos de recomendar un nuevo title. Una avalancha de impresiones para consultas más amplias podría tirar de la media hacia abajo aunque el CTR en los términos comerciales originales se hubiera mantenido exactamente igual.
Un prompt práctico para esta fase:
Para la página de servicio que pierde, compara las consultas presentes en ambos periodos. Muestra clics, impresiones, CTR y posición, y después revisa móvil y escritorio por separado. Lista las consultas nuevas y las que desaparecen en grupos propios. Dame las fechas exactas, la URL y los filtros para que pueda reproducir la comparación en SEO Stack. Si las filas de consultas solo explican parte del total de la página, muéstrame la diferencia.
Supongamos que la caída en móvil se concentra en tres términos valiosos. La skill de cannibalisation puede comprobar si una guía ha empezado a aparecer en lugar de la página de servicio para esas búsquedas. Yo querría un desglose semanal de consulta por URL, el rendimiento combinado de ambas URLs y una revisión de lo que ofrece cada página. Que dos URLs reciban impresiones para la misma frase dice muy poco sobre si alguna de ellas necesita una redirección. Si la titularidad de la URL es estable y la pérdida persiste en consultas y posiciones comparables, la skill de CTR opportunities puede comparar la página con páginas equivalentes relevantes y el SEO puede mirar los resultados de búsqueda reales.
¿Le costó algo al negocio esa pérdida?
Lleva la misma URL a GA4. Para un sitio de generación de leads yo pediría las sesiones de aterrizaje de Google orgánico y los envíos de consulta exitosos en fechas comparables. Primero establece qué registra realmente el evento. Un clic de botón que se dispara antes de la validación del formulario es una definición particularmente generosa de una consulta.
SEO Stack puede devolver métricas de GA4 junto a métricas de GSC cuando la propiedad y la herramienta lo admiten. Confirma el canal y si la fila representa una página de destino o actividad en cualquier punto de la página. Si todo lo que tienes son sesiones de todos los canales, indica ese alcance en el informe. Unir ese número a diez consultas de GSC crea diez copias del mismo número y exactamente cero evidencia sobre qué keyword generó una venta. Guía de Google sobre el uso conjunto de Analytics y Search Console
Para el profesional de marketing digital que lee el informe, la distinción importa. Si tanto los clics de búsqueda como las entradas orgánicas cayeron pero la tasa de consultas se mantuvo estable, merece la pena investigar la adquisición perdida. Si las entradas aguantaron y las consultas exitosas desaparecieron de la noche a la mañana, yo probaría el formulario, los cambios de consentimiento y el evento de GA4 antes de encargar ningún contenido. Nuestro ejemplo en CSV no contiene datos de GA4, así que su impacto comercial sigue siendo una pregunta abierta.
Dónde se ganan el sueldo las demás skills
Yo no ejecutaría las 21 skills contra cada propiedad todas las mañanas. Una migración necesita un mapa de URLs antiguas a nuevas. Una auditoría de enlaces internos necesita saber dónde está situado un enlace en la página de origen. Un informe mensual de agencia necesita saber qué cliente es dueño de cada propiedad y quién recibe el resultado. Así encaja el pack en esos trabajos. Los nombres de abajo coinciden con los nombres de carpeta tras el prefijo común seo-stack-.
Trabajo | Skills | Qué puedes entregarle a alguien después |
|---|---|---|
Establecer qué se puede medir |
| La propiedad verificada, las fechas disponibles, una lectura de métrica exitosa y un filtro reutilizable con URLs de ejemplo que deberían incluirse y excluirse. |
Investigar cambios en el rendimiento en búsqueda |
| Una alerta fechada con la carpeta afectada, su contribución a la pérdida, la evidencia de consultas y una comparación con el comportamiento estacional previo cuando el histórico lo permita. |
Decidir dónde se justifica trabajar el contenido |
| Una decisión concreta sobre una URL existente. Amplía esta sección, diferencia estas dos páginas, prueba este snippet o deja la página en paz. GSC puede indicar demanda para la que ya apareces. La investigación de mercados donde no tienes visibilidad necesita otra fuente. |
Auditar rastreo, indexación y enlaces internos |
| URLs afectadas, un fallo reproducible, la página o plantilla de origen y una comprobación que el desarrollador pueda ejecutar tras el arreglo. Aporta las exportaciones relevantes, el crawl o el HTML renderizado. |
Revisar una migración o un despliegue internacional |
| Rendimiento de URL antigua a nueva, redirecciones omitidas, destinos incorrectos o pares de locales que merecen investigación, con evidencia de país y consultas adjunta. |
Entender los resultados comerciales y de búsqueda con IA |
| Resultados verificados por página de destino, o una comparación de menciones y citas a través de los mismos prompts y modelos monitorizados. Cada uno tiene su propia unidad de medida. |
Conseguir que el trabajo se implemente y evaluar la publicación |
| La edición propuesta, el alcance de URLs, la prueba de aceptación, la publicación verificada y una decisión de seguimiento basada en la métrica acordada. |
Ejecutar el trabajo en todas las cuentas de clientes |
| Experimentos abiertos pendientes de revisión, acciones pendientes por cliente y un registro explícito de las propiedades cuyos datos no se pudieron comprobar. |
Una mejor manera de usar una exportación de páginas no indexadas
Aquí tienes una tarea que puedes probar sin dar a ningún agente acceso al código de tu web. Exporta un grupo de motivos del informe de Indexación de páginas de GSC, por ejemplo Rastreada: actualmente sin indexar. En Search Console Data de SEO Stack, lleva esa lista de URLs a PAGES → SHOULD → EXACT. Quieres que coincida cualquiera de esas URLs completas. Guarda el grupo bajo GSC Non Indexed Reasons, con el motivo como nombre del subgrupo. Así obtienes una lista a la que puedes volver después de que alguien haya trabajado en ella.
Dale a la skill de indexación la exportación fechada y un rastreo actual con estado HTTP, indexabilidad, canonical, pertenencia al sitemap y enlaces internos entrantes. Pídele que describa los principales tipos de URL y que te muestre ejemplos de cada decisión. Una URL retirada que ahora devuelve 404, no tiene enlaces internos y se eliminó deliberadamente tiene una prioridad muy distinta sobre tu tiempo que una página de servicio activa, autocanonical y presente en el sitemap a la que la navegación nunca enlaza. Los clics históricos de GSC pueden indicarte que una URL solía atraer tráfico. Para determinar qué informa Google actualmente sobre una URL concreta, usa la Inspección de URLs.
La skill de enlazado interno puede llevar la investigación más lejos. Si un rastreador dice que la página de servicio tiene 400 enlaces entrantes, pide al agente que los agrupe por página de origen y ubicación en el DOM. ¿Cuántos son el mismo enlace «Leer más» repetido en una tarjeta? ¿Cuántos son enlaces relevantes dentro del propio contenido? Pide la URL de origen, el destino previsto, la frase existente y el anchor propuesto. Un desarrollador puede implementar eso. «Mejorar el enlazado interno» seguirá en la hoja de cálculo el trimestre que viene.
Monitorizar la visibilidad en respuestas de IA
Con prompts monitorizados, el conjunto de comparación importa tanto como la respuesta. Imagina que una agencia añade 40 prompts no de marca en octubre a un conjunto que antes consistía principalmente en preguntas de marca. La tasa global de menciones cae. Antes de que alguien le diga al cliente que su marca ha perdido visibilidad, haz que la skill de AI visibility compare las ejecuciones completadas de los prompts originales, en los mismos modelos y mercados. Informa de las menciones y las citas enlazadas por separado, conserva las URLs citadas reales y muestra cuántas ejecuciones produjeron cada porcentaje. Los prompts nuevos pueden tener su propia línea base. Herramientas de informes de IA y prompts de SEO Stack
Dar a un agente permiso para editar una web en Vercel
Hay tres puntos de parada útiles. En modo recommend, el SEO recibe un brief con la URL exacta, las evidencias y la edición propuesta. En modo preview, un agente con el acceso Git adecuado puede trabajar en una rama, abrir una pull request e inspeccionar la preview de Vercel. Production es para sitios cuyos propietarios han autorizado expresamente los cambios concretos y el método de publicación. La clave de SEO Stack proporciona el acceso a la analítica. Git y Vercel controlan quién puede modificar el sitio.
Para un experimento de títulos registraría el título renderizado actual, la redacción propuesta, las URLs afectadas y una página vecina que debería mantener su título existente. La página vecina merece los pocos segundos que lleva comprobarla. Lo que parece una edición de una sola página en Next.js puede resultar ser un cambio en el layout compartido. En preview, confirma el HTML real, el canonical y el hostname de destino; después comprueba los mismos elementos en el dominio en producción tras la publicación. Una pull request aprobada tiene una fecha. Un despliegue sirviendo a usuarios reales puede tener otra distinta. Usa esta última para medir. Guía de preview y promoción de Vercel
Registra la publicación, la línea base, las URLs, el grupo de comparación y la próxima fecha de revisión en el registro de experimentos. En SEO Stack, una anotación puede cubrir una sola página, un grupo de URLs o todo el sitio. Cuando la herramienta MCP disponible solo puede leer anotaciones, el agente puede darte el texto para añadirlo en la aplicación y conservar el registro de publicación en local. Uso de anotaciones y comparaciones en SEO Stack
Ahora supongamos que la página de servicio se recupera de 75 clics a 90 tras el cambio. Eso es un aumento del 20%. Páginas de servicio similares sin modificar pasaron de 100 clics a 120 en el mismo periodo. Con esa comparación, habrías esperado unos 90 clics en la página editada de todos modos. Puede que mantenga el nuevo título porque describe mejor el servicio, pero no pondría «20% de mejora gracias a la optimización del título» en la presentación al cliente.
Esa revisión es lo que significa recursivo en este pack. La siguiente ejecución consulta el trabajo que ya está en medición, comprueba si se han acumulado suficientes datos completos y registra una decisión antes de proponer otra edición al mismo grupo. Tú eliges la ventana de revisión según el volumen de tráfico, el cambio y cuándo Google podría razonablemente haberlo procesado. Una página de servicio de poco volumen puede necesitar bastante más tiempo que una plantilla de categoría con mucho tráfico.
Tu primera prueba en real, y después tu primer cron
Elige una propiedad que conozcas. Dale al agente su nombre exacto y la ubicación del repositorio descomprimido, y luego pídele:
Usa seo-stack-connect y seo-stack-loss-diagnosis en [propiedad]. Encuentra el sitio correspondiente usando SEO Stack MCP. Compara los últimos siete días completos con los siete anteriores. Devuelve ambos rangos de fechas, los clics e impresiones del sitio, y las cinco URLs con las mayores pérdidas absolutas de clics. Muestra los clics antes y después de cada URL. Intenta una lectura independiente de sesiones de GA4 e indica su alcance de canal. Dime qué lectura falló si no hay datos disponibles. No hagas ningún cambio en el sitio.
Abre la misma propiedad en SEO Stack, iguala el tipo de búsqueda, los filtros y las fechas, y después comprueba los dos totales del sitio y una URL concreta. Una lista de herramientas verifica el descubrimiento. Un conjunto de cifras que puedes reproducir verifica bastante más.
Para Hermes, programa esa misma lectura una vez antes de comprometerte con un trabajo recurrente. El siguiente ejemplo es para una terminal Bash en un VPS. Sustituye los tres valores de las primeras líneas. Arranca el gateway de ese perfil si está inactivo.
SEO_PROFILE='your-profile'
SEO_SITE='your-property'
SEO_REPO='/absolute/path/to/seo-stack-skills'

hermes -p "$SEO_PROFILE" gateway status
hermes -p "$SEO_PROFILE" cron create "2m" \
  "Read $SEO_REPO/docs/data-contract.md. Use SEO Stack MCP for $SEO_SITE. Compare the last seven complete days with the previous seven. Give exact dates, site clicks and the five losing URLs with before and after clicks. Record a failed read explicitly." \
  --skill seo-stack-connect --skill seo-stack-loss-diagnosis \
  --name "SEO Stack property test" --deliver local
Revisa el informe en el cron/output/ de ese perfil. Si el resultado manual fue correcto y el trabajo programado no puede leer el sitio, comprueba el perfil programado, la cuenta de servicio, las herramientas disponibles y la sesión del gateway antes de regenerar credenciales. Si ambas lecturas funcionan, tienes una base razonable para un informe semanal de pérdidas. Tareas programadas de Hermes · Resolución de problemas de cron
Para un programa de mayor duración, el pack incluye un runner para Linux. Copia examples/client.json a un almacenamiento privado, configura la propiedad, el perfil de Hermes y un directorio de estado absoluto con permisos de escritura, y empieza en modo recommend. Ejecuta python3 scripts/run.py /path/to/client.json weekly --dry-run desde el checkout para inspeccionar la instrucción. Quita --dry-run para el trabajo real. Los ejemplos de docs/operations.md muestran cómo programar alertas diarias, una investigación semanal y revisiones de experimentos abiertos. Usa un solo programador por trabajo. El runner incluido llama a Hermes y usa un bloqueo de archivo de Linux, así que una instalación de la skill en Cursor o Claude Desktop por sí sola no lo ejecutará.
En una cuenta de agencia, juzgaría el primer mes con preguntas bastante corrientes. ¿Cuántas alertas llevaron a un fallo o a una oportunidad que alguien pudiera verificar? ¿Podría otro SEO reproducir los hallazgos sin pedirle al agente que se explicara otra vez? ¿Recibió el desarrollador del cliente una URL, un cambio exacto y una forma de probarlo? Y cuando llegó la fecha de revisión, ¿comprobó alguien qué pasó con el tráfico cualificado o las consultas?
Yo empezaría por el informe que ya dedicas tiempo a elaborar a mano. Sabes qué cifras deberían cuadrar, qué clientes tienen una caída estacional y qué evento de GA4 lleva contando mal desde la última reconstrucción del sitio. Eso te convierte en un juez mucho mejor del trabajo del agente. Cuando pueda hacer ese trabajo de forma fiable, dale el siguiente.

Fundador, SEO Stack
Daniel es el fundador de SEO Stack. Ha dedicado más de 2 décadas al SEO técnico y a los datos de búsqueda, y creó SEO Stack tras toparse una vez más con los mismos límites de Search Console en el trabajo con clientes.
Daniel cuenta con una amplia experiencia en SEO: ha montado agencias de SEO, negocios de auditoría y una consultoría próspera. En su tiempo libre, le gusta realizar experimentos de SEO y compartir los resultados.
Publicado 9 de noviembre de 2026


