谷歌 site: 运算符完全指南(以及 SEO 人员必须掌握的每个技巧)
大多数 SEO 从业者都知道有 site: 这个搜索运算符,但真正把它用到接近极致的人要少得多。最基础的用法是,site: example.com 能告诉你 Google 从某个域名收录了哪些内容。不过……
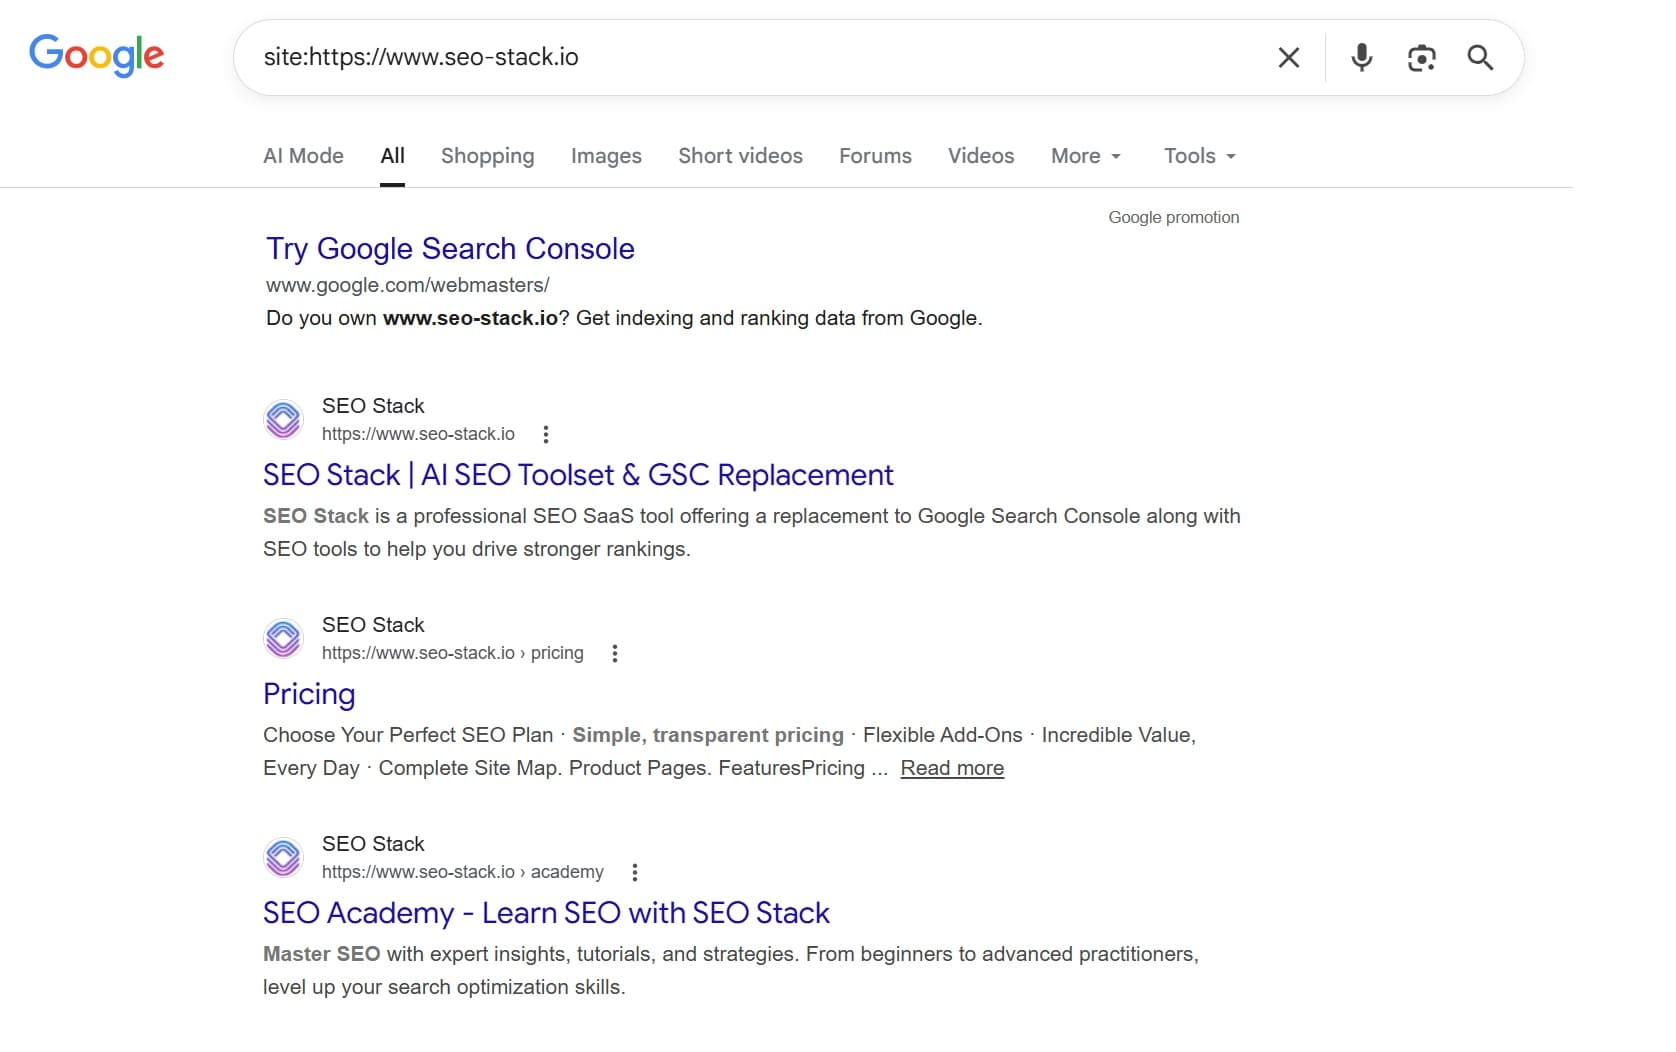
大多数 SEO 从业者都知道 site: 运算符的存在,但真正把它用到接近全部潜力的人要少得多。
最基础的用法是,site:example.com 会告诉你 Google 从某个域名索引了哪些页面。但如果叠加其他运算符、按子目录过滤、限定到某个子域,或结合布尔逻辑,它就会变成技术 SEO 中最强大的诊断工具之一。无需任何付费工具。
本指南涵盖全部内容:基础用法、可以叠加使用的高级运算符、真实场景的用例,以及在你信任这些数字之前必须了解的局限。
基础:site: 到底做了什么
site:seo-stack.io
这条查询会返回 Google 索引中所有被它识别为属于 seo-stack.io 的页面。结果栏中显示的数字("找到约 X 条结果")会给你一个大致的已索引页面数量。
有几点需要立刻理解:
这个数字是估算值。Google 不会返回精确的索引数量。该数字在不同次搜索之间会波动,在大规模站点上更是出了名的不可靠。不要基于它建立报告。
它显示的是 Google 已索引的内容,而非你已发布的内容。被 robots.txt 屏蔽、带 noindex 标记,或者干脆还没被抓取的页面都不会出现。
默认情况下它包含子域——除非你另行指定(下文详述)。
你不需要加 https:// 前缀。site:seo-stack.io 和 site:https://www.seo-stack.io 都能用,但前者更干净。
将 site: 限定到子目录和子域
从这里开始,site: 才在真实审计中体现出价值。
子目录层级的索引情况
site:example.com/blog/
site:example.com/products/
site:example.com/en-gb/
这会把查询限定到站点的特定板块。适用于:
检查已索引的博客文章数量与已发布数量的对比
诊断电商品类页面的索引缺口
逐个审计各个国际化子目录
实际示例:如果 site:example.com/blog/ 返回 47 条结果,但你已经发布了 200 篇文章,那么你就存在索引问题——规范化处理、noindex 标签、抓取预算或内容过薄都是可能的元凶。
子域层级的索引情况
site:blog.example.com
site:app.example.com
site:support.example.com
这会把结果限制在特定子域内。当一个站点使用不同子域来区分环境(博客、应用、支持文档、预发布)且你想独立审计每一个时,这很有用。
排除子域
site:example.com -site:blog.example.com
显示 example.com 上所有已索引内容,但不包括博客子域。当博客或文档子域虚增了总数时,这有助于把核心站点单独隔离出来。
叠加运算符:威力所在
当 site: 运算符与其他运算符结合时,它才真正具备诊断能力。以下是最有用的几种组合。
site: + inurl:
site:example.com inurl:category
site:example.com inurl:?
site:example.com inurl:page
作用:筛选出 URL 中包含特定字符串的已索引页面。
用例:
site:example.com inurl:? —— 找出已被索引的分面筛选或带参数的 URL。如果这里出现成千上万条结果,你很可能存在抓取预算或重复内容问题。
site:example.com inurl:/tag/ —— 找出 WordPress 站点上已索引的标签页,这类页面往往内容单薄,应当设为 noindex。
site:example.com inurl:utm_ —— 查看带 UTM 参数的 URL 是否被索引(本不该被索引)。
site:example.com inurl:print —— 发现被索引的打印版页面。
site: + intitle:
site:example.com intitle:"buy"
site:example.com intitle:"login"
site:example.com intitle:"404"
作用:筛选出页面标题中包含指定词或短语的结果。
用例:
site:example.com intitle:"404" —— 找出被 Google 索引、且标题中含有 "404" 的错误页面。这是常见的技术 SEO 失误。
site:example.com intitle:"index of" —— 检测已被索引的开放目录列表。这既是安全问题也是 SEO 问题。
site:example.com intitle:"duplicate title" —— 配合你已知的重复标题文本使用,以发现大规模重复。
site:example.com intitle:"coming soon" —— 揪出泄漏进索引的占位页面。
site:competitor.com intitle:"best [keyword]" —— 针对竞争对手优化内容的竞品研究。
site: + intext:
site:example.com intext:"noindex"
site:example.com intext:"lorem ipsum"
site:example.com intext:"test page"
作用:筛选出页面正文中包含指定文本的结果。
用例:
site:example.com intext:"lorem ipsum" —— 找出被发布到线上的占位内容。如果客户比你先发现,那就很尴尬了。
site:example.com intext:"add to basket" —— 快速确认电商产品页是否被索引。
site:example.com intext:"affiliate disclosure" —— 审计全站各处的披露声明文本出现位置。
site: + filetype:
site:example.com filetype:pdf
site:example.com filetype:xml
site:example.com filetype:doc
作用:按文件类型筛选。
用例:
site:example.com filetype:pdf —— 找出被 Google 索引的 PDF。审计中经常被忽视;PDF 可以独立获得排名,并稀释链接权重。
site:example.com filetype:xml —— 检查站点地图文件是否被当作页面索引(本不该如此)。
site:competitor.com filetype:pdf —— 竞品研究。对方被索引的 PDF 中常常包含定价、案例研究或指南,否则你根本看不到。
site: + related:
related:seo-stack.io
严格来说这是一个独立的运算符,但在概念上与之搭配得很好。它会显示 Google 认为在主题上相关或相似的站点。可用于发现竞争对手,或理解 Google 如何对你的域名进行归类。
site: + cache:
cache:example.com/specific-page/
显示 Google 对某个具体页面的缓存版本,包括最后一次抓取的日期。可用于检查:
近期的内容改动是否已被收录
Google 实际渲染出的内容是什么(JavaScript 渲染问题在这里会一目了然)
在排查处罚问题时查看页面的历史快照
高级叠加:多运算符组合
到了这一步,site: 才真正成为一件审计利器。
发现重复内容模式
site:example.com intitle:"widget reviews" -inurl:"/widget-reviews/"
找出具有特定标题、但不位于规范 URL 上的页面。适合捕捉被转载或近乎重复的内容。
按内容类型做索引审计
site:example.com/blog/ -inurl:"/author/" -inurl:"/tag/" -inurl:"/category/" -inurl:"/page/"
返回博客文章,同时排除归档页、标签页、作者页和分页页——让你更干净地统计真正的文章内容数量。
竞争对手内容缺口分析
site:competitor.com intitle:"guide" OR intitle:"tutorial" OR intitle:"how to"
快速看清竞争对手长文内容策略的体量和类型。
检测预发布站点泄漏
site:staging.example.com OR site:dev.example.com OR site:test.example.com
检查开发子域是否被 Google 收录。一旦有结果,说明 robots.txt 配置有误或缺少 noindex 响应头。
站内链接(Sitelinks)排查
site:example.com inurl:"/careers/"
site:example.com inurl:"/legal/"
要查清哪些次级页面被收录、可能出现在 sitelinks 中时,按栏目圈定范围比爬取整站更快。
site: 的布尔逻辑
Google 在搜索查询中支持 AND、OR 和 -(NOT)。与 site: 结合,就能做跨域名查询和排除式查询。
多域名对比
site:example.com OR site:competitor.com intitle:"product reviews"
同时返回两个域名下匹配的已收录内容。适合快速做竞品基准对比。
从结果中排除某个栏目
site:example.com -site:example.com/blog/
返回整站内容,但不含博客目录。当博客页面数量远超商业页面、而你想单独评估核心站点时很有用。
检查跨域内容分发问题
site:syndicatedomain.com "original article title text"
检查你的内容是否被抓取并收录到了其他域名上,这会带来重复内容风险。
完整的实战 SEO 用例
1. 审计前的索引健康检查
在开始完整的技术审计之前,先运行:
site:example.com
记下数量。然后运行:
site:example.com inurl:?
site:example.com inurl:/page/
site:example.com inurl:/tag/
如果带参数的、分页的或分类类 URL 把总数撑大了,你立刻就知道该把精力放在哪里。
2. 发现内容自相蚕食
site:example.com intitle:"keyword phrase"
如果多个页面的标题里都带同一个关键词,你就有自相蚕食的风险。等于是在让 Google 在针对同一意图的多个页面之间做选择。
3. 迁移后的索引检查
站点迁移之后,每隔一段时间对新旧域名分别运行子目录级别的 site: 查询。对比已收录页面数,以确认:
旧 URL 正在被移出索引(site:old-domain.com 的结果数下降)
新 URL 正在被收录(site:new-domain.com 的结果数增长)
4. 用站点地图核对收录情况
导出站点地图中的 URL。对每个子目录运行 site: 查询。站点地图数量与 Google 收录数量之间的差距,就是你的索引覆盖缺口——这个缺口需要有解释。
5. 批量识别内容单薄或近似重复的页面
site:example.com intitle:"[模板标题字符串]"
很多 CMS 平台会生成使用模板标题的页面(例如 "Products – Brand Name")。如果出现几百个这样的页面,说明你有单薄内容被收录的问题。
用 site: 做竞争情报
不要只把 site: 用在自己的站点上。竞品方面的用法包括:
总收录页面数:site:competitor.com ——他们可被索引的规模有多大?
内容产出速度:每月监测他们的 site: 结果数。快速增长说明内容策略正在推进。
资源页面:site:competitor.com filetype:pdf ——他们在发布哪些资料?
博客深度:site:competitor.com/blog/ ——他们有多少编辑内容被收录?
结构化定位:site:competitor.com intitle:"[你的目标关键词]" ——他们针对你关心的词在优化哪些内容?
你必须了解的局限
site: 运算符是诊断工具,不是报表工具。它的局限相当明显:
1. 数字不可靠。显示出的数量("About X,XXX results")只是粗略估算,而且会波动。不要把它当作 KPI。准确的索引数据请用 Google Search Console 的索引覆盖率报告。
2. 它不会展示 Google 收录的全部内容。有些已收录页面不会出现在 site: 结果中——尤其是内容单薄的页面、高度重复的内容,或被 Google 抓取但判定价值较低的页面。
3. 结果会个性化。登录状态下的搜索可能受你的搜索历史影响。使用无痕模式可获得更中立的结果。
4. 它不会显示已抓取但未收录的页面。GSC 会区分已抓取(但未收录)、已发现(但未抓取)和已收录。site: 只显示已收录的那一层。
5. 不适合大规模的 URL 级别审计。Google 在搜索结果页中最多只展示约 1,000 个结果。要做大规模的完整索引分析,请使用 GSC、Screaming Frog 或日志文件分析工具。
速查表:site: 运算符
查询 | 用途 |
site:example.com | 总收录页面数 |
site:example.com/subfolder/ | 子目录收录情况 |
子域收录情况 | |
site:example.com -site:blog.example.com | 整站减去某个子域 |
site:example.com inurl:? | 索引中带参数的 URL |
site:example.com inurl:/tag/ | 索引中的标签页 |
site:example.com intitle:"404" | 被收录的错误页 |
site:example.com intitle:"lorem ipsum" | 上线的占位内容 |
site:example.com filetype:pdf | 被收录的 PDF |
site:example.com intext:"lorem ipsum" | 正文中的占位文字 |
site:example.com OR site:competitor.com | 多域名对比 |
site:competitor.com intitle:"[keyword]" | 竞品内容审计 |
site:staging.example.com | 预发布站点泄漏 |
site:example.com -inurl:/blog/ -inurl:/tag/ | 核心页面(排除归档类页面) |
结语
site: 运算符已经是 Google 搜索语法的一部分二十多年了,但大多数 SEO 只把它当成一行简单命令。真正的价值来自把它和 inurl:、intitle:、filetype: 以及布尔逻辑组合起来,提出精确的诊断性问题。
审计开始前跑一遍。迁移完成后跑一遍。针对竞争对手跑一遍。并且始终在清楚这个运算符能告诉你什么、不能告诉你什么的前提下去解读结果。

SEO Stack 创始人
Daniel 是 SEO Stack 的创始人。他在技术 SEO 和搜索数据领域深耕二十余年,在客户项目中一次又一次撞上 Search Console 的同样限制后,他着手打造了 SEO Stack。
Daniel 拥有丰富的 SEO 经验,创办过 SEO 代理机构、审计业务以及一家发展良好的咨询公司。业余时间里,Daniel 喜欢做 SEO 实验并分享实验结果。
发布于 2026年3月18日

