Der komplette Leitfaden zum site:-Operator von Google (und alle Tricks, die SEOs kennen müssen)
Die meisten SEOs wissen, dass es den site:-Operator gibt. Weit weniger nutzen ihn auch nur annähernd aus. Im einfachsten Fall zeigt site:example.com, was Google von einer Domain indexiert hat. Aber …
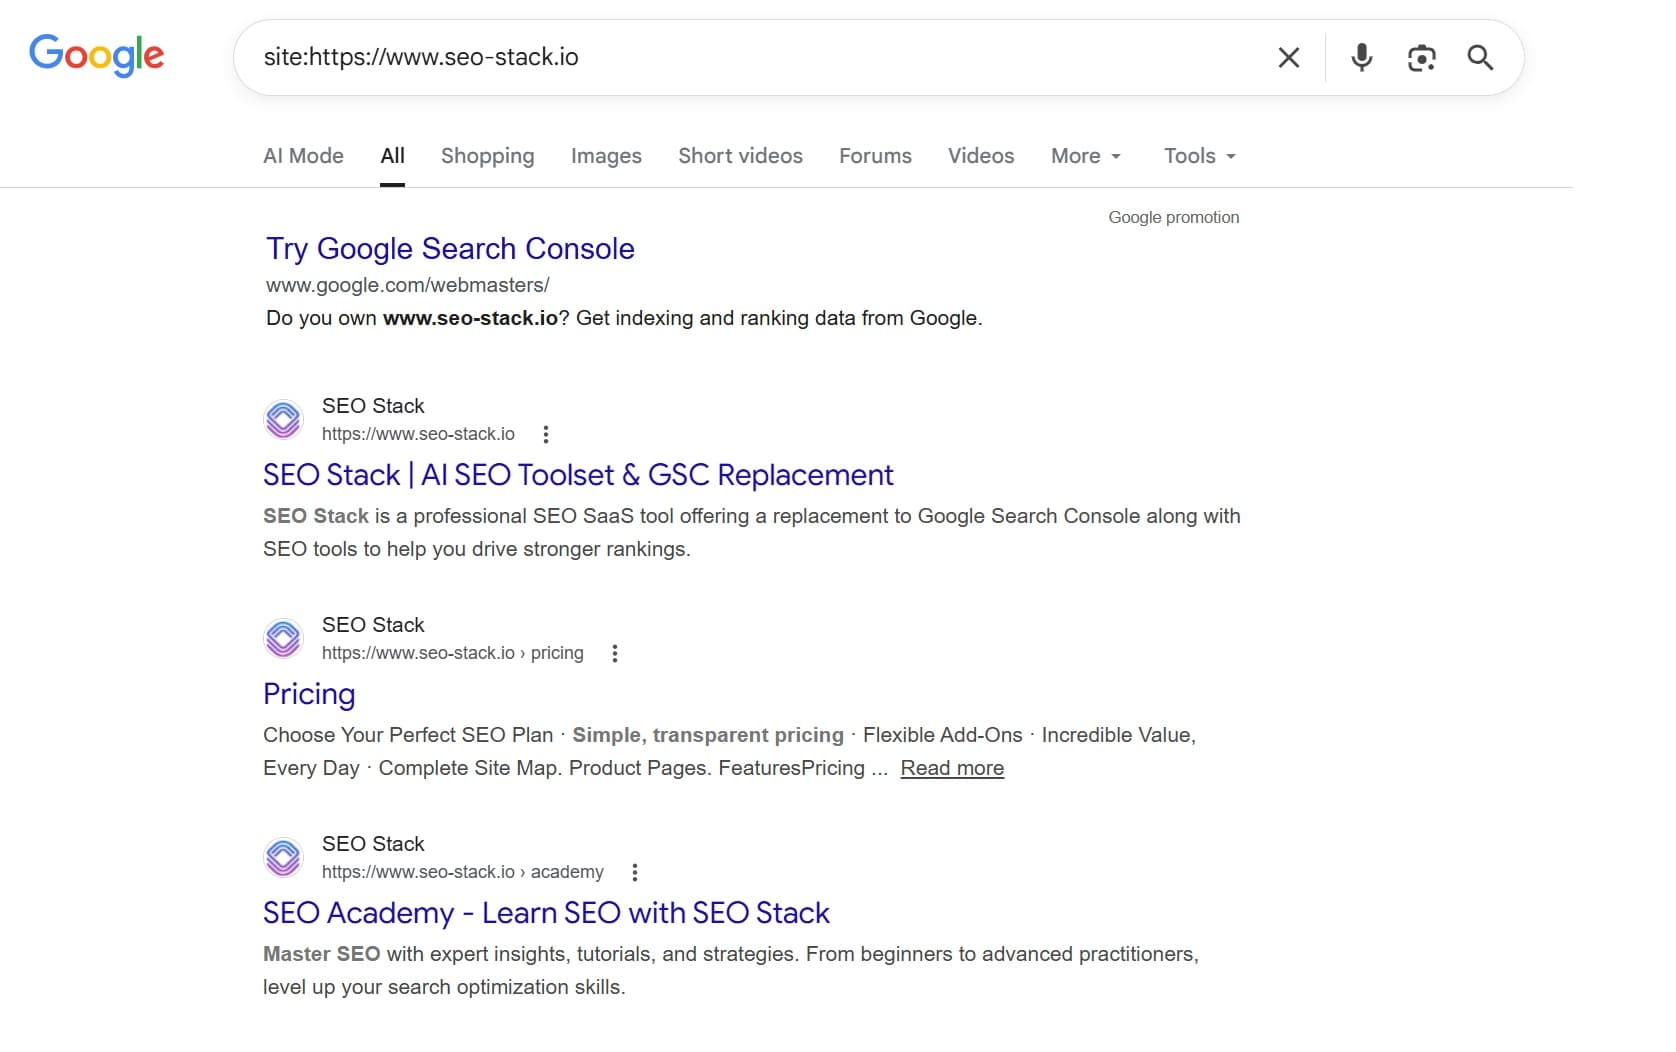
Die meisten SEOs wissen, dass es den site:-Operator gibt. Weitaus weniger nutzen ihn auch nur annähernd aus.
Im einfachsten Fall zeigt site:example.com, was Google von einer Domain indexiert hat. Kombiniert mit weiteren Operatoren, gefiltert nach Unterverzeichnis, eingegrenzt auf eine Subdomain oder verknüpft mit boolescher Logik wird daraus jedoch eines der mächtigsten Diagnosewerkzeuge im technischen SEO. Ganz ohne kostenpflichtige Tools.
Dieser Leitfaden deckt alles ab: die Grundlagen, die fortgeschrittenen Operatoren zum Kombinieren, Anwendungsfälle aus der Praxis und die Einschränkungen, die Sie kennen müssen, bevor Sie den Zahlen vertrauen.
Die Grundlagen: Was site: tatsächlich macht
site:seo-stack.io
Diese Abfrage liefert Googles Index aller Seiten, die es seo-stack.io zuordnet. Die in der Ergebnisleiste angezeigte Zahl („Ungefähr X Ergebnisse“) gibt Ihnen einen groben Wert für die Anzahl indexierter Seiten.
Ein paar Dinge sollten Sie sofort verstehen:
Die Zahl ist eine Schätzung. Google liefert keine präzisen Indexzahlen. Der Wert schwankt zwischen einzelnen Suchen und ist bei großen Websites notorisch unzuverlässig. Bauen Sie darauf kein Reporting auf.
Sie zeigt, was Google indexiert hat, nicht was Sie veröffentlicht haben. Seiten, die per robots.txt blockiert, auf noindex gesetzt oder schlicht noch nicht gecrawlt wurden, tauchen nicht auf.
Subdomains sind standardmäßig enthalten – sofern Sie es nicht anders festlegen (dazu unten mehr).
Das Präfix https:// brauchen Sie nicht. site:seo-stack.io und site:https://www.seo-stack.io funktionieren beide, aber Ersteres ist sauberer.
site: auf Unterverzeichnisse und Subdomains eingrenzen
Hier beginnt site: sich in einem echten Audit zu bewähren.
Indexierung auf Unterverzeichnisebene
site:example.com/blog/
site:example.com/products/
site:example.com/en-gb/
Damit wird die Abfrage auf einen bestimmten Bereich der Website eingegrenzt. Nützlich für:
Den Abgleich, wie viele Blogbeiträge indexiert vs. veröffentlicht sind
Die Diagnose von Indexierungslücken in einer E-Commerce-Kategorie
Das separate Auditieren internationaler Unterverzeichnisse
Praxisbeispiel: Wenn site:example.com/blog/ 47 Ergebnisse liefert, Sie aber 200 Beiträge veröffentlicht haben, haben Sie ein Indexierungsproblem – Canonicalisation, noindex-Tags, Crawl-Budget oder Thin Content sind die wahrscheinlichen Ursachen.
Indexierung auf Subdomain-Ebene
site:blog.example.com
site:app.example.com
site:support.example.com
Das beschränkt die Ergebnisse auf eine bestimmte Subdomain. Nützlich, wenn eine Website Subdomains für verschiedene Umgebungen nutzt (Blog, App, Support-Doku, Staging) und Sie jede einzeln auditieren wollen.
Subdomains ausschließen
site:example.com -site:blog.example.com
Zeigt alle indexierten Inhalte auf example.com außer der Blog-Subdomain. Gut geeignet, um die Kernwebsite zu isolieren, wenn eine Blog- oder Doku-Subdomain die Zahl aufbläht.
Operatoren kombinieren: Hier wird es mächtig
Der site:-Operator wird wirklich diagnostisch, wenn er mit anderen kombiniert wird. Hier die nützlichsten Kombinationen.
site: + inurl:
site:example.com inurl:category
site:example.com inurl:?
site:example.com inurl:page
Was es macht: Filtert indexierte Seiten, deren URL eine bestimmte Zeichenfolge enthält.
Anwendungsfälle:
site:example.com inurl:? – deckt facettierte oder parametrisierte URLs auf, die indexiert wurden. Wenn Sie hier Tausende Ergebnisse sehen, haben Sie wahrscheinlich ein Crawl-Budget- oder Duplicate-Content-Problem.
site:example.com inurl:/tag/ – findet indexierte Tag-Seiten auf WordPress-Websites, die häufig dünn sind und auf noindex gesetzt werden sollten.
site:example.com inurl:utm_ – zeigt, ob UTM-getaggte URLs indexiert wurden (sollten sie nicht).
site:example.com inurl:print – deckt indexierte Druckversionen von Seiten auf.
site: + intitle:
site:example.com intitle:"buy"
site:example.com intitle:"login"
site:example.com intitle:"404"
Was es macht: Filtert Ergebnisse, bei denen der Seitentitel das angegebene Wort oder die angegebene Phrase enthält.
Anwendungsfälle:
site:example.com intitle:"404" – findet 404-Fehlerseiten, die Google mit „404“ im Titel indexiert hat. Ein häufiger technischer SEO-Fehler.
site:example.com intitle:"index of" – erkennt offene Verzeichnisauflistungen, die indexiert wurden. Ein Sicherheits- und SEO-Problem.
site:example.com intitle:"duplicate title" – mit Ihrem bekannten doppelten Titeltext verwenden, um massenhafte Duplikate aufzuspüren.
site:example.com intitle:"coming soon" – findet Platzhalterseiten, die in den Index gelangt sind.
site:competitor.com intitle:"best [keyword]" – Wettbewerbsrecherche zu den optimierten Inhalten eines Konkurrenten.
site: + intext:
site:example.com intext:"noindex"
site:example.com intext:"lorem ipsum"
site:example.com intext:"test page"
Was es macht: Filtert Ergebnisse, bei denen der Seiteninhalt den angegebenen Text enthält.
Anwendungsfälle:
site:example.com intext:"lorem ipsum" – findet Platzhalterinhalte, die live veröffentlicht wurden. Peinlich, wenn ein Kunde das vor Ihnen entdeckt.
site:example.com intext:"add to basket" – schnell prüfen, ob E-Commerce-Produktseiten indexiert sind.
site:example.com intext:"affiliate disclosure" – prüfen, wo auf einer Website Offenlegungstexte erscheinen.
site: + filetype:
site:example.com filetype:pdf
site:example.com filetype:xml
site:example.com filetype:doc
Was es macht: Filtert nach Dateityp.
Anwendungsfälle:
site:example.com filetype:pdf – zeigt PDFs, die Google indexiert hat. In Audits oft übersehen; PDFs können eigenständig ranken und Link Equity verwässern.
site:example.com filetype:xml – prüfen, ob Sitemap-Dateien als Seiten indexiert sind (sollten sie nicht).
site:competitor.com filetype:pdf – Wettbewerbsrecherche. Deren indexierte PDFs enthalten häufig Preise, Fallstudien oder Guides, die Ihnen sonst entgehen würden.
site: + related:
related:seo-stack.io
Technisch gesehen ein eigener Operator, der konzeptionell aber gut dazupasst. Zeigt Websites, die Google als thematisch verwandt oder ähnlich einstuft. Nutzen Sie ihn, um Wettbewerber zu entdecken oder zu verstehen, wie Google Ihre Domain einordnet.
site: + cache:
cache:example.com/specific-page/
Zeigt Googles Cache-Version einer bestimmten Seite, inklusive des Datums des letzten Crawls. Nützlich, um zu prüfen:
Ob jüngste Inhaltsänderungen erfasst wurden
Was Google tatsächlich rendert (JavaScript-Rendering-Probleme werden hier offensichtlich)
Historische Snapshots einer Seite bei der Untersuchung einer Penalty
Fortgeschrittenes Kombinieren: Multi-Operator-Abfragen
Hier wird site: zu einem echten Audit-Instrument.
Duplicate-Content-Muster finden
site:example.com intitle:"widget reviews" -inurl:"/widget-reviews/"
Zeigt Seiten mit einem bestimmten Titel, die nicht unter der kanonischen URL liegen. Nützlich, um syndizierte oder nahezu identische Inhalte aufzuspüren.
Indexierungs-Audit nach Inhaltstyp
site:example.com/blog/ -inurl:"/author/" -inurl:"/tag/" -inurl:"/category/" -inurl:"/page/"
Liefert Blogbeiträge und schließt Archiv-, Tag-, Autoren- und Paginierungsseiten aus – das ergibt eine sauberere Zahl der tatsächlichen Artikelinhalte.
Content-Gap-Analyse beim Wettbewerb
site:competitor.com intitle:"guide" OR intitle:"tutorial" OR intitle:"how to"
Zeigt schnell Umfang und Art der Long-Form-Content-Strategie eines Wettbewerbers.
Staging-Websites im Index aufspüren
site:staging.example.com OR site:dev.example.com OR site:test.example.com
Prüft, ob Entwicklungs-Subdomains in Googles Index gelangt sind. Ein Treffer hier bedeutet eine fehlerhafte robots.txt-Konfiguration oder fehlende noindex-Header.
Sitelinks untersuchen
site:example.com inurl:"/careers/"
site:example.com inurl:"/legal/"
Wenn Sie untersuchen, welche sekundären Seiten indexiert sind und als Sitelinks erscheinen könnten, ist die Eingrenzung nach Bereich schneller als ein Crawl.
Boolesche Logik mit site:
Google unterstützt AND, OR und - (NOT) innerhalb von Suchanfragen. In Kombination mit site: eröffnet das Abfragen über mehrere Domains hinweg sowie Ausschlussabfragen.
Vergleich mehrerer Domains
site:example.com OR site:competitor.com intitle:"product reviews"
Liefert passende indexierte Inhalte aus beiden Domains gleichzeitig. Gut für schnelles Competitive Benchmarking.
Einen Bereich aus den Ergebnissen ausschließen
site:example.com -site:example.com/blog/
Liefert die gesamte Website abzüglich des Blog-Verzeichnisses. Nützlich, wenn der Blog die kommerziellen Seiten zahlenmäßig weit übersteigt und Sie die Kernwebsite separat bewerten wollen.
Auf Content-Syndication-Probleme über Domains hinweg prüfen
site:syndicatedomain.com "original article title text"
Prüft, ob Ihre Inhalte gescrapt und auf einer anderen Domain indexiert wurden, was ein Duplicate-Content-Risiko erzeugen kann.
Praktische SEO-Anwendungsfälle, von Anfang bis Ende
1. Indexierungs-Check vor dem Audit
Bevor Sie ein vollständiges technisches Audit starten, führen Sie aus:
site:example.com
Notieren Sie die Zahl. Dann führen Sie aus:
site:example.com inurl:?
site:example.com inurl:/page/
site:example.com inurl:/tag/
Wenn parametrisierte, paginierte oder taxonomische URLs die Gesamtzahl aufblähen, wissen Sie sofort, worauf Sie sich konzentrieren müssen.
2. Content-Kannibalisierung erkennen
site:example.com intitle:"keyword phrase"
Wenn mehrere Seiten mit demselben Keyword im Titel zurückkommen, besteht Kannibalisierungsrisiko. Google muss sich dann zwischen konkurrierenden Seiten für dieselbe Suchintention entscheiden.
3. Indexierungs-Check nach einer Migration
Führen Sie nach einer Website-Migration in Intervallen site:-Abfragen auf Unterverzeichnisebene für die alte und die neue Domain aus. Vergleichen Sie die Anzahl indexierter Seiten, um zu bestätigen:
Alte URLs werden deindexiert (Rückgang der Ergebnisse für site:old-domain.com)
Neue URLs werden indexiert (Zuwachs der Ergebnisse für site:new-domain.com)
4. Indexierung gegen Ihre Sitemap prüfen
Exportieren Sie Ihre Sitemap-URLs. Führen Sie für jedes Unterverzeichnis eine site:-Abfrage aus. Die Differenz zwischen Ihrer Sitemap-Zahl und Googles indexierter Zahl ist Ihre Indexierungslücke – und die muss erklärt werden.
5. Thin Content oder Near-Duplicates in großem Maßstab erkennen
site:example.com intitle:"[boilerplate title string]"
Viele CMS-Plattformen erzeugen Seiten mit Template-Titeln (z. B. „Products – Brand Name“). Wenn Hunderte davon auftauchen, haben Sie ein Indexierungsproblem mit Thin Content.
site: für Competitive Intelligence
Beschränken Sie site: nicht auf Ihre eigenen Properties. Anwendungsfälle im Wettbewerbsumfeld:
Indexierte Seiten insgesamt: site:competitor.com – wie groß ist deren indexierbarer Fußabdruck?
Content-Geschwindigkeit: Beobachten Sie die site:-Zahl monatlich. Schnelles Wachstum deutet auf eine aktive Content-Strategie hin.
Ressourcenseiten: site:competitor.com filetype:pdf – welche Assets veröffentlichen sie?
Blog-Tiefe: site:competitor.com/blog/ – wie viele redaktionelle Inhalte haben sie indexiert?
Gezielte Ausrichtung: site:competitor.com intitle:"[Ihr Ziel-Keyword]" – auf welche Inhalte optimieren sie für Begriffe, die für Sie relevant sind?
Einschränkungen, die Sie kennen müssen
Der site:-Operator ist ein Diagnosewerkzeug, kein Reporting-Instrument. Seine Einschränkungen sind erheblich:
1. Die Zahl ist unzuverlässig. Der angezeigte Wert („Ungefähr X.XXX Ergebnisse“) ist eine grobe Schätzung und schwankt. Nutzen Sie ihn nicht als KPI. Verwenden Sie für belastbare Indexierungsdaten den Index-Coverage-Bericht in Google Search Console.
2. Er zeigt nicht alles, was Google indexiert hat. Manche indexierten Seiten erscheinen nicht in den site:-Ergebnissen – insbesondere dünne Seiten, stark duplizierte Inhalte oder Seiten, die Google gecrawlt, aber als geringwertig eingestuft hat.
3. Ergebnisse sind personalisiert. Suchanfragen im eingeloggten Zustand können von Ihrem Suchverlauf beeinflusst sein. Nutzen Sie den Inkognito-Modus für neutralere Ergebnisse.
4. Er zeigt keine gecrawlten, aber nicht indexierten Seiten. GSC unterscheidet zwischen gecrawlt (aber nicht indexiert), gefunden (aber nicht gecrawlt) und indexiert. site: zeigt nur die indexierte Ebene.
5. Nicht geeignet für großflächige Audits auf URL-Ebene. Google begrenzt die Ergebnisse in der SERP auf rund 1.000 Seiten. Für vollständige Indexierungsanalysen in großem Maßstab nutzen Sie GSC, Screaming Frog oder ein Logfile-Analysetool.
Kurzübersicht: site:-Operator-Cheatsheet
Abfrage | Anwendungsfall |
site:example.com | Indexierte Seiten insgesamt |
site:example.com/subfolder/ | Indexierung eines Unterverzeichnisses |
Indexierung einer Subdomain | |
site:example.com -site:blog.example.com | Website ohne Subdomain |
site:example.com inurl:? | Parametrisierte URLs im Index |
site:example.com inurl:/tag/ | Tag-Seiten im Index |
site:example.com intitle:"404" | Indexierte Fehlerseiten |
site:example.com intitle:"lorem ipsum" | Platzhalterinhalte live |
site:example.com filetype:pdf | Indexierte PDFs |
site:example.com intext:"lorem ipsum" | Platzhaltertext im Seiteninhalt |
site:example.com OR site:competitor.com | Vergleich mehrerer Domains |
site:competitor.com intitle:"[keyword]" | Content-Audit beim Wettbewerb |
site:staging.example.com | Staging-Website im Index |
site:example.com -inurl:/blog/ -inurl:/tag/ | Kernseiten ohne Archivtypen |
Schlusswort
Den site:-Operator gibt es in Googles Suchsyntax seit über zwei Jahrzehnten, dennoch behandeln ihn die meisten SEOs als Einzeiler. Der wirkliche Mehrwert entsteht durch die Kombination mit inurl:, intitle:, filetype: und boolescher Logik, um präzise diagnostische Fragen zu stellen.
Setzen Sie ihn vor dem Start eines Audits ein. Setzen Sie ihn nach einer Migration ein. Setzen Sie ihn bei Wettbewerbern ein. Und interpretieren Sie die Ergebnisse immer im Bewusstsein dessen, was der Operator Ihnen sagen kann – und was nicht.

Gründer, SEO Stack
Daniel ist der Gründer von SEO Stack. Er arbeitet seit über 2 Jahrzehnten an technischem SEO und Suchdaten und hat SEO Stack entwickelt, nachdem er in der Kundenarbeit einmal zu oft an dieselben Search-Console-Limits gestoßen war.
Daniel verfügt über umfangreiche SEO-Erfahrung: Er hat SEO-Agenturen, Audit-Unternehmen und eine erfolgreiche Beratung aufgebaut. In seiner Freizeit führt Daniel gerne SEO-Experimente durch und teilt seine Erkenntnisse.
Veröffentlicht 18. März 2026

