Google Search Console URL 检查工具完全指南
Google Search Console 的网址检查(URL Inspection)工具,堪称当下 SEO 工具箱中最有用的单项诊断工具。只有在这里,Google 才会针对你……
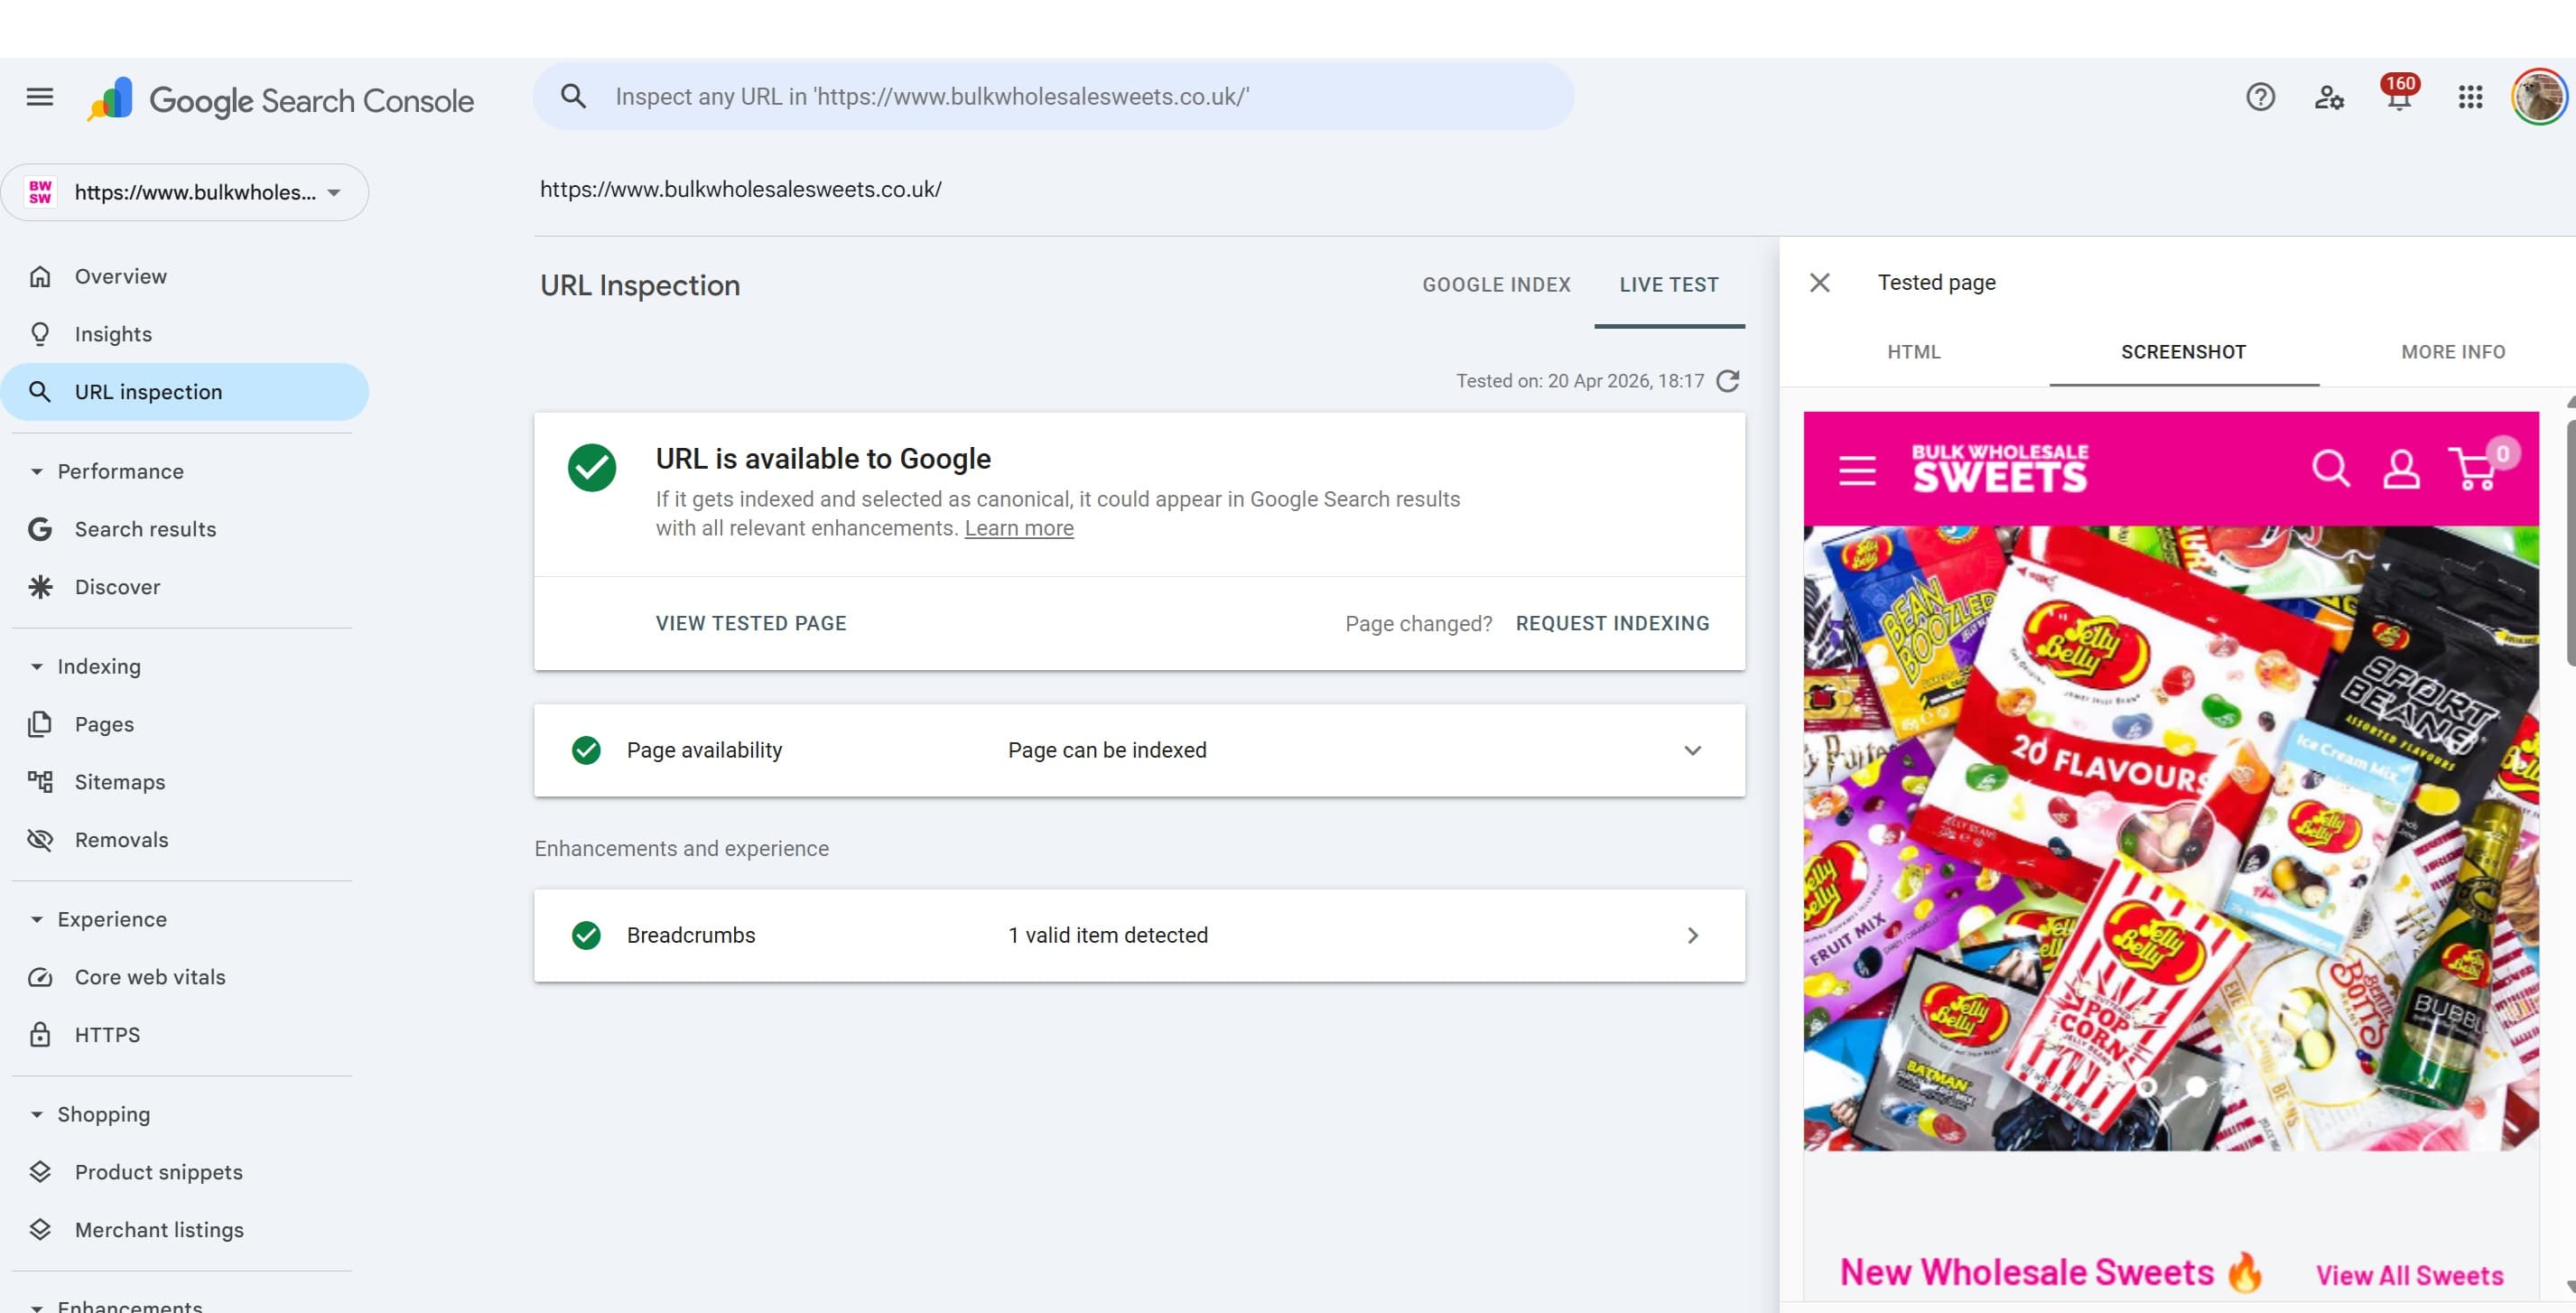
Google Search Console 的网址检查(URL Inspection)工具,可以说是现代 SEO 工具箱中最有用的单一诊断工具。只有在这里,Google 才会针对你提交的每一个网址,告诉你它究竟如何看待某个特定页面:是否已被编入索引、如何被渲染、抓取了哪些资源、规范网址是什么,以及 Google 最终决定如何处理它。
对于一个大多数 SEO 每天都会用到的工具来说,它被低估的程度令人意外。多数人只是用它快速确认一下"这个页面收录了吗?",然后就跳过了,却没意识到在已测试页面视图里,只需再点一下就能看到多么深入的诊断数据。本指南旨在成为一份全面的参考,帮你把 Google 网址检查的价值榨干。
什么是网址检查工具?
网址检查工具是 Google Search Console(GSC)中的一项功能,它会返回 Google 自己对某个已验证资源中单个网址的认知。它位于每个 GSC 资源顶部,是一个标有"检查 [资源名称] 中的任意网址"的搜索框,也可以通过左侧导航访问。
它本质上是一个网址层级的诊断工具。"网页"或"核心网页指标"等报告展示的是全站的汇总数据,而网址检查只聚焦于 1 个网址,并告诉你:
该网址当前是否在 Google 索引中
Google 为其指定了什么索引状态(以及原因)
上次抓取的时间以及使用的 user agent
Google 选择的规范网址(与你声明的规范网址对比)
Google 执行 JavaScript 后生成的渲染后 HTML
页面渲染效果的截图
HTTP 响应标头和状态码
Google 尝试加载的所有页面资源,以及哪些加载失败
渲染过程中产生的 JavaScript 控制台消息
检测到的各类增强功能(结构化数据、HTTPS 等)
页面是如何被发现的(站点地图、引荐页面)
这些信息没有其他来源可以获取。第三方爬虫可以模拟 Googlebot,但它们无法告诉你 Google 实际上对你的网址做了什么。网址检查可以。
网址检查工具是如何工作的?
Google 的网址检查工具允许用户查看缓存状态或实时状态下的网址情况,理解两者的区别是有效使用它的基础。
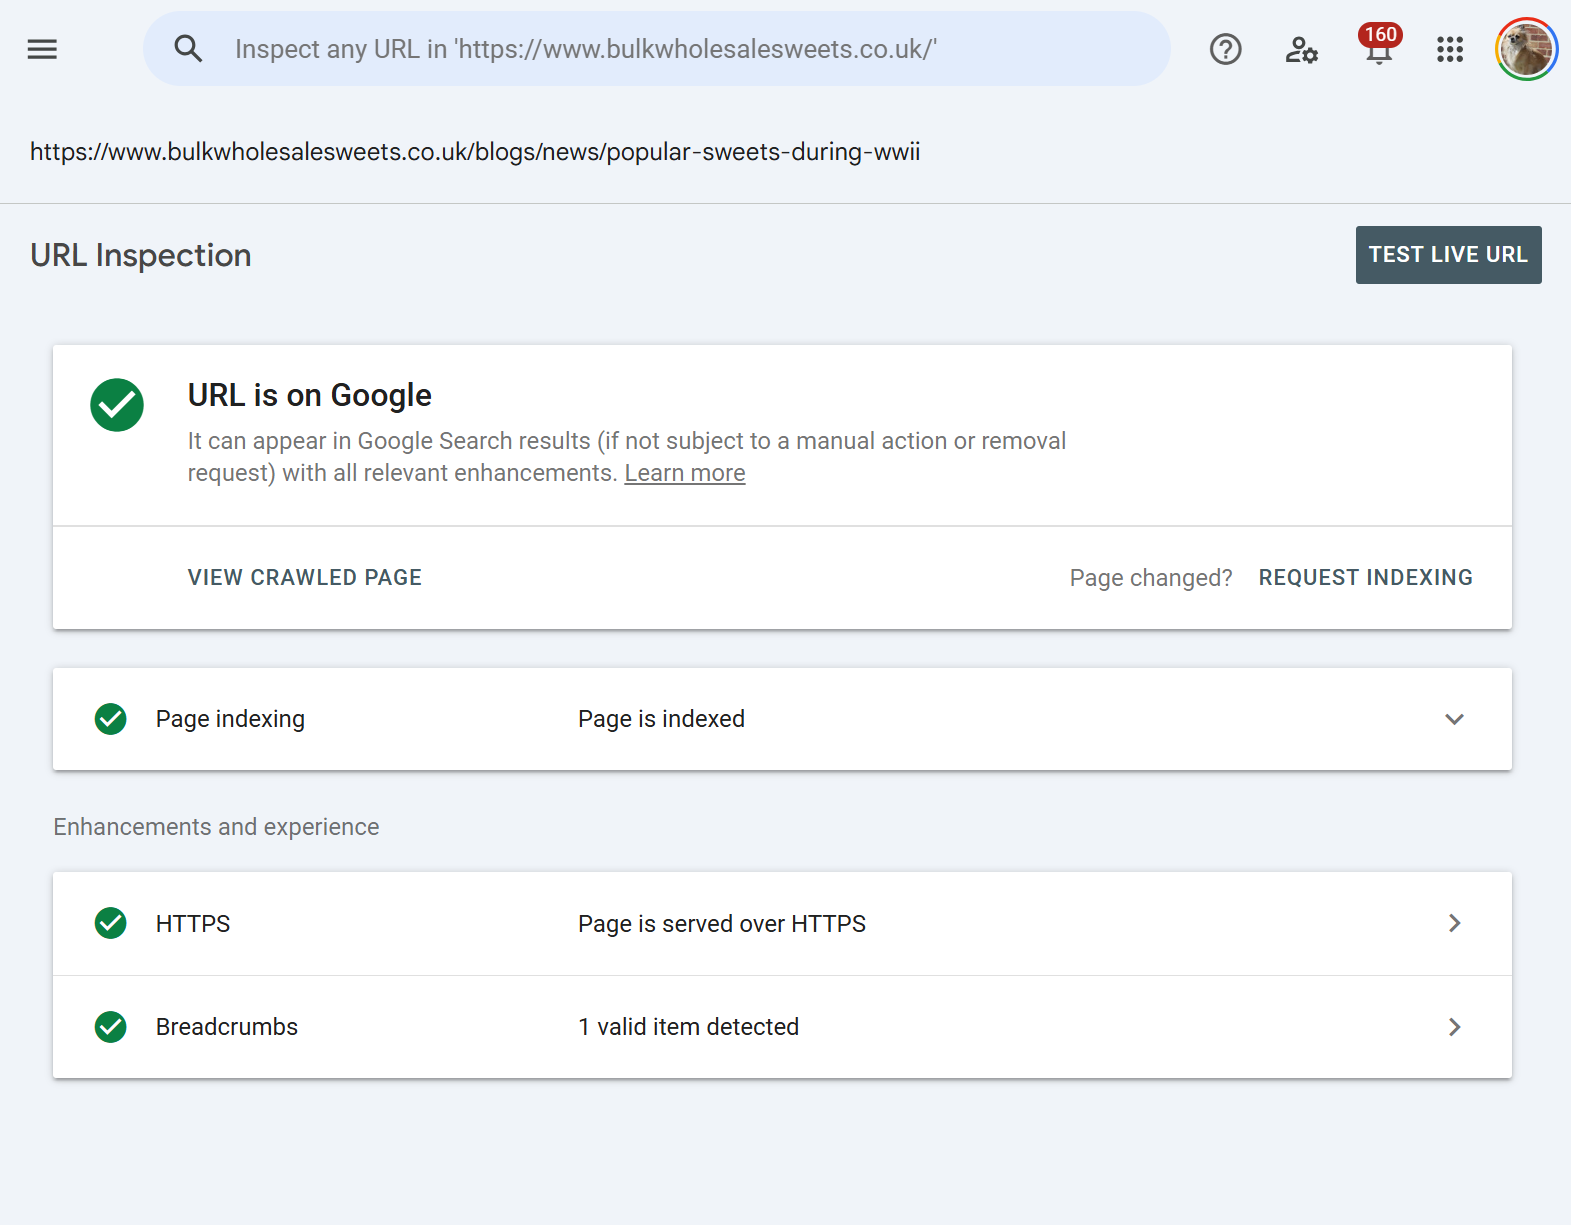
缓存检查(默认模式)
返回的是 Google 索引中的数据。当你粘贴一个网址并按下回车时,你并没有触发一次新的抓取,而是基于 Google 对该网址的上一次抓取拉取了一份最新报告。那次抓取可能发生在几分钟前、几天前,对于低优先级或孤立网址来说,也可能是几个月前。覆盖范围详情里的"上次抓取"时间戳会准确告诉你具体时间。
这个模式回答的问题是:"Google 目前对这个网址的认知是什么?"
测试实际网址会使用 Googlebot Smartphone 对该网址发起一次实时的全新抓取。Google 会向你的服务器发送 HTTP 请求,在较新版本的 Chromium 中渲染页面,并返回结果。关键在于,实时测试不会更新索引。它只是一个预览,展示如果 Google 现在抓取该页面会看到什么。如果实时测试结果良好,你随后可以选择"请求编入索引"。
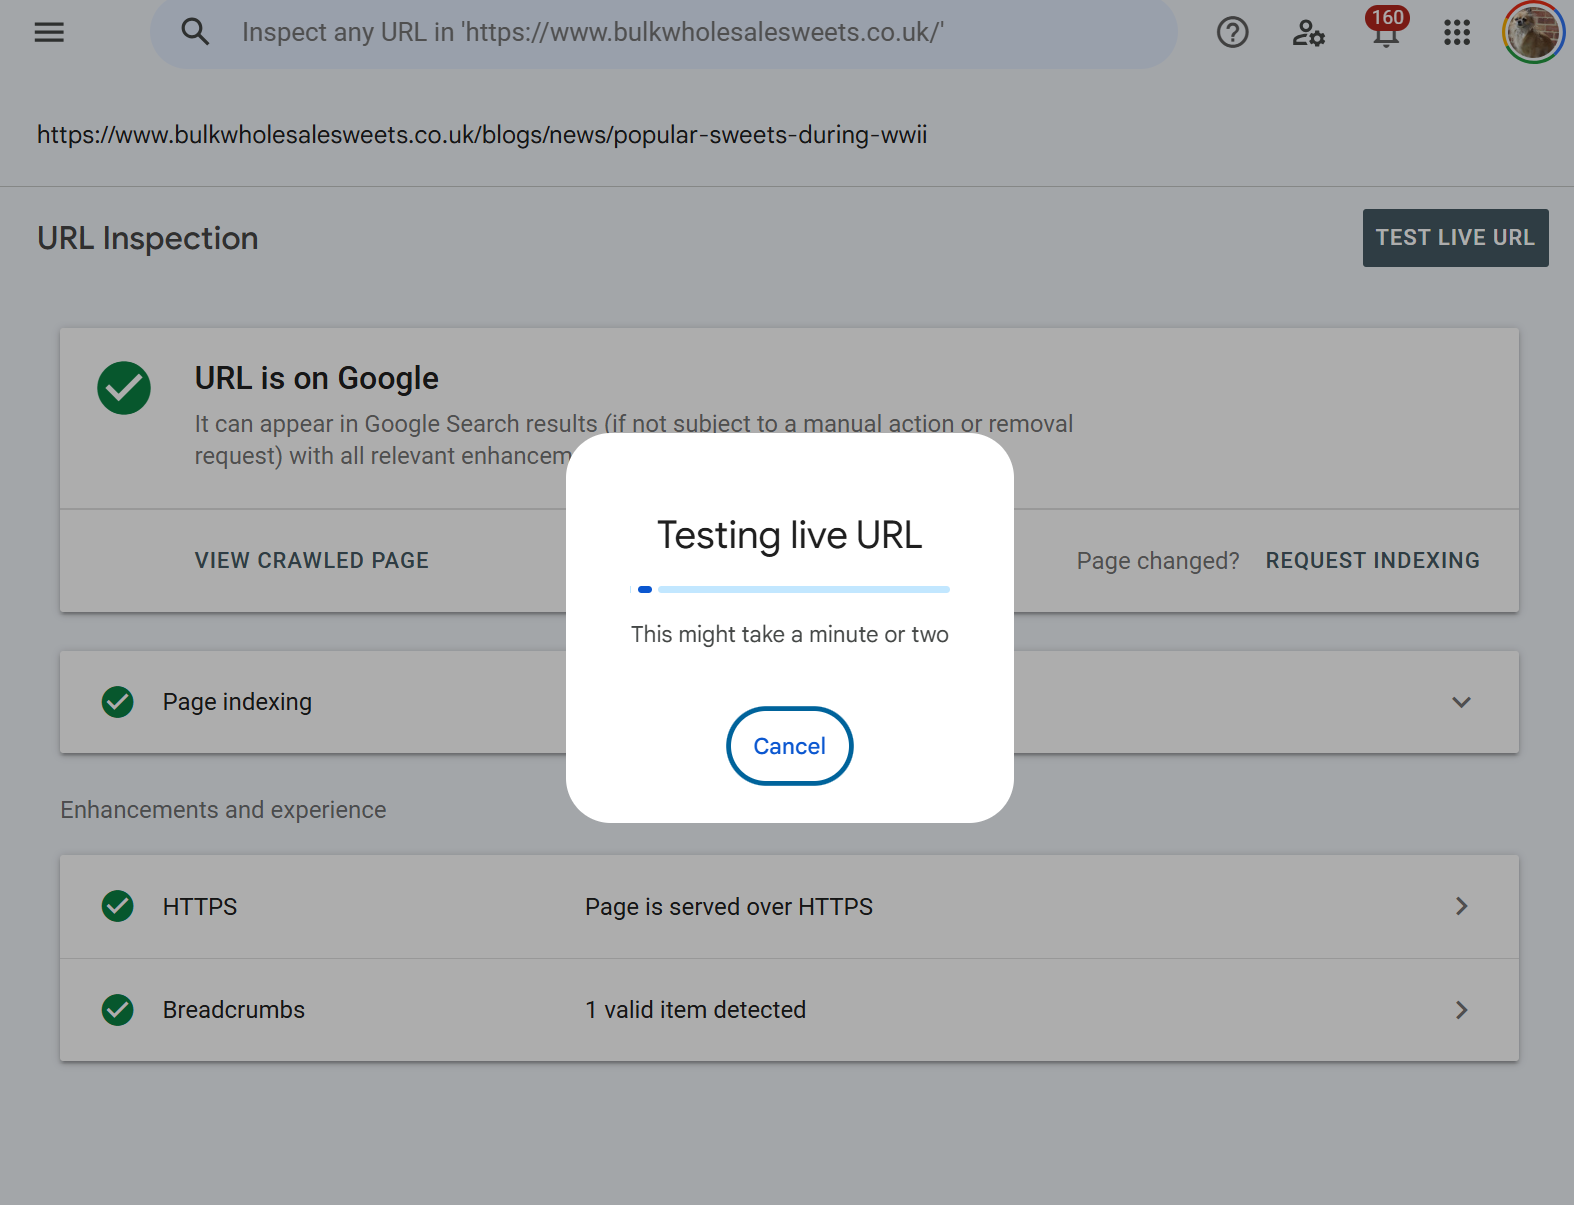
实时网址检查本质上就是——"如果 Google 今天访问这个网址,会看到什么?"
典型的诊断流程会依次使用这两种模式。先检查缓存数据,了解当前的索引状态并找出问题,然后进行实时测试,确认修复已部署且对 Googlebot 可见。
为什么网址检查很重要?
有几类 SEO 问题,网址检查都极其有用(在大多数情况下更是必不可少)
网址层级的索引诊断
"网页"报告会告诉你有 4,200 个网址处于"已抓取 - 尚未编入索引"状态。网址检查则告诉你某个具体网址为什么会落入这一类、Google 做出该判断时抓取到了什么,以及渲染输出是什么样的。
网址检查只返回针对单个网址的索引状态及相关属性。
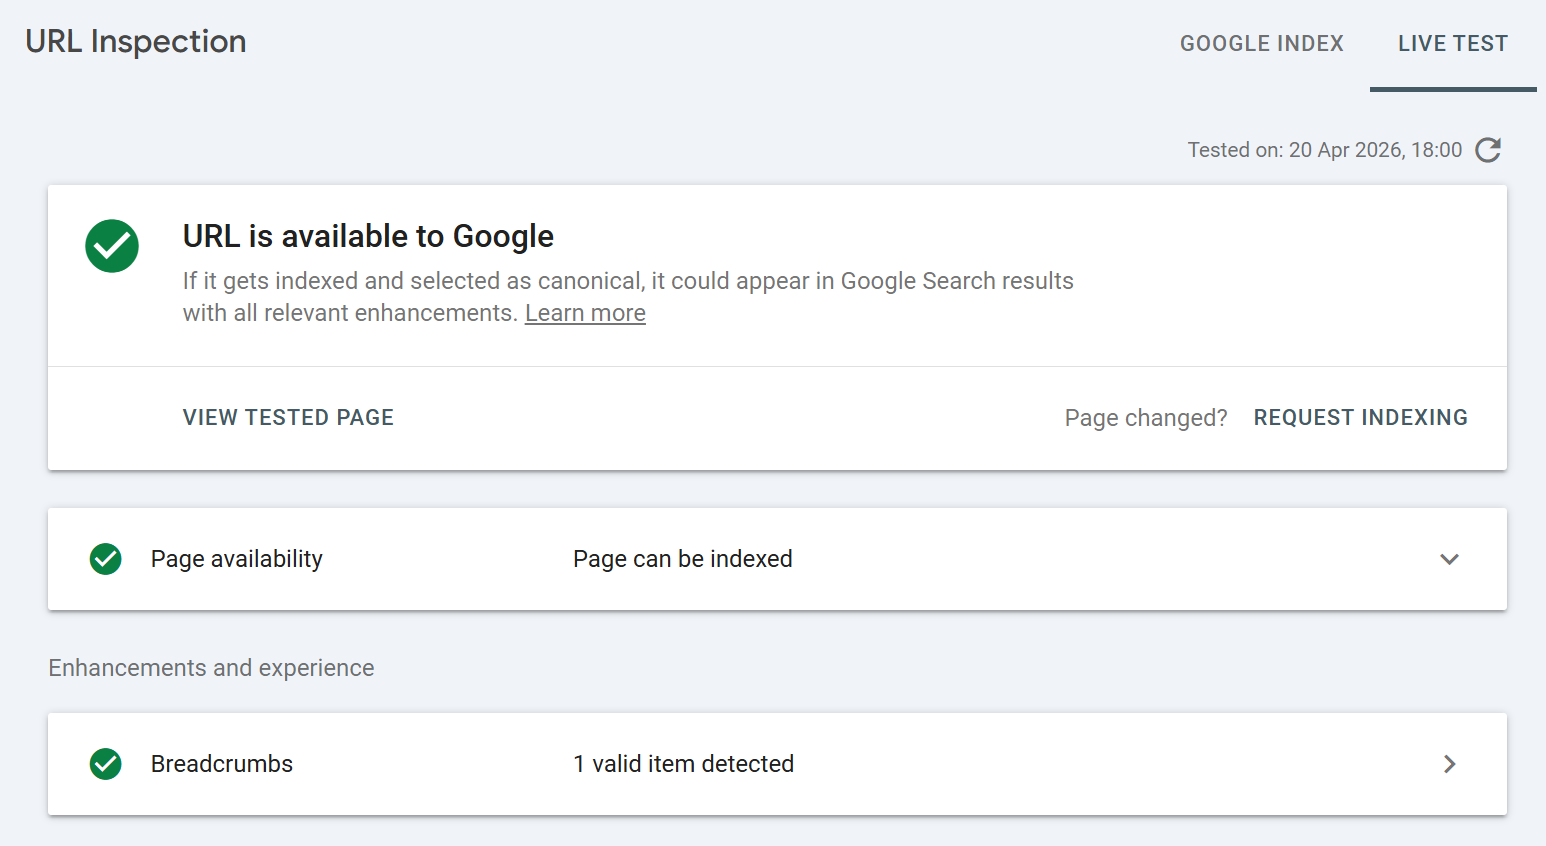
修复验证
你更新了 noindex 标签、修正了规范标签、清除了重定向链,或部署了模板变更。网址检查的实时测试让你在干等下一次自然重新抓取之前,就能确认修复确实已上线并对 Googlebot 可见。
JavaScript 渲染验证
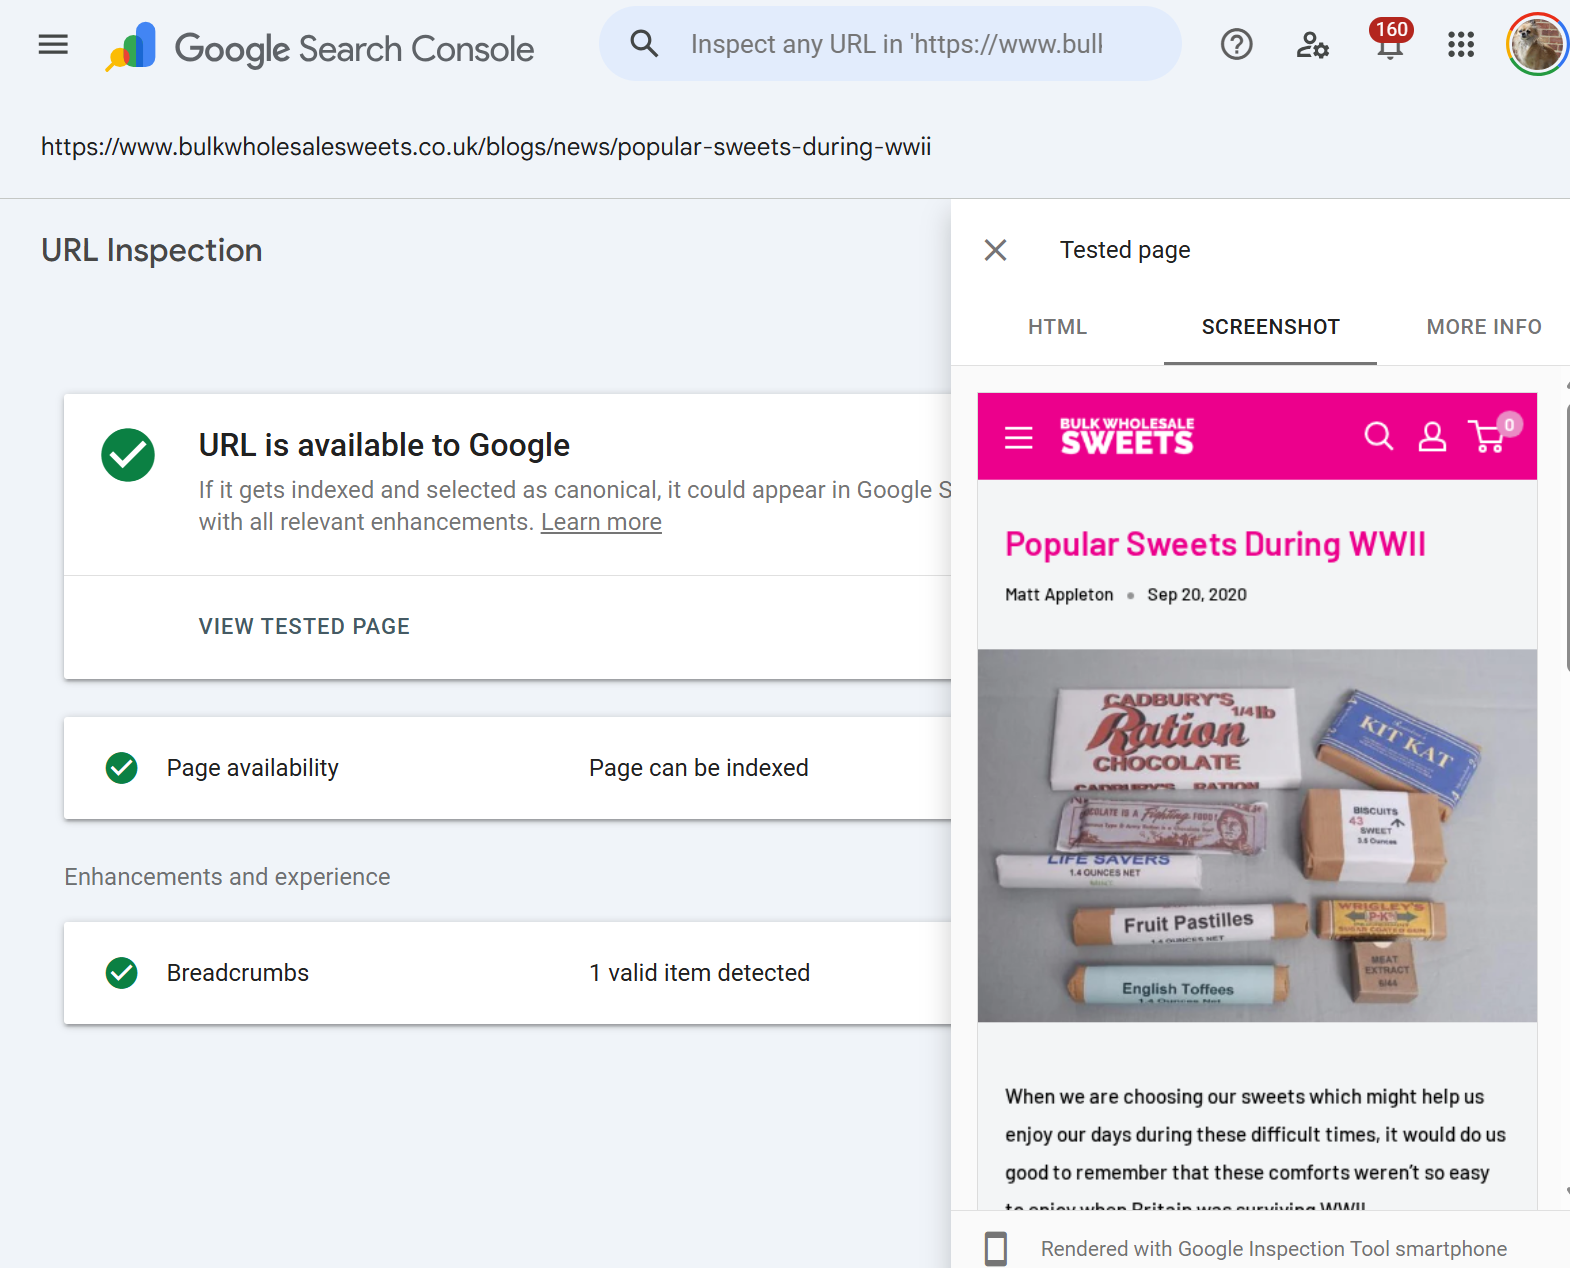
对于任何依赖客户端渲染、hydration 或框架加载内容的网站,网址检查的渲染后 HTML 视图可以让你看到 Google 从检查期间获取的 HTML 源码中渲染出了什么 >
规范标签审核
Google 选择的规范网址可能与你声明的规范网址不一致。网址检查正是让这种差异变得明显的地方,而它往往就是"这个页面为什么没被收录?"的根本原因。
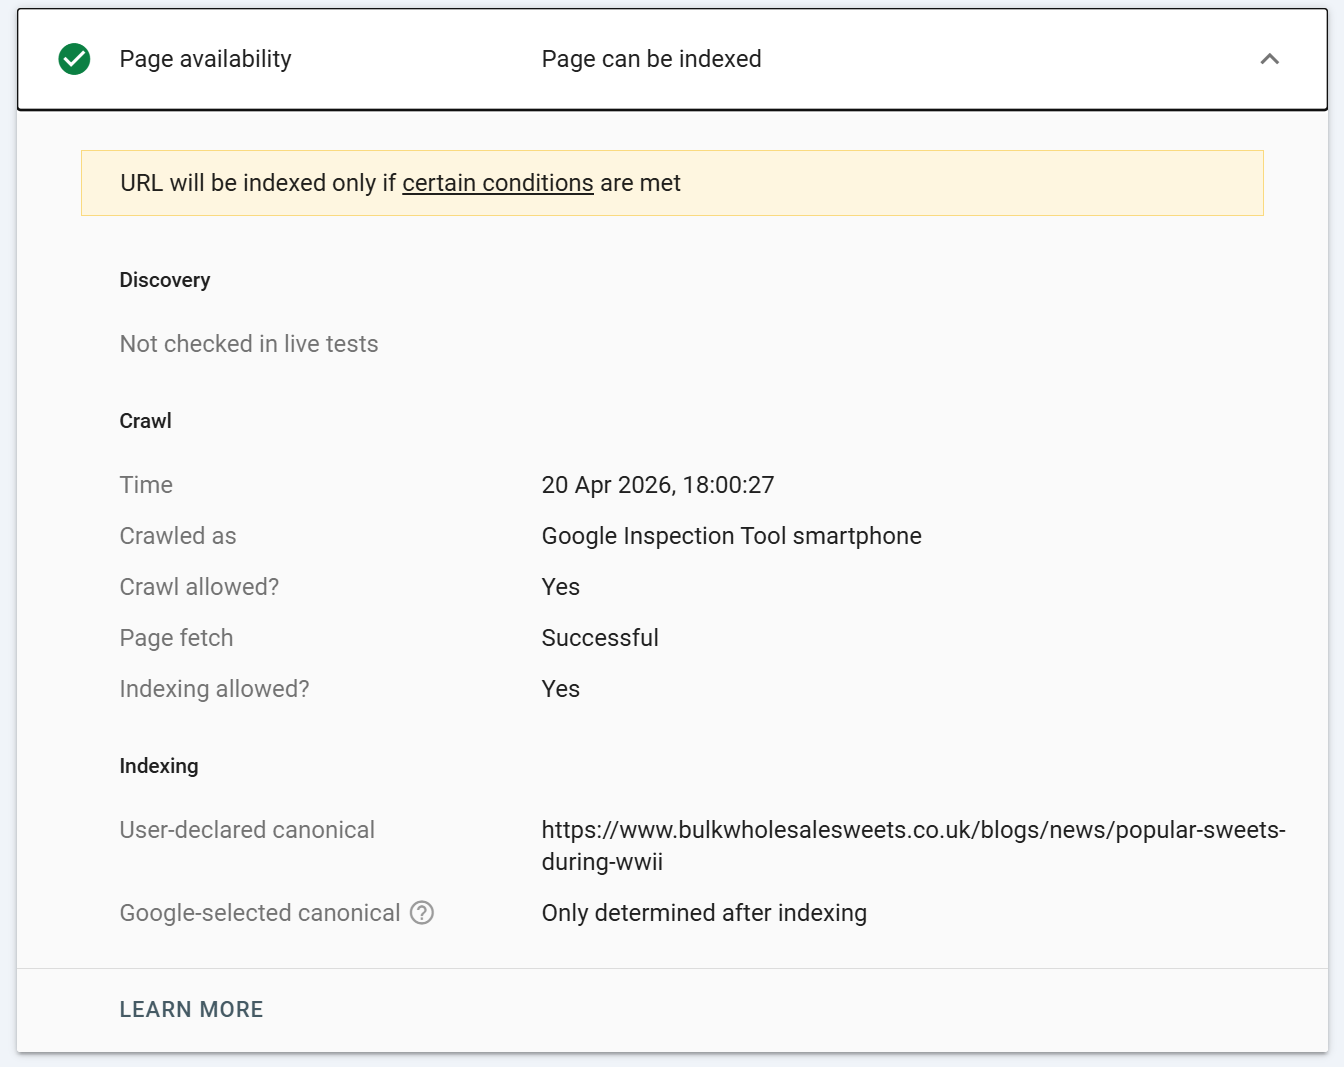
如果某个网址未被编入索引,就不会显示 Google 选择的规范网址。如果网址已被编入索引,且 Google 选择的规范网址与用户声明的规范网址一致,那就没有问题。
但如果 Google 选择的规范网址与用户声明的规范网址不同,通常意味着 Google 忽略了你为该网址设定的规范路径,这可能表明存在规范化问题。
结构化数据与增强功能验证
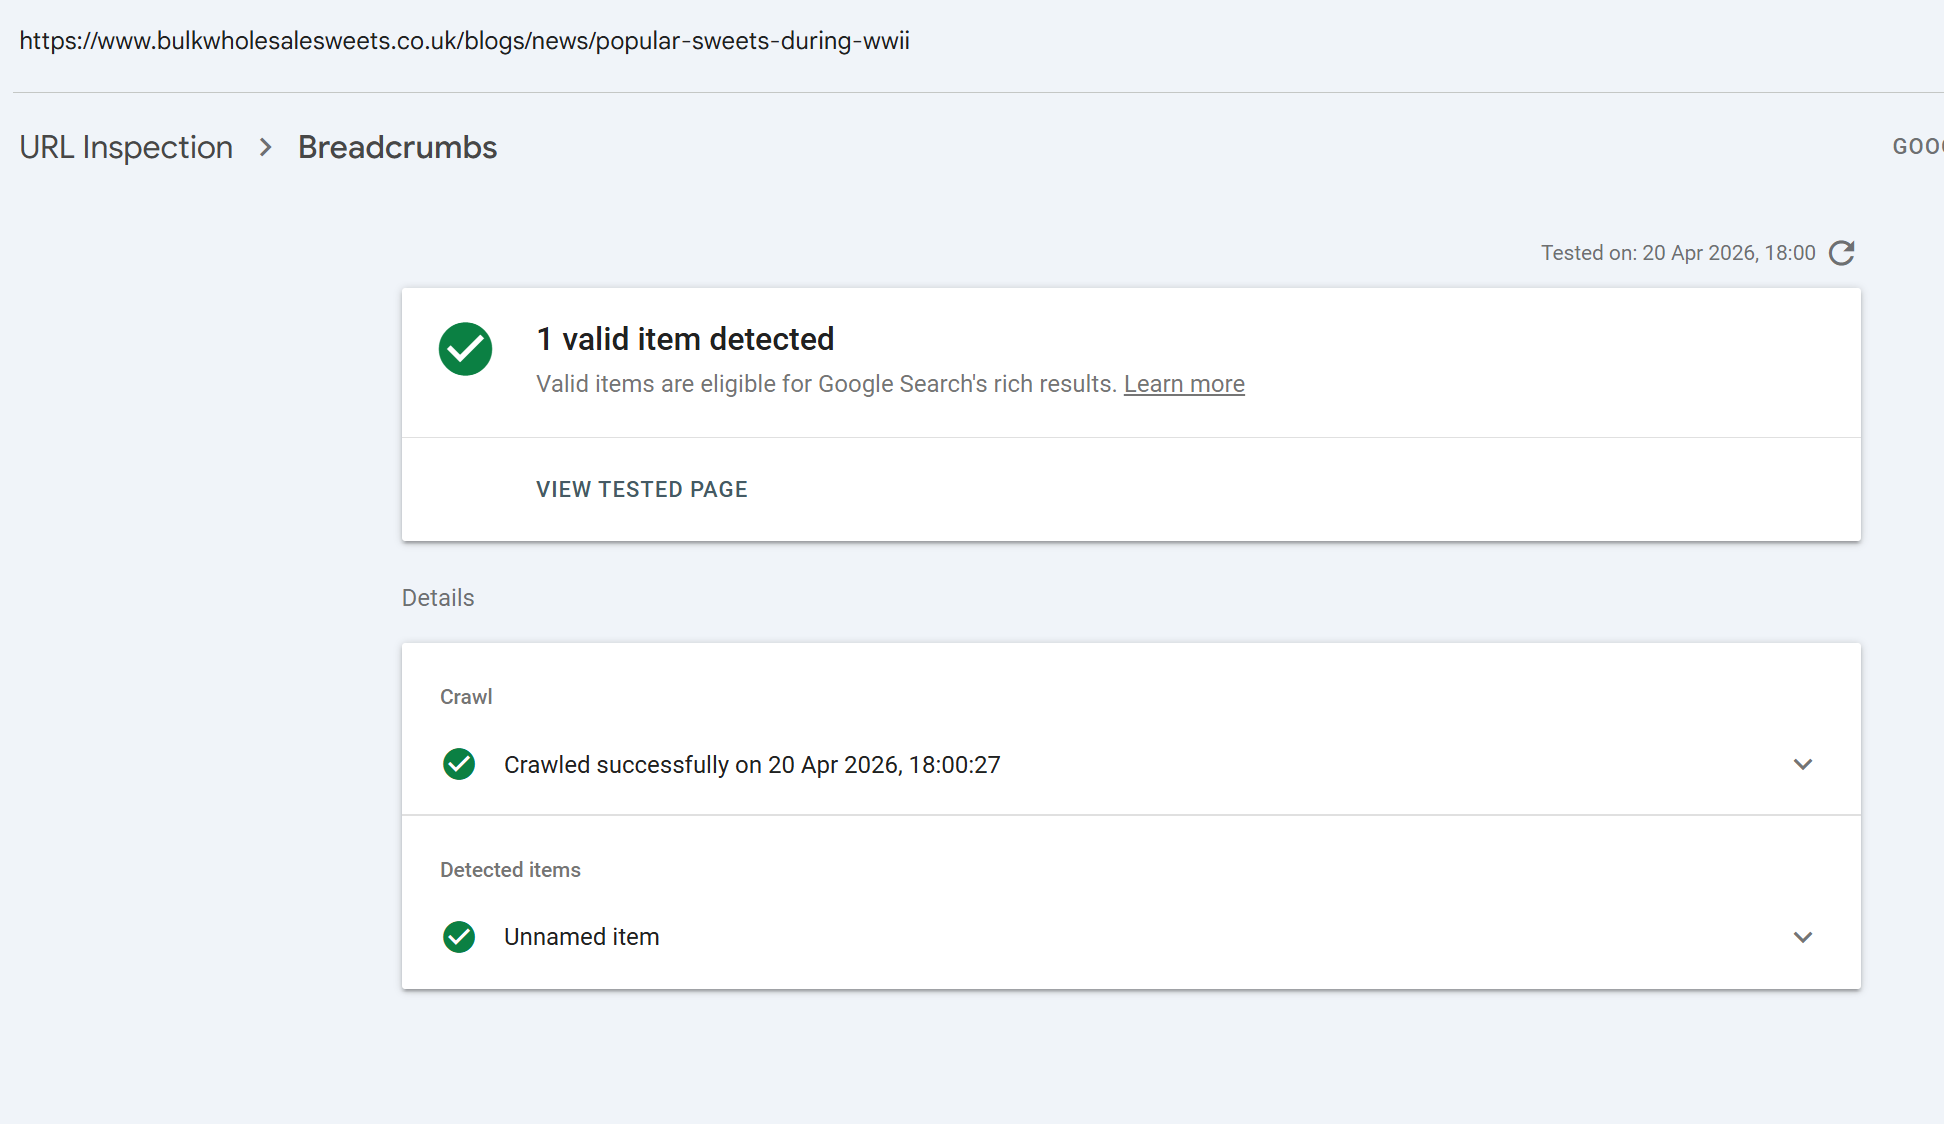
你可以准确看到 Google 在某个特定网址上检测到了哪些富媒体搜索结果类型,以及它们是否有效。
手动请求编入索引
对于新页面、刚更新的页面,或者卡在发现环节迟迟没有进展的网址,"请求编入索引"按钮是目前最快的正当推动方式。
缓存网址检查 vs 测试实际网址:关键区别
这两种模式回答的是根本不同的问题,而把它们混为一谈是我见过的 SEO 最常犯的错误之一。
缓存检查显示的是已编入索引的状态
它反映的是 Google 基于过去某次抓取存储在索引中的内容。如果该页面上次抓取是在三周前,而你此后修复了一个关键问题,缓存检查仍会显示旧状态。顶部的"网址在 Google 上"或"网址不在 Google 上"的结论,是基于那次过去的抓取做出的判断。
实时测试显示的是页面的当前状态
它完全绕过索引。如果你的修复已上线,实时测试就会反映出来。如果没有——因为缓存、部署问题或 CDN——实时测试会立刻告诉你。
由此带来几个实际影响:
上线修复后,务必先运行实时测试,再请求编入索引。在未经验证的修复上请求索引是浪费时间,Google 不太可能收录一个有问题的网址
缓存数据可能滞后现实数周。你昨天刚移除了 noindex,缓存检查却仍显示"被 noindex 标记排除",这不是 bug,只是索引/处理延迟的副作用
实时测试默认使用 Googlebot Smartphone,并且总是会渲染页面。缓存数据反映的则是 Google 在原始抓取时所使用的 user agent(对于移动优先索引的网站通常是智能手机版)
实时测试不会更新索引。如果你想加速重新抓取,之后必须明确请求编入索引。仅仅运行一次实时测试对你在搜索中的实际呈现没有任何影响
某些增强功能只在缓存模式下可用(因为它们需要引用一个实际已编入索引的版本)。另一些则可以实时测试
索引状态:顶部结论的含义
每条网址检查结果的顶部都有一个彩色图标和一个结论。这是 Google 给出的核心答案。可能的状态包括:
网址在 Google 上 该网址已编入索引,可以出现在搜索结果中。绿色对勾。最理想的情况。
网址在 Google 上,但存在问题 已编入索引,但一项或多项增强功能存在问题(结构化数据错误、核心网页指标未达标等)。琥珀色警告。
网址不在 Google 上:编入索引时出错 由于 Google 遇到了错误,该网址无法被编入索引。红色错误。
网址不在 Google 上 该网址未被编入索引。下方的详情面板会告诉你原因。
Google 不识别此网址 Google 没有任何抓取过该网址的记录。常见于全新网址或尚未被发现的网址。
网址是备用版本 Google 将该网址视为非规范变体(例如移动版、AMP 变体或重复页面)。
这个结论始终基于缓存/已编入索引的状态,而非实时状态。即便实时测试通过,在 Google 重新抓取并重新编入索引之前,这一结论性标题也不会改变。
网页索引状态:Google 给出的所有原因
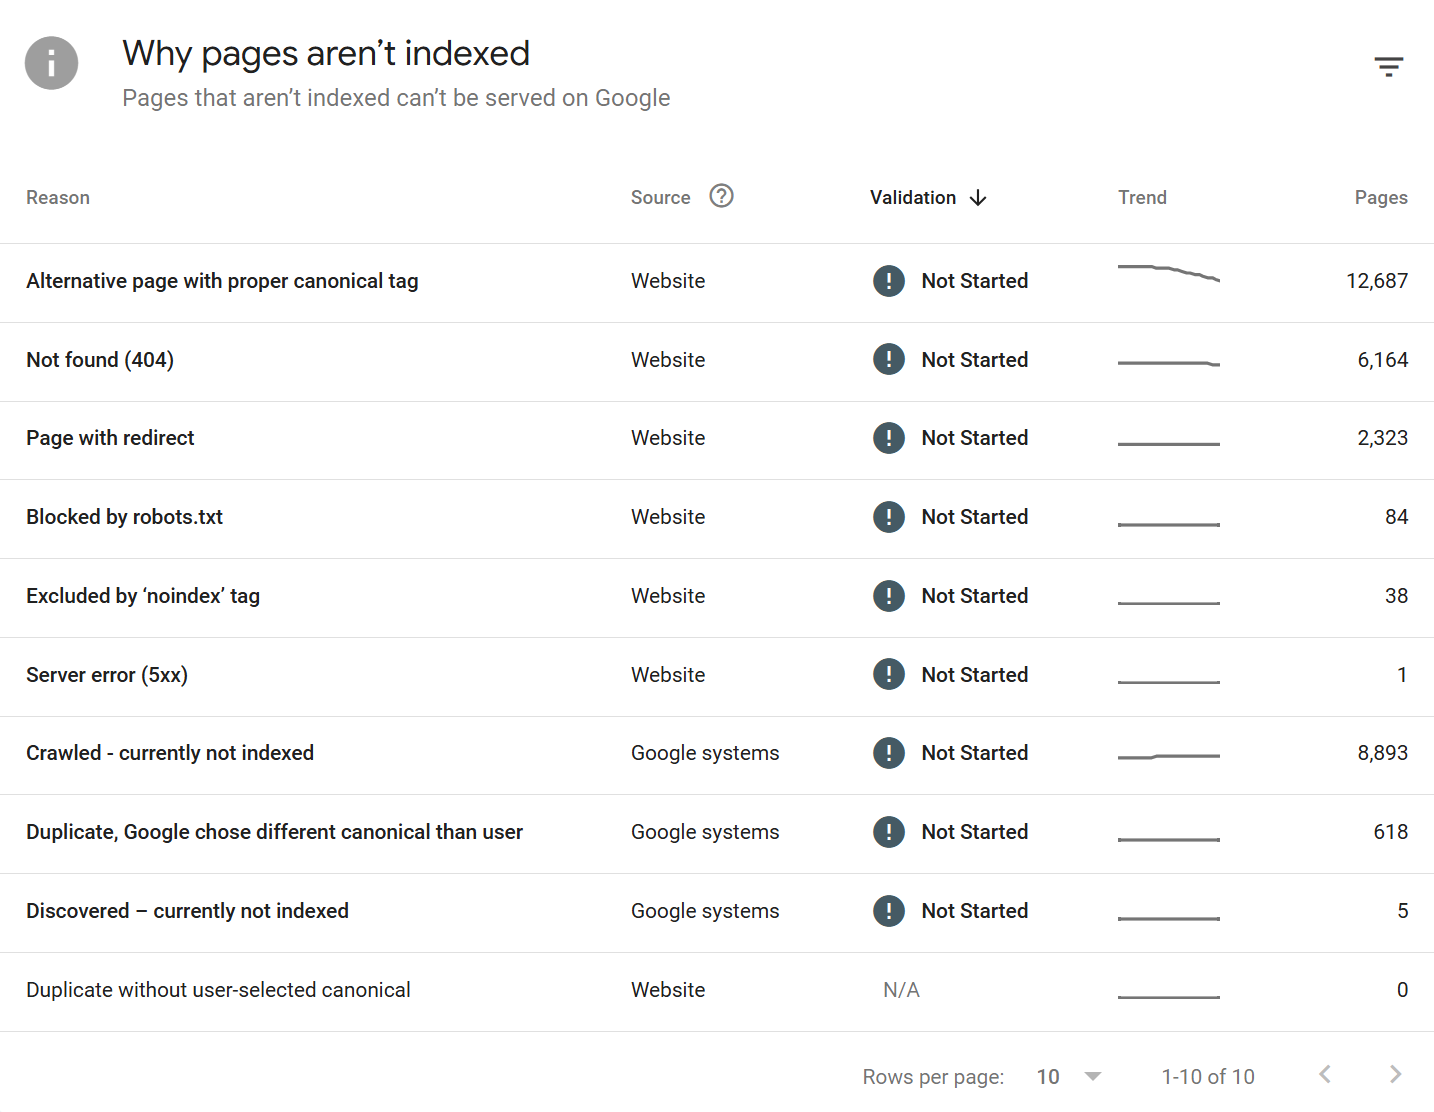
“网页索引编制”部分(此前称为“覆盖率”)是 Google 说明未编入索引具体原因的地方。这些原因与你在 GSC 的“网页”报告中看到的状态一一对应。了解全部状态很有必要,因为每种状态的处理方式都不同。
成功状态:
已提交并编入索引 通过站点地图提交并成功编入索引。
已编入索引,但未提交到站点地图 已编入索引,但 Google 是在没有站点地图条目的情况下发现它的。建议加入站点地图以提升抓取优先级。
已编入索引,但被 robots.txt 阻止 基于外部信号(通常是链接)编入索引,但 Google 无法抓取内容。该页面会出现在搜索结果中,摘要显示“此页面没有可用信息”。这是一种常见且通常并非有意造成的状态。
排除状态(未编入索引,但属于有意或可接受的情况):
被“noindex”标记排除 - 发现了
或X-Robots-Tag: noindex响应头。属于有意排除。被 robots.txt 阻止 -
robots.txt禁止抓取。如果该网址通过链接被发现,仍可能被编入索引(见上文)。网页会重定向 - 该网址重定向到别处。被编入索引的是目标页面,而不是这个网址。
有适当规范标记的备用网页 - 该网址规范指向另一个已编入索引的页面。对于重复内容来说这是正确的行为。
重复网页,用户未选定规范网页 - Google 检测到重复内容,但你没有声明规范网址。Google 替你选了一个。
重复网页,Google 选择的规范网页与用户指定的不同 - 你声明了规范网址,但 Google 不认同,选择了另一个。这通常说明你的规范信号不一致(内部链接、站点地图、hreflang 都需要保持一致)。
重复网页,提交的网址未被选为规范网页 - 你提交了这个网址,但 Google 选择了另一个作为规范网址。
因访问被禁止而被屏蔽 (403) - 服务器返回 403。
因未经授权的请求而被屏蔽 (401) - 需要身份验证。
因其他 4xx 问题而被屏蔽 - 401/403/404 之外的 4xx 状态。
网址被移除工具屏蔽 - 通过 GSC 的“移除”工具临时移除。
索引失败或警告状态:
未找到 (404) - 该网址返回 404。Google 最终会将其剔除。
软 404 - 该网址返回 200 状态码,但 Google 认为内容看起来像空白页或错误页。常见于内容单薄的分类页、空白搜索结果页和缺货的商品页。
服务器错误 (5xx) - 服务器返回 500、502、503、504 等。抓取期间偶发的 5xx 也会导致这一状态。
重定向错误 - 重定向次数过多、重定向循环,或重定向格式有误。
已发现 - 尚未编入索引 - Google 知道这个网址,但尚未抓取,通常是出于抓取预算或优先级被判定较低的原因。
已抓取 - 尚未编入索引 - Google 已抓取该网址,但选择不编入索引。这是最让人头疼的状态,因为 Google 不会给出具体原因。通常是对内容质量、重复度或内容单薄程度的判断。
抓取异常 - 无法解释的抓取失败的统称。较为少见。
需要立即处理的状态:
意料之外的
noindex- 通常是模板问题或测试环境配置泄漏到了线上。5xx 或抓取异常 - 检查服务器日志和可用性。
商业页面上的软 404 - 修复被判定为空白的内容,否则该页面无法获得排名。
整个模板都出现“已抓取但未编入索引” - 说明该页面类型存在质量或重复内容问题。
增强功能与体验:各项报告的含义
在网页索引编制模块下方,GSC 会展示增强功能层面的结果。这些结果与特定的富媒体搜索结果类型、结构化数据和体验信号相关。常见的包括:
HTTPS 确认该页面通过 HTTPS 提供服务。这份报告取代了旧版中关于传输层的安全问题报告。
面包屑导航 面包屑路径的结构化数据。验证
BreadcrumbList架构。商品 / 商家详情 / 配送详情 用于电商的商品标记。
评价摘要
Review或AggregateRating标记。文章
Article、NewsArticle或BlogPosting标记。视频
VideoObject标记和视频索引状态。无论页面上是否存在视频标记,每个网址都会显示一行单独的“视频索引编制”。食谱 面向烹饪类网站的
Recipe架构。活动
Event架构。招聘信息 面向招聘类网站的
JobPosting标记。站点链接搜索框
WebSite+SearchAction标记。徽标
Organization徽标标记。课程信息 / 预估薪资 / 学习视频 / 练习题 较新的垂直行业专用类型。
AMP 针对仍在使用 AMP 的网站,显示验证状态。
请注意,近年来 Google 已弃用或大幅限制了若干富媒体搜索结果类型:FAQ 富媒体结果现在只对高权威网站展示,How-to 富媒体结果基本已被取消。URL 检查工具仍会验证架构,但即使标记有效,也不再保证能在 SERP 中展示。
“移动设备易用性”此前在这里是一项显眼的内容,已于 2023 年 12 月被 Google 取消,不再出现在 URL 检查中。
每项增强功能会显示三种状态之一:有效(检测到且通过验证)、无效(检测到但存在错误),或不存在(未检测到此类型的标记)。
实时网址检查:“测试实际网址”到底做了什么
点击测试实际网址会触发一次实时抓取。耗时从十秒到一两分钟不等,具体取决于你的服务器响应时间、页面上的资源数量,以及 JavaScript 执行的繁重程度。
实时测试结果的布局与缓存检查结果一致:顶层结论、网页可用性详情,以及“查看已测试的网页”选项,但每一项数据反映的都是测试当时该网址的实时状态,而非已编入索引的状态。
实时测试的顶层结论包括:
网址可供 Google 使用 没有任何因素阻止索引编制。
网址可供 Google 使用,但存在问题 可以被编入索引,但增强功能存在问题。
网址无法供 Google 使用 存在索引阻碍因素(noindex、robots.txt、错误状态码、重定向、规范网址指向别处等)。
当实时测试结果为“无法使用”时,详情面板会给出具体原因,用词与上文的网页索引状态一致。以下是最常见的实时测试失败原因汇总:
被 robots.txt 阻止 你线上的
robots.txt禁止抓取该网址。检查是否有误留的Disallow规则,或测试环境的规则泄漏到了生产环境。网页带有 noindex 标记 实时 HTML 中包含 noindex 指令。meta 标签和 HTTP 响应头都要检查。
重定向 该网址现在会重定向。改为检查目标网址。
未找到 (404) 页面已不存在。
软 404 页面可以加载,但内容被判定为空白。查看渲染后的 HTML 以找出原因。
服务器错误 5xx 响应。检查日志。
规范指向了另一个网址 你的
rel="canonical"或 Google 的推断指向了别处。网页提取失败 Googlebot 完全无法抓取该网址。防火墙、WAF、速率限制或地区屏蔽是常见原因。
抓取异常 少见且含义模糊。
实时测试也能帮你发现缓存数据中看不到的问题,例如某条 Cloudflare 规则意外开始对 Googlebot 发起质询,或者某条配置错误的 WAF 规则会针对特定 user agent 触发。
查看已测试的网页:真正的诊断价值所在
完成任意一次实时测试后(对已编入索引 URL 的缓存检查也同样),右侧会出现查看已测试的网页面板。正是这里让网址检查工具成为 GSC 中最强大的诊断工具。它包含三个标签页:HTML、屏幕截图和更多信息。
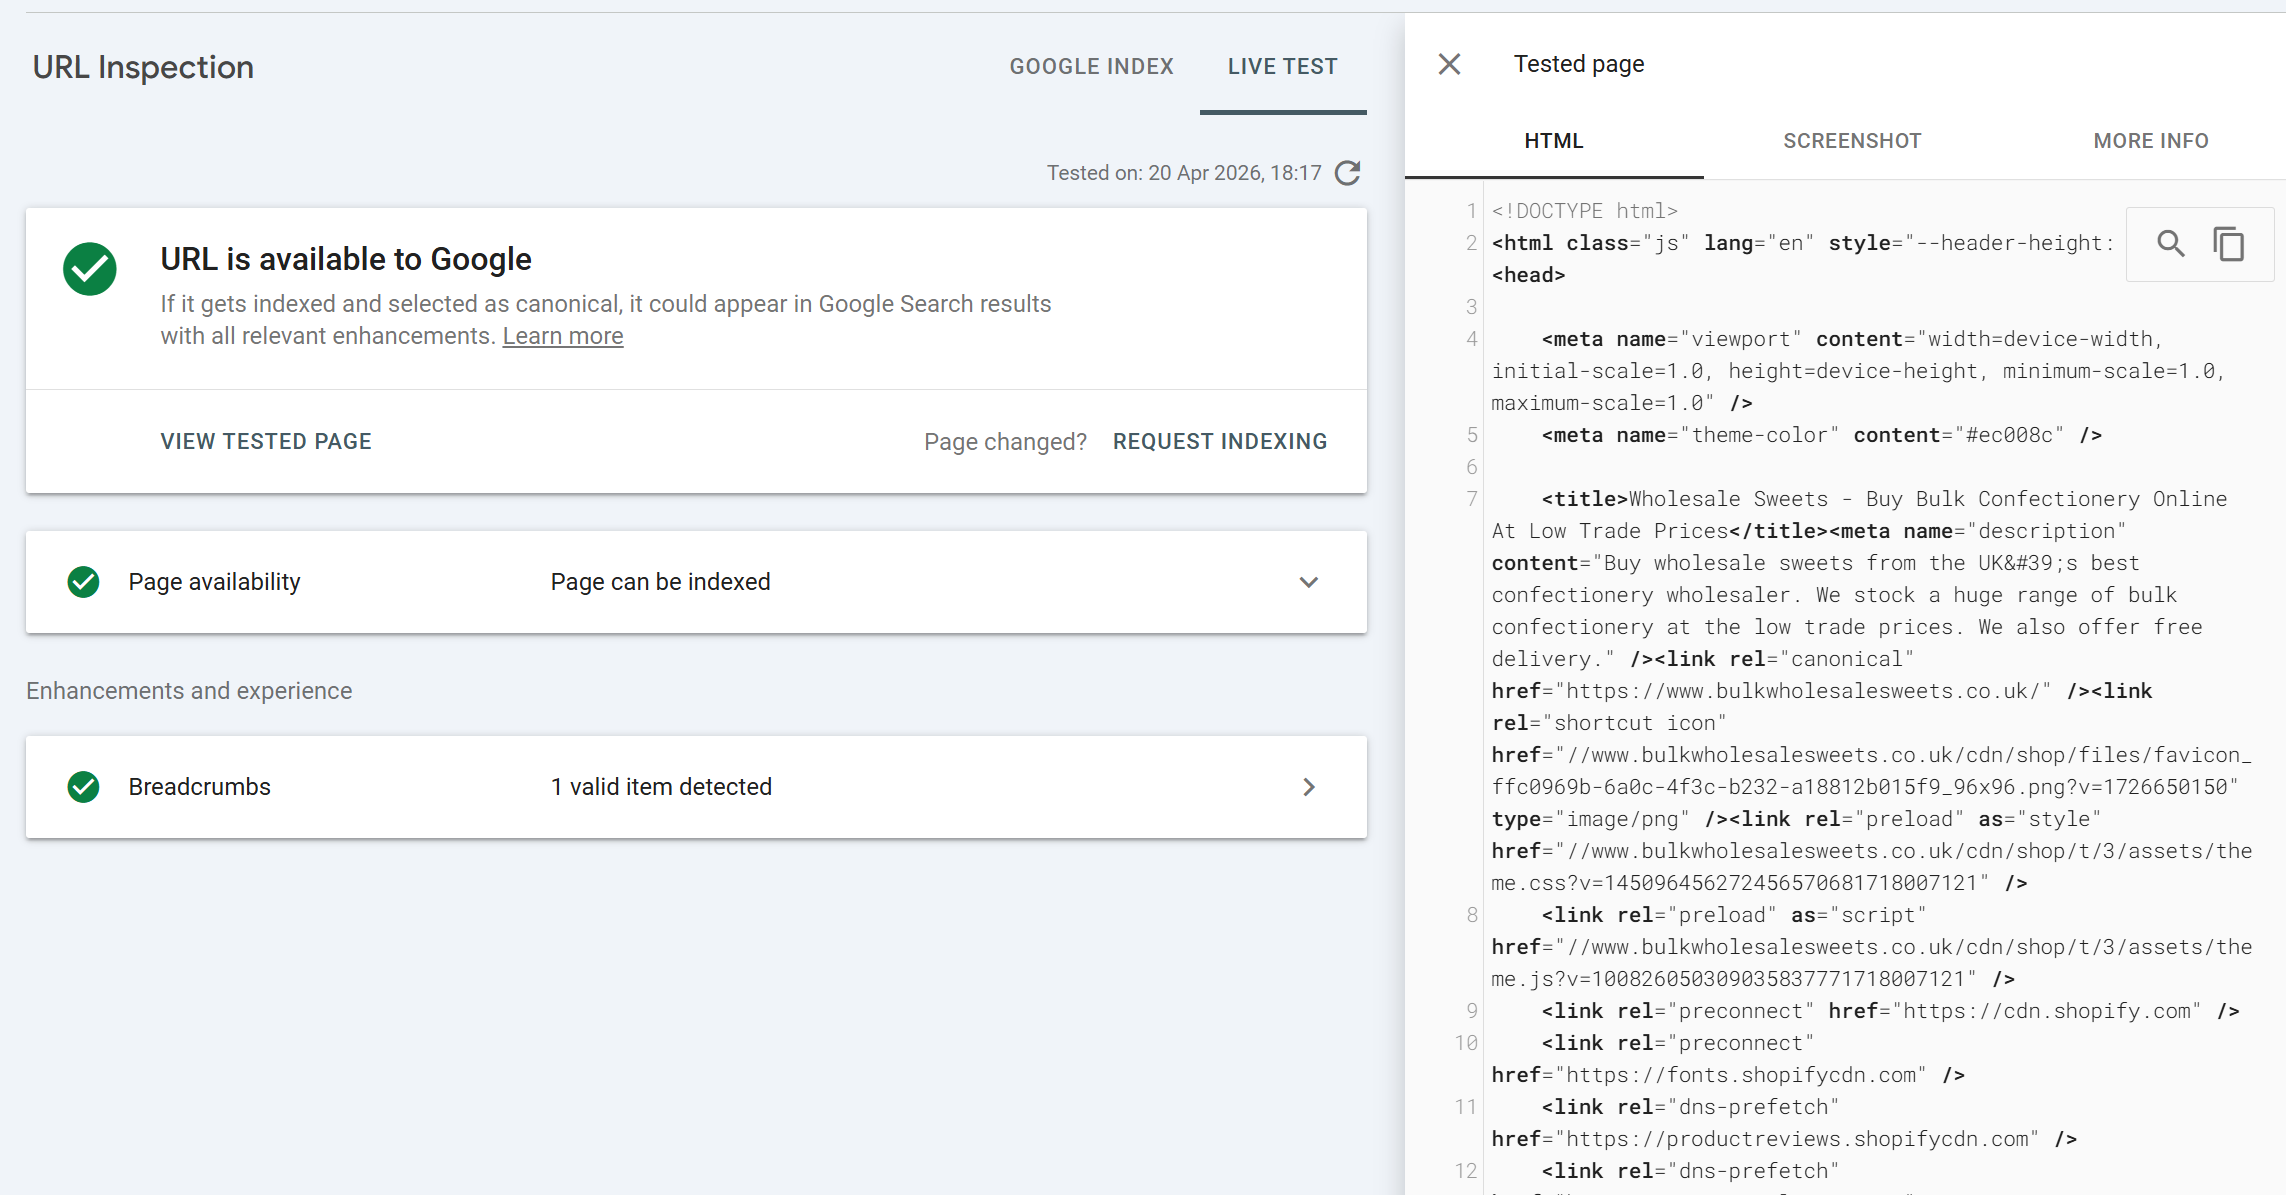
有些 SEO 从业者会跳过这部分,或者并不总是深入研究这些输出,甚至干脆忽略它。这是不应该的。查看已测试的网页中的数据往往能暴露尚未被诊断出的问题——比如 HTML 输出中的异常、屏幕截图中没有渲染出内容、用于渲染页面的资源被屏蔽等等。
HTML 标签页
HTML 标签页显示的是完全渲染后的 HTML,也就是 Googlebot 执行页面 JavaScript 之后的 DOM。这才是 Google 实际用于索引的页面版本。
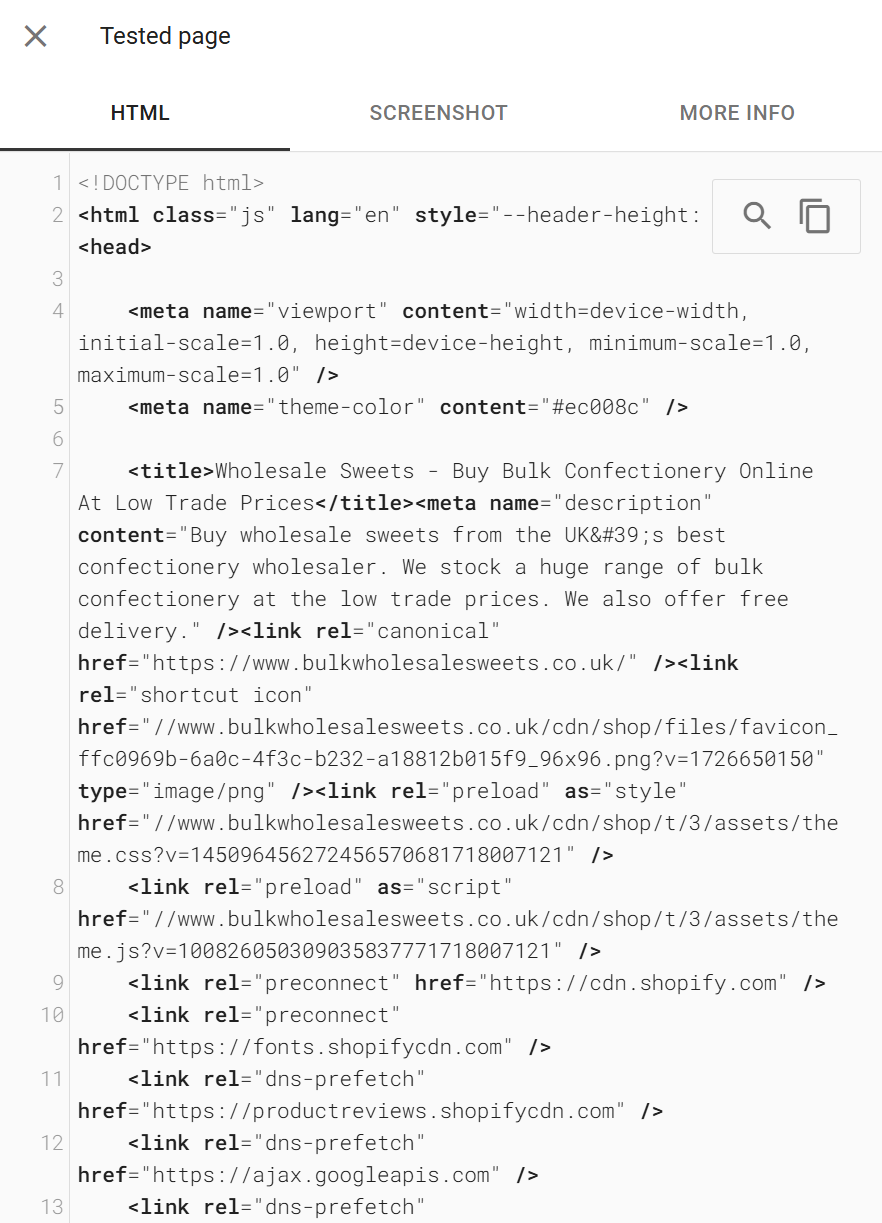
这不是你用 view-source: 看到的 HTML。如果你的网站使用客户端渲染、hydration,或任何在加载后注入内容的框架,HTML 标签页就是确认哪些内容真正进入了渲染后 DOM 的权威依据。
HTML 标签页的用途:
确认 JavaScript 注入的内容可见
搜索特定的产品名称、文章正文或内链。如果它们在渲染后的 HTML 中缺失,那它们在 Google 的索引中同样缺失。这是诊断你的框架是否生成了 Google 能看到的内容的最快方式。验证最终渲染 HTML 中的 canonical 标签是否正确
有些 CMS 会输出相互冲突的 canonical,或者有插件在渲染周期后期将其覆盖。检查 meta robots 指令
如果你通过 JavaScript 动态设置了noindex(本不该这么做,但确实有人这么干),这里会显示出来。检查内链
确认你的导航、页脚和交叉链接都在渲染后的 HTML 中,而不是因延迟加载而消失不见。查找结构化数据
确认 JSON-LD 代码块确实存在于渲染输出中。诊断内容一致性
如果桌面端 HTML 中有的内容没有出现在移动端渲染的 HTML 中(实时测试默认使用移动端),你就存在移动优先索引的问题。
你可以把 HTML 复制到剪贴板,然后用任何工具处理它:HTML 验证器、正则搜索、与源 HTML 做 diff 比对,从而准确看出 JavaScript 添加或移除了什么。
需要注意一点:HTML 标签页展示的是测试那一刻的渲染 HTML。如果页面中有依赖用户交互才加载的内容(点击展开的标签页、"加载更多"按钮),这些内容通常不会出现在渲染后的 HTML 中,除非它们本就在初始 DOM 里只是被 CSS 隐藏了。
屏幕截图标签页
屏幕截图展示的是 Googlebot 所看到的页面视觉渲染结果。它之所以有用,恰恰因为它是视觉化的——那些在浏览 HTML 时可能被你忽略的异常会一眼跳出来。
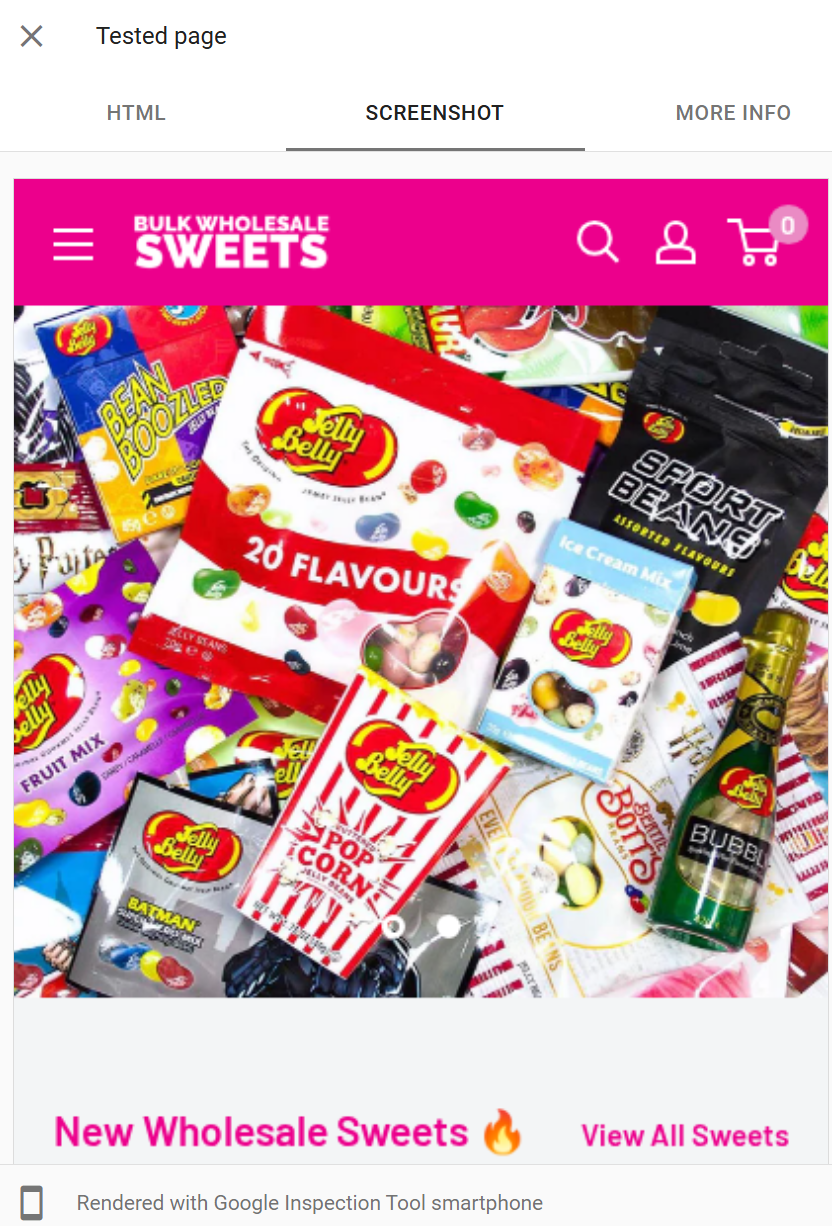
重要提醒:屏幕截图不是整页渲染
它只捕获页面的顶部区域,通常大约是第一屏左右的内容,而不是整个可滚动页面。
不要因为可见区域下方的内容没出现就断定 Google 没看到它。在内容方面,HTML 标签页是权威依据;屏幕截图只是视觉渲染的参考指示。
屏幕截图特别有用的场景:
完全空白的截图
这是渲染失败。Google 抓取了页面,但渲染结果什么都没有。几乎总是由关键 JavaScript 执行失败、必需资源被屏蔽,或客户端框架在绘制前报错导致。配合 JavaScript 控制台标签页定位错误。页面加载了但内容区域为空
外壳渲染出来了,但主内容没有。通常意味着内容是通过 XHR/fetch 调用加载的,而该调用在渲染过程中失败或被屏蔽。布局错乱、样式缺失
CSS 文件没有加载。检查网页资源标签页,通常是某个 CSS 文件被 robots.txt 屏蔽、返回 4xx,或托管在拒绝 Googlebot 的 CDN 上。文字嵌在图片里而非 HTML 中
这确认了一个可能相当严重的索引问题——如果你的内容嵌在图片中,Google 从这部分内容获得的索引信号会非常有限。Cookie 横幅或插页广告遮挡内容
如果在 Google 的渲染结果中有全屏弹窗占据了视口,可能会触发 Google 的移动端插页式广告惩罚,用户感知质量也会受影响。看到占位内容
截图中出现骨架屏、加载动画或"Loading..."文字,说明 Google 在你的内容到达之前就完成了渲染。被地域屏蔽或地区重定向的内容
如果你看到的是网站其他国家版本的内容,说明你的地域识别逻辑错误识别了 Googlebot。
一个常见错误是以"我自己加载时页面看着好好的"为由忽视渲染问题。屏幕截图展示的是 Googlebot 的渲染环境,不是你的。浏览器渲染和 Googlebot 渲染在 JavaScript 超时、资源限制和用户交互方面都不同。
更多信息标签页
更多信息标签页是深层技术细节所在。它包含四个子板块,合在一起构成你能获得的关于一次 Googlebot 抓取的最细颗粒度视图。
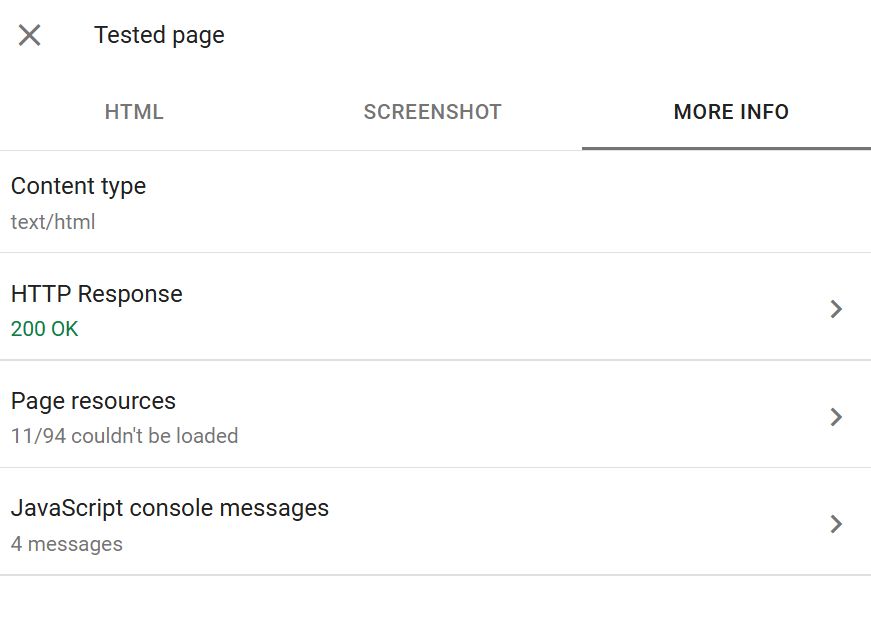
HTTP 响应显示服务器针对初始 URL 请求返回的完整响应头。用途包括:
确认实际的 HTTP 状态码(有时重定向或 WAF 规则意味着你以为在返回的状态码并非 Googlebot 实际收到的)。
检查
X-Robots-Tag响应头——这是隐藏noindex指令的常见来源,而这类指令不会出现在 HTML 中。验证
Content-Type响应头——以text/plain而非text/html提供的页面无法被正确索引。检查缓存头、CORS 头,以及你的应用设置的任何自定义响应头。
如果你在做动态提供(dynamic serving),确认
Vary: User-Agent的行为是否正确。
网页资源列出 Googlebot 在渲染过程中尝试抓取的每一个资源:JavaScript 文件、样式表、图片、字体、XHR 请求。每一项都会显示状态:已抓取、被 robots.txt 屏蔽,或"其他错误"(通常是 4xx/5xx)。
这往往是诊断渲染问题时最有价值的单个标签页:
关键 JS 文件被屏蔽通常就是截图空白的原因。
CSS 文件被屏蔽通常就是截图无样式的原因。
多个 XHR 请求失败可能说明 API 端点按 user agent 拒绝了 Googlebot,或不允许从渲染环境发起跨域请求。
第三方脚本超时可能拖慢渲染,久到触发 Googlebot 的渲染超时。
一条经验法则:被 robots.txt 屏蔽的资源值得逐个复核。屏蔽分析、标签管理和第三方脚本没问题。屏蔽你自己网站的 CSS 和 JS 则几乎从来都有问题。
JavaScript 控制台消息会呈现 Googlebot 渲染期间触发的每一条 console.error、console.warn,以及部分 console.log 调用。如果你在 Chrome DevTools 的 Console 面板中调试过 JS 应用,这就是 Googlebot 浏览器端的对应物。
需要留意的内容:
Uncaught TypeError、ReferenceError、SyntaxError——这些致命 JS 错误很可能中断了渲染。带有描述性错误信息的网络请求失败。
内容安全策略(CSP)违规——有时 CSP 响应头会阻止资源在 Googlebot 环境中加载,即便它们在你的浏览器里正常工作。
来自 React/Vue/Angular/Svelte 的 hydration 错误——通常意味着服务端渲染的 HTML 与客户端框架的预期不匹配,渲染可能因此中断。
控制台为空通常是好事。控制台里全是报错,则一定值得深究。
页面可用性(根据界面版本不同,有时单独显示,有时在“更多信息”中)展示抓取元数据:
发现方式 Google 最初是如何找到该 URL 的(站点地图、引荐页面等)。
上次抓取 最近一次成功抓取的时间戳。
抓取身份 Googlebot 智能手机版或桌面版(移动优先索引之后几乎都是智能手机版)。
是否允许抓取? robots.txt 是否允许抓取。
页面抓取 抓取本身是否成功。
是否允许编入索引? 索引指令是否允许编入索引。
用户声明的规范网址 你设置的 canonical。
Google 选择的规范网址 Google 实际采用的 canonical。如果两者不一致,说明存在需要排查的规范化合并问题。
引荐页面 如果是通过链接发现的,指出哪个 URL 链接到了该页面。
“用户声明的 canonical”与“Google 选择的 canonical”之间的对比,是整个 GSC 中杠杆率最高的数据点之一。如果全站范围内两者持续不一致,说明你的规范化信号在某处相互冲突——通常出在站点地图、内链或 hreflang 声明上。
实操流程:一套诊断顺序
当某个 URL 没有排名或表现不符合预期时,我会按以下顺序排查:
运行缓存检查。查看顶层结论、页面索引状态和上次抓取日期。如果上次抓取是在几个月前,缓存状态就不可靠,直接进入第 2 步。
检查 canonical。如果 Google 选择的 ≠ 用户声明的,先弄清原因,其他都往后放。
运行实时测试。确认当前线上状态是否与已编入索引的状态一致。
如果两个结论不同,说明只是索引滞后于现实。请求编入索引,然后继续下一项。
如果实时测试失败,阅读给出的原因,并逐项查看“更多信息”标签页:
HTTP 响应,查看异常状态码或响应头。
页面资源,查看被屏蔽或抓取失败的资源。
JavaScript 控制台,查看致命错误。
HTML 标签页,确认内容是否渲染出来。
屏幕截图,直观发现异常。
修复、重新部署、再次运行实时测试,确认修复对 Googlebot 可见。
请求编入索引,在实时测试结果干净之后再做。
不要跳过第 6 步。在未经验证的修复上请求编入索引,是 SEO 从业者浪费配额、拖慢自己重新抓取的最常见方式。
值得了解的注意事项与限制
请求编入索引有每日配额。每个资源大约每天 10–12 个 URL。它是分诊工具,不是批量提交机制。批量重新索引仍然要靠站点地图这一主渠道。
实时测试通过并不保证会被编入索引。它只能确认该 URL 具备被编入索引的资格。Google 在真正收录前仍会做质量和重复性判断。
该工具只能用于已验证资源中的 URL。你无法用它检查竞争对手的 URL。
实时测试结果与实际索引表现可能不同。Googlebot 实时测试的渲染环境在超时设置和资源预算上与索引抓取程序略有差异。勉强能渲染出来的实时测试,实际可能无法被编入索引。
HTML 标签页展示的是渲染后的 HTML,不是源码 HTML。如果你想看服务器在 JavaScript 执行前返回了什么,请在 Chrome 中使用
view-source:或用 cURL。屏幕截图是局部的。不要仅凭截图判断页面整体的渲染质量。
部分增强功能报告存在滞后。结构化数据的改动可能需要数天才会反映出来,即使在缓存检查中也是如此。
结语
URL 检查是 SEO 诊断与网站工程的交汇点。用得浅,它只是一个“这个页面被收录了吗?”的检查器。用得对,它是最快的路径,让你准确理解某个页面为什么没有排名、修复是否正确上线、Google 的渲染流程产出了什么,以及是哪个资源或指令挡住了你的路。
URL 检查非常有用,它让 SEO 从业者能够逐页了解索引状态、渲染情况、HTML 输出等更多信息。

SEO Stack 创始人
Daniel 是 SEO Stack 的创始人。他在技术 SEO 和搜索数据领域深耕二十余年,在客户项目中一次又一次撞上 Search Console 的同样限制后,他着手打造了 SEO Stack。
Daniel 拥有丰富的 SEO 经验,创办过 SEO 代理机构、审计业务以及一家发展良好的咨询公司。业余时间里,Daniel 喜欢做 SEO 实验并分享实验结果。
发布于 2026年4月20日

