NavBoost 详解:Google Content Warehouse 泄露文件究竟揭示了哪些关于点击排名的真相
多年来,Google 一直在告诉 SEO 行业:点击无关紧要。停留时间无足轻重。CTR 只是噪音。事实上,我在 LinkedIn 上就此大声疾呼了很多年,很多……
多年来,Google 一直告诉 SEO 行业:点击不重要,停留时间无关紧要,CTR 只是噪音。事实上,我在 LinkedIn 上就这件事喊了很多年,不少人说我是阴谋论者。
“Dan,Google 不会用行为数据做排名”,或者“如果一个站点没有配置 GSC 或 google analytics 怎么办”。
但现实是,我知道 Google 在用这些数据,我做过太多 SEO 测试——我买了几个域名,用 CTR Booster 加住宅代理、随机化 user agent 以及不同的页面/交互行为来测试点击操控。
我曾经靠这类测试把一个假的电商网站 www.bulkco.co.uk 做上去了——一个权重很弱的域名,却靠数千个关键词排了 3 年多。
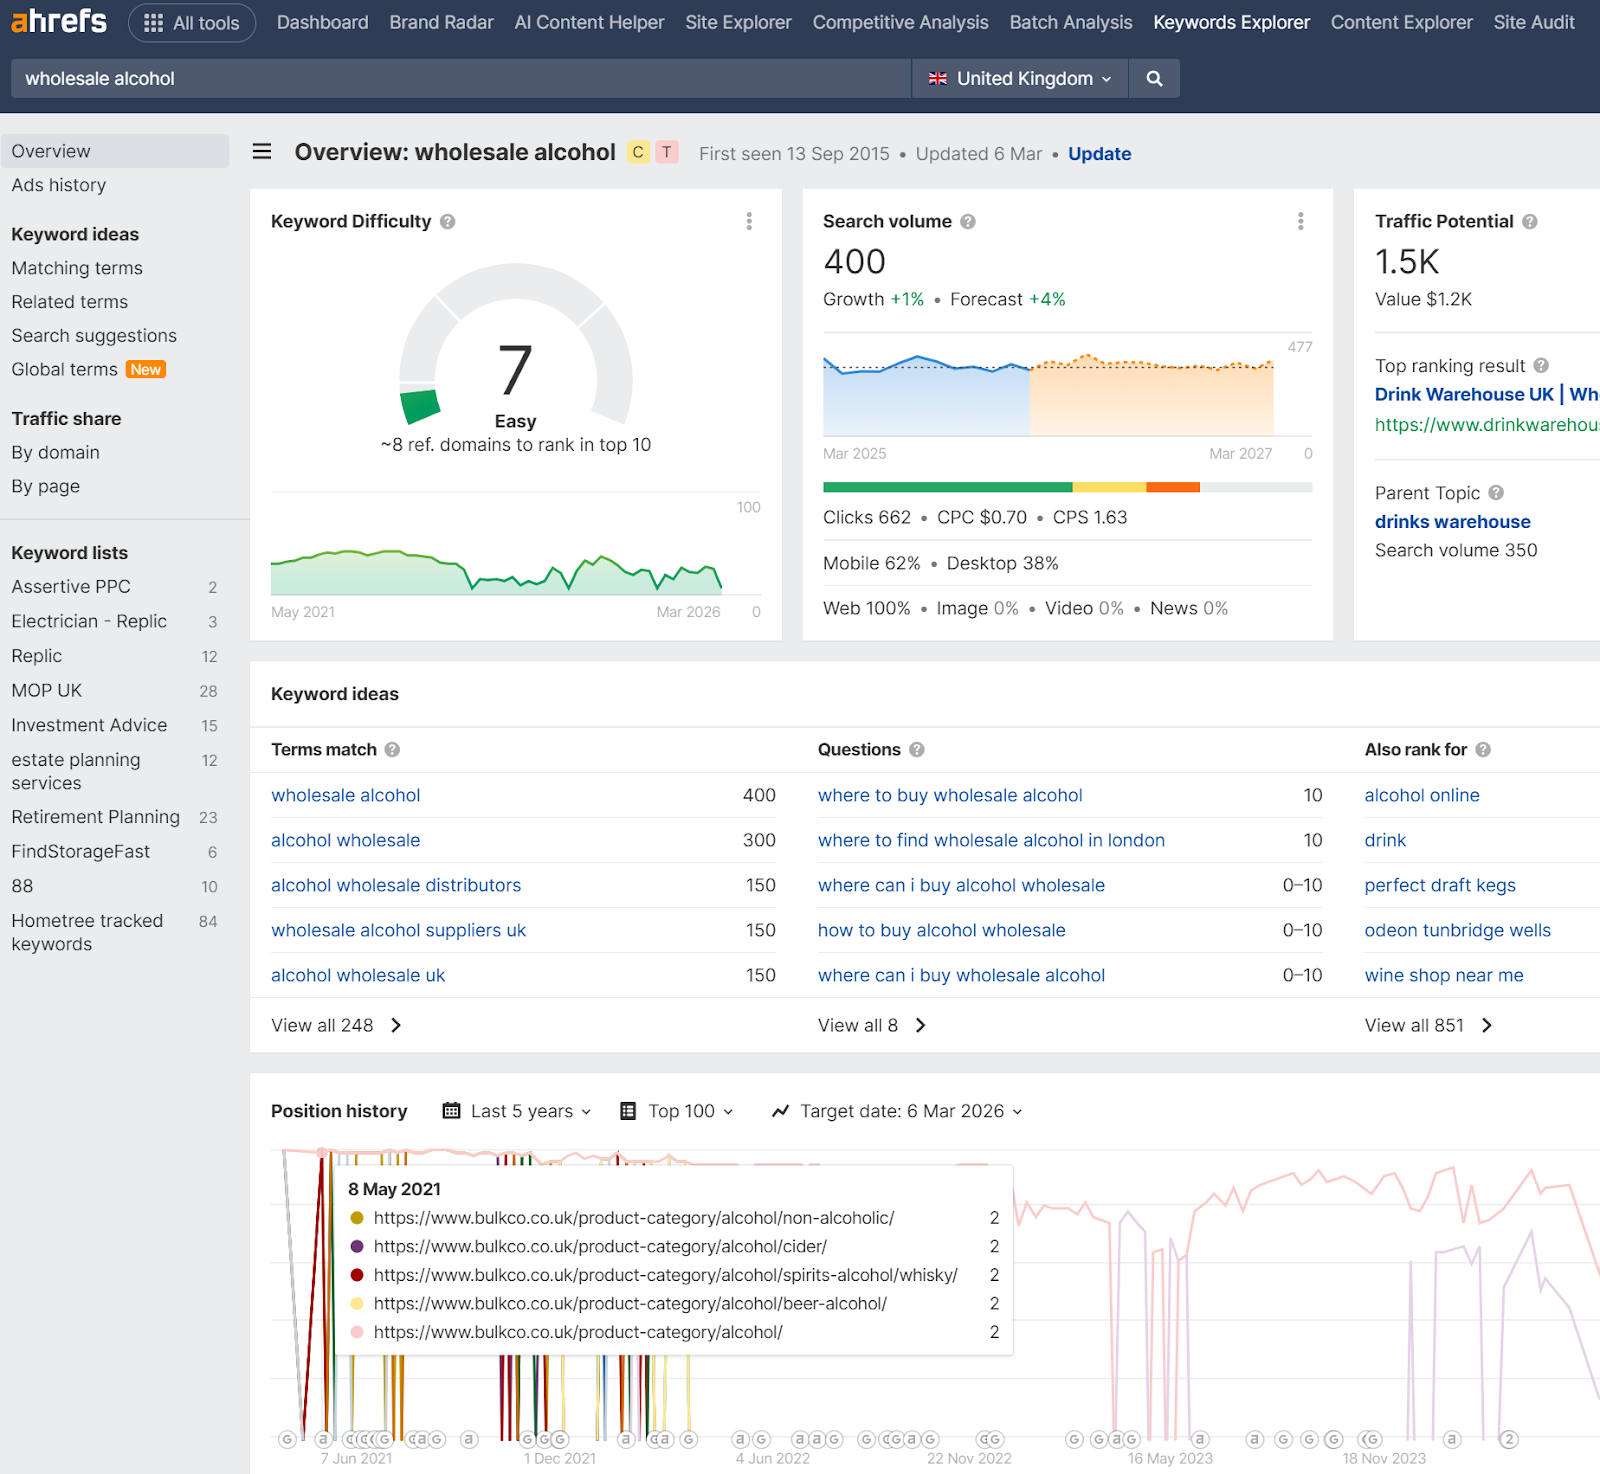
我当时就知道事情不对劲,而借由那次泄露以及随后的 DOJ 庭审,我们现在知道 Google 确实使用行为数据,也就有了 Navboost。
Content Warehouse API 文档于 2024 年 5 月泄露,而就在那份 schema 里,NavBoost 被引用了 84 次,分布在六个专门的模型中。这个系统会追踪 good clicks、bad clicks、long clicks、展示次数、设备类型、地理切分、基于 IP 的欺诈评分,以及代表单个用户的 voter token——没过多久,大家就开始把线索拼起来了。
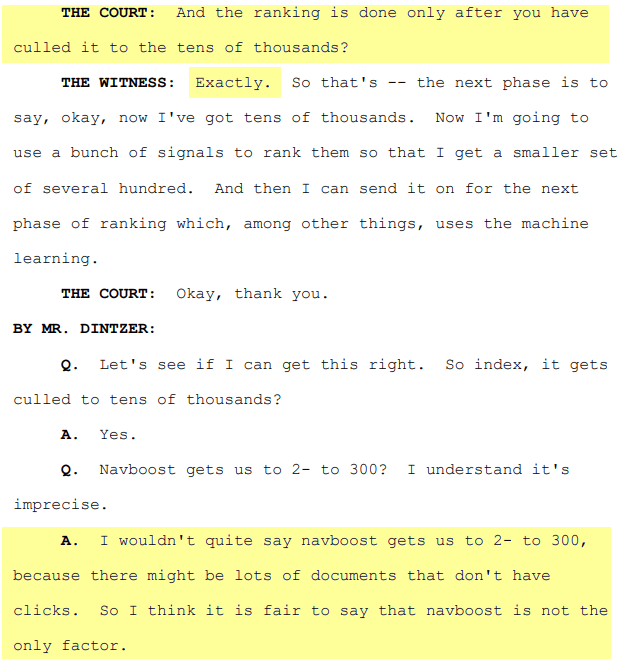
而在几个月之前的美国 DOJ 反垄断庭审中,Google 副总裁 Pandu Nayak 就已在宣誓作证时确认,NavBoost 是 Google 使用的“重要信号之一”。作为证据提交的内部邮件说得更直白。Google 副总裁 Alexander Grushetsky 在 2019 年写道,单就点击和精确度指标而言,NavBoost 很可能比其余所有排名机制加起来还要强大,而且 NavBoost 团队之外的工程师对它影响力之大颇有不满。
本文将逐一梳理泄露的 Content Warehouse 文档中 NavBoost 类别下的每一个模型。凡是 schema 能给出明确结论的地方,我们就直说。凡是字段名和结构指向某种可能的解读但仍有歧义空间的地方,我们会说明这一点,并给出有依据的推测。目标是让你真正从技术层面理解泄露的内容,而不是读一份把未知部分一笔带过的二手摘要。
我必须说清楚——作为 SEO,我的职责是尽可能提供有用的洞察和事实准确的信息——我并不知道这些模型具体是**如何**被应用的、权重有多大,没有人知道。但我们可以推断/推测——某些情况下这些数据如何被收集/使用是相当明显的,但程度如何?
没人知道。
好,那就开始吧……………
六个 NavBoost 模型
此次泄露暴露了 QualityNavboost 命名空间下的六个 protocol buffer 模型。整理泄露内容的分析人士给每一个都打了 10/10 的 SEO 影响力评分。它们分别是:
QualityNavboostCrapsCrapsClickSignals 核心点击信号容器(10 个属性)
QualityNavboostCrapsCrapsData 将点击与 URL、查询、设备和地理位置关联起来的主数据记录(22 个属性)
QualityNavboostCrapsCrapsDevice 设备与浏览器分类(3 个属性)
QualityNavboostCrapsFeatureCrapsData 语言区域与特征层级的信号切分(6 个属性)
QualityNavboostCrapsStatsWithWeightsProto 用于模式层级聚合的统计分布数据(15 个属性)
QualityNavboostGlueVoterTokenBitmapMessage 用户去重与隐私过滤(2 个属性)
在逐个拆解之前,这个名字值得一提。“CRAPS”似乎是 Google 内部的缩写,很可能代表类似 Click and Results Prediction System 之类的含义,不过这一点并未得到官方确认。它是否同时也在暗指那款骰子游戏(毕竟从点击模式预测用户满意度本质上是概率性的),或者在调侃 Google 多年来公开把基于点击的理论称作“胡编的垃圾(made up crap)”,就留给读者自行体会了。
还有,别把 Craps 误会成什么厕所笑话或赌场游戏:
模型 1:CrapsClickSignals 核心点击分类体系
这是最基础的模型。它包含十个 float 类型属性,而泄露文档中对它的描述虽简短却很说明问题:“Click / impression signals for craps.”
这里的每一个 float 都代表一个计数或一个比率。它们不是二元标志位,而是连续值,这意味着 Google 几乎可以肯定用的是经过加权、归一化的数字,而不是原始整数——但再次强调,这属于推测,并未得到证实(这一点我想说清楚)。
各项属性
clicks 某个文档针对某个查询(或查询簇)的总点击数。这是基准值。该模型中其余的一切,都是对这个数字的细化或其子集。从根本上说,必须先发生点击,才谈得上做出判定。
显然,有些点击会让用户满意,有些则不会。我们拿 pain harold 来举例(谁不爱这个表情包呢)。
goodClicks Google 认为代表了成功用户结果的点击。泄露内容没有定义精确标准,但结合反垄断庭审证词以及 SEO 圈多年来对 pogo-stick 的分析,一次 good click 几乎可以肯定意味着:用户点击了某个结果,在该页面上停留了有意义的一段时间,并且没有返回 SERP 去点别的结果。换句话说:这次点击解决了查询需求。
访问了一个误导他、或体验糟糕的网站之后的 hide the pain harold:
badClicks 反过来的情况。用户很快就返回了搜索结果页的点击。这正是 Google 多年来坚称并不作为排名因素存在的 pogo-stick 信号。泄露的 schema 证实,它是一个有名有姓、被存储下来、float 取值的属性,位于一个 SEO 影响力 10/10 的模型之中。
如果你想知道 pogo 是什么意思:它指的是“pogo sticking”,即在两个状态之间快速来回——也就是你访问了一个网站后很快离开。顺带一提,Google 并不需要网站装了 analytics 才能知道互动持续了多久——还记得那个叫 Chrome 的小浏览器吗?没错,它同样是行为数据的特洛伊木马!
看看这篇关于 google chrome 阴暗面、你的浏览器如何出卖你的文章
lastLongestClicks 这里开始有意思了。父级模型 CrapsData 的文档将其描述为“在相关用户查询中既是最后一次、又是最长一次的点击数量”。这不只关乎某人在你页面上单独停留了多久,而是关乎你的结果是否就是用户最终停下来的那个——搜索会话中的最后一次点击,也是他们花时间最多的那次。如果用户点了结果 A,跳出;点了结果 B,跳出;然后点了结果 C 并停留四分钟后关闭标签页,那么 lastLongestClick 的功劳就记在结果 C 头上。
这就是为什么我认为 Google 会把 SERP 混排,尤其是在搜索查询的意图比较“模糊”的时候——比如你搜“car”,你并没有明确你要什么?你想知道车是什么?你想买一辆?你想了解有哪些汽车品牌?
**多样化的 SERP** 给了 Google 更大的评估样本池——在一个 SERP 里呈现不同意图,长期累积点击数据,这些随时间聚合的行为能帮助 Google 更好地理解“大多数人想要什么”。
我相信这正是 Google 经常把不同类型结果混排的原因,也是为什么多年来我们总能看到一些完全不像是配得上排名的网站却偏偏排上去了!
比如说多年来, vatcalculator.co.uk 这个 EMD 在 vat calculator 上排第一,事实上它从 2009 年就开始排名,到今天依然是 #1。那是一个未做优化的 EMD,不走 HTTPS,不适配移动端,堪称“建好、上线、然后撒手不管”的典型!
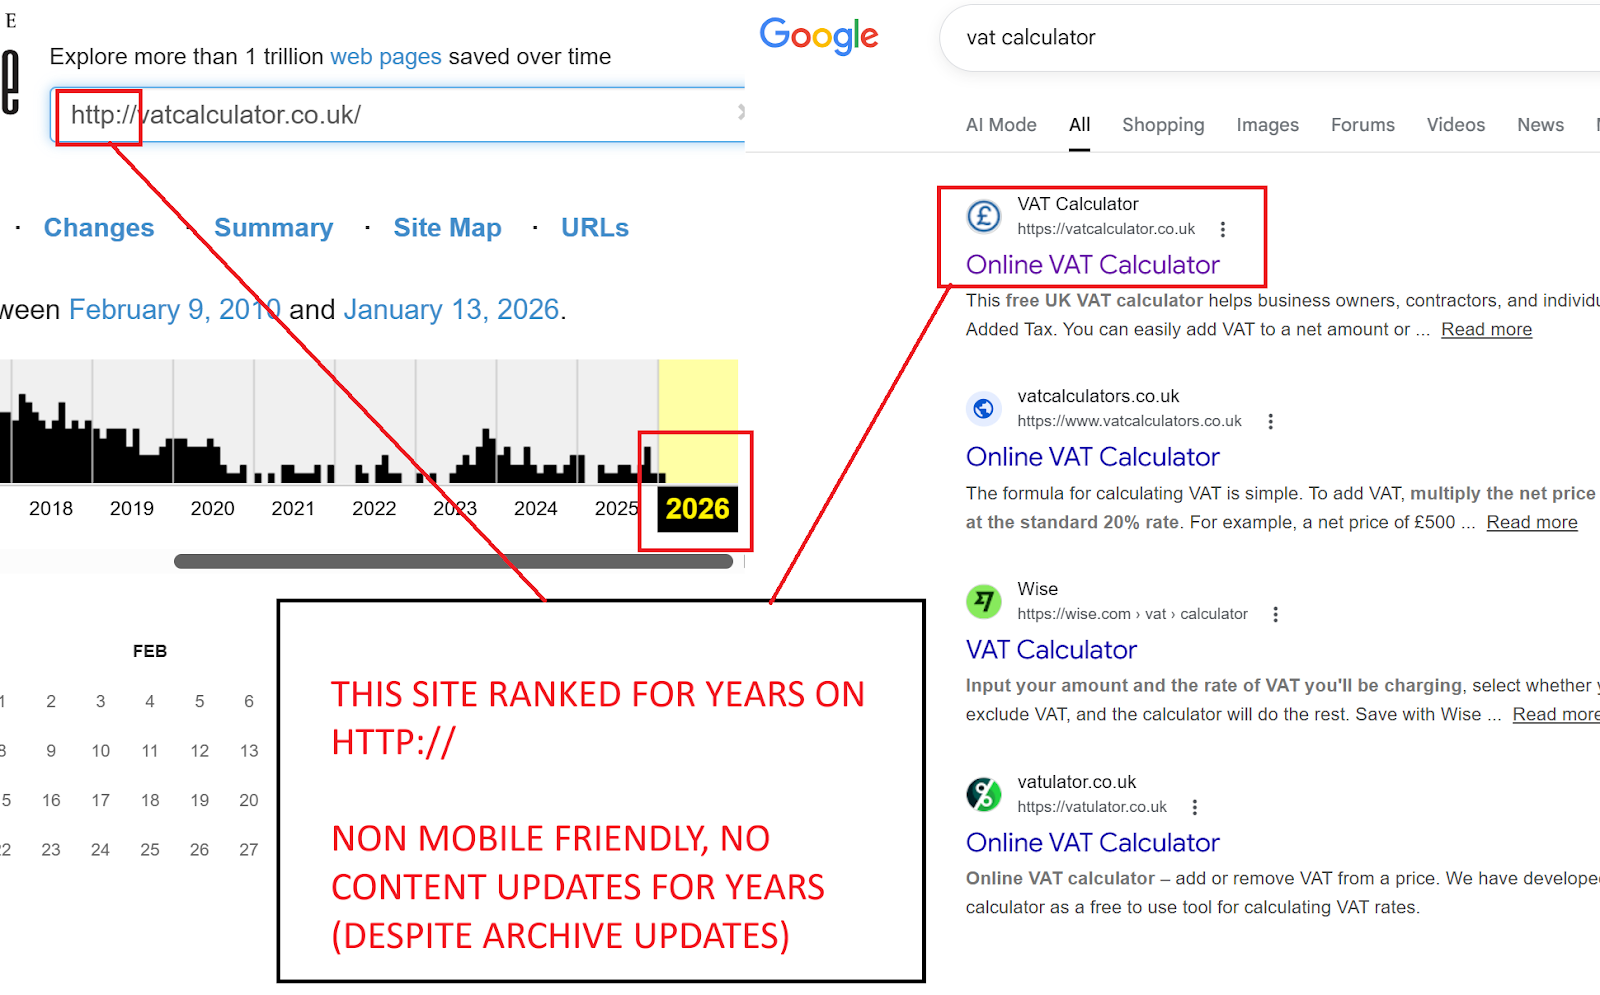
它为什么能稳稳霸榜这——么——多——年?
因为它只做一件事,并且做到了极致——它给了用户他们真正想要的东西:一个简单直接、毫不啰嗦的 VAT 计算器:
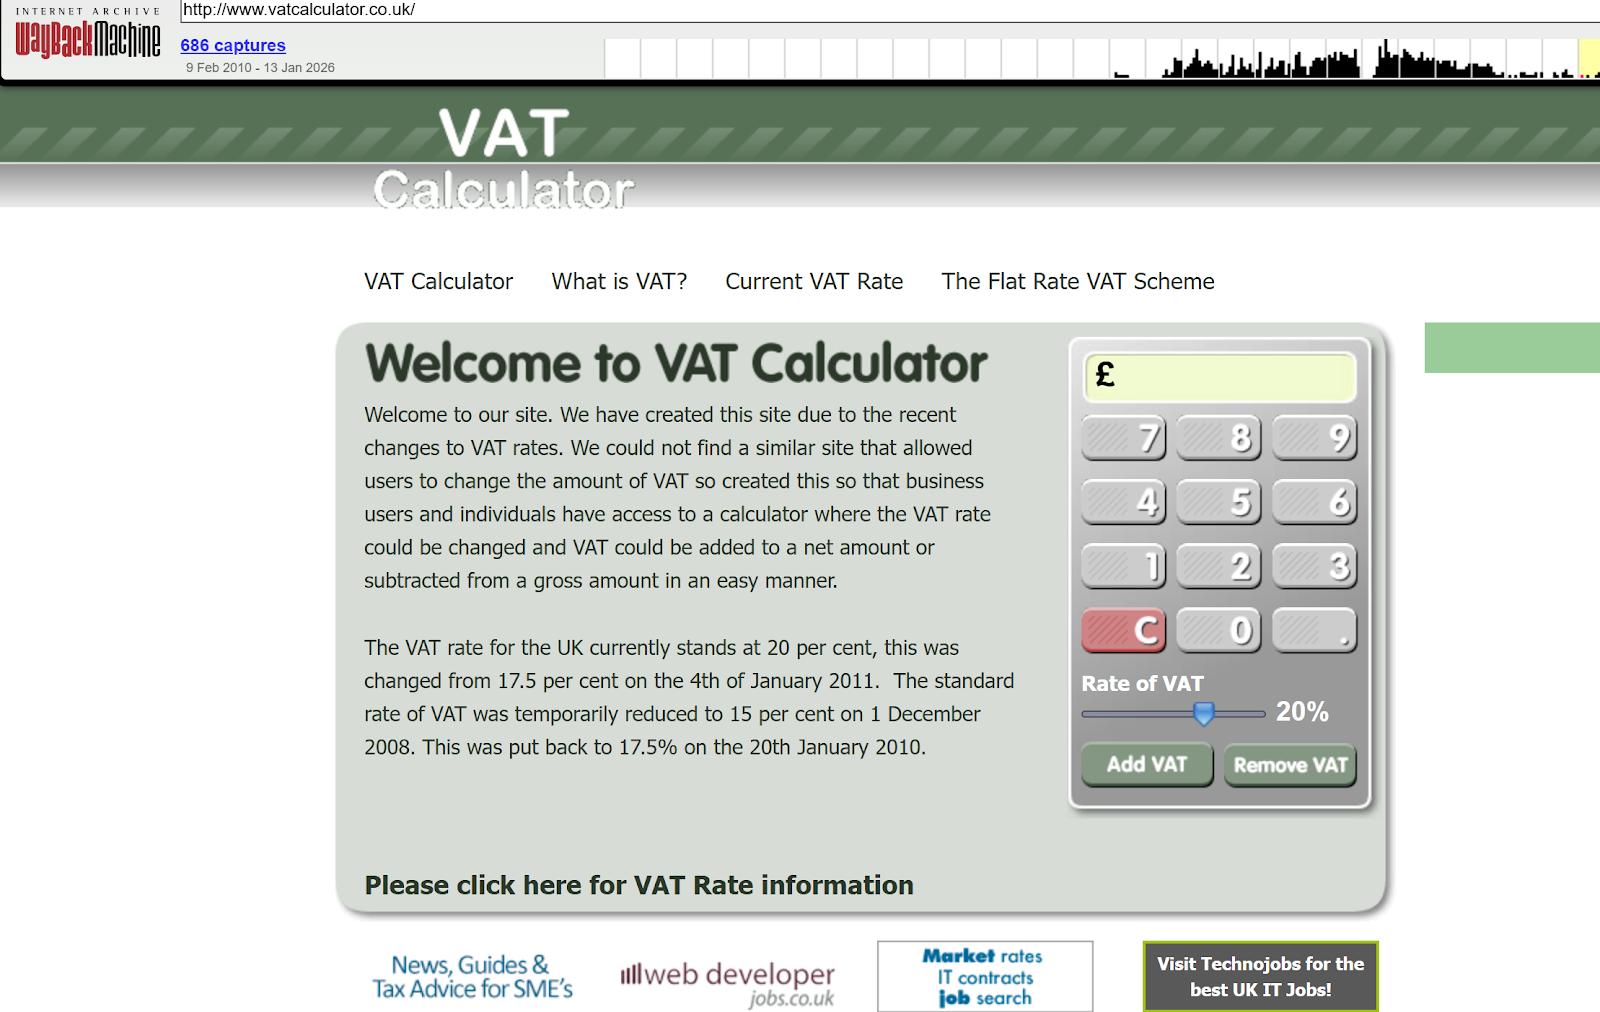
它能排上去,是因为用户真的用了这个计算器,然后结束了会话。
这就是「好点击」。
接下来,我们继续看其他的点击类型:
推测性解读:这很可能是整个模型中最有价值的单一信号。它同时捕捉了满意度(长停留)和终结性(最后一次点击)。一个页面如果在大量会话中持续获得 lastLongestClicks,说明它确实解决了查询需求。如果 Google 对这些信号赋予权重,这一项的权重大概率最高。
impressions 某个文档针对某个查询在搜索结果中被展示的次数。这是任何类 CTR 计算的分母。没有展示量,点击数就毫无意义——10 次展示带来 10 次点击的页面,与 10,000 次展示带来 10 次点击的页面,表现完全不同。
这背后其实还有一层——我会留到另一篇文章再讲,但展示量和 CTR 在这里是关键,Google 自身就在使用 CTR 数据。不过我们都知道,AI 概览已经显著蚕食了点击率,即便是那些长期稳定排名的站点也不例外——AIO 的挤压已经严重扭曲了 CTR。
absoluteImpressions 文档对这一项说得很具体:「到目前为止,该字段仅用于主机级别的 unsquashed 展示量。」这里有两点值得注意。第一,它作用于主机(host)层级,而非 URL 层级。Google 衡量的是你整个域名在结果中出现的频率,而不只是某个单独页面。第二,它被明确标注为 unsquashed——关于这意味着什么,下文会详述。
unicornClicks 文档写道:「与来自 Unicorn 用户的事件相关联的那部分点击。」这是泄露文档中较为隐晦的属性之一。公开泄露的文档中并没有进一步定义什么构成「Unicorn 用户」——所以这里我同样不做臆测。
推测性解读:以我个人的看法,最可能的解释是 Unicorn 指的是已认证、已登录的 Google 用户——即 Google 能够高置信度验证其身份和浏览历史的人。他们的点击权重会更高,因为 Google 可以确认这些是真实、独立、有既有浏览模式的人类,而不是机器人、点击农场或通过 VPN 伪装的操纵行为。另一种说法是,Unicorn 用户特指 Chrome 用户,考虑到 Chrome 与 Google 数据采集基础设施的深度集成,这也说得通。不管是哪种,含义都很清楚:并非所有点击都是平等的,Google 能够高置信度识别出的用户所产生的点击,似乎是被单独追踪和单独赋值的。
毫无疑问,Chrome 之下还有大量机制,再加上 user-agent 伪装和点击农场/点击操纵工具,它们都试图通过模仿真实用户会话来影响排名;不过在大多数情况下,点击操纵都来自未登录的浏览器。
unsquashedClicks、unsquashedImpressions、unsquashedLastLongestClicks 文档指出,这些字段正在迁移到一种新格式,数据将分别存储在 CrapsClickSignals 的 squashed 和 unsquashed 两个实例中。两个版本同时存在,这本身就揭示了 Google 处理这类数据的关键方式。
Squashed 与 Unsquashed:Google 如何对点击数据做归一化
这是整份泄露文档中最重要的架构细节之一。
「Squashing(压缩)」是一种归一化函数。Google 一项关于本地搜索结果评分的专利(US8046371B2)将 squashing 描述为一种防止某个大信号压倒其他信号的函数。实际操作中,squashing 函数会压缩数值区间——通常使用对数曲线、sigmoid 函数或硬性上限——使得 10 次点击与 100 次点击之间的差异显著,而 10,000 次点击与 100,000 次点击之间的差异则被削弱。
为什么这很重要:如果没有 squashing,高流量页面将拥有无法逾越的优势。一篇获得 50,000 次点击的 BBC 文章会淹没一个只有 500 次点击的垂直博客,哪怕后者的好点击与坏点击之比高得多。Squashing 通过压缩绝对数值、让比例说话,来拉平这个竞争环境。
而 unsquashed 值,就是应用归一化之前的原始数字。Google 同时保留两个版本,是因为它们用途不同:
Squashed 数据输入排名算法,在那里比例上的质量比绝对量级更重要
Unsquashed 数据很可能输入反垃圾检测系统,而在那里,绝对量级和异常峰值恰恰是你要找的东西
实际场景:设想 Bedford 一家本地律师事务所的网站,针对「family solicitor Bedford」这个词每月通常获得 30 次展示和 8 次点击。某一周,它突然从 500 次展示中获得了 400 次点击。Squashed 数据会削弱这个异常值,使其不至于把该站点一举推上排名高位。而 unsquashed 数据则保留了原始峰值,以便垃圾检测系统(可能是泄露文档中其他部分描述的 IP prior 或 voter token 系统)将其标记出来进行调查。
模型 2:CrapsData —— 主记录
如果说 CrapsClickSignals 是词汇,那么 CrapsData 就是句子。这个包含 22 个属性的模型,把所有点击信号与上下文绑定在一起——查询、URL、国家、设备、语言,以及若干层级的聚合与切分。
查询与 URL 的绑定
query(字符串)这些数据所对应的实际搜索查询。NavBoost 追踪的不只是「这个页面获得了 X 次点击」,而是「这个页面针对这个特定查询获得了 X 次点击」。这是「查询—文档」配对数据,意味着 NavBoost 能够区分一个页面在某个查询上表现良好、而在另一个查询上表现不佳的情况。
url(字符串)被追踪的具体 URL。
patternLevel(整数)这说明 Google 并不只追踪单个 URL,它会在多个 URL 抽象层级上聚合点击数据:
Level 0:精确 URL(例如 https://example.com/services/seo-audit)
Level 1:主机模式(例如 p://example.com)
Level 2:域名模式(例如 p://example.com 剥离至根域)
文档给出了一个具体示例:对于 http://abc.def.ghi/xyz.html,level 0 是完整 URL,level 1 是 p://abc.def.ghi,level 2 是 p://def.ghi。
为什么这很重要:这证实了 NavBoost 会同时在子域名、根域名和 URL 三个层级上运作。你某个单独页面的点击数据可能很弱,但如果你的域名整体在数百个 URL 上持续获得好点击,这种模式层级的信号很可能带来提升。反过来,一个 badClicks 比例长期偏高的域名,大概率会受到模式层级的惩罚——即便是在那些尚未积累自身点击历史的新页面上。
推测性场景:所以我的想法是,一个成熟站点(具有强势的域名层级 NavBoost 模式)上的新博文,可能会从母域名的点击历史中继承一份基础「信任」,从而比一个无点击历史的新域名上的同样文章获得更有利的排名起点。这也能解释为什么成熟站点的新内容往往能更快排上去——这不只是链接意义上的域名权重,更是在模式层级上累积下来的点击质量。
地理与语言切分
country(字符串)两位大写国家代码。文档给出的示例:「US」「FR」「BR」。
language(字符串)语言代码。示例:「en」「fr」「pt-BR」。
这意味着谷歌按国家和语言分别存储并评估点击信号。一个在德国点击指标极佳的页面,在法国的指标可能很糟糕。NavBoost 能够区分两者,并据此调整排名。
实际影响:如果你运营多语言站点,英文页面和法文页面会分别建立各自的 NavBoost 画像。某个表现优异的英文页面,其翻译质量糟糕的法文版本无法借英文点击数据的光。每个语言版本都要自己挣得(或失去)点击信号。
sliceTag(字符串)一个灵活字段,描述为允许 CRAPS 流水线"按设备类型、国家、地区等各种属性对信号进行切片"。这本质上是一个通用的分段键。slice tag 可以是任意字符串,信号会针对每个标签单独聚合,同时还有默认的空标签。
推测性解读:在我看来,这表明谷歌可以在标准的国家/语言/设备切分之外创建临时的信号分段。在重大事件期间(选举、疫情、自然灾害),他们可能创建临时的 slice tag,调整特定查询类别下点击信号的权重。这与反垄断证据一致——证据显示谷歌在 COVID-19 和选举期间部署过白名单。
设备分段
device 链接到 CrapsDevice 模型(下文详述)。
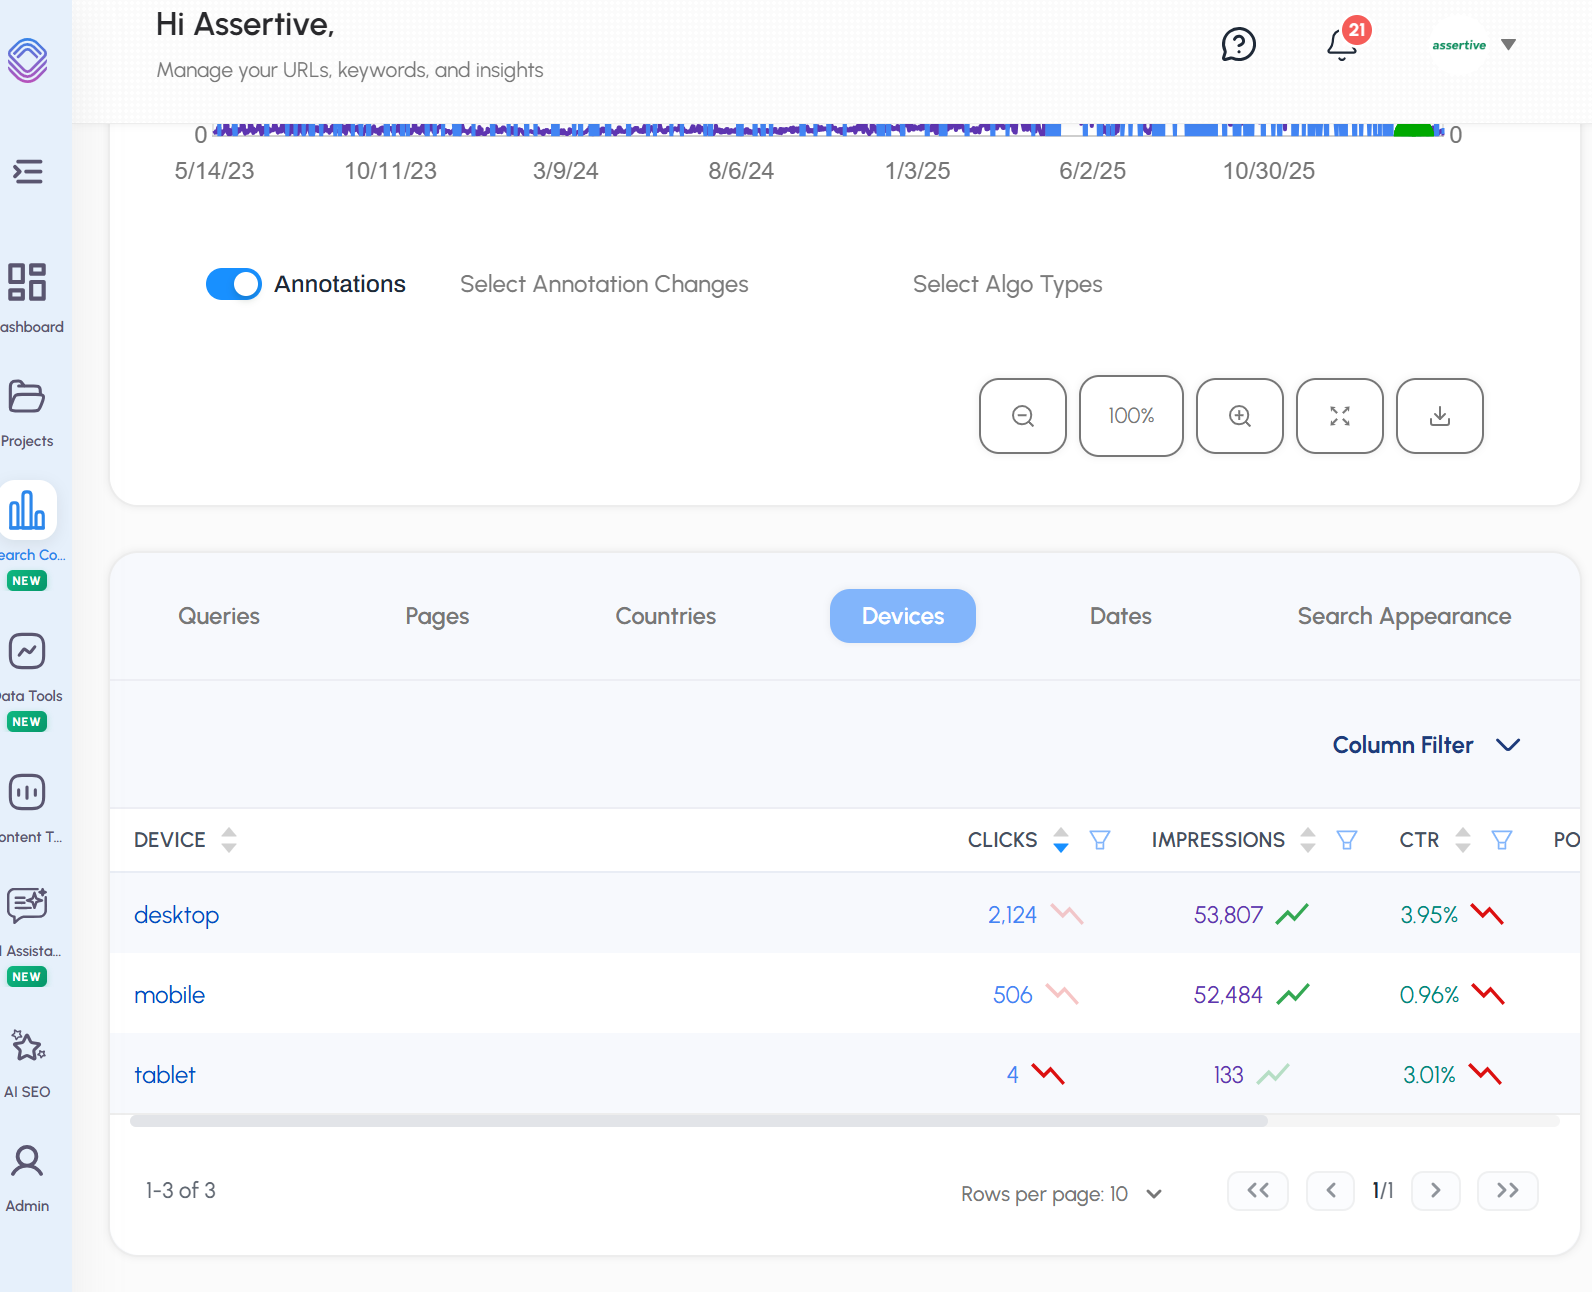
mobileSignals 一个专用的 CrapsClickSignals 实例,专门聚合自"QSessions 中的一级/二级移动端界面"。谷歌为移动端用户维护着完全独立的点击信号画像。
mobileData 被标记为遗留字段("请勿使用"),已由 mobileSignals 取代。谷歌弃用并替换该字段这一事实告诉我们,移动端信号架构经历过积极的重构,很可能是为了支持更细粒度的移动设备分类。
Squashed 与 Unsquashed 实例
squashed 一个完整的 CrapsClickSignals 实例,包含归一化后的点击数据。文档指出它最终将取代顶层的 goodClicks/badClicks/impressions 字段。
unsquashed 原始的、未归一化的实例。描述为正在为"重新调优的推出"做准备,表明在文档生成时,谷歌正在积极重新校准这两条数据流的交互方式。
unsquashedMobileSignals 归一化之前的原始移动端点击数据。
反垃圾与 IP 分析
packedIpAddress(字符串)一个按网络字节序打包的字符串,由名为 CrapsIpPrior 的系统使用。仅在谷歌于检索时查询了 IP 先验不良比例时才会填充。
unscaledIpPriorBadFraction(浮点数)用于基于 IP 地址分配先验值。文档明确引用了两个内部文件:quality/navboost/craps/craps-ip-prior.h 和 craps-penalty.cc。此处存储的值是在应用线性缩放、偏移、最小/最大运算之前的预变换值。
这告诉我们什么:谷歌维护着一套 IP 级别的信誉评分。每个 IP 地址都有一个"不良比例"——本质上是衡量来自该 IP 的点击在历史上被判定为垃圾、机器人流量或操纵行为的频率。在评估来自某个特定 IP 的点击信号时,这一先验值会调整这些点击的权重。
这或许也能解释,为什么此前的研究显示共享主机对 SEO 可能更不利——因为一个 IP 段可能与不良行为者/大规模垃圾内容等关联在一起。
事实上,几年前,一位长期的竞争对手(也是我非常要好的朋友 Shai Aharony)和他手下的一位 SEO "Oliver Sissons" 做过一个"长期共享主机实验",结果似乎也佐证了这一点:
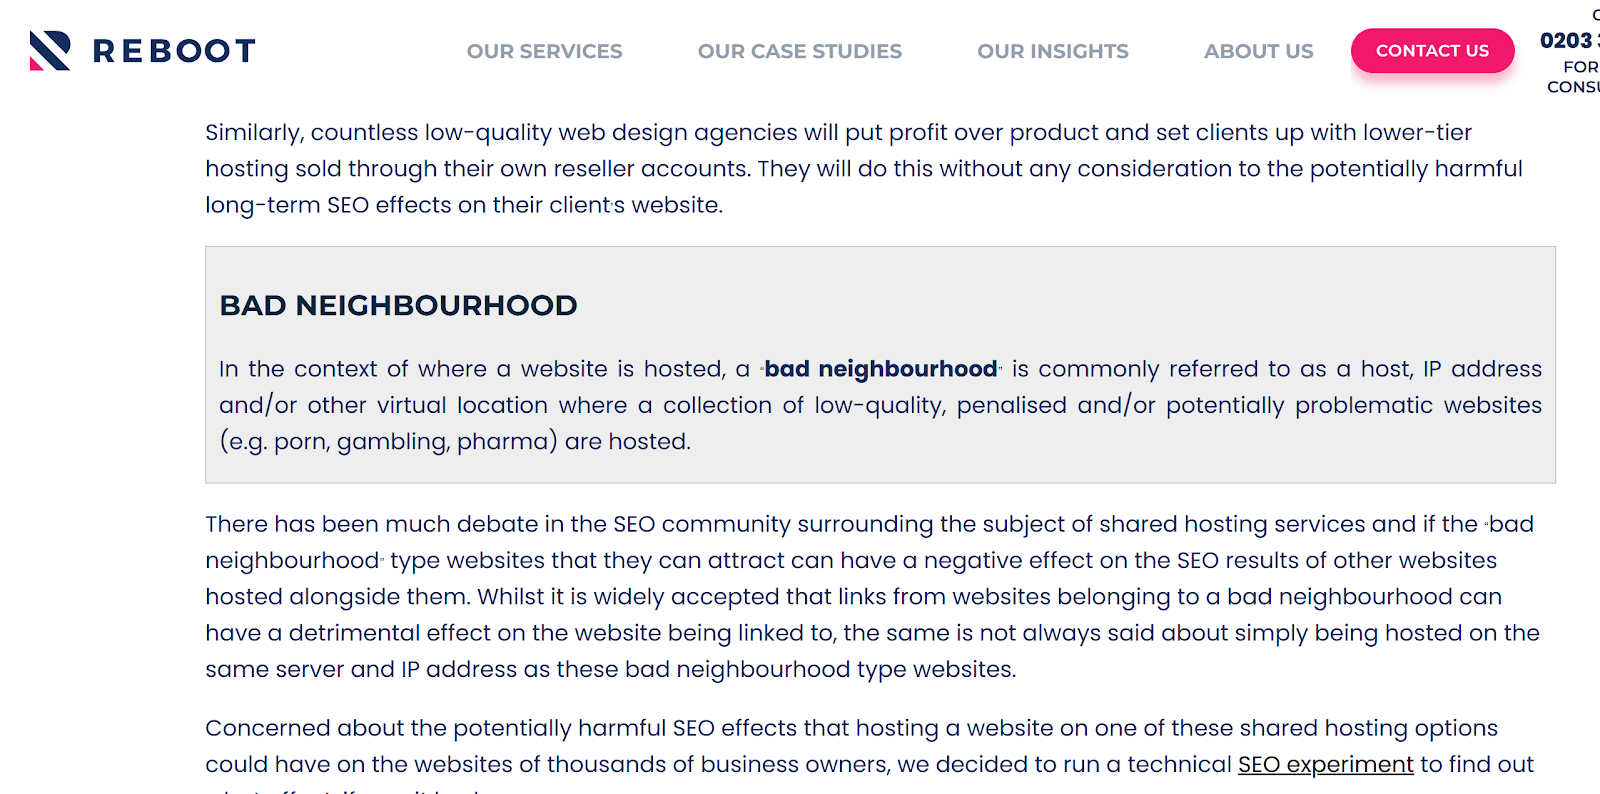
这或许能解释:
为什么有些站点在迁出共享主机后排名会有提升
为什么有些域名看起来像是"有毒"的,而实际上问题出在它们所映射的那个 IP 段——该段以垃圾/滥用闻名,于是在其上提供服务的一切都可能受牵连。
实际场景:某个 CTR 操纵服务通过伦敦的一个 VPN 出口节点刷点击,起初可能见效。但随着来自该 IP 的点击不断累积,而其中没有一次表现出自然的浏览模式(停留时长多样、自然的后续查询、点击的 URL 多元),不良比例就会上升。最终,来自该 IP 段的点击要么被大幅折损,要么被完全忽略。文档中提到的"缩放/偏移/最小/最大"变换表明存在一套阈值机制——不良比例低于某个值时,点击正常被接受;高于该值则被逐步降权;超过硬性上限则可能被直接丢弃。
这些年我用 CTR Booster + Trusted Proxies 这类工具测试过,它们通过住宅代理 IP 并伪造 user-agent 来隧道转发请求。
CTR Booster 确实有效,不过很可能随着谷歌检测能力的提升,这类会话已经变得越来越容易被识别。
投票令牌与隐私过滤
voterTokenCount(整数)"不同投票令牌的数量(对贡献该条目的不同用户数量的下界估计,用于隐私相关的过滤)。"
这一点至关重要。谷歌不只是在数点击——它在数独立的真人。投票令牌系统给出了为某个 URL 的 NavBoost 画像贡献点击的不同用户数的下界。如果一个 URL 有 500 次点击却只有 3 个投票令牌,那是极大的危险信号。如果 500 次点击来自 480 个投票令牌,那就是健康、自然的信号。
"下界"这一措辞是有意为之——投票令牌并非每个用户唯一(这一点在 FeatureCrapsData 模型中得到确认),因此该计数是保守估计。谷歌宁可低估而非高估独立用户数,这意味着隐私过滤阈值的校准是为了防范误判。
推测性解读:在我看来,几乎可以肯定存在一个投票令牌的最低阈值,低于该阈值的 URL/查询对,其 NavBoost 数据会被完全抑制。如果只有两三个用户贡献了点击,样本太小,既没有意义,也太容易被操纵。这就解释了为什么流量极低的新页面在积累到足够数量的独立用户之前,不会出现由 NavBoost 驱动的排名变化。
模式级统计
patternSccStats 链接到 StatsWithWeightsProto 模型(下文详述)。对于模式级数据,它包含了构成该模式的各个 URL 的强连通分量统计信息。换句话说,当谷歌把点击数据聚合到域名级别时,它不只是把数字加起来——它还会分析分布。各个 URL 之间的点击质量有多一致?该域名强劲的 NavBoost 画像是由一个爆款页面撑起来的,还是在数百个页面上都保持一致?
模型 3:CrapsDevice——谷歌对访客设备的了解
三个属性。简单,但很说明问题。
os(字符串)操作系统。这证实谷歌会跟踪并存储每一位点击数据进入 NavBoost 的用户的操作系统。
uxInterface(整数)来自 GWSLogEntryProto 的枚举值,表示设备类型:
1 = 桌面端
2 = 移动端
3 = 平板
文中对 "gwslog(608)" 的引用告诉我们,这些数据直接来自 Google Web Server 日志——也就是处理每一个谷歌搜索请求的那套基础设施。
uxTier(整数)浏览器能力层级:
1 = 现代浏览器
2 = 介于两者之间的所有浏览器
3 = 非常老旧的浏览器
为什么这不只是基础分段的问题:如果谷歌按浏览器层级对点击信号进行切片,就意味着该系统有可能对现代浏览器的点击与老旧浏览器的点击赋予不同权重。来自旗舰安卓设备上 Chrome 120 的点击,很可能被视为置信度更高的信号,而来自过时浏览器的点击则可能与机器人流量或老旧抓取基础设施相关联。
推测性场景:这套分层机制也可能充当反操纵的一个切入点。自动点击工具常常使用无头浏览器或较旧的用户代理,这些可能落入 tier 2 或 tier 3。如果 Google 发现某个 URL 的点击中,来自低层级浏览器的比例相较于该查询的常态明显偏高,那就是一个潜在的垃圾信号。
模型 4:FeatureCrapsData 精细地域切分
这个模型支持对点击信号做极其精细的地理与设备分段。
country(字符串)格式与 CrapsData 相同,小写(例如 "us")。文档中注明:“若不存在,则表示这是所有国家的汇总。”
language(字符串)例如 "en"。同样,缺失意味着跨所有语言的汇总。
device(字符串)简化的设备标识:"m" 表示移动端,"d" 表示桌面端。若不存在,则为跨所有设备的汇总。
locationId(整数)“都会区与城市的位置 id。若不存在,则表示这是当前国家内所有位置的汇总。”
正是这个字段确认了 NavBoost 在都会区/城市层级运作。Google 不只是知道你在英国搜索,它知道你是在伯明翰还是爱丁堡搜索,并能据此切分点击信号。
实际影响:如果你是一名 SEO 顾问,为曼彻斯特的某家企业做本地 SEO,那么客户来自曼彻斯特用户的点击信号,与来自伦敦用户的点击信号是被分开追踪的。一家餐厅若在本市用户中获得优异的点击表现,而在其他地区用户中表现不佳,就可能在本地排名很好、在全国范围排名很差——而 NavBoost 正是促成这种差异的机制。
signals 一个完整的 CrapsClickSignals 实例,包含该特定地域切片的点击数据。
voterTokenBitmap 链接到 GlueVoterTokenBitmapMessage 模型。它提供按地域划分的投票令牌追踪,意味着 Google 可以在都会区层级评估贡献点击信号的用户多样性。如果一家位于伦敦的企业突然从单一都会区的用户那里获得一波“好点击”,但投票令牌位图显示这些点击全部来自少数几个令牌,该信号就会被过滤掉。
模型 5:StatsWithWeightsProto 分布分析
这是一个统计学家的模型。十五个属性,其中十三个是浮点数,全部用于描述构成模式级汇总的那些 URL 的点击数据统计分布。
n(整数)样本量。构成该模式的单个数据点(很可能是单个 URL)的数量。
weightedN(浮点数)加权样本量。并非所有 URL 的贡献都相同——有些权重更高,可能依据流量规模或投票令牌数量。
mean, median 所测点击指标的集中趋势。
stddev, variance, varOfMean, stdError 离散度指标。该模式内各 URL 的点击信号分散程度如何?
hi, lo 分布的极值。
pc10, pc25, pc75, pc90 百分位分界点。这让 Google 对分布形态有完整的掌握。
kind(整数)一个枚举值,指明这是哪一类统计量。泄露文档没有列举可能的取值,但它很可能用于区分不同指标(好点击率、坏点击率、lastLongestClick 比率等)。
为什么这种统计细节很重要:Google 关注的不只是你的域名总体点击信号是否良好,而是你所有页面之间点击质量的分布。一个好点击率中位数为 0.6 且标准差很小的域名,是一个稳定强势的域名。而一个均值为 0.6 但标准差极大的域名——意味着部分页面极佳、另一些极差——呈现的是完全不同的质量画像。
推测性解读:在我看来,这很可能就是全站质量评估背后的机制。如果 Google 的内部系统(例如 Google 的 HCU,即有用内容更新或系统)会施加站点级的修正因子,那么 NavBoost 信号在某个域名 URL 模式上的统计分布,很可能是关键输入之一。只有几个优秀页面是不够的——如果你的 pc10(第 10 百分位)显示最差的那部分页面产生了压倒性的坏点击,就会把模式级评估整体拉低。
实际场景:某内容农场发布了 1,000 篇文章。其中 50 篇偶然表现不错,获得了好点击。另外 950 篇则产生了来回跳转(pogo-sticking)和坏点击。均值看上去可能中规中矩,但中位数很糟,pc10 接近于零,标准差极大。Google 的模式级统计会精确捕捉到这一画像,并很可能据此做出全站降权。
模型 6:GlueVoterTokenBitmapMessage 反操纵层
只有两个字符串属性,但模型描述揭示了底层机制。
文档说明该模型“用于在合并过程中汇总查询级唯一 voter_token”,并采用“4 个 uint64 作为一个 256 位位图,在 Glue 模型管线中汇总去重后的 voter_tokens”。
voterToken(字符串)单个投票令牌。作为一种优化,如果只有一个用户做出贡献,令牌就以单个 uint64 存储,而非完整位图。
subRange(字符串列表)存在多个令牌时的位图组成部分。
这大概是如何运作的:每个贡献点击的用户都会被分配一个投票令牌(它并非每个用户唯一——而是一个经过哈希、保护隐私的标识符,用作去重用户数的下界)。这些令牌被汇总进一个 256 位的位图。该位图让 Google 能在 Glue 管线处理过程中,高效地跨查询与跨时间段合并令牌集合。
对 “Glue” 的提及很有意义。正如反垄断审判中所确认的,Glue 本质上是 NavBoost 的扩展版,覆盖所有 SERP 功能——不只是十条蓝色链接,还包括知识面板、视频轮播、图片组、People Also Ask 框以及 AI Overviews。投票令牌位图确保用户多样性校验适用于所有这些功能类型。
为什么是 256 位?一个 256 位的位图最多可表示 256 个不同的投票令牌哈希桶。这意味着该系统是为高效的近似去重计数设计的,而非精确计数。对 NavBoost 的用途而言,知道“大约 180 个不同用户”做出了贡献就足够了——确切数字并不像“点击数据来自多样化、自然的用户群体”这一置信度那么重要。
Google 从哪里获取这些数据?
泄露的模型或明示、或强烈暗示地指向了几个数据来源:
Google Web Server(GWS)日志 CrapsDevice 模型明确引用了 gwslog 条目(608 和 609)。每一次搜索查询、每一次对结果的点击、每一次返回 SERP,都会被 Google 的 Web 服务器基础设施记录下来。这是首要数据源。
QSessions 在 mobileSignals 描述和 CrapsDevice 描述中均有提及。QSessions 似乎是 Google 内部的会话模型——一份结构化记录,涵盖用户在一次搜索会话中的全部行为,从初始查询到所有点击、重述查询,直至会话最终结束。
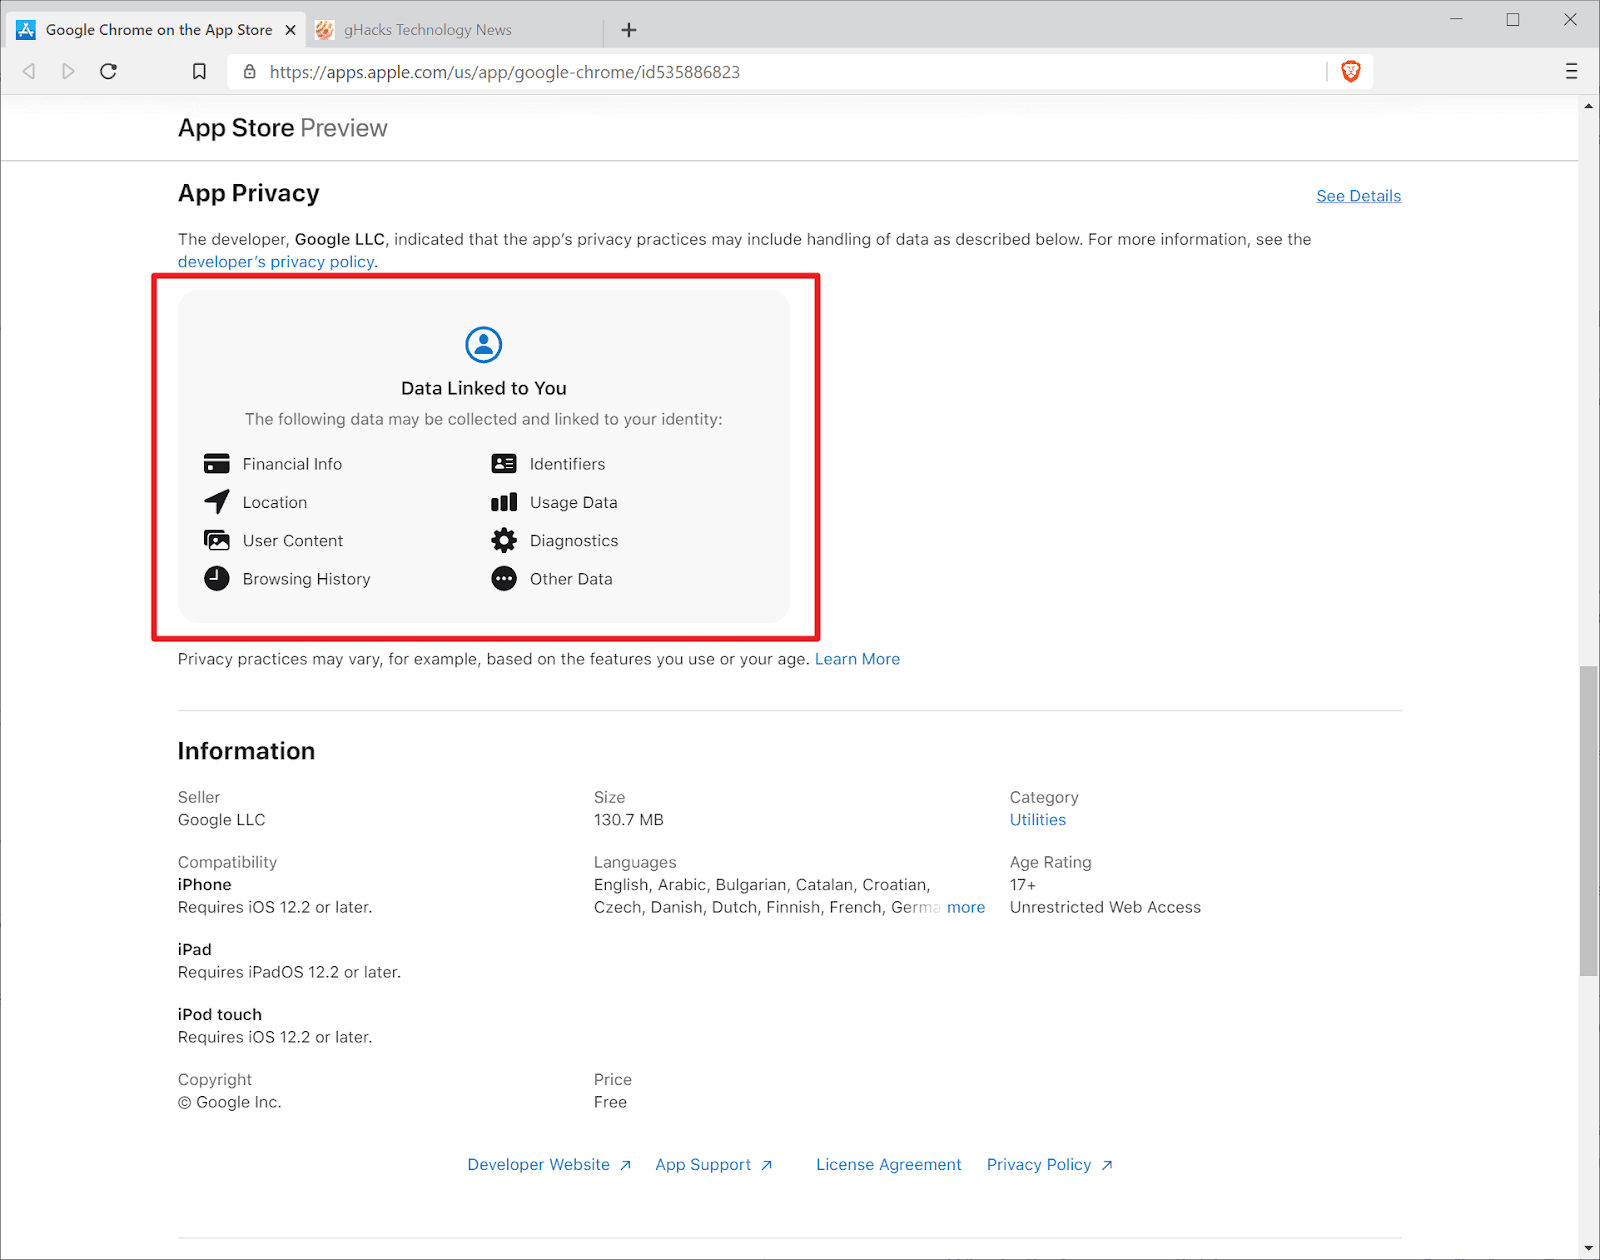
Chrome 数据 这六个模型中并未明确点名,但反垄断证据与更广泛的泄露内容中,多处提到源自 Chrome 的数据会汇入 NavBoost。“未压缩(unsquashed)”点击的概念,一直被与 Chrome 提供更高置信度用户识别的能力联系在一起。
Cookie 历史 在 Rand Fishkin 对提供泄露文档的信源的报道中有所提及。Cookie 提供会话连续性,对于已登录用户,还提供跨会话的身份持久性。
IP 地址数据 在 CrapsData 中通过 packedIpAddress 和 unscaledIpPriorBadFraction 明确存在。Google 维护着 IP 层级的信誉评分,并直接馈入点击信号评估。
推测但很可能:Android 与 Google 应用数据 Android 上的 Google 搜索以及 iOS 上的 Google 应用,会产生与桌面端 Chrome 相同的 GWS 日志条目。鉴于移动端如今已占搜索流量的大多数,它们很可能是 mobileSignals 和 uxInterface 数据的重要贡献来源。
13 个月的滚动窗口
反垄断庭审中已经证实:NavBoost 基于 13 个月滚动窗口内的点击数据运作。大约在 2017 年之前,这个窗口是 18 个月——我觉得这点有些奇怪,不太明白他们为什么没有把它和 GSC 的 16 个月数据对齐。
这带来了直接的实践影响:
新内容没有 NavBoost 信号。它必须先依靠其他信号(主题相关性、链接、新鲜度)赢得初始排名,然后才能开始积累点击数据。
表现下滑的内容不会在一夜之间失去 NavBoost 信号。半年前表现强劲的页面,其数据仍留在窗口内。但随着时间推移,更新的点击数据显示互动在下降,信号就会减弱。
季节性内容从 13 个月窗口中获益。11 月发布的圣诞礼物指南,到第二年 11 月时,其 12 月的强势点击数据仍在窗口内,让它在下一年抢得先机。
恢复中的内容:如果你修好了一个很糟糕的页面,用户开始产生正面互动,旧的糟糕点击数据不会立刻消失。你本质上是在用 3 个月的好数据稀释 10 个月的坏数据。扭转是渐进的,不是瞬间的。
NavBoost 是重排序系统,不是检索系统
Pandu Nayak 在庭审中表示:“记住,只有在文档首先被检索出来之后,你才会用到 NavBoost。”
这是一个关键区分。NavBoost 并不决定哪些页面能进入某个查询的候选集。那是由更早期的系统处理的,比如 Mustang(主要检索引擎)。NavBoost 在下游运作,调整那些已被其他信号判定为相关的页面的排列顺序。
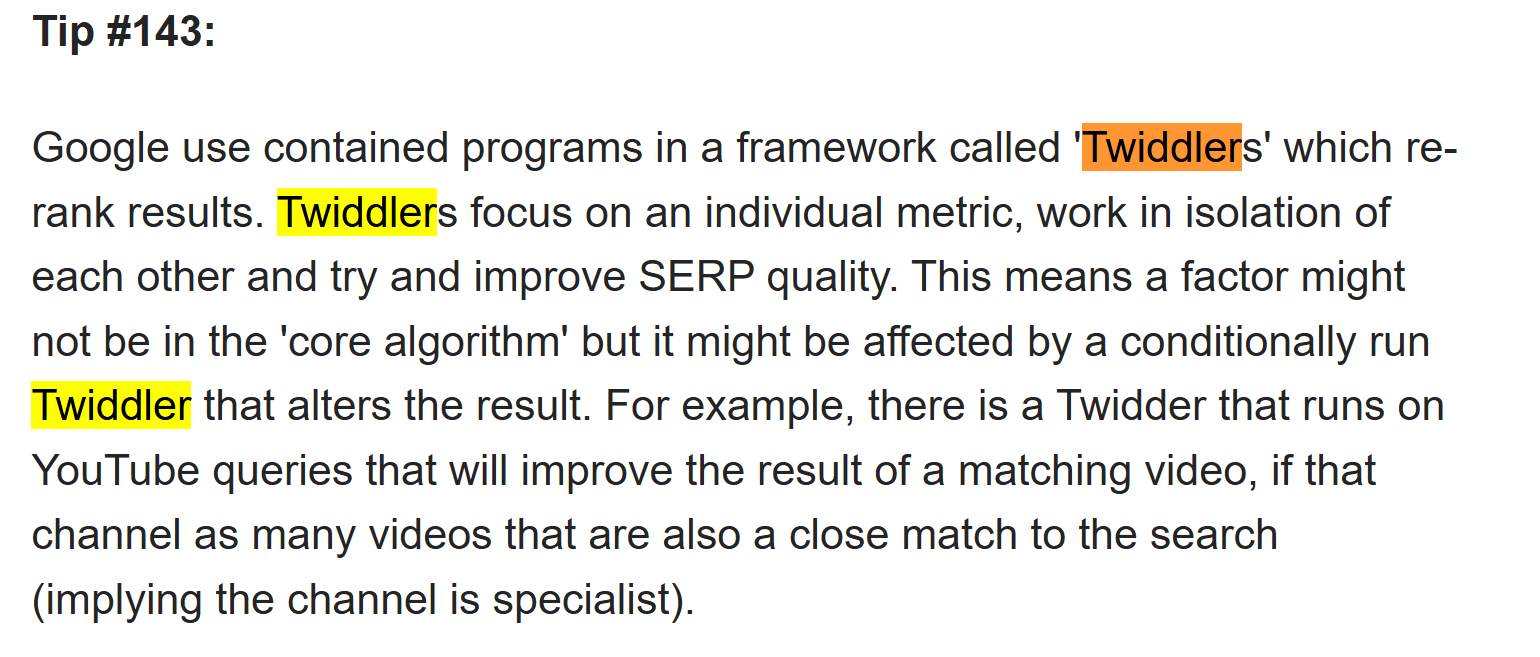
在 Google 的架构中,NavBoost 充当“Twiddler”——一种对已经过筛选的候选文档集进行重排序的系统。其他已确认的 Twiddler 包括新鲜度调整和质量提升系统。
我在 SEO 圈的一位好友 “Mark Williams Cook” 有一个500 条不请自来的 SEO 建议页面——其中从第 143 条建议开始,他讲到了 Twiddler。
这在实践中意味着什么:你无法仅凭点击信号获得排名。如果你的页面没有主题相关性、没有链接、也没有其他质量信号,它根本进不了候选集,NavBoost 也永远看不到它。但一旦你进入候选集——一旦你出现在第一页或第二页——NavBoost 可以说就成了决定你能否留在那里、上升还是被挤下去的最强力量。
边缘情况与场景
品牌查询优势
考虑这样一个查询:“Sage accounting software”。Sage.com 对这个查询几乎肯定拥有压倒性正面的 NavBoost 画像——搜索这个词的用户几乎都是在找 Sage,并点击进入 sage.com。lastLongestClicks 比率可能接近 1.0,badClicks 比率可能接近零。
现在考虑一个试图在这个查询上获得排名的竞争对手。即便拥有完美的页面 SEO 和强劲的链接,他们也要逆势对抗那些显示用户压倒性偏好点击 Sage 自家结果的 NavBoost 数据。这就是 NavBoost 的品牌护城河——对于品牌词查询,如果你自己没有相当的品牌知名度,几乎不可能突破。
本地餐厅难题
一家新餐厅在诺丁汉开业。它的 NavBoost 数据为零。它的排名基于新鲜度、本地信号,以及收录它的点评平台。用户出于好奇开始点击,但食物令人失望。访客迅速跳回搜索结果页。坏点击在 URL 层级以及城市级别的地区层级(诺丁汉对应的 FeatureCrapsData locationId)不断累积。
六个月后,这家餐厅换了老板,变得非常出色。但 NavBoost 窗口里仍然是五个月的坏点击数据对一个月的改善数据。恢复过程很慢,可能需要整整 13 个月才能让旧数据滚出窗口——除非改善程度大到足以让压缩后的比率发生实质性变化。
标题出色但内容单薄的站点
某个站点产出了数百个页面,配有极具吸引力、勾起好奇心的标题标签和元描述。点击量很高,但内容很单薄。用户落地后发现没有实质内容,于是跳出。点击量高,但 goodClicks 低,badClicks 高。lastLongestClicks 接近零,因为用户最后总会去点击另一个结果。
NavBoost 奖励的不只是点击——它奖励的是问题被解决。这个站点会积累一份灾难性的 NavBoost 画像:高展示量、尚可的点击量、糟糕的好坏点击比、几乎没有 lastLongestClicks。patternLevel 聚合会把这种负面信号扩散到整个域名。
低流量的专家型页面
一个高度专业的技术页面每月获得 50 次展示。其中 15 次产生点击,而这 15 次中有 14 次是停留时间很长的好点击。voterTokenCount 显示有 14 个不同用户。好点击比率极为出色,但绝对数字非常小。
这正是压缩机制对该页面有利之处。压缩后的数据把绝对量归一化,让比率得以凸显。但较低的投票令牌数可能触发隐私过滤,在更多用户贡献数据之前,有可能完全抑制 NavBoost 信号。这是系统中一个真实存在的矛盾——低流量的专家型内容可能需要先达到最低用户门槛,NavBoost 才会帮到它。
跨设备表现不一致
某个页面在桌面端渲染精美,但在移动端是坏的。桌面用户(uxInterface: 1)产生强劲的好点击信号。移动用户(uxInterface: 2)不断跳回搜索结果,产生坏点击。由于 NavBoost 通过 mobileSignals 以及 FeatureCrapsData 中的设备切分维护独立的移动端信号,同一个页面在同一个查询上可能同时在桌面端排名很好、在移动端排名很差。
这不是理论推演。很多 SEO 都观察到同一页面、同一查询在移动端和桌面端排名不同,而 NavBoost 的设备级信号切分极有可能是其中一个促成机制。
NavBoost 对你的 SEO 策略意味着什么
泄露文档没有告诉我们权重,也没有告诉我们阈值。但它告诉了我们架构,而架构揭示了 Google 看重什么:
满意度高于吸引力:这意味着好点击和 lastLongestClicks 是与原始点击分开追踪的。拿到点击只完成了一半。留住用户——成为终结这次搜索会话的那个结果——才是 NavBoost 真正奖励的。
一致性高于峰值:这意味着 StatsWithWeightsProto 模型及其百分位分布和标准差计算告诉我们,Google 关心的是你全站点击质量的一致程度,而不只是你表现最好的那几个页面。
多样性高于数量,这意味着:voterTokenCount 和投票令牌位图系统证实,来自 5 个用户的 1000 次点击,价值低于来自 90 个用户的 100 次点击。自然、多样的互动才是信号。人为堆量则是危险信号。
情境高于聚合:这意味着国家切分、语言切分、城市级 locationId、设备分段、浏览器层级分类——NavBoost 不会在真空中评估你的页面。它会按查询、按地区、按设备、按浏览器层级分别评估。你的排名是数十次相互重叠的 NavBoost 评估的产物,每一次都取自你点击数据的不同切片。
这个 Google 多年来一直否认其存在的系统,按 Google 自己的内部评估,是他们建造过的最强大的排名信号之一。Content Warehouse 泄露给了我们结构定义,反垄断庭审给了我们证实。接下来如何运用这份理解,取决于我们自己。
作为 SEO,我们能做的一件事就是推测、辩论和测试。自从 Content Warehouse 泄露以来,我就一直着迷于里面的信息量之大——我从原始 GitHub 仓库在被下架前发布的一份副本中克隆了代码,在里面你能看到许多其他因素。本文讲的是 NAVBOOST,因为它在 SEO 中扮演着如此内在的角色,但从富摘要质量到 SpamBrain,还有太多内容值得拆解。
点击查看SEO Datawarehouse —— 里面列出了全部 14,027 个属性(并非全部与 SEO 相关),但我做了标注,你可以看到哪些条目被用于排名权重的概率更高。
另外几点想法:
但是 DANIEL,如果排名不够靠前、拿不到点击来做评估,用户行为怎么可能成为排名因素?
Google 的排名是由多个算法共同决定的,很多时候,那些尚未被 NAVBOOST 影响的网站,会在满足其他条件后获得被评估的机会。
一般来说——如果网站在技术层面没问题,也就是 Google 能够抓取、渲染、访问并索引内容——只要内容质量好、主题契合,并且存在其他能表明可信度与质量的信号,Google 就会让新站或数据量有限/较少的网站获得排名。NAVBOOST 不需要应用到所有网站上,只需要应用在排名位置已经能带来可观点击的网站上。
我的看法是,网站会得到证明自己的机会——这也是为什么核心更新会让 SERP 发生变动,它让其他内容有机会获得排名;只有那些真正能在较长时间内持续展现出正向用户互动的内容,才往往能在历次核心更新中守住排名。
但我们都知道,Google 里没有什么是真正始终如一的。
本文中提到的所有模型名称、属性名称和文档摘录,均来自 2024 年 5 月泄露的 Google Content Warehouse API 文档,相关内容已整理收录于seo-datawarehouse.com。反垄断审判证词来自 United States of America v. Google LLC 的公开法庭记录。凡属推测性的解读,文中均已明确标注。
我热爱 SEO,也热爱推测、争论和 SEO 测试,但本文中没有任何内容是我会称之为定论的,我加入了自己的推测性想法——不过有一点我可以确定!
Chrome 就是一匹获取数据的特洛伊木马,而点击行为是判断某样东西好坏的最佳方式之一!点击行为确实很重要。

SEO Stack 创始人
Daniel 是 SEO Stack 的创始人。他在技术 SEO 和搜索数据领域深耕二十余年,在客户项目中一次又一次撞上 Search Console 的同样限制后,他着手打造了 SEO Stack。
Daniel 拥有丰富的 SEO 经验,创办过 SEO 代理机构、审计业务以及一家发展良好的咨询公司。业余时间里,Daniel 喜欢做 SEO 实验并分享实验结果。
发布于 2026年3月29日


