NavBoost im Detail: Was das Google-Content-Warehouse-Leak tatsächlich über klickbasiertes Ranking verrät
Google hat der SEO-Branche jahrelang erzählt, dass Klicks keine Rolle spielen. Dass Dwell Time irrelevant sei. Dass CTR nur Rauschen sei. Tatsächlich habe ich das viele Jahre lang auf LinkedIn lautstark vertreten, viele…
Google hat der SEO-Branche jahrelang erzählt, dass Klicks keine Rolle spielen. Dass Verweildauer irrelevant sei. Dass CTR nur Rauschen sei. Tatsächlich habe ich das viele Jahre lang auf LinkedIn lautstark angeprangert, und viele nannten mich einen Verschwörungstheoretiker.
„Dan, Google nutzt keine Verhaltensdaten für Rankings“ oder „was passiert, wenn eine Seite kein GSC oder Google Analytics eingerichtet hat?“.
Aber in Wahrheit wusste ich, dass Google diese Daten nutzt. Ich habe unzählige SEO-Tests durchgeführt – ich habe ein paar Domains gekauft und Klickmanipulation mit CTR Booster + Residential Proxies mit randomisierten User Agents und unterschiedlichem Seiten-/Interaktionsverhalten getestet.
Ich habe einmal eine Dummy-eCommerce-Website www.bulkco.co.uk aus solchen Tests heraus zum Ranken gebracht – sie rankte über 3+ Jahre für Tausende von Keywords mit einer schwachen Domain.
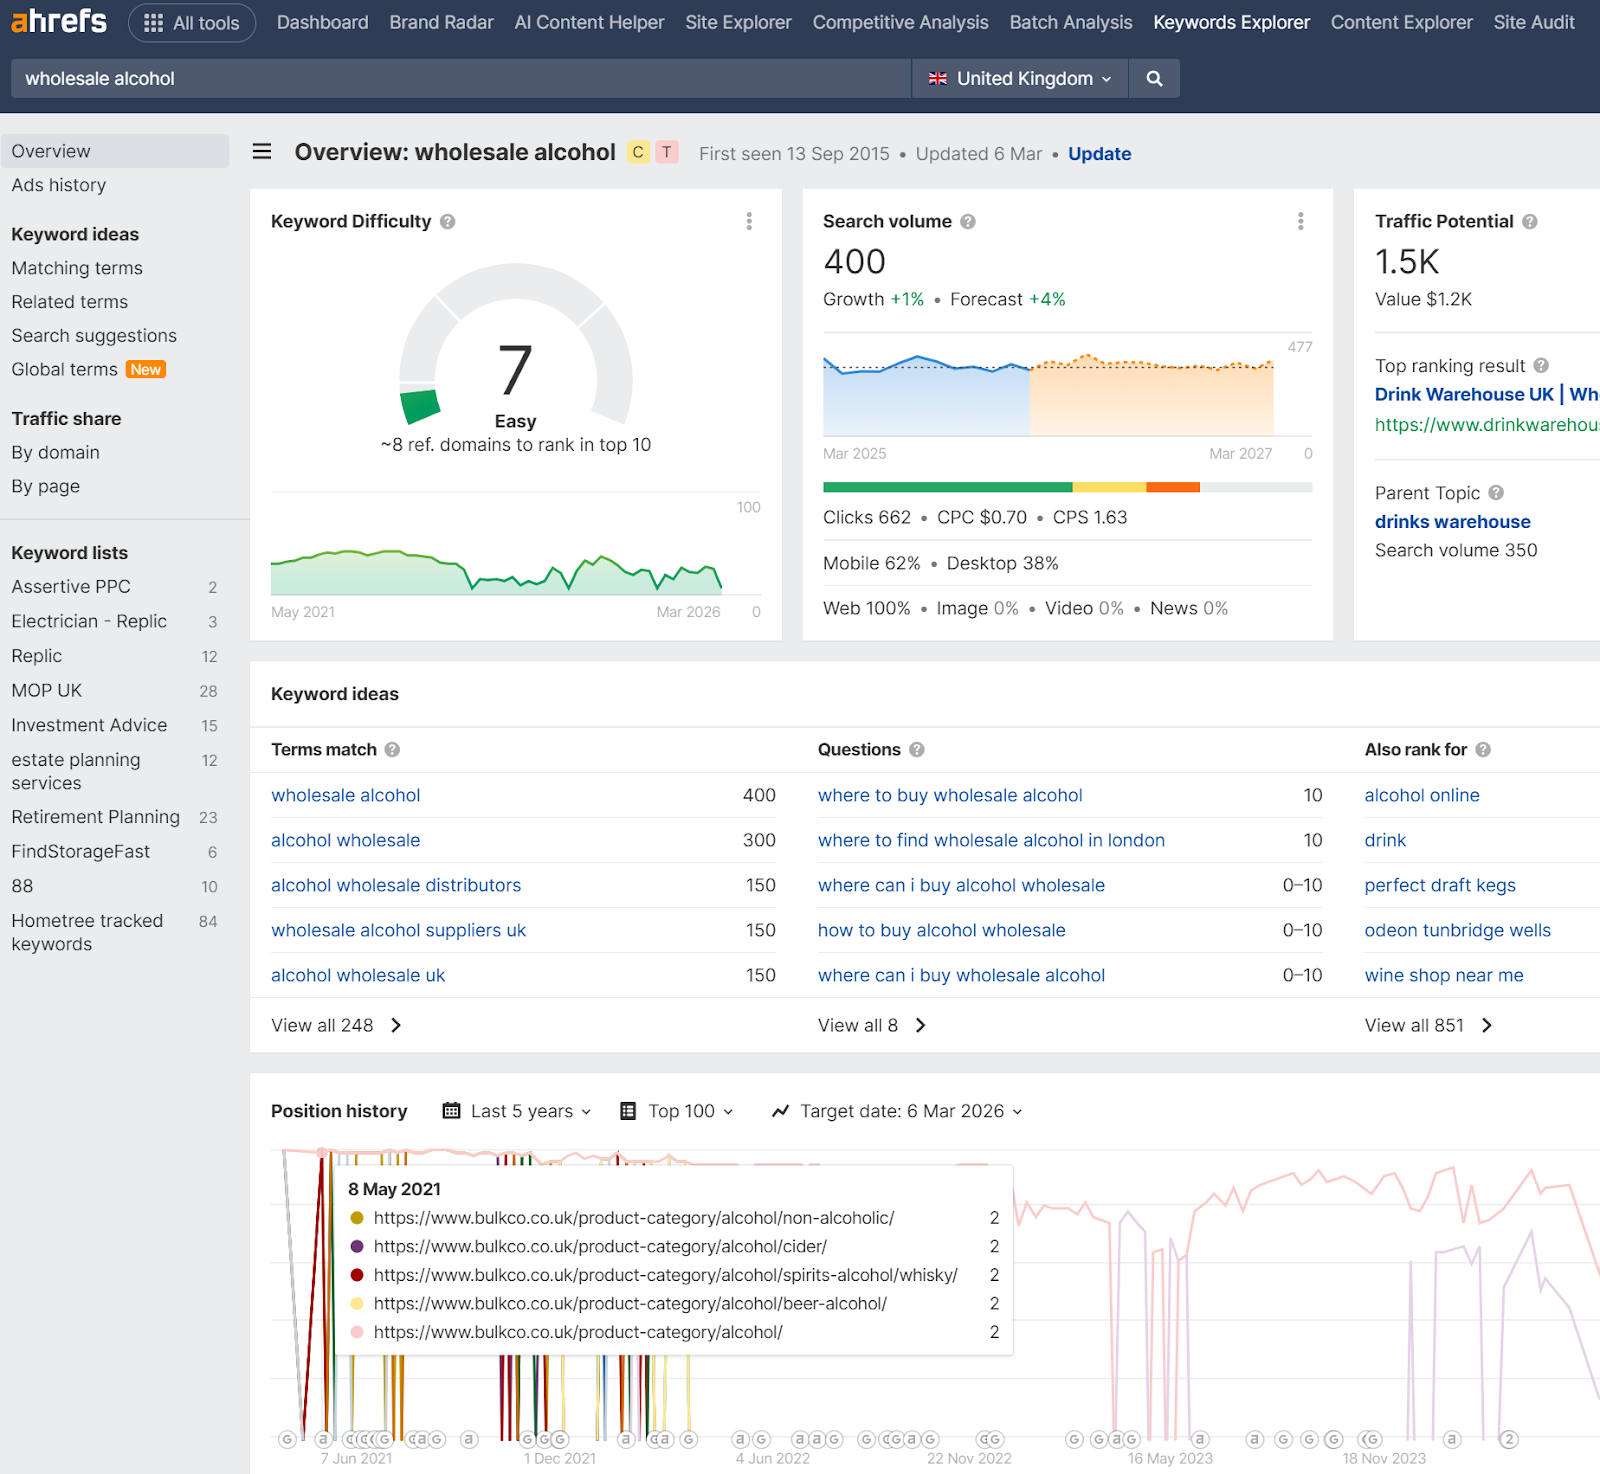
Ich wusste, dass da etwas im Busch war, und dank eines Leaks und der darauffolgenden DOJ-Verfahren wissen wir jetzt, dass Google Verhalten nutzt – daher haben wir Navboost.
Im Mai 2024 wurde also die Dokumentation der Content Warehouse API geleakt, und direkt dort im Schema – 84 Mal über sechs dedizierte Modelle hinweg referenziert – stand NavBoost. Ein System, das gute Klicks, schlechte Klicks, lange Klicks, Impressionen, Gerätetypen, geografische Segmentierung, IP-basierte Fraud-Scores und Voter-Tokens für einzelne Nutzer erfasst – es dauerte nicht lange, bis man anfing, die Teile zusammenzusetzen.
Monate zuvor hatte Google-VP Pandu Nayak im US-Kartellverfahren des DOJ bereits unter Eid bestätigt, dass NavBoost „eines der wichtigen Signale“ ist, die Google nutzt. Interne E-Mails, die als Beweismittel vorgelegt wurden, gingen noch weiter. Google-VP Alexander Grushetsky schrieb 2019, dass NavBoost allein bei Klick- und Präzisionsmetriken wahrscheinlich mächtiger sei als der gesamte Rest des Rankings zusammen, und dass Entwickler außerhalb des NavBoost-Teams unzufrieden darüber seien, wie viel Einfluss es habe.
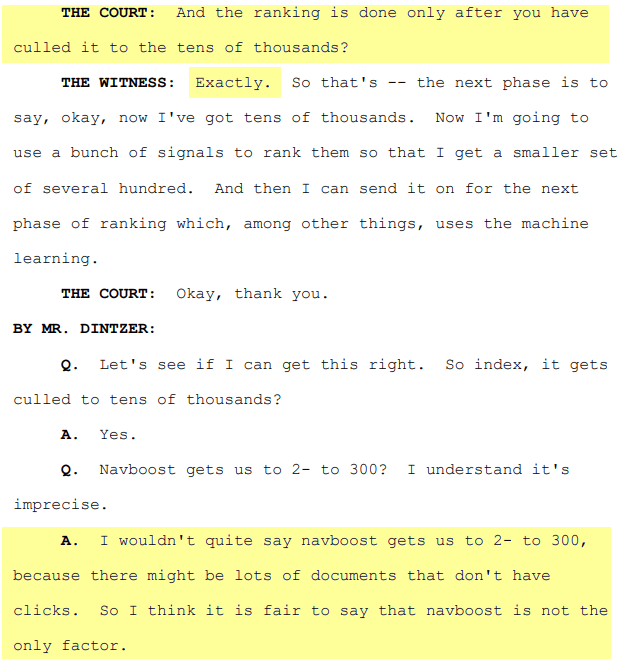
Mehr dazu im Original-PDF, gehostet vom DOJ
Dieser Artikel geht jedes Modell der NavBoost-Kategorie aus der geleakten Content-Warehouse-Dokumentation durch. Wo uns das Schema etwas Konkretes sagt, stellen wir es klar dar. Wo Feldnamen und Strukturen eine wahrscheinliche Interpretation nahelegen, aber Spielraum für Mehrdeutigkeit lassen, sagen wir das und bieten eine begründete Theorie an. Das Ziel ist, dir ein echtes technisches Verständnis davon zu geben, was geleakt wurde – nicht eine neu verpackte Zusammenfassung, in der die Unbekannten übertüncht werden.
Eines muss ich klarstellen: Als SEO ist es meine Aufgabe, immer nützliche Einsichten und faktisch korrekte Informationen zu liefern, wo ich kann – ich weiß nicht, WIE diese Modelle angewendet werden und in welchem Ausmaß, das weiß niemand. ABER wir können schlussfolgern bzw. spekulieren – in manchen Fällen ist es wohl sehr offensichtlich, wie diese Daten erhoben/genutzt werden, aber in welchem Ausmaß?
Niemand weiß es.
Okay, dann los..........
Die sechs NavBoost-Modelle
Der Leak legte sechs Protocol-Buffer-Modelle unter dem Namespace QualityNavboost offen. Jedes wurde von den Analysten, die den Leak katalogisierten, mit 10/10 für SEO-Impact bewertet. Es sind:
QualityNavboostCrapsCrapsClickSignals Der zentrale Container für Klicksignale (10 Attribute)
QualityNavboostCrapsCrapsData Der Master-Datensatz, der Klicks mit URLs, Queries, Geräten und Standorten verknüpft (22 Attribute)
QualityNavboostCrapsCrapsDevice Geräte- und Browser-Klassifizierung (3 Attribute)
QualityNavboostCrapsFeatureCrapsData Segmentierung von Signalen nach Locale und Feature-Ebene (6 Attribute)
QualityNavboostCrapsStatsWithWeightsProto Statistische Verteilungsdaten für die Aggregation auf Pattern-Ebene (15 Attribute)
QualityNavboostGlueVoterTokenBitmapMessage Nutzer-Deduplizierung und Datenschutzfilterung (2 Attribute)
Bevor wir uns die einzelnen Modelle vornehmen, verdient der Name eine Anmerkung. „CRAPS“ scheint ein internes Google-Akronym zu sein, das wahrscheinlich für so etwas wie Click and Results Prediction System steht, auch wenn das nie offiziell bestätigt wurde. Ob es außerdem eine augenzwinkernde Anspielung auf das Würfelspiel ist (angesichts der probabilistischen Natur der Vorhersage von Nutzerzufriedenheit aus Klickmustern) oder auf die Jahre, in denen Google klickbasierte Theorien öffentlich als „erfundenen Mist“ abtat, bleibt dem Leser als Übung überlassen.
Und nein, verwechseln wir Craps nicht mit Toilettenhumor oder einem Casinospiel:
Modell 1: CrapsClickSignals – die zentrale Klick-Taxonomie
Das ist das grundlegende Modell. Es enthält zehn Float-Attribute, und seine Beschreibung in der geleakten Dokumentation ist kurz, aber aufschlussreich: „Click / impression signals for craps.“
Jeder Float steht hier für eine Anzahl oder ein Verhältnis. Das sind keine binären Flags – es sind kontinuierliche Werte, was bedeutet, dass Google mit ziemlicher Sicherheit mit gewichteten, normalisierten Zahlen arbeitet und nicht mit rohen Ganzzahlen – aber auch das ist spekulativ und NICHT bestätigt (das wollte ich nur klarstellen).
Die Attribute
clicks Die Gesamtzahl der Klicks für ein bestimmtes Dokument bei einer bestimmten Query (oder einem Query-Cluster). Das ist die Basislinie. Alles andere in diesem Modell ist eine Verfeinerung oder eine Teilmenge dieser Zahl. Grundsätzlich muss ein Klick erfolgen, damit überhaupt eine Bewertung stattfinden kann.
Es wird also klar Klicks geben, die entweder zu einem zufriedenen oder unzufriedenen Nutzer führen. Nehmen wir Hide the Pain Harold (wer liebt ihn nicht als Meme).
goodClicks Klicks, die Google als erfolgreiches Nutzerergebnis wertet. Der Leak definiert die genauen Kriterien nicht, aber basierend auf den Aussagen im Kartellverfahren und jahrelanger Pogo-Stick-Analyse in der SEO-Community beinhaltet ein guter Klick mit ziemlicher Sicherheit, dass der Nutzer ein Ergebnis anklickt, eine nennenswerte Zeit auf dieser Seite bleibt und nicht zur SERP zurückkehrt, um etwas anderes anzuklicken. Mit anderen Worten: Der Klick hat die Suchanfrage aufgelöst.
Hide the Pain Harold nach dem Besuch einer Website, die ihn in die Irre geführt hat oder keine gute Nutzererfahrung bot:
badClicks Das Gegenteil. Klicks, bei denen der Nutzer schnell zu den Suchergebnissen zurückkehrte. Das ist das Pogo-Sticking-Signal, von dem Google jahrelang behauptete, es existiere nicht als Rankingfaktor. Das geleakte Schema bestätigt, dass es ein benanntes, gespeichertes Attribut mit Float-Wert innerhalb eines Modells mit 10/10 SEO-Impact ist.
Falls du dich fragst, was Pogo bedeutet: Es bezieht sich auf „Pogo Sticking“, also den schnellen Wechsel von einem Zustand in den anderen – d. h. du besuchst eine Website und verlässt sie schnell wieder. Übrigens braucht Google kein Analytics, um zu wissen, wie lange die Interaktion gedauert hat – erinnerst du dich an diesen kleinen Browser namens Chrome? Genau, der ist auch ein trojanisches Pferd für Verhaltensdaten!
Wirf einen Blick auf diesen Artikel über die dunkle Seite von Google Chrome und wie dein Browser dich verrät
lastLongestClicks Hier wird es interessant. Die Dokumentation des übergeordneten CrapsData-Modells beschreibt dies als „die Anzahl der Klicks, die bei verwandten Nutzeranfragen die letzten und längsten waren.“ Hier geht es nicht nur darum, wie lange jemand isoliert betrachtet auf deiner Seite geblieben ist. Es geht darum, ob dein Ergebnis dasjenige war, bei dem der Nutzer geblieben ist – der letzte Klick seiner Suchsitzung und derjenige, bei dem er die meiste Zeit verbracht hat. Wenn ein Nutzer Ergebnis A anklickt, abspringt, Ergebnis B anklickt, abspringt und dann Ergebnis C anklickt und vier Minuten bleibt, bevor er den Tab schließt, bekommt Ergebnis C die Gutschrift für den lastLongestClick.
Das ist der Grund, warum ich glaube, dass Google SERPs durchmischt, besonders dort, wo die Intention der Suchanfrage „vager“ wird – d. h. wenn du nach „Auto“ suchst, spezifizierst du nicht, was du willst, oder? Willst du wissen, was ein Auto ist? Willst du eins kaufen? Willst du wissen, welche Automarken es gibt?
VARIIERTE SERPS geben Google einen größeren Pool zur Auswertung – verschiedene Intentionen in einer SERP ausspielen, über die Zeit Klickdaten sammeln; das aggregierte Verhalten über die Zeit hilft Google, besser zu verstehen, was „die Mehrheit will“.
Ich glaube, das ist der Grund, warum Google oft verschiedene Ergebnisse durchmischt hat, und auch der Grund, warum wir über viele Jahre hinweg Seiten gefunden haben, die einfach nicht ins Profil einer Seite passten, die ein Ranking verdient – und die trotzdem rankten!
Jahrelang rankte zum Beispiel vatcalculator.co.uk, eine EMD, auf Platz 1 für „vat calculator“ – und zwar seit 2009, und sie rankt bis heute auf #1. Es war eine unoptimierte EMD ohne HTTPS, nicht mobilfreundlich, die Definition einer Seite, die einfach gebaut, veröffentlicht und dann liegengelassen wurde!
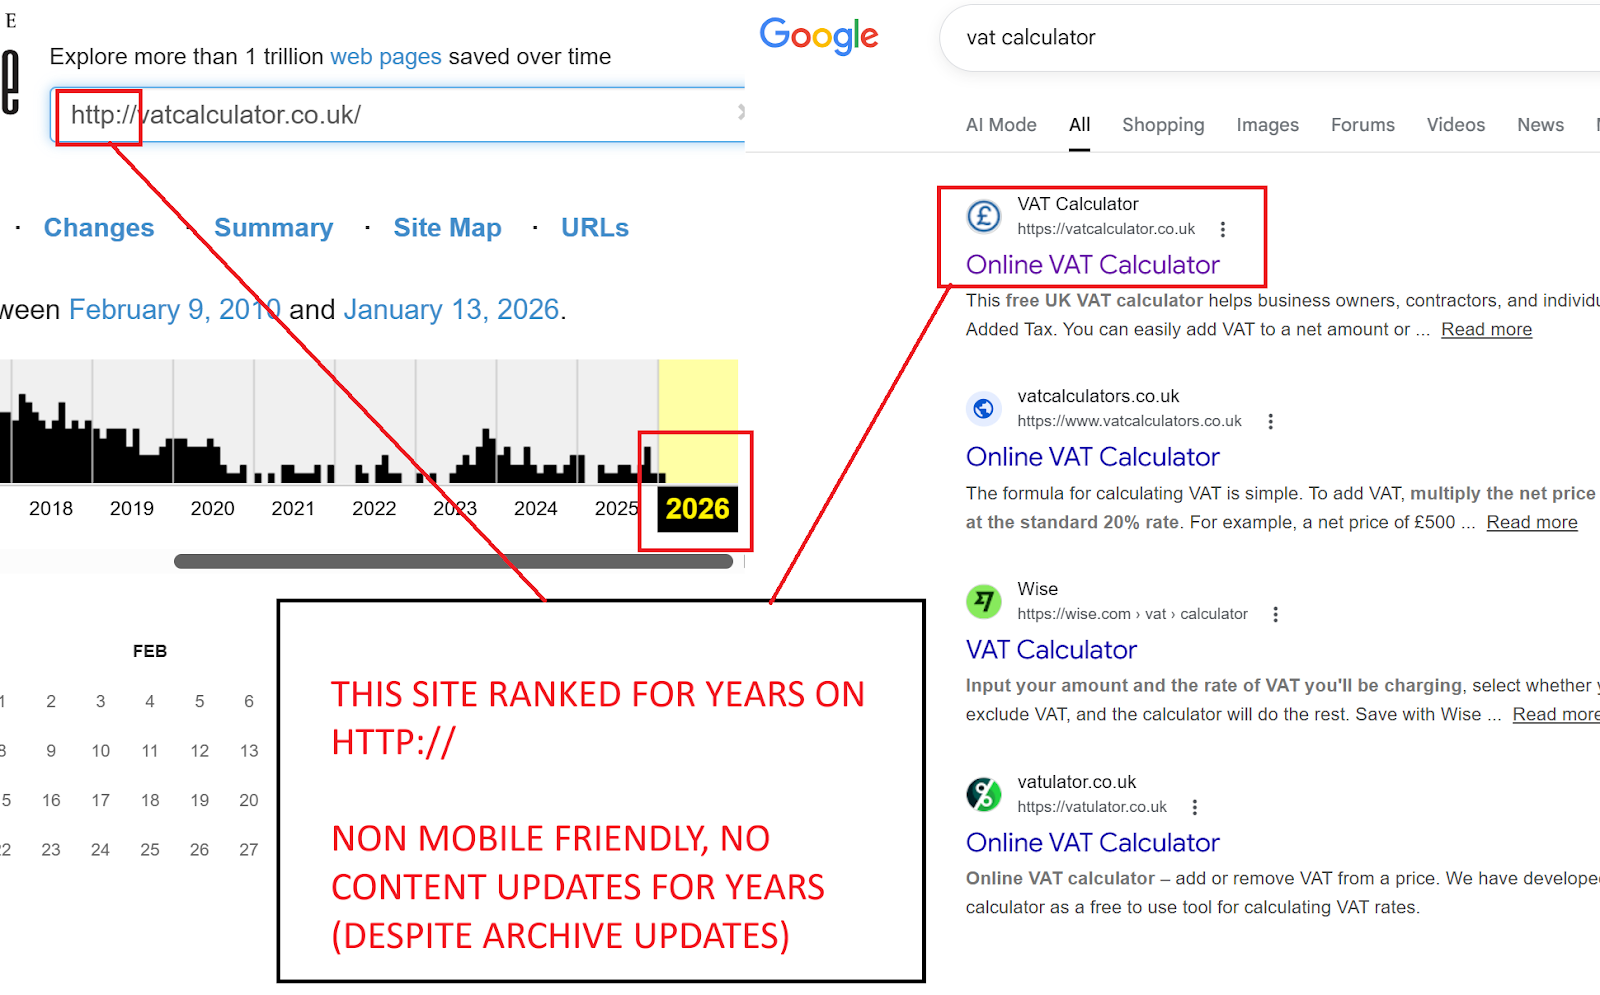
Warum hielt sie SOOOOO viele Jahre ihr Ranking?
Weil sie eine Sache tat und die richtig gut – sie gab den Nutzern GENAU das, was sie wollten: einen unkomplizierten, einfach zu bedienenden Mehrwertsteuer-Rechner:
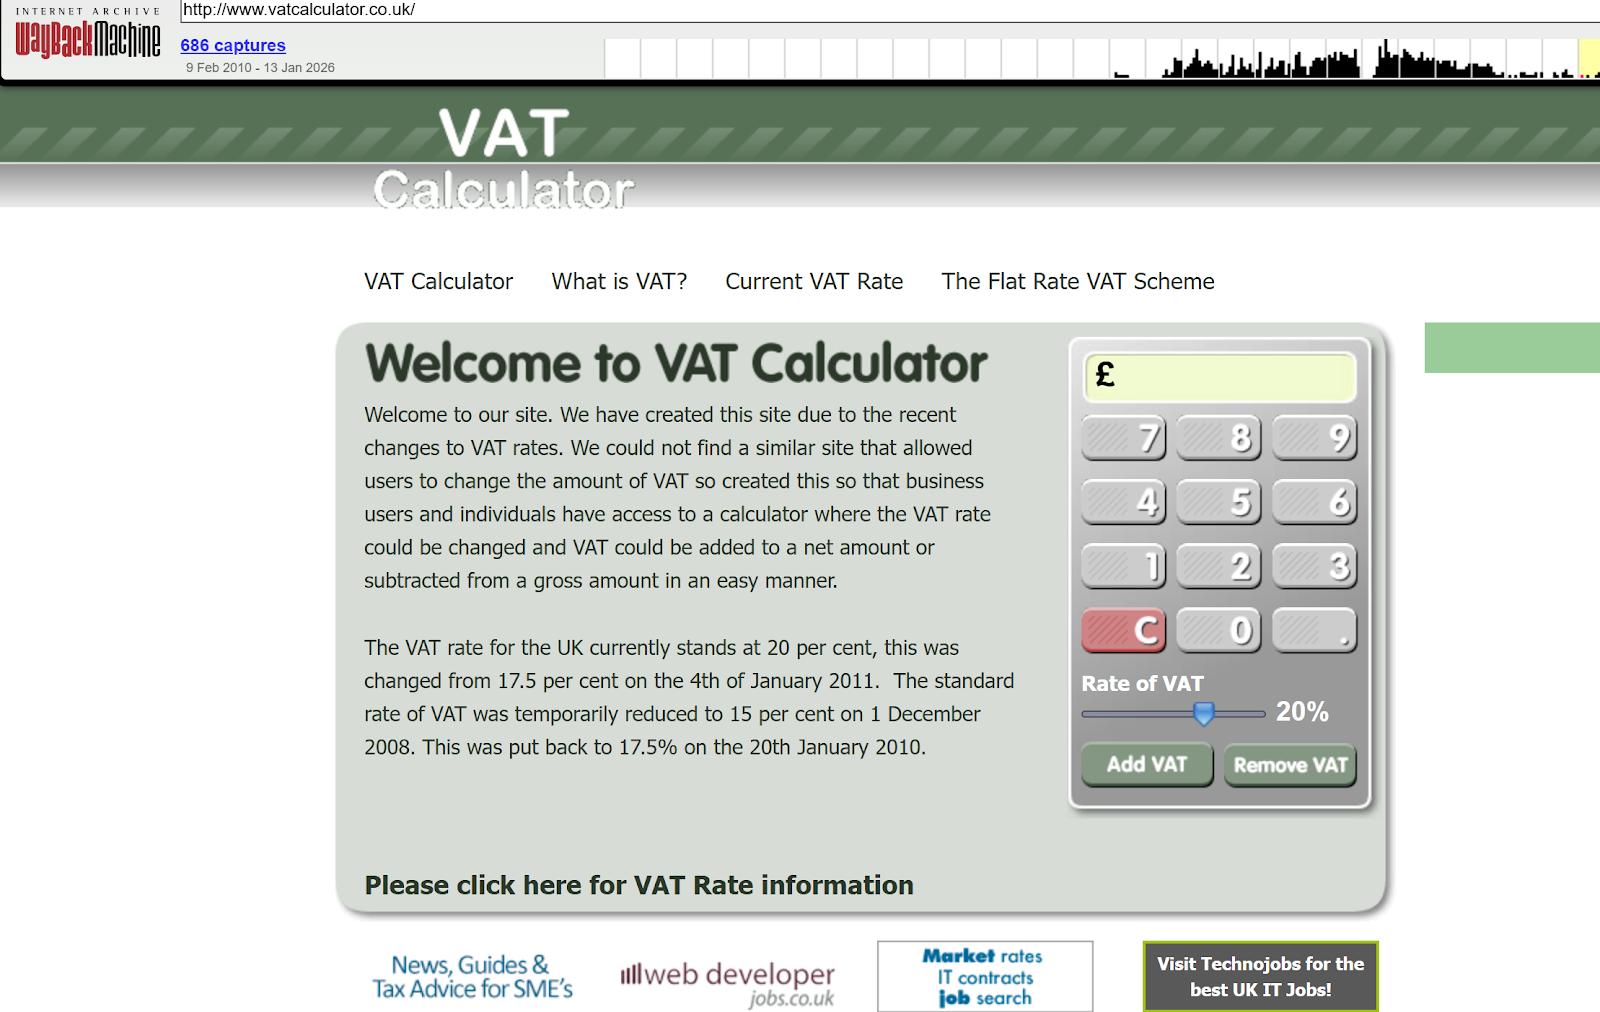
Sie rankte, weil Nutzer den Rechner BENUTZTEN und die Sitzung damit beendeten.
Gute Klicks.
Schauen wir uns jetzt die weiteren Klicktypen an:
Spekulative Interpretation: Das ist wahrscheinlich das wertvollste Einzelsignal im gesamten Modell. Es erfasst sowohl Zufriedenheit (lange Verweildauer) als auch Endgültigkeit (letzter Klick). Eine Seite, die über viele Sitzungen hinweg konsistent lastLongestClicks einfährt, löst die Suchanfrage nachweislich auf. Wenn Google diese Signale gewichtet, trägt dieses hier vermutlich das größte Gewicht.
impressions Die Anzahl der Male, die ein Dokument in den Suchergebnissen für eine Query angezeigt wurde. Das ist der Nenner für jede CTR-ähnliche Berechnung. Ohne Impressionen sind Klickzahlen bedeutungslos – eine Seite mit 10 Klicks bei 10 Impressionen performt völlig anders als eine mit 10 Klicks bei 10.000 Impressionen.
Dahinter steckt noch eine weitere Ebene – die hebe ich mir für einen anderen Artikel auf, aber Impressionen und CTR sind hier entscheidend. Google selbst nutzt CTR-Daten, aber wie wir wissen, haben AI Overviews die Klickraten selbst für Seiten, die konstant rankten, erheblich gedrückt – die Verdrängung durch AIOs hat die CTR deutlich verzerrt.
absoluteImpressions Die Dokumentation ist hier präzise: „Thus far this field is only used for host level unsquashed impressions.“ Zwei Dinge sind hier wichtig. Erstens arbeitet das auf Host-Ebene, nicht auf URL-Ebene. Google misst, wie oft deine gesamte Domain in den Ergebnissen erscheint, nicht nur eine einzelne Seite. Zweitens ist es explizit „unsquashed“ – mehr dazu, was das bedeutet, weiter unten.
unicornClicks Die Dokumentation sagt: „The subset of clicks that are associated with an event from a Unicorn user.“ Das ist eines der kryptischeren Attribute im Leak. Es gibt keine weitere Definition dessen, was einen „Unicorn user“ ausmacht, in der öffentlich geleakten Dokumentation – also werde ich hier auch nicht spekulieren.
Spekulative Interpretation: Aus meiner persönlichen Sicht ist die wahrscheinlichste Erklärung, dass Unicorn sich auf authentifizierte, eingeloggte Google-Nutzer bezieht – Menschen, deren Identität und Browserverlauf Google mit hoher Sicherheit verifizieren kann. Ihre Klicks hätten mehr Gewicht, weil Google validieren kann, dass es sich um echte, eindeutige Menschen mit etablierten Browsing-Mustern handelt und nicht um Bots, Klickfarmen oder VPN-maskierte Manipulationsversuche. Eine alternative Theorie ist, dass Unicorn-Nutzer speziell Chrome-Nutzer sind, angesichts der tiefen Integration von Chrome in Googles Datenerfassungsinfrastruktur. So oder so ist die Implikation klar: Nicht alle Klicks sind gleich, und Klicks von Nutzern, die Google mit Sicherheit identifizieren kann, werden offenbar separat erfasst und bewertet.
Zweifellos gibt es unter Chrome jede Menge Mechanik, dazu User-Agent-Spoofing und Klickfarm-/Klickmanipulations-Tools, die darauf ausgelegt sind, Rankings durch Nachahmung einer echten Nutzersitzung zu beeinflussen – in den meisten Fällen erfolgt Klickmanipulation allerdings über nicht eingeloggte Browser.
unsquashedClicks, unsquashedImpressions, unsquashedLastLongestClicks Die Dokumentation merkt an, dass diese Felder auf ein neues Format migriert werden, bei dem die Daten in separaten squashed- und unsquashed-Instanzen von CrapsClickSignals gespeichert werden. Die Existenz beider Versionen sagt uns etwas Entscheidendes darüber, wie Google diese Daten verarbeitet.
Squashed vs. Unsquashed: Wie Google Klickdaten normalisiert
Das ist eines der wichtigsten architektonischen Details im gesamten Leak.
„Squashing“ ist eine Normalisierungsfunktion. Ein Google-Patent zur Bewertung lokaler Suchergebnisse (US8046371B2) beschreibt Squashing als eine Funktion, die verhindert, dass ein großes Signal die anderen dominiert. Praktisch gesehen komprimiert eine Squashing-Funktion den Wertebereich – typischerweise über eine logarithmische Kurve, eine Sigmoidfunktion oder eine harte Obergrenze –, sodass der Unterschied zwischen 10 und 100 Klicks signifikant ist, der Unterschied zwischen 10.000 und 100.000 Klicks aber gedämpft wird.
Warum das wichtig ist: Ohne Squashing hätten Seiten mit hohem Traffic einen uneinholbaren Vorteil. Ein BBC-Artikel mit 50.000 Klicks würde einen Fachblog mit 500 Klicks übertönen, selbst wenn der Fachblog ein weitaus besseres Verhältnis von guten zu schlechten Klicks hätte. Squashing gleicht das Feld an, indem es die Absolutzahlen komprimiert und die Verhältnisse sprechen lässt.
Die unsquashed-Werte sind dann die Rohzahlen, bevor diese Normalisierung angewendet wird. Google behält beide Versionen, weil sie unterschiedlichen Zwecken dienen:
Squashed-Daten fließen in den Ranking-Algorithmus ein, wo proportionale Qualität mehr zählt als absolutes Volumen
Unsquashed-Daten fließen wahrscheinlich in die Spam-Erkennung ein, wo absolutes Volumen und anomale Ausschläge genau das sind, wonach man sucht
Praktisches Szenario: Stell dir die Website einer lokalen Anwaltskanzlei in Bedford vor, die normalerweise 30 Impressionen und 8 Klicks pro Monat für „family solicitor Bedford“ bekommt. In einer Woche erhält sie plötzlich 400 Klicks bei 500 Impressionen. Die squashed-Daten dämpfen diese Anomalie, damit sie die Seite nicht in den Rankings nach oben katapultiert. Die unsquashed-Daten bewahren den Roh-Ausschlag, damit ein Spam-Erkennungssystem (möglicherweise das IP-Prior- oder Voter-Token-System, das an anderer Stelle im Leak beschrieben wird) ihn zur Prüfung markieren kann.
Modell 2: CrapsData – der Master-Datensatz
Wenn CrapsClickSignals der Wortschatz ist, dann ist CrapsData der Satz. Dieses Modell mit 22 Attributen verknüpft alle Klicksignale mit Kontext – der Query, der URL, dem Land, dem Gerät, der Sprache und mehreren Ebenen von Aggregation und Segmentierung.
Query- und URL-Bindung
query (String) Die tatsächliche Suchanfrage, auf die sich diese Daten beziehen. NavBoost erfasst nicht nur „diese Seite hat X Klicks bekommen“. Es erfasst „diese Seite hat X Klicks für diese spezifische Query bekommen“. Das sind Query-Dokument-Paardaten, was bedeutet, dass NavBoost zwischen einer Seite unterscheiden kann, die für eine Query gut und für eine andere schlecht performt.
url (String) Die konkrete erfasste URL.
patternLevel (Integer) Das zeigt, dass Google nicht nur einzelne URLs erfasst. Es aggregiert Klickdaten auf mehreren Abstraktionsebenen der URL:
Level 0: Die exakte URL (z. B. https://example.com/services/seo-audit)
Level 1: Das Host-Pattern (z. B. p://example.com)
Level 2: Das Domain-Pattern (z. B. p://example.com auf die Root reduziert)
Die Dokumentation gibt ein konkretes Beispiel: Für http://abc.def.ghi/xyz.html ist Level 0 die vollständige URL, Level 1 ist p://abc.def.ghi und Level 2 ist p://def.ghi.
Warum das wichtig ist: Das bestätigt, dass NavBoost gleichzeitig auf Subdomain-, Root-Domain- und URL-Ebene arbeitet. Deine einzelne Seite mag schwache Klickdaten haben, aber wenn deine Domain als Ganzes über Hunderte von URLs hinweg konsistent gute Klicks erzielt, liefert dieses Signal auf Pattern-Ebene wahrscheinlich einen Auftrieb. Umgekehrt bekommt eine Domain mit konstant hohen badClicks-Verhältnissen vermutlich eine Abwertung auf Pattern-Ebene, selbst bei neuen Seiten, die noch keine eigene Klickhistorie angesammelt haben.
Spekulatives Szenario: Meine Vermutung ist, dass ein neuer Blogbeitrag auf einer etablierten Seite mit starken NavBoost-Mustern auf Domain-Ebene ein Grundvertrauen aus der Klickhistorie der übergeordneten Domain erben könnte, was ihm einen wärmeren Start in den Rankings verschafft als einem identischen Beitrag auf einer neuen Domain ohne Klickhistorie. Das würde erklären, warum etablierte Seiten neue Inhalte oft schneller ranken – es ist nicht nur Domain Authority im Linksinne, es ist angesammelte Klickqualität auf Pattern-Ebene.
Geografische und sprachliche Segmentierung
country (String) Zweistelliger Ländercode in Großbuchstaben. Gegebene Beispiele: „US“, „FR“, „BR“.
language (String) Sprachcode. Beispiele: „en“, „fr“, „pt-BR“.
Das bedeutet, Google speichert und bewertet Klicksignale pro Land und pro Sprache. Eine Seite, die in Deutschland exzellente Klickmetriken erzielt, kann in Frankreich fürchterliche Werte haben. NavBoost kann zwischen beiden unterscheiden und die Rankings entsprechend anpassen.
Praktische Implikation: Wenn du eine mehrsprachige Seite betreibst, bauen deine englischen und deine französischen Seiten separate NavBoost-Profile auf. Eine schlecht übersetzte französische Version einer gut performenden englischen Seite wird nicht im Windschatten der englischen Klickdaten mitfahren. Jede Sprachvariante verdient (oder verliert) ihre eigenen Klicksignale.
sliceTag (String) Ein flexibles Feld, das so beschrieben wird, dass es der CRAPS-Pipeline erlaubt, „Signale nach verschiedenen Attributen wie Gerätetyp, Land, Locale usw. zu segmentieren“. Das ist im Grunde ein universeller Segmentierungsschlüssel. Der Slice-Tag kann ein beliebiger String sein, und Signale werden für jeden Tag separat neben dem standardmäßig leeren Tag aggregiert.
Spekulative Interpretation: Aus meiner Sicht deutet das darauf hin, dass Google Ad-hoc-Signalsegmente jenseits der üblichen Land/Sprache/Gerät-Aufteilungen erstellen kann. Bei Großereignissen (Wahlen, Pandemien, Naturkatastrophen) könnten sie temporäre Slice-Tags anlegen, die anpassen, wie Klicksignale für bestimmte Query-Kategorien gewichtet werden. Das passt zu den Beweisen aus dem Kartellverfahren, die zeigen, dass Google während COVID-19 und Wahlen Whitelists einsetzte.
Gerätesegmentierung
device Verweist auf das CrapsDevice-Modell (weiter unten behandelt).
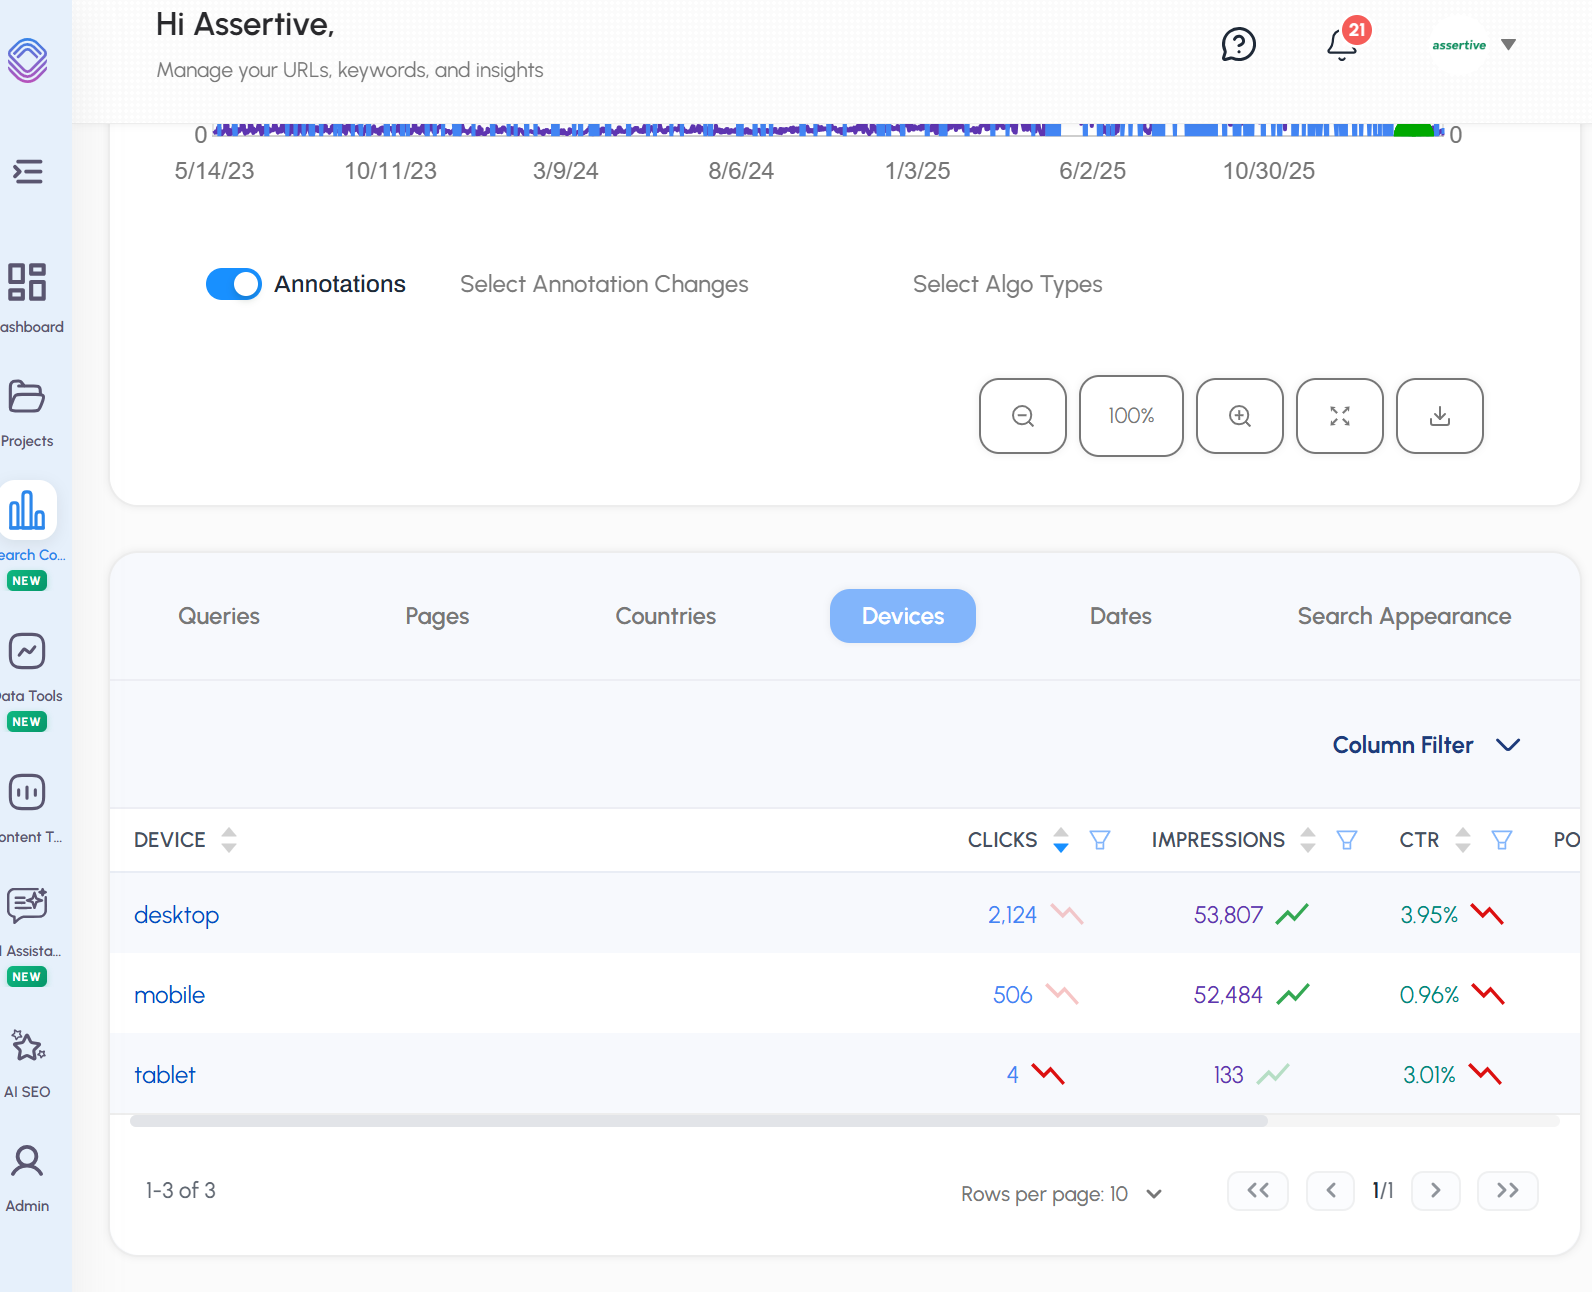
mobileSignals Eine eigene CrapsClickSignals-Instanz, die speziell aus „Tier-1/2-Mobile-Interfaces in QSessions“ aggregiert wird. Google unterhält vollständig separate Klicksignalprofile für mobile Nutzer.
mobileData Als Legacy markiert („DO NOT USE“), ersetzt durch mobileSignals. Die Tatsache, dass Google dieses Feld abgekündigt und ersetzt hat, zeigt uns, dass die Architektur der Mobilsignale aktiv überarbeitet wurde, wahrscheinlich um eine granularere Klassifizierung mobiler Geräte zu unterstützen.
Squashed- und Unsquashed-Instanzen
squashed Eine vollständige CrapsClickSignals-Instanz mit den normalisierten Klickdaten. Die Dokumentation merkt an, dass dies letztlich die Felder goodClicks/badClicks/impressions auf oberster Ebene ersetzen wird.
unsquashed Die rohe, nicht normalisierte Instanz. Beschrieben als Vorbereitung auf „the retuning rollout“, was darauf hindeutet, dass Google zum Zeitpunkt der Erstellung der Dokumentation aktiv neu kalibrierte, wie diese beiden Datenströme zusammenwirken.
unsquashedMobileSignals Rohe mobile Klickdaten vor der Normalisierung.
Anti-Spam und IP-Analyse
packedIpAddress (String) Ein gepackter String in Network Byte Order, der von einem System namens CrapsIpPrior verwendet wird. Nur befüllt, wenn Google die IP-Prior-Bad-Fraction zum Abrufzeitpunkt nachgeschlagen hat.
unscaledIpPriorBadFraction (Float) Wird verwendet, um auf Basis der IP-Adresse einen Prior zuzuweisen. Die Dokumentation verweist explizit auf zwei interne Dateien: quality/navboost/craps/craps-ip-prior.h und craps-penalty.cc. Der hier gespeicherte Wert liegt vor der Transformation – bevor eine lineare Skalierungs-, Offset- und Min/Max-Operation angewendet wird.
Was uns das sagt: Google unterhält einen Reputations-Score auf IP-Ebene. Jede IP-Adresse hat eine „bad fraction“ – im Grunde ein Maß dafür, wie oft Klicks von dieser IP historisch als Spam, Bot-Traffic oder Manipulationsversuche klassifiziert wurden. Bei der Bewertung von Klicksignalen von einer bestimmten IP passt dieser Prior das Gewicht dieser Klicks an.
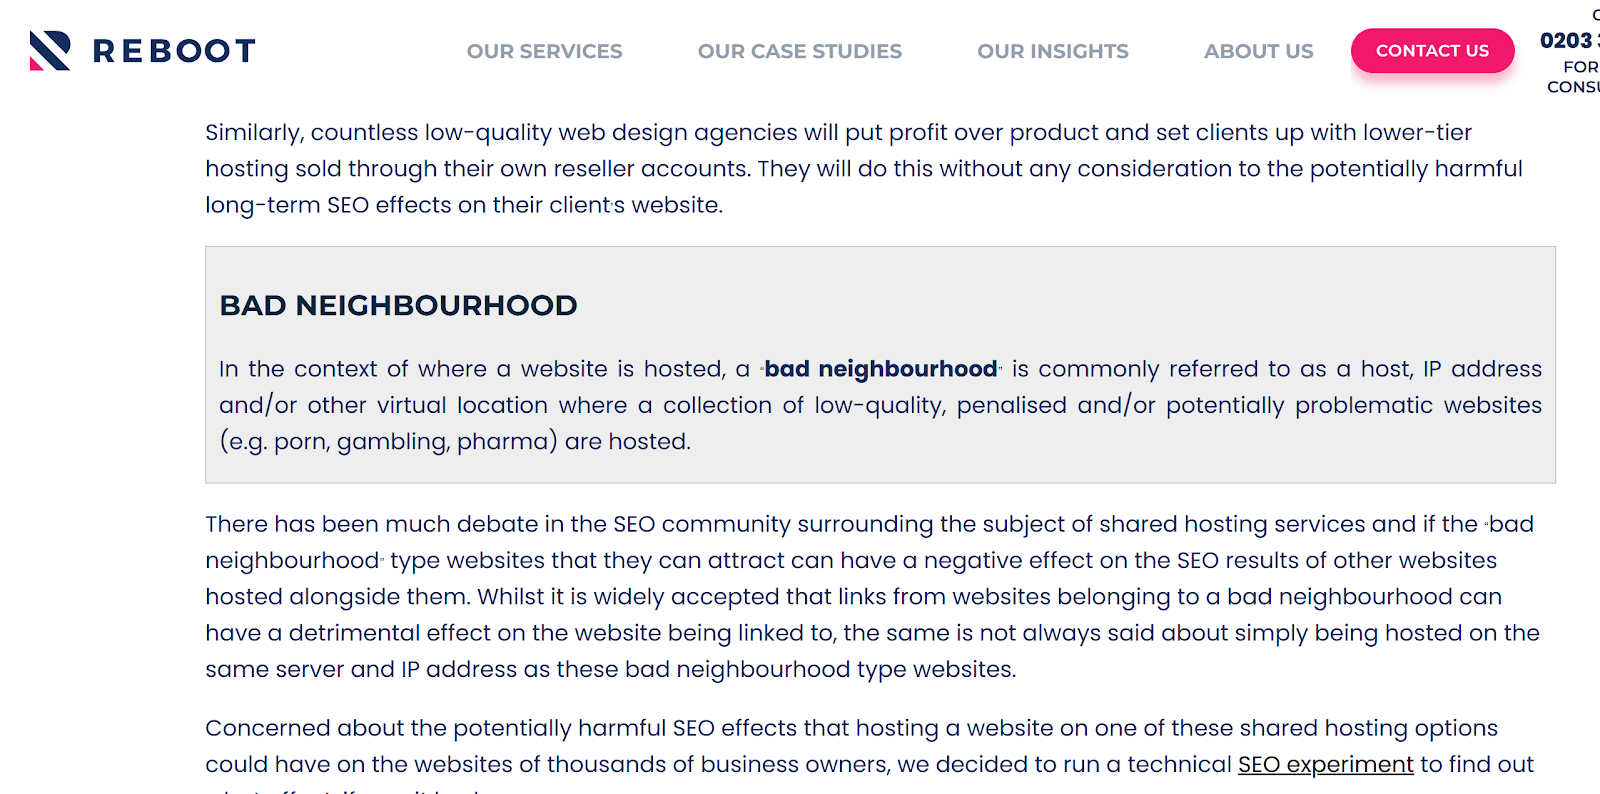
Das könnte AUCH damit zusammenhängen, warum frühere Studien gezeigt haben, dass SHARED HOSTING für SEO SCHLECHTER sein kann, wenn ein IP-Block mit schlechten Akteuren/Massenspam usw. assoziiert wird.
Tatsächlich haben vor ein paar Jahren ein langjähriger Wettbewerber (und sehr guter Freund von mir, Shai Aharony) und einer seiner SEOs, „Oliver Sissons“, ein Experiment zu einem „Langzeit-Shared-Hosting-Experiment“ durchgeführt, das ebenfalls nahezulegen schien, dass das stimmt:
Das könnte erklären:
Warum manche Seiten nach dem Wechsel weg von Shared Hosting Rankinggewinne sehen
Manche Domains wirken „toxisch“, obwohl es in Wirklichkeit der IP-Block ist, dem sie zugeordnet sind und der für Spam/Missbrauch bekannt ist – mit der Folge, dass alles, was darüber ausgeliefert wird, darunter leiden kann.
Praktisches Szenario: Ein CTR-Manipulationsdienst, der Klicks über einen VPN-Endpunkt in London laufen lässt, sieht anfangs vielleicht Ergebnisse. Aber während sich Klicks von dieser IP ansammeln und keiner davon natürliche Browsing-Muster aufweist (variierende Verweildauern, natürliche Folgeanfragen, unterschiedliche angeklickte URLs), steigt die Bad Fraction. Irgendwann werden Klicks aus diesem IP-Bereich entweder stark abgewertet oder ganz ignoriert. Die in der Dokumentation erwähnte „scaling / offset / min / max“-Transformation deutet auf ein Schwellensystem hin – unterhalb einer bestimmten Bad Fraction werden Klicks normal akzeptiert; darüber werden sie schrittweise abgewertet; oberhalb einer harten Obergrenze werden sie möglicherweise verworfen.
Ich habe das über die Jahre mit Tools wie CTR Booster + Trusted Proxies getestet, die Requests über Residential-Proxy-IPs mit gespooften User Agents getunnelt haben.
CTR Booster funktionierte, aber es ist sehr wahrscheinlich, dass diese Sitzungen offensichtlicher geworden sind, da Googles Erkennungsfähigkeiten sich über die Zeit verbessert haben.
Voter-Tokens und Datenschutzfilterung
voterTokenCount (Integer) „The number of distinct voter tokens (a lower bound on the number of distinct users that contributed to the entry, used for privacy-related filtering).“
Das ist entscheidend. Google zählt nicht nur Klicks – es zählt eindeutige Menschen. Das Voter-Token-System liefert eine untere Schranke für die Anzahl eindeutiger Nutzer, deren Klicks zum NavBoost-Profil einer URL beigetragen haben. Wenn eine URL 500 Klicks, aber nur 3 Voter-Tokens hat, ist das ein massives Warnsignal. Hat sie 500 Klicks von 480 Voter-Tokens, ist das ein gesundes, organisches Signal.
Die Formulierung „lower bound“ ist bewusst gewählt – Voter-Tokens sind nicht eindeutig pro Nutzer (wie im FeatureCrapsData-Modell bestätigt), die Zahl ist also eine konservative Schätzung. Google zählt lieber zu wenige eindeutige Nutzer als zu viele, was bedeutet, dass die Datenschutz-Filterschwelle auf Schutz vor False Positives kalibriert ist.
Spekulative Interpretation: Meiner Meinung nach gibt es mit ziemlicher Sicherheit eine Mindestschwelle an Voter-Tokens, unterhalb derer NavBoost-Daten für ein URL/Query-Paar vollständig unterdrückt werden. Wenn nur zwei oder drei Nutzer Klicks beigesteuert haben, ist die Stichprobe zu klein, um aussagekräftig zu sein, und zu leicht zu manipulieren. Das würde erklären, warum neue Seiten mit sehr wenig Traffic keine NavBoost-getriebenen Rankingveränderungen sehen, bis sie eine kritische Masse eindeutiger Nutzer angesammelt haben.
Statistiken auf Pattern-Ebene
patternSccStats Verweist auf das StatsWithWeightsProto-Modell (weiter unten behandelt). Für Daten auf Pattern-Ebene enthält es Statistiken über die stark zusammenhängenden Komponenten einzelner URLs, die zum Pattern beitragen. Mit anderen Worten: Wenn Google Klickdaten auf Domain-Ebene aggregiert, summiert es nicht einfach die Zahlen – es analysiert die Verteilung. Wie konsistent ist die Klickqualität über einzelne URLs hinweg? Wird das starke NavBoost-Profil der Domain von einer einzigen viralen Seite getragen, oder ist es über Hunderte von Seiten hinweg konsistent?
Modell 3: CrapsDevice – was Google über das Gerät deines Besuchers weiß
Drei Attribute. Einfach, aber aufschlussreich.
os (String) Das Betriebssystem. Das bestätigt, dass Google das OS jedes Nutzers erfasst und speichert, dessen Klicks in NavBoost einfließen.
uxInterface (Integer) Ein Enum aus GWSLogEntryProto, das den Gerätetyp angibt:
1 = Desktop
2 = Mobil
3 = Tablet
Der Verweis auf „gwslog(608)“ sagt uns, dass diese Daten direkt aus dem Google Web Server Log stammen – derselben Infrastruktur, die jede Google-Suchanfrage ausliefert.
uxTier (Integer) Browser-Leistungsstufe:
1 = Moderne Browser
2 = Alles dazwischen
3 = Sehr alte Browser
Warum das über eine simple Segmentierung hinaus wichtig ist: Wenn Google Klicksignale nach Browser-Tier segmentiert, kann das System Klicks aus modernen Browsern potenziell anders gewichten als Klicks aus alten Browsern. Ein Klick aus Chrome 120 auf einem Android-Flaggschiff wird wahrscheinlich als Signal mit höherer Konfidenz behandelt als ein Klick aus einem veralteten Browser, der mit Bot-Traffic oder überholter Crawling-Infrastruktur assoziiert sein könnte.
Spekulatives Szenario: Dieses Tier-System könnte auch als Anti-Manipulations-Vektor dienen. Automatisierte Klick-Tools nutzen häufig Headless-Browser oder ältere User Agents, die in Tier 2 oder Tier 3 fallen könnten. Wenn Google beobachtet, dass ein überproportionaler Anteil der Klicks einer URL aus Browsern niedriger Tiers kommt – verglichen mit der Norm für diese Query –, ist das ein potenzielles Spam-Signal.
Modell 4: FeatureCrapsData – granulare Locale-Segmentierung
Dieses Modell ermöglicht eine extrem feingliedrige geografische und gerätebezogene Segmentierung von Klicksignalen.
country (String) Gleiches Format wie bei CrapsData, kleingeschrieben (z. B. „us“). Die Dokumentation merkt an: „If not present, it's an aggregation for all countries.“
language (String) z. B. „en“. Fehlt der Wert, handelt es sich wieder um eine Aggregation über alle Sprachen.
device (String) Vereinfachter Geräteindikator: „m“ für mobil, „d“ für Desktop. Fehlt der Wert, wird über alle Geräte aggregiert.
locationId (Integer) „Location id for metro and city. If not present, it's an aggregation for all locations within current country.“
Das ist das Feld, das bestätigt, dass NavBoost auf Metro-/Stadtebene arbeitet. Google weiß nicht nur, dass du aus Großbritannien suchst – es weiß, dass du aus Birmingham oder Edinburgh suchst, und kann Klicksignale entsprechend segmentieren.
Praktische Implikation: Wenn du als SEO-Berater Local SEO für ein Unternehmen in Manchester machst, werden die Klicksignale deines Kunden von Nutzern aus Manchester getrennt von denen aus London erfasst. Ein Restaurant, das exzellente Klicks von Nutzern in seiner Heimatstadt erzielt, aber schlechte Klicks von Nutzern anderswo, kann lokal gut und national schlecht ranken – und NavBoost ist der Mechanismus, der diesen Unterschied ermöglicht.
signals Eine vollständige CrapsClickSignals-Instanz mit den Klickdaten für diesen spezifischen Locale-Slice.
voterTokenBitmap Verweist auf das GlueVoterTokenBitmapMessage-Modell. Das liefert Voter-Token-Tracking pro Locale, womit Google die Diversität der Nutzer bewerten kann, die auf Metro-Ebene zu den Klicksignalen beitragen. Wenn ein Unternehmen in London plötzlich einen Schub „guter Klicks“ von Nutzern in einem einzelnen Ballungsraum bekommt, die Voter-Token-Bitmap aber zeigt, dass sie alle von einer Handvoll Tokens stammen, wird das Signal gefiltert.
Modell 5: StatsWithWeightsProto – Verteilungsanalyse
Das ist ein Modell für Statistiker. Fünfzehn Attribute, dreizehn davon Floats, die alle die statistische Verteilung der Klickdaten über die URLs beschreiben, die zu einer Aggregation auf Pattern-Ebene beitragen.
n (Integer) Stichprobengröße. Die Anzahl der einzelnen Datenpunkte (wahrscheinlich einzelne URLs), die zum Pattern beitragen.
weightedN (Float) Gewichtete Stichprobengröße. Nicht alle URLs tragen gleich bei – manche werden stärker gewichtet, möglicherweise nach Traffic-Volumen oder Voter-Token-Anzahl.
mean, median Zentrale Tendenz der gemessenen Klickmetrik.
stddev, variance, varOfMean, stdError Streuungsmaße. Wie breit verteilt sind die Klicksignale über die URLs innerhalb dieses Patterns?
hi, lo Die Extremwerte der Verteilung.
pc10, pc25, pc75, pc90 Perzentil-Grenzpunkte. Das gibt Google ein vollständiges Bild der Verteilungsform.
kind (Integer) Ein Enum, das angibt, um welche Art von Statistik es sich handelt. Der Leak führt die möglichen Werte nicht auf, aber es unterscheidet wahrscheinlich zwischen verschiedenen Metriken (Good-Click-Verhältnisse, Bad-Click-Verhältnisse, lastLongestClick-Verhältnisse usw.).
Warum dieser statistische Detailgrad wichtig ist: Google schaut nicht nur darauf, ob deine Domain gute aggregierte Klicksignale hat. Es schaut auf die Verteilung der Klickqualität über deine Seiten hinweg. Eine Domain, bei der das mediane Good-Click-Verhältnis bei 0,6 mit geringer Standardabweichung liegt, ist durchgehend stark. Eine Domain, bei der der Mittelwert bei 0,6 liegt, die Standardabweichung aber riesig ist – also manche Seiten exzellent und andere fürchterlich sind –, hat ein anderes Qualitätsprofil.
Spekulative Interpretation: Aus meiner Sicht ist das sehr wahrscheinlich der Mechanismus hinter sitewide Qualitätsbewertungen. Wenn Googles interne Systeme (wie Googles HCU, das Helpful Content Update bzw. System) Modifikatoren auf Site-Ebene anwenden, ist die statistische Verteilung der NavBoost-Signale über das URL-Pattern einer Domain vermutlich ein zentraler Input. Es reicht nicht, ein paar großartige Seiten zu haben – wenn dein pc10 (das 10. Perzentil) zeigt, dass deine schlechtesten Seiten überwiegend schlechte Klicks erzeugen, zieht das die Bewertung auf Pattern-Ebene nach unten.
Praktisches Szenario: Eine Content-Farm veröffentlicht 1.000 Artikel. Fünfzig davon performen zufällig gut und erzielen gute Klicks. Die anderen 950 erzeugen Pogo-Sticking und schlechte Klicks. Der Mittelwert sieht vielleicht mittelmäßig aus, aber der Median ist fürchterlich, der pc10 liegt nahe null und die Standardabweichung ist enorm. Googles Pattern-Level-Statistiken würden dieses Profil präzise erfassen und wahrscheinlich eine sitewide Abwertung begründen.
Modell 6: GlueVoterTokenBitmapMessage – die Anti-Manipulations-Schicht
Zwei String-Attribute, aber die Modellbeschreibung offenbart den zugrunde liegenden Mechanismus.
Die Dokumentation besagt, dieses Modell werde „used for aggregating query unique voter_token during merging“ und nutze „4 uint64(s) as a 256-bit bitmap to aggregate distinct voter_tokens in Glue model pipeline.“
voterToken (String) Ein einzelnes Voter-Token. Als Optimierung wird das Token, wenn nur ein Nutzer beigetragen hat, als einzelnes uint64 statt als vollständige Bitmap gespeichert.
subRange (String-Liste) Die Bitmap-Komponenten, wenn mehrere Tokens vorhanden sind.
Wie das wahrscheinlich funktioniert: Jeder Nutzer, der einen Klick beisteuert, bekommt ein Voter-Token zugewiesen (das nicht eindeutig pro Nutzer ist – es ist ein gehashter, datenschutzwahrender Identifikator, der als untere Schranke für eindeutige Nutzer dient). Diese Tokens werden in einer 256-Bit-Bitmap aggregiert. Die Bitmap erlaubt es Google, Token-Mengen während der Verarbeitung in der Glue-Pipeline effizient über Queries und Zeiträume hinweg zusammenzuführen.
Der Verweis auf „Glue“ ist bedeutsam. Wie im Kartellverfahren bestätigt, ist Glue im Grunde NavBoost, erweitert auf alle SERP-Features – nicht nur die zehn blauen Links, sondern auch Knowledge Panels, Video-Karussells, Image Packs, People-Also-Ask-Boxen und AI Overviews. Die Voter-Token-Bitmap stellt sicher, dass die Prüfung der Nutzerdiversität für all diese Feature-Typen gilt.
Warum 256 Bit? Eine 256-Bit-Bitmap kann bis zu 256 unterschiedliche Voter-Token-Hash-Buckets abbilden. Das bedeutet, das System ist auf effizientes approximatives Zählen eindeutiger Nutzer ausgelegt, nicht auf exaktes Zählen. Für NavBoosts Zwecke reicht es zu wissen, dass „ungefähr 180 eindeutige Nutzer“ beigetragen haben – die exakte Zahl ist weniger wichtig als die Sicherheit, dass die Klickdaten von einer diversen, organischen Nutzerbasis stammen.
Woher bekommt Google diese Daten?
Die geleakten Modelle verweisen explizit oder durch starke Implikation auf mehrere Datenquellen:
Google Web Server (GWS) Logs Das CrapsDevice-Modell verweist explizit auf gwslog-Einträge (608 und 609). Jede Suchanfrage, jeder Klick auf ein Ergebnis, jede Rückkehr zur SERP wird von Googles Webserver-Infrastruktur protokolliert. Das ist die primäre Datenquelle.
QSessions Referenziert in der Beschreibung von mobileSignals und in der CrapsDevice-Beschreibung. QSessions scheinen Googles internes Sitzungsmodell zu sein – ein strukturierter Datensatz über alles, was ein Nutzer während einer Suchsitzung tut, von der anfänglichen Query über alle Klicks, Umformulierungen bis zum schließlichen Sitzungsende.
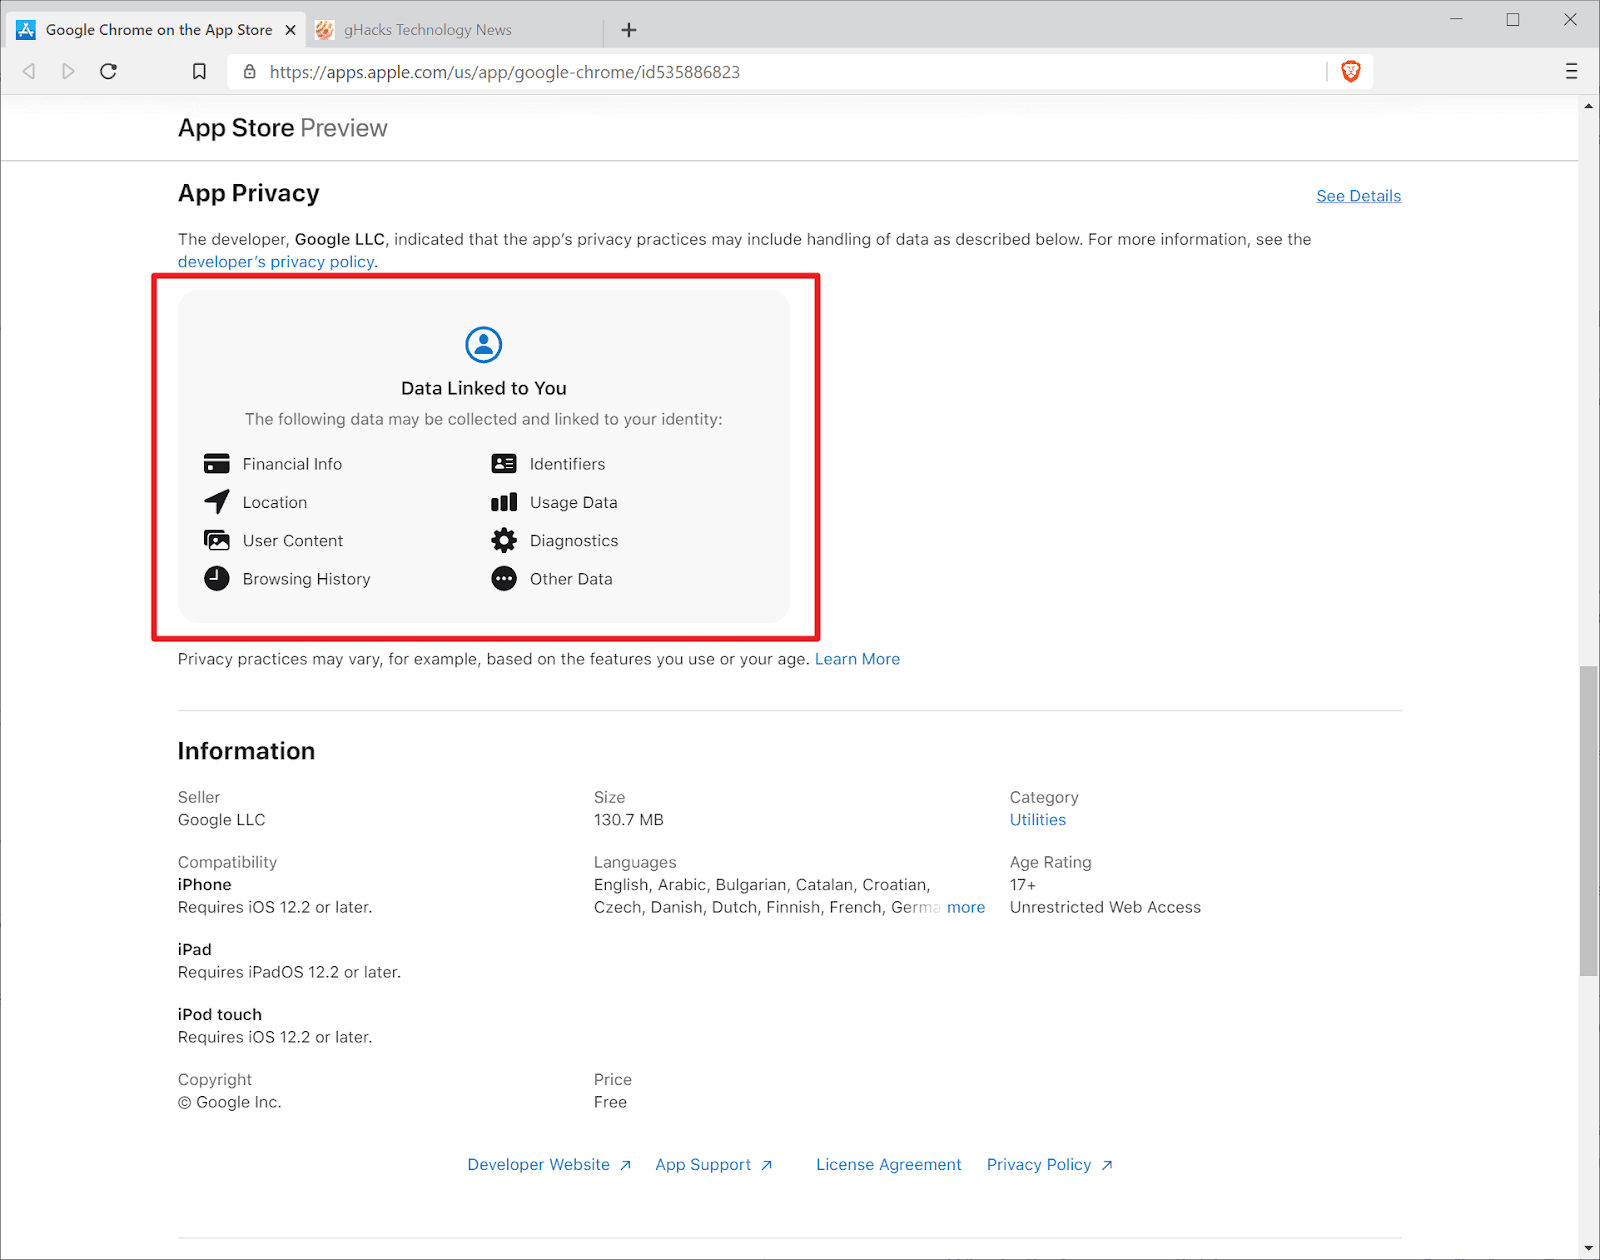
Chrome-Daten In diesen sechs Modellen nicht explizit genannt, aber die Beweise aus dem Kartellverfahren und der breitere Leak enthalten mehrere Verweise auf Chrome-stämmige Daten, die in NavBoost einfließen. Das „unsquashed“-Klickkonzept wurde mit Chromes Fähigkeit verknüpft, Nutzeridentifikation mit höherer Konfidenz zu liefern.
Cookie-Historie Erwähnt in Rand Fishkins Berichterstattung über die Quelle, die die geleakten Dokumente bereitgestellt hat. Cookies liefern Sitzungskontinuität und, für eingeloggte Nutzer, Identitätspersistenz über Sitzungen hinweg.
IP-Adressdaten Explizit in CrapsData über packedIpAddress und unscaledIpPriorBadFraction vorhanden. Google unterhält ein Reputations-Scoring auf IP-Ebene, das direkt in die Bewertung von Klicksignalen einfließt.
Spekulativ, aber wahrscheinlich: Android- und Google-App-Daten Die Google-Suche auf Android und die Google App auf iOS liefern dieselben GWS-Log-Einträge wie Chrome auf dem Desktop. Da Mobile inzwischen den Großteil des Suchtraffics ausmacht, sind diese wahrscheinlich bedeutende Beitragende zu den mobileSignals- und uxInterface-Daten.
Das rollierende 13-Monats-Fenster
Im Kartellverfahren bestätigt: NavBoost arbeitet mit einem rollierenden 13-Monats-Fenster von Klickdaten. Vor etwa 2017 war es ein 18-Monats-Fenster – das finde ich seltsam; ich weiß nicht, warum sie es nicht an die 16 Monate Daten der GSC angeglichen haben.
Das hat direkte praktische Implikationen:
Neue Inhalte haben kein NavBoost-Signal. Sie müssen ihre ersten Rankings über andere Signale erarbeiten (Themenrelevanz, Links, Aktualität), bevor sie anfangen können, Klickdaten anzusammeln.
Nachlassende Inhalte verlieren ihr NavBoost-Signal nicht über Nacht. Eine Seite, die vor sechs Monaten stark war, hat diese Daten noch im Fenster. Aber mit vergehenden Monaten und neueren Klickdaten, die nachlassendes Engagement zeigen, schwächt sich das Signal ab.
Saisonale Inhalte profitieren vom 13-Monats-Fenster. Ein im November veröffentlichter Weihnachtsgeschenke-Guide hat seine starken Dezember-Klickdaten im folgenden November noch im Fenster, was ihm im nächsten Jahr einen Vorsprung verschafft.
Wiederhergestellte Inhalte – wenn du eine fürchterliche Seite reparierst und Nutzer anfangen, positiv zu interagieren, verschwinden die alten schlechten Klickdaten nicht sofort. Du verdünnst im Grunde 10 Monate schlechter Daten mit 3 Monaten guter Daten. Die Trendwende ist allmählich, nicht sofort.
NavBoost als Re-Ranking-System, nicht als Retrieval-System
Pandu Nayak erklärte im Prozess: „Remember, you get Navboost only after they're retrieved in the first place.“
Das ist eine wesentliche Unterscheidung. NavBoost entscheidet nicht, welche Seiten überhaupt in die Kandidatenmenge für eine Query kommen. Das übernehmen frühere Systeme wie Mustang (die primäre Retrieval-Engine). NavBoost arbeitet nachgelagert und passt die Reihenfolge der Seiten an, die bereits von anderen Signalen als relevant eingestuft wurden.
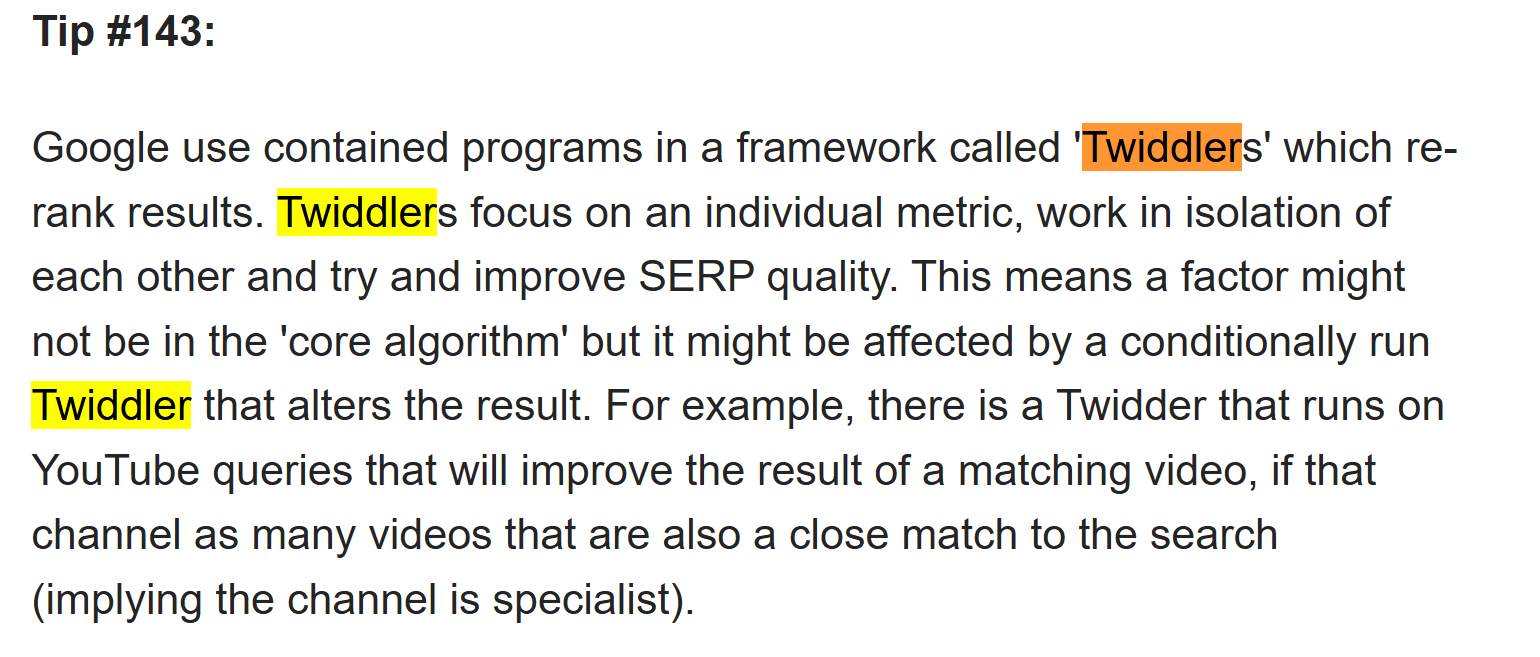
In Googles Architektur fungiert NavBoost als „Twiddler“ – ein System, das eine bereits gefilterte Menge von Kandidatendokumenten neu sortiert. Weitere bestätigte Twiddler sind Aktualitätsanpassungen und Qualitäts-Boost-Systeme.
Ein guter Freund von mir aus der SEO-Szene, „Mark Williams Cook“, hat eine Seite mit 500 unaufgeforderten SEO-Tipps – dort behandelt er ab TIPP 143 die Twiddler.
Was das praktisch bedeutet: Du kannst nicht allein über Klicksignale ranken. Wenn deine Seite keine thematische Relevanz, keine Links und keine anderen Qualitätssignale hat, kommt sie gar nicht erst in die Kandidatenmenge, und NavBoost wird sie nie sehen. Aber sobald du in der Kandidatenmenge bist – sobald du auf Seite eins oder Seite zwei bist – wird NavBoost wohl zur mächtigsten Kraft, die darüber entscheidet, ob du dort bleibst, aufsteigst oder nach unten gedrückt wirst.
Edge Cases und Szenarien
Der Brand-Query-Vorteil
Nimm eine Query wie „Sage accounting software“.Sage.com hat für diese Query mit ziemlicher Sicherheit ein überwältigend positives NavBoost-Profil – nahezu jeder Nutzer, der das sucht, sucht Sage und klickt zu sage.com durch. Das lastLongestClicks-Verhältnis liegt vermutlich nahe 1,0. Das badClicks-Verhältnis vermutlich nahe null.
Nimm jetzt einen Wettbewerber, der für diese Query ranken will. Selbst mit perfekter Onpage-SEO und starken Links kämpft er gegen NavBoost-Daten an, die zeigen, dass Nutzer überwältigend lieber Sages eigenes Ergebnis anklicken. Das ist der NavBoost-Markengraben – und er ist bei Brand-Queries ohne eigene signifikante Markenbekanntheit praktisch unüberwindbar.
Das Problem mit dem lokalen Restaurant
Ein neues Restaurant eröffnet in Nottingham. Es hat null NavBoost-Daten. Es rankt auf Basis von Aktualität, lokalen Signalen und was auch immer Bewertungsplattformen aufgegriffen haben. Nutzer klicken aus Neugier darauf, aber das Essen enttäuscht. Besucher springen per Pogo-Sticking zurück zu den Ergebnissen. Schlechte Klicks sammeln sich auf URL-Ebene und auf der metro-spezifischen Locale-Ebene an (die FeatureCrapsData locationId für Nottingham).
Sechs Monate später wechselt das Restaurant den Besitzer und wird exzellent. Aber das NavBoost-Fenster enthält noch fünf Monate schlechter Klickdaten gegenüber einem Monat sich verbessernder Daten. Die Erholung ist langsam und braucht potenziell die vollen 13 Monate, bis die alten Daten aus dem Fenster rollen – es sei denn, die Verbesserung ist so drastisch, dass sich die squashed-Verhältnisse spürbar verschieben.
Die Thin-Content-Seite mit brillanten Titeln
Eine Seite produziert Hunderte von Seiten mit außergewöhnlichen, neugierig machenden Title-Tags und Meta-Descriptions. Die Klicks sind hoch. Aber der Content ist dünn. Nutzer landen dort, merken, dass es nichts Substanzielles gibt, und springen ab. Die Klicks sind hoch, aber die goodClicks niedrig. Die badClicks sind hoch. Die lastLongestClicks liegen nahe null, weil Nutzer am Ende immer ein anderes Ergebnis anklicken.
NavBoost belohnt nicht einfach Klicks – es belohnt Auflösung. Diese Seite würde ein verheerendes NavBoost-Profil ansammeln: hohe Impressionen, ordentliche Klicks, fürchterliches Good-zu-Bad-Verhältnis, praktisch keine lastLongestClicks. Die patternLevel-Aggregation würde dieses negative Signal über die gesamte Domain verteilen.
Die Expertenseite mit wenig Traffic
Eine hochspezialisierte Fachseite bekommt 50 Impressionen pro Monat. Davon klicken 15, und 14 davon sind gute Klicks mit langer Verweildauer. Der voterTokenCount zeigt 14 eindeutige Nutzer. Das Good-Click-Verhältnis ist außergewöhnlich, aber die absoluten Zahlen sind winzig.
Hier arbeitet Squashing zugunsten der Seite. Die squashed-Daten normalisieren die absoluten Volumina und lassen das Verhältnis glänzen. Aber die niedrige Voter-Token-Anzahl könnte die Datenschutzfilterung auslösen und das NavBoost-Signal möglicherweise vollständig unterdrücken, bis mehr Nutzer Daten beisteuern. Das ist ein echter Zielkonflikt im System – Expertencontent mit wenig Traffic muss unter Umständen erst eine Mindestnutzerschwelle erreichen, bevor NavBoost ihm hilft.
Geräteübergreifende Inkonsistenz
Eine Seite wird auf dem Desktop wunderbar dargestellt, ist aber mobil kaputt. Desktop-Nutzer (uxInterface: 1) erzeugen starke Good-Click-Signale. Mobile Nutzer (uxInterface: 2) betreiben ständig Pogo-Sticking und erzeugen schlechte Klicks. Da NavBoost über mobileSignals und die Gerätesegmentierung in FeatureCrapsData separate Mobilsignale führt, könnte die Seite für dieselbe Query gleichzeitig auf dem Desktop gut und mobil schlecht ranken.
Das ist nicht theoretisch. Viele SEOs haben unterschiedliche Rankings auf Mobile versus Desktop für dieselbe Seite und Query beobachtet, und NavBoosts Signalsegmentierung auf Geräteebene ist sehr wahrscheinlich ein mitwirkender Mechanismus.
Was NavBoost für deine SEO-Strategie bedeutet
Der Leak verrät uns nicht die Gewichtungen. Er verrät uns nicht die Schwellenwerte. Aber er verrät uns die Architektur, und die Architektur zeigt, was Google wertschätzt:
Zufriedenheit vor Anziehung: Das bedeutet Good Clicks und lastLongestClicks werden getrennt von rohen Klicks erfasst. Den Klick zu bekommen ist nur die halbe Gleichung. Den Nutzer zu halten – das Ergebnis zu sein, das die Suchsitzung beendet – ist das, was NavBoost tatsächlich belohnt.
Konsistenz vor Ausschlägen: Das bedeutet Das StatsWithWeightsProto-Modell mit seinen Perzentilverteilungen und Standardabweichungsberechnungen zeigt uns, dass Google interessiert, wie konsistent deine Klickqualität über die gesamte Seite ist, nicht nur bei deinen bestperformenden Seiten.
Diversität vor Volumen – das bedeutet: Der voterTokenCount und die Voter-Token-Bitmap-Systeme bestätigen, dass tausend Klicks von fünf Nutzern weniger wert sind als hundert Klicks von neunzig Nutzern. Organisches, diverses Engagement ist das Signal. Künstlich erzeugtes Volumen ist das Warnsignal.
Kontext vor Aggregation: Das bedeutet Segmentierung nach Land, nach Sprache, locationId auf Metro-Ebene, Gerätesegmentierung, Browser-Tier-Klassifizierung – NavBoost bewertet deine Seite nicht im luftleeren Raum. Es bewertet sie pro Query, pro Locale, pro Gerät, pro Browser-Tier. Deine Rankings sind das Produkt dutzender überlappender NavBoost-Bewertungen, von denen jede aus einem anderen Ausschnitt deiner Klickdaten schöpft.
Das System, dessen Existenz Google jahrelang bestritten hat, ist nach Googles eigener interner Einschätzung eines der mächtigsten Rankingsignale, die sie je gebaut haben. Der Content-Warehouse-Leak gibt uns das Schema. Das Kartellverfahren gibt uns die Bestätigung. Was wir mit diesem Verständnis anfangen, liegt an uns.
Eines, was wir als SEOs tun können, ist spekulieren, diskutieren und testen. Seit das Content Warehouse geleakt wurde, hat mich fasziniert, wie viel darin steckte – ich habe eine Kopie des ursprünglichen GITHUB-Repos geklont, das veröffentlicht worden war, bevor es offline genommen wurde. Darin sieht man viele weitere Faktoren; in diesem Artikel haben wir NAVBOOST behandelt, weil es einen so zentralen Teil von SEO ausmacht, aber es gibt noch so viel mehr auszupacken – von Quality Rich Snippets bis SpamBrain.
Schau dir das SEO Datawarehouse hier an – dort sind alle 14.027 Attribute aufgelistet (nicht alle sind SEO-relevant), aber ich habe es so gebaut, dass du sehen kannst, welche Einträge eine HÖHERE WAHRSCHEINLICHKEIT haben, in der Rankinggewichtung verwendet zu werden.
Weitere abschließende Gedanken:
ABER DANIEL, WIE KANN NUTZERVERHALTEN EIN RANKINGFAKTOR SEIN, WENN DU NICHT PROMINENT GENUG RANKST, UM KLICKS ZUR BEWERTUNG ZU BEKOMMEN?
Nun, Rankings bei Google werden von mehreren Algorithmen bestimmt; häufig bekommen Seiten, die NOCH nicht von NAVBOOST betroffen sind, die Gelegenheit, bewertet zu werden, sobald andere Kriterien erfüllt sind.
Generell gilt: Wenn Websites technisch gut sind – also Google den Content crawlen, rendern, abrufen und indexieren kann – und solange der Content gut bzw. thematisch stimmig ist und solange es andere Signale für Vertrauen und Qualität gibt, lässt Google neue Seiten oder Seiten mit begrenzten/weniger Daten ranken. NAVBOOST muss nicht auf alles angewendet werden, sondern nur auf Seiten, bei denen Klicks aufgrund der Position überhaupt zustande kommen können.
Meiner Meinung nach bekommen Seiten eine Gelegenheit, sich zu beweisen – deshalb verschieben Core Updates die SERPs: Es gibt anderem Content die Chance zu ranken, und nur Content, der WIRKLICH nachhaltig positive Nutzerinteraktion zeigt, hält sein Ranking über Core Updates hinweg.
Aber wie wir wissen: Nichts bei Google ist jemals wirklich konsistent.
Alle in diesem Artikel genannten Modellnamen, Attributnamen und Dokumentationsauszüge stammen aus der im Mai 2024 geleakten Dokumentation der Google Content Warehouse API, katalogisiert aufseo-datawarehouse.com. Aussagen aus dem Kartellverfahren stammen aus öffentlichen Gerichtsakten in United States of America v. Google LLC. Wo Interpretationen spekulativ sind, sind sie klar als solche gekennzeichnet.
Ich liebe SEO und ich liebe Spekulationen, Diskussionen und SEO-Tests, aber NICHTS in diesem Artikel würde ich als definitiv bezeichnen; ich habe meine eigenen spekulativen Gedanken ergänzt – auch wenn ich eines mit Sicherheit weiß!
Chrome ist ein trojanisches Pferd für Daten, und Klickverhalten ist eine der besten Methoden, um festzustellen, ob etwas gut oder schlecht ist! Klickverhalten zählt wirklich.

Gründer, SEO Stack
Daniel ist der Gründer von SEO Stack. Er arbeitet seit über 2 Jahrzehnten an technischem SEO und Suchdaten und hat SEO Stack entwickelt, nachdem er in der Kundenarbeit einmal zu oft an dieselben Search-Console-Limits gestoßen war.
Daniel verfügt über umfangreiche SEO-Erfahrung: Er hat SEO-Agenturen, Audit-Unternehmen und eine erfolgreiche Beratung aufgebaut. In seiner Freizeit führt Daniel gerne SEO-Experimente durch und teilt seine Erkenntnisse.
Veröffentlicht 29. März 2026

