NavBoost spiegato: cosa ci dice davvero il leak del Google Content Warehouse sul ranking basato sui click
Google ha passato anni a ripetere al settore SEO che i clic non contavano. Che il dwell time era irrilevante. Che il CTR era rumore. In effetti, per molti anni l'ho gridato su LinkedIn, molti…
Google ha passato anni a ripetere al settore SEO che i click non contavano. Che il dwell time era irrilevante. Che il CTR era rumore. Anzi, per molti anni ho gridato questa cosa su LinkedIn, e in tanti mi hanno dato del complottista.
“Dan, Google non usa i dati comportamentali per il ranking” oppure “che succede se un sito non ha GSC o google analytics configurati?”.
Ma la realtà è che sapevo che Google usava quei dati: ho condotto moltissimi test SEO — ho comprato un paio di domini e ho testato la manipolazione dei click usando CTR Booster + proxy residenziali con user agent randomizzati e comportamenti di pagina / interazione differenti.
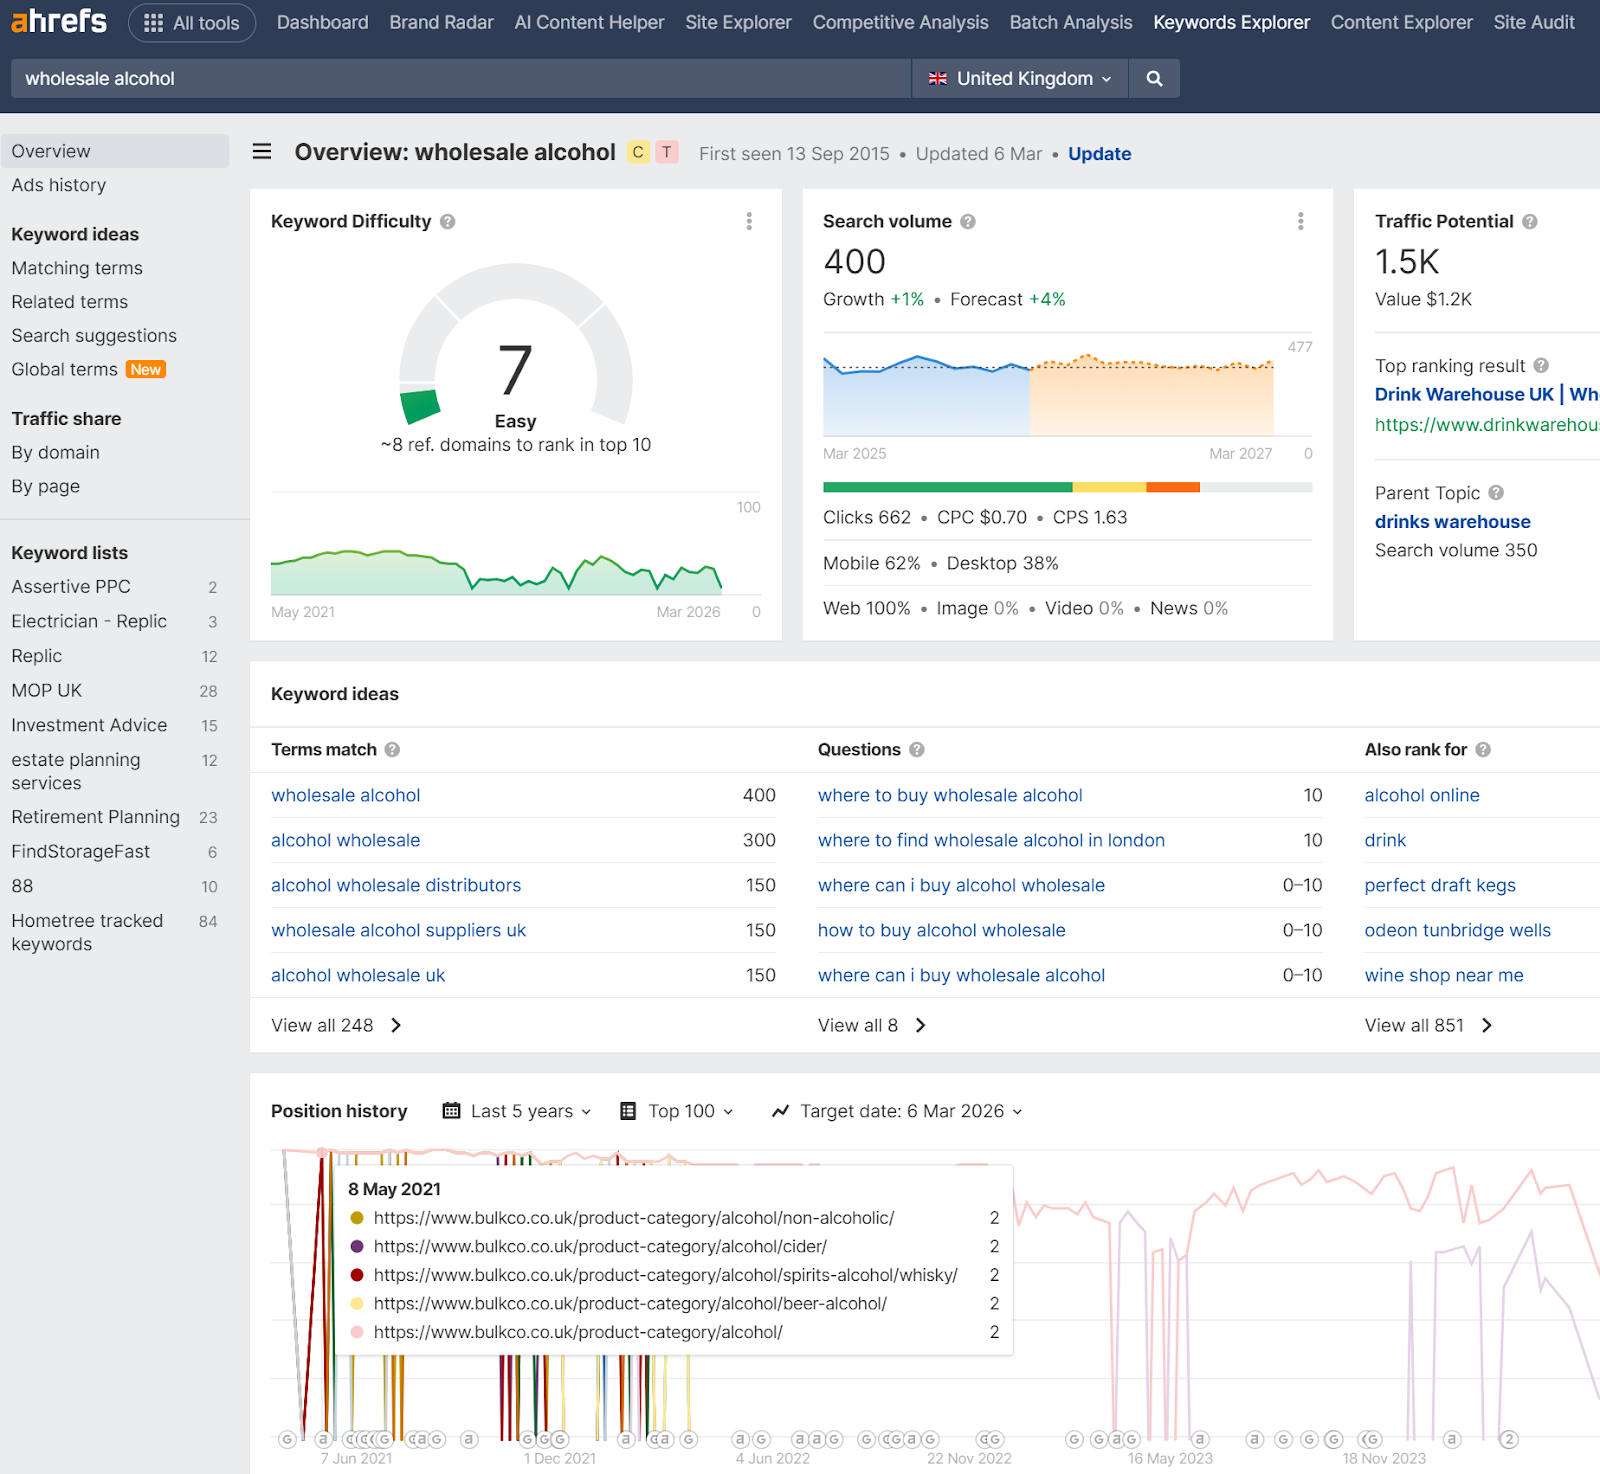
Una volta ho posizionato un sito eCommerce fittizio www.bulkco.co.uk proprio con questi test — posizionato per oltre 3 anni su migliaia di keyword con un dominio debole.
Sapevo che c'era qualcosa sotto e, grazie a un leak e ai successivi processi del DOJ, ora sappiamo che Google usa effettivamente il comportamento: ecco a voi Navboost.
Quindi, la documentazione della Content Warehouse API è trapelata a maggio 2024 e lì, dentro lo schema, referenziato 84 volte in sei modelli dedicati, c'era NavBoost. Un sistema che traccia good click, bad click, long click, impression, tipi di dispositivo, segmentazione geografica, punteggi di frode basati su IP e voter token che rappresentano singoli utenti — non ci è voluto molto per iniziare a mettere insieme i pezzi.
Mesi prima, durante il processo antitrust del DOJ statunitense, il VP di Google Pandu Nayak aveva già confermato sotto giuramento che NavBoost era "uno dei segnali importanti" usati da Google. Le email interne presentate come prova andavano oltre. Il VP di Google Alexander Grushetsky scriveva nel 2019 che NavBoost da solo era probabilmente più potente di tutto il resto del ranking messo insieme sulle metriche di click e precisione, e che gli ingegneri esterni al team NavBoost erano scontenti di quanta influenza avesse.
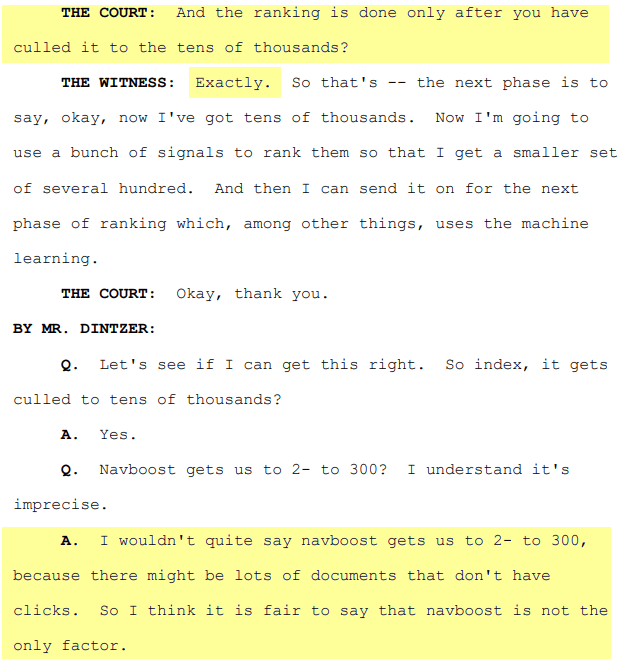
Approfondisci leggendo il PDF originale pubblicato dal DOJ qui
Questo articolo passa in rassegna ogni modello della categoria NavBoost presente nella documentazione trapelata della Content Warehouse. Dove lo schema ci dice qualcosa di concreto, lo diremo chiaramente. Dove i nomi dei campi e le strutture suggeriscono un'interpretazione probabile ma lasciano margine di ambiguità, lo segnaleremo e proporremo una teoria ragionata. L'obiettivo è darti una comprensione tecnica reale di ciò che è trapelato, non un riassunto riconfezionato con le incognite nascoste sotto il tappeto.
Devo essere chiaro: come SEO, il mio lavoro è fornire sempre insight utili e informazioni fattualmente corrette dove posso — non so COME questi modelli vengano applicati né in che misura, nessuno lo sa, MA possiamo dedurre / speculare. In alcuni casi è probabilmente molto ovvio come questi dati vengano raccolti / usati, ma in che misura?
Nessuno lo sa.
Ok, si parte..........
I sei modelli NavBoost
Il leak ha esposto sei modelli protocol buffer sotto il namespace QualityNavboost. Ciascuno valutato 10/10 per impatto SEO dagli analisti che hanno catalogato il leak. Sono:
QualityNavboostCrapsCrapsClickSignals Il contenitore principale dei segnali di click (10 attributi)
QualityNavboostCrapsCrapsData Il record dati master che lega i click a URL, query, dispositivi e località (22 attributi)
QualityNavboostCrapsCrapsDevice Classificazione di dispositivo e browser (3 attributi)
QualityNavboostCrapsFeatureCrapsData Segmentazione dei segnali per locale e a livello di feature (6 attributi)
QualityNavboostCrapsStatsWithWeightsProto Dati di distribuzione statistica per l'aggregazione a livello di pattern (15 attributi)
QualityNavboostGlueVoterTokenBitmapMessage Deduplicazione degli utenti e filtraggio per la privacy (2 attributi)
Prima di approfondire ciascuno, il nome merita una nota. "CRAPS" sembra essere un acronimo interno di Google che probabilmente sta per qualcosa tipo Click and Results Prediction System, anche se questo non è stato confermato ufficialmente. Se sia anche una strizzata d'occhio al gioco di dadi (data la natura probabilistica della previsione della soddisfazione utente a partire dai pattern di click) o agli anni in cui Google definiva pubblicamente le teorie basate sui click "stronzate inventate", lo lasciamo come esercizio al lettore.
E no, non confondiamo Craps con umorismo da bagno o giochi da casinò:
Modello 1: CrapsClickSignals — la tassonomia base dei click
Questo è il modello fondamentale. Contiene dieci attributi float e la sua descrizione nella documentazione trapelata è breve ma eloquente: "Click / impression signals for craps."
Ogni float qui rappresenta un conteggio o un rapporto. Non sono flag binari: sono valori continui, il che significa che Google sta quasi certamente lavorando con numeri pesati e normalizzati anziché con interi grezzi — ma, di nuovo, è una speculazione e NON è confermato (volevo solo metterlo in chiaro).
Gli attributi
clicks Il conteggio totale dei click per un dato documento rispetto a una data query (o cluster di query). Questa è la baseline. Tutto il resto in questo modello è un affinamento, o un sottoinsieme, di questo numero. Fondamentalmente deve verificarsi un click perché si possa fare una valutazione.
Quindi, chiaramente, ci saranno click che si traducono in un utente soddisfatto o insoddisfatto. Usiamo Hide the pain Harold (chi non lo ama come meme).
goodClicks I click che Google considera rappresentativi di un esito positivo per l'utente. Il leak non definisce i criteri precisi, ma sulla base delle testimonianze antitrust e di anni di analisi del pogo-sticking nella community SEO, un good click implica quasi certamente che l'utente clicchi un risultato, resti su quella pagina per un periodo significativo e non torni alla SERP per cliccare qualcos'altro. In altre parole: il click ha risolto la query.
Hide the pain Harold dopo aver visitato un sito che lo ha fuorviato o che non offriva una buona esperienza utente:
badClicks L'inverso. Click in cui l'utente è tornato rapidamente ai risultati di ricerca. È il segnale di pogo-sticking che Google ha passato anni a negare come fattore di ranking. Lo schema trapelato conferma che è un attributo con nome, memorizzato, di tipo float, collocato dentro un modello con impatto SEO 10/10.
Se ti stai chiedendo cosa sia il pogo, si riferisce al "pogo sticking", cioè passare rapidamente da uno stato all'altro — visiti un sito e lo abbandoni subito. Per inciso, a Google non serve la presenza di analytics per sapere quanto è durato l'engagement — ti ricordi di quel piccolo browser chiamato Chrome? Ecco, è un cavallo di Troia anche per i dati comportamentali!
Dai un'occhiata a questo articolo sul lato oscuro di Google Chrome e su come il tuo browser ti tradisce
lastLongestClicks Qui la cosa si fa interessante. La documentazione del modello padre CrapsData lo descrive come "il numero di click che sono stati gli ultimi e i più lunghi nelle query utente correlate." Non si tratta solo di quanto a lungo qualcuno è rimasto sulla tua pagina preso isolatamente. Si tratta di capire se il tuo risultato è stato quello su cui l'utente si è fermato: l'ultimo click della sua sessione di ricerca, e quello su cui ha passato più tempo. Se un utente clicca il Risultato A, rimbalza, clicca il Risultato B, rimbalza, poi clicca il Risultato C e ci resta quattro minuti prima di chiudere la scheda, è il Risultato C a prendersi il credito del lastLongestClick.
Per questo credo che Google mescoli le SERP, soprattutto quando l'intento della query di ricerca diventa più "vago" — ad esempio, se cercassi "auto" non stai specificando cosa vuoi, no? Vuoi sapere cos'è un'auto? Vuoi comprarne una? Vuoi sapere quali marchi di auto esistono?
SERP VARIE danno a Google un bacino di valutazione più ampio: servi intenti diversi in una SERP, accumuli i dati di click nel tempo e il comportamento aggregato nel tempo aiuta Google a capire meglio cosa "vuole la maggioranza".
Credo sia per questo che Google mescolava spesso risultati diversi, ed è anche il motivo per cui, per molti anni, trovavamo siti che semplicemente non avevano il profilo di un sito che meritasse di posizionarsi e che invece si posizionavano!
Voglio dire, per anni vatcalculator.co.uk, che era un EMD, si è posizionato al primo posto per vat calculator; anzi, si posiziona dal 2009 ed è ancora #1 oggi. Era un EMD non ottimizzato, senza HTTPS, non mobile friendly: la definizione stessa di sito costruito, messo online e poi abbandonato!
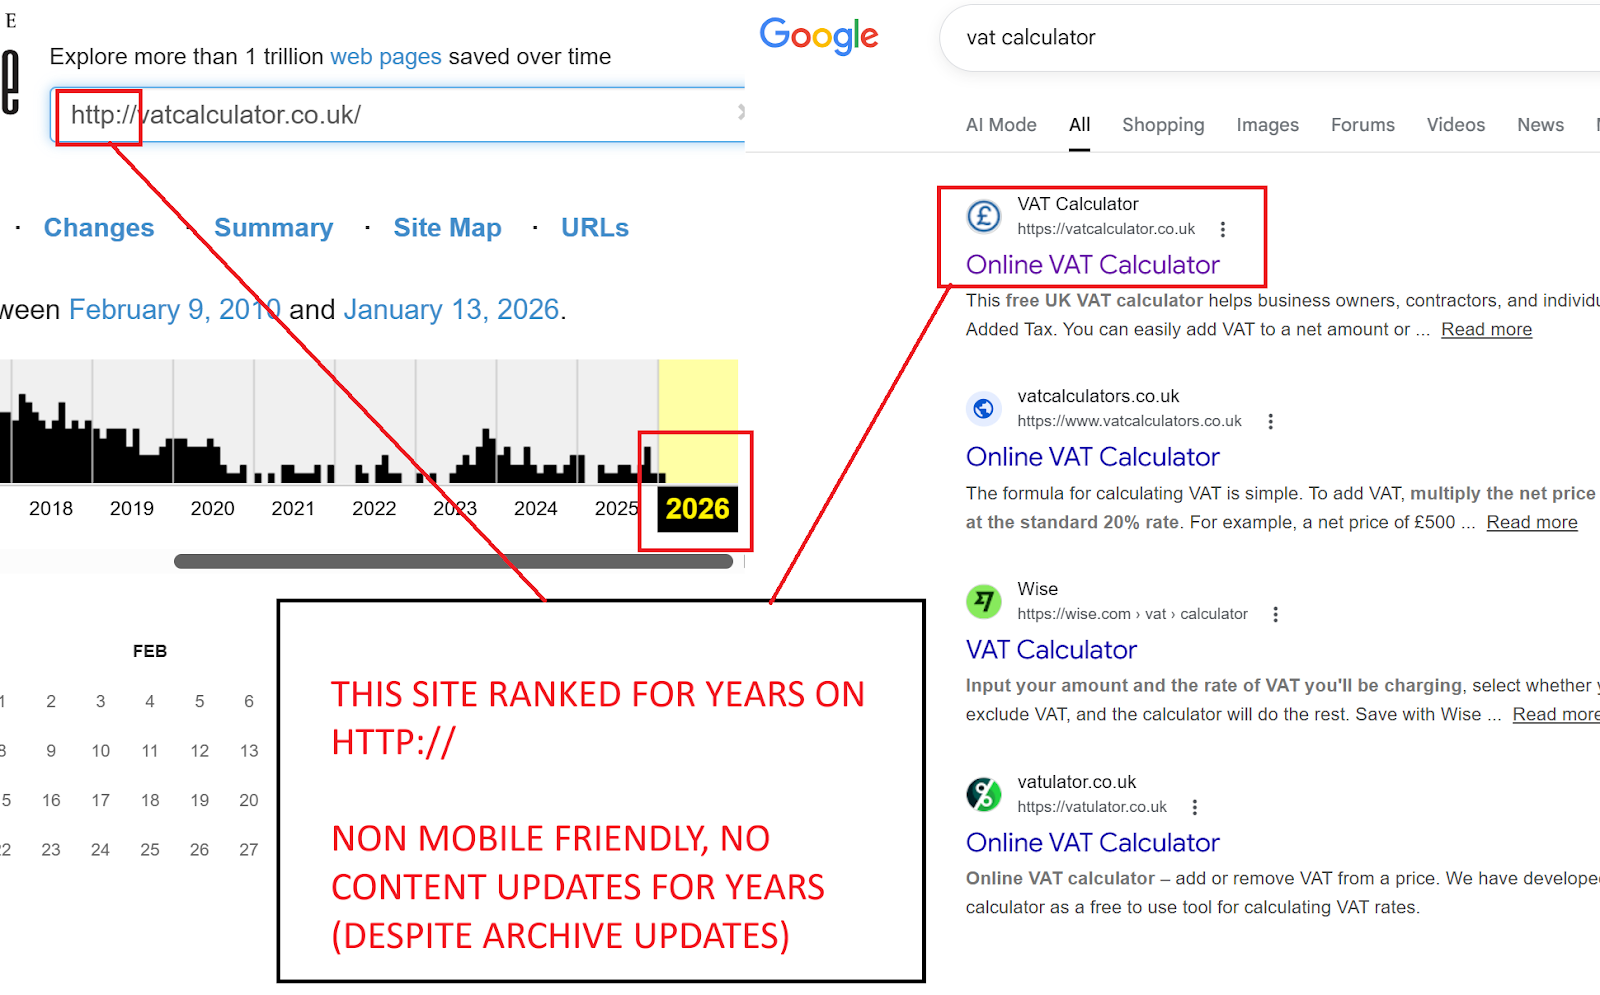
Perché ha mantenuto la posizione per COSÌÌÌÌ tanti anni?
Perché faceva una cosa sola e la faceva bene: dava agli utenti ESATTAMENTE quello che volevano, un calcolatore IVA semplice da usare e senza fronzoli:
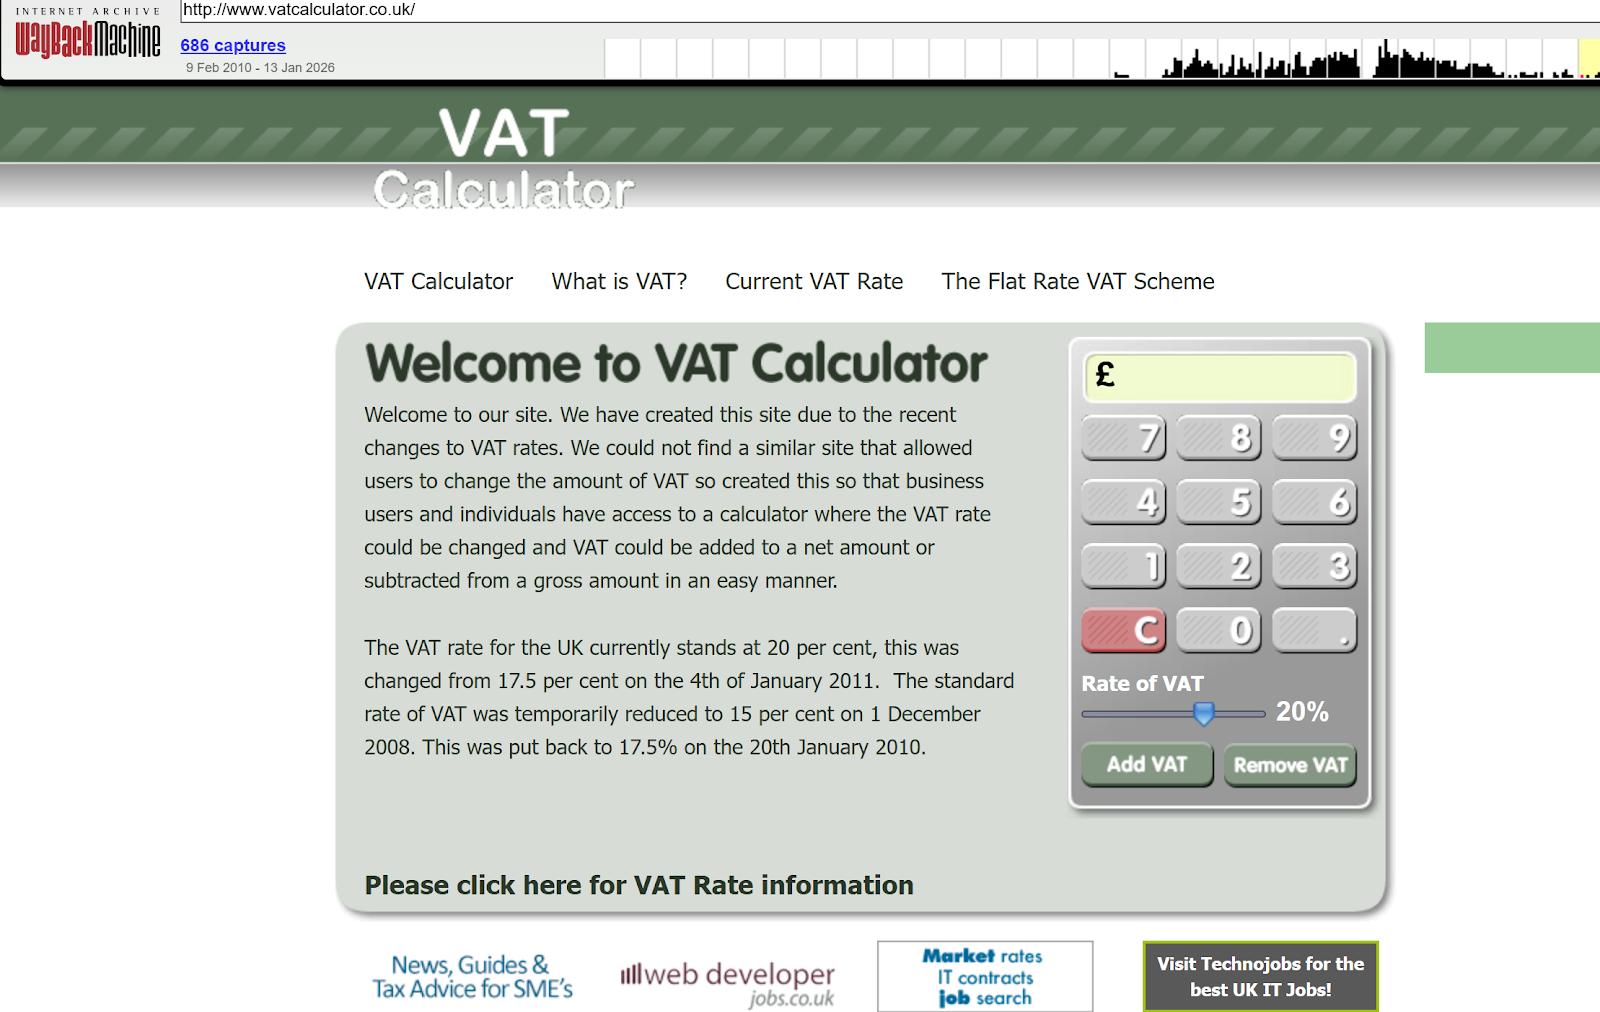
Si posizionava perché gli utenti USAVANO il calcolatore e chiudevano la sessione.
Good clicks.
Ora, continuiamo a esaminare altri tipi di click:
Interpretazione speculativa: questo è probabilmente il singolo segnale più prezioso dell'intero modello. Cattura sia la soddisfazione (dwell time lungo) sia la finalità (ultimo click). Una pagina che accumula costantemente lastLongestClicks su molte sessioni è una pagina che risolve dimostrabilmente la query. Se Google pesasse questi segnali, questo porterebbe probabilmente il carico maggiore.
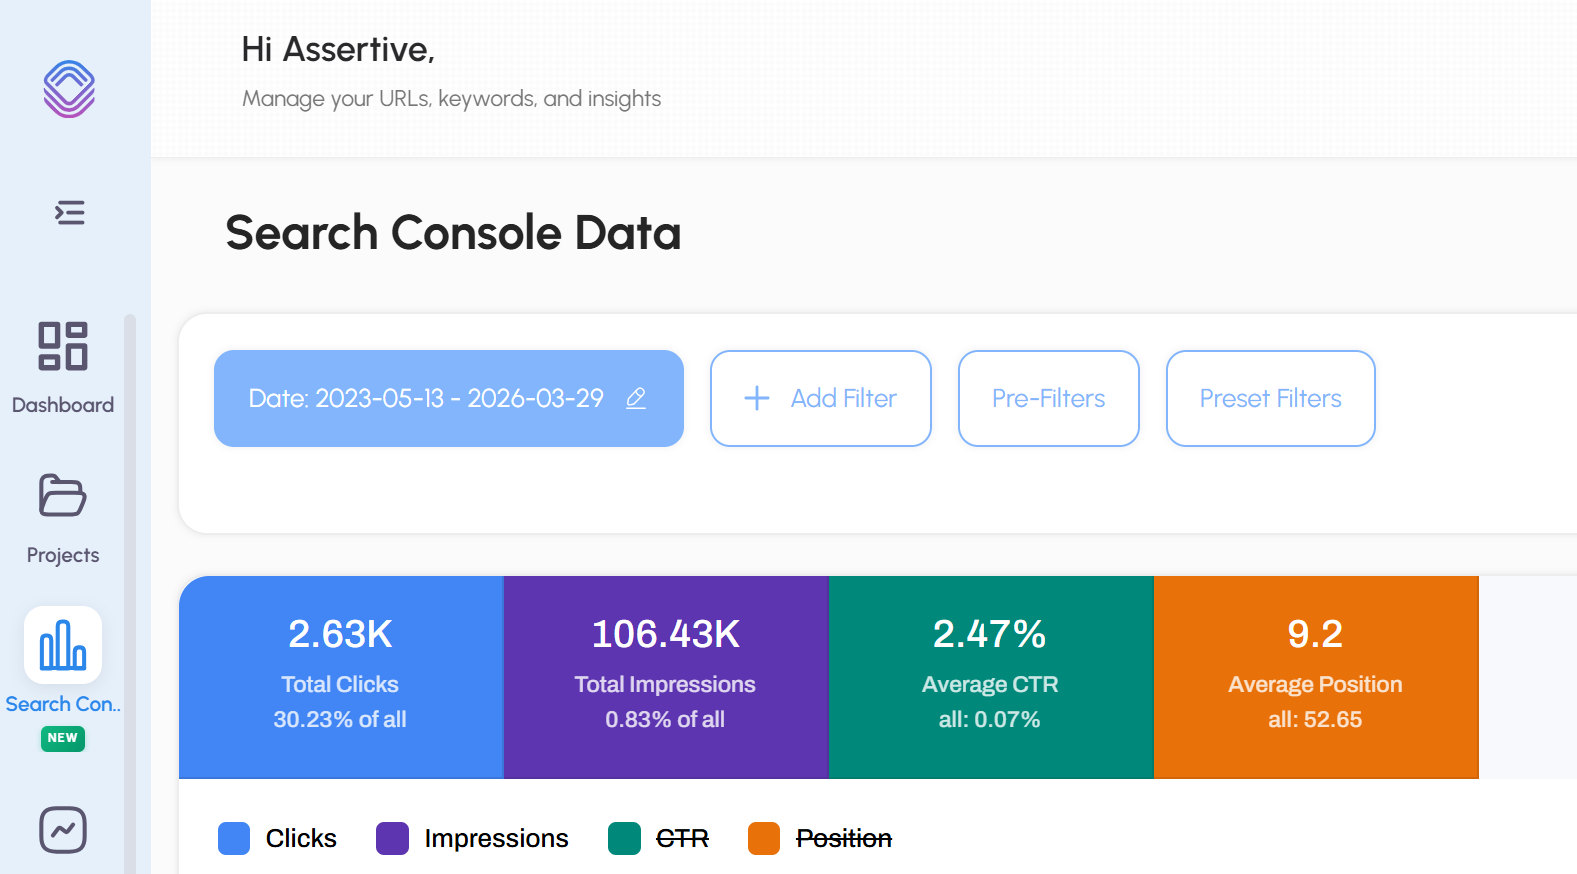
impressions Il numero di volte in cui un documento è stato mostrato nei risultati di ricerca per una query. È il denominatore di qualsiasi calcolo simile al CTR. Senza le impressions, il conteggio dei click è privo di significato: una pagina con 10 click su 10 impressions ha un rendimento molto diverso da una con 10 click su 10.000 impressions.
Dietro a questo c'è un ulteriore livello — lo riservo a un altro articolo, ma impressions e CTR sono centrali qui: Google stesso usa i dati di CTR e, come sappiamo, le AI overview hanno eroso significativamente i tassi di click anche per siti che si posizionavano stabilmente: lo spostamento causato dalle AIO ha distorto parecchio il CTR.
absoluteImpressions La documentazione è precisa su questo punto: "Thus far this field is only used for host level unsquashed impressions." Due aspetti contano qui. Primo, opera a livello di host, non di URL. Google misura quanto spesso l'intero dominio compare nei risultati, non solo una singola pagina. Secondo, è esplicitamente unsquashed — più avanti vediamo cosa significa.
unicornClicks La documentazione dice: "The subset of clicks that are associated with an event from a Unicorn user." È uno degli attributi più criptici del leak. Nella documentazione trapelata pubblicamente non c'è un'ulteriore definizione di cosa costituisca un "Unicorn user" — quindi anche qui non mi lancio in speculazioni.
Interpretazione speculativa: a mio avviso personale, la spiegazione più probabile è che Unicorn si riferisca a utenti Google autenticati, loggati, persone la cui identità e cronologia di navigazione Google può verificare con alta affidabilità. I loro click avrebbero più peso perché Google può confermare che si tratta di esseri umani reali e distinti, con pattern di navigazione consolidati, non bot, click farm o tentativi di manipolazione mascherati da VPN. Una teoria alternativa è che gli Unicorn user siano specificamente utenti Chrome, data la profonda integrazione di Chrome con l'infrastruttura di raccolta dati di Google. In ogni caso, l'implicazione è chiara: non tutti i click sono uguali, e i click provenienti da utenti che Google può identificare con sicurezza sembrano essere tracciati e valutati separatamente.
Non c'è dubbio che esistano molti meccanismi legati a Chrome, oltre allo spoofing dello user-agent e agli strumenti di click farming / manipolazione dei click progettati per influenzare il ranking imitando una sessione utente reale; tuttavia, nella maggior parte dei casi la manipolazione dei click proviene da browser non autenticati.
unsquashedClicks, unsquashedImpressions, unsquashedLastLongestClicks La documentazione segnala che questi campi stanno migrando verso un nuovo formato in cui i dati saranno memorizzati in istanze separate, squashed e unsquashed, di CrapsClickSignals. L'esistenza di entrambe le versioni ci dice qualcosa di cruciale su come Google elabora questi dati.
Squashed vs Unsquashed: come Google normalizza i dati di click
Questo è uno dei dettagli architetturali più importanti dell'intero leak.
Lo "squashing" è una funzione di normalizzazione. Un brevetto Google sul punteggio dei risultati di ricerca locale (US8046371B2) descrive lo squashing come una funzione che impedisce a un singolo segnale di grandi dimensioni di dominare gli altri. In termini pratici, una funzione di squashing comprime l'intervallo dei valori — tipicamente con una curva logaritmica, una sigmoide o un tetto rigido — così che la differenza tra 10 click e 100 click sia significativa, mentre quella tra 10.000 e 100.000 click venga attenuata.
Perché è importante: senza squashing, le pagine ad alto traffico avrebbero un vantaggio incolmabile. Un articolo della BBC con 50.000 click soffocherebbe un blog specialistico con 500 click, anche se il blog specialistico avesse un rapporto tra good click e bad click molto più alto. Lo squashing livella il campo comprimendo i numeri assoluti e lasciando parlare i rapporti.
I valori unsquashed, quindi, sono i numeri grezzi prima dell'applicazione di questa normalizzazione. Google conserva entrambe le versioni perché servono a scopi diversi:
I dati squashed alimentano l'algoritmo di ranking, dove la qualità proporzionale conta più del volume assoluto
I dati unsquashed alimentano probabilmente il rilevamento antispam, dove il volume assoluto e i picchi anomali sono esattamente ciò che si cerca
Scenario pratico: immagina il sito di uno studio legale locale a Bedford che normalmente ottiene 30 impressions e 8 click al mese per "family solicitor Bedford". Una settimana riceve improvvisamente 400 click su 500 impressions. I dati squashed attenuano questa anomalia, così da non catapultare il sito in cima ai risultati. I dati unsquashed conservano il picco grezzo, così che un sistema di rilevamento spam (potenzialmente i sistemi IP prior o voter token descritti altrove nel leak) possa segnalarlo per un'indagine.
Modello 2: CrapsData — Il record principale
Se CrapsClickSignals è il vocabolario, CrapsData è la frase. Questo modello da 22 attributi lega insieme tutti i segnali di click con il contesto: la query, l'URL, il paese, il dispositivo, la lingua e diversi livelli di aggregazione e segmentazione.
Associazione tra query e URL
query (string) La query di ricerca effettiva a cui si riferiscono questi dati. NavBoost non traccia semplicemente "questa pagina ha ricevuto X click". Traccia "questa pagina ha ricevuto X click per questa specifica query". Sono dati di coppia query-documento, il che significa che NavBoost può distinguere tra una pagina che rende bene per una query e male per un'altra.
url (string) L'URL specifico tracciato.
patternLevel (integer) Rivela che Google non traccia solo i singoli URL. Aggrega i dati di click a più livelli di astrazione dell'URL:
Livello 0: l'URL esatto (es. https://example.com/services/seo-audit)
Livello 1: il pattern dell'host (es. p://example.com)
Livello 2: il pattern del dominio (es. p://example.com ridotto alla radice)
La documentazione fornisce un esempio concreto: per http://abc.def.ghi/xyz.html, il livello 0 è l'URL completo, il livello 1 è p://abc.def.ghi e il livello 2 è p://def.ghi.
Perché è importante: conferma che NavBoost opera simultaneamente a livello di sottodominio, dominio radice e URL. La tua singola pagina può avere dati di click deboli, ma se il tuo dominio nel complesso accumula costantemente good click su centinaia di URL, quel segnale a livello di pattern fornisce probabilmente una spinta. Al contrario, un dominio con rapporti di badClicks costantemente elevati subisce probabilmente una penalizzazione a livello di pattern anche su pagine nuove che non hanno ancora accumulato una propria cronologia di click.
Scenario speculativo: la mia idea è che un nuovo articolo su un sito consolidato, con pattern NavBoost solidi a livello di dominio, possa ereditare una "fiducia" di base dalla cronologia di click del dominio padre, ottenendo una partenza più favorevole nei ranking rispetto a un articolo identico su un dominio nuovo privo di cronologia di click. Questo spiegherebbe perché i siti consolidati spesso posizionano più rapidamente i contenuti nuovi: non è solo domain authority nel senso dei link, è qualità dei click accumulata a livello di pattern.
Segmentazione geografica e linguistica
country (string) Codice paese di due lettere maiuscole. Esempi forniti: "US", "FR", "BR".
language (string) Codice lingua. Esempi: "en", "fr", "pt-BR".
Questo significa che Google memorizza e valuta i segnali di clic per paese e per lingua. Una pagina che ottiene metriche di clic eccellenti in Germania potrebbe avere metriche pessime in Francia. NavBoost è in grado di distinguere tra le due e adeguare i ranking di conseguenza.
Implicazione pratica: se gestisci un sito multilingua, le tue pagine in inglese e quelle in francese stanno costruendo profili NavBoost separati. Una versione francese tradotta male di una pagina inglese che performa bene non beneficerà dei dati di clic della versione inglese. Ogni variante linguistica guadagna (o perde) i propri segnali di clic.
sliceTag (stringa) Un campo flessibile descritto come un elemento che consente alla pipeline CRAPS di "suddividere i segnali in base a vari attributi come tipo di dispositivo, paese, locale ecc." Si tratta essenzialmente di una chiave di segmentazione jolly. Lo slice tag può essere una stringa arbitraria e i segnali vengono aggregati separatamente per ciascun tag, accanto al tag vuoto predefinito.
Interpretazione speculativa: a mio avviso questo suggerisce che Google può creare segmenti di segnale ad hoc oltre alle suddivisioni standard per paese/lingua/dispositivo. Durante eventi importanti (elezioni, pandemie, disastri naturali), potrebbe potenzialmente creare slice tag temporanei che modificano il peso dei segnali di clic per specifiche categorie di query. Questo è coerente con le prove emerse dal processo antitrust, che mostrano come Google abbia utilizzato whitelist durante il COVID-19 e le elezioni.
Segmentazione per dispositivo
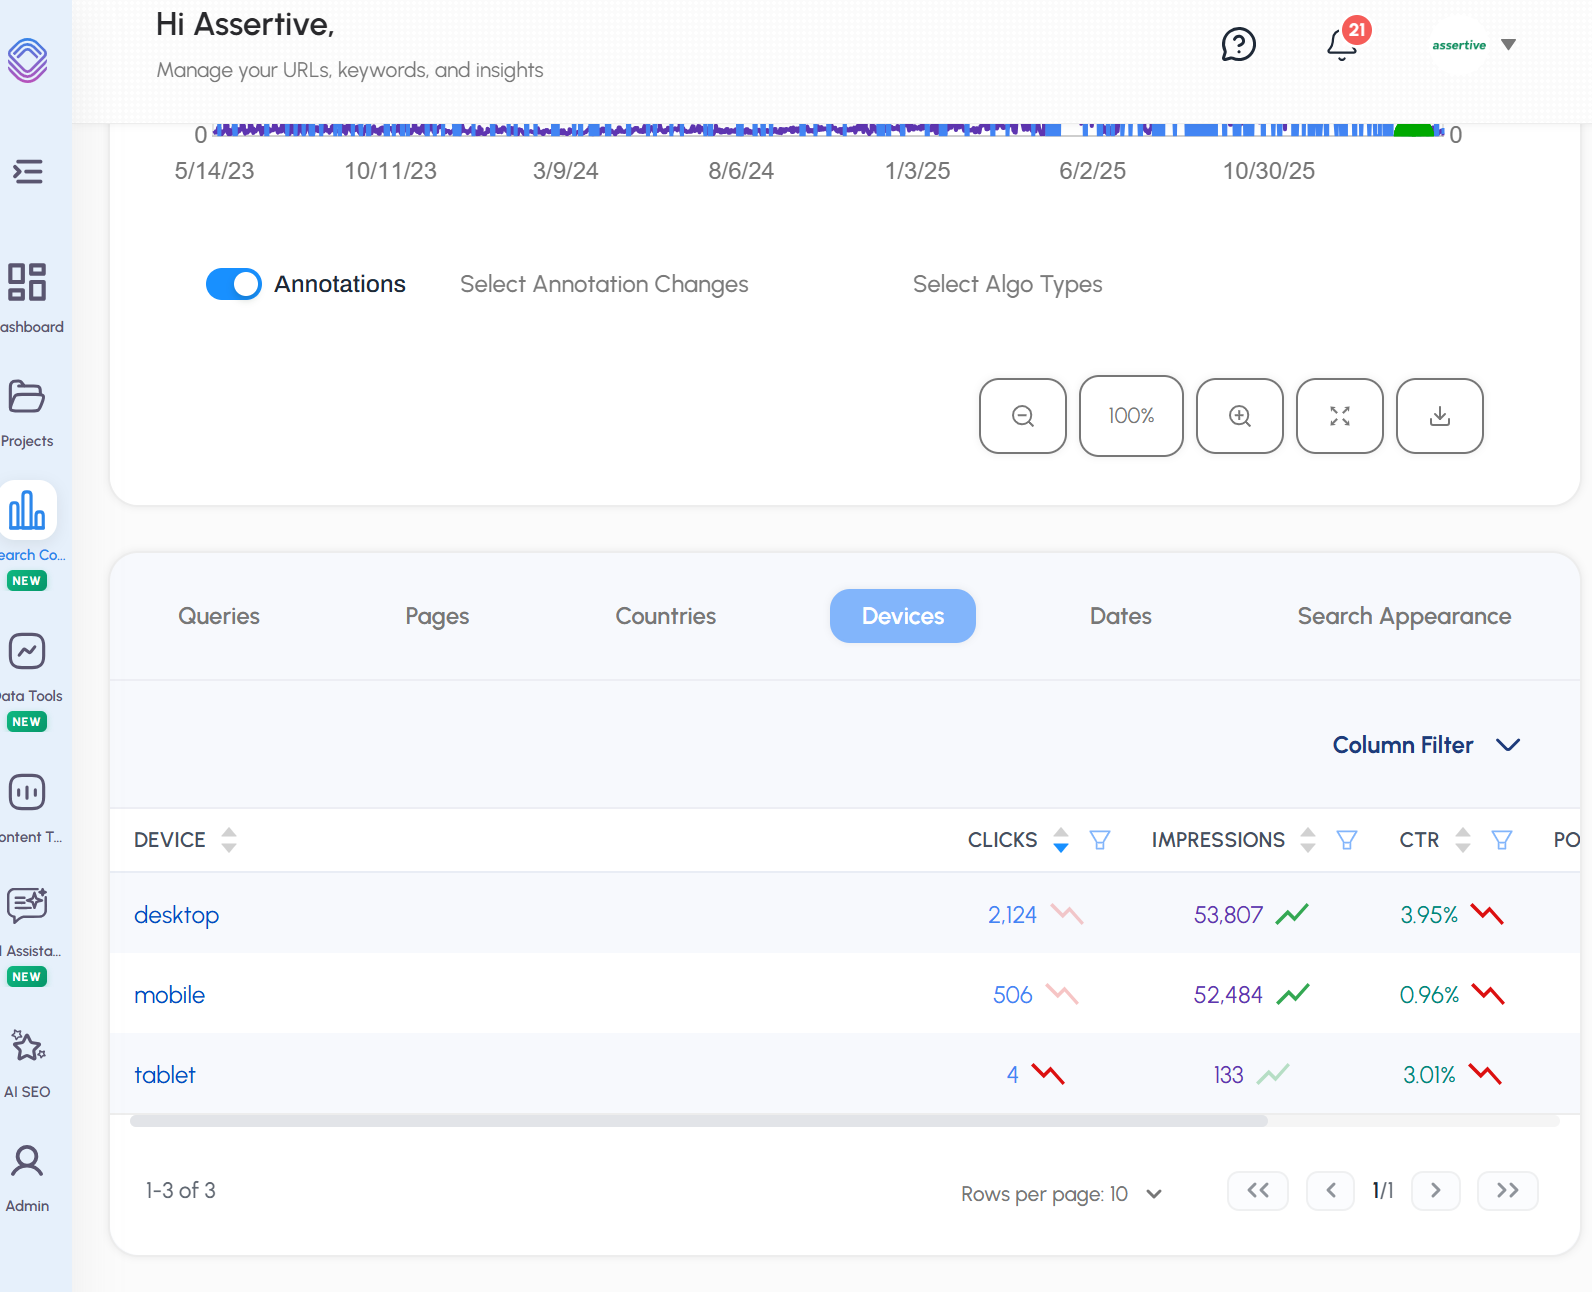
device Si collega al modello CrapsDevice (trattato più avanti).
mobileSignals Un'istanza dedicata di CrapsClickSignals aggregata specificamente dalle "interfacce mobile di tier 1/2 nelle QSessions." Google mantiene profili di segnali di clic completamente separati per gli utenti mobile.
mobileData Contrassegnato come legacy ("DO NOT USE"), sostituito da mobileSignals. Il fatto che Google abbia deprecato e sostituito questo campo ci dice che l'architettura dei segnali mobile è stata attivamente rielaborata, probabilmente per supportare una classificazione più granulare dei dispositivi mobile.
Istanze squashed e unsquashed
squashed Un'istanza completa di CrapsClickSignals contenente i dati di clic normalizzati. La documentazione segnala che alla fine sostituirà i campi di primo livello goodClicks/badClicks/impressions.
unsquashed L'istanza grezza, non normalizzata. Descritta come in preparazione per "il rollout di retuning," il che suggerisce che Google stesse attivamente ricalibrando il modo in cui questi due flussi di dati interagiscono nel momento in cui la documentazione è stata generata.
unsquashedMobileSignals Dati di clic mobile grezzi prima della normalizzazione.
Anti-spam e analisi degli IP
packedIpAddress (stringa) Una stringa in network byte order compresso utilizzata da un sistema chiamato CrapsIpPrior. Popolata solo quando Google ha consultato l'IP prior bad fraction al momento del retrieval.
unscaledIpPriorBadFraction (float) Utilizzato per assegnare un prior basato sull'indirizzo IP. La documentazione fa esplicito riferimento a due file interni: quality/navboost/craps/craps-ip-prior.h e craps-penalty.cc. Il valore qui memorizzato è precedente alla trasformazione, prima che venga applicata un'operazione di scaling lineare, offset e min/max.
Cosa ci dice questo: Google mantiene un punteggio di reputazione a livello di IP. Ogni indirizzo IP ha una "bad fraction", essenzialmente una misura di quanto spesso i clic provenienti da quell'IP siano stati storicamente classificati come spam, traffico bot o tentativi di manipolazione. Quando valuta i segnali di clic provenienti da un determinato IP, questo prior modifica il peso di quei clic.
Questo PUÒ ANCHE collegarsi al motivo per cui studi precedenti hanno mostrato che l'HOSTING CONDIVISO può essere PEGGIORE per la SEO, laddove un blocco di IP potrebbe essere associato a soggetti malevoli / spam di massa ecc.
Di fatto, qualche anno fa, un concorrente di lunga data (e mio ottimo amico, Shai Aharony) e uno dei suoi SEO, "Oliver Sissons", hanno condotto un esperimento su un "long term shared hosting experiment" che sembrava anch'esso suggerire che questo sia vero:
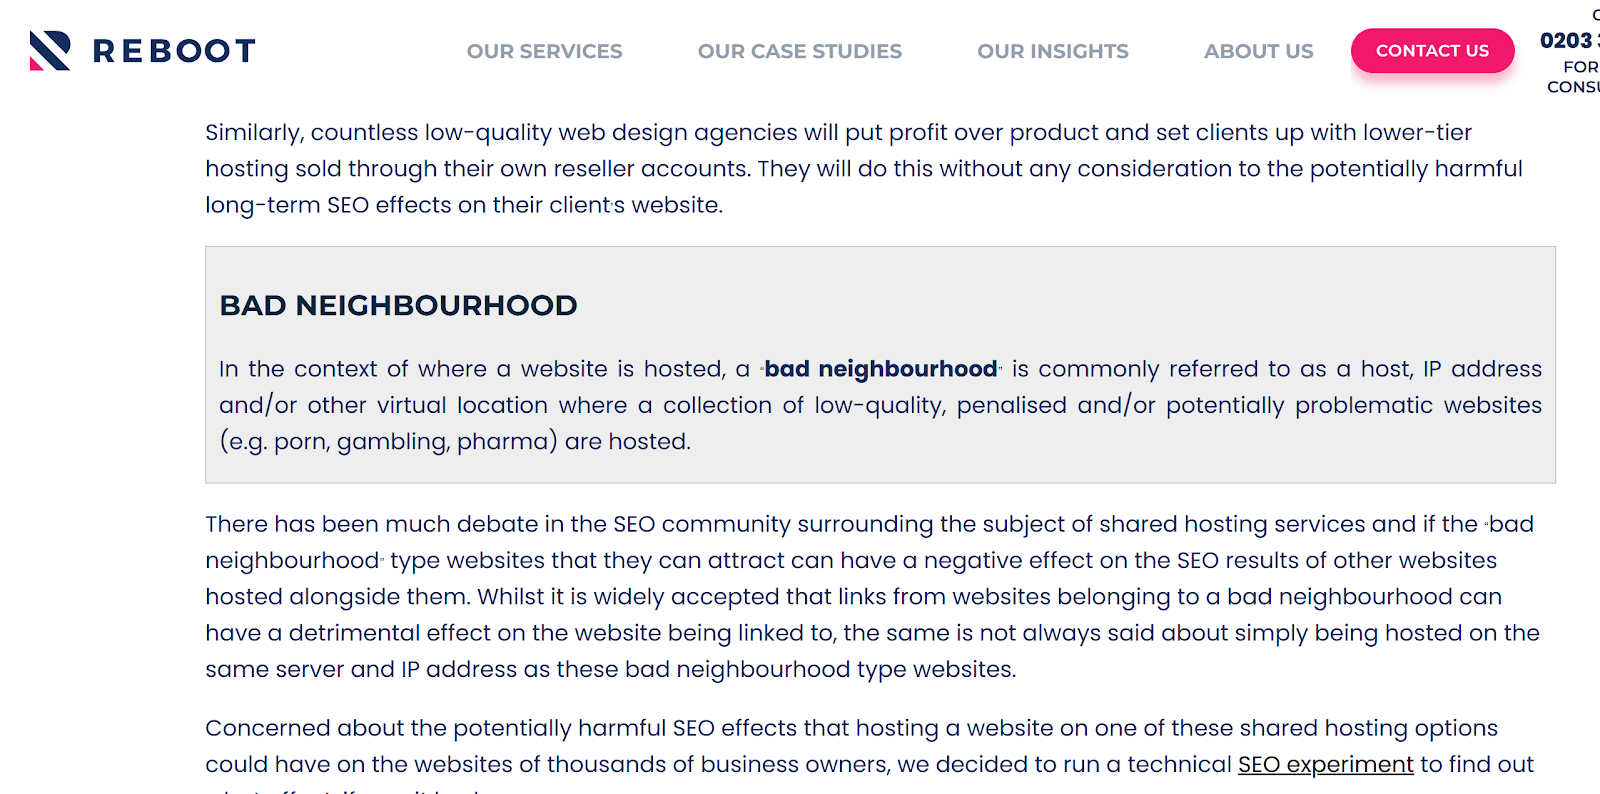
Questo potrebbe spiegare:
Perché alcuni siti registrano guadagni di ranking dopo essersi spostati da un hosting condiviso
Perché alcuni domini sembrano "tossici" quando in realtà è il blocco di IP a cui sono associati a essere noto per spam/abusi e, di conseguenza, qualunque cosa venga servita su di esso può risentirne.
Scenario pratico: un servizio di manipolazione del CTR che instrada clic attraverso un endpoint VPN a Londra potrebbe inizialmente ottenere risultati. Ma man mano che i clic da quell'IP si accumulano e nessuno di essi mostra pattern di navigazione naturali (dwell time variabili, query di follow-up naturali, URL cliccati diversificati), la bad fraction sale. Alla fine, i clic provenienti da quel range IP vengono o fortemente scontati o ignorati del tutto. La trasformazione "scaling / offset / min / max" menzionata nella documentazione suggerisce l'esistenza di un sistema a soglie: al di sotto di una certa bad fraction i clic vengono accettati normalmente; al di sopra vengono progressivamente svalutati; oltre un tetto massimo possono essere scartati.
L'ho testato negli anni usando strumenti come CTR Booster + Trusted Proxies, che instradavano le richieste tramite IP di proxy residenziali con user-agent falsificati.
CTR Booster funzionava, tuttavia è molto probabile che queste sessioni siano diventate più evidenti con il miglioramento nel tempo delle capacità di rilevamento di Google.
Voter token e filtraggio per la privacy
voterTokenCount (intero) "Il numero di voter token distinti (un limite inferiore al numero di utenti distinti che hanno contribuito alla voce, utilizzato per il filtraggio legato alla privacy)."
Questo è cruciale. Google non si limita a contare i clic: conta gli esseri umani unici. Il sistema dei voter token fornisce un limite inferiore al numero di utenti distinti i cui clic hanno contribuito al profilo NavBoost di un URL. Se un URL ha 500 clic ma solo 3 voter token, è un enorme campanello d'allarme. Se ha 500 clic da 480 voter token, è un segnale sano e organico.
La formulazione "limite inferiore" è deliberata: i voter token non sono unici per utente (come confermato nel modello FeatureCrapsData), quindi il conteggio è una stima conservativa. Google preferisce sottostimare gli utenti distinti piuttosto che sovrastimarli, il che significa che la soglia di filtraggio per la privacy è calibrata per proteggere dai falsi positivi.
Interpretazione speculativa: secondo me esiste quasi certamente una soglia minima di voter token al di sotto della quale i dati NavBoost per una coppia URL/query vengono soppressi del tutto. Se solo due o tre utenti hanno contribuito con clic, il campione è troppo piccolo per essere significativo e troppo facile da manipolare. Questo spiegherebbe perché le pagine nuove con traffico molto basso non registrano variazioni di ranking guidate da NavBoost finché non hanno accumulato una massa critica di utenti distinti.
Statistiche a livello di pattern
patternSccStats Si collega al modello StatsWithWeightsProto (trattato più avanti). Per i dati a livello di pattern, contiene statistiche sulle componenti fortemente connesse dei singoli URL che contribuiscono al pattern. In altre parole, quando Google aggrega i dati di clic a livello di dominio, non si limita a sommare i numeri: ne analizza la distribuzione. Quanto è costante la qualità dei clic tra i singoli URL? Il solido profilo NavBoost del dominio è trainato da un'unica pagina virale, oppure è costante su centinaia di pagine?
Modello 3: CrapsDevice, cosa sa Google del dispositivo del tuo visitatore
Tre attributi. Semplici, ma rivelatori.
os (stringa) Il sistema operativo. Conferma che Google traccia e memorizza l'OS di ogni utente i cui clic alimentano NavBoost.
uxInterface (intero) Un enum da GWSLogEntryProto che indica il tipo di dispositivo:
1 = Desktop
2 = Mobile
3 = Tablet
Il riferimento a "gwslog(608)" ci dice che questi dati provengono direttamente dal log del Google Web Server, la stessa infrastruttura che serve ogni richiesta di ricerca su Google.
uxTier (intero) Tier di capacità del browser:
1 = Browser moderni
2 = Tutto ciò che sta nel mezzo
3 = Browser molto datati
Perché questo conta al di là della segmentazione di base: se Google suddivide i segnali di clic per tier del browser, significa che il sistema può potenzialmente pesare i clic dai browser moderni diversamente dai clic dai browser datati. Un clic da Chrome 120 su un dispositivo Android di punta è probabilmente trattato come un segnale a maggiore affidabilità rispetto a un clic da un browser obsoleto, che potrebbe essere associato a traffico bot o a infrastrutture di crawling datate.
Scenario ipotetico: questo sistema a livelli potrebbe fungere anche da vettore anti-manipolazione. Gli strumenti di click automatizzati usano spesso browser headless o user agent datati che potrebbero ricadere nel tier 2 o nel tier 3. Se Google osserva che una quota sproporzionata dei click di una URL proviene da browser di livello basso rispetto alla norma per quella query, si tratta di un potenziale segnale di spam.
Modello 4: FeatureCrapsData – Suddivisione granulare per locale
Questo modello consente una segmentazione geografica e per dispositivo estremamente capillare dei segnali di click.
country (stringa) Stesso formato di CrapsData, in minuscolo (es. "us"). La documentazione precisa: "If not present, it's an aggregation for all countries."
language (stringa) es. "en". Anche qui, l'assenza indica un'aggregazione su tutte le lingue.
device (stringa) Indicatore semplificato del dispositivo: "m" per mobile, "d" per desktop. Se assente, il dato è aggregato su tutti i dispositivi.
locationId (intero) "Location id for metro and city. If not present, it's an aggregation for all locations within current country."
È questo il campo che conferma come NavBoost operi a livello di area metropolitana/città. Google non sa soltanto che stai cercando dal Regno Unito: sa che stai cercando da Birmingham o da Edimburgo, e può segmentare i segnali di click di conseguenza.
Implicazione pratica: se sei un consulente SEO che lavora sulla local SEO per un'attività di Manchester, i segnali di click del tuo cliente provenienti dagli utenti di Manchester vengono tracciati separatamente da quelli provenienti dagli utenti di Londra. Un ristorante che ottiene ottimi click dagli utenti della propria città ma click scadenti dagli utenti di altre aree può posizionarsi bene a livello locale e male a livello nazionale: NavBoost è il meccanismo che rende possibile questo differenziale.
signals Un'istanza completa di CrapsClickSignals contenente i dati di click per questa specifica porzione di locale.
voterTokenBitmap Si collega al modello GlueVoterTokenBitmapMessage. Fornisce un tracciamento dei voter token per singolo locale, il che significa che Google può valutare la diversità degli utenti che contribuiscono ai segnali di click a livello metropolitano. Se un'attività con sede a Londra riceve improvvisamente un picco di "good click" da utenti di una singola area metropolitana, ma la bitmap dei voter token mostra che provengono tutti da una manciata di token, il segnale viene filtrato.
Modello 5: StatsWithWeightsProto – Analisi della distribuzione
Questo è un modello da statistici. Quindici attributi, tredici dei quali float, tutti descrittivi della distribuzione statistica dei dati di click tra le URL che contribuiscono a un'aggregazione a livello di pattern.
n (intero) Dimensione del campione. Il numero di singoli data point (verosimilmente singole URL) che contribuiscono al pattern.
weightedN (float) Dimensione ponderata del campione. Non tutte le URL contribuiscono allo stesso modo: alcune hanno un peso maggiore, forse in base al volume di traffico o al numero di voter token.
mean, median Tendenza centrale della metrica di click misurata.
stddev, variance, varOfMean, stdError Metriche di dispersione. Quanto sono distribuiti i segnali di click tra le URL all'interno di questo pattern?
hi, lo Gli estremi della distribuzione.
pc10, pc25, pc75, pc90 Punti di rottura percentili. Danno a Google un quadro completo della forma della distribuzione.
kind (intero) Un enum che indica di quale tipo di statistica si tratta. Il leak non elenca i valori possibili, ma con ogni probabilità distingue tra metriche diverse (good click ratio, bad click ratio, lastLongestClick ratio, ecc.).
Perché questo livello di dettaglio statistico conta: Google non si limita a guardare se il tuo dominio ha buoni segnali di click aggregati. Guarda la distribuzione della qualità dei click tra le tue pagine. Un dominio in cui il good click ratio mediano è 0,6 con una deviazione standard contenuta è un dominio solido in modo costante. Un dominio in cui la media è 0,6 ma la deviazione standard è enorme – il che significa che alcune pagine sono eccellenti e altre pessime – presenta un profilo qualitativo del tutto diverso.
Interpretazione ipotetica: dal mio punto di vista è molto probabile che sia questo il meccanismo dietro le valutazioni di qualità a livello di sito. Se i sistemi interni di Google (come l'HCU di Google, helpful content update o system) applicano modificatori a livello di sito, la distribuzione statistica dei segnali NavBoost lungo il pattern di URL di un dominio è con tutta probabilità un input chiave. Non basta avere qualche pagina eccellente: se il tuo pc10 (il 10° percentile) mostra che le tue pagine peggiori generano click in larghissima parte negativi, questo trascina verso il basso la valutazione a livello di pattern.
Scenario pratico: una content farm pubblica 1.000 articoli. Cinquanta di questi, per caso, performano bene e ottengono buoni click. Gli altri 950 generano pogo-sticking e click negativi. La media potrebbe sembrare mediocre, ma la mediana è pessima, il pc10 è vicino allo zero e la deviazione standard è enorme. Le statistiche a livello di pattern di Google catturerebbero questo profilo con precisione e probabilmente alimenterebbero una penalizzazione a livello di sito.
Modello 6: GlueVoterTokenBitmapMessage – Il livello anti-manipolazione
Due attributi stringa, ma la descrizione del modello rivela il meccanismo sottostante.
La documentazione afferma che questo modello è "used for aggregating query unique voter_token during merging" e impiega "4 uint64(s) as a 256-bit bitmap to aggregate distinct voter_tokens in Glue model pipeline."
voterToken (stringa) Un singolo voter token. Come ottimizzazione, se ha contribuito un solo utente, il token viene memorizzato come un singolo uint64 anziché come bitmap completa.
subRange (lista di stringhe) I componenti della bitmap quando sono presenti più token.
Come funziona, con ogni probabilità: a ogni utente che contribuisce con un click viene assegnato un voter token (che non è univoco per utente: è un identificatore hashato e privacy-preserving che funge da limite inferiore sul numero di utenti distinti). Questi token vengono aggregati in una bitmap a 256 bit. La bitmap consente a Google di unire in modo efficiente insiemi di token tra query e periodi temporali durante l'elaborazione della pipeline Glue.
Il riferimento a "Glue" è significativo. Come confermato durante il processo antitrust, Glue è essenzialmente NavBoost esteso a coprire tutte le feature della SERP: non solo i dieci link blu, ma anche Knowledge Panel, caroselli video, image pack, box People Also Ask e AI Overview. La bitmap dei voter token garantisce che il controllo sulla diversità degli utenti si applichi a tutti questi tipi di feature.
Perché 256 bit? Una bitmap a 256 bit può rappresentare fino a 256 bucket hash distinti di voter token. Questo significa che il sistema è progettato per un conteggio approssimato ed efficiente degli utenti distinti, non per un conteggio esatto. Per gli scopi di NavBoost, sapere che hanno contribuito "circa 180 utenti distinti" è sufficiente: il conteggio esatto conta meno della certezza che i dati di click provengano da una base utenti diversificata e organica.
Da dove arrivano questi dati a Google?
I modelli trapelati fanno riferimento a diverse fonti di dati, in modo esplicito o per forte implicazione:
Log del Google Web Server (GWS) Il modello CrapsDevice fa riferimento esplicito alle voci gwslog (608 e 609). Ogni query di ricerca, ogni click su un risultato, ogni ritorno alla SERP viene registrato dall'infrastruttura dei web server di Google. È questa la fonte di dati principale.
QSessions Citate nella descrizione di mobileSignals e in quella di CrapsDevice. Le QSessions sembrano essere il modello di sessione interno di Google: un record strutturato di tutto ciò che un utente fa durante una sessione di ricerca, dalla query iniziale fino a tutti i click, le riformulazioni e la chiusura finale della sessione.
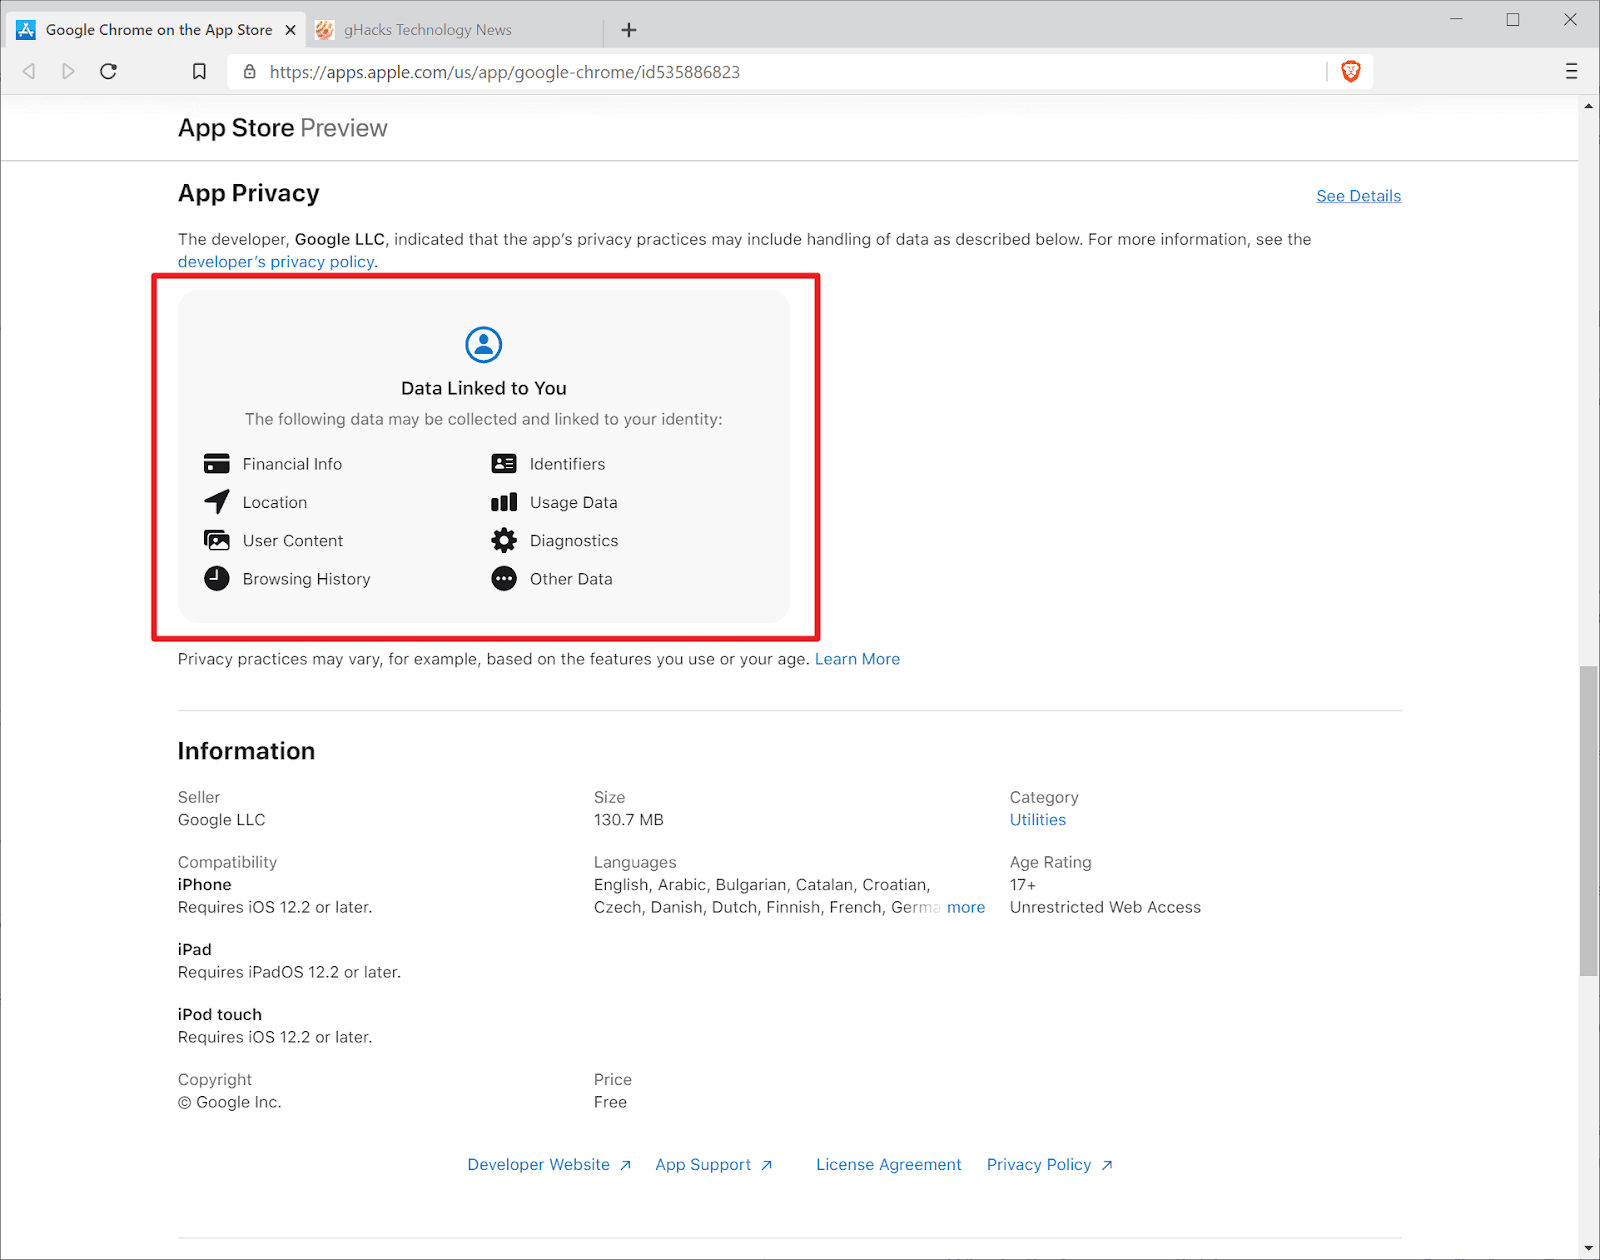
Dati Chrome Non nominati esplicitamente in questi sei modelli, ma le prove emerse dal processo antitrust e il leak nel suo complesso contengono molteplici riferimenti a dati di provenienza Chrome che alimentano NavBoost. Il concetto di click "unsquashed" è stato collegato alla capacità di Chrome di fornire un'identificazione dell'utente ad alta affidabilità.
Cronologia dei cookie Citata nel resoconto di Rand Fishkin sulla fonte che ha fornito i documenti trapelati. I cookie garantiscono la continuità di sessione e, per gli utenti loggati, la persistenza dell'identità tra sessioni diverse.
Dati sugli indirizzi IP Esplicitamente presenti in CrapsData tramite packedIpAddress e unscaledIpPriorBadFraction. Google mantiene uno scoring reputazionale a livello di IP che confluisce direttamente nella valutazione dei segnali di click.
Ipotetico ma probabile: dati da Android e dall'app Google Google Search su Android e l'app Google su iOS producono le stesse voci di log GWS del Chrome desktop. Con il mobile che oggi rappresenta la maggioranza del traffico di ricerca, sono verosimilmente contributori significativi ai dati di mobileSignals e uxInterface.
La finestra mobile di 13 mesi
Confermato durante il processo antitrust: NavBoost opera su una finestra mobile di 13 mesi di dati sui click. Prima del 2017 circa, la finestra era di 18 mesi - lo trovo strano, non so perché non l'abbiano allineata ai 16 mesi di dati di GSC.
Questo ha implicazioni pratiche dirette:
I contenuti nuovi non hanno alcun segnale NavBoost. Devono guadagnarsi i primi posizionamenti attraverso altri segnali (pertinenza tematica, link, freschezza) prima di poter iniziare ad accumulare dati sui click.
I contenuti in calo non perdono il segnale NavBoost da un giorno all'altro. Una pagina che era forte sei mesi fa ha ancora quei dati nella finestra. Ma con il passare dei mesi, man mano che i dati più recenti mostrano un engagement in calo, il segnale si indebolisce.
I contenuti stagionali traggono vantaggio dalla finestra di 13 mesi. Una guida ai regali di Natale pubblicata a novembre avrà ancora i suoi forti dati di click di dicembre nella finestra il novembre successivo, con un vantaggio di partenza per l'anno seguente.
Contenuti recuperati: se sistemi una pagina pessima e gli utenti iniziano a interagire positivamente, i vecchi dati di click negativi non svaniscono subito. In sostanza stai diluendo 10 mesi di dati negativi con 3 mesi di dati positivi. L'inversione di tendenza è graduale, non istantanea.
NavBoost come sistema di re-ranking, non di retrieval
Pandu Nayak ha dichiarato durante il processo: "Ricordate, NavBoost si ottiene solo dopo che i documenti sono stati recuperati."
È una distinzione essenziale. NavBoost non decide quali pagine entrano nell'insieme dei candidati per una query. Di questo si occupano sistemi a monte come Mustang (il motore di retrieval principale). NavBoost opera a valle, aggiustando l'ordine delle pagine già giudicate pertinenti da altri segnali.
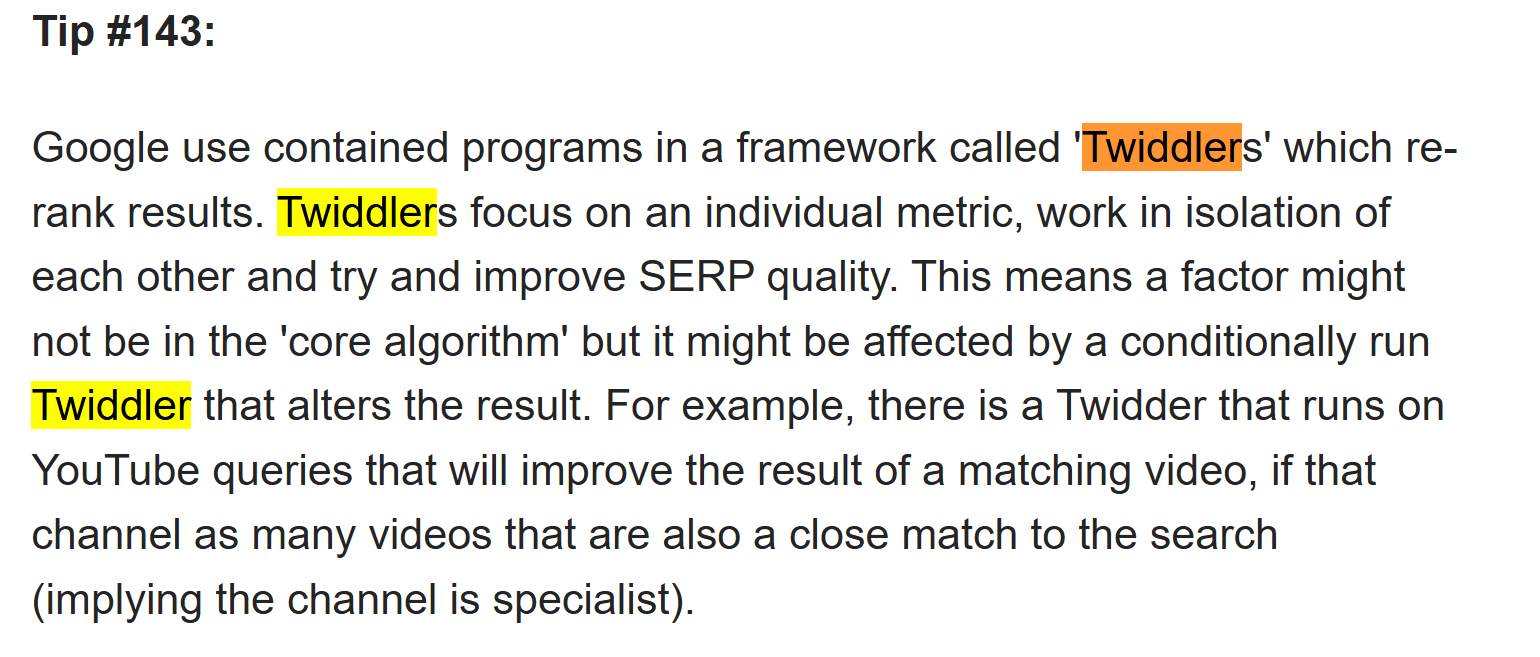
Nell'architettura di Google, NavBoost funziona come un "Twiddler": un sistema che riordina un insieme di documenti candidati già filtrato. Altri Twiddler confermati includono gli aggiustamenti di freschezza e i sistemi di quality boost.
Un mio caro amico nel settore SEO, "Mark Williams Cook", ha una pagina con 500 consigli SEO non richiesti - lì, dal TIP 143 in poi, parla dei Twiddler.
Cosa significa in pratica: non puoi posizionarti solo grazie ai segnali di click. Se la tua pagina non ha pertinenza tematica, non ha link e non ha altri segnali di qualità, non entrerà nemmeno nell'insieme dei candidati e NavBoost non la vedrà mai. Ma una volta che sei nell'insieme dei candidati - una volta che sei in prima o seconda pagina - NavBoost diventa probabilmente la forza più potente nel determinare se ci rimani, se sali o se vieni spinto giù.
Casi limite e scenari
Il vantaggio delle query di brand
Considera una query come "Sage accounting software".Sage.com ha quasi certamente un profilo NavBoost estremamente positivo per questa query: quasi ogni utente che la cerca sta cercando Sage e clicca su sage.com. Il rapporto lastLongestClicks è probabilmente vicino a 1.0. Il rapporto badClicks è probabilmente vicino a zero.
Ora considera un concorrente che prova a posizionarsi per questa query. Anche con una SEO on-page perfetta e link forti, combatte una battaglia in salita contro dati NavBoost che mostrano come gli utenti preferiscano in modo schiacciante cliccare il risultato di Sage. Questo è il fossato di brand creato da NavBoost: è quasi impossibile superarlo sulle query branded senza una notevole brand awareness propria.
Il problema del ristorante locale
Apre un nuovo ristorante a Nottingham. Ha zero dati NavBoost. Si posiziona in base alla freschezza, ai segnali locali e a qualunque piattaforma di recensioni lo abbia intercettato. Gli utenti iniziano a cliccarlo per curiosità, ma il cibo delude. I visitatori fanno pogo-sticking tornando ai risultati. I bad click si accumulano a livello di URL e a livello di locale metropolitano (il locationId di FeatureCrapsData per Nottingham).
Sei mesi dopo il ristorante cambia proprietà e diventa eccellente. Ma la finestra NavBoost contiene ancora cinque mesi di dati di click negativi contro un mese di dati in miglioramento. Il recupero è lento e potrebbe richiedere l'intero arco dei 13 mesi perché i vecchi dati escano dalla finestra, a meno che il miglioramento non sia così netto da spostare in modo significativo i rapporti compressi (squashed).
Il sito con contenuti sottili e titoli brillanti
Un sito produce centinaia di pagine con title tag e meta description eccezionali, capaci di suscitare curiosità. I click sono alti. Ma il contenuto è sottile. Gli utenti arrivano, si accorgono che non c'è sostanza e rimbalzano. I click sono alti, ma i goodClicks sono bassi. I badClicks sono alti. I lastLongestClicks sono vicini a zero perché gli utenti finiscono sempre per cliccare un risultato diverso.
NavBoost non premia solo i click: premia la risoluzione. Questo sito accumulerebbe un profilo NavBoost devastante: molte impressioni, click discreti, pessimo rapporto good/bad, lastLongestClicks praticamente nulli. L'aggregazione a livello patternLevel diffonderebbe questo segnale negativo su tutto il dominio.
La pagina specialistica a basso traffico
Una pagina tecnica altamente specialistica riceve 50 impressioni al mese. Di queste, 15 generano un click, e 14 sono good click con tempi di permanenza lunghi. Il voterTokenCount mostra 14 utenti distinti. Il rapporto di good click è eccezionale, ma i numeri assoluti sono minuscoli.
È qui che lo squashing gioca a favore della pagina. I dati compressi normalizzano i volumi assoluti, lasciando emergere il rapporto. Ma il basso numero di voter token potrebbe attivare il filtro per la privacy, sopprimendo del tutto il segnale NavBoost finché più utenti non contribuiscono con dati. È una tensione reale nel sistema: i contenuti specialistici a basso traffico potrebbero dover raggiungere una soglia minima di utenti prima che NavBoost li aiuti.
Incoerenza cross-device
Una pagina si visualizza benissimo su desktop ma è rotta su mobile. Gli utenti desktop (uxInterface: 1) generano forti segnali di good click. Gli utenti mobile (uxInterface: 2) fanno continuamente pogo-sticking, generando bad click. Poiché NavBoost mantiene segnali mobile separati tramite mobileSignals e la segmentazione per dispositivo in FeatureCrapsData, la pagina potrebbe posizionarsi bene su desktop e male su mobile contemporaneamente, per la stessa query.
Non è teoria. Molti SEO hanno osservato posizionamenti diversi su mobile e desktop per la stessa pagina e la stessa query, ed è molto probabile che la segmentazione dei segnali per dispositivo di NavBoost sia uno dei meccanismi in gioco.
Cosa significa NavBoost per la tua strategia SEO
Il leak non ci dice i pesi. Non ci dice le soglie. Ma ci dice l'architettura, e l'architettura rivela cosa conta per Google:
Soddisfazione più che attrazione: significa che i good click e i lastLongestClicks vengono tracciati separatamente dai click grezzi. Ottenere il click è solo metà dell'equazione. Trattenere l'utente - essere il risultato che chiude la sessione di ricerca - è ciò che NavBoost premia davvero.
Costanza più che picchi: significa che il modello StatsWithWeightsProto, con le sue distribuzioni per percentili e i calcoli di deviazione standard, ci dice che a Google interessa quanto è costante la qualità dei click su tutto il sito, non solo sulle pagine migliori.
Diversità più che volume, significa che: il voterTokenCount e i sistemi di bitmap dei voter token confermano che mille click da cinque utenti valgono meno di cento click da novanta utenti. Il segnale è l'engagement organico e diversificato. Il volume artificiale è un campanello d'allarme.
Contesto più che aggregazione: significa che con la segmentazione per paese, per lingua, per locationId a livello metropolitano, per dispositivo e per browser tier, NavBoost non valuta la tua pagina nel vuoto. La valuta per query, per locale, per dispositivo, per browser tier. I tuoi posizionamenti sono il prodotto di decine di valutazioni NavBoost sovrapposte, ciascuna basata su una fetta diversa dei tuoi dati di click.
Il sistema la cui esistenza Google ha negato per anni è, secondo la stessa valutazione interna di Google, uno dei segnali di ranking più potenti mai costruiti. Il leak del Content Warehouse ci dà lo schema. Il processo antitrust ci dà la conferma. Cosa farne, dipende da noi.
Una cosa che noi SEO possiamo fare è ipotizzare, discutere e testare. Da quando il Content Warehouse è trapelato sono rimasto affascinato da quanto ci fosse dentro - ho clonato una copia del repository GITHUB originale pubblicato prima che venisse rimosso: al suo interno si vedono moltissimi altri fattori. In questo articolo abbiamo trattato NAVBOOST perché gioca un ruolo così intrinseco nella SEO, ma c'è molto altro da analizzare, dai rich snippet di qualità a SpamBrain.
Dai un'occhiata al SEO Datawarehouse qui - elenca tutti i 14.027 attributi (non tutti sono legati alla SEO) ma l'ho strutturato in modo che tu possa vedere quali elementi hanno una PROBABILITÀ PIÙ ALTA di essere usati nella ponderazione del ranking.
Altre riflessioni finali:
MA DANIEL, COME PUÒ IL COMPORTAMENTO DELL'UTENTE ESSERE UN FATTORE DI RANKING SE NON TI POSIZIONI ABBASTANZA IN ALTO DA OTTENERE CLIC DA VALUTARE?
Beh, il posizionamento su Google è dettato da più algoritmi: molto spesso i siti che non sono ANCORA impattati da NAVBOOST hanno l'opportunità di essere valutati una volta soddisfatti altri criteri.
In generale - se i siti sono validi dal punto di vista tecnico, nel senso che Google riesce a fare crawling, rendering, accedere e indicizzare i contenuti - finché il contenuto è buono / topicamente allineato e finché ci sono altri segnali che indicano fiducia e qualità, Google permetterà a siti nuovi o con dati limitati / ridotti di posizionarsi. NAVBOOST non deve essere applicato a tutto, ma solo ai siti dove i clic diventano rilevanti in base alla posizione.
La mia opinione è che i siti abbiano l'opportunità di dimostrare il proprio valore - ed è per questo che i core update muovono le SERP: consentono ad altri contenuti di avere una possibilità di posizionarsi, e solo i contenuti che dimostrano VERAMENTE un'interazione positiva degli utenti in modo costante tendono a mantenere la posizione attraverso i core update.
Ma, come sappiamo, nulla in Google è mai davvero coerente.
Tutti i nomi dei modelli, i nomi degli attributi e gli estratti della documentazione citati in questo articolo provengono dalla documentazione della Google Content Warehouse API trapelata a maggio 2024, così come catalogata suseo-datawarehouse.com. Le testimonianze del processo antitrust provengono dagli atti pubblici del caso United States of America v. Google LLC. Dove le interpretazioni sono speculative, ciò è chiaramente indicato.
Amo la SEO e amo le speculazioni, le discussioni e i test SEO, ma NULLA in questo articolo è ciò che definirei definitivo: ho aggiunto le mie riflessioni speculative - anche se so con certezza che!
Chrome è un cavallo di Troia per i dati e il comportamento di clic è uno dei modi migliori per capire se qualcosa è buono o cattivo! I comportamenti di clic contano davvero.

Fondatore, SEO Stack
Daniel è il fondatore di SEO Stack. Ha trascorso oltre due decenni lavorando su SEO tecnica e dati di ricerca, e ha creato SEO Stack dopo essersi scontrato, una volta di troppo, con i soliti limiti di Search Console nel lavoro con i clienti.
Daniel ha una vasta esperienza in ambito SEO: ha costruito agenzie SEO, attività di audit e una consulenza di grande successo. Nel tempo libero, si diverte a condurre esperimenti SEO e a condividerne i risultati.
Pubblicato 29 marzo 2026


