NavBoost al descubierto: qué nos dice realmente la filtración del Google Content Warehouse sobre el ranking basado en clics
Google se pasó años diciéndole al sector del SEO que los clics no importaban. Que el dwell time era irrelevante. Que el CTR era ruido. De hecho, durante muchos años yo mismo lo grité en LinkedIn, muchas…
Google se pasó años diciéndole a la industria SEO que los clics no importaban. Que el dwell time era irrelevante. Que el CTR era ruido. De hecho, durante muchos años grité esto en LinkedIn, y muchos me llamaron conspiranoico.
«Dan, Google no usa datos de comportamiento para los rankings» o «¿qué pasa si un sitio no tiene configurado GSC o Google Analytics?».
Pero la realidad es que yo sabía que Google estaba usando esos datos. Hice muchísimos tests SEO: compré un par de dominios y probé la manipulación de clics usando CTR Booster + proxies residenciales con user agents aleatorizados y distintos comportamientos de página / interacción.
Una vez posicioné una web de eCommerce de prueba www.bulkco.co.uk con ese tipo de tests: rankeó durante más de 3 años para miles de keywords con un dominio débil.
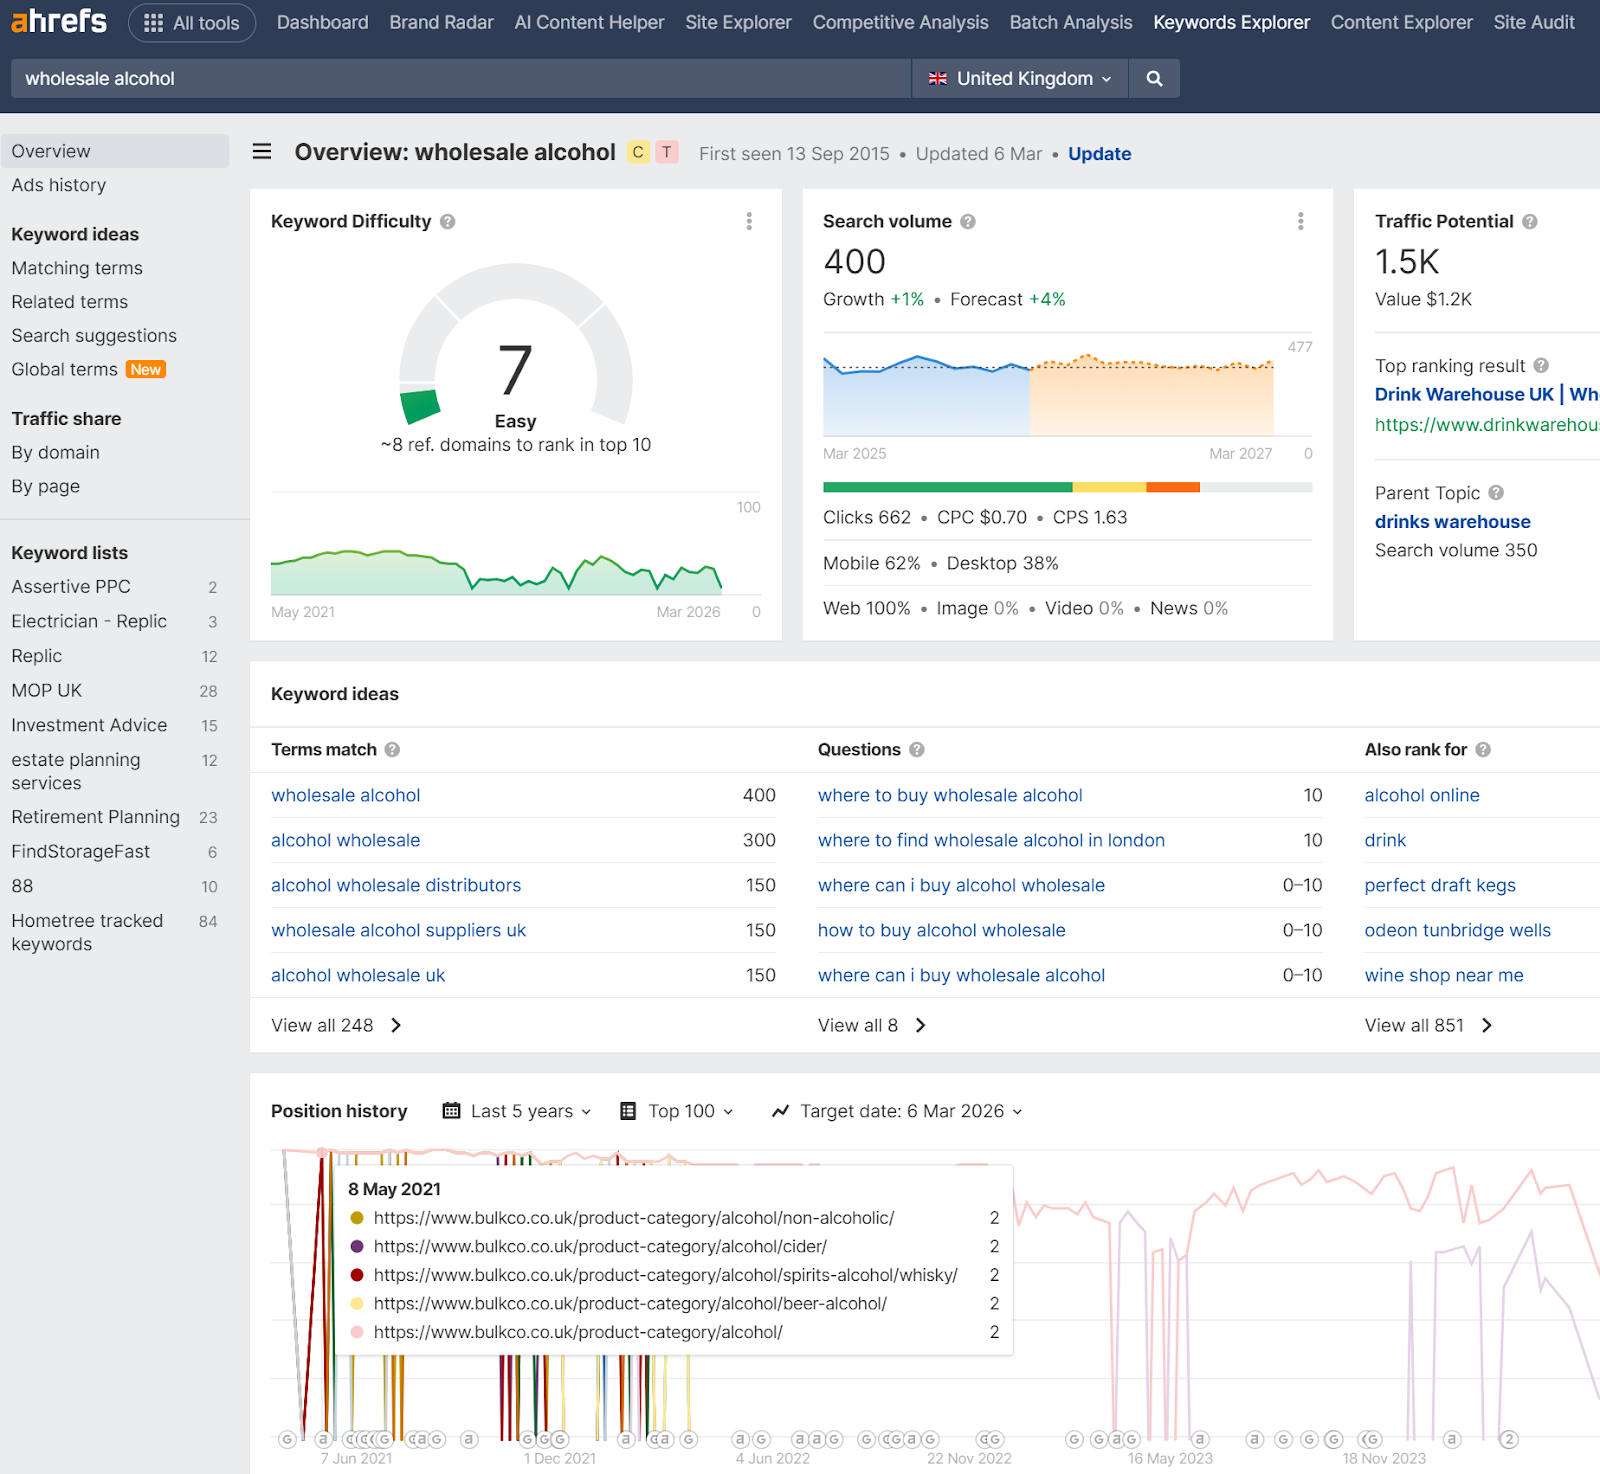
Sabía que algo pasaba y, gracias a una filtración y a los juicios posteriores del DOJ, ahora sabemos que Google sí usa el comportamiento: de ahí, Navboost.
Así que la documentación de la Content Warehouse API se filtró en mayo de 2024, y ahí mismo, en el esquema, referenciado 84 veces a lo largo de seis modelos dedicados, estaba NavBoost. Un sistema que registra buenos clics, malos clics, clics largos, impresiones, tipos de dispositivo, segmentación geográfica, puntuaciones de fraude basadas en IP y tokens de votante que representan a usuarios individuales: no tardamos mucho en empezar a atar cabos.
Meses antes, durante el juicio antimonopolio del DOJ en Estados Unidos, el vicepresidente de Google Pandu Nayak ya había confirmado bajo juramento que NavBoost era «una de las señales importantes» que usa Google. Los correos internos presentados como prueba iban más allá. El vicepresidente de Google Alexander Grushetsky escribió en 2019 que NavBoost por sí solo era probablemente más potente que el resto del ranking combinado en métricas de clic y precisión, y que los ingenieros ajenos al equipo de NavBoost no estaban contentos con la influencia que tenía.
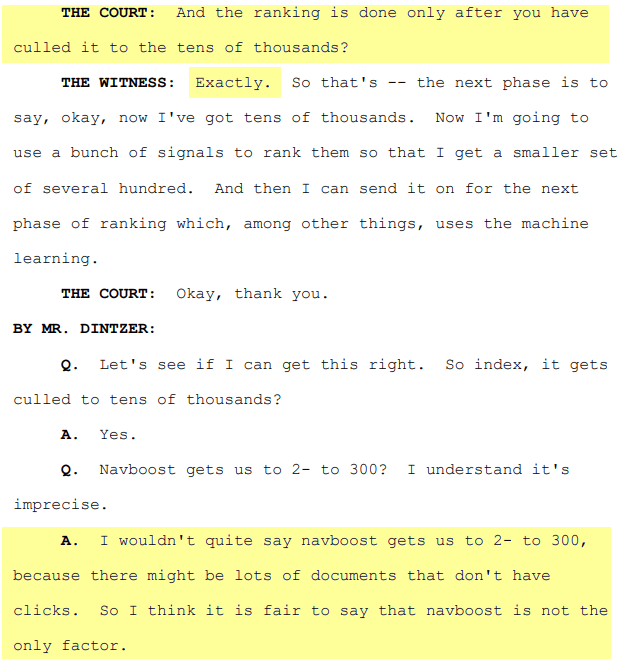
Más información leyendo el PDF original alojado por el DOJ aquí
Este artículo repasa cada modelo de la categoría NavBoost de la documentación filtrada de Content Warehouse. Donde el esquema nos dice algo concreto, lo diremos claramente. Donde los nombres de campo y las estructuras sugieren una interpretación probable pero dejan margen a la ambigüedad, lo indicaremos y ofreceremos una teoría razonada. El objetivo es darte una comprensión técnica real de lo que se filtró, no un resumen reempaquetado con las incógnitas tapadas.
Tengo que dejarlo claro: como SEO, mi trabajo es aportar siempre insights útiles e información factualmente correcta en la medida de lo posible. No sé CÓMO se aplican estos modelos ni en qué grado, nadie lo sabe; PERO podemos inferir / especular. En algunos casos es bastante evidente cómo se recopilan / utilizan estos datos, pero ¿en qué grado?
Nadie lo sabe.
Bien, vamos allá..........
Los seis modelos de NavBoost
La filtración expuso seis modelos de protocol buffer bajo el namespace QualityNavboost. Cada uno recibió una valoración de 10/10 en impacto SEO por parte de los analistas que catalogaron la filtración. Son:
QualityNavboostCrapsCrapsClickSignals El contenedor principal de señales de clic (10 atributos)
QualityNavboostCrapsCrapsData El registro maestro de datos que vincula clics con URLs, consultas, dispositivos y ubicaciones (22 atributos)
QualityNavboostCrapsCrapsDevice Clasificación de dispositivo y navegador (3 atributos)
QualityNavboostCrapsFeatureCrapsData Segmentación de señales por locale y por feature (6 atributos)
QualityNavboostCrapsStatsWithWeightsProto Datos de distribución estadística para la agregación a nivel de patrón (15 atributos)
QualityNavboostGlueVoterTokenBitmapMessage Deduplicación de usuarios y filtrado de privacidad (2 atributos)
Antes de entrar en cada uno, el nombre merece una nota. «CRAPS» parece ser un acrónimo interno de Google que probablemente significa algo parecido a Click and Results Prediction System, aunque no se ha confirmado oficialmente. Si además es un guiño pícaro al juego de dados (dada la naturaleza probabilística de predecir la satisfacción del usuario a partir de los patrones de clic) o a los años en que Google calificó públicamente las teorías basadas en clics de «basura inventada», queda como ejercicio para el lector.
Y no, no confundamos Craps con humor escatológico ni con un juego de casino:
Modelo 1: CrapsClickSignals, la taxonomía básica del clic
Este es el modelo fundacional. Contiene diez atributos de tipo float, y su descripción en la documentación filtrada es breve pero reveladora: «Click / impression signals for craps».
Cada float aquí representa un recuento o un ratio. No son flags binarios: son valores continuos, lo que significa que Google casi con total seguridad trabaja con números ponderados y normalizados en lugar de enteros en bruto; pero, de nuevo, es especulativo y NO está confirmado (quería dejarlo claro).
Los atributos
clicks El recuento total de clics de un documento dado frente a una consulta (o clúster de consultas) dada. Esta es la línea base. Todo lo demás en este modelo es un refinamiento o un subconjunto de este número. En esencia, tiene que producirse un clic para que se pueda hacer una determinación.
Así que, claramente, habrá clics que resulten en un usuario satisfecho o insatisfecho. Usemos a Hide the Pain Harold (¿a quién no le gusta como meme?).
goodClicks Clics que Google considera que representan un resultado satisfactorio para el usuario. La filtración no define los criterios exactos, pero a partir del testimonio antimonopolio y de años de análisis del pogo-sticking dentro de la comunidad SEO, un buen clic casi con seguridad implica que el usuario hace clic en un resultado, permanece en esa página un tiempo significativo y no vuelve a la SERP para hacer clic en otra cosa. Dicho de otro modo: el clic resolvió la consulta.
Hide the Pain Harold tras visitar una web que le engañó o no le ofreció una buena experiencia de usuario:
badClicks Lo contrario. Clics en los que el usuario volvió rápidamente a los resultados de búsqueda. Esta es la señal de pogo-sticking que Google pasó años diciendo que no existía como factor de ranking. El esquema filtrado confirma que es un atributo con nombre, almacenado y con valor float, situado dentro de un modelo con impacto SEO de 10/10.
Si te preguntas qué es el pogo, se refiere al «pogo sticking», cuando pasas de un estado a otro rápidamente, es decir, visitas una web y te vas enseguida. Por cierto, Google no necesita que haya analytics instalado para saber cuánto duró la interacción: ¿recuerdas ese pequeño navegador llamado Chrome? Pues sí, ¡también es un caballo de Troya para datos de comportamiento!
Echa un vistazo a este artículo sobre el lado oscuro de Google Chrome y cómo tu navegador te traiciona
lastLongestClicks Aquí es donde se pone interesante. La documentación del modelo padre CrapsData lo describe como «el número de clics que fueron los últimos y los más largos en consultas de usuario relacionadas». Esto no va solo de cuánto tiempo permaneció alguien en tu página de forma aislada. Va de si tu resultado fue aquel en el que el usuario se quedó: el clic final de su sesión de búsqueda, y aquel en el que pasó más tiempo. Si un usuario hace clic en el Resultado A, rebota, hace clic en el Resultado B, rebota, y luego hace clic en el Resultado C y se queda cuatro minutos antes de cerrar la pestaña, el Resultado C se lleva el crédito del lastLongestClick.
Por eso creo que Google mezcla las SERPs, especialmente cuando la intención de la consulta se vuelve más «vaga»: es decir, si buscas «coche», ¿qué estás especificando que quieres? ¿quieres saber qué es un coche? ¿quieres comprar uno? ¿quieres saber qué marcas de coches existen?
Las SERPs VARIADAS le dan a Google un abanico más amplio de evaluación: sirve distintas intenciones en una SERP, acumula los datos de clic con el tiempo, y el comportamiento agregado a lo largo del tiempo ayuda a Google a entender mejor qué quiere «la mayoría».
Creo que por eso Google a menudo MEZCLABA resultados distintos, y también por eso, durante muchos años, encontrábamos sitios que simplemente no encajaban con el perfil de un sitio que mereciera posicionar ¡y aun así posicionaban!
Durante años, vatcalculator.co.uk, que era un EMD, estuvo en el número 1 para «vat calculator»; de hecho, posiciona desde 2009 y sigue siendo #1 a día de hoy. Era un EMD sin optimizar, sin HTTPS, no adaptado a móvil: la definición exacta de un sitio que se construyó, se desplegó ¡y se abandonó!
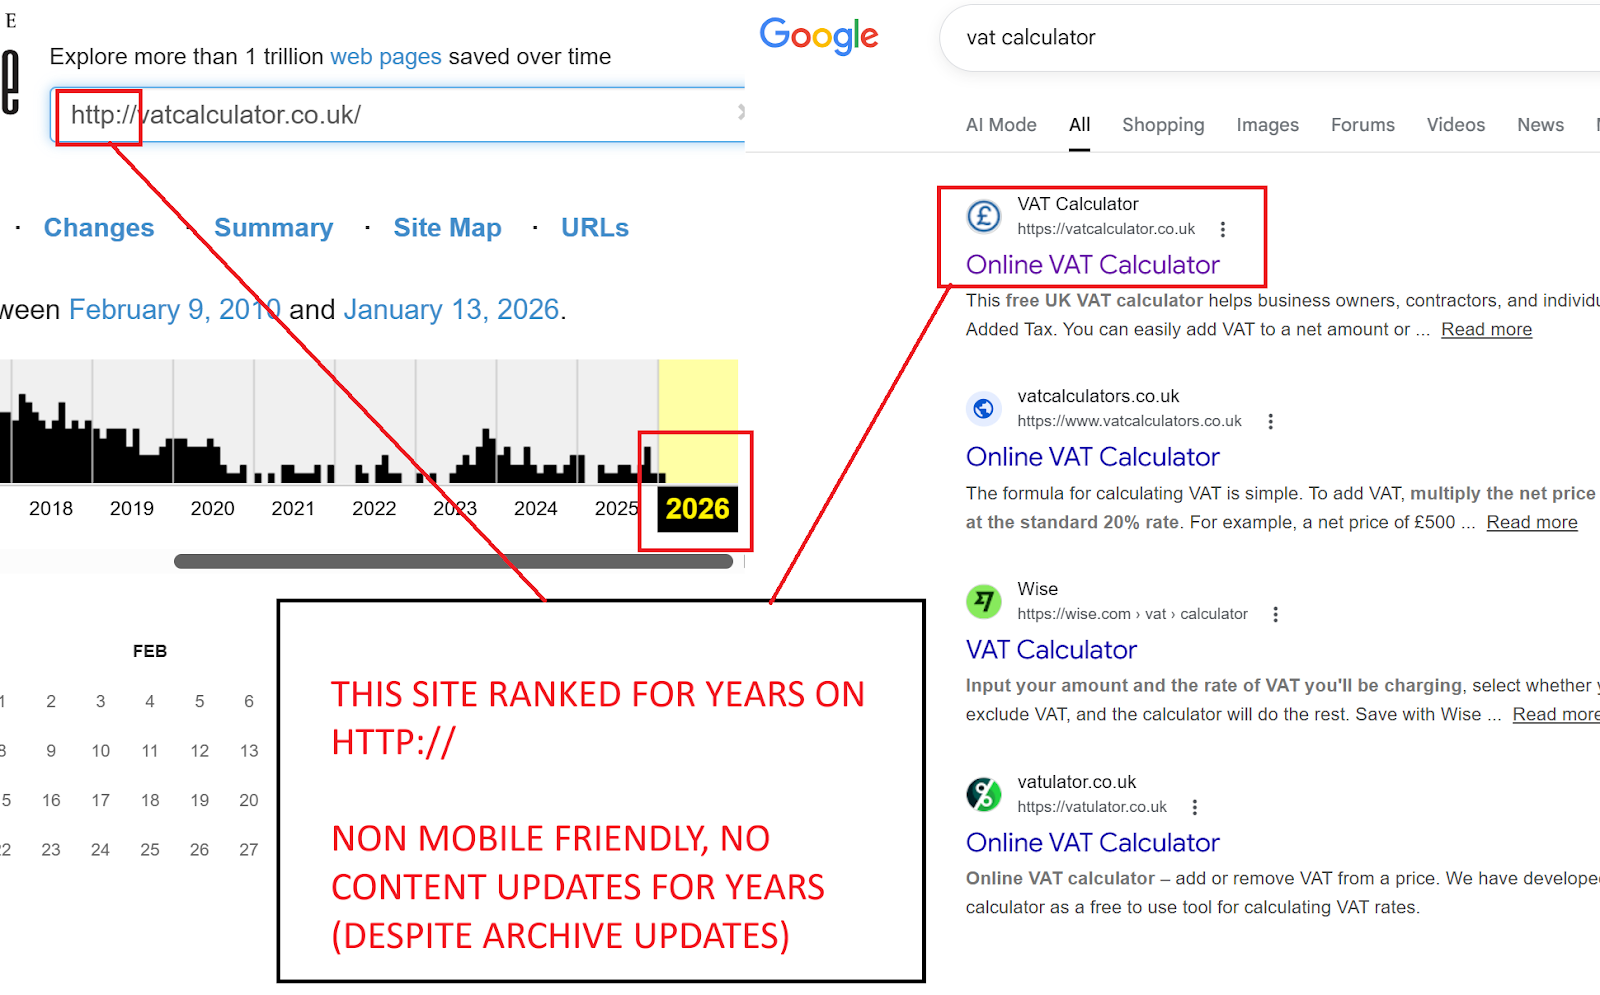
¿Por qué mantuvo su posición durante TANTÍSIMOS años?
Porque hacía una sola cosa y la hacía bien: daba a los usuarios EXACTAMENTE lo que querían, una calculadora de IVA sencilla y sin complicaciones:
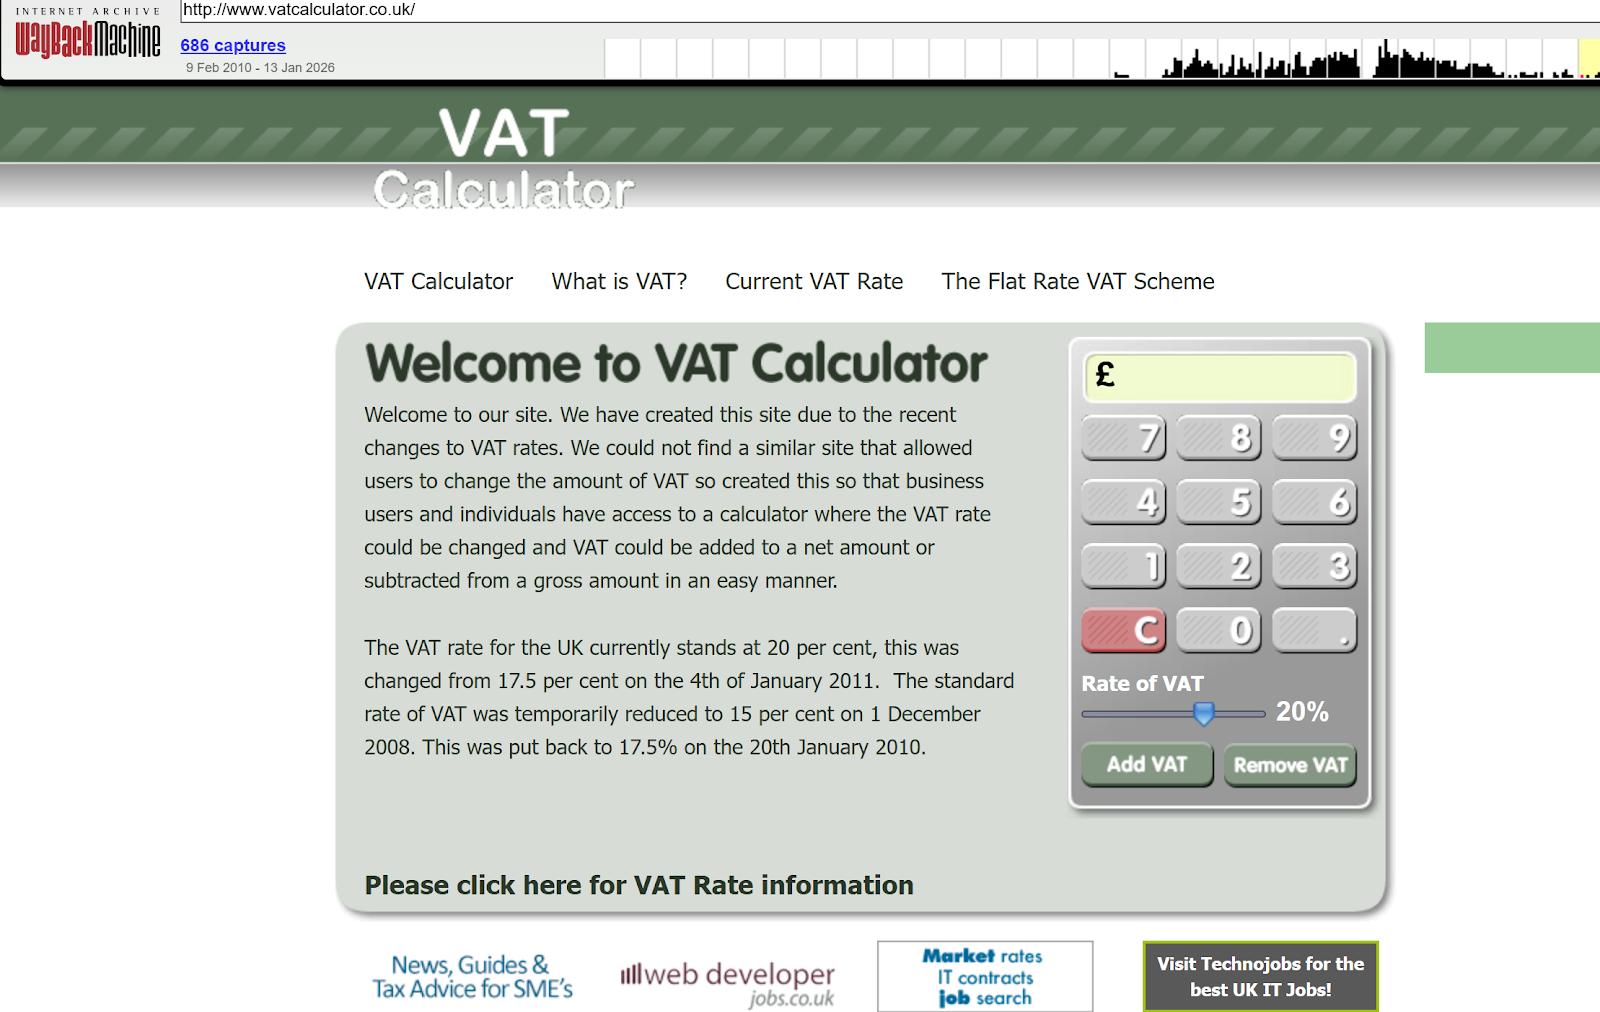
Posicionaba porque los usuarios USABAN la calculadora y terminaban la sesión.
Buenos clics.
Ahora, sigamos analizando otros tipos de clic:
Interpretación especulativa: Probablemente sea la señal más valiosa de todo el modelo. Captura tanto la satisfacción (dwell time largo) como la finalidad (último clic). Una página que obtiene de forma consistente lastLongestClicks en muchas sesiones es una página que demostrablemente resuelve la consulta. Si Google pondera estas señales, esta seguramente tiene el mayor peso.
impressions El número de veces que un documento se mostró en los resultados de búsqueda para una consulta. Es el denominador de cualquier cálculo del tipo CTR. Sin impresiones, los recuentos de clics no significan nada: una página con 10 clics de 10 impresiones se comporta de forma muy distinta a una con 10 clics de 10.000 impresiones.
Esto tiene además otra capa detrás —la dejaré para otro artículo—, pero las impresiones y el CTR son clave aquí: el propio Google usa datos de CTR y, como sabemos, las AI overviews han reducido significativamente las tasas de clic incluso en sitios que posicionaban de forma consistente; el desplazamiento provocado por las AIOs ha distorsionado el CTR de forma notable.
absoluteImpressions La documentación es concreta con este campo: "Thus far this field is only used for host level unsquashed impressions." Aquí importan dos cosas. Primero, opera a nivel de host, no de URL. Google mide con qué frecuencia aparece tu dominio entero en los resultados, no solo una página concreta. Segundo, es explícitamente unsquashed; más abajo explico qué significa eso.
unicornClicks La documentación dice: "The subset of clicks that are associated with an event from a Unicorn user." Es uno de los atributos más crípticos de la filtración. No hay ninguna definición adicional de qué constituye un "Unicorn user" en la documentación filtrada públicamente, así que tampoco voy a especular aquí.
Interpretación especulativa: En mi opinión personal, la explicación más probable es que Unicorn se refiera a usuarios de Google autenticados, con sesión iniciada: personas cuya identidad e historial de navegación Google puede verificar con alta confianza. Sus clics tendrían más peso porque Google puede validar que son humanos reales y distintos, con patrones de navegación establecidos, y no bots, granjas de clics o intentos de manipulación enmascarados con VPN. Una teoría alternativa es que los Unicorn users sean específicamente usuarios de Chrome, dada la profunda integración de Chrome con la infraestructura de recopilación de datos de Google. En cualquier caso, la implicación es clara: no todos los clics son iguales, y los clics de usuarios que Google puede identificar con confianza parecen registrarse y valorarse por separado.
Sin duda hay mucha mecánica bajo Chrome, junto con el spoofing de user-agent y las herramientas de granjas de clics / manipulación de clics diseñadas para influir en el ranking imitando una sesión de usuario real; sin embargo, en la mayoría de los casos la manipulación de clics procede de navegadores sin sesión iniciada.
unsquashedClicks, unsquashedImpressions, unsquashedLastLongestClicks La documentación señala que estos campos se están migrando a un nuevo formato en el que los datos se almacenarán en instancias separadas squashed y unsquashed de CrapsClickSignals. La existencia de ambas versiones nos dice algo crítico sobre cómo procesa Google estos datos.
Squashed frente a unsquashed: cómo normaliza Google los datos de clics
Este es uno de los detalles arquitectónicos más importantes de toda la filtración.
El "squashing" es una función de normalización. Una patente de Google sobre la puntuación de resultados de búsqueda local (US8046371B2) describe el squashing como una función que evita que una señal grande domine a las demás. En términos prácticos, una función de squashing comprime el rango de valores —normalmente mediante una curva logarítmica, una sigmoide o un techo fijo— de modo que la diferencia entre 10 clics y 100 clics es significativa, pero la diferencia entre 10.000 clics y 100.000 clics queda amortiguada.
Por qué importa: Sin squashing, las páginas con mucho tráfico tendrían una ventaja insuperable. Un artículo de la BBC con 50.000 clics eclipsaría a un blog especializado con 500 clics, aunque el blog especializado tuviera una proporción mucho mejor de buenos clics frente a malos. El squashing iguala el terreno comprimiendo las cifras absolutas y dejando que hablen las proporciones.
Los valores unsquashed, por tanto, son las cifras brutas antes de aplicar esa normalización. Google guarda ambas versiones porque sirven para fines distintos:
Los datos squashed alimentan el algoritmo de ranking, donde la calidad proporcional importa más que el volumen absoluto
Los datos unsquashed probablemente alimentan la detección antispam, donde el volumen absoluto y los picos anómalos son precisamente lo que buscas
Escenario práctico: Imagina la web de un despacho de abogados local en Bedford que normalmente recibe 30 impresiones y 8 clics al mes para "family solicitor Bedford". Una semana, de repente recibe 400 clics de 500 impresiones. Los datos squashed amortiguan esa anomalía para que no catapulte al sitio en las clasificaciones. Los datos unsquashed conservan el pico bruto para que un sistema de detección de spam (potencialmente los sistemas de IP prior o voter token descritos en otras partes de la filtración) pueda marcarlo para su investigación.
Modelo 2: CrapsData, el registro maestro
Si CrapsClickSignals es el vocabulario, CrapsData es la frase. Este modelo de 22 atributos une todas las señales de clic con contexto: la consulta, la URL, el país, el dispositivo, el idioma y varias capas de agregación y segmentación.
Vinculación de consulta y URL
query (string) La consulta de búsqueda real a la que se refieren estos datos. NavBoost no se limita a registrar "esta página recibió X clics". Registra "esta página recibió X clics para esta consulta concreta". Son datos de pares consulta-documento, lo que significa que NavBoost puede diferenciar entre una página que funciona bien para una consulta y mal para otra.
url (string) La URL concreta que se está registrando.
patternLevel (integer) Revela que Google no solo registra URLs individuales. Agrega datos de clics en varios niveles de abstracción de URL:
Nivel 0: la URL exacta (p. ej., https://example.com/services/seo-audit)
Nivel 1: el patrón de host (p. ej., p://example.com)
Nivel 2: el patrón de dominio (p. ej., p://example.com reducido a la raíz)
La documentación da un ejemplo concreto: para http://abc.def.ghi/xyz.html, el nivel 0 es la URL completa, el nivel 1 es p://abc.def.ghi y el nivel 2 es p://def.ghi.
Por qué importa: Esto confirma que NavBoost opera simultáneamente a nivel de subdominio, dominio raíz y URL. Tu página individual puede tener datos de clic flojos, pero si tu dominio en conjunto obtiene buenos clics de forma consistente en cientos de URLs, esa señal a nivel de patrón probablemente aporte un impulso. A la inversa, un dominio con proporciones de badClicks consistentemente altas probablemente reciba una penalización a nivel de patrón incluso en páginas nuevas que aún no han acumulado su propio historial de clics.
Escenario especulativo: Mi impresión es que una entrada de blog nueva en un sitio bien establecido, con patrones sólidos de NavBoost a nivel de dominio, podría heredar una "confianza" de base del historial de clics del dominio padre, dándole un arranque más cálido en las clasificaciones que una entrada idéntica en un dominio nuevo sin historial de clics. Esto explicaría por qué los sitios establecidos suelen posicionar contenido nuevo más rápido: no es solo autoridad de dominio en el sentido de enlaces, es calidad de clic acumulada a nivel de patrón.
Segmentación geográfica y por idioma
country (string) Código de país de dos letras en mayúsculas. Ejemplos dados: "US", "FR", "BR".
language (string) Código de idioma. Ejemplos: "en", "fr", "pt-BR".
Esto significa que Google almacena y evalúa las señales de clic por país y por idioma. Una página que consigue excelentes métricas de clic en Alemania podría tener métricas pésimas en Francia. NavBoost puede distinguir entre ambas y ajustar los rankings en consecuencia.
Implicación práctica: si gestionas un sitio multilingüe, tus páginas en inglés y tus páginas en francés están construyendo perfiles de NavBoost separados. Una versión francesa mal traducida de una página en inglés con buen rendimiento no va a aprovecharse de los datos de clic de la versión inglesa. Cada variante de idioma gana (o pierde) sus propias señales de clic.
sliceTag (string) Un campo flexible que se describe como el que permite al pipeline CRAPS "segmentar las señales por diversos atributos como tipo de dispositivo, país, configuración regional, etc.". Es, en esencia, una clave de segmentación comodín. El slice tag puede ser una cadena arbitraria, y las señales se agregan por separado para cada etiqueta junto con la etiqueta vacía por defecto.
Interpretación especulativa: en mi opinión, esto sugiere que Google puede crear segmentos de señal ad-hoc más allá de las divisiones estándar por país/idioma/dispositivo. Durante eventos importantes (elecciones, pandemias, desastres naturales), podrían crear slice tags temporales que ajusten cómo se ponderan las señales de clic para categorías de consulta concretas. Esto encaja con las pruebas del caso antimonopolio que muestran que Google desplegó listas blancas durante la COVID-19 y las elecciones.
Segmentación por dispositivo
device Enlaza con el modelo CrapsDevice (tratado más abajo).
mobileSignals Una instancia dedicada de CrapsClickSignals agregada específicamente a partir de "interfaces móviles de tier 1/2 en QSessions". Google mantiene perfiles de señales de clic completamente separados para los usuarios móviles.
mobileData Marcado como heredado ("DO NOT USE"), sustituido por mobileSignals. El hecho de que Google haya dado de baja y reemplazado este campo nos dice que la arquitectura de señales móviles se ha rediseñado activamente, probablemente para dar soporte a una clasificación de dispositivos móviles más granular.
Instancias squashed y unsquashed
squashed Una instancia completa de CrapsClickSignals que contiene los datos de clic normalizados. La documentación señala que acabará sustituyendo a los campos de nivel superior goodClicks/badClicks/impressions.
unsquashed La instancia en bruto, sin normalizar. Se describe como preparada para "the retuning rollout", lo que sugiere que Google estaba recalibrando activamente cómo interactúan estos dos flujos de datos en el momento en que se generó la documentación.
unsquashedMobileSignals Datos de clic móviles en bruto antes de la normalización.
Antispam y análisis de IP
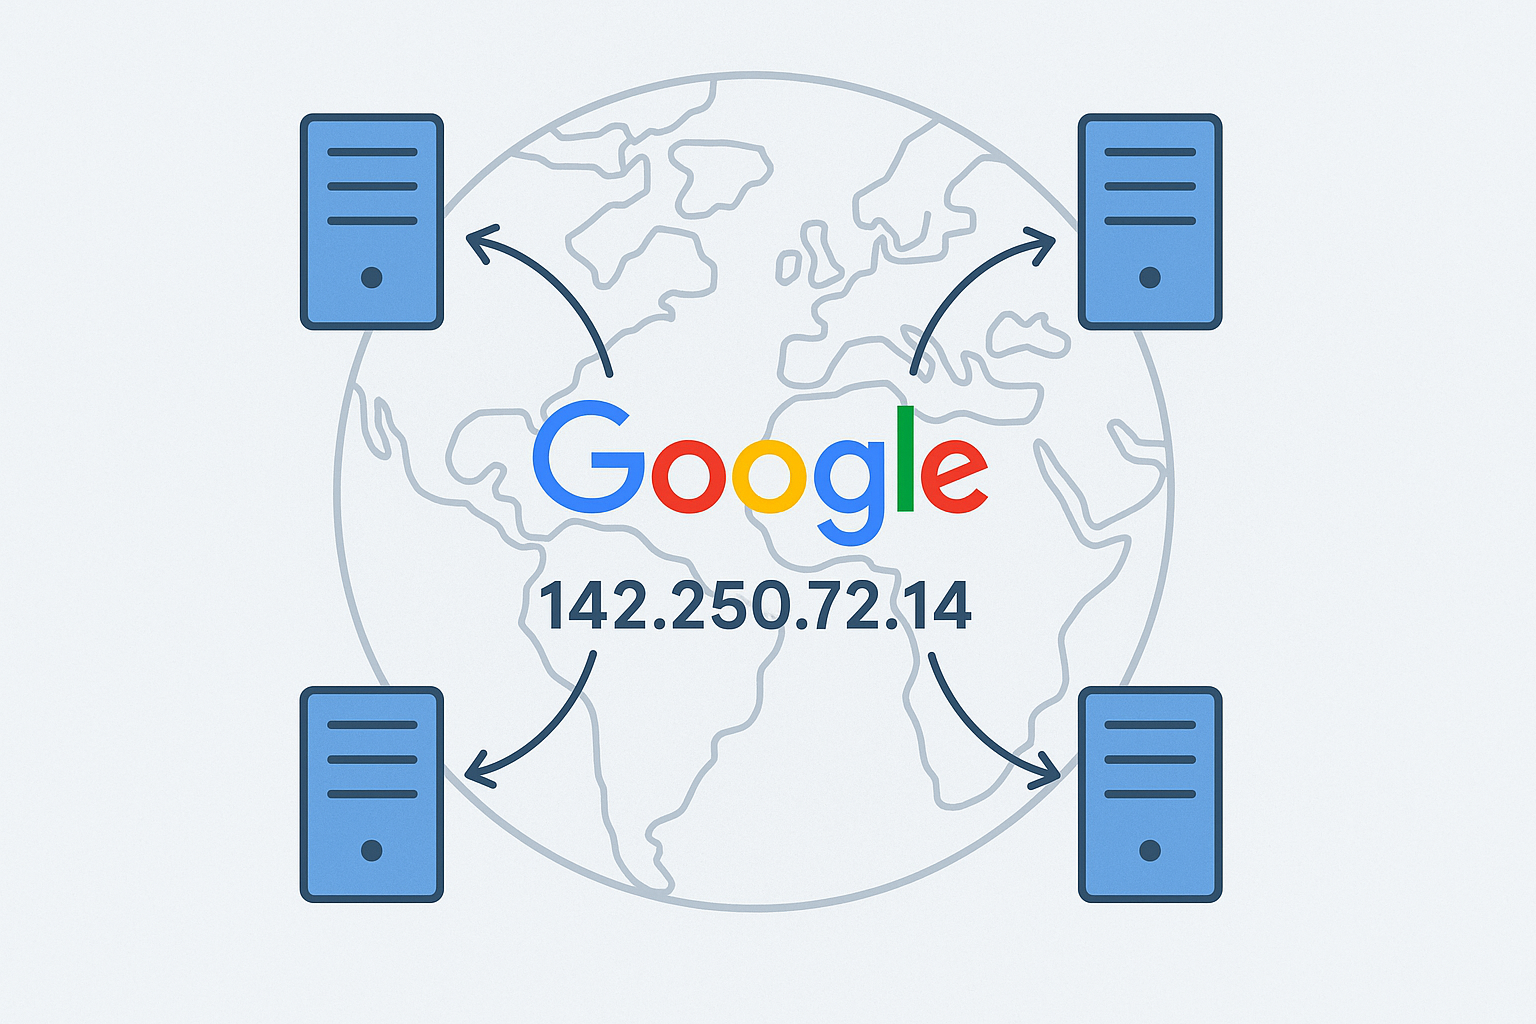
packedIpAddress (string) Una cadena empaquetada en orden de bytes de red utilizada por un sistema llamado CrapsIpPrior. Solo se rellena cuando Google consultó la fracción previa de IP maliciosa en el momento de la recuperación.
unscaledIpPriorBadFraction (float) Se usa para asignar una probabilidad previa basada en la dirección IP. La documentación hace referencia explícita a dos archivos internos: quality/navboost/craps/craps-ip-prior.h y craps-penalty.cc. El valor almacenado aquí es previo a la transformación, antes de aplicar una operación de escalado lineal, desplazamiento y mínimo/máximo.
Qué nos dice esto: Google mantiene una puntuación de reputación a nivel de IP. Cada dirección IP tiene una "bad fraction", esencialmente una medida de con qué frecuencia los clics procedentes de esa IP se han clasificado históricamente como spam, tráfico de bots o intentos de manipulación. Al evaluar las señales de clic de una IP concreta, esta probabilidad previa ajusta el peso de esos clics.
Esto TAMBIÉN puede estar relacionado con por qué estudios anteriores han demostrado que el ALOJAMIENTO COMPARTIDO puede ser PEOR para el SEO, cuando un bloque de IP puede estar asociado a actores maliciosos / spam masivo, etc.
De hecho, hace unos años, un competidor de larga trayectoria (y muy buen amigo mío, Shai Aharony) y uno de sus SEO, "Oliver Sissons", realizaron un experimento sobre un "long term shared hosting experiment" que también parecía sugerir que esto es cierto:
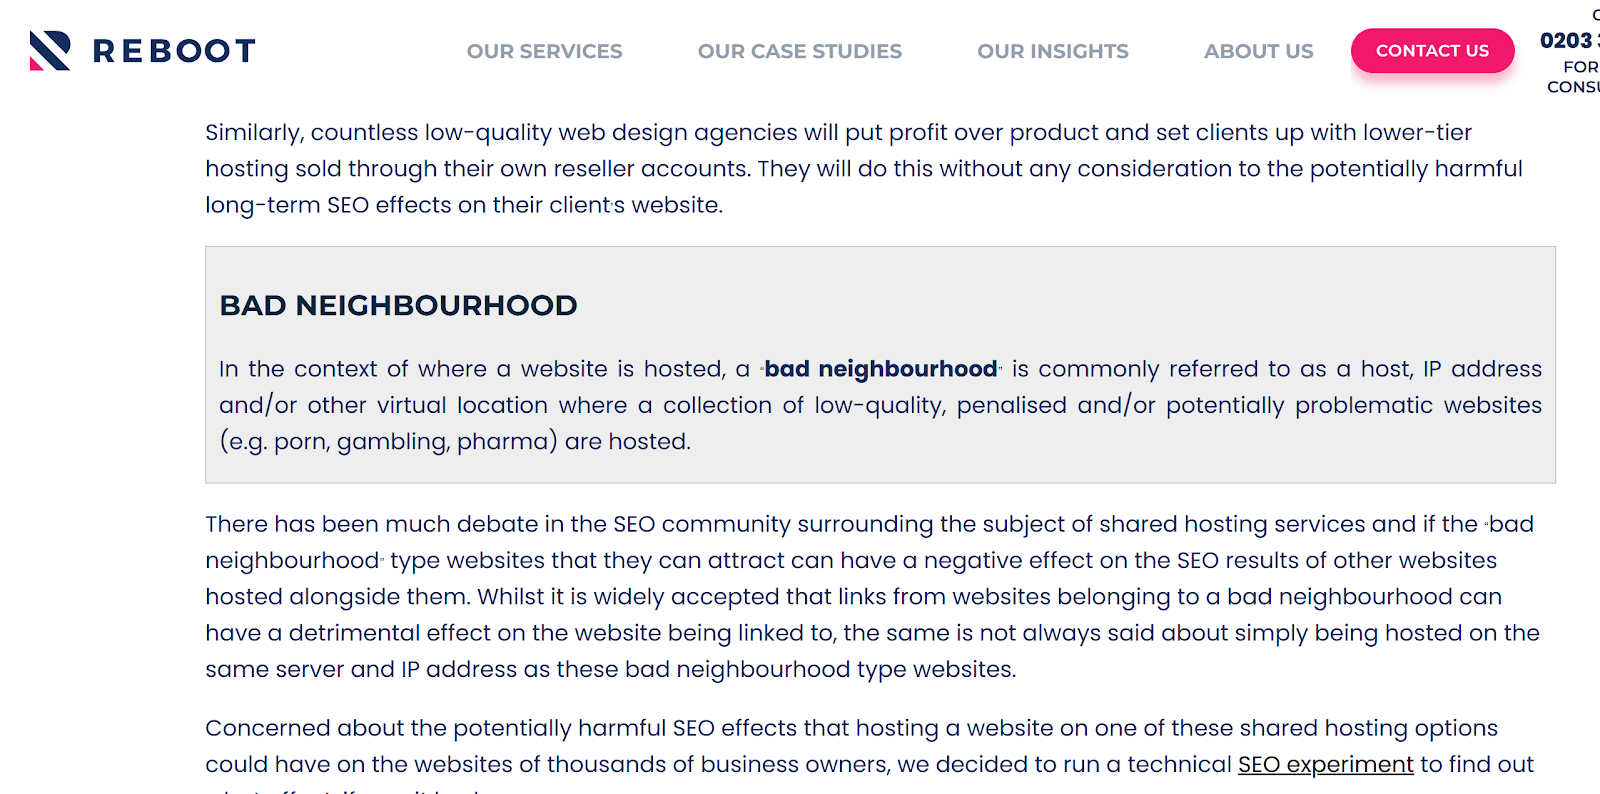
Esto podría explicar:
Por qué algunos sitios experimentan mejoras de posicionamiento tras abandonar el alojamiento compartido
Algunos dominios parecen ser "tóxicos" cuando en realidad es el bloque de IP al que están asignados el que es conocido por spam/abuso y, en consecuencia, todo lo que se sirve desde él puede verse perjudicado.
Escenario práctico: un servicio de manipulación de CTR que envía clics a través de un endpoint VPN en Londres podría ver resultados al principio. Pero a medida que los clics desde esa IP se acumulan y ninguno de ellos muestra patrones de navegación naturales (tiempos de permanencia variados, consultas de seguimiento naturales, URLs diversas clicadas), la bad fraction sube. Con el tiempo, los clics de ese rango de IP se descuentan fuertemente o se ignoran por completo. La transformación de "escalado / desplazamiento / mínimo / máximo" mencionada en la documentación sugiere que existe un sistema de umbrales: por debajo de una cierta bad fraction, los clics se aceptan con normalidad; por encima, se devalúan progresivamente; por encima de un techo duro, pueden descartarse.
He probado esto a lo largo de los años con herramientas como CTR Booster + Trusted Proxies, que tunelizaban las peticiones a través de IPs de proxies residenciales con user-agents falsificados.
CTR Booster funcionaba, sin embargo, es muy probable que estas sesiones se hayan vuelto más evidentes a medida que las capacidades de detección de Google han mejorado con el tiempo.
Voter tokens y filtrado por privacidad
voterTokenCount (integer) "El número de voter tokens distintos (una cota inferior del número de usuarios distintos que contribuyeron a la entrada, utilizada para el filtrado relacionado con la privacidad)."
Esto es crucial. Google no se limita a contar clics: cuenta personas únicas. El sistema de voter tokens proporciona una cota inferior del número de usuarios distintos cuyos clics han contribuido al perfil NavBoost de una URL. Si una URL tiene 500 clics pero solo 3 voter tokens, eso es una señal de alarma enorme. Si tiene 500 clics de 480 voter tokens, es una señal sana y orgánica.
La expresión "cota inferior" es deliberada: los voter tokens no son únicos por usuario (como se confirma en el modelo FeatureCrapsData), así que el recuento es una estimación conservadora. Google prefiere subestimar el número de usuarios distintos que sobreestimarlo, lo que significa que el umbral de filtrado por privacidad está calibrado para protegerse frente a falsos positivos.
Interpretación especulativa: en mi opinión, es casi seguro que existe un umbral mínimo de voter tokens por debajo del cual los datos de NavBoost para un par URL/consulta se suprimen por completo. Si solo dos o tres usuarios han aportado clics, la muestra es demasiado pequeña para ser significativa y demasiado fácil de manipular. Esto explicaría por qué las páginas nuevas con muy poco tráfico no experimentan cambios de ranking impulsados por NavBoost hasta que han acumulado una masa crítica de usuarios distintos.
Estadísticas a nivel de patrón
patternSccStats Enlaza con el modelo StatsWithWeightsProto (tratado más abajo). Para los datos a nivel de patrón, contiene estadísticas sobre los componentes fuertemente conexos de las URLs individuales que contribuyen al patrón. Dicho de otro modo, cuando Google agrega los datos de clic hasta el nivel de dominio, no se limita a sumar las cifras: analiza la distribución. ¿Qué nivel de consistencia tiene la calidad de los clics entre las distintas URLs? ¿El sólido perfil NavBoost del dominio lo impulsa una única página viral, o es consistente a lo largo de cientos de páginas?
Modelo 3: CrapsDevice. Lo que Google sabe sobre el dispositivo de tu visitante
Tres atributos. Sencillo, pero revelador.
os (string) El sistema operativo. Esto confirma que Google rastrea y almacena el SO de cada usuario cuyos clics alimentan NavBoost.
uxInterface (integer) Un enum de GWSLogEntryProto que indica el tipo de dispositivo:
1 = Escritorio
2 = Móvil
3 = Tablet
La referencia a "gwslog(608)" nos indica que estos datos provienen directamente del log del Google Web Server, la misma infraestructura que sirve cada petición de búsqueda de Google.
uxTier (integer) Nivel de capacidad del navegador:
1 = Navegadores modernos
2 = Todo lo intermedio
3 = Navegadores muy antiguos
Por qué esto importa más allá de la segmentación básica: si Google segmenta las señales de clic por nivel de navegador, significa que el sistema puede ponderar potencialmente los clics de navegadores modernos de forma distinta a los de navegadores antiguos. Un clic desde Chrome 120 en un dispositivo Android de gama alta probablemente se trate como una señal de mayor confianza que un clic desde un navegador obsoleto que podría estar asociado a tráfico de bots o a infraestructura de rastreo anticuada.
Escenario especulativo: Este sistema de niveles también podría servir como vector antimanipulación. Las herramientas automatizadas de clics suelen usar navegadores headless o user agents antiguos que podrían caer en el nivel 2 o el nivel 3. Si Google observa que una proporción desmesurada de los clics de una URL procede de navegadores de nivel bajo en comparación con la norma de esa consulta, se trata de una posible señal de spam.
Modelo 4: FeatureCrapsData Segmentación granular por ubicación
Este modelo permite una segmentación geográfica y por dispositivo extremadamente detallada de las señales de clic.
country (string) Mismo formato que CrapsData, en minúsculas (p. ej., "us"). La documentación señala: "If not present, it's an aggregation for all countries."
language (string) p. ej., "en". De nuevo, la ausencia significa agregación de todos los idiomas.
device (string) Indicador simplificado de dispositivo: "m" para móvil, "d" para escritorio. Si no está presente, se agrega entre todos los dispositivos.
locationId (integer) "Location id for metro and city. If not present, it's an aggregation for all locations within current country."
Este es el campo que confirma que NavBoost opera a nivel de área metropolitana/ciudad. Google no solo sabe que buscas desde el Reino Unido: sabe que buscas desde Birmingham o Edimburgo, y puede segmentar las señales de clic en consecuencia.
Implicación práctica: Si eres consultor SEO y trabajas el SEO local de un negocio en Manchester, las señales de clic de tu cliente procedentes de usuarios de Manchester se registran por separado de las señales de clic de usuarios de Londres. Un restaurante que consigue clics excelentes de usuarios de su propia ciudad pero clics pobres de usuarios de otros lugares puede posicionar bien a nivel local y mal a nivel nacional, y NavBoost es el mecanismo que permite esa diferencia.
signals Una instancia completa de CrapsClickSignals con los datos de clic de ese segmento de ubicación concreto.
voterTokenBitmap Enlaza con el modelo GlueVoterTokenBitmapMessage. Proporciona seguimiento de voter tokens por ubicación, lo que significa que Google puede evaluar la diversidad de usuarios que contribuyen a las señales de clic a nivel metropolitano. Si un negocio de Londres recibe de repente una avalancha de "good clicks" de usuarios de una sola área metropolitana, pero el bitmap de voter tokens muestra que todos proceden de un puñado de tokens, la señal se filtra.
Modelo 5: StatsWithWeightsProto Análisis de distribución
Este es un modelo de estadístico. Quince atributos, trece de ellos floats, todos describiendo la distribución estadística de los datos de clic entre las URL que contribuyen a una agregación a nivel de patrón.
n (integer) Tamaño de la muestra. El número de puntos de datos individuales (probablemente URL individuales) que contribuyen al patrón.
weightedN (float) Tamaño muestral ponderado. No todas las URL contribuyen por igual: algunas se ponderan más, posiblemente por volumen de tráfico o número de voter tokens.
mean, median Tendencia central de la métrica de clic que se está midiendo.
stddev, variance, varOfMean, stdError Métricas de dispersión. ¿Cómo de dispersas están las señales de clic entre las URL dentro de este patrón?
hi, lo Los extremos de la distribución.
pc10, pc25, pc75, pc90 Puntos de corte percentiles. Esto le da a Google una imagen completa de la forma de la distribución.
kind (integer) Un enum que indica de qué tipo de estadística se trata. La filtración no enumera los valores posibles, pero probablemente distingue entre métricas diferentes (ratios de good clicks, ratios de bad clicks, ratios de lastLongestClick, etc.).
Por qué importa este nivel de detalle estadístico: Google no se limita a mirar si tu dominio tiene buenas señales de clic agregadas. Mira la distribución de la calidad de los clics entre tus páginas. Un dominio cuya mediana de ratio de good clicks es 0,6 con una desviación estándar ajustada es un dominio consistentemente sólido. Un dominio cuya media es 0,6 pero cuya desviación estándar es enorme —lo que significa que algunas páginas son excelentes y otras pésimas— presenta un perfil de calidad distinto.
Interpretación especulativa: Desde mi punto de vista, este es muy probablemente el mecanismo que hay detrás de las evaluaciones de calidad a nivel de sitio. Si los sistemas internos de Google (como el HCU de Google, helpful content update o system) aplican modificadores a nivel de sitio, la distribución estadística de las señales NavBoost en el patrón de URL de un dominio es probablemente una entrada clave. No basta con tener unas pocas páginas excelentes: si tu pc10 (el percentil 10) muestra que tus peores páginas generan clics abrumadoramente malos, eso arrastra hacia abajo la evaluación a nivel de patrón.
Escenario práctico: Una granja de contenidos publica 1.000 artículos. Cincuenta de ellos funcionan bien por casualidad y consiguen buenos clics. Los otros 950 generan pogo-sticking y malos clics. La media puede parecer mediocre, pero la mediana es terrible, el pc10 está cerca de cero y la desviación estándar es enorme. Las estadísticas a nivel de patrón de Google capturarían este perfil con precisión y probablemente alimentarían una degradación de todo el sitio.
Modelo 6: GlueVoterTokenBitmapMessage La capa antimanipulación
Dos atributos de tipo string, pero la descripción del modelo revela el mecanismo subyacente.
La documentación afirma que este modelo se "used for aggregating query unique voter_token during merging" y emplea "4 uint64(s) as a 256-bit bitmap to aggregate distinct voter_tokens in Glue model pipeline."
voterToken (string) Un único voter token. Como optimización, si solo ha contribuido un usuario, el token se almacena como un único uint64 en lugar de un bitmap completo.
subRange (lista de strings) Los componentes del bitmap cuando hay varios tokens presentes.
Cómo funciona probablemente: A cada usuario que contribuye un clic se le asigna un voter token (que no es único por usuario: es un identificador hasheado y respetuoso con la privacidad que sirve como cota inferior del número de usuarios distintos). Estos tokens se agregan en un bitmap de 256 bits. El bitmap permite a Google fusionar de forma eficiente conjuntos de tokens entre consultas y periodos de tiempo durante el procesamiento del pipeline Glue.
La referencia a "Glue" es significativa. Como se confirmó durante el juicio antimonopolio, Glue es esencialmente NavBoost ampliado para cubrir todas las features de la SERP: no solo los diez enlaces azules, sino también Knowledge Panels, carruseles de vídeo, packs de imágenes, cajas de People Also Ask y AI Overviews. El bitmap de voter tokens garantiza que la comprobación de diversidad de usuarios se aplique a todos estos tipos de feature.
¿Por qué 256 bits? Un bitmap de 256 bits puede representar hasta 256 buckets de hash de voter tokens distintos. Esto significa que el sistema está diseñado para un recuento aproximado eficiente de usuarios distintos, no para un recuento exacto. Para los fines de NavBoost, saber que han contribuido "aproximadamente 180 usuarios distintos" es suficiente: el número exacto importa menos que la confianza en que los datos de clic proceden de una base de usuarios diversa y orgánica.
¿De dónde obtiene Google estos datos?
Los modelos filtrados hacen referencia a varias fuentes de datos, de forma explícita o por fuerte implicación:
Logs del Google Web Server (GWS) El modelo CrapsDevice hace referencia explícita a entradas de gwslog (608 y 609). Cada consulta de búsqueda, cada clic en un resultado, cada regreso a la SERP queda registrado por la infraestructura de servidores web de Google. Esta es la fuente de datos principal.
QSessions Referenciadas en la descripción de mobileSignals y en la de CrapsDevice. Las QSessions parecen ser el modelo interno de sesión de Google: un registro estructurado de todo lo que hace un usuario durante una sesión de búsqueda, desde la consulta inicial hasta todos los clics, reformulaciones y la eventual finalización de la sesión.
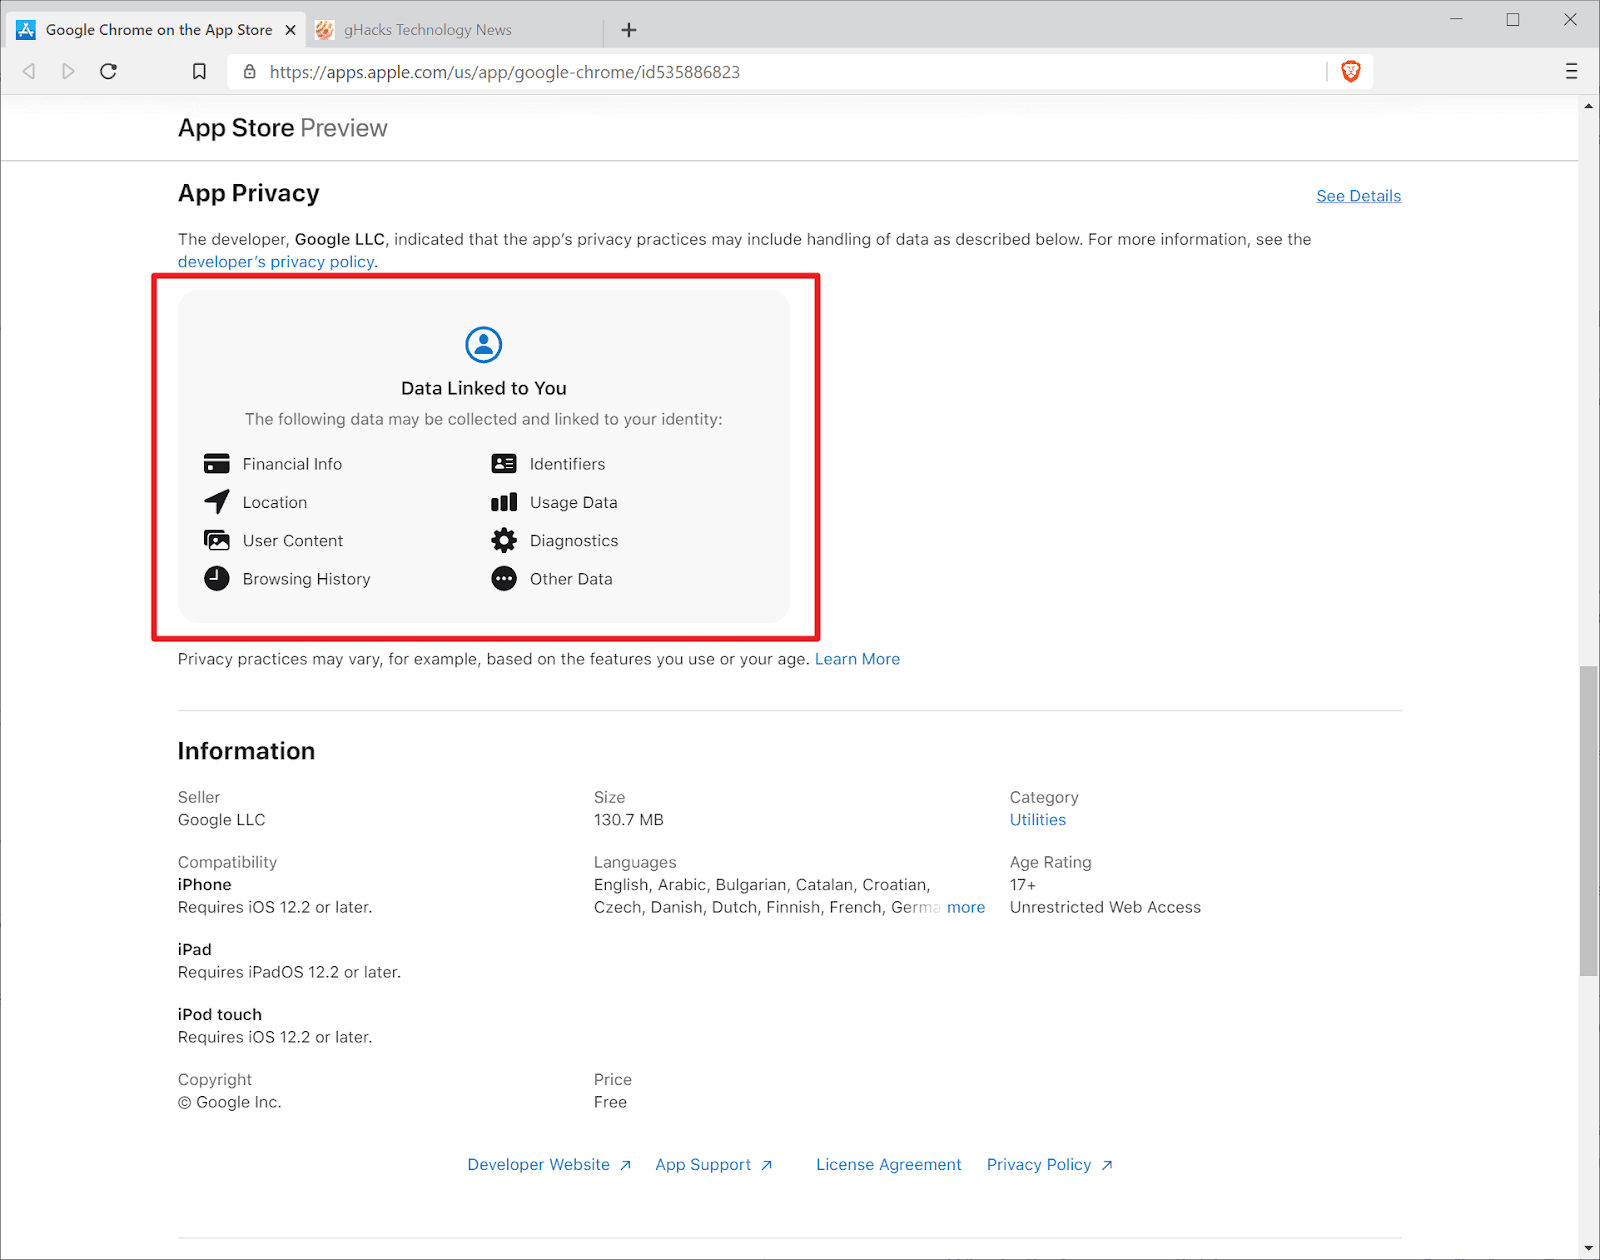
Datos de Chrome No se nombran explícitamente en estos seis modelos, pero las pruebas del juicio antimonopolio y la filtración en su conjunto contienen múltiples referencias a datos procedentes de Chrome que alimentan NavBoost. El concepto de clic "unsquashed" se ha vinculado a la capacidad de Chrome de aportar una identificación de usuario con mayor nivel de confianza.
Historial de cookies Referenciado en la información de Rand Fishkin sobre la fuente que facilitó los documentos filtrados. Las cookies aportan continuidad de sesión y, para los usuarios logueados, persistencia de identidad entre sesiones.
Datos de dirección IP Explícitamente presentes en CrapsData a través de packedIpAddress y unscaledIpPriorBadFraction. Google mantiene una puntuación de reputación a nivel de IP que alimenta directamente la evaluación de las señales de clic.
Especulativo pero probable: datos de Android y de la app de Google Google Search en Android y la app de Google en iOS generan las mismas entradas de log de GWS que Chrome en escritorio. Con el móvil representando ya la mayoría del tráfico de búsqueda, es probable que sean contribuyentes significativos a los datos de mobileSignals y uxInterface.
La ventana móvil de 13 meses
Confirmado durante el juicio antimonopolio: NavBoost funciona con una ventana móvil de 13 meses de datos de clics. Antes de 2017 aproximadamente, esa ventana era de 18 meses: me resulta extraño, no sé muy bien por qué no la alinearon con los 16 meses de datos de GSC.
Esto tiene implicaciones prácticas directas:
El contenido nuevo no tiene señal de NavBoost. Debe ganarse sus posiciones iniciales mediante otras señales (relevancia temática, enlaces, frescura) antes de poder empezar a acumular datos de clics.
El contenido en declive no pierde su señal de NavBoost de la noche a la mañana. Una página que era fuerte hace seis meses todavía tiene esos datos dentro de la ventana. Pero, a medida que pasan los meses y los datos de clics más recientes muestran una interacción decreciente, la señal se debilita.
El contenido estacional se beneficia de la ventana de 13 meses. Una guía de regalos de Navidad publicada en noviembre seguirá teniendo sus buenos datos de clics de diciembre dentro de la ventana en noviembre del año siguiente, lo que le da ventaja de salida al año siguiente.
El contenido recuperado: si arreglas una página pésima y los usuarios empiezan a interactuar de forma positiva, los datos de clics malos antiguos no desaparecen de inmediato. Básicamente estás diluyendo 10 meses de datos malos con 3 meses de datos buenos. El cambio es gradual, no instantáneo.
NavBoost como sistema de reordenación, no de recuperación
Pandu Nayak declaró durante el juicio: "Recuerda, solo obtienes Navboost después de que hayan sido recuperados en primer lugar".
Es una distinción esencial. NavBoost no decide qué páginas entran en el conjunto de candidatas para una consulta. De eso se encargan sistemas anteriores como Mustang (el motor de recuperación principal). NavBoost actúa aguas abajo, ajustando el orden de páginas que otras señales ya han considerado relevantes.
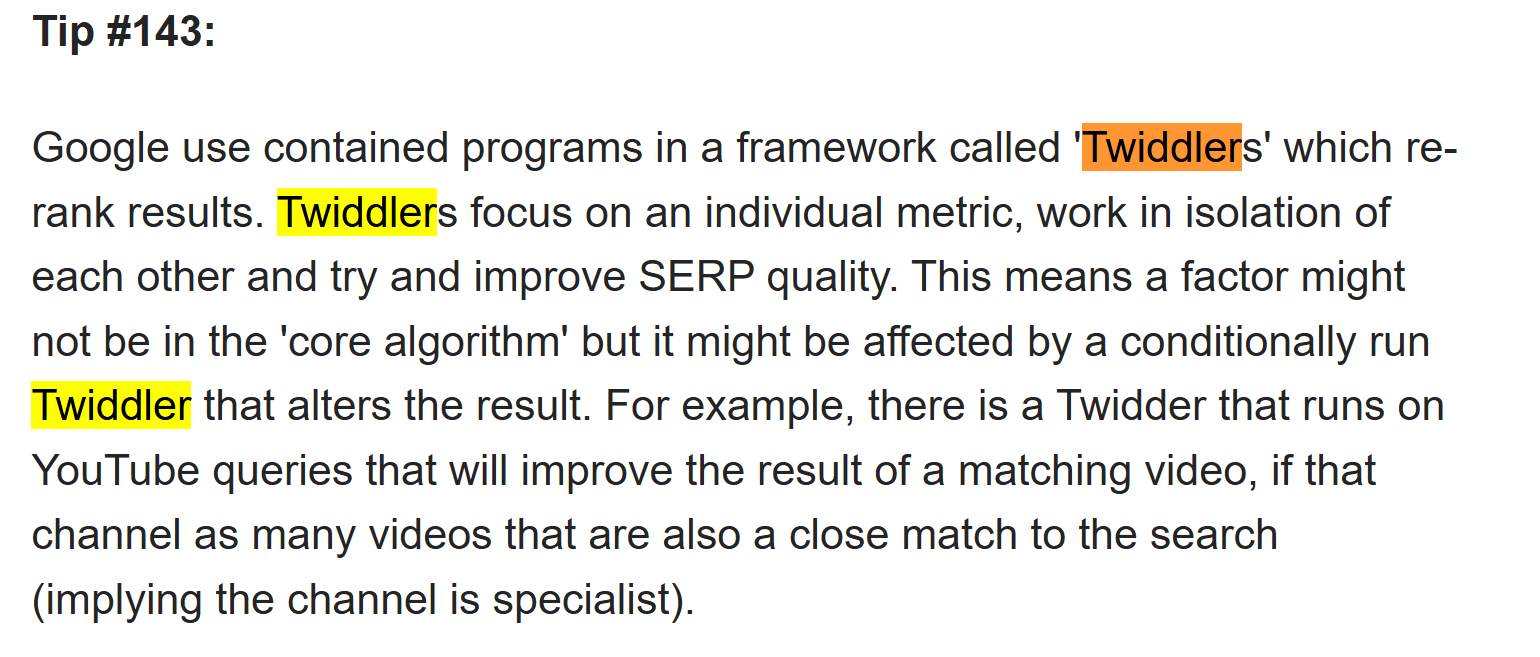
En la arquitectura de Google, NavBoost funciona como un "Twiddler": un sistema que reordena un conjunto ya filtrado de documentos candidatos. Otros Twiddlers confirmados incluyen los ajustes de frescura y los sistemas de impulso por calidad.
Un buen amigo mío del sector SEO, "Mark Williams Cook", tiene una página con 500 consejos SEO no solicitados: ahí, a partir del CONSEJO 143, habla de los Twiddlers.
Qué significa esto en la práctica: no puedes posicionar únicamente con señales de clics. Si tu página no tiene relevancia temática, ni enlaces, ni otras señales de calidad, no entrará en el conjunto de candidatas y NavBoost nunca la verá. Pero una vez que estás en ese conjunto —una vez que estás en la página uno o la página dos—, NavBoost se convierte posiblemente en la fuerza más potente a la hora de determinar si te quedas ahí, subes o te empujan hacia abajo.
Casos límite y escenarios
La ventaja de las consultas de marca
Piensa en una consulta como "Sage accounting software".Sage.com tiene casi con total seguridad un perfil de NavBoost abrumadoramente positivo para esta consulta: prácticamente todos los usuarios que la buscan están buscando Sage y hacen clic hacia sage.com. El ratio de lastLongestClicks probablemente se acerca a 1,0. El ratio de badClicks probablemente ronda cero.
Ahora piensa en un competidor que intente posicionarse para esa consulta. Incluso con un SEO on-page perfecto y enlaces potentes, libra una batalla cuesta arriba contra unos datos de NavBoost que muestran que los usuarios prefieren abrumadoramente hacer clic en el resultado propio de Sage. Este es el foso de marca de NavBoost, y resulta casi imposible de superar en consultas de marca sin un reconocimiento de marca propio considerable.
El problema del restaurante local
Abre un restaurante nuevo en Nottingham. Tiene cero datos de NavBoost. Posiciona en función de la frescura, las señales locales y las plataformas de reseñas que lo hayan recogido. Los usuarios empiezan a hacer clic por curiosidad, pero la comida decepciona. Los visitantes hacen pogo-sticking de vuelta a los resultados. Los clics malos se acumulan a nivel de URL y a nivel de localidad metropolitana específica (el locationId de FeatureCrapsData para Nottingham).
Seis meses después, el restaurante cambia de propietarios y pasa a ser excelente. Pero la ventana de NavBoost todavía contiene cinco meses de datos de clics malos frente a un mes de datos en mejora. La recuperación es lenta y podría requerir los 13 meses completos para que los datos antiguos salgan de la ventana, salvo que la mejora sea lo bastante drástica como para que los ratios comprimidos (squashed) se desplacen de forma significativa.
El sitio de contenido pobre con títulos brillantes
Un sitio produce cientos de páginas con title tags y meta descripciones excepcionales, que despiertan la curiosidad. Los clics son altos. Pero el contenido es pobre. Los usuarios aterrizan, se dan cuenta de que no hay nada de sustancia y rebotan. Los clics son altos, pero los goodClicks son bajos. Los badClicks son altos. Los lastLongestClicks rozan el cero porque los usuarios siempre acaban haciendo clic en otro resultado.
NavBoost no premia solo los clics: premia la resolución. Este sitio acumularía un perfil de NavBoost devastador: muchas impresiones, clics aceptables, un ratio de clics buenos frente a malos pésimo y prácticamente ningún lastLongestClicks. La agregación por patternLevel extendería esta señal negativa a todo el dominio.
La página experta con poco tráfico
Una página técnica muy especializada recibe 50 impresiones al mes. De ellas, 15 hacen clic, y 14 de esos clics son buenos, con tiempos de permanencia largos. El voterTokenCount muestra 14 usuarios distintos. El ratio de clics buenos es excepcional, pero las cifras absolutas son diminutas.
Aquí es donde el squashing juega a favor de la página. Los datos comprimidos normalizan los volúmenes absolutos y dejan que el ratio brille. Pero el bajo recuento de tokens de votante podría activar el filtrado por privacidad y llegar a suprimir por completo la señal de NavBoost hasta que más usuarios aporten datos. Es una tensión real dentro del sistema: el contenido experto de poco tráfico puede necesitar alcanzar un umbral mínimo de usuarios antes de que NavBoost le ayude.
Inconsistencia entre dispositivos
Una página se renderiza perfectamente en escritorio pero está rota en móvil. Los usuarios de escritorio (uxInterface: 1) generan señales fuertes de clics buenos. Los usuarios de móvil (uxInterface: 2) hacen pogo-sticking constantemente y generan clics malos. Como NavBoost mantiene señales móviles separadas mediante mobileSignals y la segmentación por dispositivo en FeatureCrapsData, la página podría posicionar bien en escritorio y mal en móvil al mismo tiempo para la misma consulta.
Esto no es teórico. Muchos SEOs han observado posiciones distintas en móvil y en escritorio para la misma página y consulta, y la segmentación de señales por dispositivo de NavBoost es muy probablemente un mecanismo que contribuye a ello.
Qué significa NavBoost para tu estrategia SEO
La filtración no nos dice los pesos. No nos dice los umbrales. Pero sí nos dice la arquitectura, y la arquitectura revela qué valora Google:
Satisfacción por encima de atracción: esto significa que los clics buenos y los lastLongestClicks se registran por separado de los clics brutos. Conseguir el clic es solo la mitad de la ecuación. Retener al usuario —ser el resultado que termina la sesión de búsqueda— es lo que NavBoost premia de verdad.
Consistencia por encima de picos: esto significa que el modelo StatsWithWeightsProto, con sus distribuciones por percentiles y sus cálculos de desviación estándar, nos indica que a Google le importa lo consistente que es la calidad de tus clics en todo el sitio, no solo en tus páginas con mejor rendimiento.
Diversidad por encima de volumen, esto significa: los sistemas de voterTokenCount y de mapas de bits de tokens de votante confirman que mil clics de cinco usuarios valen menos que cien clics de noventa usuarios. La señal es la interacción orgánica y diversa. El volumen fabricado es la señal de alarma.
Contexto por encima de agregación: esto significa que con la segmentación por país, la segmentación por idioma, el locationId a nivel metropolitano, la segmentación por dispositivo y la clasificación por tier de navegador, NavBoost no evalúa tu página en el vacío. La evalúa por consulta, por localidad, por dispositivo y por tier de navegador. Tus posiciones son el producto de decenas de evaluaciones de NavBoost superpuestas, cada una basada en una porción distinta de tus datos de clics.
El sistema cuya existencia Google negó durante años es, según la propia valoración interna de Google, una de las señales de ranking más potentes que han construido jamás. La filtración de Content Warehouse nos da el esquema. El juicio antimonopolio nos da la confirmación. Qué hacemos con ese conocimiento depende de nosotros.
Algo que podemos hacer como SEOs es especular, debatir y probar. Desde que se filtró el Content Warehouse me fascinó la cantidad de información que contenía: cloné una copia del repositorio original de GITHUB que se había publicado antes de que lo retiraran y, dentro, se ven muchos otros factores. En este artículo hemos tratado NAVBOOST porque desempeña un papel intrínseco en el SEO, pero queda muchísimo más por desgranar, desde los rich snippets de calidad hasta SpamBrain.
Echa un vistazo al SEO Datawarehouse aquí: están listados los 14.027 atributos (no todos están relacionados con SEO), pero lo he preparado para que puedas ver qué elementos tienen una MAYOR PROBABILIDAD de usarse en la ponderación del ranking.
Otras reflexiones finales:
PERO DANIEL, ¿CÓMO PUEDE SER EL COMPORTAMIENTO DEL USUARIO UN FACTOR DE POSICIONAMIENTO SI NO POSICIONAS LO BASTANTE ARRIBA COMO PARA OBTENER CLICS QUE EVALUAR?
Bueno, el posicionamiento en Google lo dictan múltiples algoritmos y, muy a menudo, los sitios que TODAVÍA no están afectados por NAVBOOST tienen la oportunidad de ser evaluados una vez que se cumplen otros criterios.
En general, si los sitios web son buenos desde el punto de vista técnico —es decir, Google puede rastrear, renderizar, acceder e indexar el contenido—, siempre que el contenido sea bueno / esté alineado temáticamente y existan otras señales que indiquen confianza y calidad, Google permitirá posicionar a sitios nuevos o con datos limitados / escasos. NAVBOOST no tiene que aplicarse a todo, solo a los sitios donde los clics resultan viables en función de la posición.
En mi opinión, los sitios reciben la oportunidad de demostrar su valía, y por eso las core updates mueven las SERPS: permiten que otros contenidos tengan la ocasión de posicionar. Solo el contenido que DEMUESTRA REALMENTE una interacción positiva del usuario de forma sostenida suele mantener su posición a lo largo de las core updates.
Pero, como sabemos, en Google nada es nunca del todo consistente.
Todos los nombres de modelos, nombres de atributos y extractos de documentación mencionados en este artículo proceden de la documentación de la Google Content Warehouse API filtrada en mayo de 2024, tal y como está catalogada enseo-datawarehouse.com. El testimonio del juicio antimonopolio procede de los registros judiciales públicos de United States of America v. Google LLC. Cuando las interpretaciones son especulativas, se indica claramente.
Me encanta el SEO y me encantan las especulaciones, los debates y los tests de SEO, pero NADA en este artículo es lo que yo llamaría definitivo; he añadido mis propias reflexiones especulativas, aunque sí sé con certeza que...
Chrome es un caballo de Troya para los datos, y el comportamiento de clic es una de las mejores formas de determinar si algo es bueno o malo. Los comportamientos de clic sí importan.

Fundador, SEO Stack
Daniel es el fundador de SEO Stack. Ha dedicado más de 2 décadas al SEO técnico y a los datos de búsqueda, y creó SEO Stack tras toparse una vez más con los mismos límites de Search Console en el trabajo con clientes.
Daniel cuenta con una amplia experiencia en SEO: ha montado agencias de SEO, negocios de auditoría y una consultoría próspera. En su tiempo libre, le gusta realizar experimentos de SEO y compartir los resultados.
Publicado 29 de marzo de 2026


