La guía completa del operador site: de Google (y todos los trucos que los SEOs necesitan conocer)
La mayoría de los SEOs sabe que el operador site: existe. Muchos menos lo utilizan ni de lejos a su máximo potencial. En su forma más simple, site: example.com te dice qué ha indexado Google de un dominio. Pero…
La mayoría de los SEOs sabe que existe el operador site:. Muchos menos lo aprovechan ni de lejos al máximo.
En su forma más simple, site:example.com te dice qué ha indexado Google de un dominio. Pero combinado con otros operadores, filtrado por subcarpeta, acotado a un subdominio o unido a lógica booleana, se convierte en una de las herramientas de diagnóstico más potentes del SEO técnico. Sin necesidad de herramientas de pago.
Esta guía lo cubre todo: lo básico, los operadores avanzados que puedes superponer, casos de uso reales y las limitaciones que debes entender antes de fiarte de las cifras.
Lo básico: qué hace realmente site:
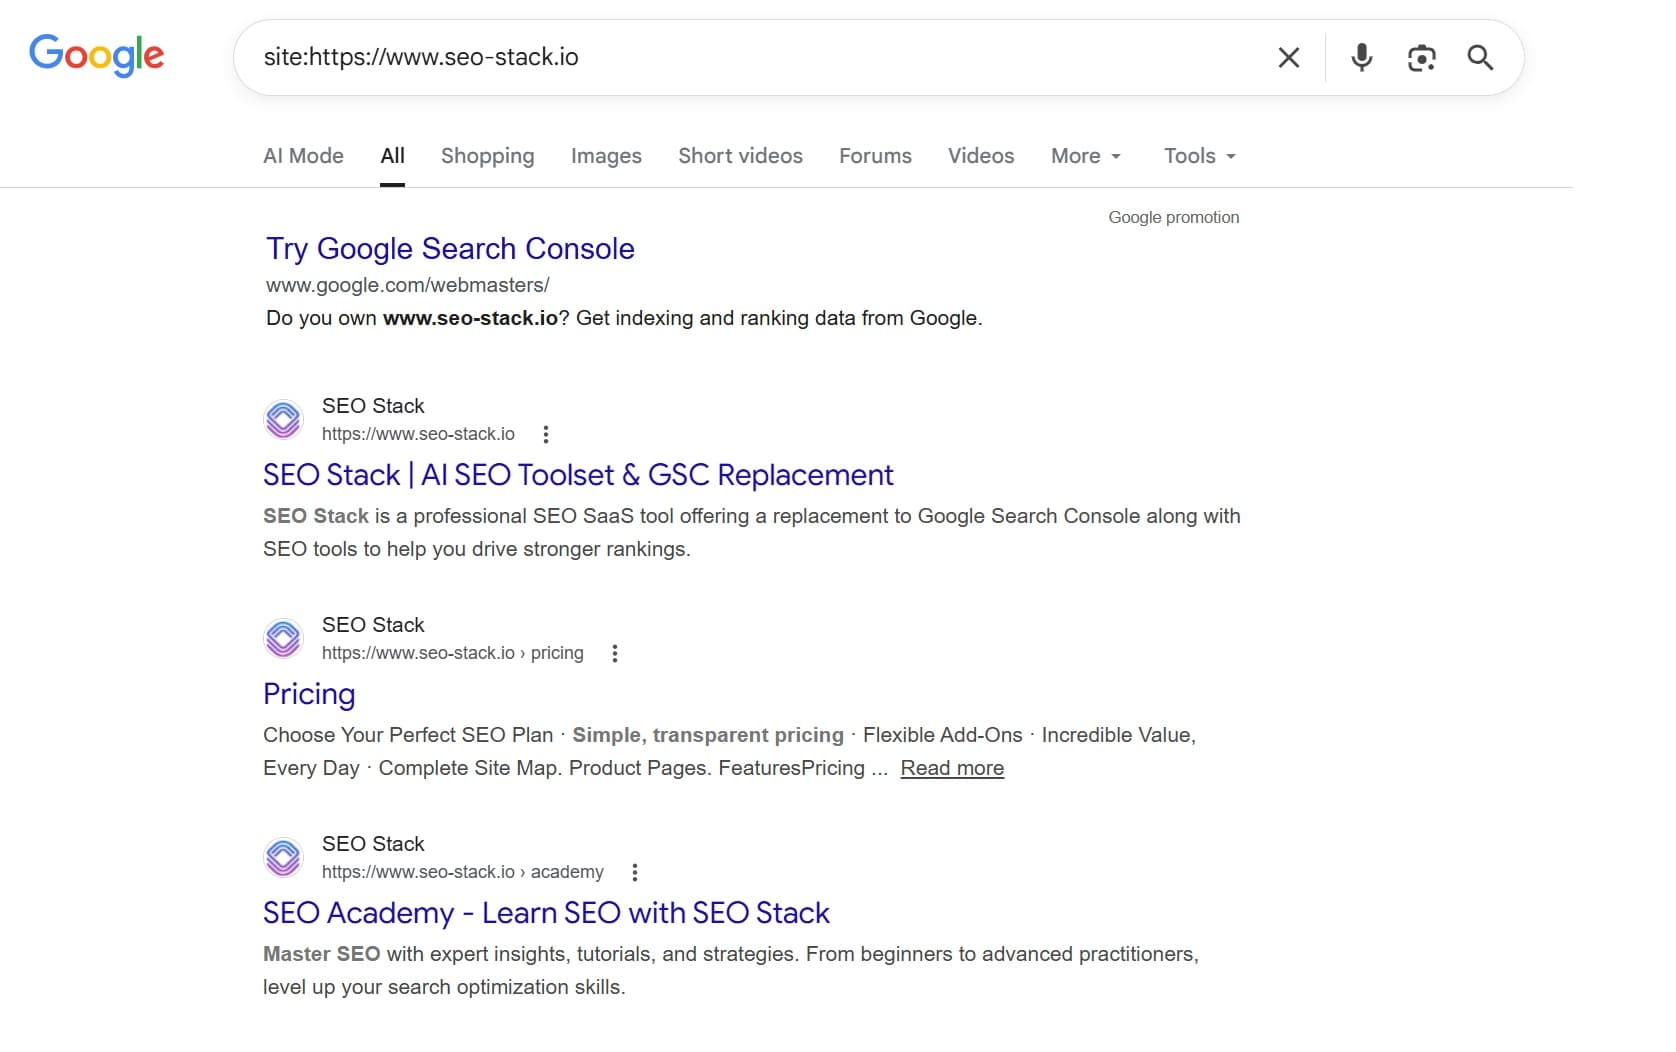
site:seo-stack.io
Esta consulta devuelve el índice de Google de todas las páginas que reconoce como pertenecientes a seo-stack.io. El número que aparece en la barra de resultados («Aproximadamente X resultados») te da un recuento aproximado de páginas indexadas.
Algunas cosas que conviene entender de entrada:
El número es una estimación. Google no devuelve recuentos de índice precisos. La cifra fluctúa entre búsquedas y es notoriamente poco fiable a escala. No construyas informes sobre ella.
Muestra lo que Google ha indexado, no lo que has publicado. Las páginas bloqueadas por robots.txt, con noindex o simplemente no rastreadas todavía no aparecerán.
Incluye subdominios por defecto, salvo que especifiques lo contrario (más sobre esto abajo).
No necesitas el prefijo https://. site:seo-stack.io y site:https://www.seo-stack.io funcionan igual, pero la primera forma es más limpia.
Acotar site: a subcarpetas y subdominios
Aquí es donde site: empieza a ganarse su sitio en una auditoría real.
Indexación a nivel de subcarpeta
site:example.com/blog/
site:example.com/products/
site:example.com/en-gb/
Esto acota la consulta a una sección concreta del sitio. Útil para:
Comprobar cuántas entradas del blog están indexadas frente a las publicadas
Diagnosticar huecos de indexación en una categoría de e-commerce
Auditar subdirectorios internacionales de forma individual
Ejemplo práctico: si site:example.com/blog/ devuelve 47 resultados pero has publicado 200 entradas, tienes un problema de indexación: canonicalización, etiquetas noindex, crawl budget o contenido thin son los sospechosos habituales.
Indexación a nivel de subdominio
site:blog.example.com
site:app.example.com
site:support.example.com
Esto restringe los resultados a un subdominio concreto. Útil cuando un sitio usa subdominios para distintos entornos (blog, app, documentación de soporte, staging) y quieres auditar cada uno por separado.
Excluir subdominios
site:example.com -site:blog.example.com
Muestra todo el contenido indexado de example.com excepto el subdominio del blog. Práctico para aislar el sitio principal cuando un subdominio de blog o de documentación infla el recuento.
Superponer operadores: donde gana potencia
El operador site: se vuelve realmente diagnóstico cuando se combina con otros. Estas son las combinaciones más útiles.
site: + inurl:
site:example.com inurl:category
site:example.com inurl:?
site:example.com inurl:page
Qué hace: filtra las páginas indexadas cuya URL contiene una cadena concreta.
Casos de uso:
site:example.com inurl:? — saca a la luz URLs facetadas o con parámetros que han sido indexadas. Si ves miles de resultados aquí, probablemente tengas un problema de crawl budget o de contenido duplicado.
site:example.com inurl:/tag/ — encuentra páginas de etiquetas indexadas en sitios WordPress, que suelen ser thin y deberían llevar noindex.
site:example.com inurl:utm_ — revela si se han indexado URLs con etiquetas UTM (no deberían estarlo).
site:example.com inurl:print — descubre versiones para imprimir que están siendo indexadas.
site: + intitle:
site:example.com intitle:"buy"
site:example.com intitle:"login"
site:example.com intitle:"404"
Qué hace: filtra los resultados cuyo título de página contiene la palabra o frase indicada.
Casos de uso:
site:example.com intitle:"404" — encuentra páginas de error 404 que Google ha indexado con «404» en el título. Es un fallo de SEO técnico habitual.
site:example.com intitle:"index of" — detecta listados de directorios abiertos que han sido indexados. Un problema de seguridad y de SEO.
site:example.com intitle:"duplicate title" — úsalo con el texto del título duplicado que conozcas para detectar duplicación masiva.
site:example.com intitle:"coming soon" — caza páginas provisionales que se han colado en el índice.
site:competitor.com intitle:"best [keyword]" — investigación competitiva sobre el contenido optimizado de un rival.
site: + intext:
site:example.com intext:"noindex"
site:example.com intext:"lorem ipsum"
site:example.com intext:"test page"
Qué hace: filtra los resultados cuyo cuerpo de página contiene el texto indicado.
Casos de uso:
site:example.com intext:"lorem ipsum" — encuentra contenido de relleno publicado en producción. Vergonzoso si el cliente lo descubre antes que tú.
site:example.com intext:"add to basket" — confirma rápidamente que las páginas de producto de e-commerce están indexadas.
site:example.com intext:"affiliate disclosure" — audita dónde aparece el texto de divulgación de afiliación en un sitio.
site: + filetype:
site:example.com filetype:pdf
site:example.com filetype:xml
site:example.com filetype:doc
Qué hace: filtra por tipo de archivo.
Casos de uso:
site:example.com filetype:pdf — revela los PDFs que Google ha indexado. Suele pasarse por alto en las auditorías; los PDFs pueden posicionar por su cuenta y diluir el link equity.
site:example.com filetype:xml — comprueba si los archivos de sitemap están indexados como páginas (no deberían estarlo).
site:competitor.com filetype:pdf — investigación competitiva. Sus PDFs indexados suelen contener precios, casos de estudio o guías que de otro modo se te escaparían.
site: + related:
related:seo-stack.io
Técnicamente es un operador distinto, pero encaja bien conceptualmente. Muestra sitios que Google considera relacionados temáticamente o similares. Úsalo para descubrir competidores o para entender cómo categoriza Google tu dominio.
site: + cache:
cache:example.com/specific-page/
Muestra la versión en caché que Google tiene de una página concreta, incluida la fecha del último rastreo. Útil para comprobar:
Si se han recogido los cambios recientes de contenido
Qué está renderizando Google realmente (los problemas de renderizado de JavaScript se hacen evidentes aquí)
Instantáneas históricas de una página durante la investigación de una penalización
Superposición avanzada: combinaciones de varios operadores
Aquí es donde site: se convierte en un verdadero instrumento de auditoría.
Detectar patrones de contenido duplicado
site:example.com intitle:"widget reviews" -inurl:"/widget-reviews/"
Saca a la luz páginas con un título concreto que no residen en la URL canónica. Útil para detectar contenido sindicado o casi duplicado.
Auditoría de indexación por tipo de contenido
site:example.com/blog/ -inurl:"/author/" -inurl:"/tag/" -inurl:"/category/" -inurl:"/page/"
Devuelve las entradas del blog excluyendo páginas de archivo, etiquetas, autores y paginación, lo que te da un recuento más limpio del contenido real de los artículos.
Análisis de brechas de contenido de la competencia
site:competitor.com intitle:"guide" OR intitle:"tutorial" OR intitle:"how to"
Revela rápidamente el volumen y la naturaleza de la estrategia de contenido extenso de un competidor.
Detectar filtraciones del entorno de staging
site:staging.example.com OR site:dev.example.com OR site:test.example.com
Comprueba si los subdominios de desarrollo se han filtrado al índice de Google. Un hallazgo aquí significa una mala configuración del robots.txt o cabeceras noindex ausentes.
Investigación de sitelinks
site:example.com inurl:"/careers/"
site:example.com inurl:"/legal/"
Cuando investigas qué páginas secundarias están indexadas y podrían aparecer como sitelinks, acotar por sección es más rápido que rastrear el sitio.
Lógica booleana con site:
Google admite AND, OR y - (NOT) dentro de las consultas de búsqueda. Combinados con site:, se abren consultas multidominio y de exclusión.
Comparación entre varios dominios
site:example.com OR site:competitor.com intitle:"product reviews"
Devuelve simultáneamente el contenido indexado coincidente de ambos dominios. Útil para un benchmarking competitivo rápido.
Excluir una sección de los resultados
site:example.com -site:example.com/blog/
Devuelve todo el sitio menos el directorio del blog. Útil cuando el blog supera con creces a las páginas comerciales y quieres evaluar el sitio principal por separado.
Comprobar problemas de sindicación de contenido entre dominios
site:syndicatedomain.com "original article title text"
Comprueba si tu contenido ha sido copiado e indexado en otro dominio, lo que puede generar riesgo de contenido duplicado.
Casos de uso prácticos de SEO, de principio a fin
1. Comprobación de la salud de indexación previa a la auditoría
Antes de iniciar una auditoría técnica completa, ejecuta:
site:example.com
Anota el recuento. Después ejecuta:
site:example.com inurl:?
site:example.com inurl:/page/
site:example.com inurl:/tag/
Si las URL parametrizadas, paginadas o taxonómicas están inflando el total, sabrás de inmediato dónde centrarte.
2. Detectar canibalización de contenido
site:example.com intitle:"keyword phrase"
Si aparecen varias páginas con la misma palabra clave en el título, tienes riesgo de canibalización. Le estás pidiendo a Google que elija entre páginas que compiten por la misma intención.
3. Comprobación de indexación tras una migración
Después de una migración de sitio, ejecuta consultas site: a nivel de subcarpeta contra el dominio antiguo y el nuevo a intervalos. Compara los recuentos de páginas indexadas para confirmar que:
Las URL antiguas se están desindexando (caída en los resultados de site:old-domain.com)
Las URL nuevas se están indexando (crecimiento en los resultados de site:new-domain.com)
4. Auditar la indexación frente a tu sitemap
Exporta las URL de tu sitemap. Ejecuta una consulta site: para cada subcarpeta. La diferencia entre el recuento de tu sitemap y el recuento indexado de Google es tu brecha de cobertura de indexación, y hay que explicarla.
5. Detectar contenido pobre o casi duplicado a escala
site:example.com intitle:"[cadena de título genérica]"
Muchos CMS generan páginas con títulos plantilla (por ejemplo, "Productos – Nombre de marca"). Si aparecen cientos de ellas, tienes un problema de indexación de contenido pobre.
site: para inteligencia competitiva
No limites site: a tus propias propiedades. Entre los casos de uso competitivos se incluyen:
Total de páginas indexadas: site:competitor.com — ¿qué tamaño tiene su huella indexable?
Velocidad de contenido: monitoriza su recuento de site: cada mes. Un crecimiento rápido indica una estrategia de contenidos activa.
Páginas de recursos: site:competitor.com filetype:pdf — ¿qué activos están publicando?
Profundidad del blog: site:competitor.com/blog/ — ¿cuánto contenido editorial tienen indexado?
Segmentación estructurada: site:competitor.com intitle:"[tu palabra clave objetivo]" — ¿qué contenido están optimizando para los términos que te interesan?
Limitaciones que debes entender
El operador site: es una herramienta de diagnóstico, no un instrumento de reporting. Sus limitaciones son significativas:
1. El recuento no es fiable. El número mostrado ("Aproximadamente X.XXX resultados") es una estimación aproximada y fluctúa. No lo uses como KPI. Usa el informe de Cobertura del índice de Google Search Console para obtener datos de indexación precisos.
2. No muestra todo lo que Google ha indexado. Algunas páginas indexadas no aparecerán en los resultados de site:, en particular las páginas pobres, el contenido muy duplicado o las páginas que Google ha rastreado pero a las que ha asignado poco valor.
3. Los resultados están personalizados. Las búsquedas con sesión iniciada pueden devolver resultados influidos por tu historial de búsqueda. Usa el modo incógnito para obtener resultados más neutrales.
4. No muestra las páginas rastreadas pero no indexadas. GSC distingue entre rastreadas (pero no indexadas), descubiertas (pero no rastreadas) e indexadas. site: solo muestra el nivel de las indexadas.
5. No sirve para auditorías a nivel de URL a gran escala. Google limita los resultados a unas 1.000 páginas en la SERP. Para un análisis de indexación completo a escala, usa GSC, Screaming Frog o una herramienta de análisis de logs.
Referencia rápida: chuleta del operador site:
Consulta | Caso de uso |
site:example.com | Total de páginas indexadas |
site:example.com/subfolder/ | Indexación de una subcarpeta |
Indexación de un subdominio | |
site:example.com -site:blog.example.com | Sitio menos subdominio |
site:example.com inurl:? | URL parametrizadas en el índice |
site:example.com inurl:/tag/ | Páginas de etiquetas en el índice |
site:example.com intitle:"404" | Páginas de error indexadas |
site:example.com intitle:"lorem ipsum" | Contenido de relleno en producción |
site:example.com filetype:pdf | PDF indexados |
site:example.com intext:"lorem ipsum" | Texto de relleno en el cuerpo |
site:example.com OR site:competitor.com | Comparación multidominio |
site:competitor.com intitle:"[palabra clave]" | Auditoría de contenido de la competencia |
site:staging.example.com | Filtración del entorno de staging |
site:example.com -inurl:/blog/ -inurl:/tag/ | Páginas principales menos tipos de archivo |
Última palabra
El operador site: lleva más de dos décadas formando parte de la sintaxis de búsqueda de Google y, aun así, la mayoría de los SEO lo tratan como una consulta de una sola línea. El valor real llega al combinarlo con inurl:, intitle:, filetype: y lógica booleana para plantear preguntas de diagnóstico precisas.
Ejecútalo antes de empezar una auditoría. Ejecútalo después de una migración. Ejecútalo contra la competencia. Y interpreta siempre los resultados entendiendo qué puede —y qué no puede— decirte el operador.

Fundador, SEO Stack
Daniel es el fundador de SEO Stack. Ha dedicado más de 2 décadas al SEO técnico y a los datos de búsqueda, y creó SEO Stack tras toparse una vez más con los mismos límites de Search Console en el trabajo con clientes.
Daniel cuenta con una amplia experiencia en SEO: ha montado agencias de SEO, negocios de auditoría y una consultoría próspera. En su tiempo libre, le gusta realizar experimentos de SEO y compartir los resultados.
Publicado 18 de marzo de 2026


