什么是 Google BigQuery?面向 SEO 从业者的完整指南
Google BigQuery 是当下最强大的数据仓库工具之一,但它究竟能做什么、如何运作,以及为什么这么多 SEO 从业者最终都需要用它来访问……
Google BigQuery 是目前最强大的数据仓库工具之一,但它究竟能做什么、如何运作,为什么这么多 SEO 从业者仅仅为了访问自己的 Google Search Console 数据就不得不用上它?本指南涵盖你需要知道的一切。
什么是 Google BigQuery?
Google BigQuery 是构建在 Google Cloud Platform(GCP)之上的全托管、无服务器数据仓库。它专为高速存储和分析海量数据集而设计,让企业无需自行管理任何基础设施,就能在数秒内查询 TB 级数据,在数分钟内查询 PB 级数据。
BigQuery 最初脱胎于 Google 内部的 Dremel 技术,这是一套能够在数万亿行数据上实现快速分析的查询引擎。BigQuery 于 2010 年 5 月的 Google I/O 上首次公布,并在 2012 年正式全面开放。此后,它成为全球应用最广泛的云数据仓库解决方案之一,服务的客户横跨零售、金融、航空和数字营销等多个行业。
简单来说:BigQuery 是一个可以让你倾倒海量数据的地方,并能在其上快速、低成本地运行复杂的 SQL 查询,而无需操心服务器、索引或数据库管理。
一句话概括 BigQuery
BigQuery 是 Google 的云端数据仓库,一个可扩展的无服务器平台,用于存储结构化与非结构化数据,并支持使用标准 SQL 进行查询。
Google BigQuery 如何运作?
BigQuery 在技术上令人印象深刻之处,在于其底层架构将存储与计算彻底分离。大多数传统数据库在读取、写入和分析操作之间共享资源,这在规模扩大时会造成瓶颈。BigQuery 通过完全解耦这两层来解决这个问题。
核心架构
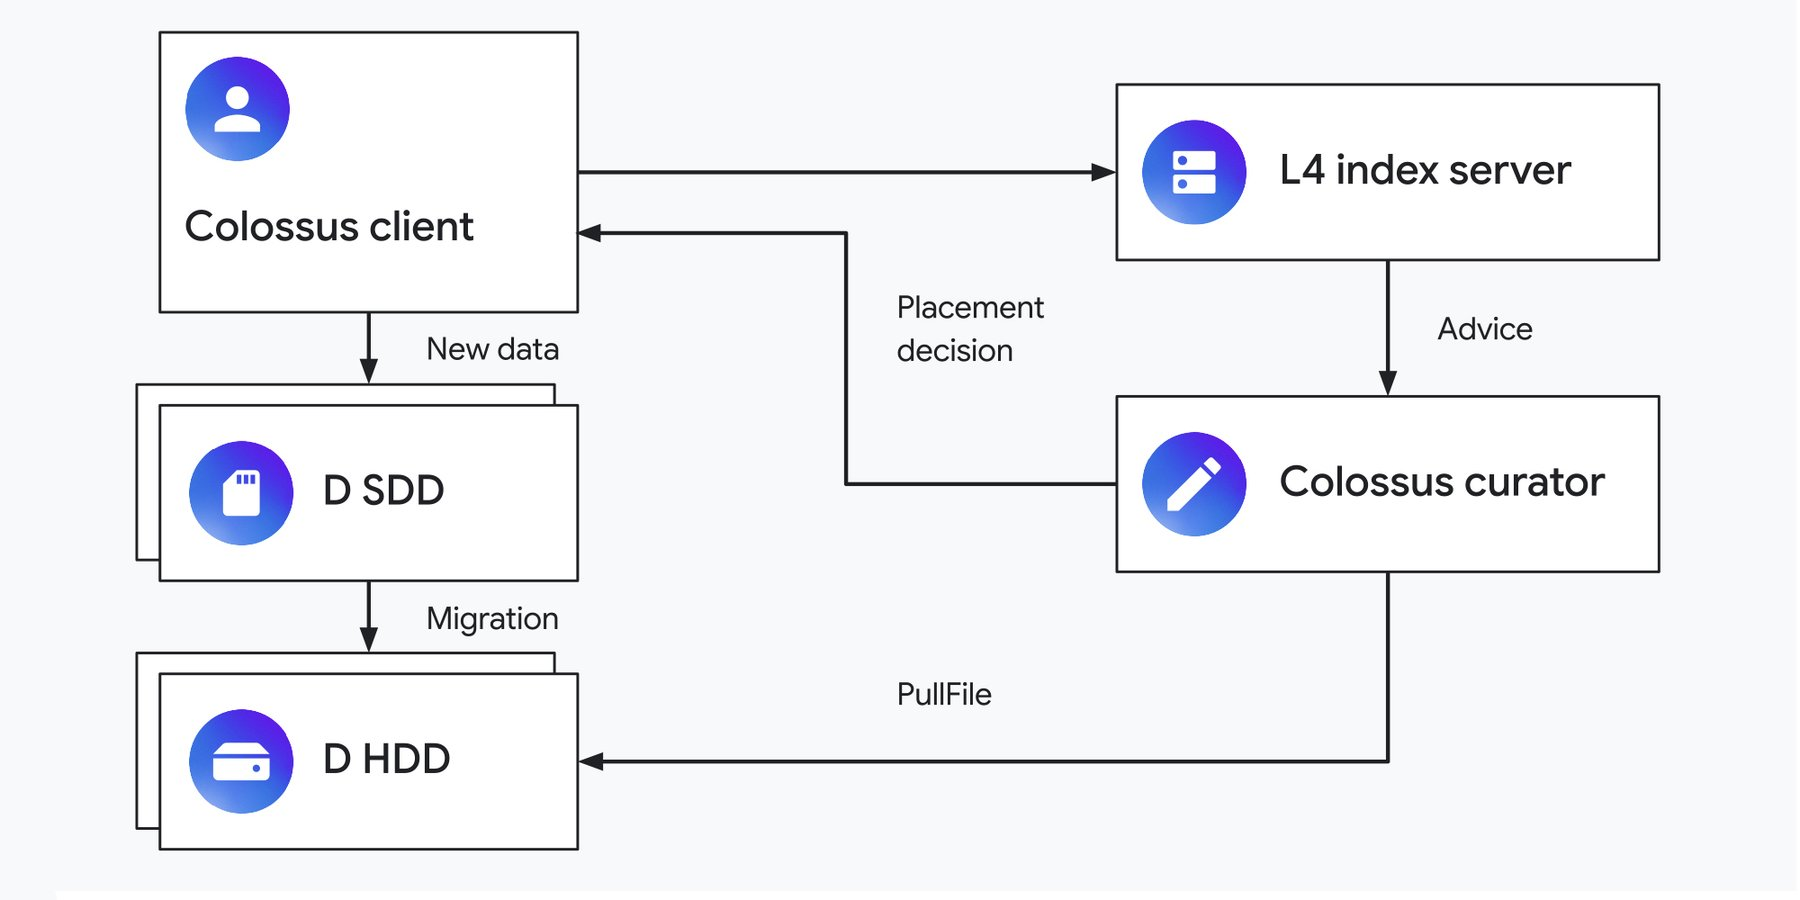
Colossus(存储) BigQuery 使用名为 Capacitor 的列式格式,将数据存储在 Google 的分布式文件系统 Colossus 中。列式存储意味着查询不必读取整行数据,只扫描所需的特定列,从而大幅减少处理的数据量,提升速度并降低成本。
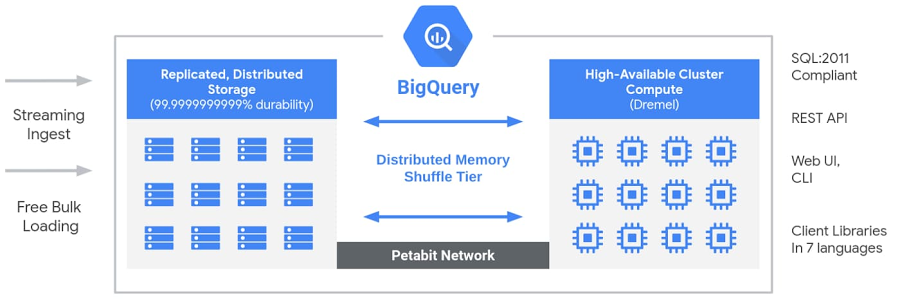
Dremel(查询引擎) 当你在 BigQuery 中运行 SQL 查询时,查询会被传递给 Dremel 引擎,后者将其拆分为更小的子任务,并同时分发到数千台机器上。正是这种并行处理,让 BigQuery 能在数秒内从数十亿行数据中返回结果。
Jupiter(网络) 由于存储与计算相互分离,BigQuery 依靠 Google 的 Jupiter петabit 级网络,在 Colossus 存储层与 Dremel 查询层之间以极高速度、极低延迟搬运 TB 级数据。
Borg(集群管理) Borg 是 Google 内部的集群管理系统,负责为 Dremel 作业分配计算容量、在数千台机器上运行作业,并处理容错,确保个别机器故障不会中断你的查询。
这套架构组合在一起,意味着 BigQuery 无需你做任何操作就能动态扩展资源;而且存储层或计算层的升级可以各自独立推出,不会产生停机时间。
一次查询的实际执行过程
当你向 BigQuery 提交 SQL 查询时,会依次发生以下步骤:
• 查询由 BigQuery 的客户端接口(网页界面、命令行工具或 API)接收
• Borg 为该作业分配计算容量(称为「slots」)
• Dremel 将你的 SQL 转换为多层执行树,把子查询分发到众多工作节点
• 工作节点通过 Jupiter 网络,仅从 Colossus 读取相关的列式数据
• 结果沿执行树逐层汇总,最终返回给你
即便面对数十亿行数据,整个过程也能在数秒内完成,这是传统关系型数据库无法做到的。
Google BigQuery 的核心功能
无服务器架构
没有需要预配的服务器,没有需要安装的数据库软件,也没有需要维护的索引。Google 自动处理所有底层基础设施、扩展与维护工作。你只需为实际使用量付费。
支持标准 SQL
BigQuery 使用符合 ANSI 标准的 SQL,任何具备常规数据库经验的人都能上手。你不需要学习专有查询语言或专用工具,就能从数据中挖掘价值。
可扩展性
BigQuery 可从 GB 级扩展到 PB 级,无需你做任何配置调整。无论你是只有几百万行数据的初创公司,还是拥有数千亿行数据的大型企业,使用的都是同一套界面。
内置机器学习(BigQuery ML)
BigQuery 内置 BigQuery ML,数据团队可以直接用 SQL 查询创建和训练机器学习模型,无需将数据导出到单独的机器学习平台。
实时分析
BigQuery 支持流式数据摄取,意味着数据可以持续写入并几乎立即被查询,这对实时看板和时效性强的报告非常有用。
与 Google Cloud 及第三方工具集成
BigQuery 原生对接 Google Cloud 生态的其余组件,包括 Looker、Vertex AI、Cloud Storage、Dataflow 和 Pub/Sub。它还可通过标准的 JDBC/ODBC 连接器与 Tableau、Power BI 等第三方 BI 工具集成。
按量付费定价
BigQuery 的定价基于两个维度:存储(你保存了多少数据)和计算(你的查询扫描了多少数据)。它提供免费额度,包含 10 GB 存储和每月最多 1 TB 查询量,超出部分才开始计费。
Google BigQuery 与 Google Search Console:SEO 从业者为何最终会用到它
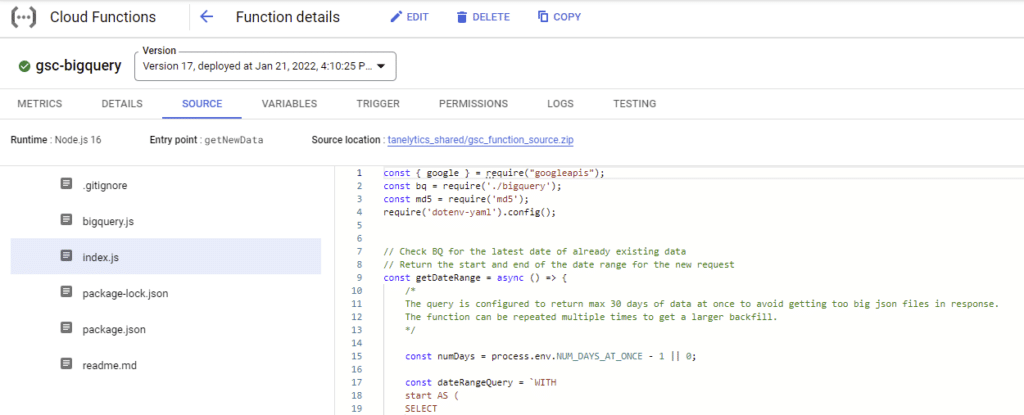
Google Search Console(GSC)是大多数 SEO 了解自然搜索表现的主要工具,用于按查询词和 URL 追踪展示量、点击量、CTR 和平均排名。但 GSC 存在众所周知的限制,让所有做规模化工作的人倍感沮丧:
• 标准界面一次只显示排名前 1,000 的查询词
• 数据最多只保留 16 个月,导致无法在完整历史深度上做同比对比
• 筛选受限,每个维度只能用一个筛选条件。例如,你无法在界面中同时按国家、设备和查询词进行筛选
• 原生只能按天分组,无法按周或按月分组
• 不支持跨资源分析(对比多个 GSC 账户)
为了绕开这些限制,Google 在 2023 年初推出了一项功能:
批量数据导出至 BigQuery
GSC 到 BigQuery 的导出如何运作
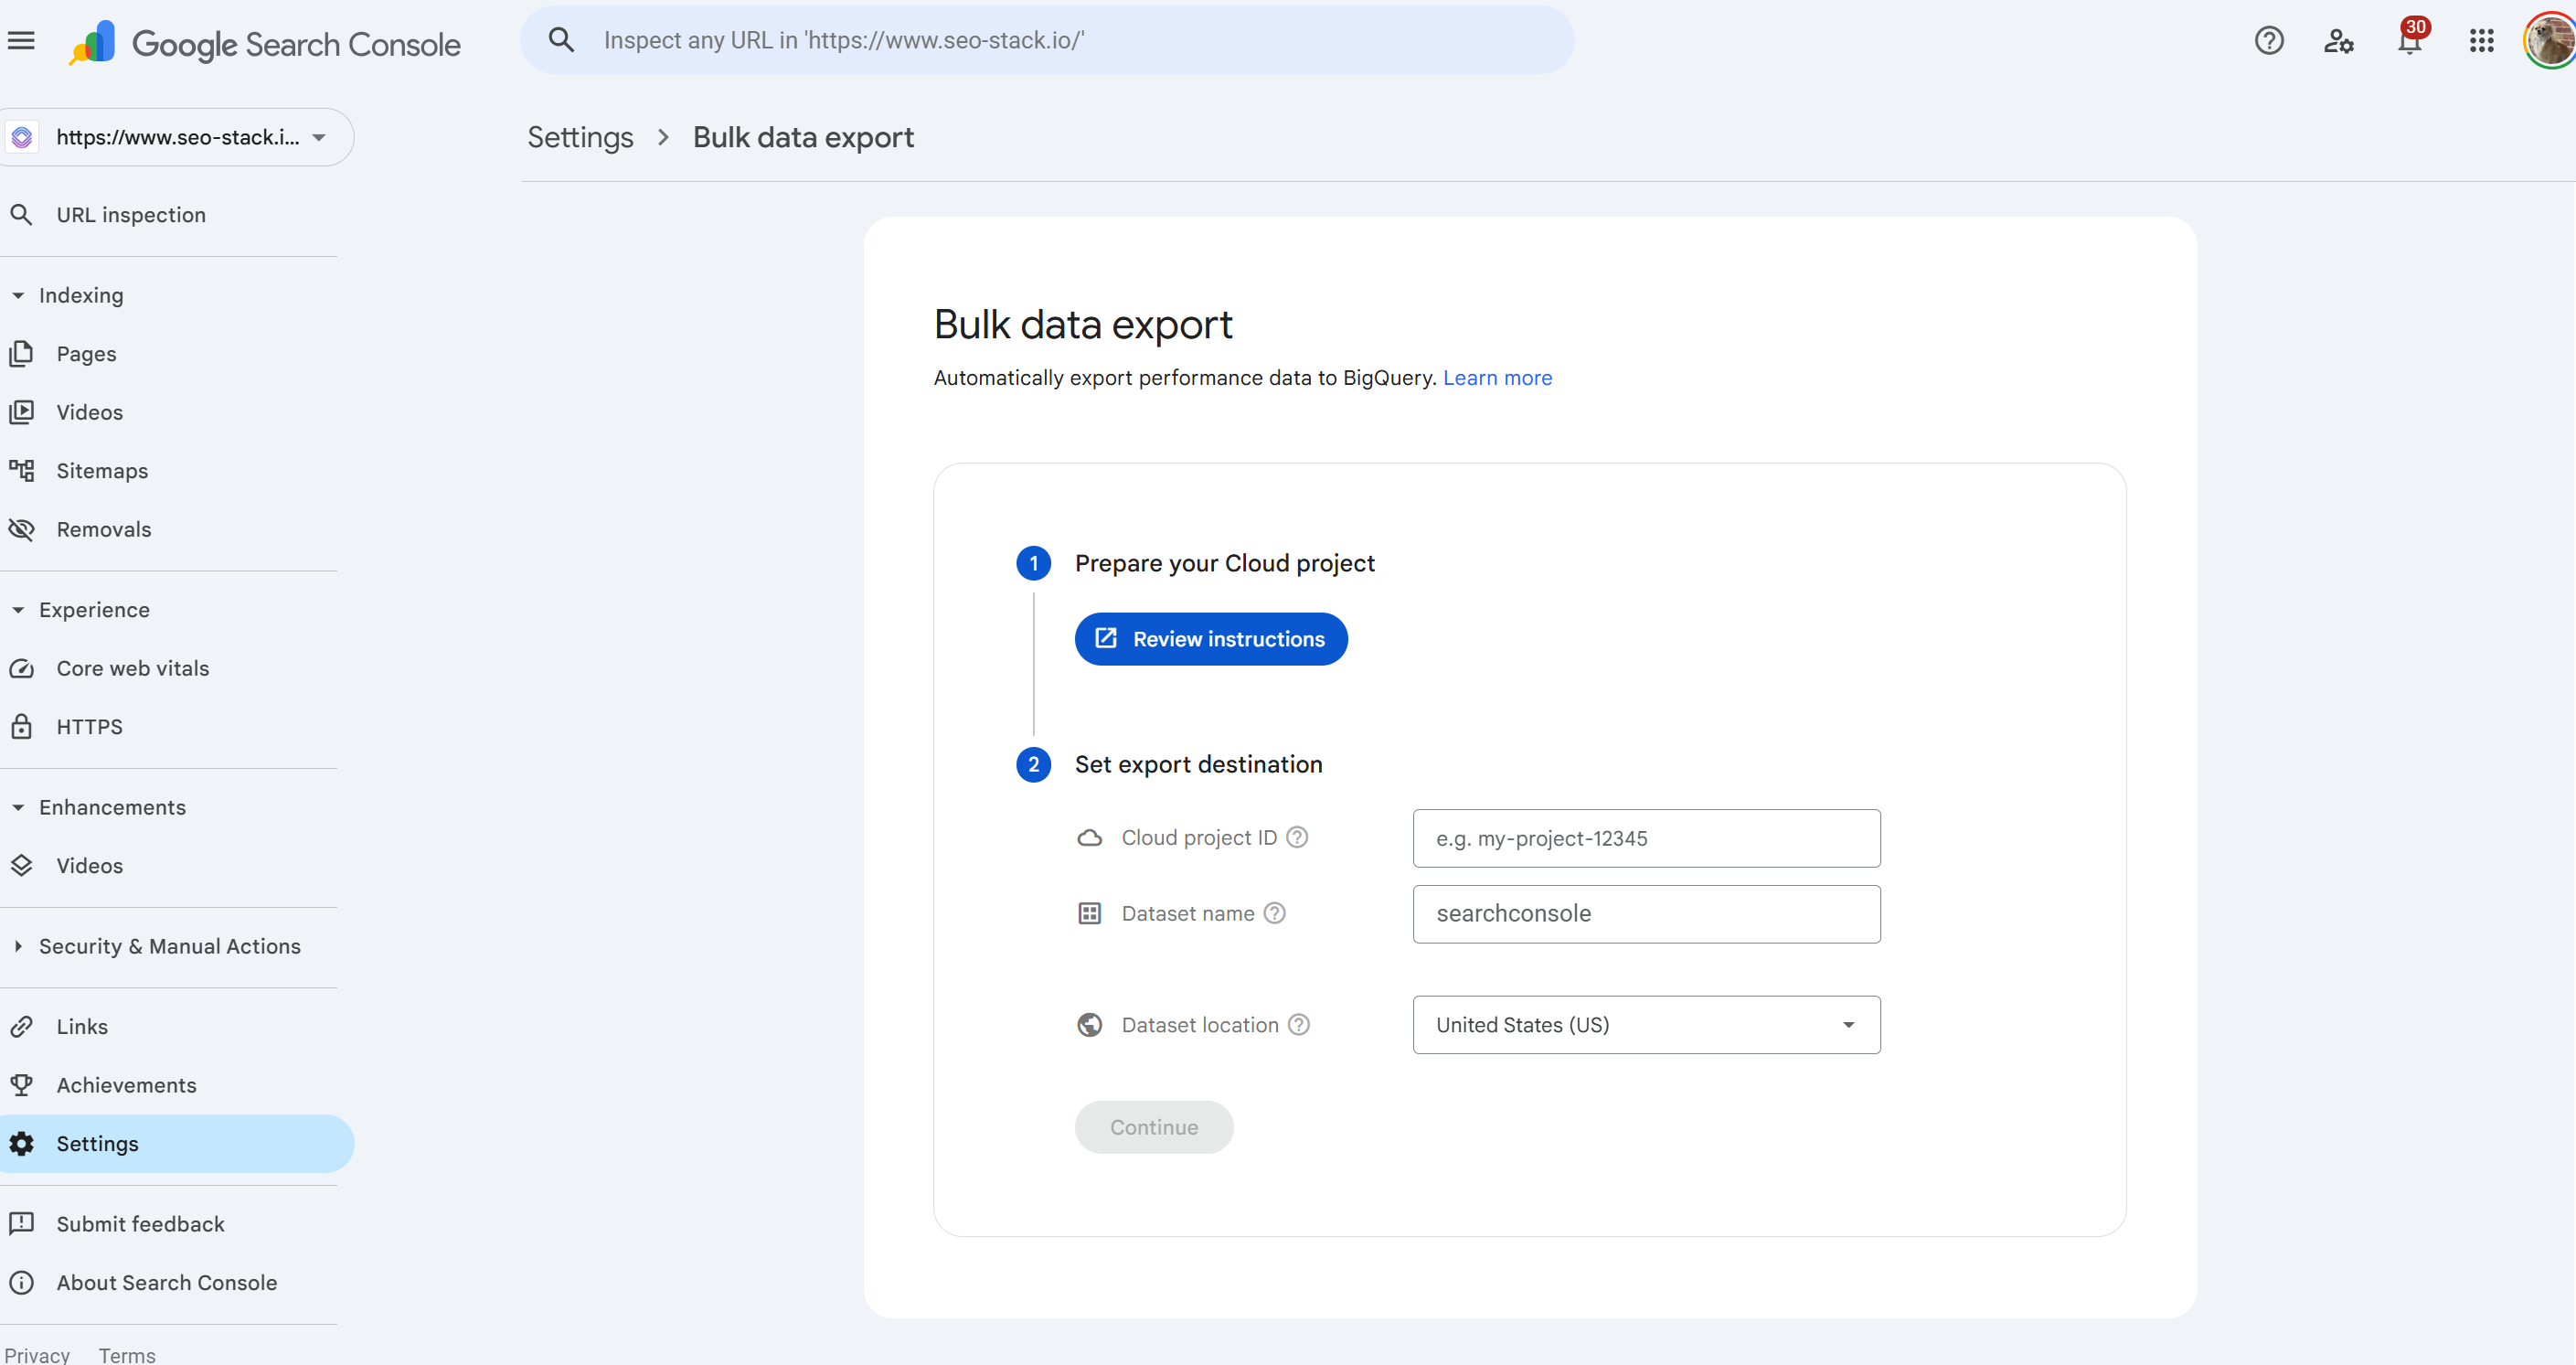
Google Search Console 现在允许资源所有者配置每日定时导出,将全部效果数据(包括标准 GSC 界面中看不到的数据)直接导出到 BigQuery 项目中。这解除了行数限制,让你可以访问标准界面省略的匿名化查询数据,并能无限期保留数据。
理论上,这听起来是理想方案。但实际操作中,配置它需要:
• 一个已启用结算功能的 Google Cloud Platform(GCP)账户
• 一个专门为此目的配置的 Google Cloud 项目
• 手动在 GCP Console 中启用 BigQuery API 与 BigQuery Storage API
• IAM 权限,你必须在项目中为 Search Console 服务账号(search-console-data-export@system.gserviceaccount.com)同时授予 BigQuery Job User 和 BigQuery Data Editor 两个角色
• 需要资源所有者权限在 Search Console 中,只有所有者(而非完整用户)才能发起批量导出
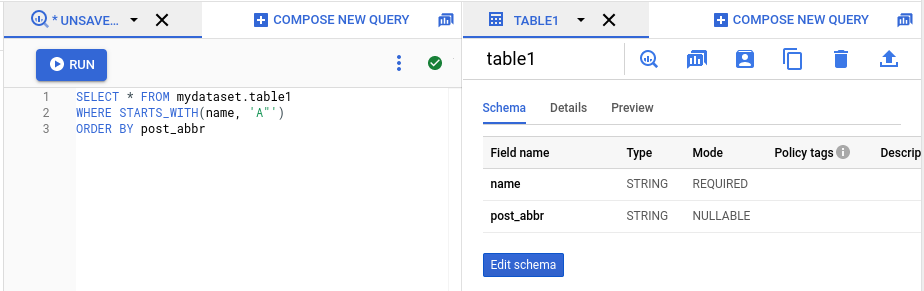
• SQL 知识数据进入 BigQuery 后,并没有报表界面。要真正读取你的数据,你必须手动编写 SQL 查询
而且在完成所有这些配置之后,首次导出最多需要 48 小时,数据只会从配置完成的时间点开始累积(该集成不支持回溯),而你面对的仍是一个原始数据仓库——没有可视化层、没有保存好的报表,也没有内置的 SEO 专属指标或洞察。
核心问题: Google Search Console 会把原始数据导出到 BigQuery,但 BigQuery 不提供统一界面、没有 SEO 专属报表,也没有分析层。你拿到的是一堆数据,而不是一个工具。
用 GSC + BigQuery 仍然做不到的事
即便完成了配置,GSC–BigQuery 集成仍存在明显缺口:
• 没有仪表盘——你看到的是原始数据表,而不是报表
• 原生不支持跨多个 GSC 账户的跨资源查询
• 首次导出日期之前的历史数据无法获取——16 个月的 GSC API 窗口是你唯一的来源
• 每一项洞察都需要自定义 SQL——没有预建的 SEO 报表、没有趋势预警,也没有开箱即用的 AI 分析
• 它有实实在在的成本:存储和计算费用会不断累积,在企业级场景下尤其明显,大型站点每天会产生数百万行数据
• 架构变更可能导致导出中断——表结构的改动会引发失败,需要人工介入处理
简而言之:GSC–BigQuery 管道对数据工程师来说是一个强大的起点,但它不是一个 SEO 工具。它需要技术配置、持续维护、SQL 能力,以及大量投入才能把原始数据转化为可执行的洞察。
SEO Stack:为 SEO 打造的数据仓库
这正是 SEO Stack 要解决的问题。
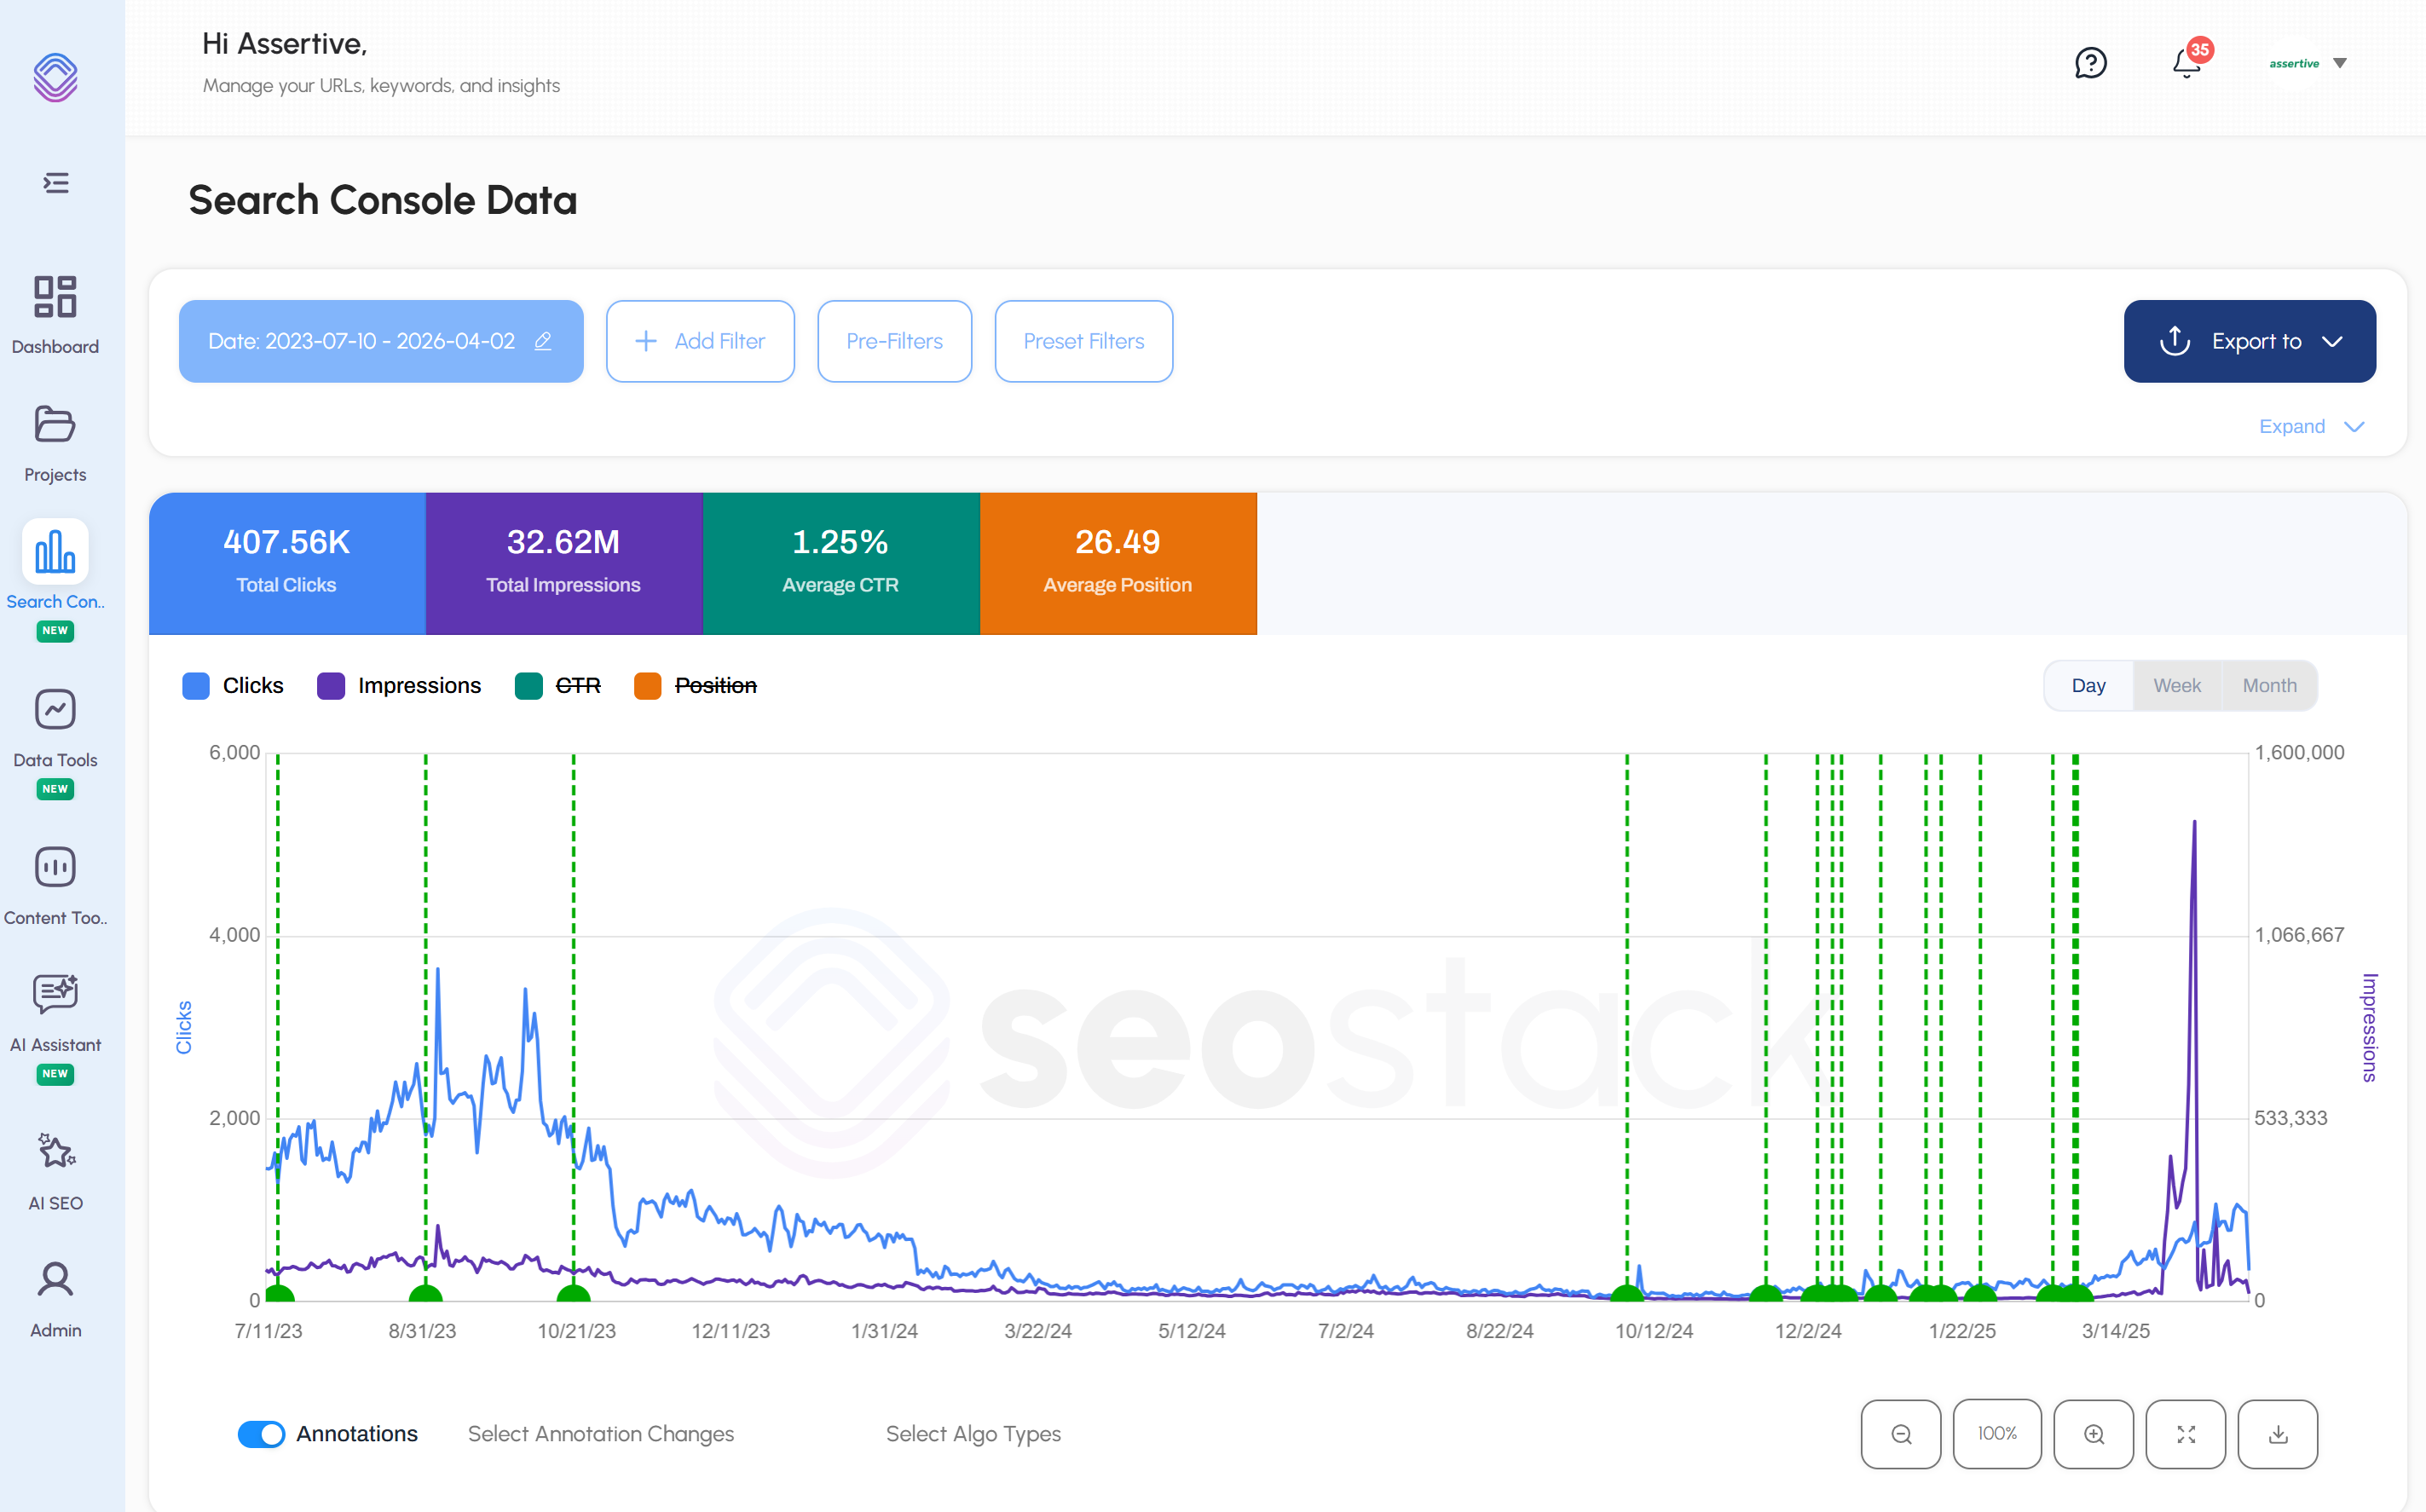
SEO Stack 是一个专为 SEO 打造的数据仓库与分析平台。与 BigQuery 一样,它会独立存储你的 Google Search Console 数据——意味着不会丢失数据、没有 16 个月上限,从连接那一刻起就完整保留历史数据。但与 BigQuery 的方案不同,它不需要任何技术配置、不需要 SQL 知识,也不需要管理基础设施。
SEO Stack 的不同之处
• 无需配置——连接你的 GSC 账户,数据立即开始同步。无需 GCP 账户、无需启用 API、无需 IAM 权限、无需配置结算。
• 统一界面——所有内容都在一个一致的、以 SEO 为核心的仪表盘中。你的数据不是等待查询的原始数据表,而是已经整理成你真正需要的报表。
• 独立数据仓库——SEO Stack 不是一个即时重新拉取 GSC 数据又随即丢弃的 API 封装层。你的数据存储在 SEO Stack 自有的仓库中,带来真正的历史连续性,让你能够追踪 GSC 界面根本无法呈现的长期趋势。
• AI 驱动的分析——你不必再编写 SQL 来挖掘洞察,SEO Stack 的 AI 助手会分析你的数据,自动呈现有价值的模式、异常和机会。
• 无需 SQL——高级用户可以随心所欲地切分和筛选数据,但你不需要懂任何一行 SQL 就能从数据中获得价值。这个界面是为 SEO 而建,不是为数据工程师。
• 多资源支持——在一个账户中管理和对比多个 GSC 资源的数据,无需任何额外配置。
• 4,000+ 用户的信赖之选——其中包括 Sage、Sytner 和 Printful 等企业客户。
SEO Stack 与自建 BigQuery 方案对比
以下是针对这两条路线的客观对比:
• 配置时间: BigQuery 需要在两个平台上花费数小时进行技术配置。SEO Stack 只需几分钟。
• 技术门槛: BigQuery 需要管理 GCP 账户、IAM 角色和 SQL。SEO Stack 除了你的 GSC 登录之外什么都不需要。
• 成本: BigQuery 会按存储量和你运行的每一次查询收费。SEO Stack 是固定订阅费,不会出现意外的用量账单。
• 界面: BigQuery 提供的是原始数据仓库。SEO Stack 提供的是专门打造的 SEO 分析平台。
• 洞察: BigQuery 只会返回你的 SQL 查询所得的结果。SEO Stack 会自动呈现 AI 生成的洞察。
• 历史数据: 两者都会从连接时间点起无限期保留数据。两者都无法提供配置之前的数据。
如果你是拥有热爱 SQL 的工程师的企业数据团队,BigQuery 是出色的原始存储层。如果你是一名 SEO——无论是企业内部、代理商还是顾问——希望在一个强大、开箱即用的界面中获取完整的 GSC 数据,又不想承担工程开销,那么 SEO Stack 能提供 BigQuery 对 SEO 而言的全部价值,却不带任何复杂性。
Google BigQuery 用来做什么?常见使用场景
除 SEO 之外,BigQuery 被广泛应用于各类分析工作流:
大规模数据仓库
企业把来自多个来源的数据——CRM 系统、营销平台、事务型数据库、应用分析——整合到一个 BigQuery 仓库中,形成对业务表现的统一视图。
商业智能与报表
BigQuery 可以连接 Looker、Tableau 以及 Google 自家的 Looker Studio 等 BI 工具,为全公司的高管仪表盘和运营报表提供支撑。
数字营销分析
营销人员使用 BigQuery 关联来自 Google Ads、Google Analytics 4、Search Console 以及第三方广告平台的数据,构建归因模型并分析跨触点的完整客户旅程。
机器学习
BigQuery ML 让数据团队可以直接在仓库中使用 SQL 构建、训练和部署机器学习模型,无需单独搭建 ML 基础设施。
实时分析
借助 BigQuery 的流式写入能力,并结合 Google Pub/Sub 和 Dataflow,企业可以搭建近实时的分析管道,从实时数据流中提取洞察。
Google BigQuery 适合你吗?
BigQuery 确实是一个强大且高性价比的方案——但它是为数据工程团队设计的,而不是终端用户。在以下情况下它最有意义:
• 你有专门的数据工程或分析团队,熟悉 SQL 和 GCP
• 你处理的是跨多个来源的超大规模数据集,需要关联在一起进行分析
• 你需要定制化的 ML 能力,或希望构建专属的分析应用
• 你已经深度投入 Google Cloud Platform 生态
反过来,如果你是 SEO 从业者或团队,希望从 Google Search Console 数据中获得更多价值——保留历史数据、获取完整数据访问权限、得到有意义的洞察,同时不想承担工程开销——那么像 SEO Stack 这样专门打造的平台能让你更快达成目标,成本更低,用户体验也好得多。
总结
Google BigQuery 是世界一流的数据仓库平台,从根本上改变了企业处理大规模分析的方式。它的无服务器架构、SQL 兼容性以及与 Google Cloud 生态的紧密集成,使其成为企业数据团队的天然归宿。
对 SEO 而言,最相关的应用是 BigQuery 与 Google Search Console 的集成——支持批量数据导出,从而突破标准 GSC 界面的限制。但这项集成伴随着不小的技术门槛:GCP 配置、IAM 设置、SQL 查询,以及缺乏内置的 SEO 报表层。
SEO Stack 的诞生,正是为了兑现 BigQuery 方案所承诺的一切——无限的 GSC 历史数据、独立的数据仓库、强大的分析能力——但它以一个统一平台的形式呈现,任何 SEO 从第一天起就能上手。无需配置,无需 SQL,没有意外。

SEO Stack 创始人
Daniel 是 SEO Stack 的创始人。他在技术 SEO 和搜索数据领域深耕二十余年,在客户项目中一次又一次撞上 Search Console 的同样限制后,他着手打造了 SEO Stack。
Daniel 拥有丰富的 SEO 经验,创办过 SEO 代理机构、审计业务以及一家发展良好的咨询公司。业余时间里,Daniel 喜欢做 SEO 实验并分享实验结果。
发布于 2026年4月2日


