GEO 与 AI 提示词可见性的问题
先说明一下,我做 SEO 已经超过 25 年了。这个行业能想到的每一轮周期——炒作、恐慌、改头换面,最后归于平常——我都亲眼见过。从……
先说明一下,我做 SEO 已经超过 25 年了。这个行业能想到的各种周期——炒作、恐慌、改名、最后归于平常——我都见过。
从痴迷 PageRank,到外链建设的猎巫行动,到"内容为王"(加冕典礼我还在等),再到 RankBrain 当初号称要怎么改变我们所有人。
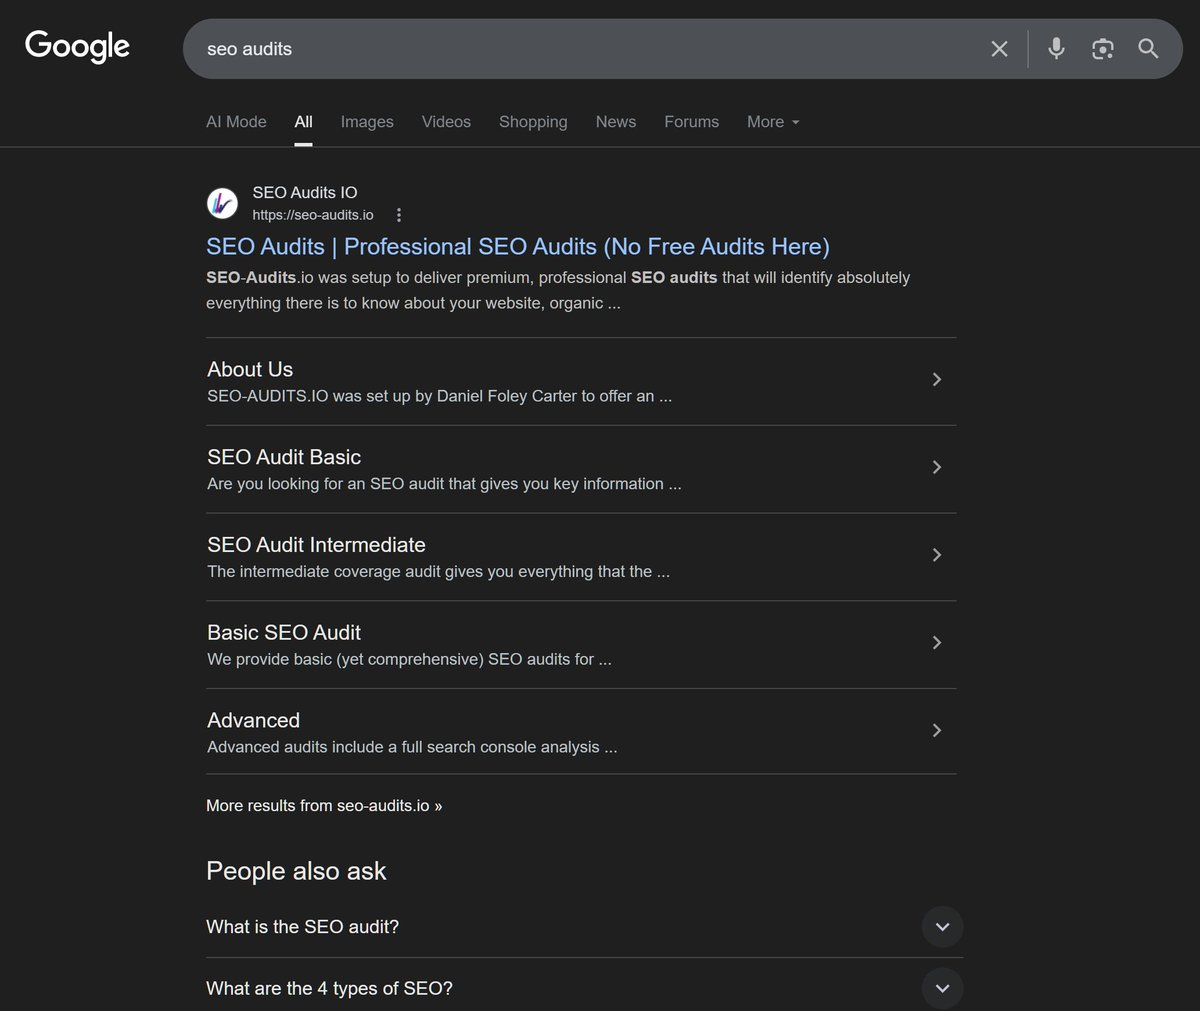
从 Google 的 Bigdaddy 更新,一直看到 EMD 之死(是啊,才怪,Google 现在还是喜欢得很,不信你搜搜 Google "SEO Audits",应该能看到我的 EMD 排名)
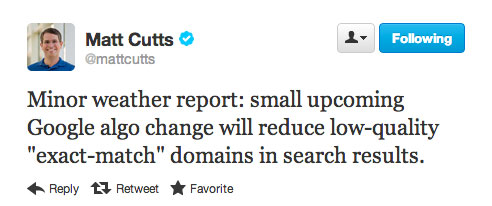
真怀念 Matt Cutts 啊
扯远了。总之,现在又如期而至,我们迎来了最新一轮身份危机:Generative Engine Optimisation,也就是 GEO。或者 AEO。或者 LLM-SEO。随你挑哪个缩写,总有某个顾问准备好拿它来卖你一份长期服务合同。
我随手做了这个,你们觉得怎么样?
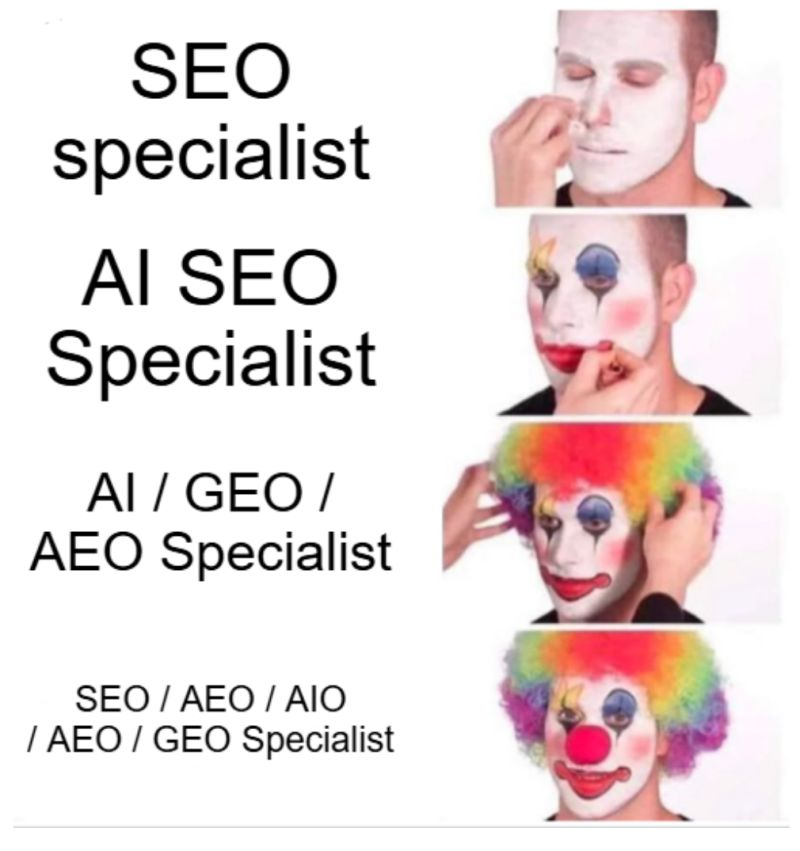
下面我就具体讲讲,为什么我认为围绕 GEO 的很多喧嚣要么为时过早,要么具有误导性,要么两者皆是。
平台问题:你追踪的不是一个对象,而是五个,甚至六个?
这里有一个根本性问题,似乎没人愿意正面回答。
传统 SEO 只有一个主导平台:Google。没错,还有 Bing。没错,当年还有 Yahoo。但现实点说,只要你在 Google 上排名不错,你的 SEO 就算做到位了。衡量方式、工具、策略——全都聚焦在同一个目标上。
这非常简单:你要么花钱在 Google 上投广告,要么在 Google 上做排名,要么两者都做。
GEO 没有这种便利。
ChatGPT 目前占据 AI 聊天机器人市场约 68% 的份额,但这相比十二个月前的 86.7% 已大幅下滑。来源:Vertu
同期,Google Gemini 从 5.7% 猛增到 21.5%。
来源:ALM Corp
与此同时,Perplexity 在走自己的路线,Grok 从 X 的实时社交数据洪流中取材,而 Claude 则运行在完全不同的训练与检索逻辑之上。这些平台各有自己的预训练数据、自己的 RAG 配置、自己的引用行为,以及自己决定什么内容被展示、什么内容不被展示的方式。
另外别忘了:
1. LLM 有各种不同的模型,而且一直在变?这一刻是 chatGPT 4o,下一刻是 5.2,再然后是 5.3,或者你用的是 Sonnet 或 Opus(很快还会有 mythos)
2. 个性化/记忆——这会带来很大差异
3. 地理位置
4. 内容生成并非线性或稳定一致,它会变化
更要命的是:研究显示,你问 ChatGPT 还是问 Perplexity,89% 的引用结果是不同的。来源:Exposure Ninja
所以当一家 GEO 机构告诉你,他们要"优化你品牌的 AI visibility"时,问问他们是哪个 AI,因为这个答案极其重要,而且根本不存在统一的打法。
你或许可以这样问他们:
除了 SEO 之外,你们具体会做哪些 GEO 工作?
你们如何衡量效果?
不同追踪平台之间"可见度"分数差异巨大,你们怎么应对?
记住,你追踪的不是一个搜索引擎。做 GEO 的人是在试图为五个不同的黑箱做优化,它们有五套不同的算法、五种不同的数据源、五种不同的"性格"(这还是假设他们只盯着主流玩家,没有再往外扩展到 deepseek 之类的)
查询长度问题:欢迎来到提示词追踪的蛮荒西部
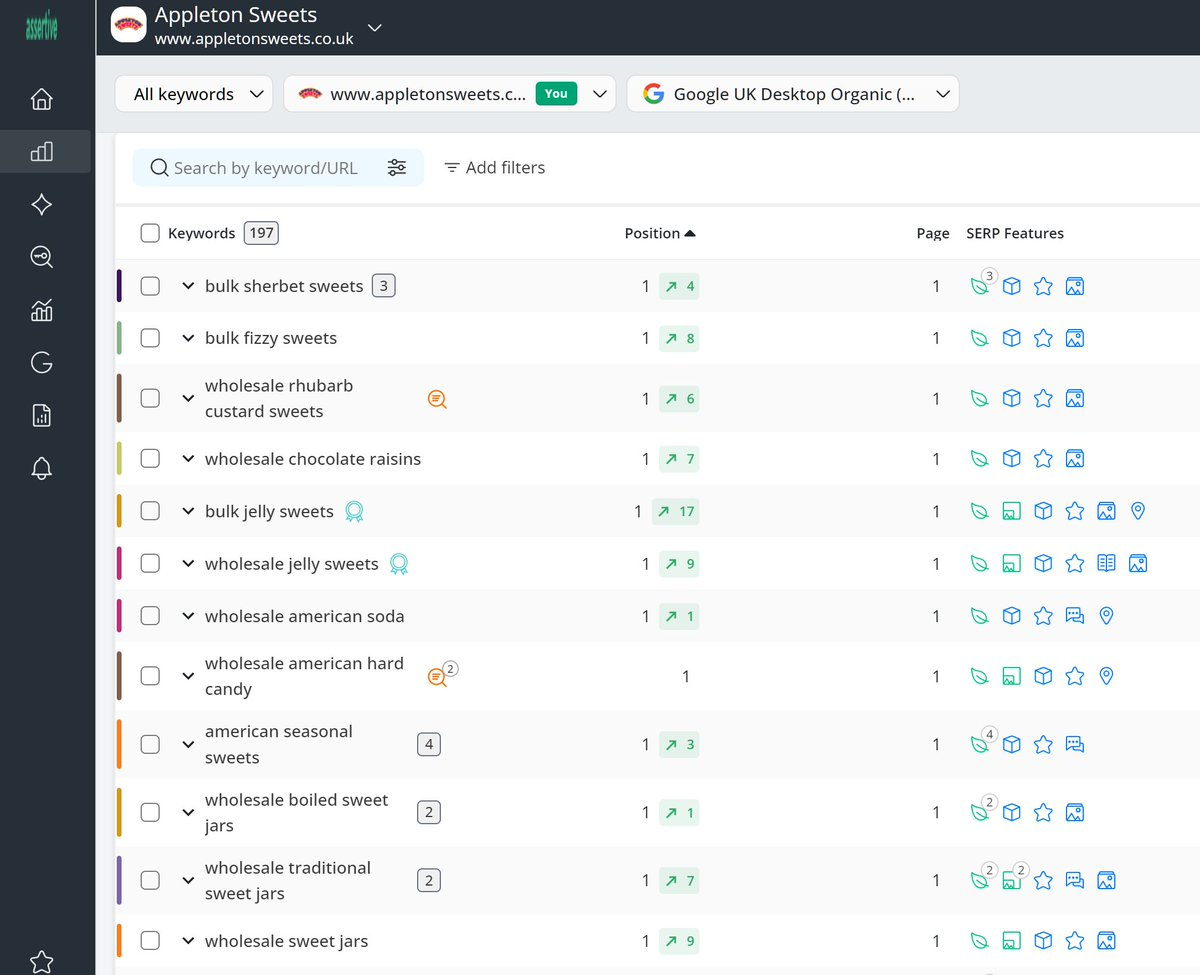
在传统 SEO 里,排名追踪工具对较短、明确的关键词组合效果极好。"SEO consultant London"。"Buy running shoes UK"。干净、可重复、可追踪。你把它们丢进 Semrush 或 Ahrefs、AWR、SERanking,每周查一次排名,给客户出报告,皆大欢喜。
我们当年用的是 AWR,非常棒的平台!但现在我们把所有追踪都迁到了
www.seo-stack.io,因为这是我们自己的产品,也因为它能追踪大 G 前 100 名结果里的一切。
AI 用户不是这么搜索的。使用 ChatGPT 或 Perplexity 的人可能会输入:"英国有哪些专精企业级技术 SEO、并且有数据仓库平台经验的最佳 SEO 顾问?"
那你告诉我,这要怎么追踪?
你在 GEO 追踪工具里填什么提示词?
因为查询越长,这条完全相同的查询被另一个人再次输入的概率就越低。
即便在传统的 Google 搜索中,每天也有约 15% 的搜索是从未出现过的查询(Kartikahuja),而那还是平均只有 3–4 个词的查询。把词数乘以五倍或十倍变成对话式 AI 提示词,独特查询的组合爆炸就使其在任何有意义的规模上都实际上无法衡量。
另外——想想 ZSV 查询(零搜索量)的庞大数量——即便是 AHREFS 和 SEMRUSH 这样全球最大的 SEO 工具,也只捕获了一小部分数据(下图对比了 SEO Stack、AHREFS 和 SEMRUSH 对我自己网站
的关键词统计数量)
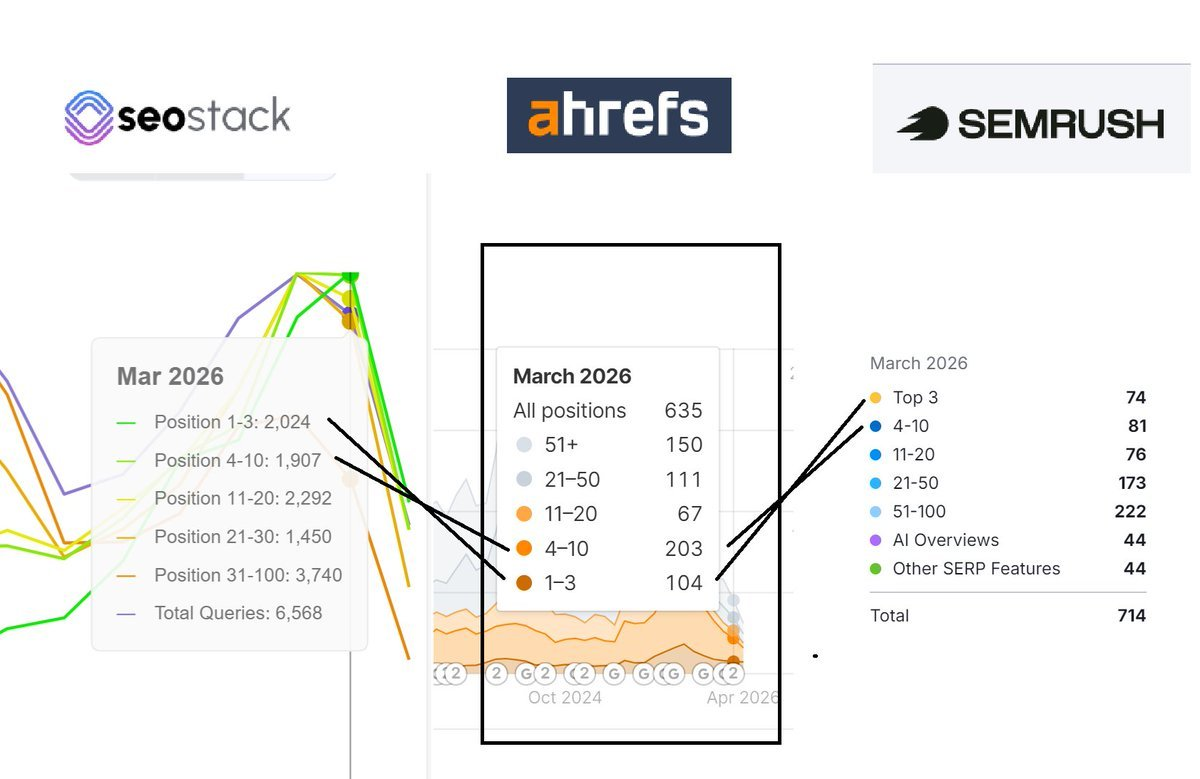
看看这数据量上的巨大差距!
AHREFS 和 SEMRUSH 毫无疑问是全球最大的 SEO 数据持有方(Search Console 除外)——但如果这些工具都漏掉了 70-80% 的被搜索查询,想想要追踪 AI 提示词/引用表现会是什么局面?
你大概可以加进 1000 条查询,其中很大一部分可能根本没人搜过?你完全有可能把整笔 GEO 预算,都砸在追踪那些根本没人搜索的查询表现上。
还有别忘了,GEO 工具的提示词搜索量数据到底是从哪来的?
Google 给了我们 Google Search Console
chatGPT、Gemini、Grok、Perplexity、Claude——目前都还没有一个带关键词数据的对等"search console 界面"。
提示词追踪工具是在试图从一个无限的宇宙中采样。
它们抓取少量查询,看看你的品牌有没有被提到,然后把这称为"可见度"。往好了说,这在方法论上还挺有意思。往坏了说,这是在收取真金白银的监测费用,却给客户一个意义甚微的数字。
唯一性问题:
大多数 AI 查询都是一次性事件
这一点承接上文,但值得单独成节,因为它确实很重要,而我觉得讨论得还不够多。
搜索查询越长,就越独特。这不是观点,而是基本概率。如果我追踪的是"SEO consultant",每个月有成百上千人在搜这个——而且至少我能看到那份数据。
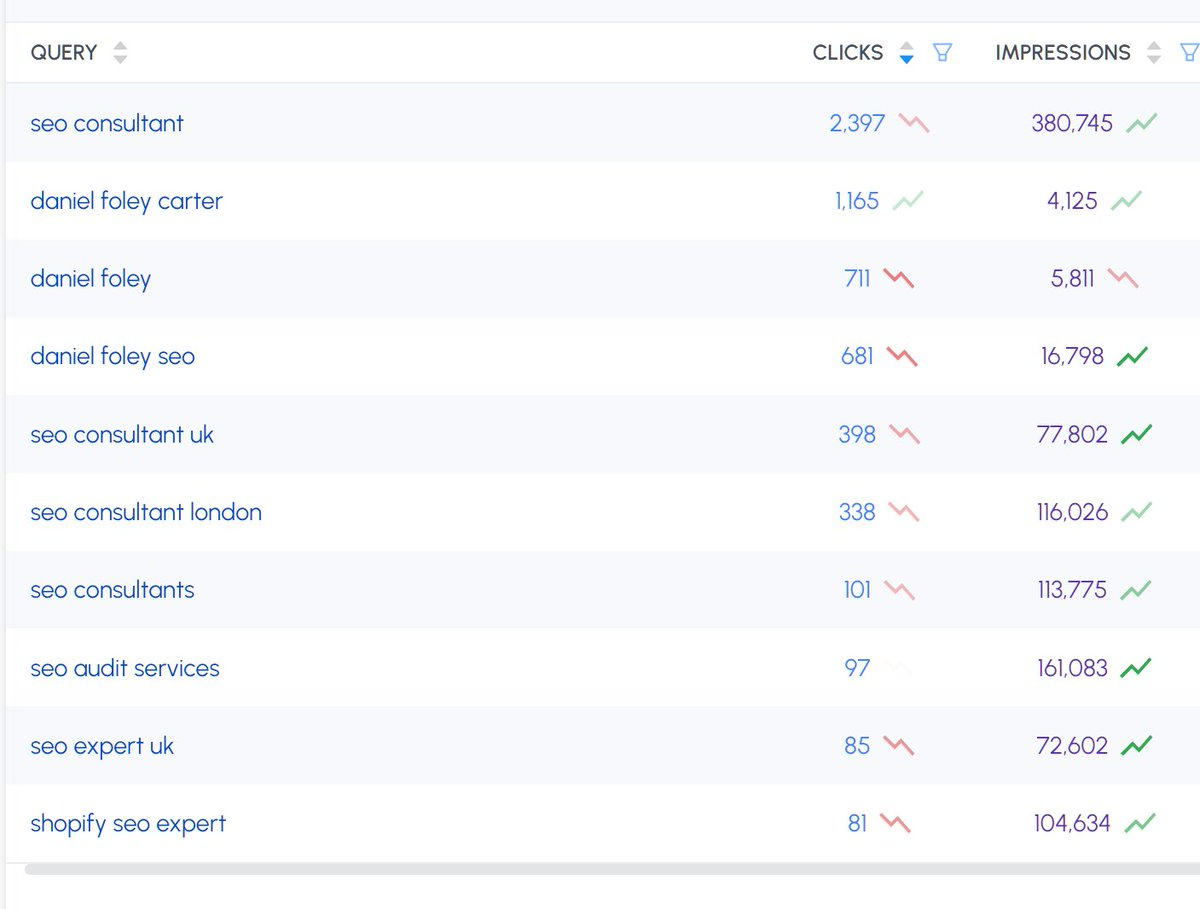
那是一个市场。但如果我追踪的是"如果我在运营一个面向美国中端市场企业的 B2B SaaS 平台,而且已经试过内容营销,我该雇哪家 SEO 顾问",这条查询今年可能只有三个人输入过,其中两个还是在为一篇关于 GEO 的博客文章做调研。
这对任何效果衡量框架都影响巨大。在 SEO 中,我们建立衡量体系的前提是:关键词的搜索量是真实且可重复的。
GEO 并不存在同样的对应物。即便你的品牌今天在某个 40 个词的 AI 提示词下被漂亮地引用,同一条提示词明天再被输入的概率也微乎其微,更别说是由一位潜在客户输入了。对任何想做严肃的效果报告的人来说,基于提示词的追踪里的信噪比都将是一个真正的问题。
分析数据的黑洞:没有数据,没有证明,(显然)也没问题
这里有个有意思的点。在 SEO 领域,我们有 Google Search Console。它并不完美,但它给我们展示次数、点击、平均排名、点击率。我们有 GA4。我们有 Ahrefs 和 Semrush 做竞品情报。我们确实能证明正在发生什么。
而我们还有 SEO stack,它融合了 GSC + GA4 的数据,让我们可以把 LLM 流量单独拆分出来(按来源网站或汇总查看)
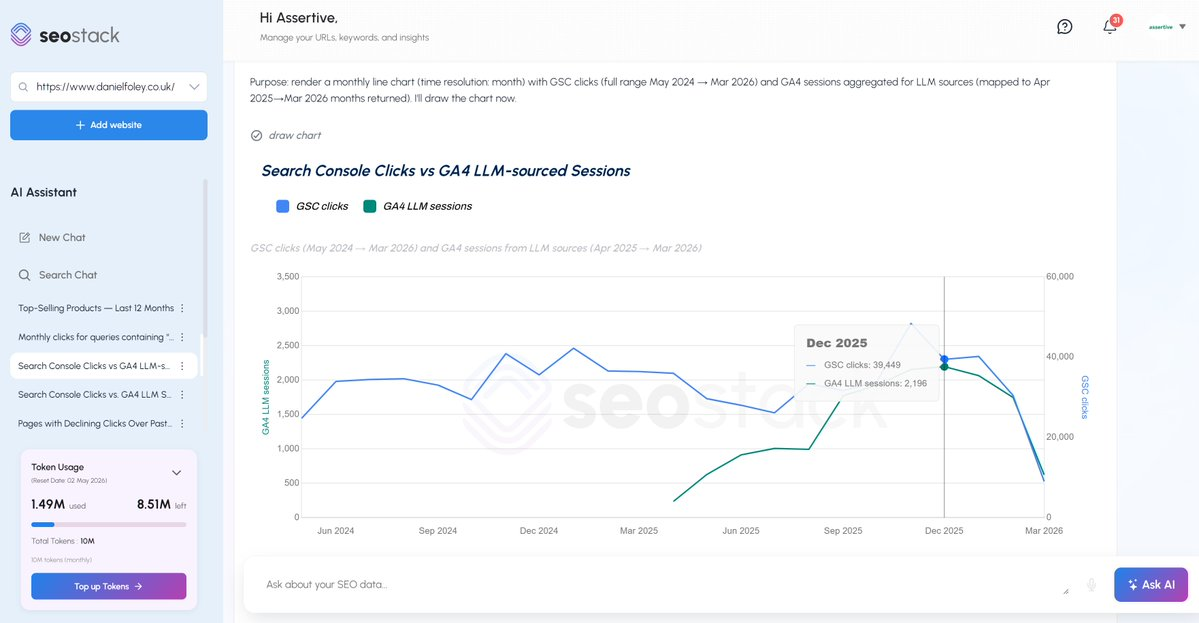
AI 平台给你的,恰恰是什么都没有。
AI 引荐流量目前仅占全球网页流量的 1%
来源:Exposure Ninja ,而且就连这一丁点流量也很难干净地归因,因为大多数 AI 平台并不会以任何一致的方式传递引荐数据。
OpenAI 不给你仪表盘。
Perplexity 没有 Search Console 的对应产品。
Claude 不会给你发月度效果报告。
你只能靠第三方工具去推断一切——这些工具对提示词做抽样,然后对引用频率做有根据的猜测。
所以当一家 GEO 代理商承诺“提升你的 AI Visibility”时,他们到底在衡量什么?
他们如何证明 ROI?如果答案是“我们在四个平台上跑了 500 条提示词,你被提及了 47 次”,那你应该追问:这在实际流量、线索和营收上意味着什么?
因为就目前而言,这种关联至多只能说是脆弱的。
还有,看看这个——这不是玩笑,这是真实数据!
这是某家网络媒体出版物来自 GA4 的 LLM 流量 >
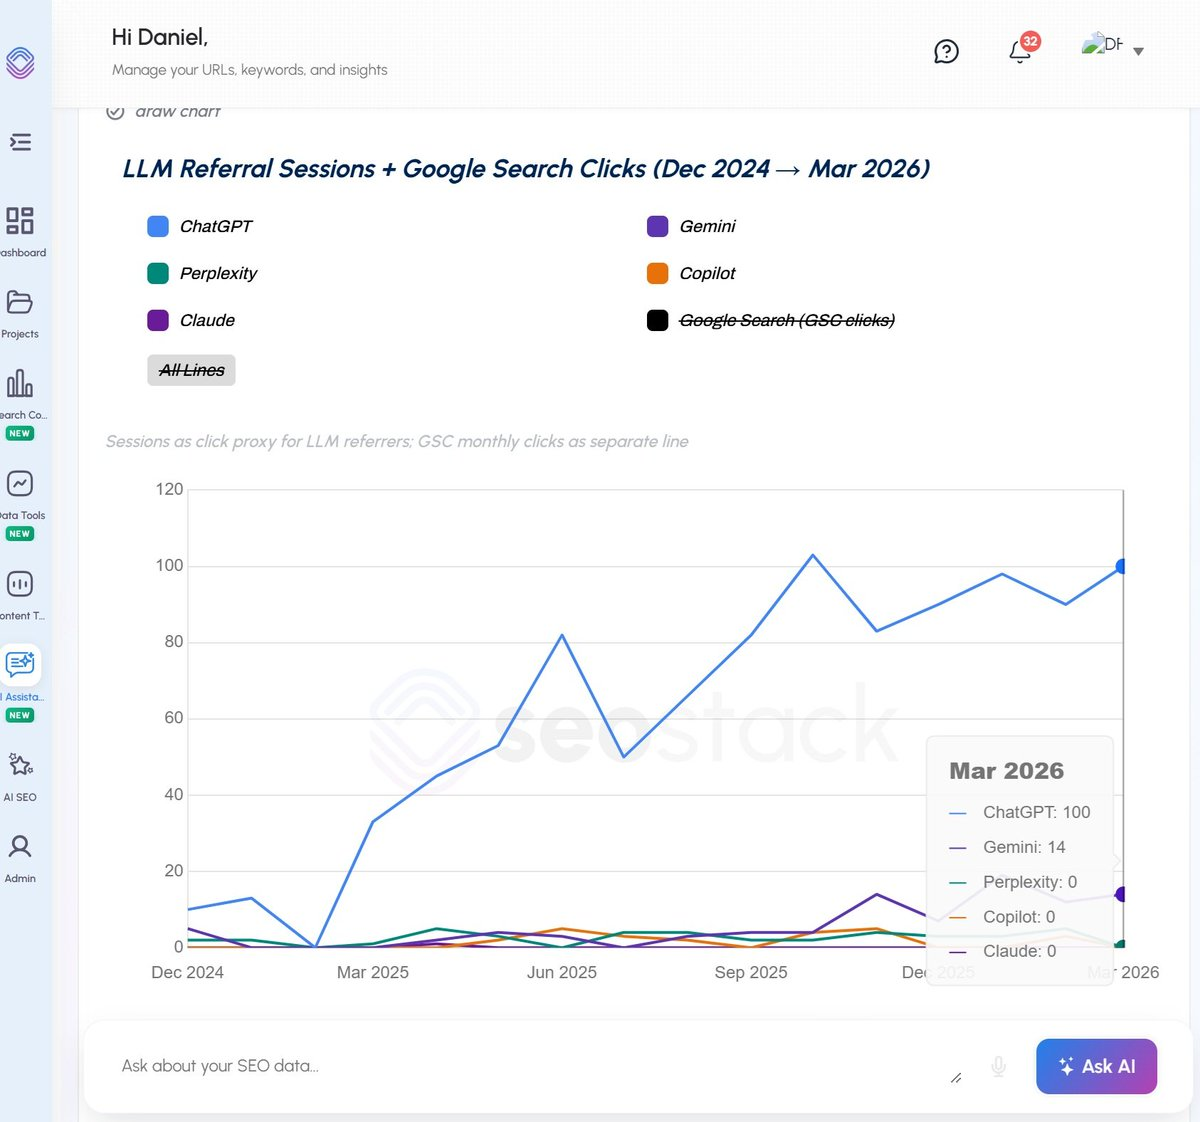
然后,当我把 GSC 点击数也加进来时:
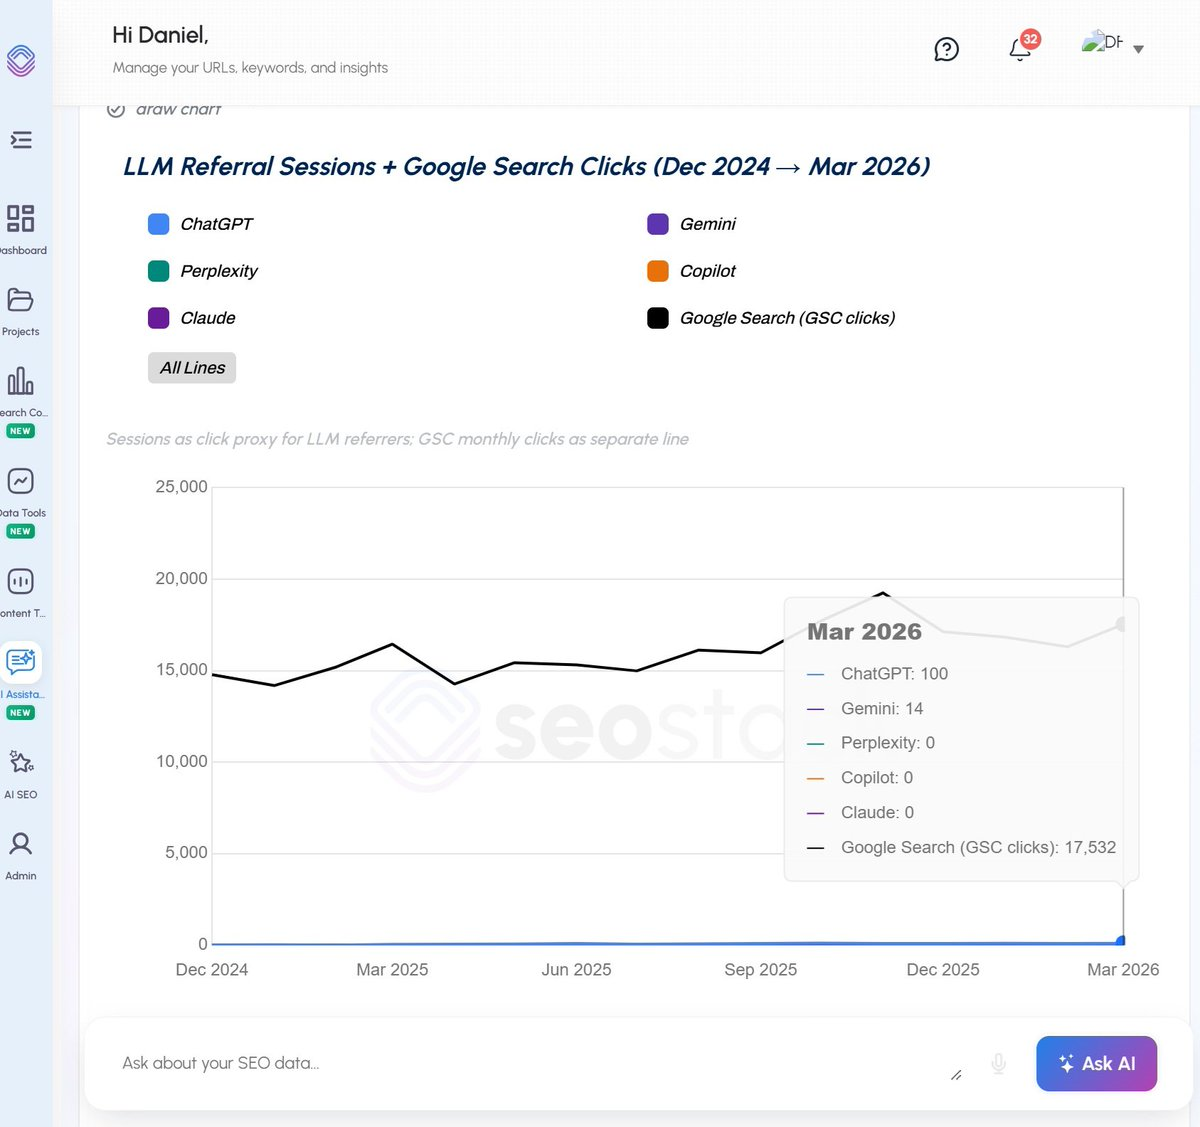
这应该能让你看清,这块市场份额到底有多小。
一致性问题:LLM 不是搜索引擎
这大概是我对当前被兜售的整套 GEO 框架最大的技术层面的不满。
LLM 是不一致的!
搜索引擎的确定性足够高,因此我们可以围绕它们建立稳健的追踪体系。谷歌的算法会变,没错,但在某个给定的时间窗口内,你搜索“SEO consultant”,通常会看到同样的前十条结果。正是这种一致性让排名追踪有意义。
LLM 不是这样构建的。它们在设计上就是概率性的。再加上 RAG(检索增强生成)、查询扩散(query fan-out)、个性化、对话记忆、地理本地化等一层层复杂性,以及同一模型的不同版本和配置可能给出实质性不同答案这一事实——你面对的衡量难题,比 SEO 此前遇到过的任何问题都要难上好几个数量级。
同一个问题问 ChatGPT 两次,你可能得到不同的答案和不同的引用来源。
再把记忆功能加进来,回答还会根据你之前问过什么而变化。
再加上地理位置,曼彻斯特的用户和旧金山的用户问同一个问题,得到的引用来源可能完全不同。
这不是什么无关紧要的脚注——它从根本上动摇了可规模化、可靠的 GEO 追踪这一前提。
GEO 真的有什么独特之处吗?
我想公平一点,因为我确实认为,在为 LLM 可见度做优化与传统搜索优化之间,存在一些真正有区别的要素。它们只是没有 GEO 顾问们想让你相信的那么戏剧化,也没那么具有战略上的新意。
有几点确实有所不同:
引用来源不一样。
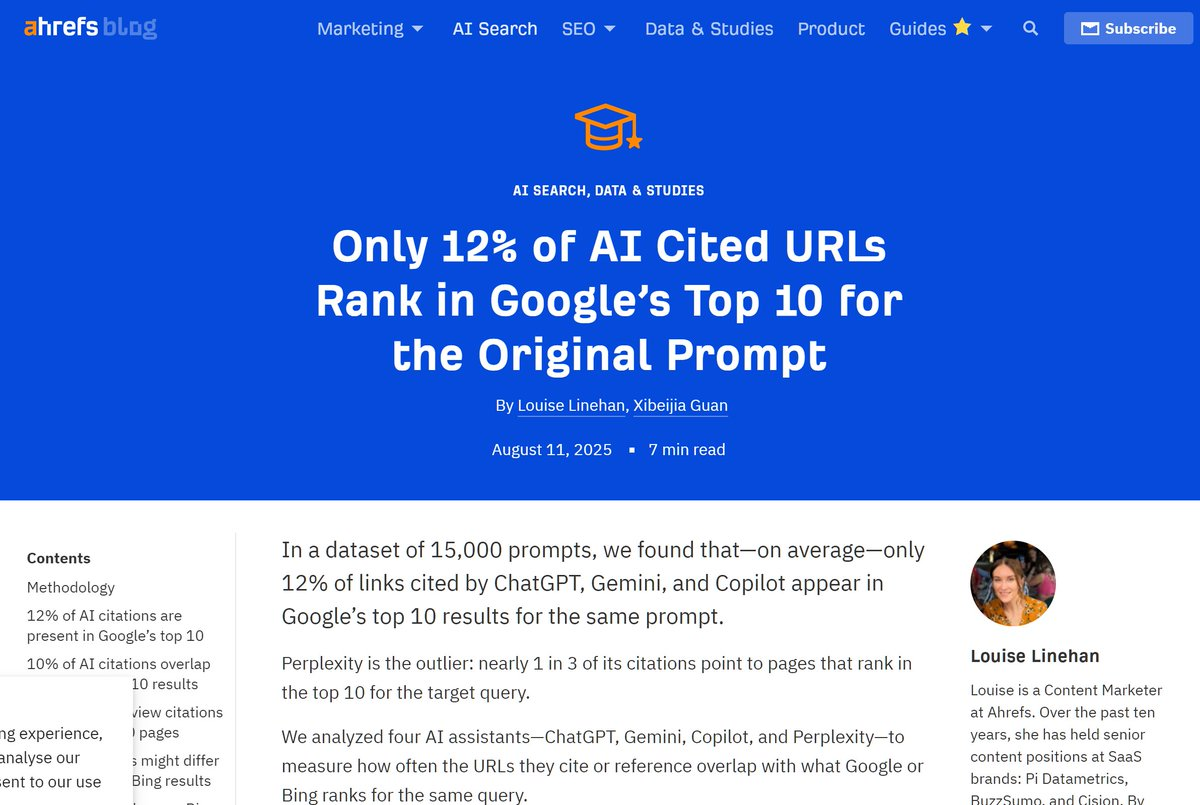
Ahrefs 的研究显示,80% 的 LLM 引用的页面甚至没有进入谷歌原始查询结果的前 100 名(参见
https://ahrefs.com/blog/ai-search-overlap/
),而 ChatGPT 引用最多的页面中有 28.3% 完全没有自然搜索可见度。
这是个实打实的发现,它表明 LLM 正在从一个更广、更不同的内容池中取材。弄清那个内容池长什么样、以及如何进入其中,是一个合理的、GEO 特有的关注点。
结构化、事实性、权威性的内容更重要。
LLM 倾向于综合并引用那些表述明确、结构清晰、事实可验证的内容。
这会把内容策略从长篇说服性文案,推向定义式、参考资料式的内容——这是一个真实存在的战术转变。
不过,无论你做什么,别被围绕这件事的复杂措辞唬住,比如“语义内容分块(semantic content chunking)”,说真的,别信。
品牌实体强度的作用方式不同。
在 SEO 中,品牌信号是间接帮助排名的。在 LLM 中,训练数据里的品牌实体识别会直接影响模型究竟知不知道你的存在。让你的品牌在权威来源上被持续提及——维基百科、主流出版物、G2、行业数据库——其重要性体现得很不一样。
但这些都没有脱离核心 SEO 到需要一门全新学科的程度。John Mueller 也是这么说的。这是我们已有工作的演进,而非革命。
为什么 SEO 依然胜出——而且还会持续一段时间
让我用数字来收尾,因为这些数字讲的故事很清楚,而大量 GEO 炒作恰恰对此避而不谈。
谷歌每天处理约 137 亿次搜索。
来源:Visual Capitalist
ChatGPT 尽管录得了可观的每日 10 亿次搜索,仍然远远落后。
谷歌在全球所有数字查询中仍占据近 80% 的主导份额,而 ChatGPT 占 17%。
即便拥有消费科技史上最快的采用曲线,AI 搜索仍只是传统搜索的一小部分。而且关键在于,当你单独看交易型搜索——也就是真正为多数企业带来商业价值的那部分——谷歌受到的冲击要小得多。人们依然去谷歌买东西、找本地服务、做商业调研。这种行为根深蒂固,不会很快改变。
即便美国用户人均搜索次数同比下降,传统搜索仍占美国桌面端全部活动的约 10%——这一份额在整个 2025 年几乎保持平稳。
是的,AI 采用率在增长。是的,Gartner 预测到 2026 年传统搜索量将下降 25%。但我们以前也预言过谷歌的死亡,而它总有本事在自己的讣告中活下来。另外别忘了,谷歌的 AI Overviews、Gemini 集成和 AI Mode 意味着谷歌本身就是现存最大的 AI 搜索场景之一。做好 SEO 和出现在谷歌的 AI 答案里,往往是同一件事。
在谷歌 AI Overviews 中被引用的 URL,有 76.1% 同时也排在谷歌搜索结果的前 10 位。所以把 SEO 做好,你很可能同时也在为谷歌的 AI 做好 GEO——不需要额外的服务费。
结论
从“AI 搜索行为需要对内容策略做一些调整”这个意义上说,GEO 是真实存在的。但从“它是一门界定清晰、可独立衡量、与 SEO 完全不同的学科”这个意义上说,它并不真实。
当前 GEO 被兜售方式的最大问题在于,用以验证这笔投入的衡量基础设施根本不存在。没有分析数据的访问权限,平台行为极度不一致,查询的唯一性让抽样几乎失去意义,而碎片化的平台格局让任何统一的“AI Visibility”指标在很大程度上都是虚构的。
我见过的淘金热足够多了。等工具跟上来,等平台真的提供分析数据,等衡量方法形成一致且经过验证的体系,我们才能把 GEO 当作一门独立的实践来认真讨论。
在那之前,先把 SEO 的基本功做扎实。因为每天在 Google 上搜索的 137 亿人次,暂时还不会去别的地方。

SEO Stack 创始人
Daniel 是 SEO Stack 的创始人。他在技术 SEO 和搜索数据领域深耕二十余年,在客户项目中一次又一次撞上 Search Console 的同样限制后,他着手打造了 SEO Stack。
Daniel 拥有丰富的 SEO 经验,创办过 SEO 代理机构、审计业务以及一家发展良好的咨询公司。业余时间里,Daniel 喜欢做 SEO 实验并分享实验结果。
发布于 2026年4月12日


