Perché mancano dati in Google Search Console? Dati di query con clic mancanti e dati campionati?
Come me, se ti è capitato di guardare i totali dei click in Google Search Console e pensare “qui c’è qualcosa che non torna”, non è una tua impressione. I dati davvero non tornano, ed è una scelta…
Come me, se hai mai guardato il totale dei clic in Google Search Console e hai pensato "qui qualcosa non torna", non te lo stai immaginando. I dati davvero non tornano ed è voluto.
Google Search Console (GSC) è lo strumento gratuito più importante in assoluto per capire le performance della tua ricerca organica. Ma ha un segreto che i SEO alle prime armi (o i SEO junior) ignorano: non ti mostra tutti i tuoi dati. Anzi, una ricerca di Ahrefs su 887.534 proprietà GSC ha rilevato che quasi il 47% di tutti i clic è attribuito a query anonimizzate, il che significa che quasi metà dei tuoi dati sui clic non ha un termine di ricerca associato.
Qui spieghiamo nel dettaglio perché i tuoi dati GSC sono incompleti, cosa succede dietro le quinte con query anonimizzate, limiti di dati, filtri di Bloom e campionamento e, soprattutto, come individuare e aggirare queste lacune. Che tu sia un SEO in-house, un consulente, uno stratega di agenzia o il proprietario di un sito che cerca di dare un senso ai propri numeri, questa è una lettura importante.
Google Search Console è uno strumento GRATUITO: archiviare ed elaborare i dati costa a Google, quindi non tutti i dati sono accessibili tramite l'interfaccia. Ecco perché molti SEO ripiegano su soluzioni alternative come Looker Studio con Google BigQuery, o soluzioni come SEO Stack, SEO Gets ecc.
1. GSC non ti dà tutti i tuoi dati
La prima cosa che ogni SEO deve capire è che Google Search Console impone limiti rigidi ai dati che ti espone. Questi limiti valgono per l'interfaccia web, per le API e persino per il più recente export massivo su BigQuery.
Ecco alcuni dei limiti di righe più comuni sulle piattaforme di Google:
I limiti di righe
Metodo di accesso | Limite di righe | Note |
Interfaccia web GSC | 1.000 righe | Massimo visibile o esportabile per vista report |
Search Analytics API | 50.000 righe al giorno | Per sito, per tipo di ricerca. Di default restituisce 1.000: occorre usare rowLimit e la paginazione |
Connettore Looker Studio | 50.000 righe al giorno | Stessa API sottostante, si applicano limiti identici |
Export massivo BigQuery | Nessun limite rigido di righe | Il dataset più completo, ma comunque soggetto al filtraggio per privacy. Richiede accesso Owner e conoscenza di SQL |
Per un sito con decine di migliaia di pagine posizionate e centinaia di migliaia di combinazioni query/pagina, il limite di 1.000 righe nell'interfaccia significa che stai vedendo solo la punta dell'iceberg dei dati disponibili. Persino il limite di 50.000 righe delle API può essere raggiunto facilmente su siti più grandi quando combini dimensioni come query + pagina + dispositivo + paese.
La documentazione di Google afferma: "A causa di limitazioni interne, Search Console archivia le righe di dati principali e non tutte le righe di dati." I dati restituiti sono ordinati per clic in ordine decrescente, senza un ordinamento secondario: questo significa che le query a basso traffico e i termini a coda lunga sono i primi a essere scartati.
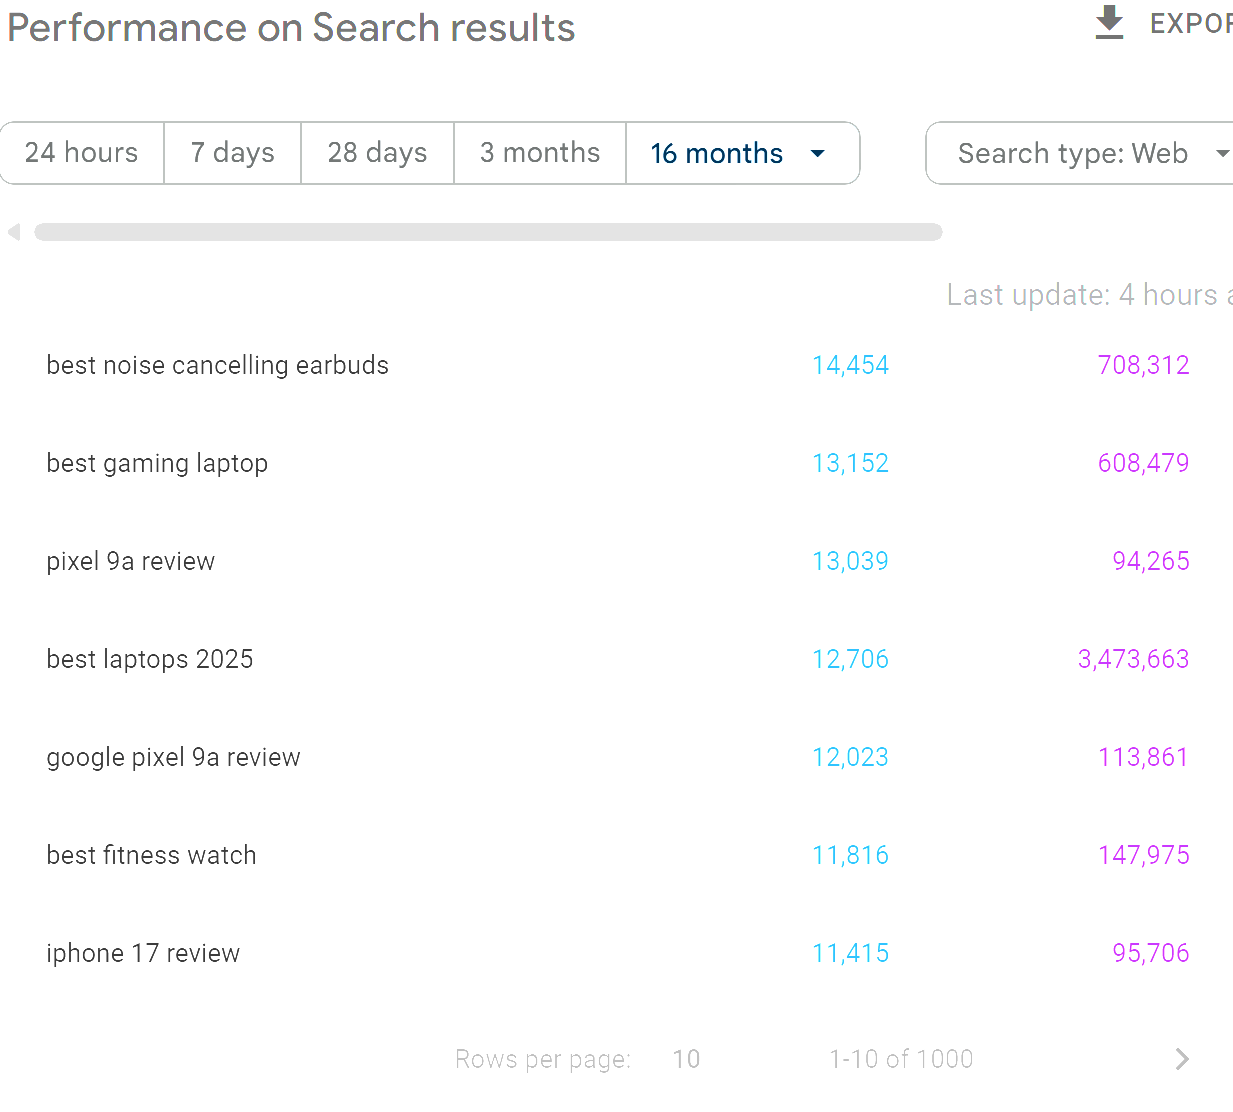
Qualche SEO obietterà "ma ci serve davvero accedere a tutti i dati?". La realtà è sì, ci serve, perché in definitiva, se abbiamo tutti i dati possiamo prendere decisioni migliori in termini di strategia / esecuzione ecc.
Cosa significa in pratica
Immagina di avere un sito che si posiziona per 25.000 query uniche in un dato mese. Nell'interfaccia GSC ne vedrai le prime 1.000. Tramite API potresti recuperare fino a 50.000 righe, ma se stai estraendo combinazioni query + pagina su più dispositivi e paesi, potresti comunque perdere una fetta significativa dei tuoi dati a coda lunga. Questi dati mancanti però non sono persi a livello di grafico: vengono comunque conteggiati nei totali delle performance. Ed è qui che nasce la confusione.
Quindi, usando l'interfaccia di Google Search Console, potrai accedere solo alle prime 1000 query rispetto a qualsiasi filtro applicato:
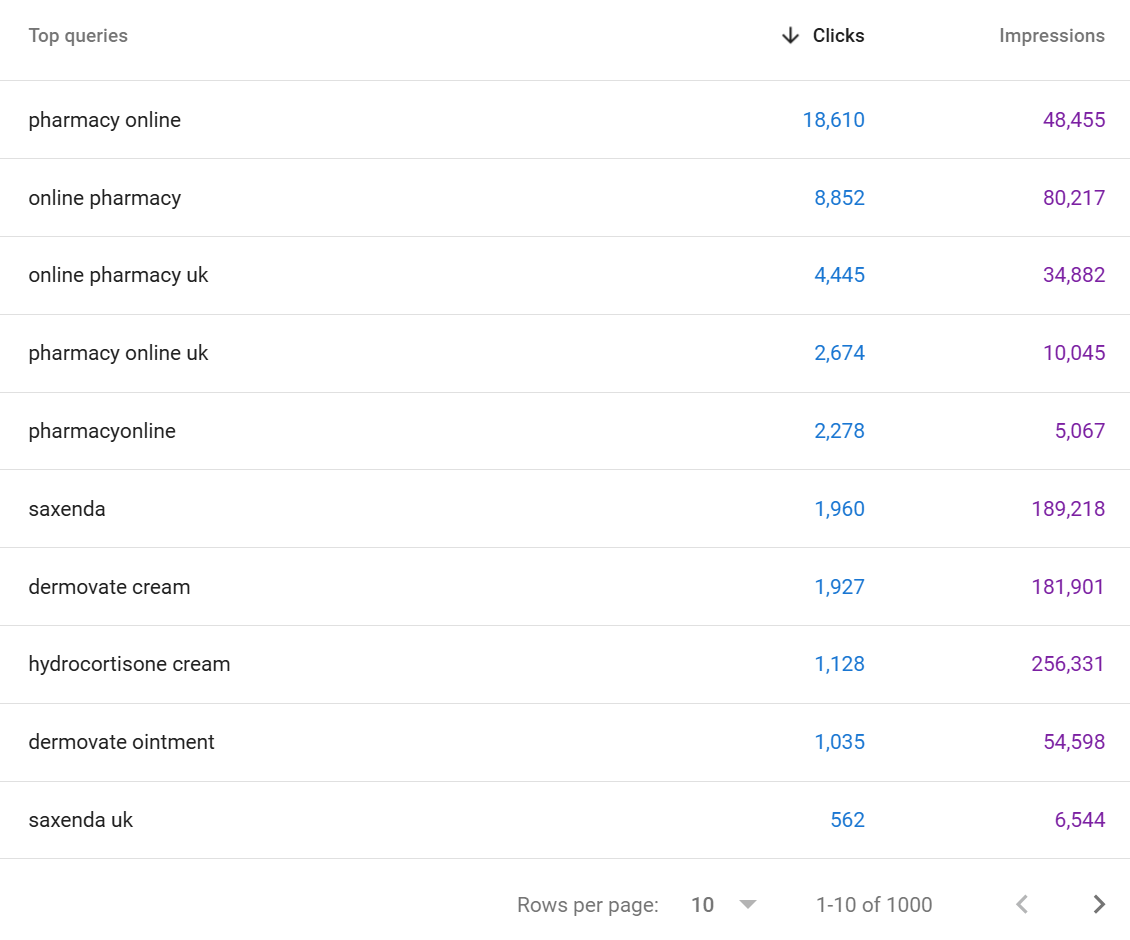
C'è un volume SIGNIFICATIVO di query che non vedrai: anche quando filtri in profondità, i dati sono sempre limitati a un massimo di 1000 righe (a meno che tu non stia facendo un confronto, ma di solito si resta sotto le 1500 query).
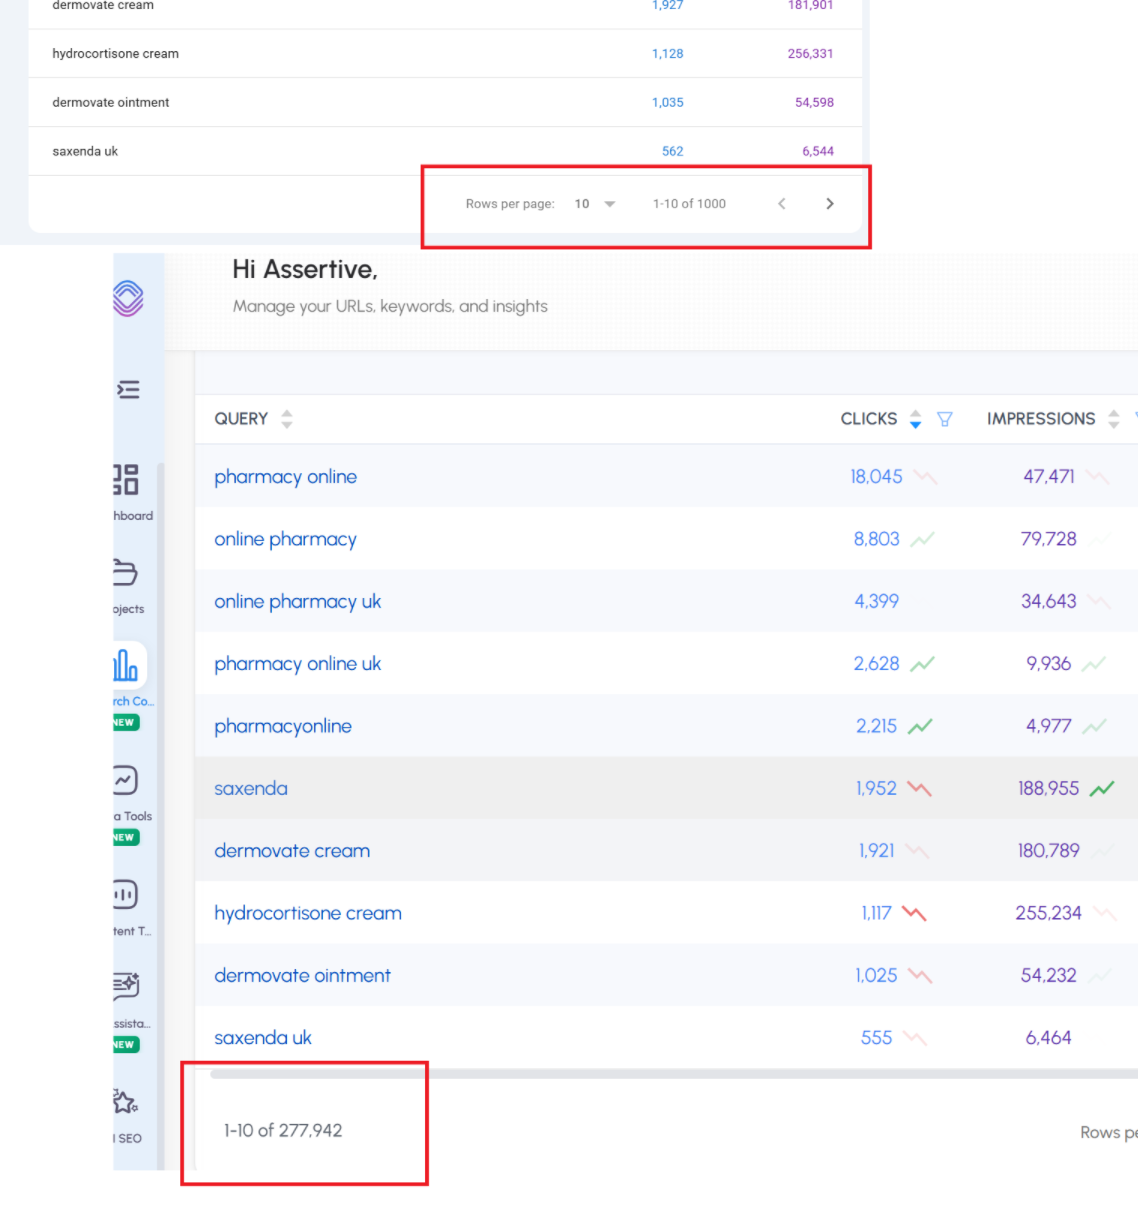
Ecco perché in SEO Stack abbiamo eliminato le limitazioni relative a Google Search Console:
Per il nostro cliente pharmacyonline.co.uk vediamo 1000 query in GSC. Se guardiamo la stessa proprietà URL in SEO Stack vediamo >
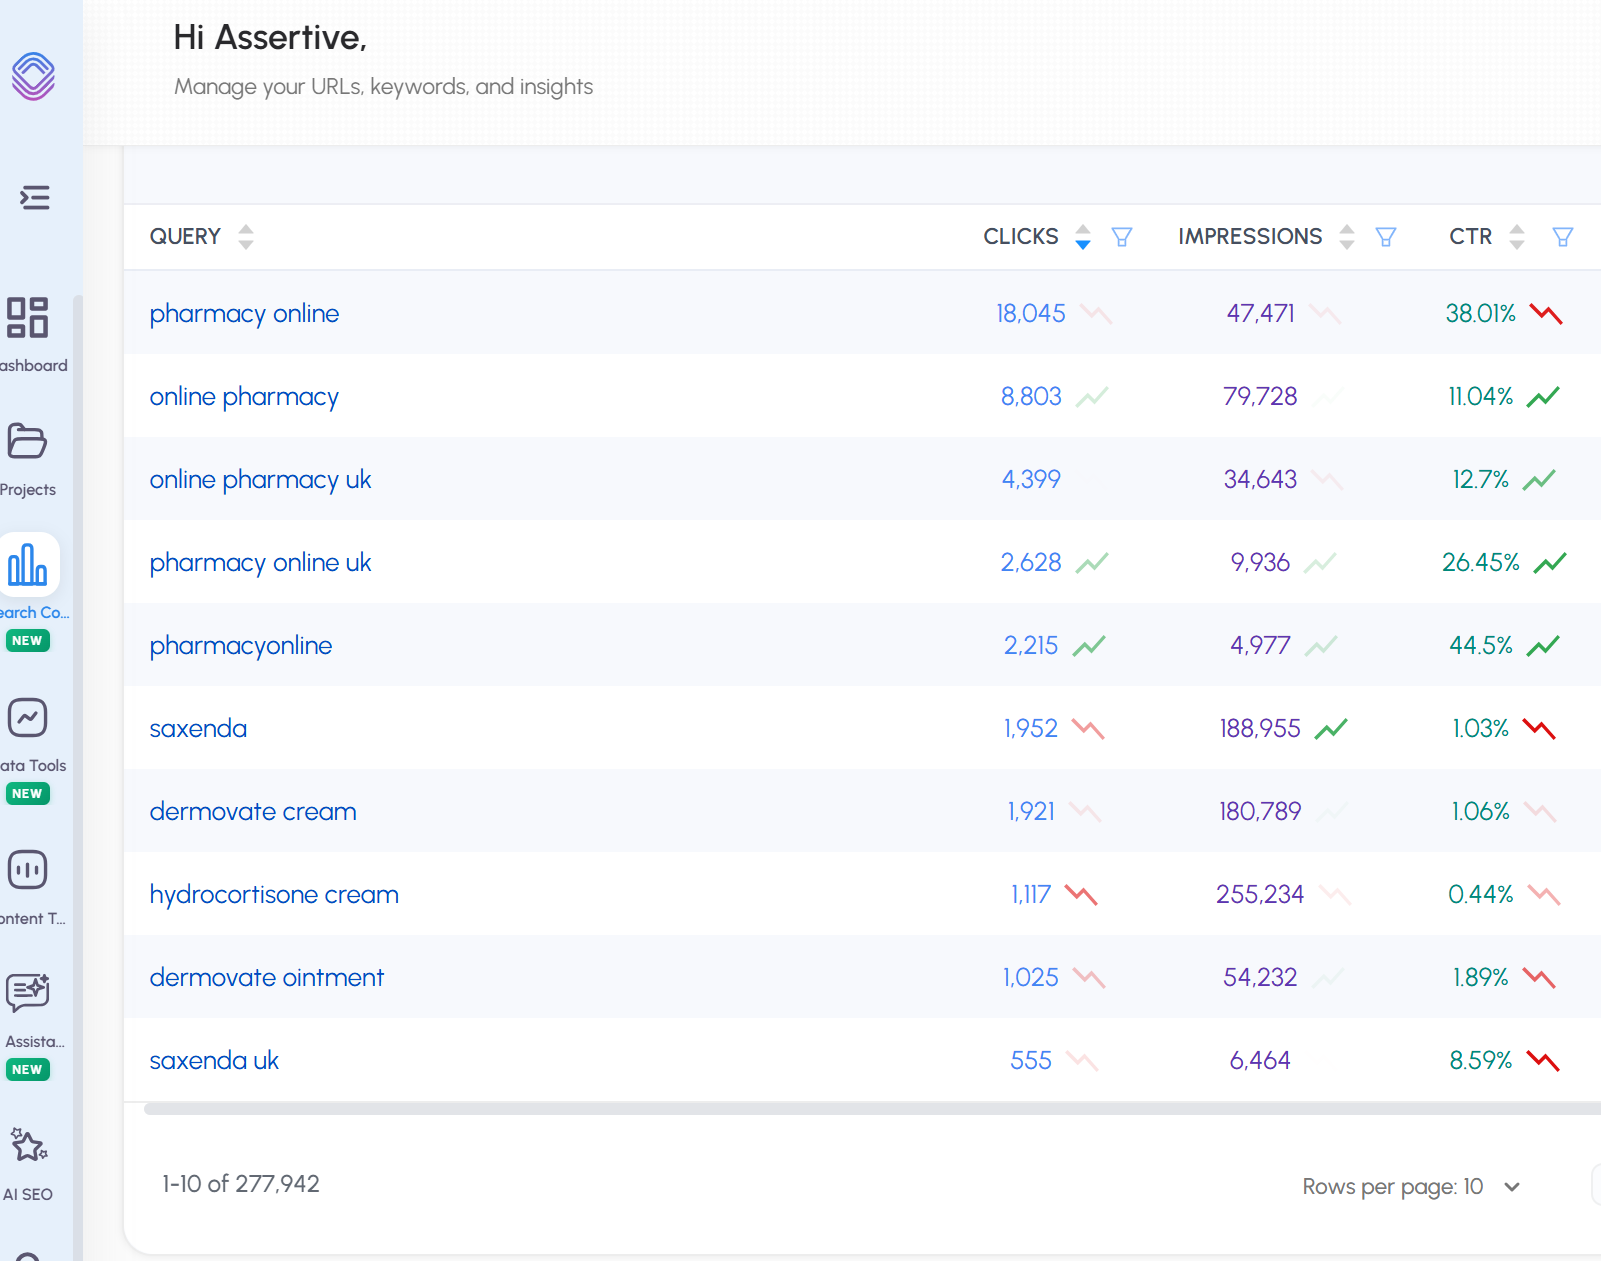
Vediamo 277.942 query.
In breve: SEO Stack sblocca i dati di Google Search Console perché li archiviamo in un data warehouse e li rendiamo accessibili.
2. Il grafico e la tabella sono dataset diversi
Questo è uno degli aspetti più fraintesi di Google Search Console, e trae in inganno anche SEO esperti. Il grafico delle performance in cima al report e la tabella dati sottostante non mostrano gli stessi dati.
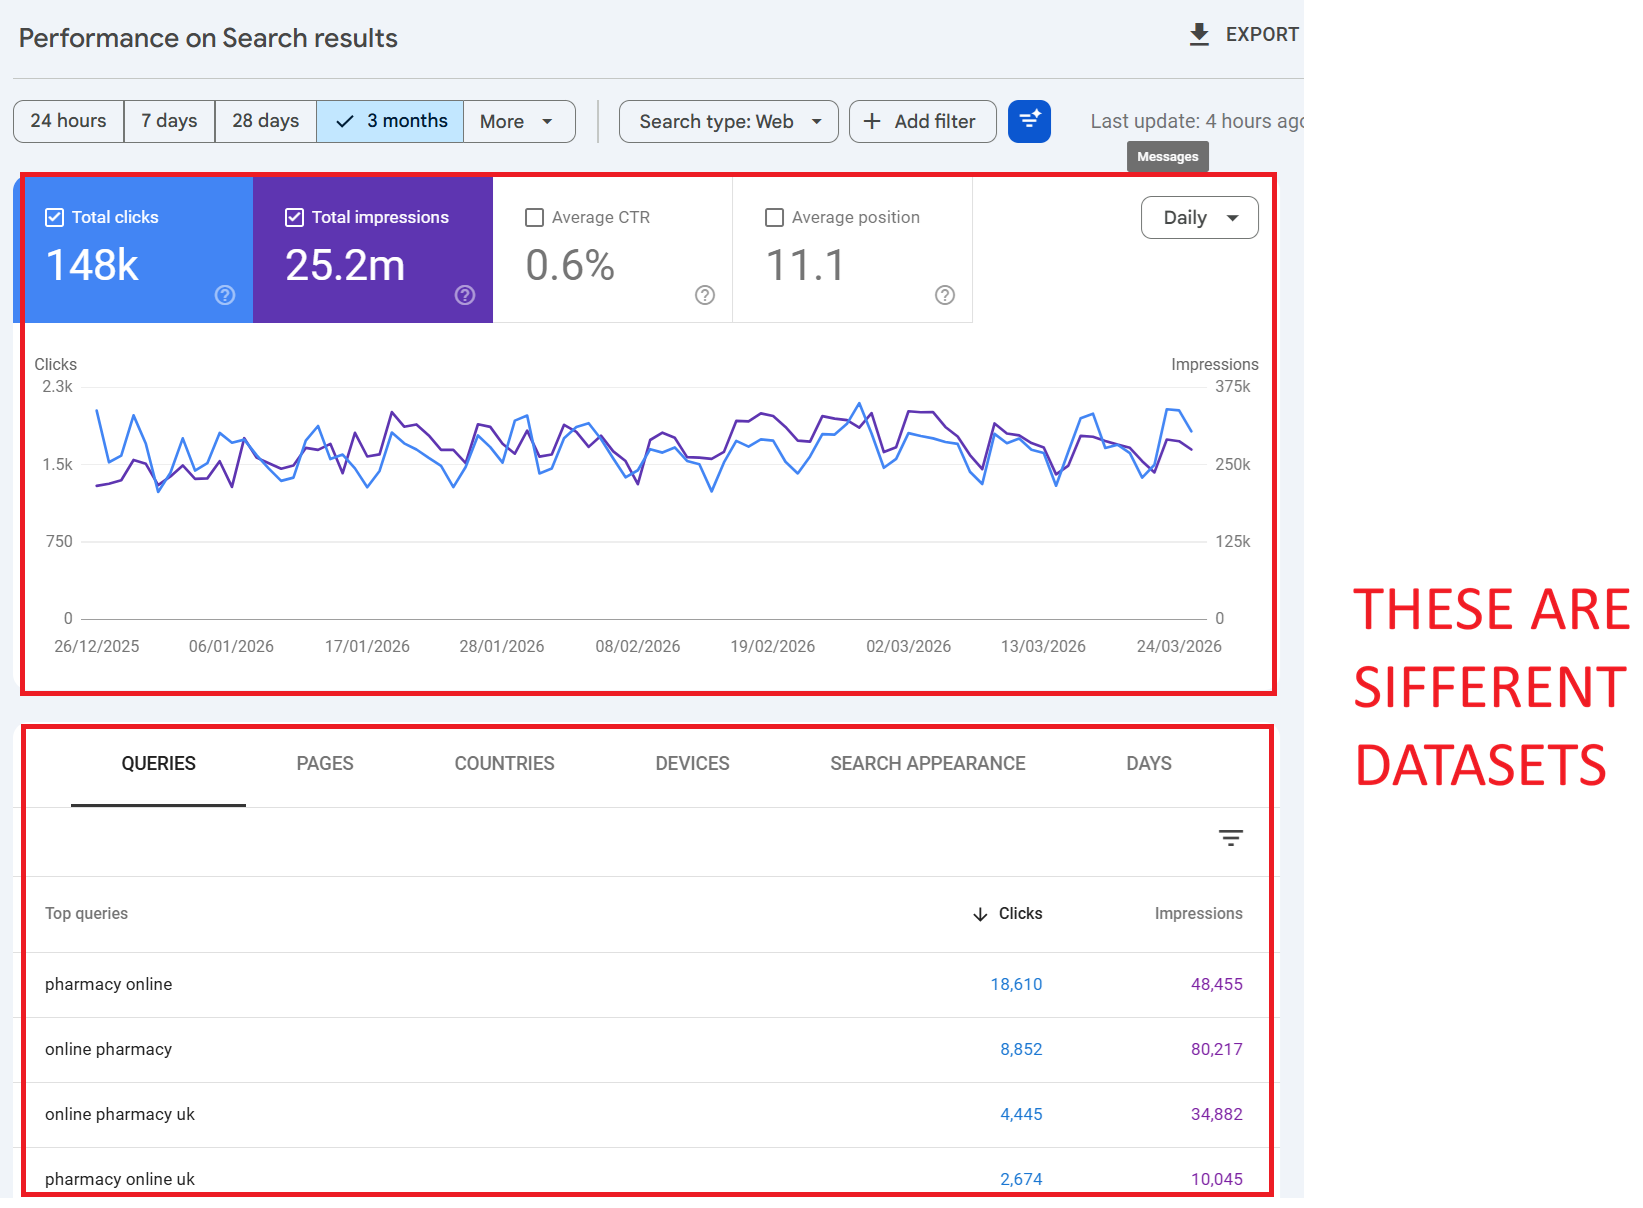
Come funziona il grafico
Il grafico mostra i totali aggregati per l'intera proprietà. Quando non è applicato alcun filtro, il grafico include tutti i clic, le impressioni, il CTR e i dati di posizione, inclusi i clic da query anonimizzate. Rappresenta il quadro completo di ciò che Google ha registrato per il tuo sito.
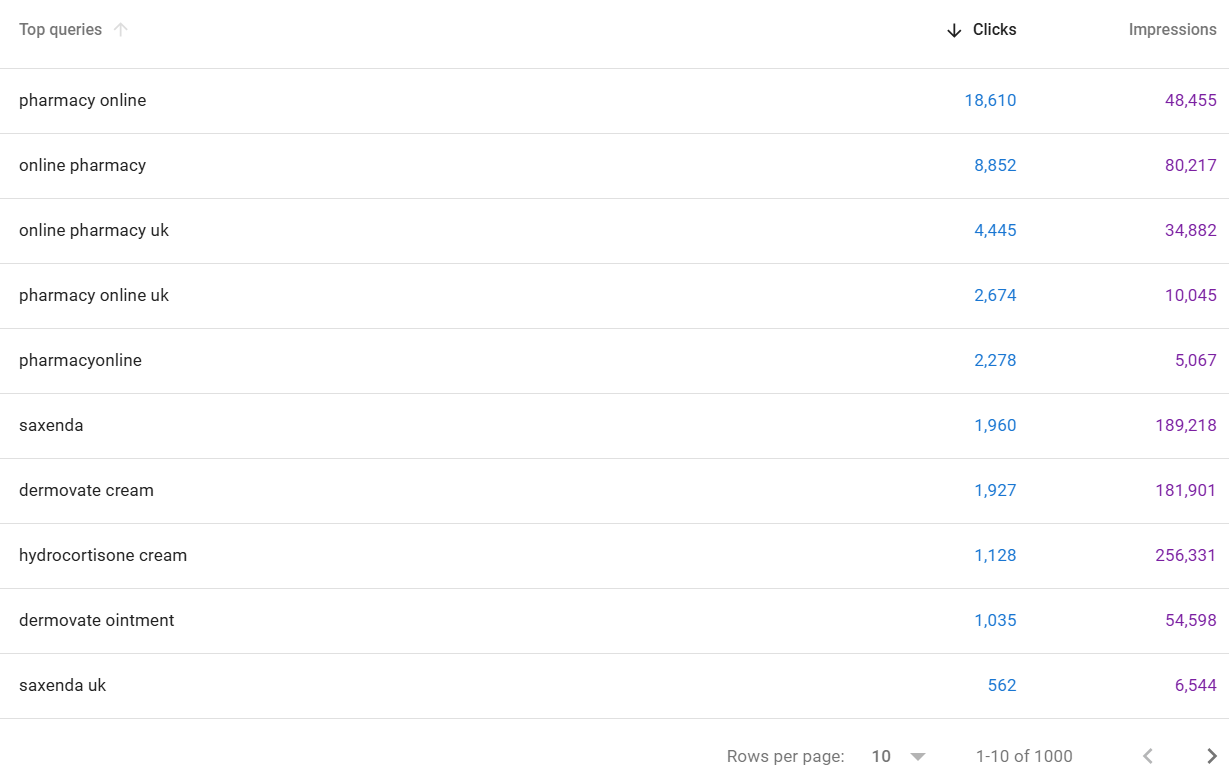
Come funziona la tabella
La tabella sotto il grafico, invece, mostra solo i dati relativi alle query identificate e non anonimizzate. Se Google non riesce ad attribuire i clic a una query specifica (perché la query è stata anonimizzata per motivi di privacy), quei clic semplicemente non compaiono nella tabella. Non c'è una riga "query anonimizzate": il dato è semplicemente assente.
Il risultato
Se sommi ogni riga della tabella delle query, il tuo totale sarà quasi sempre inferiore al totale del grafico. La differenza è costituita dai dati delle query anonimizzate: clic avvenuti, registrati da Google, ma senza alcuna stringa di ricerca associata che tu possa vedere.
💡 Esempio: il grafico mostra 10.000 clic per il mese. Esporti tutte le righe delle query e sommi i clic: ottieni 5.400. I restanti 4.600 clic provengono da query anonimizzate. Google li ha registrati, ma non ti dirà cosa hanno cercato le persone.
3. Perché mancano i dati su query e clic?
Ci sono diversi motivi distinti per cui i tuoi dati GSC sono incompleti. Capire ciascuno di essi è fondamentale per interpretare correttamente i tuoi report.
Motivo 1: query anonimizzate (filtraggio per privacy)
Questo è il fattore principale. Google definisce come anonimizzate quelle query "che non vengono effettuate da più di qualche decina di utenti nell'arco di due o tre mesi". Queste query vengono rimosse del tutto dalle tabelle dati per proteggere la privacy degli utenti.
La portata del fenomeno è notevole. Lo studio Ahrefs del 2025 su 22 miliardi di clic ha rilevato che le query anonimizzate rappresentavano in media il 46,77% di tutti i clic. Per alcuni siti la cifra superava l'80%. La distribuzione varia enormemente: i siti con molti termini di ricerca a coda lunga, di nicchia o proprietari subiscono un'anonimizzazione molto maggiore rispetto ai siti dominati da una manciata di head term ad alto volume.
Punto chiave: non si tratta del volume di query verso il tuo sito, ma di quanti utenti unici su tutto il web hanno cercato quel termine. Una query potrebbe generare 50 clic verso il tuo sito, ma se solo 20 persone al mondo l'hanno cercata in 3 mesi, Google la anonimizzerà.
Motivo 2: limiti di righe e troncamento dei dati
Come visto sopra, GSC archivia e restituisce solo le righe di dati "principali". Google dà priorità alle righe con il maggior numero di clic. Se il tuo sito ha migliaia di combinazioni query/pagina, quelle in fondo — tipicamente query a coda lunga con 1–2 clic — vengono semplicemente scartate. Questo è un fenomeno distinto dall'anonimizzazione: queste query potrebbero avere abbastanza utenti unici per essere identificate, ma vengono tagliate dal dataset per limiti di archiviazione ed elaborazione.
Motivo 3: Ritardo nell'elaborazione dei dati
I dati di GSC sono tipicamente in ritardo di 2–3 giorni. I dati dei giorni più recenti possono essere incompleti o del tutto assenti. Si tratta di un normale ritardo di elaborazione e i dati verranno popolati col tempo, ma può generare confusione se controlli i report in tempo reale.
Motivo 4: Differenze di tipo di proprietà e di aggregazione
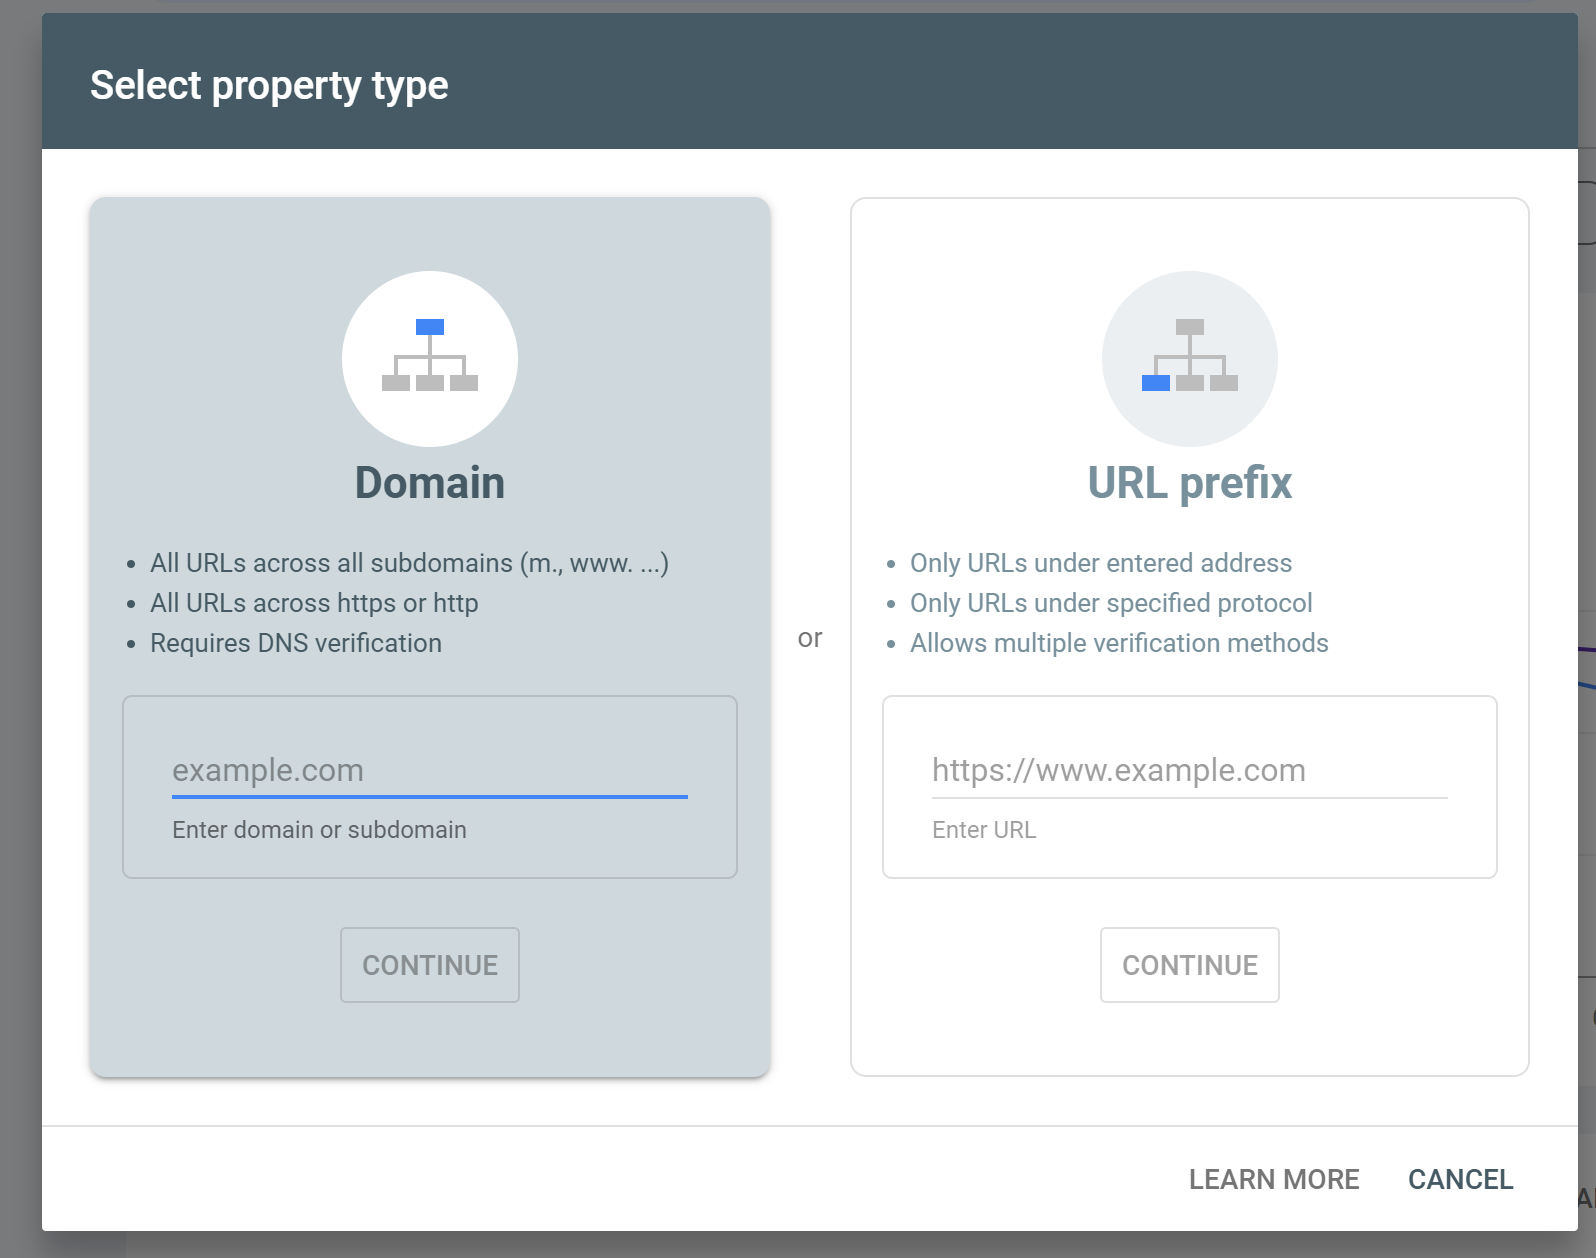
Il modo in cui i dati vengono aggregati dipende dal fatto che tu stia usando una proprietà Dominio o una proprietà con prefisso URL, e dal fatto che i dati siano aggregati a livello di proprietà o a livello di pagina. Passare da un contesto all'altro può far cambiare i totali in modo inatteso, in particolare quando il metodo di aggregazione passa da livello di proprietà a livello di pagina, cosa che può addirittura aumentare i numeri riportati perché vengono esposti punti dati più granulari.
Motivo 5: Query sensibili o personali
Oltre alla soglia di volume, Google rimuove anche le query che contengono informazioni personali o sensibili. Query sanitarie, dettagli finanziari e altri comportamenti di ricerca personalmente identificabili possono essere eliminati indipendentemente dal volume di ricerca. La documentazione di Google segnala esplicitamente che potrebbe non tracciare le query che contengono "informazioni personali o sensibili".
4. Google Search Console campiona i dati?
È una domanda frequente e la risposta è sfumata. GSC non "campiona" i dati nel modo in cui Google Analytics (UA) era noto per campionare i dati di sessione nei report ad alto traffico. Google non seleziona casualmente un sottoinsieme di clic per poi estrapolare.
Tuttavia, GSC tronca e filtra i dati in modi che producono un effetto simile. La combinazione di filtraggio per privacy (query anonimizzate), limiti di righe (solo le righe di dati principali) e approssimazioni dei filtri di Bloom significa che ciò che vedi non è un campione casuale, ma è una rappresentazione incompleta dell'intero dataset.
Il linguaggio usato da Google nella sua documentazione di approfondimento è indicativo: "Riteniamo che i dati rimanenti saranno sufficientemente ampi da creare un campione rappresentativo dei dati." Nota la parola "campione": persino Google riconosce che ciò che stai vedendo è un sottoinsieme rappresentativo, non il quadro completo.
L'impatto pratico è che per la maggior parte dei siti di piccole e medie dimensioni i dati sono ragionevolmente completi. Per siti più grandi con profili di query diversificati, le lacune nei dati possono essere significative. Più dimensioni aggiungi (query + pagina + paese + dispositivo), più dati vengono tagliati.
5. Filtri di Bloom: il motivo nascosto per cui i tuoi numeri non tornano
A settembre 2023, Gary Illyes di Google ha affrontato direttamente un mistero di lunga data: perché i dati filtrati in GSC mostrano a volte PIÙ clic dei dati non filtrati? La risposta: i filtri di Bloom.
Cos'è un filtro di Bloom?
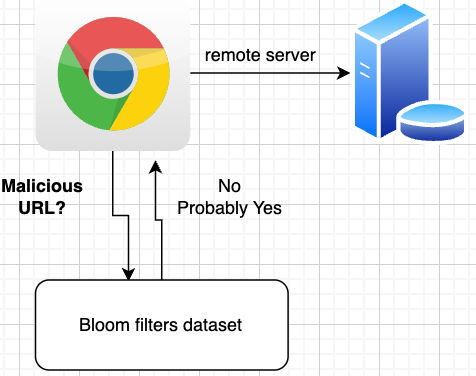
Un filtro di Bloom è una struttura dati probabilistica inventata nel 1970 da Burton Howard Bloom. È progettata per verificare se un elemento appartiene a un insieme in modo estremamente rapido e con un consumo minimo di memoria. Il compromesso è che può produrre falsi positivi (dire che qualcosa è nell'insieme quando non lo è) ma mai falsi negativi (non dirà che qualcosa non c'è quando invece c'è).
Come Google usa i filtri di Bloom in GSC
Gary Illyes ha spiegato che Google elabora miliardi, potenzialmente migliaia di miliardi, di elementi di dati per la reportistica di Search Console. Cercare elementi specifici in dataset di queste dimensioni è computazionalmente oneroso. I filtri di Bloom risolvono il problema creando una versione più piccola e sottoposta ad hashing dei dati, che può essere consultata per prima.
Nelle parole di Illyes: "I filtri di Bloom velocizzano le ricerche prevedendo se qualcosa esiste in un insieme di dati, ma a scapito dell'accuratezza, e più piccolo è l'insieme di dati, più accurate sono le previsioni."
Il processo di hashing può comportare una perdita di dati, intenzionale o come inevitabile effetto collaterale della compressione. Ecco perché:
• Applicare un filtro di pagina può aumentare il totale dei clic, perché il dataset più specifico (e più piccolo) attraversa il filtro di Bloom con maggiore accuratezza, recuperando dati che erano andati persi nella vista più ampia e non filtrata.
• Rimuovere un filtro può ridurre i totali, perché tornare all'aggregazione più ampia a livello di proprietà reintroduce gli errori di approssimazione del filtro di Bloom.
• I totali dei filtri "includi" + "escludi" non coincidono con il totale non filtrato, perché ogni sottoinsieme filtrato attraversa il filtro di Bloom in modo indipendente e gli errori di approssimazione sono diversi per ciascun passaggio.
💡 Pensala così: Google usa un motore di approssimazione molto efficiente anziché un conteggio esatto. È veloce, ma gli errori di arrotondamento si accumulano in modo diverso a seconda di come segmenti i dati. Più piccolo è il segmento, più tende a essere accurato.
6. Esempi pratici: prova tu stesso nel tuo account GSC
Il modo migliore per capire queste lacune nei dati è vederle con i propri occhi. Ecco diversi esercizi che puoi eseguire subito in Google Search Console.
Esercizio 1: Il disallineamento delle query di brand
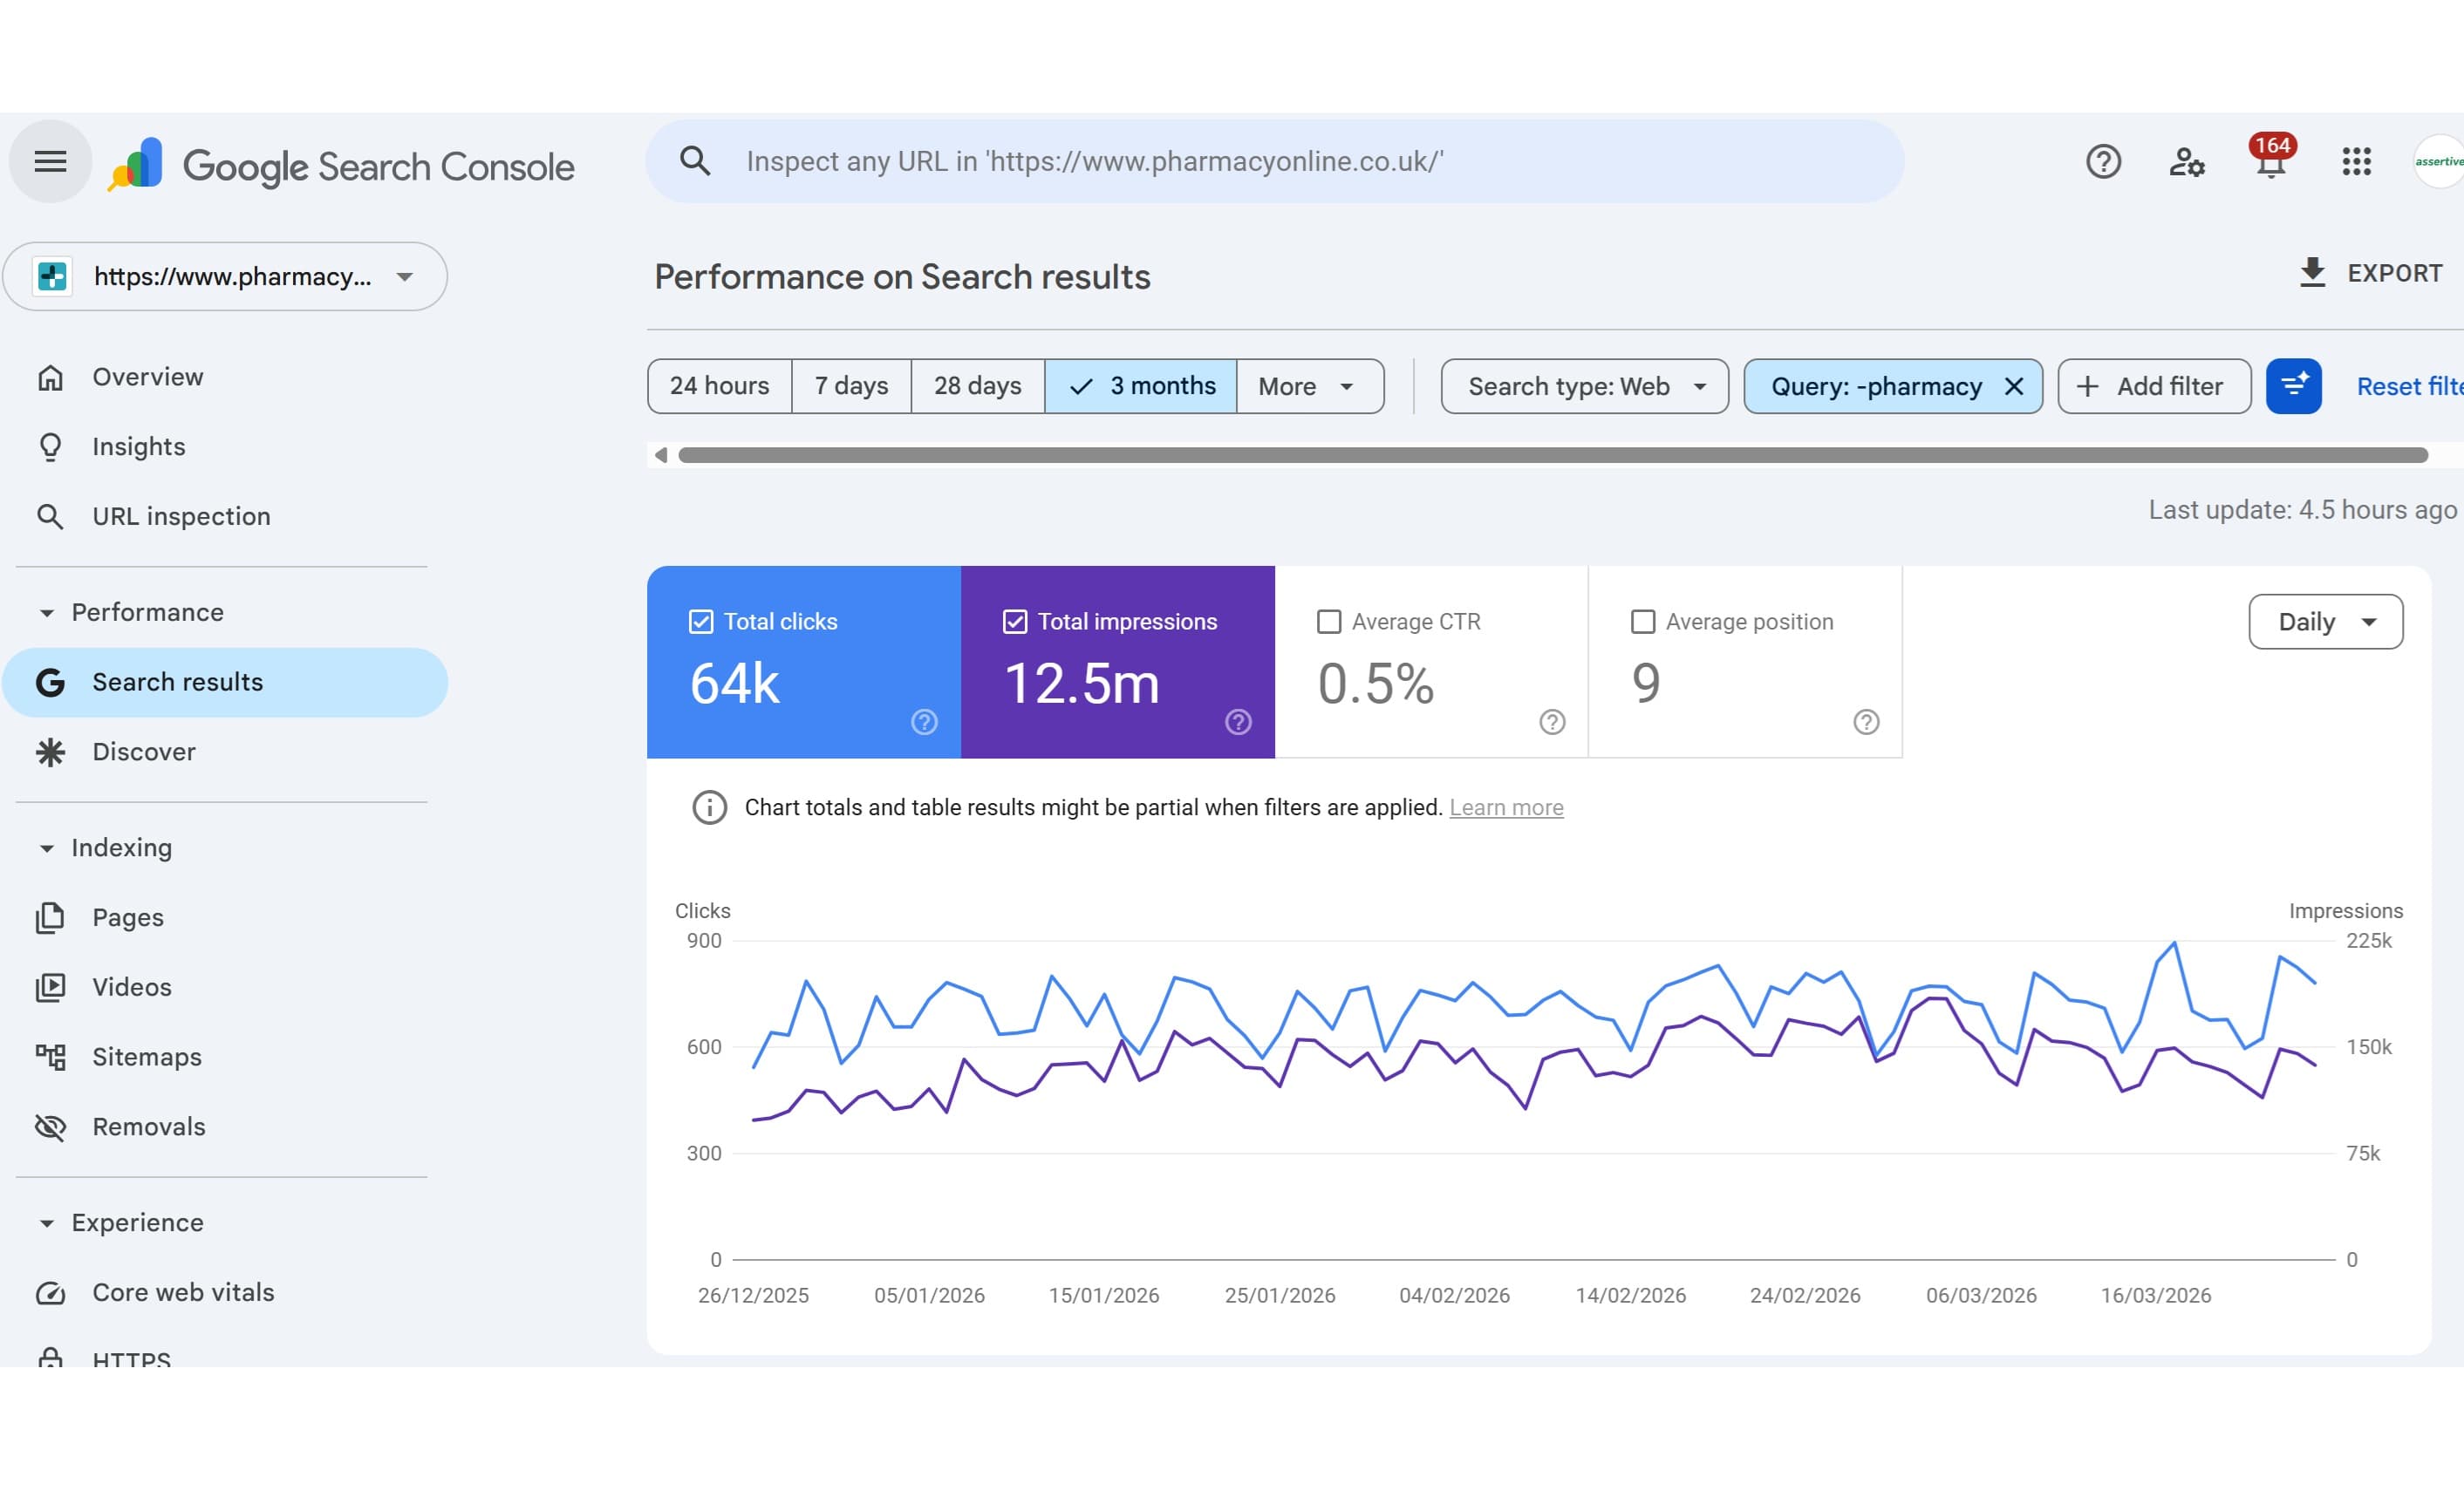
Cosa fare: Apri GSC > Rendimento > imposta un intervallo di date di 3 mesi. Annota i clic totali sul grafico (poniamo che mostri 15.000 clic).
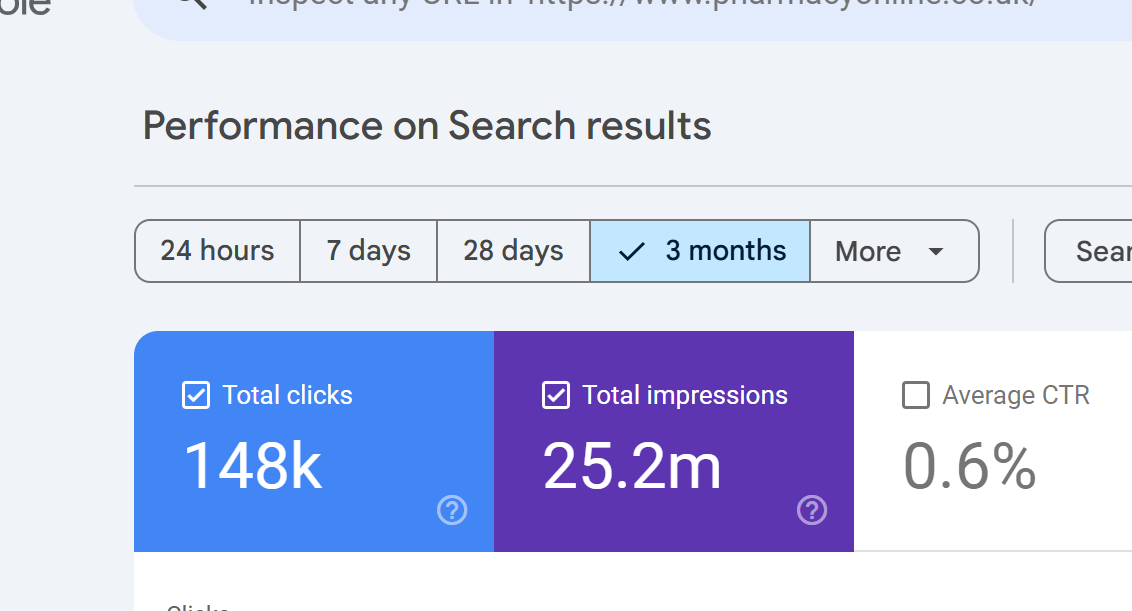
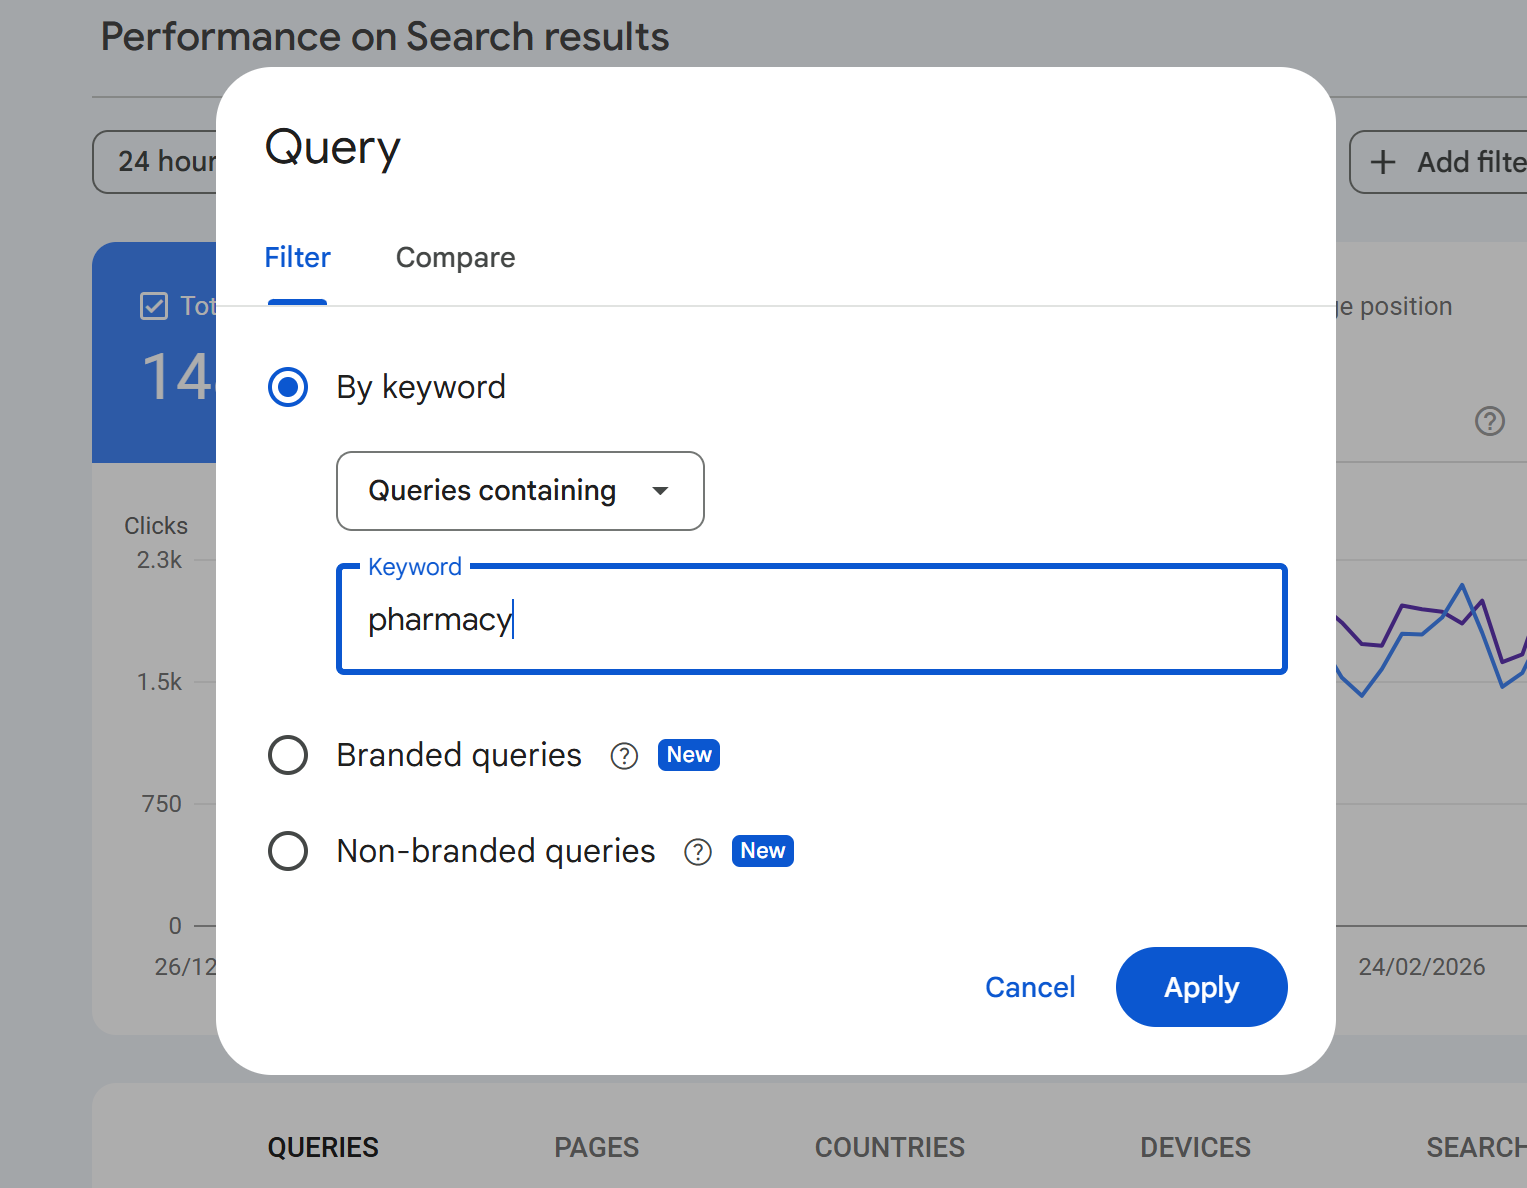
Ora aggiungi un filtro query: Query contenenti "iltuobrand". Il grafico potrebbe mostrare 4.200 clic.
In questo esempio applichiamo la query contenente "pharmacy"
Cambia il filtro in: Query NON contenenti "iltuobrand". Il grafico potrebbe mostrare 6.300 clic.
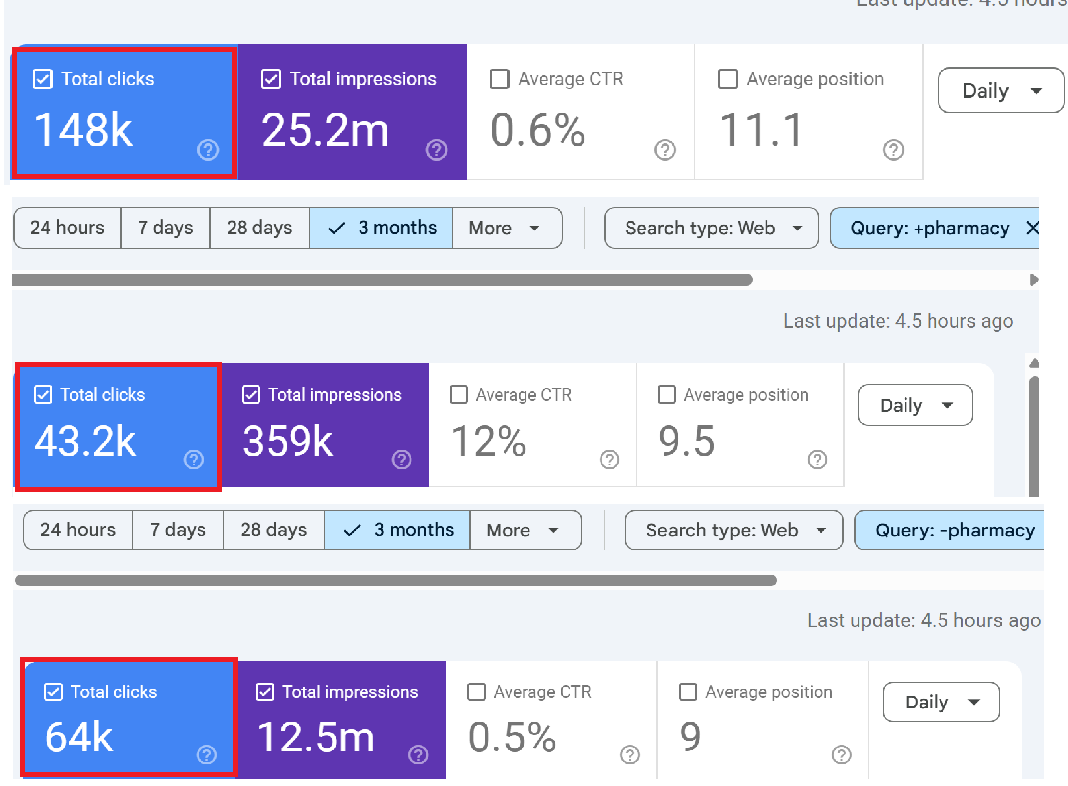
4.200 + 6.300 = 10.500. Ma il totale non filtrato era 15.000. Dove sono finiti i 4.500 clic mancanti?
Cosa sta succedendo: Quando applichi un qualsiasi filtro di query (di inclusione o di esclusione), GSC elimina dai totali tutte le query anonimizzate. Quei 4.500 clic provenivano da query che Google ha anonimizzato. Senza alcun filtro, sono inclusi nel totale del grafico. Con un filtro applicato, spariscono completamente, perché Google non può valutare se una query anonimizzata contiene o meno il nome del tuo brand.
Esercizio 2: Totale del grafico vs. somma della tabella
Cosa fare: Nel report Rendimento senza filtri applicati, annota i clic totali sul grafico. Poi apri la scheda "Query" sottostante ed esporta tutte le righe in un foglio di calcolo. Somma la colonna dei clic.
Cosa scoprirai: La somma dei clic nella tabella sarà inferiore al totale del grafico. Il divario corrisponde ai dati delle query anonimizzate. Per molti siti, questo divario sarà il 30–60% del totale.
Esercizio 3: Il filtro di pagina aumenta i clic
Cosa fare: Annota i tuoi clic totali non filtrati. Poi aggiungi un filtro di pagina per il tuo URL più popolare (es. Pagine contenenti "/tua-pagina-principale/"). Guarda il totale.
Cosa potrebbe succedere: In alcuni casi, il totale filtrato per quella pagina sarà superiore a quanto mostrato dal report non filtrato per la stessa pagina nella tabella. È il filtro di Bloom all'opera: il dataset più piccolo e specifico viene elaborato con maggiore accuratezza, facendo emergere dati che erano andati persi nell'aggregazione più ampia.
Esercizio 4: Lacune nel filtraggio per paese
Cosa fare: Guarda i tuoi clic totali. Poi filtra per paese, ad esempio Regno Unito. Annota i clic. Poi passa agli Stati Uniti e annota quei clic. Somma tutti i paesi che filtri singolarmente.
Cosa scoprirai: La somma dei clic dei singoli paesi non corrisponderà al totale, perché molti clic non sono attribuiti a un paese specifico e ogni passaggio di filtraggio introduce il proprio errore di approssimazione del filtro di Bloom.
Esercizio 5: Sovrapporre i filtri amplifica il divario
Cosa fare: Parti con un filtro di pagina per un URL specifico. Annota i clic. Ora aggiungici sopra un filtro di query. Poi aggiungi un filtro per paese. A ogni filtro aggiuntivo, spariscono più dati.
Perché: Ogni filtro amplifica l'effetto. Le query anonimizzate vengono eliminate con qualsiasi filtro di query. I limiti di righe tagliano in modo più aggressivo quando sono in gioco più dimensioni. E gli errori di approssimazione del filtro di Bloom si accumulano a ogni ulteriore passaggio di filtraggio. Più diventi specifico, meno completi sono i tuoi dati: un paradosso frustrante per chiunque cerchi di fare un'analisi granulare.
7. Domande frequenti sui dati mancanti in GSC
D: Perché i totali dei clic dei report Query e Pagine non coincidono?
Il report Query e il report Pagine usano metodi di aggregazione diversi. Il report Query conta i clic per query, mentre il report Pagine conta i clic per pagina. Un singolo clic può comparire sia in una riga query sia in una riga pagina, ma le query anonimizzate vengono escluse dal report Query mentre il clic corrispondente sulla pagina viene comunque conteggiato nel report Pagine. Inoltre, una singola pagina può posizionarsi per più query e una singola query può portare a più pagine, quindi la deduplicazione funziona in modo diverso in ciascuna vista.
D: È solo un problema dell'interfaccia gratuita di GSC?
No. L'API ha limiti di righe più alti (50.000 contro 1.000) ma è soggetta allo stesso filtraggio per privacy e allo stesso comportamento dei Bloom filter. Persino l'export massivo su BigQuery, che è la fonte dati più completa, contiene comunque query anonimizzate contrassegnate come valori NULL: puoi vedere che il traffico esiste, ma continui a non sapere cosa hanno cercato le persone. Tuttavia, BigQuery mostra un tasso di anonimizzazione più basso perché cattura più query a volume borderline che l'API scarta.
D: Il mio sito è piccolo, la cosa mi riguarda?
Sì, spesso in modo sproporzionato. I siti più piccoli tendono a ricevere traffico da molte query long-tail a basso volume. Poiché l'anonimizzazione si basa su quanti utenti unici a livello globale hanno cercato un termine, i siti piccoli con pubblico di nicchia hanno spesso una percentuale più alta di dati anonimizzati. Una ricerca di SEO Gets ha rilevato che i siti piccoli avevano una visibilità delle query che scendeva fino allo 0–37%, con una media di appena il 18,3%.
D: Posso recuperare i dati delle query mancanti?
Non direttamente da Google. Puoi però incrociare i dati di GSC con strumenti di terze parti come Ahrefs, Semrush o SEO Stack per individuare le query che probabilmente generano traffico ma non compaiono in GSC. L'export su BigQuery conserva anche le righe delle query anonimizzate (con valori query NULL), così puoi almeno quantificare quanto traffico resta non attribuito. La conservazione estesa dei dati di SEO Stack e le sue analisi basate su AI ti aiutano a individuare pattern nel traffico long-tail che GSC da sola non può rivelare.
D: Perché Google ha cambiato la sua documentazione da "molto raro" a "alcune"?
Dopo lo studio di Ahrefs del 2022 che mostrava come quasi metà dei clic andasse a termini nascosti, Google ha aggiornato la documentazione di supporto rimuovendo l'affermazione che le query anonimizzate fossero "molto rare". Il testo aggiornato ora dice che "alcune query" vengono anonimizzate. Danny Sullivan di Google ha riconosciuto che i termini long-tail, singolarmente rari, possono sommarsi fino a rappresentare una quota significativa del traffico totale.
D: Perché filtrando per una pagina specifica a volte si vedono più clic rispetto ai dati non filtrati?
È l'effetto del Bloom filter. Quando applichi un filtro di pagina, GSC passa dall'aggregazione a livello di proprietà a quella a livello di pagina. Il dataset più piccolo e specifico attraversa il Bloom filter con maggiore accuratezza, il che può recuperare dati persi nell'aggregazione più ampia. Sembra controintuitivo, ma è una conseguenza diretta del modo in cui le strutture dati probabilistiche barattano velocità con accuratezza.
D: I dati sono peggiorati da quando sono state lanciate le AI Overviews?
Probabilmente sì, anche se Google non l'ha confermato esplicitamente. Le AI Overviews e le interfacce di ricerca conversazionale incoraggiano query più lunghe e in linguaggio più naturale. Le query più lunghe tendono a essere più uniche, il che significa che meno utenti distinti cercano esattamente la stessa stringa. Questo spinge più query sotto la soglia di anonimizzazione di Google. Lo studio di Ahrefs del 2025 è stato condotto prima del rollout completo delle AI Overviews, il che suggerisce che l'attuale tasso di anonimizzazione reale possa essere persino superiore al 46,77%.
D: I dati di GSC coincidono con quelli di Google Analytics?
No, e non dovrebbero. GA traccia le sessioni sul tuo sito (richiede l'esecuzione di JavaScript e il caricamento della pagina). GSC traccia i clic dai risultati di ricerca (registrati lato Google). Traffico bot, errori JavaScript, timeout di caricamento, redirect e impostazioni di privacy creano tutti discrepanze tra i due. Misurano cose collegate, ma fondamentalmente diverse.
8. Cosa puoi fare
1. Usa l'API, non solo l'interfaccia. L'API ti dà 50 volte più righe rispetto alla UI web. Strumenti come SEO Stack estraggono automaticamente i dati dall'API e li archiviano con conservazione estesa, così lavori sempre con il dataset più completo disponibile.
2. Attiva l'export massivo su BigQuery. Se hai accesso come Owner, è la fonte dati più completa. Le query anonimizzate compaiono come valori NULL: non puoi vedere il testo della query, ma puoi quantificare e segmentare il traffico non attribuito.
3. Non fidarti dell'aritmetica dei filtri. Accetta che i totali filtrati non corrisponderanno ai totali non filtrati. Usa i dati non filtrati per il reporting di sintesi e quelli filtrati per analisi direzionali, non per una contabilità precisa.
4. Incrocia con dati di terze parti. Strumenti come Ahrefs, Semrush e SEO Stack possono far emergere dati di query che GSC anonimizza. Il report Anonymous Queries di Ahrefs incrocia specificamente i dati GSC con i propri dati di ranking per individuare i probabili termini nascosti.
5. Analizza a livello di pagina per avere completezza. Le ricerche mostrano costantemente che in GSC i dati a livello di pagina sono molto più completi di quelli a livello di query. I siti piccoli mostrano il 97–102% dei clic totali a livello di pagina, contro un minimo del 18% a livello di query. Se ti servono conteggi di clic accurati, usa le dimensioni di pagina invece di quelle di query.
6. Concentrati sui trend, non sui valori assoluti. I dati di GSC sono direzionalmente accurati anche quando non sono perfettamente completi. Un aumento del 20% dei clic mese su mese è significativo a prescindere dal fatto che tu possa vedere ogni singola query. Usa i dati per l'analisi dei trend e le decisioni strategiche, non per contare i centesimi.
7. Usa SEO Stack per conservazione estesa e analisi più approfondite. Google conserva solo 16 mesi di dati sulle performance. SEO Stack archivia i tuoi dati GSC dal momento in cui ti colleghi, offrendoti analisi di trend a lungo termine che GSC da sola non può fornire. In combinazione con le analisi basate su AI, puoi individuare pattern nei tuoi dati che un'analisi manuale di GSC non coglierebbe.
Conclusione
Google Search Console è uno strumento indispensabile, ma non è la verità completa. Tra le query anonimizzate che nascondono quasi metà dei dati sui clic, i limiti di righe che tagliano la visibilità sulla long-tail e i Bloom filter che producono un'aritmetica che non torna, c'è un divario significativo tra ciò che accade davvero nella ricerca e ciò che GSC ti mostra.
Capire questi limiti non rende GSC meno utile: rende la tua analisi più onesta. I SEO che superano i concorrenti sono quelli che sanno cosa stanno davvero dicendo i loro dati, aggirano le lacune e usano strumenti come SEO Stack per estendere la visibilità oltre ciò che offre l'interfaccia gratuita di Google.
La prossima volta che i tuoi numeri in GSC non torneranno, saprai perché. E, soprattutto, saprai cosa fare.
Fonti e approfondimenti
• SEO Gets: Google's Dirty Little Secret – Anonymous Queries (2024)
• Documentazione di supporto di Google Search Console: report sul rendimento nella ricerca

Fondatore, SEO Stack
Daniel è il fondatore di SEO Stack. Ha trascorso oltre due decenni lavorando su SEO tecnica e dati di ricerca, e ha creato SEO Stack dopo essersi scontrato, una volta di troppo, con i soliti limiti di Search Console nel lavoro con i clienti.
Daniel ha una vasta esperienza in ambito SEO: ha costruito agenzie SEO, attività di audit e una consulenza di grande successo. Nel tempo libero, si diverte a condurre esperimenti SEO e a condividerne i risultati.
Pubblicato 27 marzo 2026


