Warum fehlen Daten in der Google Search Console? Fehlende Klick- und Suchanfragendaten & Stichprobendaten?
Wenn es Ihnen wie mir geht und Sie schon einmal auf die Klick-Summen in der Google Search Console geschaut und gedacht haben „da stimmt was nicht“, dann bilden Sie sich das nicht ein. Die Daten gehen tatsächlich nicht auf – und das ist so…
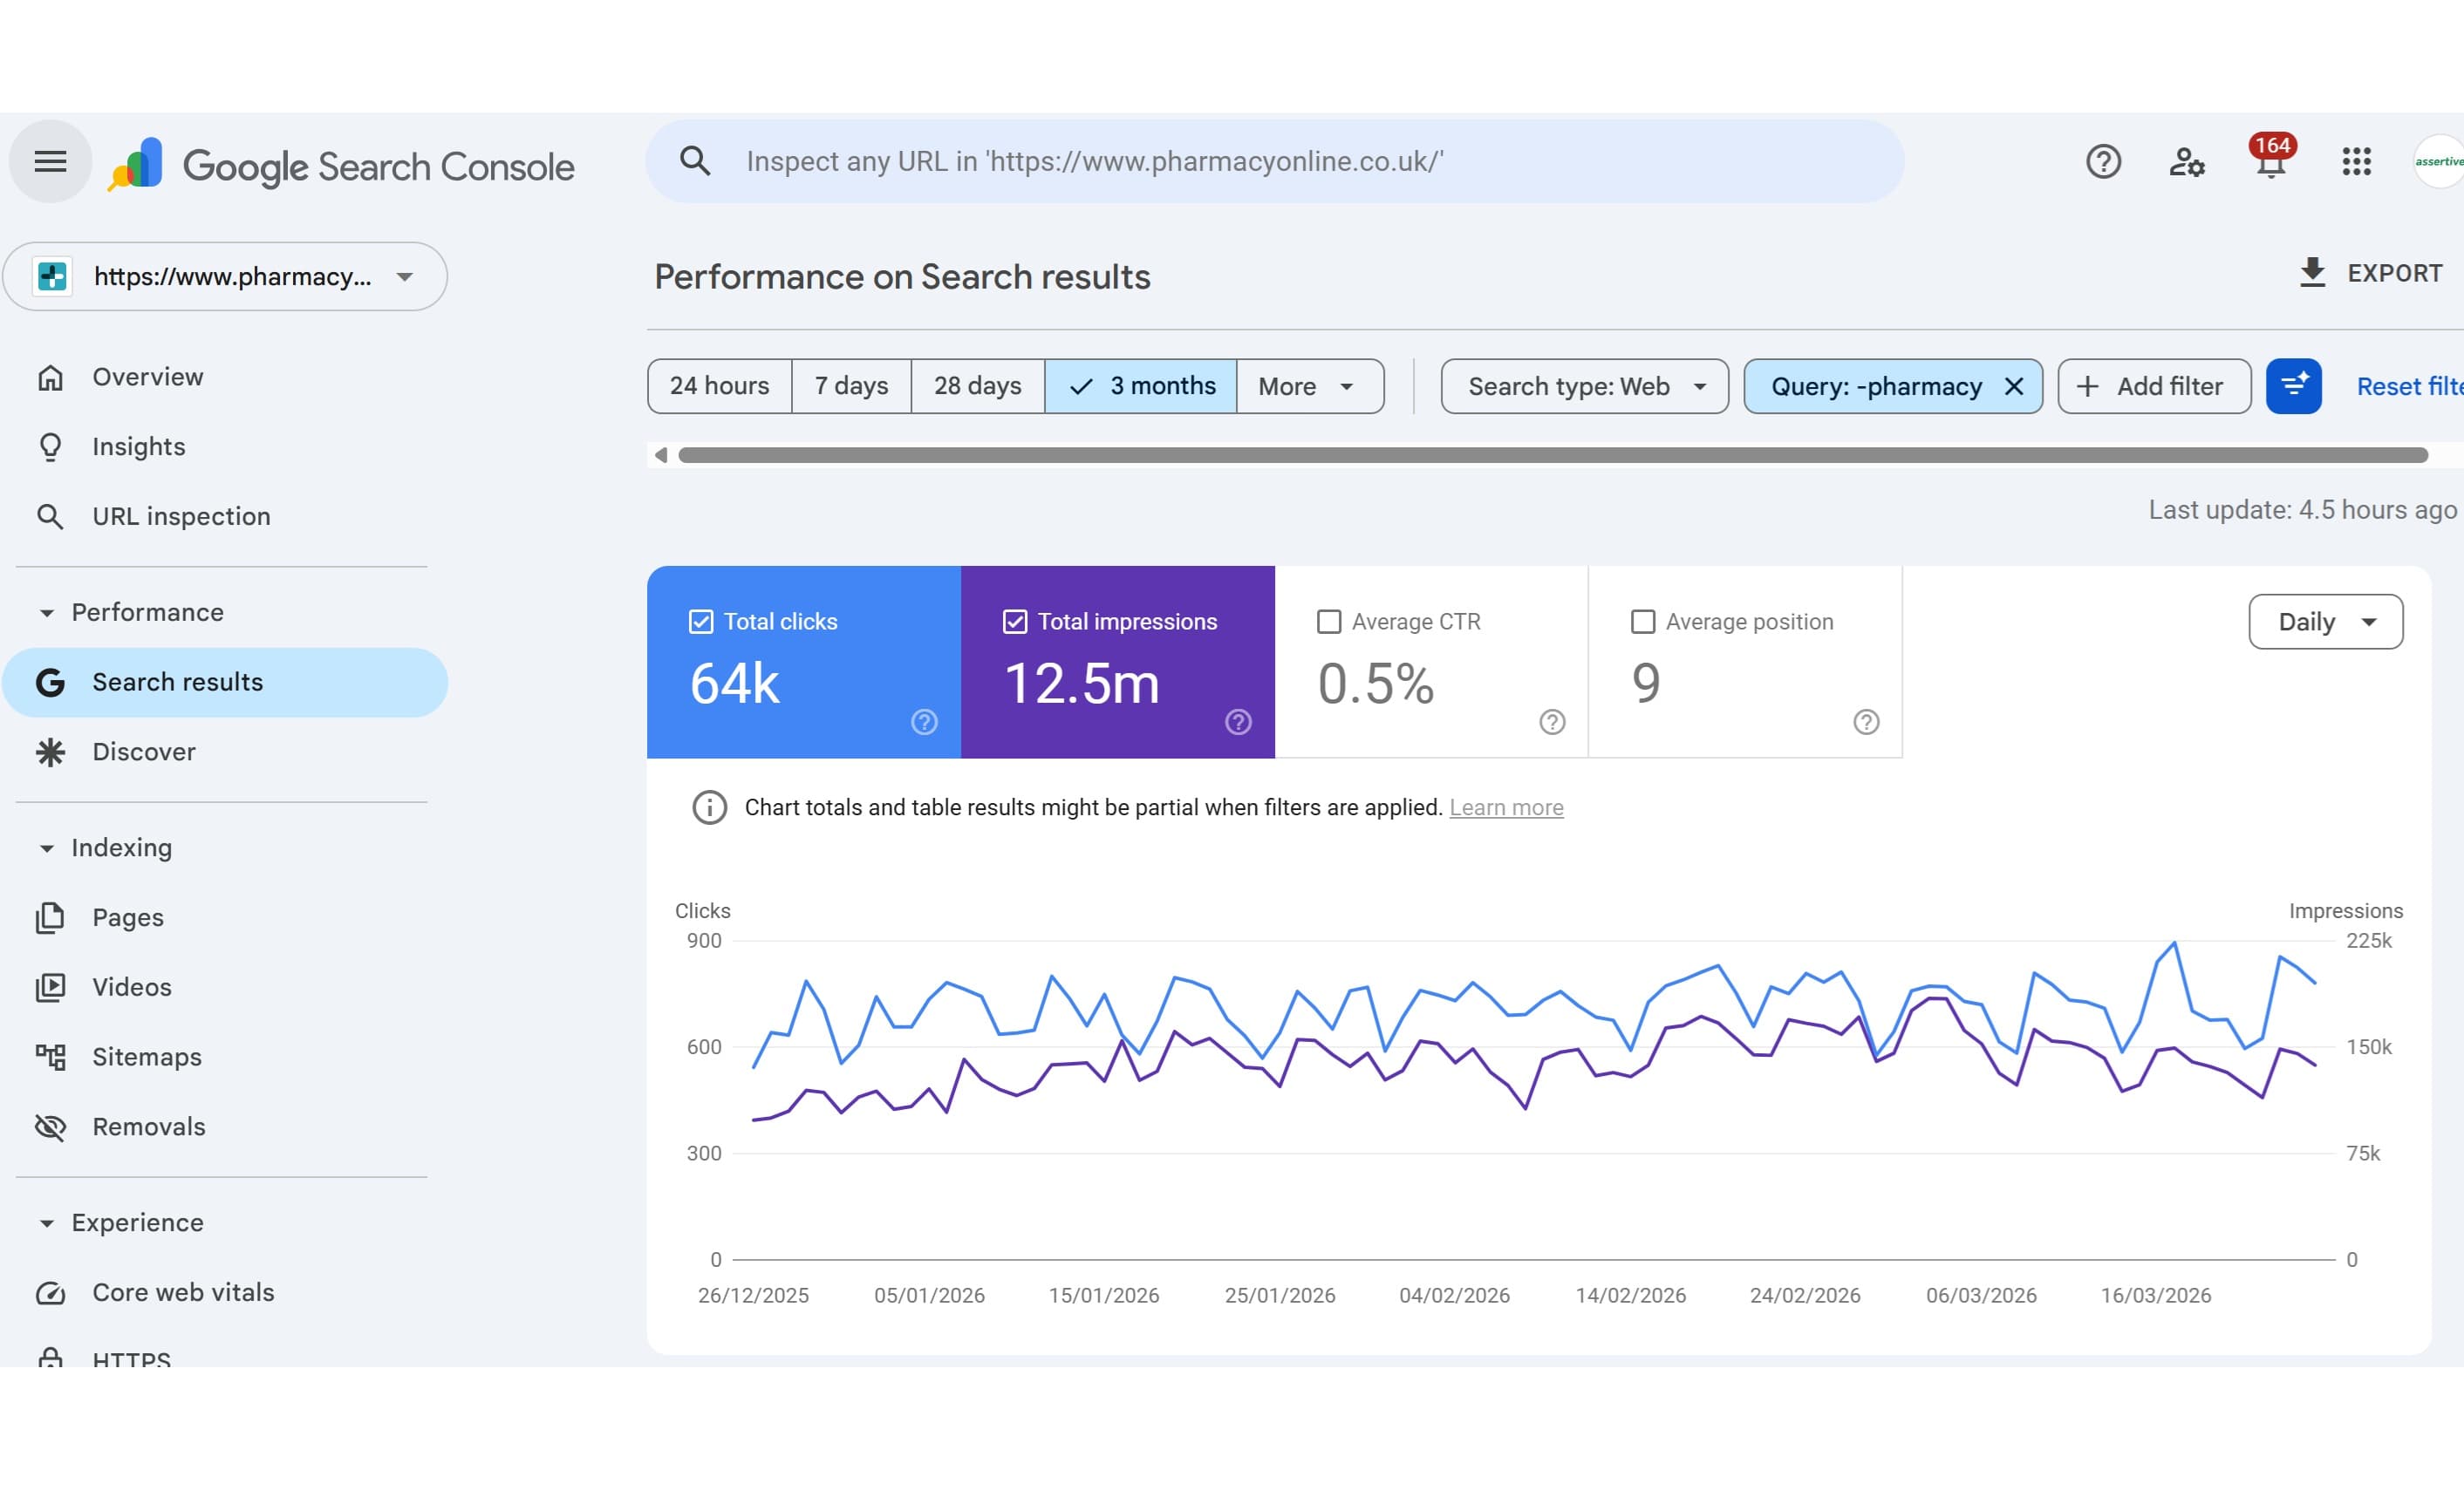
Wie mir ist es Ihnen vielleicht auch schon so gegangen: Sie schauen auf die Klick-Summen in der Google Search Console und denken „da stimmt doch was nicht“. Das bilden Sie sich nicht ein. Die Daten gehen tatsächlich nicht auf – und das ist so gewollt.
Google Search Console (GSC) ist das wichtigste kostenlose Tool, um die eigene organische Suchperformance zu verstehen. Aber es hat ein Geheimnis, das neue (oder Junior-) SEOs nicht kennen: Es zeigt Ihnen nicht alle Daten. Eine Untersuchung von Ahrefs über 887.534 GSC-Properties ergab, dass fast 47 % aller Klicks anonymisierten Suchanfragen zugeordnet werden – das heißt, fast die Hälfte Ihrer Klickdaten hat keinen zugehörigen Suchbegriff.
Hier erklären wir genau, warum Ihre GSC-Daten unvollständig sind, was hinter den Kulissen mit anonymisierten Suchanfragen, Datenlimits, Bloom-Filtern und Sampling passiert – und vor allem, wie Sie diese Lücken erkennen und umgehen. Ob Sie In-house-SEO, Berater, Agentur-Stratege oder Website-Betreiber sind, der seine Zahlen verstehen will: Das hier ist Pflichtlektüre.
Google Search Console ist ein KOSTENLOSES Tool – Google kostet es Geld, Daten zu speichern und zu verarbeiten, deshalb sind nicht alle Daten über die Oberfläche zugänglich. Darum greifen viele SEOs standardmäßig zu Alternativen wie Looker Studio mit Google BigQuery oder Lösungen wie SEO Stack, SEO Gets usw.
1. GSC gibt Ihnen nicht alle Daten
Das Erste, was jeder SEO verstehen muss: Google Search Console setzt strikte Grenzen bei den Daten, die sie Ihnen zugänglich macht. Diese Limits gelten für das Web-Interface, die API und sogar für den neueren BigQuery-Bulk-Export.
Hier einige der üblichen Zeilenlimits über Googles eigene Plattformen hinweg:
Die Zeilenlimits
Zugriffsmethode | Zeilenlimit | Hinweise |
GSC Web-Interface | 1.000 Zeilen | Maximum, das pro Berichtsansicht sichtbar bzw. exportierbar ist |
Search Analytics API | 50.000 Zeilen pro Tag | Pro Website, pro Suchtyp. Standardmäßig werden 1.000 zurückgegeben – rowLimit und Pagination sind erforderlich |
Looker Studio Connector | 50.000 Zeilen pro Tag | Dieselbe zugrunde liegende API – identische Limits |
BigQuery Bulk Export | Kein hartes Zeilenlimit | Vollständigster Datensatz, aber weiterhin Datenschutz-Filterung unterworfen. Erfordert Owner-Zugriff und SQL-Kenntnisse |
Für eine Website mit Zehntausenden rankenden Seiten und Hunderttausenden Query/Page-Kombinationen bedeutet das 1.000-Zeilen-Limit in der UI, dass Sie nur die Spitze des Eisbergs der verfügbaren Daten sehen. Selbst das 50.000-Zeilen-Limit der API ist bei größeren Websites schnell erreicht, wenn Sie Dimensionen wie Query + Page + Device + Country kombinieren.
In Googles eigener Dokumentation heißt es: „Aufgrund interner Beschränkungen speichert Search Console die obersten Datenzeilen und nicht alle Datenzeilen.“ Die zurückgegebenen Daten sind absteigend nach Klicks sortiert, ohne sekundäre Sortierung – das heißt, Suchanfragen mit wenig Traffic und Long-Tail-Begriffe fallen zuerst heraus.
Manche SEOs fragen: „Brauchen wir wirklich Zugriff auf alle Daten?“ Die Realität ist: Ja, brauchen wir. Denn letztlich können wir mit allen Daten bessere Entscheidungen bei Strategie, Umsetzung usw. treffen.
Was das in der Praxis bedeutet
Stellen Sie sich vor, Ihre Website rankt in einem bestimmten Monat für 25.000 einzelne Suchanfragen. In der GSC-Oberfläche sehen Sie davon die Top 1.000. Über die API rufen Sie vielleicht bis zu 50.000 Zeilen ab – aber wenn Sie Query/Page-Kombinationen über mehrere Geräte und Länder hinweg ziehen, fehlt Ihnen trotzdem ein erheblicher Teil Ihrer Long-Tail-Daten. Diese fehlenden Daten sind auf Chart-Ebene allerdings nicht verloren – sie zählen weiterhin in die Performance-Gesamtwerte. Und genau da beginnt die Verwirrung.
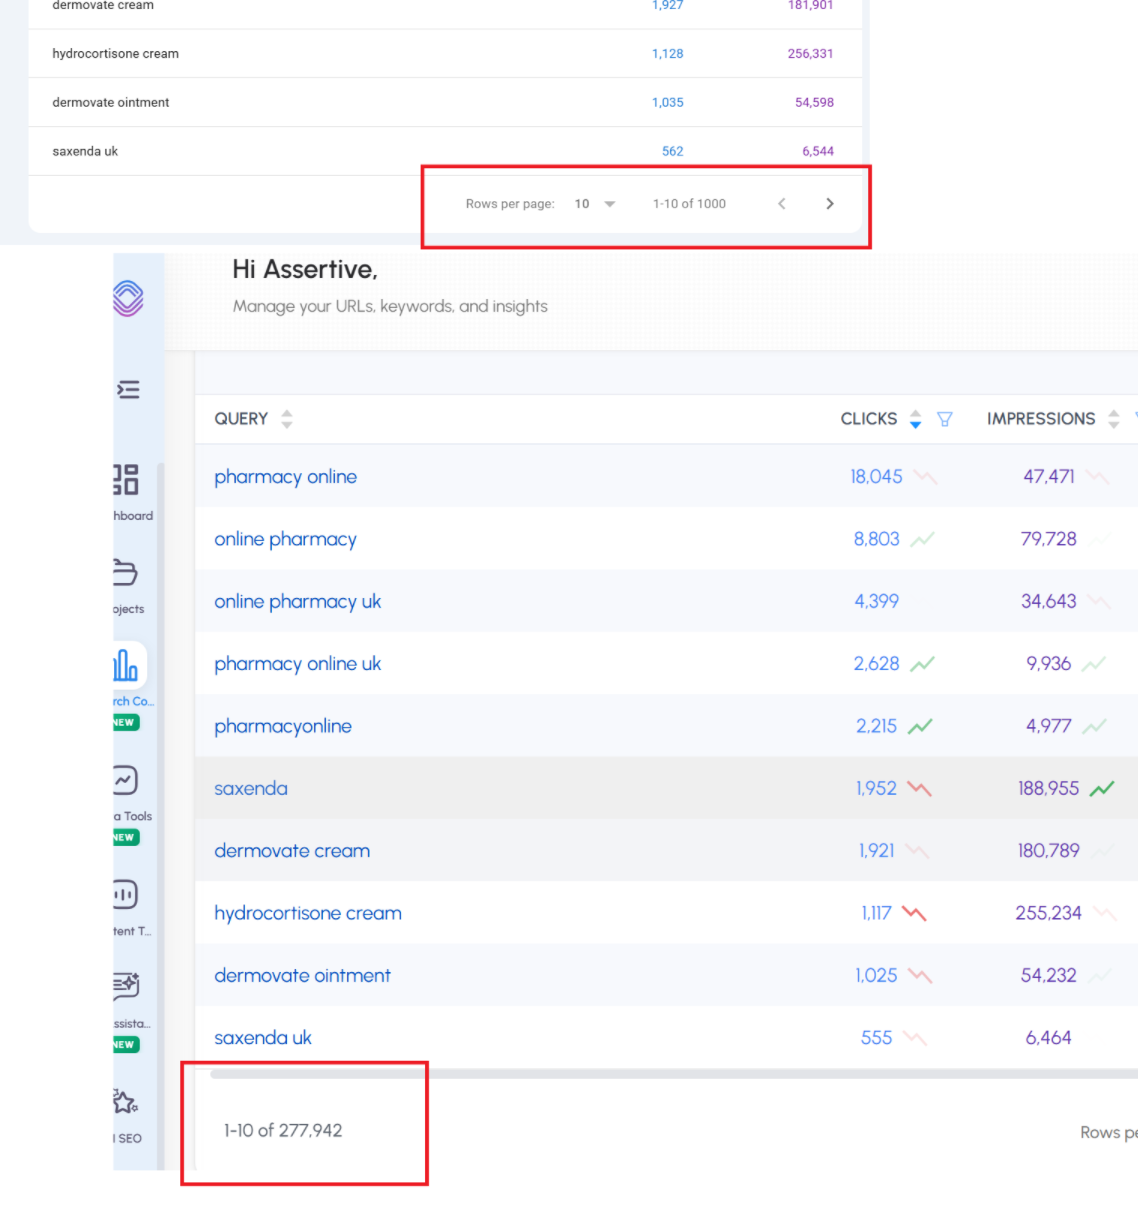
Also: Über die Oberfläche der Google Search Console können Sie immer nur auf die ersten 1.000 Suchanfragen in Bezug auf die angewendeten Filter zugreifen:
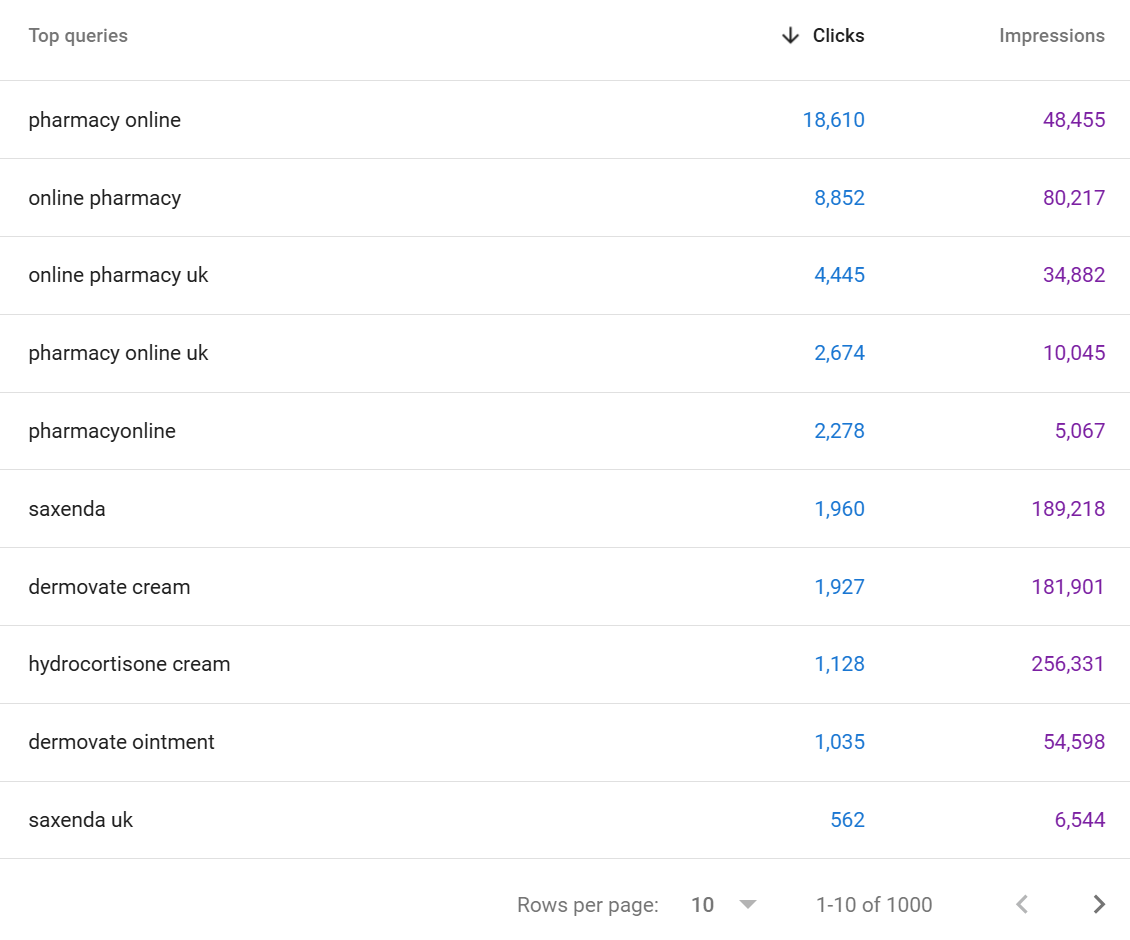
Es gibt ein ERHEBLICHES Volumen an Suchanfragen, die Sie nicht sehen. Selbst wenn Sie weiter herunterfiltern, sind die Daten immer auf maximal 1.000 Zeilen begrenzt (außer beim Vergleich – aber üblicherweise bleibt das unter 1.500 Suchanfragen).
Deshalb haben wir bei SEO Stack die Beschränkungen bei Google Search Console aufgehoben:
Für unseren Kunden pharmacyonline.co.uk sehen wir in GSC 1.000 Suchanfragen. Schauen wir uns dieselbe URL-Property in SEO Stack an, sehen wir >
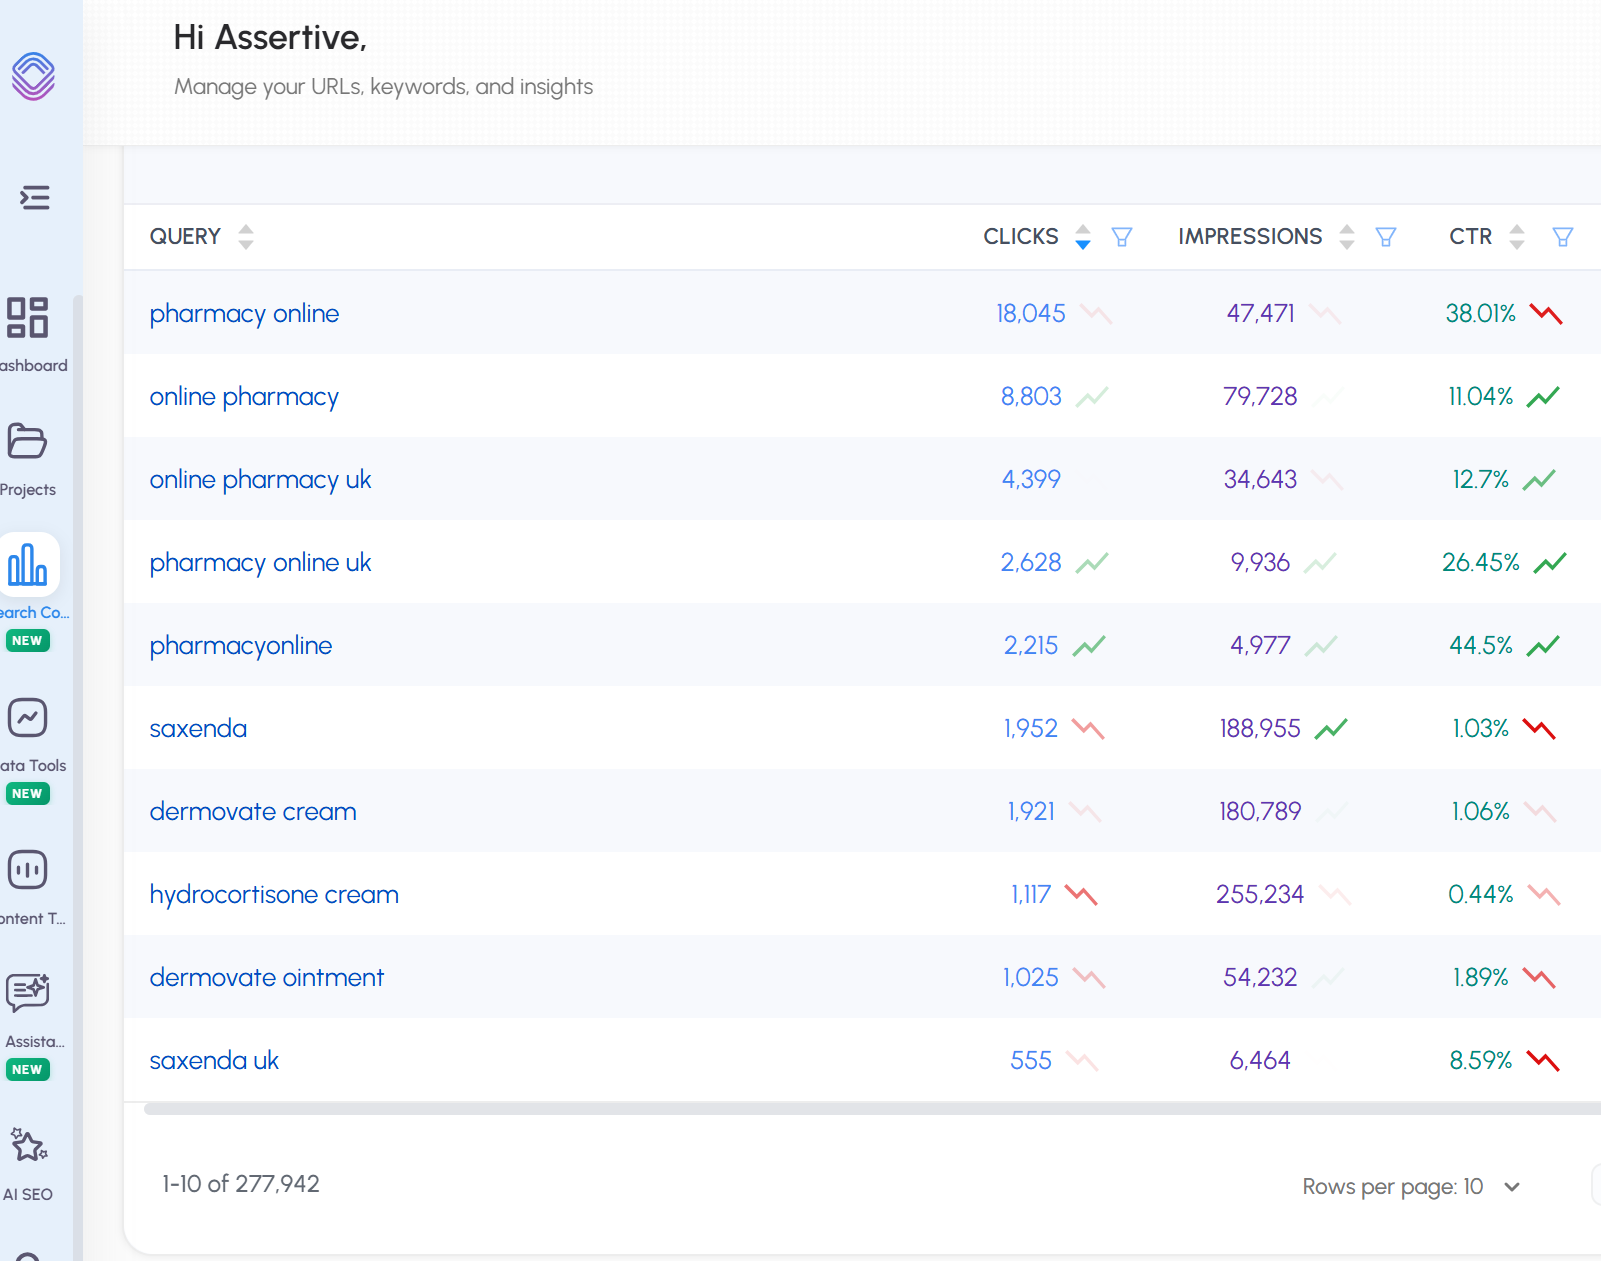
Wir sehen 277.942 Suchanfragen.
Kurz gesagt: SEO Stack schließt die Daten aus Google Search Console auf, weil wir die Daten speichern und zugänglich machen.
2. Chart und Tabelle sind unterschiedliche Datensätze
Das ist einer der am häufigsten missverstandenen Aspekte der Google Search Console, und selbst erfahrene SEOs tappen hier hinein. Das Performance-Chart oben im Bericht und die Datentabelle darunter zeigen nicht dieselben Daten.
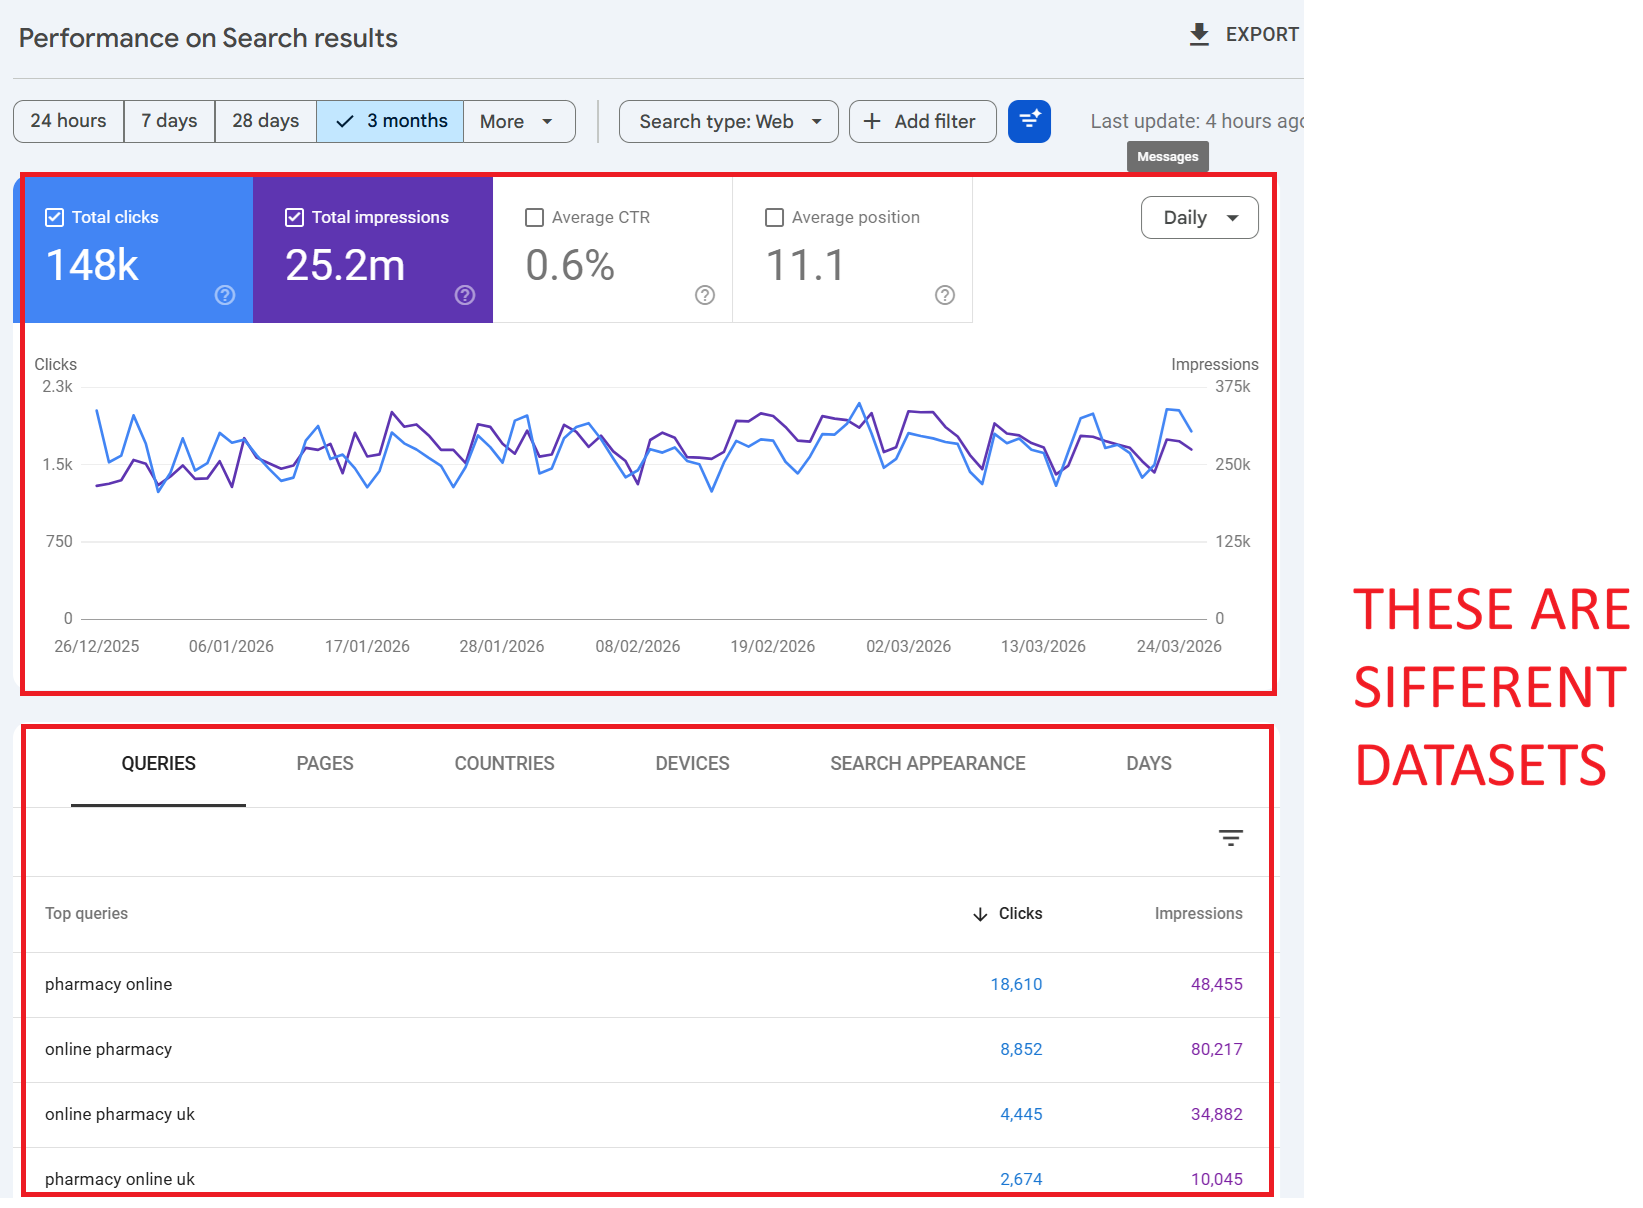
Wie das Chart funktioniert
Das Chart zeigt aggregierte Gesamtwerte für Ihre gesamte Property. Wenn keine Filter angewendet sind, enthält das Chart alle Klicks, Impressionen, CTR- und Positionsdaten – einschließlich Klicks aus anonymisierten Suchanfragen. Es bildet das vollständige Bild dessen ab, was Google für Ihre Website erfasst hat.
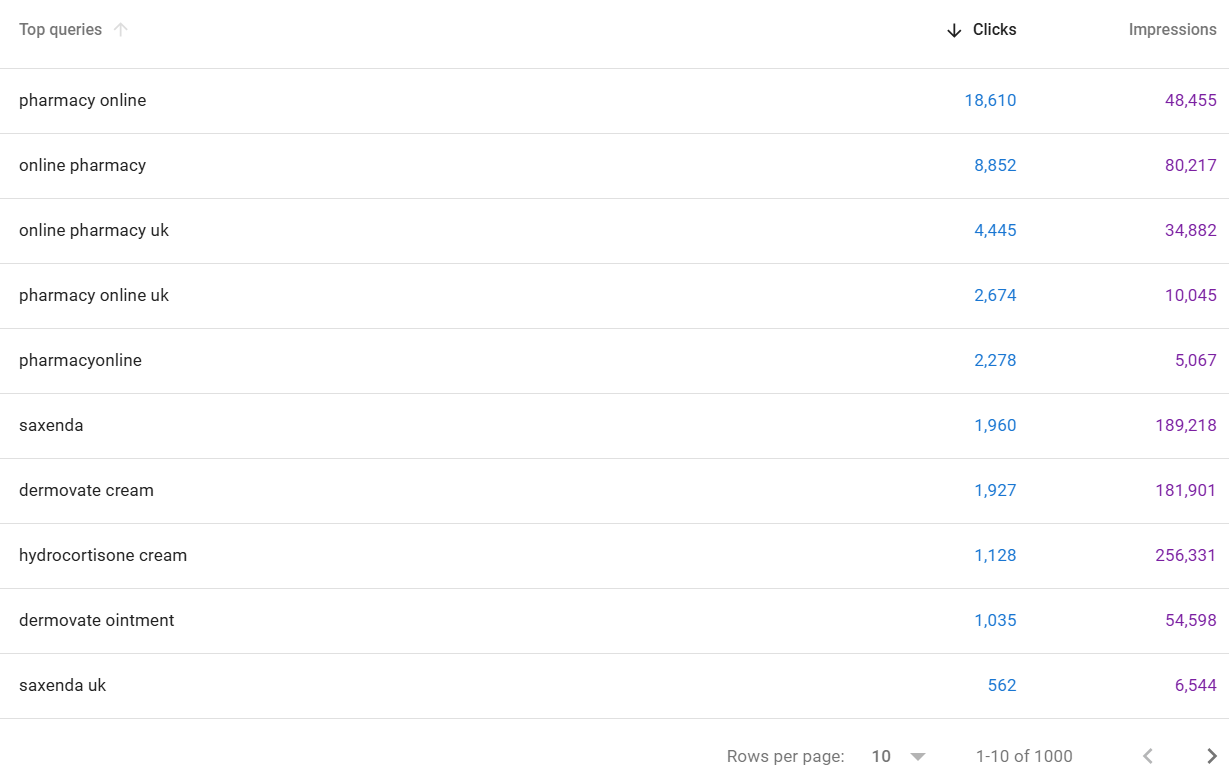
Wie die Tabelle funktioniert
Die Tabelle unter dem Chart zeigt dagegen nur Daten für identifizierte, nicht anonymisierte Suchanfragen. Wenn Google Klicks keiner konkreten, benannten Suchanfrage zuordnen kann (weil die Anfrage aus Datenschutzgründen anonymisiert wurde), tauchen diese Klicks in der Tabelle schlicht nicht auf. Es gibt keine Zeile „anonymisierte Suchanfragen“ – die Daten fehlen einfach.
Das Ergebnis
Wenn Sie jede Zeile der Query-Tabelle aufsummieren, liegt Ihre Summe fast immer niedriger als der Chart-Gesamtwert. Die Differenz sind die Daten anonymisierter Suchanfragen – Klicks, die passiert sind, die Google erfasst hat, zu denen Sie aber keinen Suchbegriff sehen.
💡 Beispiel: Ihr Chart zeigt 10.000 Klicks für den Monat. Sie exportieren alle Query-Zeilen und summieren die Klicks – Sie kommen auf 5.400. Die restlichen 4.600 Klicks stammen aus anonymisierten Suchanfragen. Google hat sie erfasst, verrät Ihnen aber nicht, wonach die Leute gesucht haben.
3. Warum fehlen Query- und Klickdaten?
Es gibt mehrere klar unterscheidbare Gründe, warum Ihre GSC-Daten unvollständig sind. Jeden davon zu verstehen ist entscheidend, um Ihre Berichte richtig zu interpretieren.
Grund 1: Anonymisierte Suchanfragen (Datenschutz-Filterung)
Das ist der größte Faktor. Google definiert anonymisierte Suchanfragen als solche, „die über einen Zeitraum von zwei bis drei Monaten nicht von mehr als ein paar Dutzend Nutzern gestellt werden“. Diese Anfragen werden vollständig aus den Datentabellen entfernt, um die Privatsphäre der Nutzer zu schützen.
Das Ausmaß ist erheblich. Die Ahrefs-Studie von 2025 über 22 Milliarden Klicks ergab, dass anonymisierte Suchanfragen im Schnitt 46,77 % aller Klicks ausmachten. Bei manchen Websites lag der Wert über 80 %. Die Verteilung schwankt enorm: Websites mit vielen Long-Tail-, Nischen- oder proprietären Suchbegriffen sehen weit mehr Anonymisierung als Websites, die von einer Handvoll volumenstarker Head-Terms dominiert werden.
Wichtig: Es geht nicht um das Query-Volumen auf Ihrer Website – es geht darum, wie viele einzelne Nutzer im gesamten Web nach diesem Begriff gesucht haben. Eine Suchanfrage kann 50 Klicks auf Ihre Website bringen; wenn aber weltweit nur 20 Personen in 3 Monaten danach gesucht haben, anonymisiert Google sie.
Grund 2: Zeilenlimits und Datenkürzung
Wie oben beschrieben, speichert und liefert GSC nur die „obersten“ Datenzeilen. Google priorisiert Zeilen mit den höchsten Klickzahlen. Wenn Ihre Website Tausende Query/Page-Kombinationen hat, fallen die am unteren Ende – typischerweise Long-Tail-Anfragen mit 1–2 Klicks – einfach weg. Das ist unabhängig von der Anonymisierung; diese Anfragen können durchaus genug einzelne Suchende haben, um identifiziert zu werden, werden aber wegen Speicher- und Verarbeitungsgrenzen aus dem Datensatz geschnitten.
Grund 3: Verzögerung bei der Datenverarbeitung
GSC-Daten sind typischerweise um 2–3 Tage verzögert. Daten der jüngsten Tage können unvollständig sein oder ganz fehlen. Das ist eine normale Verarbeitungsverzögerung, und die Daten füllen sich mit der Zeit auf – aber es kann Verwirrung stiften, wenn Sie Berichte in Echtzeit prüfen.
Grund 4: Unterschiede bei Property-Typ und Aggregation
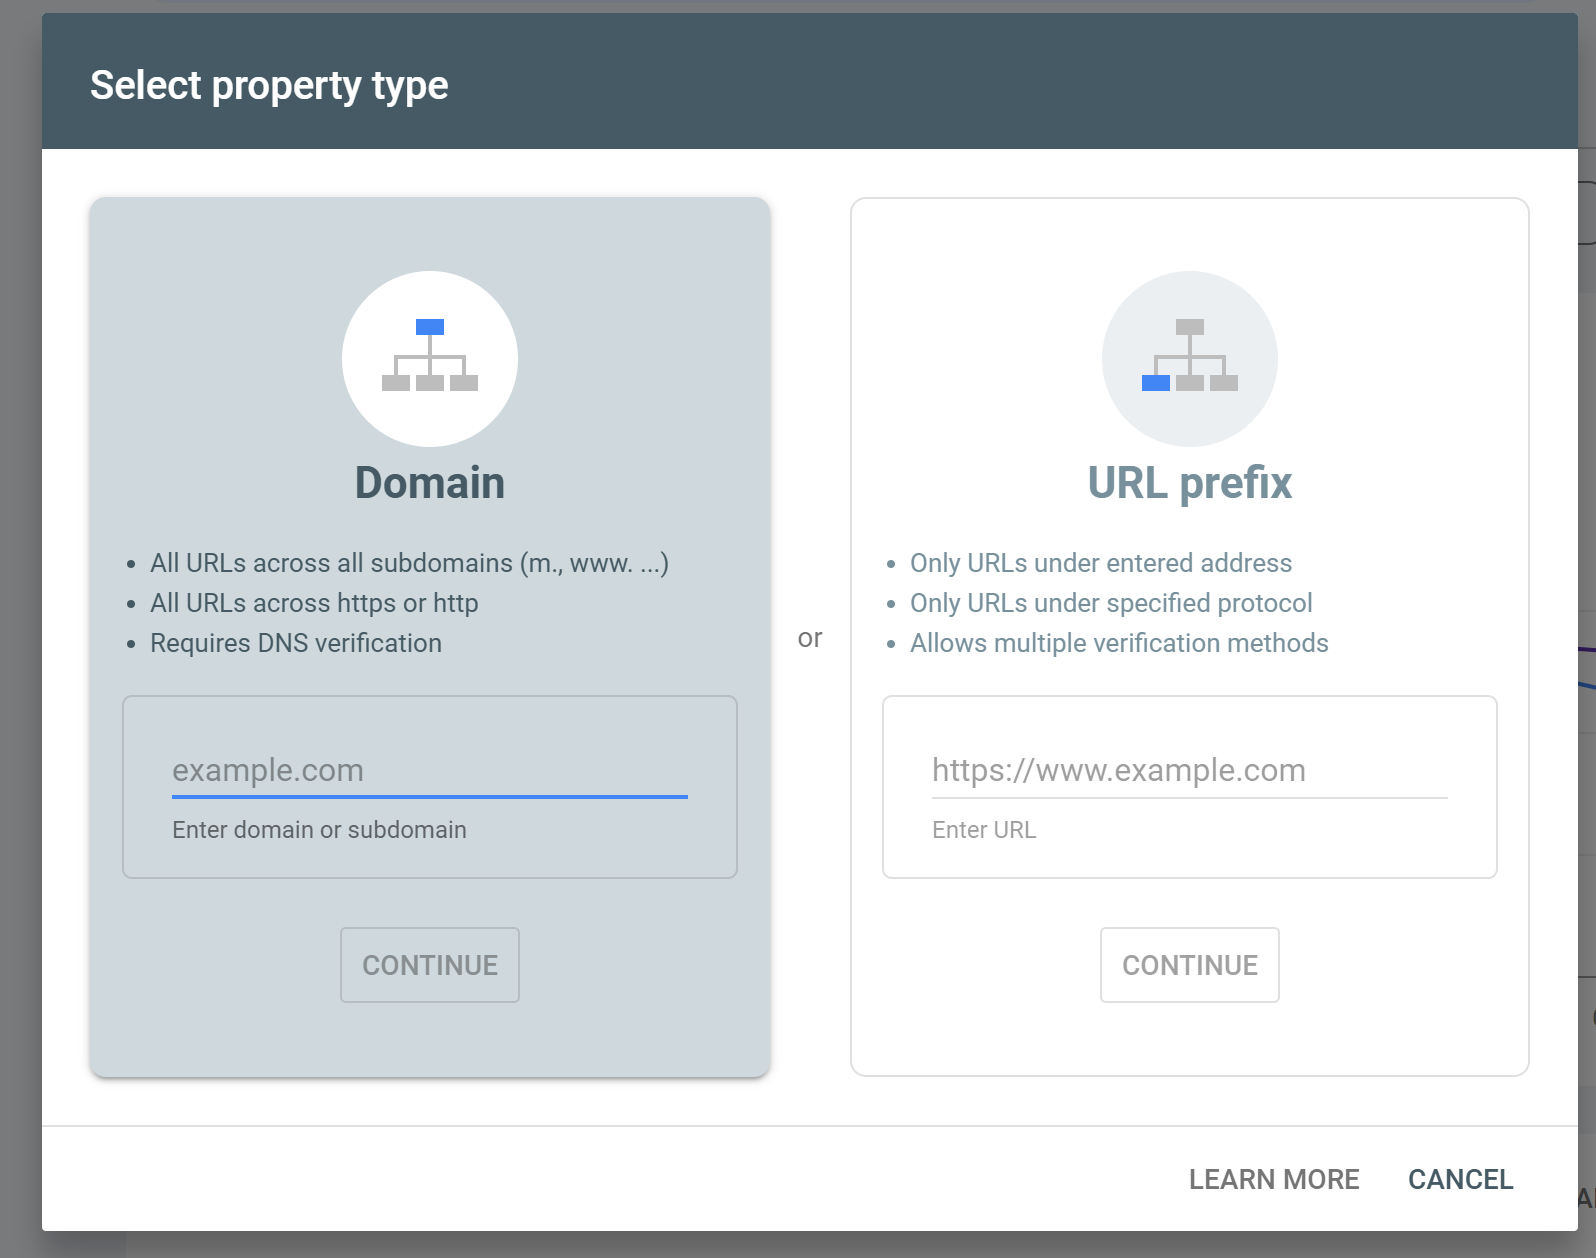
Wie Daten aggregiert werden, hängt davon ab, ob Sie eine Domain-Property oder eine URL-Präfix-Property nutzen und ob auf Property- oder Seitenebene aggregiert wird. Der Wechsel zwischen diesen Kontexten kann dazu führen, dass sich Gesamtwerte unerwartet ändern – besonders, wenn die Aggregationsmethode von Property-Ebene auf Seitenebene wechselt, was die ausgewiesenen Zahlen tatsächlich erhöhen kann, weil granularere Datenpunkte sichtbar werden.
Grund 5: Sensible oder persönliche Suchanfragen
Über die Volumenschwelle hinaus entfernt Google auch Suchanfragen, die persönliche oder sensible Informationen enthalten. Gesundheitsanfragen, Finanzdetails und anderes personenbezogen identifizierbares Suchverhalten können unabhängig vom Suchvolumen entfernt werden. Googles Dokumentation weist ausdrücklich darauf hin, dass Anfragen mit „persönlichen oder sensiblen Informationen“ möglicherweise nicht erfasst werden.
4. Sampelt Google Search Console Daten?
Das ist eine häufige Frage, und die Antwort ist differenziert. GSC „sampelt“ Daten nicht in der Weise, wie Google Analytics (UA) dafür bekannt war, Session-Daten für traffic-starke Berichte zu sampeln. Google wählt nicht zufällig eine Teilmenge an Klicks aus und extrapoliert daraus.
Allerdings kürzt und filtert GSC Daten auf eine Weise, die einen ähnlichen Effekt erzeugt. Die Kombination aus Datenschutz-Filterung (anonymisierte Suchanfragen), Zeilenlimits (nur oberste Datenzeilen) und Bloom-Filter-Näherungen bedeutet: Was Sie sehen, ist keine Zufallsstichprobe, aber eine unvollständige Abbildung des vollständigen Datensatzes.
Googles eigene Formulierung in der ausführlichen Dokumentation ist aufschlussreich: „Wir gehen davon aus, dass die verbleibenden Daten groß genug sind, um eine repräsentative Stichprobe der Daten zu bilden.“ Achten Sie auf das Wort „Stichprobe“ – selbst Google räumt ein, dass Sie eine repräsentative Teilmenge sehen, nicht das vollständige Bild.
Praktisch heißt das: Für die meisten kleinen bis mittleren Websites sind die Daten einigermaßen vollständig. Bei größeren Websites mit vielfältigen Query-Profilen können die Datenlücken erheblich sein. Je mehr Dimensionen Sie hinzufügen (Query + Page + Country + Device), desto mehr Daten werden gekürzt.
5. Bloom-Filter: Der verborgene Grund, warum Ihre Zahlen nicht passen
Im September 2023 ging Googles Gary Illyes direkt auf ein langjähriges Rätsel ein: Warum zeigen gefilterte Daten in GSC manchmal MEHR Klicks als ungefilterte Daten? Die Antwort: Bloom-Filter.
Was ist ein Bloom-Filter?
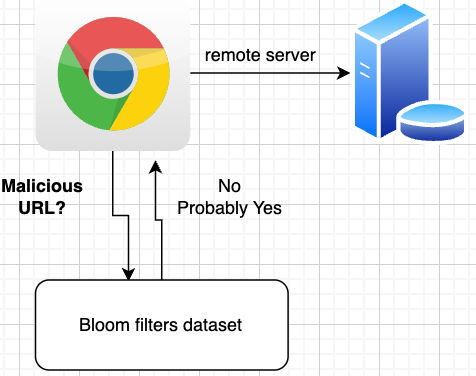
Ein Bloom-Filter ist eine probabilistische Datenstruktur, die 1970 von Burton Howard Bloom erfunden wurde. Sie ist darauf ausgelegt, extrem schnell und mit minimalem Speicherbedarf zu prüfen, ob ein Element Teil einer Menge ist. Der Kompromiss: Sie kann False Positives erzeugen (behaupten, etwas sei in der Menge, obwohl es das nicht ist), aber niemals False Negatives (sie sagt nie, dass etwas nicht da ist, wenn es da ist).
Wie Google Bloom-Filter in GSC einsetzt
Gary Illyes erklärte, dass Google für das Search-Console-Reporting Milliarden, potenziell Billionen von Datenelementen verarbeitet. Bestimmte Elemente in so großen Datensätzen nachzuschlagen ist rechenintensiv. Bloom-Filter lösen das, indem sie eine kleinere, gehashte Version der Daten erzeugen, die zuerst konsultiert werden kann.
In Illyes' Worten: „Bloom-Filter beschleunigen Lookups, indem sie vorhersagen, ob etwas in einem Datensatz existiert – auf Kosten der Genauigkeit. Und je kleiner der Datensatz ist, desto genauer sind die Vorhersagen.“
Der Hashing-Prozess kann zu Datenverlust führen – entweder absichtlich oder als unvermeidbarer Nebeneffekt der Komprimierung. Deshalb gilt:
• Das Anwenden eines Seitenfilters kann Ihre Klick-Gesamtzahl erhöhen – weil der spezifischere (kleinere) Datensatz den Bloom-Filter mit höherer Genauigkeit passiert und Daten zurückholt, die in der breiteren, ungefilterten Ansicht verloren gingen.
• Das Entfernen eines Filters kann Ihre Gesamtwerte verringern – weil die Rückkehr zur größeren Aggregation auf Property-Ebene die Näherungsfehler des Bloom-Filters wieder einführt.
• Include- und Exclude-Filtersummen ergeben nicht den ungefilterten Gesamtwert – weil jede gefilterte Teilmenge den Bloom-Filter unabhängig passiert und die Näherungsfehler bei jedem Durchlauf anders ausfallen.
💡 Denken Sie es sich so: Google nutzt eine sehr effiziente Näherungsmaschine statt exakter Zählung. Das ist schnell, aber die Rundungsfehler akkumulieren je nach Datenschnitt unterschiedlich. Je kleiner der Schnitt, desto genauer ist es in der Regel.
6. Praktische Beispiele: Probieren Sie das in Ihrem eigenen GSC-Konto aus
Der beste Weg, diese Datenlücken zu verstehen, ist, sie selbst zu sehen. Hier sind mehrere Übungen, die Sie sofort in Google Search Console durchführen können.
Übung 1: Die Brand-Query-Diskrepanz
Was zu tun ist: Öffnen Sie GSC > Leistung > stellen Sie einen 3-Monats-Zeitraum ein. Notieren Sie die Gesamtklicks im Chart (sagen wir, es zeigt 15.000 Klicks).
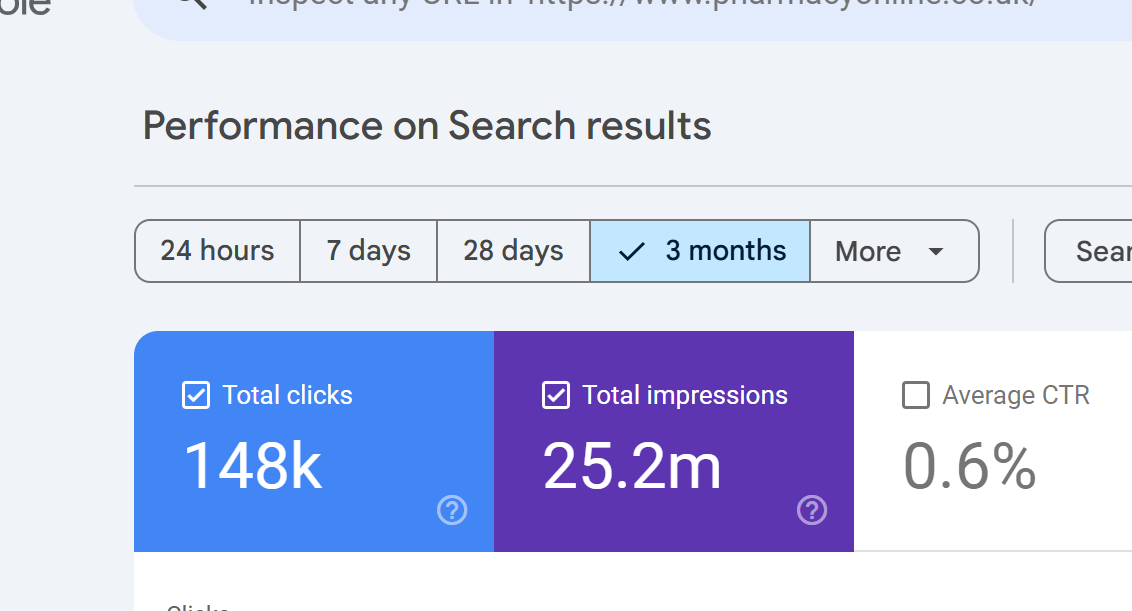
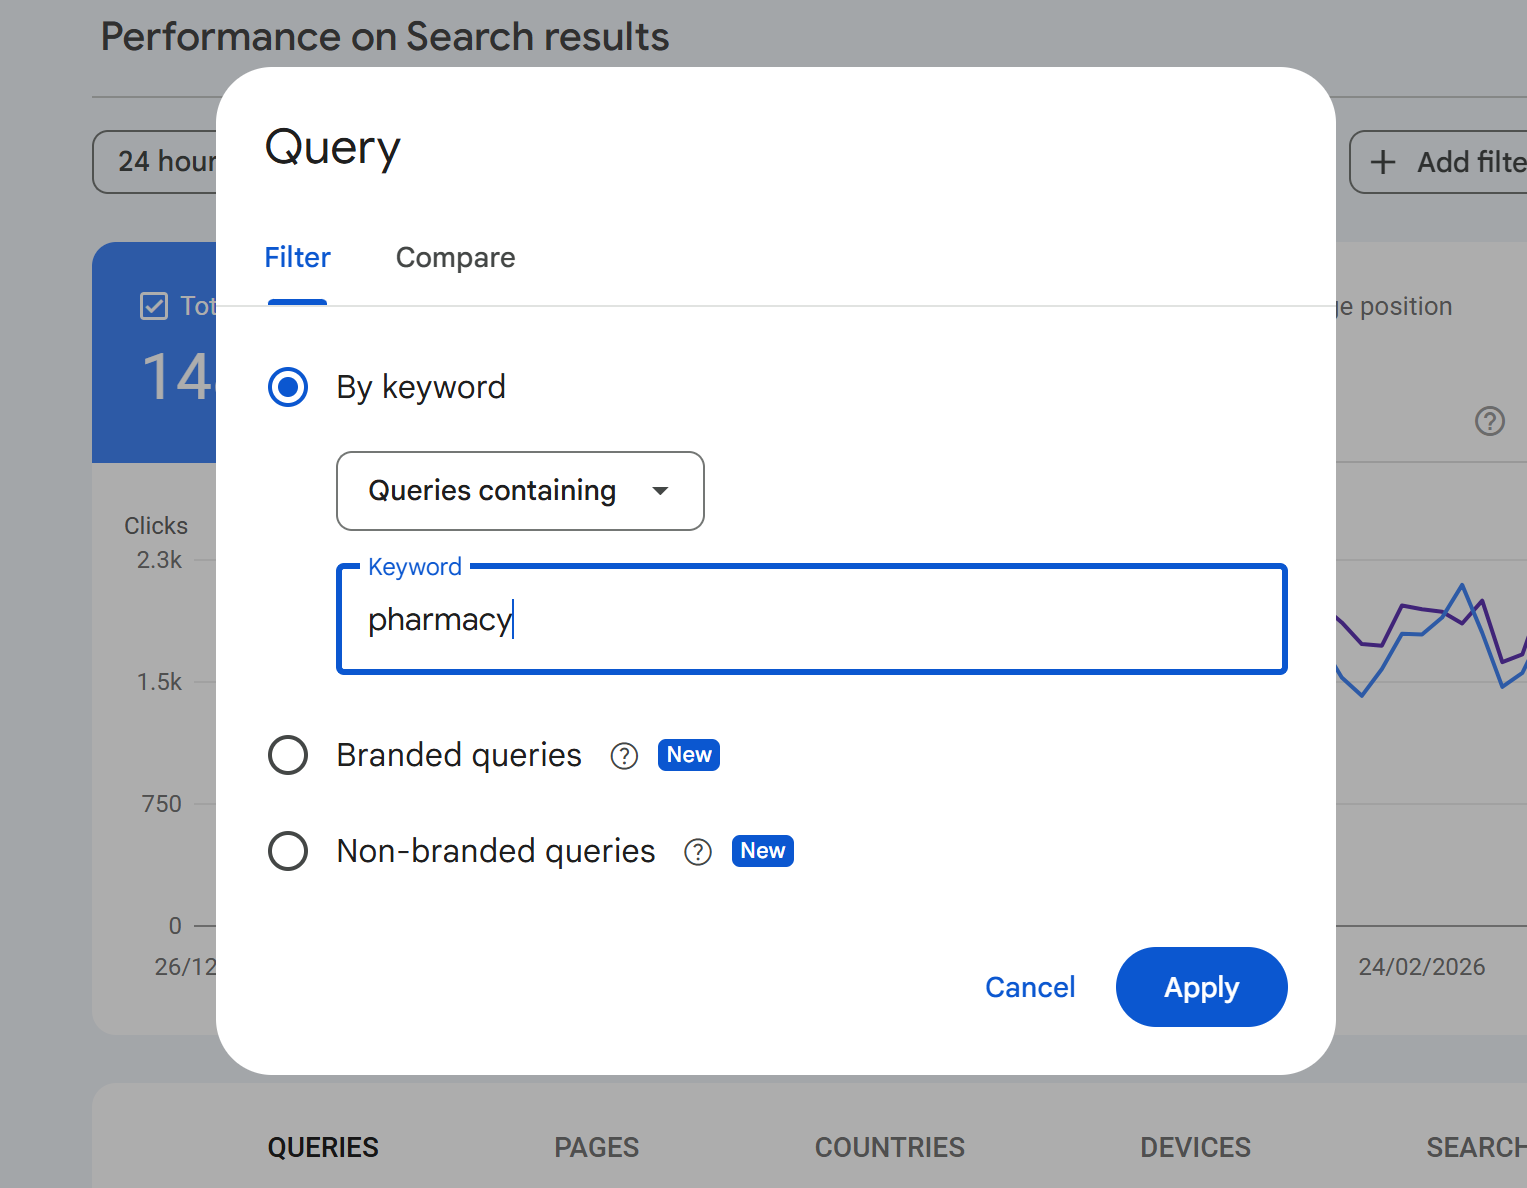
Fügen Sie nun einen Query-Filter hinzu: Suchanfragen, die „ihremarke“ enthalten. Das Chart zeigt vielleicht 4.200 Klicks.
In diesem Beispiel wenden wir den Query-Filter „pharmacy“ an.
Ändern Sie den Filter auf: Suchanfragen, die „ihremarke“ NICHT enthalten. Das Chart zeigt vielleicht 6.300 Klicks.
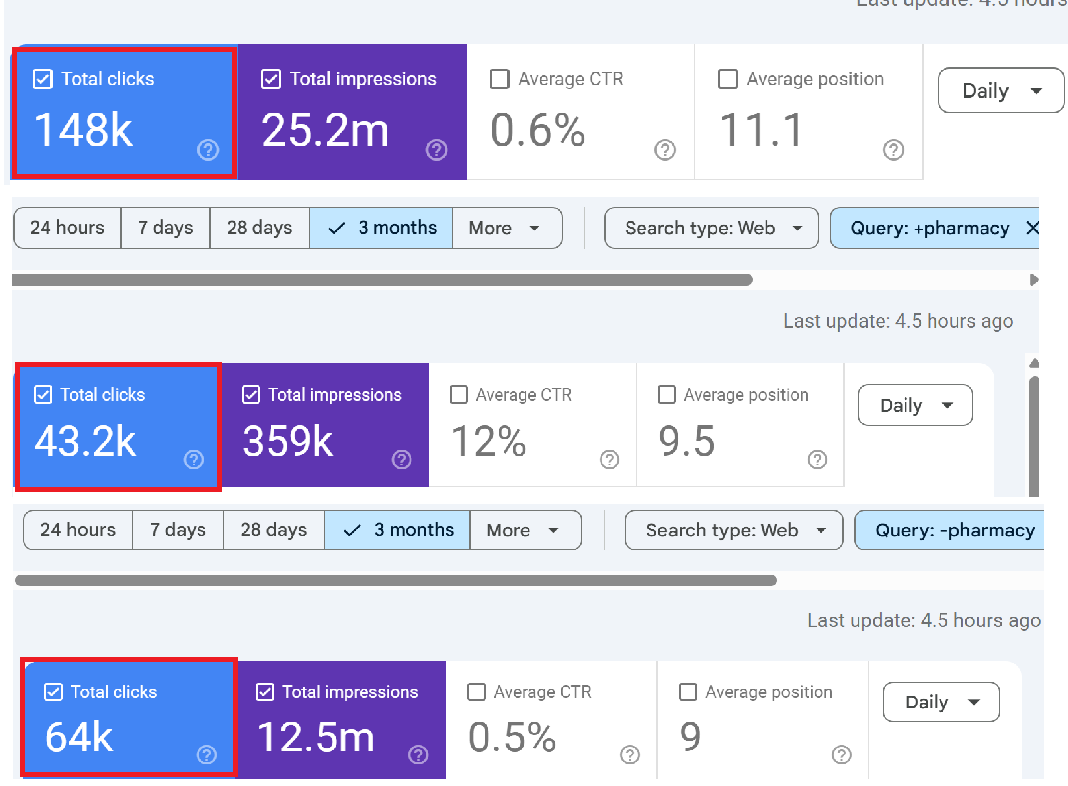
4.200 + 6.300 = 10.500. Aber der ungefilterte Gesamtwert lag bei 15.000. Wo sind die fehlenden 4.500 Klicks?
Was passiert: Sobald Sie irgendeinen Query-Filter anwenden (einschließend oder ausschließend), entfernt GSC alle anonymisierten Suchanfragen aus den Gesamtwerten. Diese 4.500 Klicks stammten aus Anfragen, die Google anonymisiert hat. Ohne Filter sind sie im Chart-Gesamtwert enthalten. Mit Filter verschwinden sie vollständig, weil Google nicht beurteilen kann, ob eine anonymisierte Anfrage Ihren Markennamen enthält oder nicht.
Übung 2: Chart-Gesamtwert vs. Tabellensumme
Was zu tun ist: Notieren Sie im Leistungsbericht ohne angewendete Filter die Gesamtklicks im Chart. Klicken Sie dann unten auf den Tab „Suchanfragen“ und exportieren Sie alle Zeilen in eine Tabelle. Summieren Sie die Klick-Spalte.
Was Sie feststellen werden: Die Summe der Klicks in der Tabelle liegt unter dem Chart-Gesamtwert. Die Lücke sind Ihre anonymisierten Query-Daten. Bei vielen Websites beträgt diese Lücke 30–60 % des Gesamtwerts.
Übung 3: Seitenfilter erhöht die Klicks
Was zu tun ist: Notieren Sie Ihre ungefilterten Gesamtklicks. Fügen Sie dann einen Seitenfilter für Ihre populärste URL hinzu (z. B. Seiten, die „/ihre-top-seite/“ enthalten). Schauen Sie sich den Gesamtwert an.
Was passieren kann: In manchen Fällen liegt der gefilterte Gesamtwert für diese Seite höher als das, was der ungefilterte Bericht für dieselbe Seite in der Tabelle gezeigt hat. Das ist der Bloom-Filter am Werk – der kleinere, spezifischere Datensatz wird mit höherer Genauigkeit verarbeitet und bringt Daten zum Vorschein, die in der breiteren Aggregation verloren gingen.
Übung 4: Lücken bei der Länderfilterung
Was zu tun ist: Schauen Sie sich Ihre Gesamtklicks an. Filtern Sie dann nach Land – sagen wir Vereinigtes Königreich. Notieren Sie die Klicks. Wechseln Sie dann zu den USA und notieren Sie diese Klicks. Addieren Sie alle einzeln gefilterten Länder.
Was Sie feststellen werden: Die Summe der einzelnen Länderklicks entspricht nicht dem Gesamtwert, weil viele Klicks keinem bestimmten Land zugeordnet werden und jeder Filterdurchlauf seinen eigenen Bloom-Filter-Näherungsfehler einbringt.
Übung 5: Filter stapeln verstärkt die Lücke
Was zu tun ist: Beginnen Sie mit einem Seitenfilter für eine bestimmte URL. Notieren Sie die Klicks. Fügen Sie nun zusätzlich einen Query-Filter hinzu. Dann einen Länderfilter. Mit jedem weiteren Filter verschwinden mehr Daten.
Warum: Jeder Filter verstärkt den Effekt. Anonymisierte Suchanfragen fallen bei jedem Query-Filter weg. Zeilenlimits schneiden aggressiver, wenn mehrere Dimensionen im Spiel sind. Und Bloom-Filter-Näherungsfehler akkumulieren sich mit jedem zusätzlichen Filterdurchlauf. Je spezifischer Sie werden, desto unvollständiger werden Ihre Daten – ein frustrierendes Paradox für alle, die granulare Analysen machen wollen.
7. Häufige Fragen zu fehlenden GSC-Daten
F: Warum stimmen meine Klick-Gesamtwerte bei Suchanfragen und Seiten nicht überein?
Der Suchanfragen-Bericht und der Seiten-Bericht nutzen unterschiedliche Aggregationsmethoden. Der Suchanfragen-Bericht zählt Klicks pro Suchanfrage, der Seiten-Bericht zählt Klicks pro Seite. Ein einzelner Klick kann sowohl in einer Query-Zeile als auch in einer Seiten-Zeile auftauchen, aber anonymisierte Suchanfragen werden aus dem Suchanfragen-Bericht ausgeschlossen, während der entsprechende Seitenklick im Seiten-Bericht weiterhin gezählt wird. Zudem kann eine einzelne Seite für mehrere Suchanfragen ranken und eine einzelne Suchanfrage zu mehreren Seiten führen – die Deduplizierung funktioniert in jeder Ansicht anders.
F: Ist das nur ein Problem der kostenlosen GSC-Oberfläche?
Nein. Die API hat höhere Zeilenlimits (50.000 statt 1.000), unterliegt aber derselben Datenschutz-Filterung und demselben Bloom-Filter-Verhalten. Selbst der BigQuery-Bulk-Export, die vollständigste Datenquelle, enthält anonymisierte Suchanfragen als NULL-Werte – Sie sehen, dass dieser Traffic existiert, wissen aber trotzdem nicht, wonach die Leute gesucht haben. Allerdings zeigt BigQuery eine niedrigere Anonymisierungsrate, weil dort mehr Anfragen im Grenzbereich erfasst werden, die die API verwirft.
F: Meine Website ist klein – betrifft mich das?
Ja, oft überproportional. Kleinere Websites erhalten tendenziell Traffic aus vielen volumenschwachen Long-Tail-Anfragen. Da die Anonymisierung davon abhängt, wie viele einzelne Nutzer weltweit nach einem Begriff gesucht haben, haben kleine Websites mit Nischenpublikum oft einen höheren Anteil anonymisierter Daten. Eine Untersuchung von SEO Gets ergab, dass kleine Websites eine Query-Sichtbarkeit von nur 0–37 % hatten, im Durchschnitt lediglich 18,3 %.
F: Kann ich die fehlenden Query-Daten wiederherstellen?
Nicht direkt bei Google. Sie können GSC-Daten aber mit Drittanbieter-Tools wie Ahrefs, Semrush oder SEO Stack abgleichen, um Suchanfragen zu identifizieren, die wahrscheinlich Traffic bringen, aber nicht in GSC erscheinen. Der BigQuery-Export bewahrt außerdem die Zeilen anonymisierter Suchanfragen (mit NULL-Query-Werten), sodass Sie zumindest quantifizieren können, wie viel Traffic nicht zugeordnet ist. Die erweiterte Datenaufbewahrung und die KI-gestützte Analytik von SEO Stack helfen Ihnen, Muster in Ihrem Long-Tail-Traffic zu erkennen, die GSC allein nicht sichtbar machen kann.
F: Warum hat Google seine Dokumentation von „sehr selten“ auf „manche“ geändert?
Nach der Ahrefs-Studie von 2022, die zeigte, dass fast die Hälfte aller Klicks auf verborgene Begriffe entfällt, hat Google seine Hilfedokumentation aktualisiert und die Behauptung entfernt, anonymisierte Suchanfragen seien „sehr selten“. Die neue Formulierung lautet nun, dass „manche Suchanfragen“ anonymisiert werden. Danny Sullivan von Google räumte ein, dass Long-Tail-Begriffe, die einzeln selten sind, in Summe einen erheblichen Anteil am Gesamt-Traffic ausmachen können.
F: Warum zeigt das Filtern nach einer bestimmten Seite manchmal mehr Klicks als die ungefilterten Daten?
Das ist der Bloom-Filter-Effekt. Wenn Sie einen Seitenfilter anwenden, wechselt GSC von der Aggregation auf Property-Ebene zur Aggregation auf Seitenebene. Der kleinere, spezifischere Datensatz passiert den Bloom-Filter mit höherer Genauigkeit, was Daten zurückholen kann, die in der breiteren Aggregation verloren gingen. Das klingt kontraintuitiv, ist aber eine direkte Folge davon, wie probabilistische Datenstrukturen Geschwindigkeit gegen Genauigkeit eintauschen.
F: Sind die Daten seit dem Start von AI Overviews schlechter?
Wahrscheinlich, auch wenn Google das nicht ausdrücklich bestätigt hat. AI Overviews und dialogorientierte Suchoberflächen begünstigen längere, natürlichsprachigere Suchanfragen. Längere Anfragen sind tendenziell einzigartiger, das heißt, weniger verschiedene Nutzer suchen nach exakt derselben Zeichenfolge. Dadurch rutschen mehr Anfragen unter Googles Anonymisierungsschwelle. Die Ahrefs-Studie von 2025 wurde vor dem vollständigen Rollout der AI Overviews durchgeführt – die tatsächliche aktuelle Anonymisierungsrate dürfte also noch höher liegen als 46,77 %.
F: Stimmen GSC-Daten mit Google-Analytics-Daten überein?
Nein, und das sollen sie auch nicht. GA erfasst Sessions auf Ihrer Website (dazu müssen JavaScript ausgeführt und die Seite geladen werden). GSC erfasst Klicks aus den Suchergebnissen (auf Googles Seite registriert). Bot-Traffic, JavaScript-Fehler, Timeouts beim Seitenaufbau, Weiterleitungen und Datenschutzeinstellungen erzeugen allesamt Abweichungen zwischen beiden. Sie messen verwandte, aber grundlegend unterschiedliche Dinge.
8. Was Sie dagegen tun können
1. Nutzen Sie die API, nicht nur die Oberfläche. Die API liefert 50-mal mehr Zeilen als die Web-UI. Tools wie SEO Stack ziehen API-Daten automatisch und speichern sie mit erweiterter Aufbewahrung, sodass Sie immer mit dem vollständigsten verfügbaren Datensatz arbeiten.
2. Aktivieren Sie den BigQuery-Bulk-Export. Wenn Sie Owner-Zugriff haben, ist das die umfassendste Datenquelle. Anonymisierte Suchanfragen erscheinen als NULL-Werte – Sie sehen den Query-Text nicht, können den nicht zugeordneten Traffic aber quantifizieren und segmentieren.
3. Vertrauen Sie keiner Filter-Arithmetik. Akzeptieren Sie, dass gefilterte Gesamtwerte nicht die ungefilterten Gesamtwerte ergeben. Nutzen Sie ungefilterte Daten für das Topline-Reporting und gefilterte Daten für richtungsweisende Analysen, nicht für exakte Buchhaltung.
4. Gleichen Sie mit Drittanbieter-Daten ab. Tools wie Ahrefs, Semrush und SEO Stack können Query-Daten sichtbar machen, die GSC anonymisiert. Der Anonymous-Queries-Bericht von Ahrefs gleicht gezielt GSC-Daten mit den eigenen Ranking-Daten ab, um wahrscheinliche verborgene Begriffe zu identifizieren.
5. Analysieren Sie für Vollständigkeit auf Seitenebene. Untersuchungen zeigen durchgängig, dass Daten auf Seitenebene in GSC deutlich vollständiger sind als Daten auf Query-Ebene. Kleine Websites zeigen auf Seitenebene 97–102 % der Gesamtklicks, verglichen mit teils nur 18 % auf Query-Ebene. Wenn Sie exakte Klickzahlen brauchen, nutzen Sie Seiten- statt Query-Dimensionen.
6. Konzentrieren Sie sich auf Trends, nicht auf Absolutwerte. GSC-Daten sind richtungsweisend korrekt, auch wenn sie nicht perfekt vollständig sind. Ein Klick-Plus von 20 % gegenüber dem Vormonat ist aussagekräftig, unabhängig davon, ob Sie jede einzelne Suchanfrage sehen können. Nutzen Sie die Daten für Trendanalysen und strategische Entscheidungen, nicht für Erbsenzählerei.
7. Nutzen Sie SEO Stack für erweiterte Aufbewahrung und tiefere Analysen. Google bewahrt nur 16 Monate Performance-Daten auf. SEO Stack speichert Ihre GSC-Daten ab dem Moment der Verbindung und ermöglicht so Langzeit-Trendanalysen, die GSC allein nicht liefern kann. Kombiniert mit KI-gestützter Analytik erkennen Sie Muster in Ihren Daten, die eine manuelle GSC-Analyse übersehen würde.
Fazit
Google Search Console ist ein unverzichtbares Tool, aber nicht die ganze Wahrheit. Zwischen anonymisierten Suchanfragen, die fast die Hälfte Ihrer Klickdaten verbergen, Zeilenlimits, die Ihre Long-Tail-Sichtbarkeit beschneiden, und Bloom-Filtern, die eine nicht aufgehende Arithmetik erzeugen, klafft eine erhebliche Lücke zwischen dem, was in der Suche tatsächlich passiert, und dem, was GSC Ihnen zeigt.
Diese Grenzen zu verstehen macht GSC nicht weniger nützlich – es macht Ihre Analyse ehrlicher. Die SEOs, die ihre Wettbewerber übertreffen, sind jene, die wissen, was ihre Daten tatsächlich aussagen, die Lücken umgehen und Tools wie SEO Stack nutzen, um ihre Sichtbarkeit über das hinaus zu erweitern, was Googles kostenlose Oberfläche bietet.
Wenn Ihre GSC-Zahlen das nächste Mal nicht aufgehen, wissen Sie, warum. Und noch wichtiger: Sie wissen, was Sie dagegen tun können.
Quellen & weiterführende Literatur
• SEO Gets: Googles schmutziges kleines Geheimnis – anonyme Suchanfragen (2024)
• Google Search Console Hilfedokumentation: Leistungsbericht für die Suche

Gründer, SEO Stack
Daniel ist der Gründer von SEO Stack. Er arbeitet seit über 2 Jahrzehnten an technischem SEO und Suchdaten und hat SEO Stack entwickelt, nachdem er in der Kundenarbeit einmal zu oft an dieselben Search-Console-Limits gestoßen war.
Daniel verfügt über umfangreiche SEO-Erfahrung: Er hat SEO-Agenturen, Audit-Unternehmen und eine erfolgreiche Beratung aufgebaut. In seiner Freizeit führt Daniel gerne SEO-Experimente durch und teilt seine Erkenntnisse.
Veröffentlicht 27. März 2026

