¿Por qué faltan datos en Google Search Console? ¿Datos de consultas con clics ausentes y datos muestreados?
Si, como yo, alguna vez has mirado los totales de clics en Google Search Console y has pensado «aquí hay algo que no cuadra», no son imaginaciones tuyas. Los datos realmente no cuadran, y es por…
Como a mí, si alguna vez has mirado los totales de clics en Google Search Console y has pensado «aquí hay algo que no cuadra», no son imaginaciones tuyas. Los datos realmente no cuadran, y es algo intencionado.
Google Search Console (GSC) es la herramienta gratuita más importante para entender tu rendimiento en búsqueda orgánica. Pero tiene un secreto que los SEOs nuevos (o júnior) desconocen: no te muestra todos tus datos. De hecho, una investigación de Ahrefs sobre 887.534 propiedades de GSC concluyó que casi el 47% de todos los clics se atribuyen a consultas anonimizadas, lo que significa que casi la mitad de tus datos de clics no tienen un término de búsqueda asociado.
Aquí desglosamos exactamente por qué tus datos de GSC están incompletos, qué ocurre entre bastidores con las consultas anonimizadas, los límites de datos, los filtros de Bloom y el muestreo y, lo más importante, cómo identificar y sortear estas lagunas. Tanto si eres un SEO in-house, consultor, estratega de agencia o propietario de un sitio que intenta dar sentido a sus cifras, esta lectura es importante.
Google Search Console es una herramienta GRATUITA: a Google le cuesta dinero almacenar y procesar datos, por lo que no todos los datos son accesibles a través de la interfaz, y por eso muchos SEOs recurren a soluciones alternativas como Looker Studio con Google BigQuery, o soluciones como SEO Stack, SEO Gets, etc.
1. GSC no te da todos tus datos
Lo primero que todo SEO debe entender es que Google Search Console impone límites estrictos a los datos que te expone. Estos límites existen en la interfaz web, en la API e incluso en la más reciente exportación masiva a BigQuery.
Estos son algunos de los límites de filas habituales en las propias plataformas de Google:
Los límites de filas
Método de acceso | Límite de filas | Notas |
Interfaz web de GSC | 1.000 filas | Máximo visible o exportable por vista de informe |
Search Analytics API | 50.000 filas al día | Por sitio y por tipo de búsqueda. Por defecto devuelve 1.000; hay que usar rowLimit y paginación |
Conector de Looker Studio | 50.000 filas al día | Misma API subyacente, se aplican límites idénticos |
Exportación masiva a BigQuery | Sin límite estricto de filas | El conjunto de datos más completo, pero sigue sujeto al filtrado por privacidad. Requiere acceso de propietario y conocimientos de SQL |
Para un sitio web con decenas de miles de páginas posicionadas y cientos de miles de combinaciones de consulta/página, el límite de 1.000 filas de la interfaz significa que solo estás viendo la punta del iceberg de los datos disponibles. Incluso el límite de 50.000 filas de la API se puede alcanzar fácilmente en sitios grandes cuando combinas dimensiones como consulta + página + dispositivo + país.
La propia documentación de Google afirma: «Debido a limitaciones internas, Search Console almacena las filas de datos principales y no todas las filas de datos.» Los datos devueltos se ordenan por clics en orden descendente, sin criterio de ordenación secundario, lo que significa que las consultas con poco tráfico y los términos long tail son los primeros en descartarse.
Algunos SEOs argumentarán «¿de verdad necesitamos acceso a todos los datos?»; la realidad es que sí, porque en última instancia, si tenemos todos los datos podemos tomar mejores decisiones en cuanto a estrategia, ejecución, etc.
Qué significa esto en la práctica
Imagina que tienes un sitio web que posiciona para 25.000 consultas únicas en un mes dado. En la interfaz de GSC verás las 1.000 principales. A través de la API podrías recuperar hasta 50.000 filas, pero si estás extrayendo combinaciones de consulta + página en varios dispositivos y países, puede que sigas perdiéndote una parte significativa de tus datos long tail. Sin embargo, estos datos que faltan no se pierden a nivel de gráfico: siguen contabilizándose en los totales de rendimiento. Y ahí empieza la confusión.
Así que, usando la interfaz de Google Search Console, solo podrás acceder a las primeras 1000 consultas en relación con los filtros aplicados:
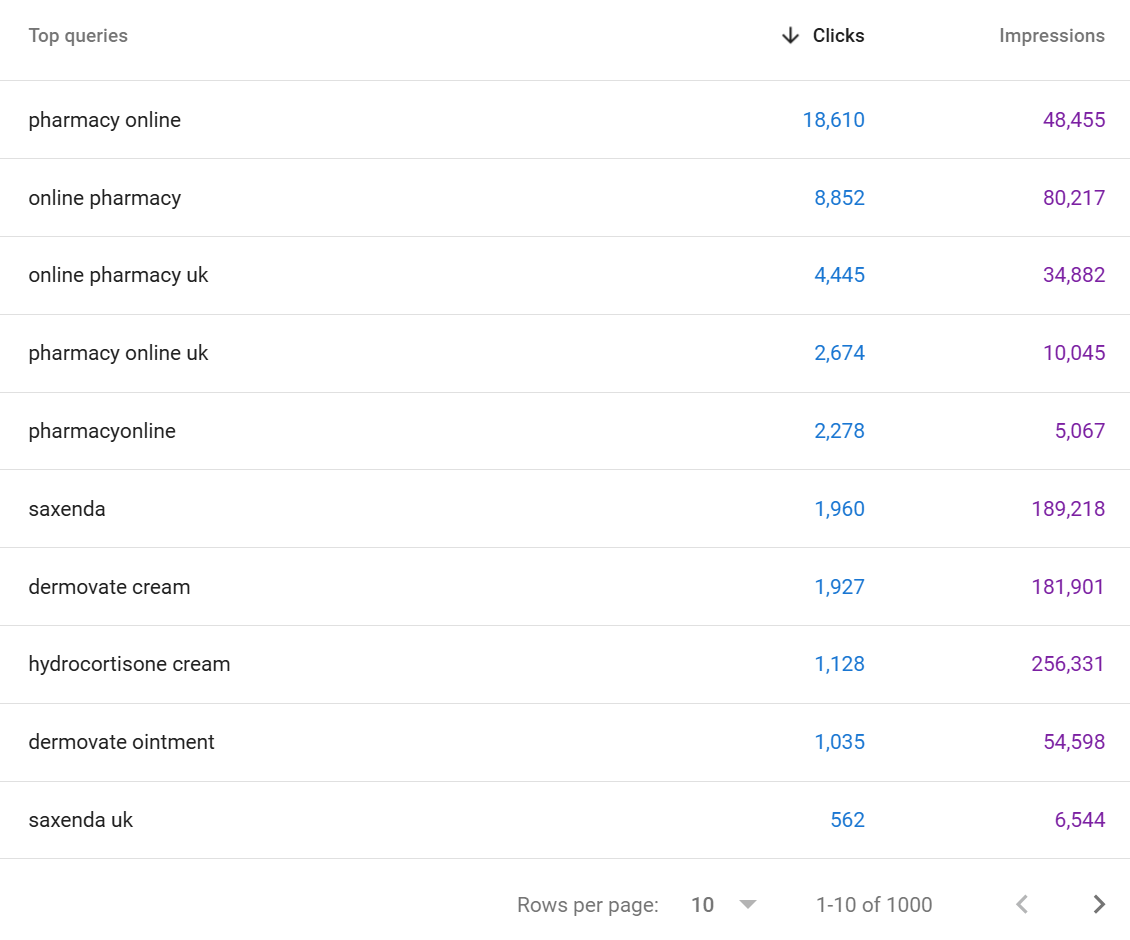
Hay un volumen SIGNIFICATIVO de consultas que no verás; incluso cuando filtras hacia abajo, los datos siempre están limitados a un máximo de 1000 filas (a menos que estés comparando, pero normalmente eso se mantiene por debajo de 1500 consultas).
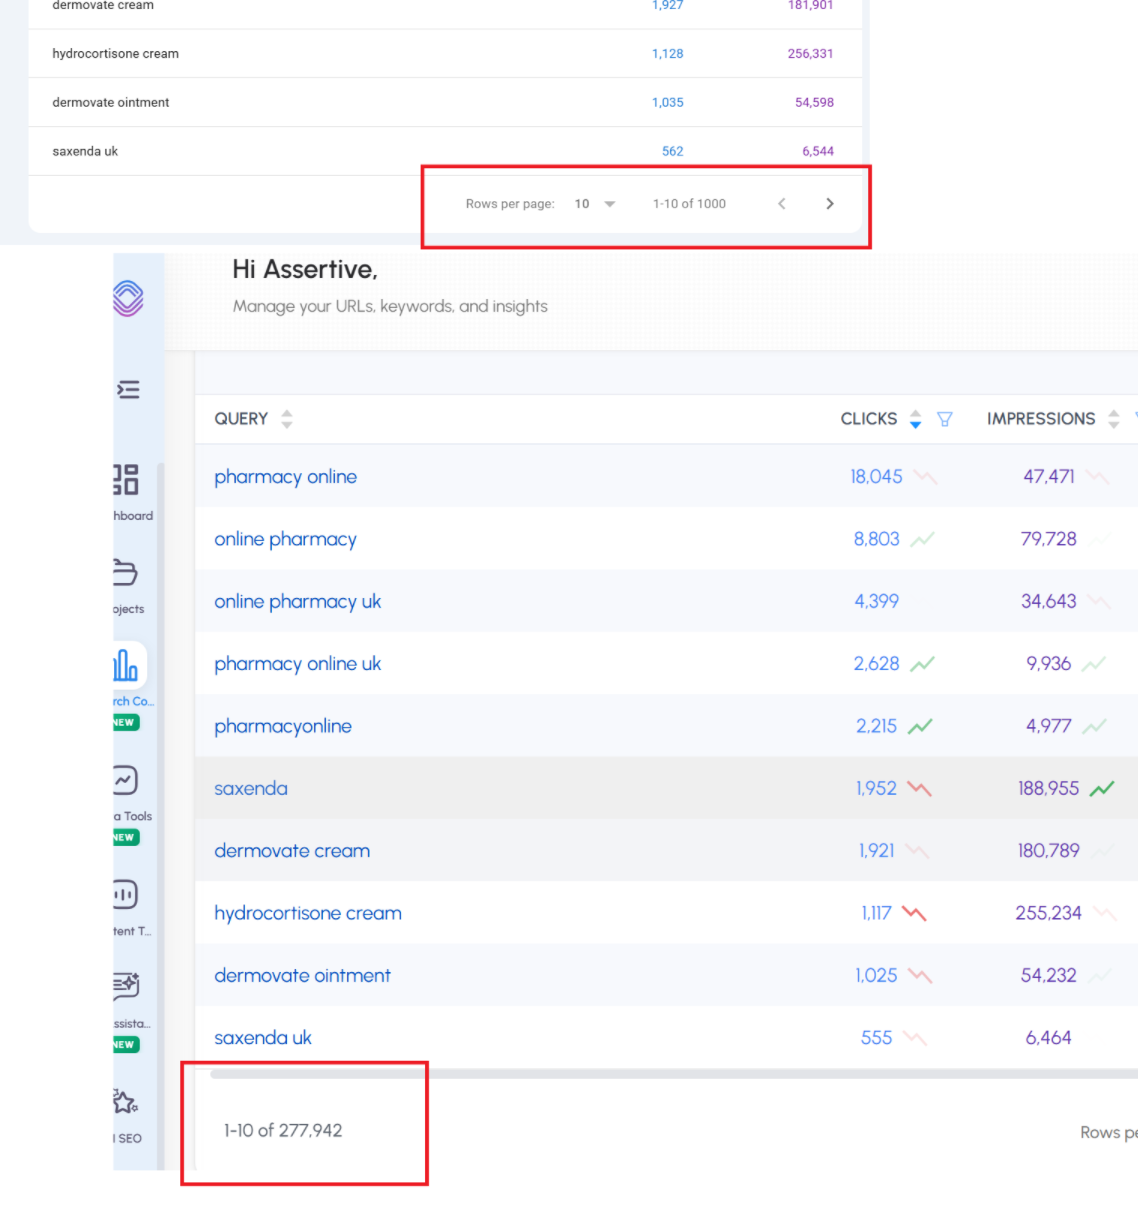
Por eso en SEO Stack eliminamos las limitaciones en lo que respecta a Google Search Console:
Así, para nuestro cliente pharmacyonline.co.uk, vemos 1000 consultas en GSC. Si miramos la misma propiedad de URL en SEO Stack vemos >
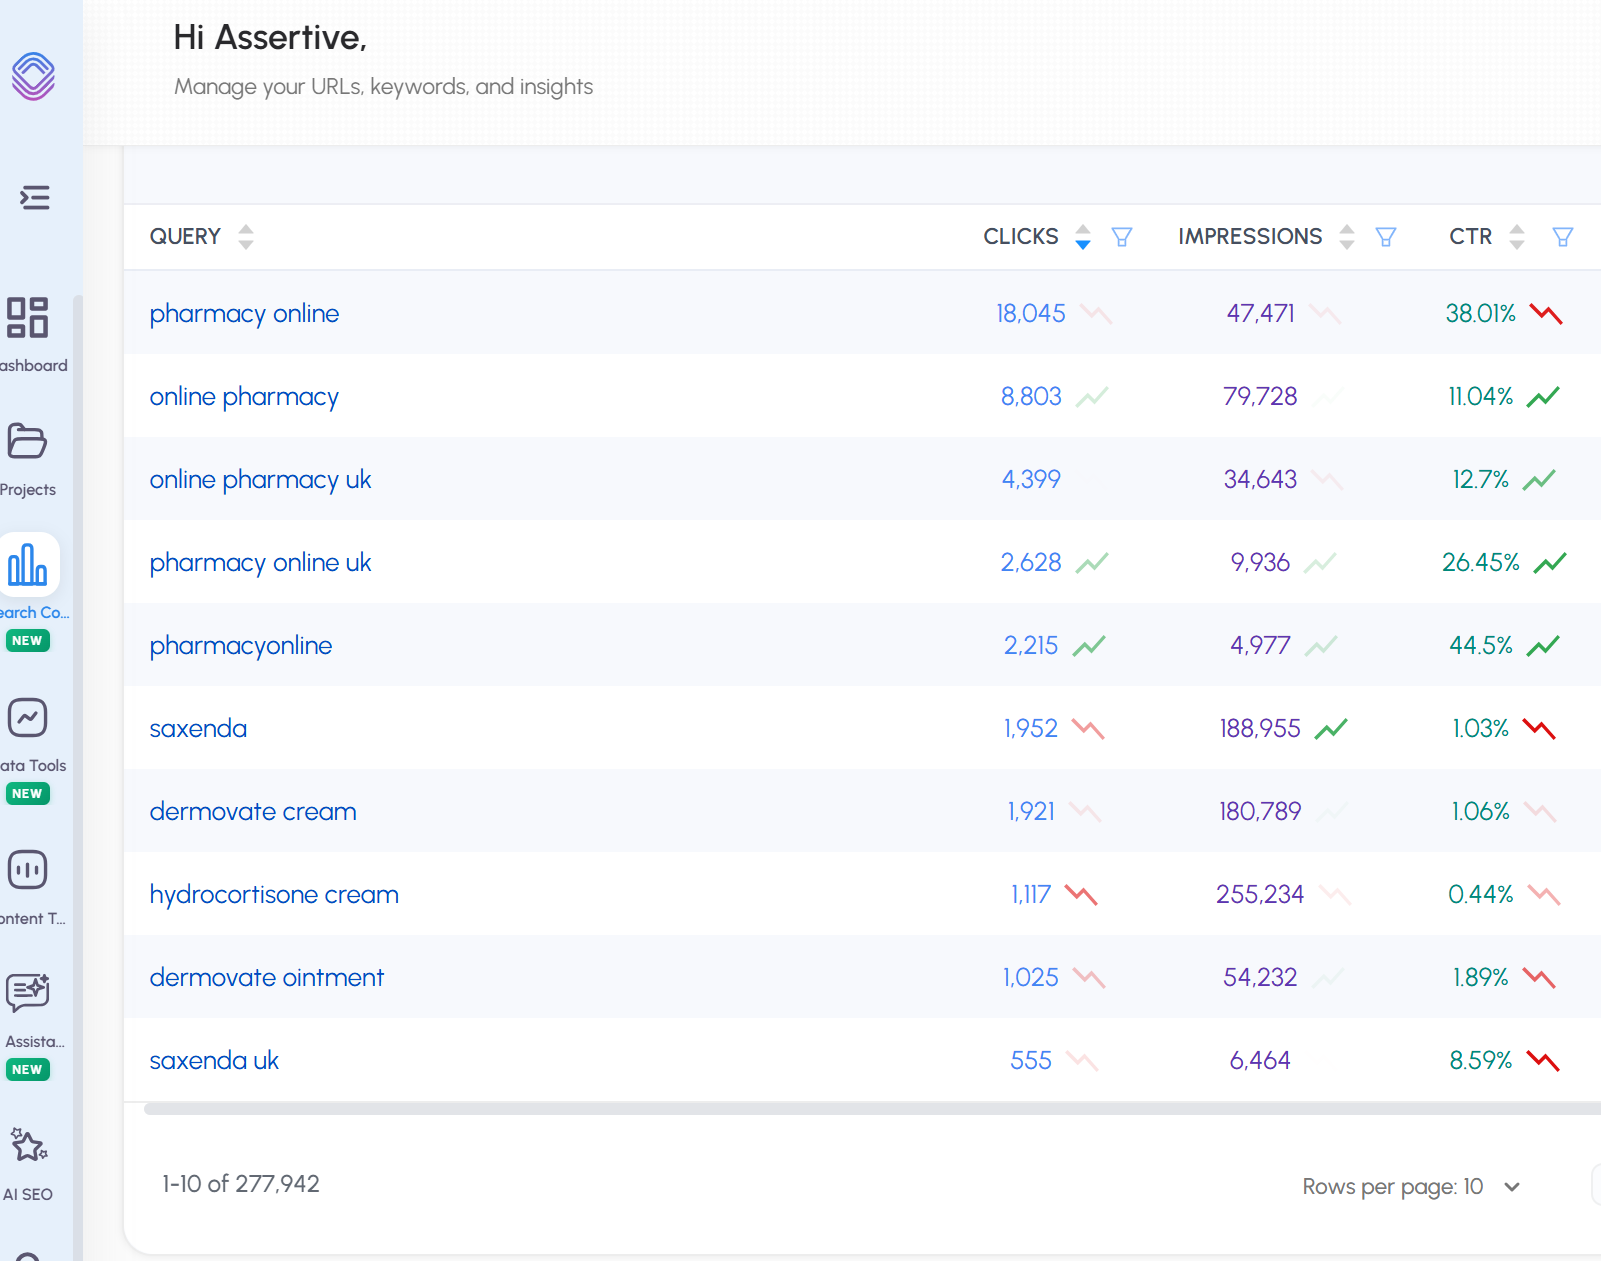
Vemos 277.942 consultas.
En resumen: SEO Stack desbloquea los datos de Google Search Console porque almacenamos los datos en un warehouse y los hacemos accesibles.
2. El gráfico y la tabla son conjuntos de datos diferentes
Este es uno de los aspectos peor entendidos de Google Search Console, y pilla incluso a SEOs experimentados. El gráfico de rendimiento de la parte superior del informe y la tabla de datos que aparece debajo no muestran los mismos datos.
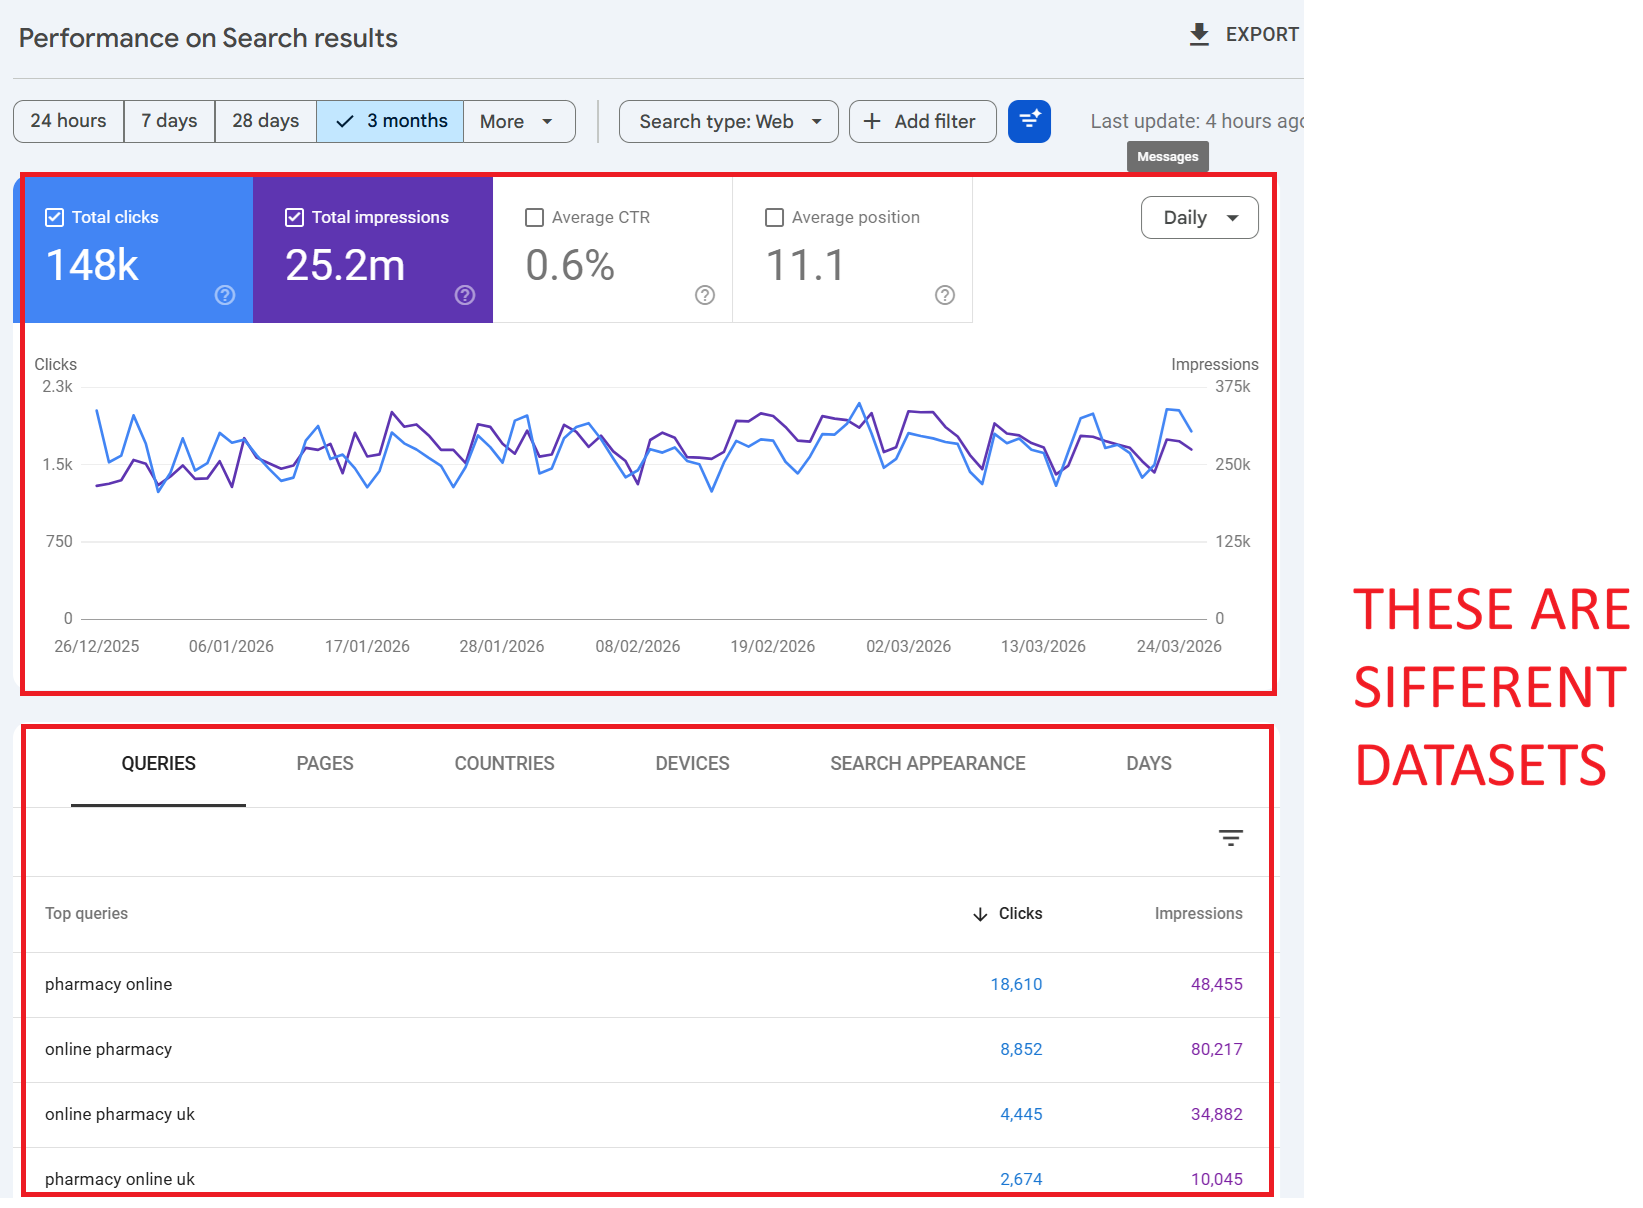
Cómo funciona el gráfico
El gráfico muestra los totales agregados de toda tu propiedad. Cuando no hay filtros aplicados, el gráfico incluye todos los clics, impresiones, CTR y datos de posición, incluidos los clics de consultas anonimizadas. Representa la imagen completa de lo que Google registró para tu sitio.
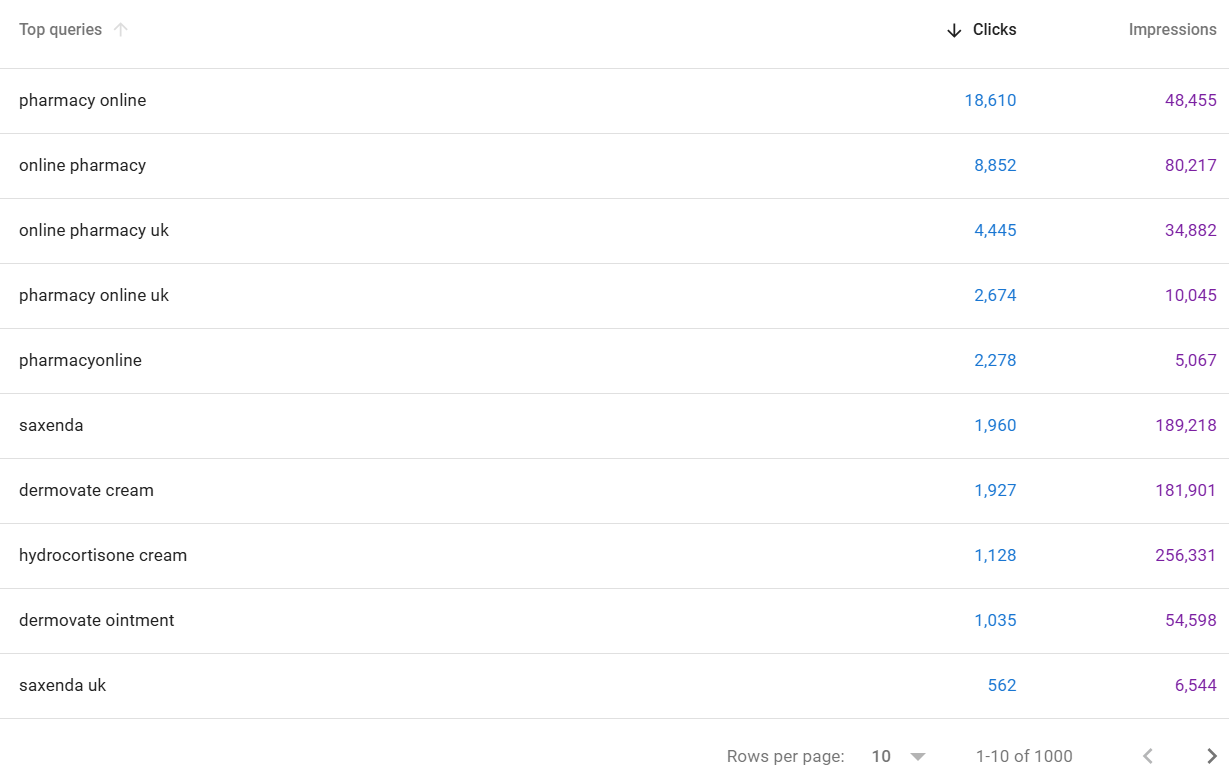
Cómo funciona la tabla
La tabla que aparece debajo del gráfico, sin embargo, solo muestra datos de consultas identificadas, no anonimizadas. Si Google no puede atribuir clics a una consulta concreta con nombre (porque la consulta se anonimizó por privacidad), esos clics simplemente no aparecen en la tabla. No hay una fila de «consultas anonimizadas»: los datos sencillamente no están.
El resultado
Si sumas todas las filas de la tabla de consultas, tu total casi siempre será inferior al total del gráfico. La diferencia son los datos de consultas anonimizadas: clics que ocurrieron, que Google registró, pero que no tienen una cadena de búsqueda asociada que tú puedas ver.
💡 Ejemplo: tu gráfico muestra 10.000 clics en el mes. Exportas todas las filas de consultas y sumas los clics: obtienes 5.400. Los 4.600 clics restantes proceden de consultas anonimizadas. Google los registró, pero no te dirá qué buscó la gente.
3. ¿Por qué faltan datos de consultas y clics?
Hay varias razones diferenciadas por las que tus datos de GSC están incompletos. Entender cada una es fundamental para interpretar correctamente tus informes.
Razón 1: consultas anonimizadas (filtrado por privacidad)
Este es el factor más importante. Google define las consultas anonimizadas como aquellas «que no son realizadas por más de unas pocas docenas de usuarios durante un periodo de dos a tres meses». Estas consultas se eliminan por completo de las tablas de datos para proteger la privacidad de los usuarios.
La escala de esto es significativa. El estudio de Ahrefs de 2025 sobre 22.000 millones de clics halló que las consultas anonimizadas representaban de media el 46,77% de todos los clics. En algunos sitios web, la cifra superaba el 80%. La distribución varía enormemente: los sitios con muchos términos de búsqueda long tail, de nicho o propios sufren mucha más anonimización que los sitios dominados por un puñado de términos head de alto volumen.
Punto clave: no se trata del volumen de consultas hacia tu sitio, sino de cuántos usuarios únicos en toda la web buscaron ese término. Una consulta podría generar 50 clics a tu sitio, pero si solo 20 personas en todo el mundo la buscaron en 3 meses, Google la anonimizará.
Razón 2: límites de filas y truncamiento de datos
Como se ha comentado arriba, GSC almacena y sirve únicamente las filas de datos «principales». Google prioriza las filas con mayor número de clics. Si tu sitio tiene miles de combinaciones de consulta/página, las que están al final —normalmente consultas long tail con 1–2 clics— simplemente se descartan. Esto es independiente de la anonimización; estas consultas pueden tener suficientes buscadores únicos como para ser identificadas, pero se recortan del conjunto de datos debido a los límites de almacenamiento y procesamiento.
Razón 3: Retraso en el procesamiento de datos
Los datos de GSC suelen tener un retraso de 2–3 días. Los datos de los días más recientes pueden estar incompletos o no aparecer en absoluto. Es un retraso de procesamiento normal y los datos acabarán apareciendo, pero puede generar confusión si consultas los informes en tiempo real.
Razón 4: Diferencias de tipo de propiedad y de agregación
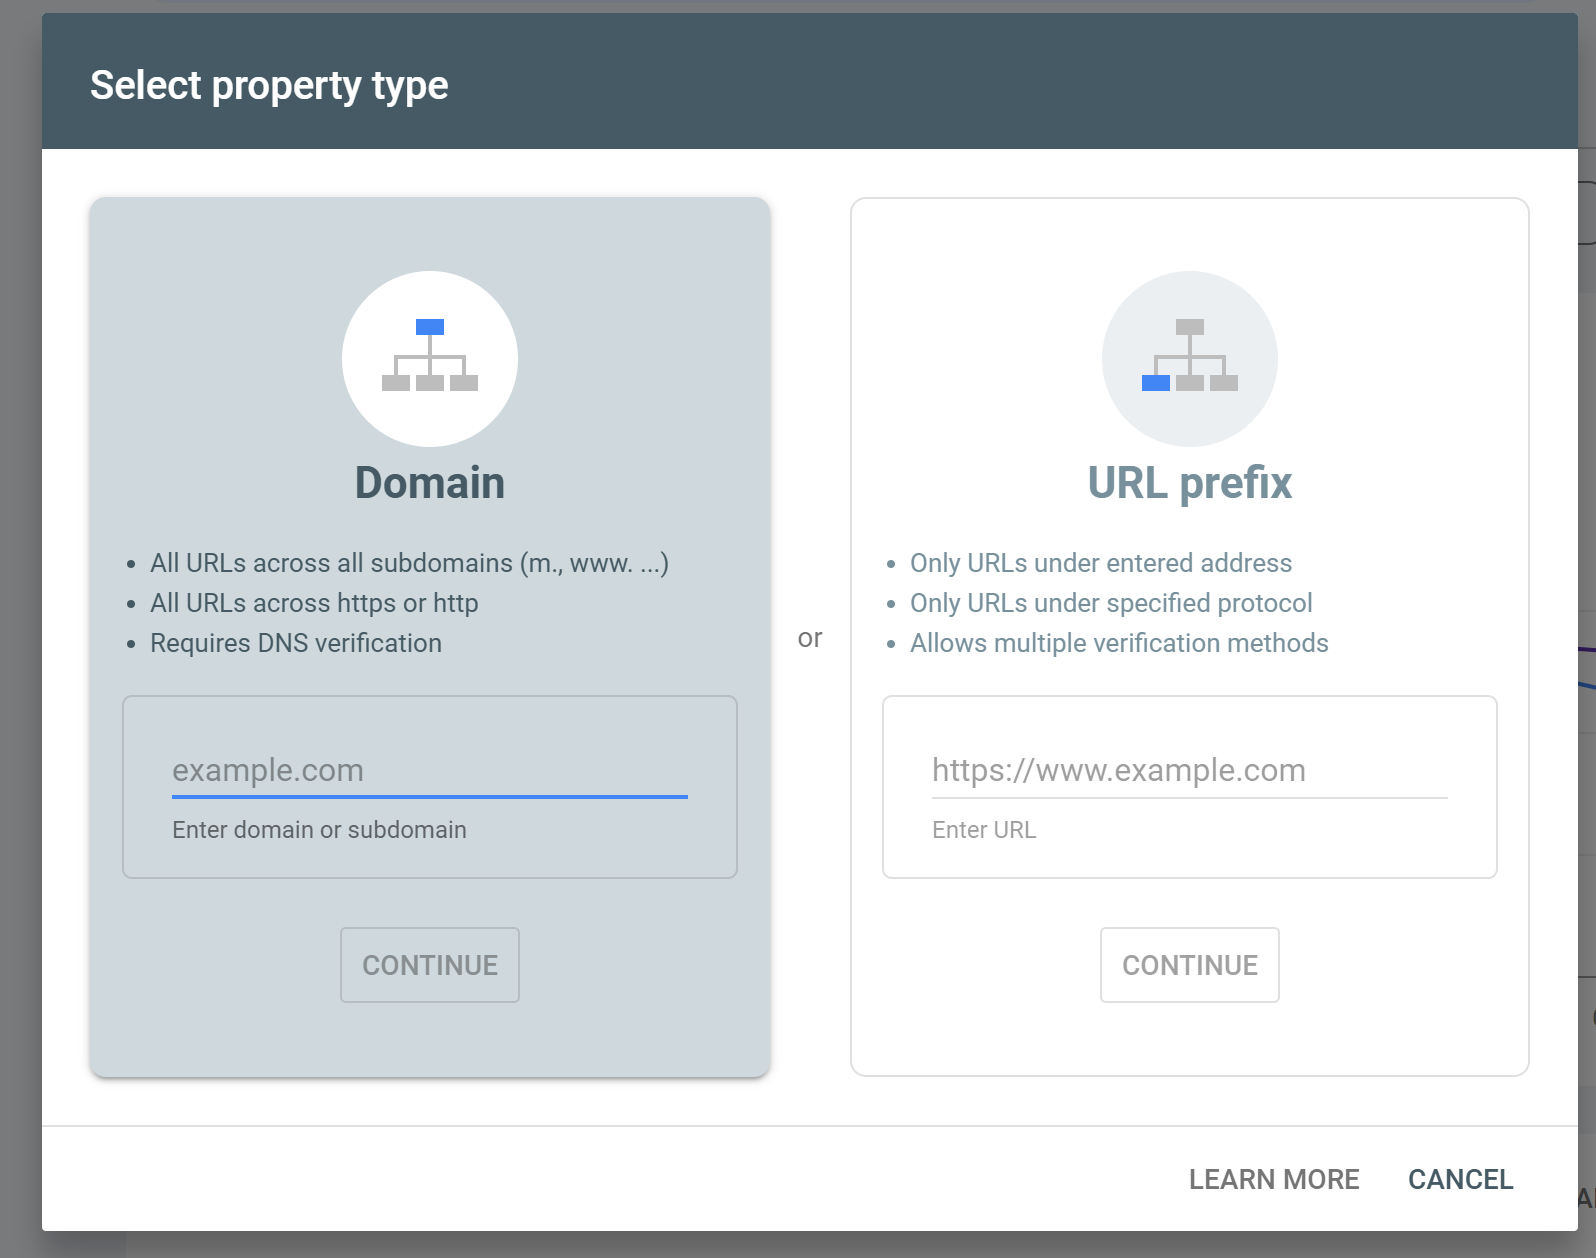
La forma en que se agregan los datos depende de si usas una propiedad de dominio o una propiedad de prefijo de URL, y de si los datos se agregan a nivel de propiedad o a nivel de página. Cambiar entre estos contextos puede hacer que los totales varíen de forma inesperada, sobre todo cuando el método de agregación pasa de nivel de propiedad a nivel de página, lo que de hecho puede aumentar las cifras reportadas porque se muestran puntos de datos más granulares.
Razón 5: Consultas sensibles o personales
Más allá del umbral de volumen, Google también elimina las consultas que contienen información personal o sensible. Las consultas sobre salud, los datos financieros y otros comportamientos de búsqueda que permitan identificar a una persona pueden eliminarse independientemente del volumen de búsqueda. La documentación de Google indica explícitamente que puede no registrar consultas que contengan «información personal o sensible».
4. ¿Google Search Console aplica muestreo a los datos?
Es una pregunta habitual, y la respuesta tiene matices. GSC no «muestrea» los datos del modo en que Google Analytics (UA) era conocido por muestrear datos de sesiones en informes de mucho tráfico. Google no selecciona aleatoriamente un subconjunto de clics y lo extrapola.
Sin embargo, GSC sí trunca y filtra los datos de formas que producen un efecto similar. La combinación de filtrado por privacidad (consultas anonimizadas), límites de filas (solo las filas de datos principales) y aproximaciones con filtros de Bloom significa que lo que ves no es una muestra aleatoria, pero sí una representación incompleta del conjunto de datos completo.
El propio lenguaje de Google en su documentación detallada es revelador: «Creemos que los datos restantes serán lo bastante amplios como para crear una muestra representativa de los datos.» Fíjate en la palabra «muestra»: incluso Google reconoce que lo que estás viendo es un subconjunto representativo, no la imagen completa.
El impacto práctico es que, para la mayoría de sitios pequeños y medianos, los datos son razonablemente completos. Para sitios más grandes con perfiles de consulta diversos, las lagunas de datos pueden ser considerables. Cuantas más dimensiones añadas (consulta + página + país + dispositivo), más datos se recortan.
5. Filtros de Bloom: la razón oculta por la que tus cifras no cuadran
En septiembre de 2023, Gary Illyes de Google abordó directamente un misterio de larga data: ¿por qué los datos filtrados en GSC a veces muestran MÁS clics que los datos sin filtrar? La respuesta: los filtros de Bloom.
¿Qué es un filtro de Bloom?
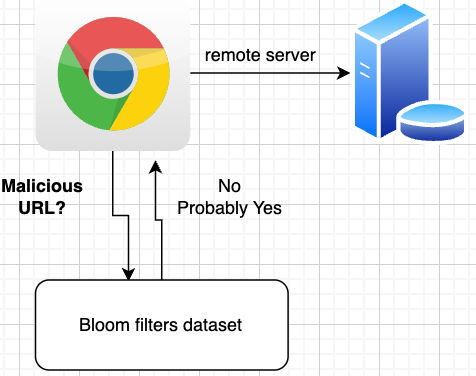
Un filtro de Bloom es una estructura de datos probabilística inventada en 1970 por Burton Howard Bloom. Está diseñada para comprobar si un elemento pertenece a un conjunto de forma extremadamente rápida y con un almacenamiento mínimo. La contrapartida es que puede producir falsos positivos (decir que algo está en el conjunto cuando no lo está), pero nunca falsos negativos (no dirá que algo no está cuando sí está).
Cómo usa Google los filtros de Bloom en GSC
Gary Illyes explicó que Google procesa miles de millones, potencialmente billones, de elementos de datos para los informes de Search Console. Buscar elementos concretos en conjuntos de datos tan grandes es costoso computacionalmente. Los filtros de Bloom resuelven esto creando una versión más pequeña y hasheada de los datos que puede consultarse primero.
En palabras de Illyes: «Los filtros de Bloom aceleran las búsquedas prediciendo si algo existe en un conjunto de datos, pero a costa de la precisión, y cuanto más pequeño es el conjunto de datos, más precisas son las predicciones.»
El proceso de hashing puede provocar pérdida de datos, ya sea de forma intencionada o como efecto secundario inevitable de la compresión. Por eso:
• Aplicar un filtro de página puede aumentar tu total de clics, porque el conjunto de datos más específico (más pequeño) pasa por el filtro de Bloom con mayor precisión, recuperando datos que se habían perdido en la vista más amplia y sin filtrar.
• Quitar un filtro puede reducir tus totales, porque volver a la agregación más grande, a nivel de propiedad, reintroduce los errores de aproximación del filtro de Bloom.
• Los totales de los filtros de inclusión + exclusión no equivalen al total sin filtrar, porque cada subconjunto filtrado pasa por el filtro de Bloom de forma independiente, y los errores de aproximación son distintos en cada pasada.
💡 Piénsalo así: Google usa un motor de aproximación muy eficiente en lugar de un recuento exacto. Es rápido, pero los errores de redondeo se acumulan de forma diferente según cómo segmentes los datos. Cuanto más pequeño es el segmento, más preciso tiende a ser.
6. Ejemplos prácticos: pruébalo en tu propia cuenta de GSC
La mejor forma de entender estas lagunas de datos es verlas por ti mismo. Aquí tienes varios ejercicios que puedes ejecutar ahora mismo en Google Search Console.
Ejercicio 1: El desajuste de las consultas de marca
Qué hacer: Abre GSC > Rendimiento > establece un rango de fechas de 3 meses. Anota el total de clics del gráfico (supongamos que muestra 15.000 clics).
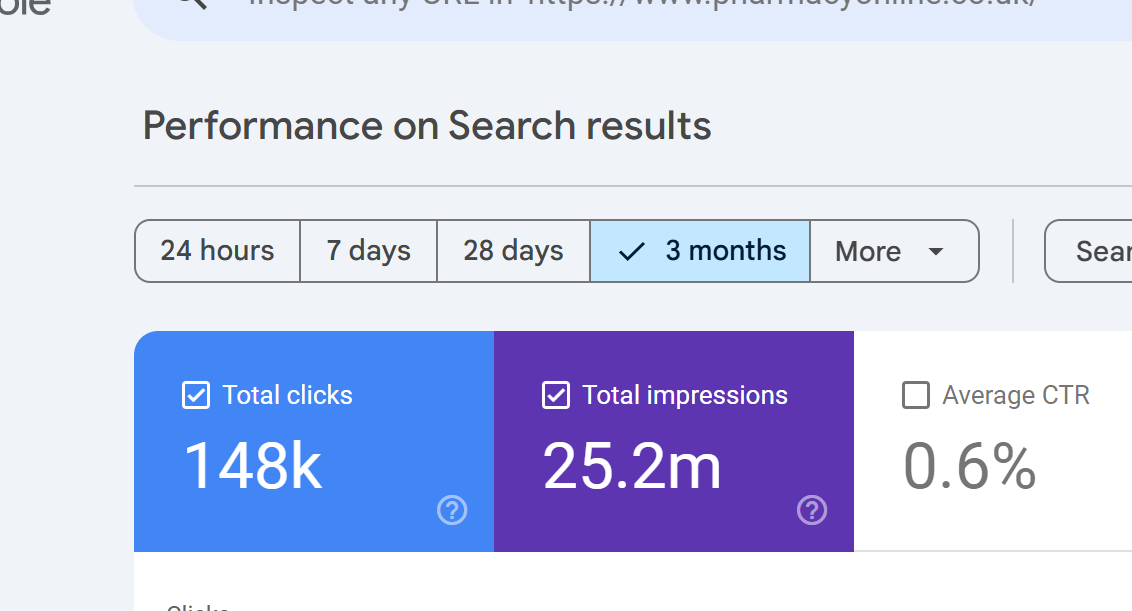
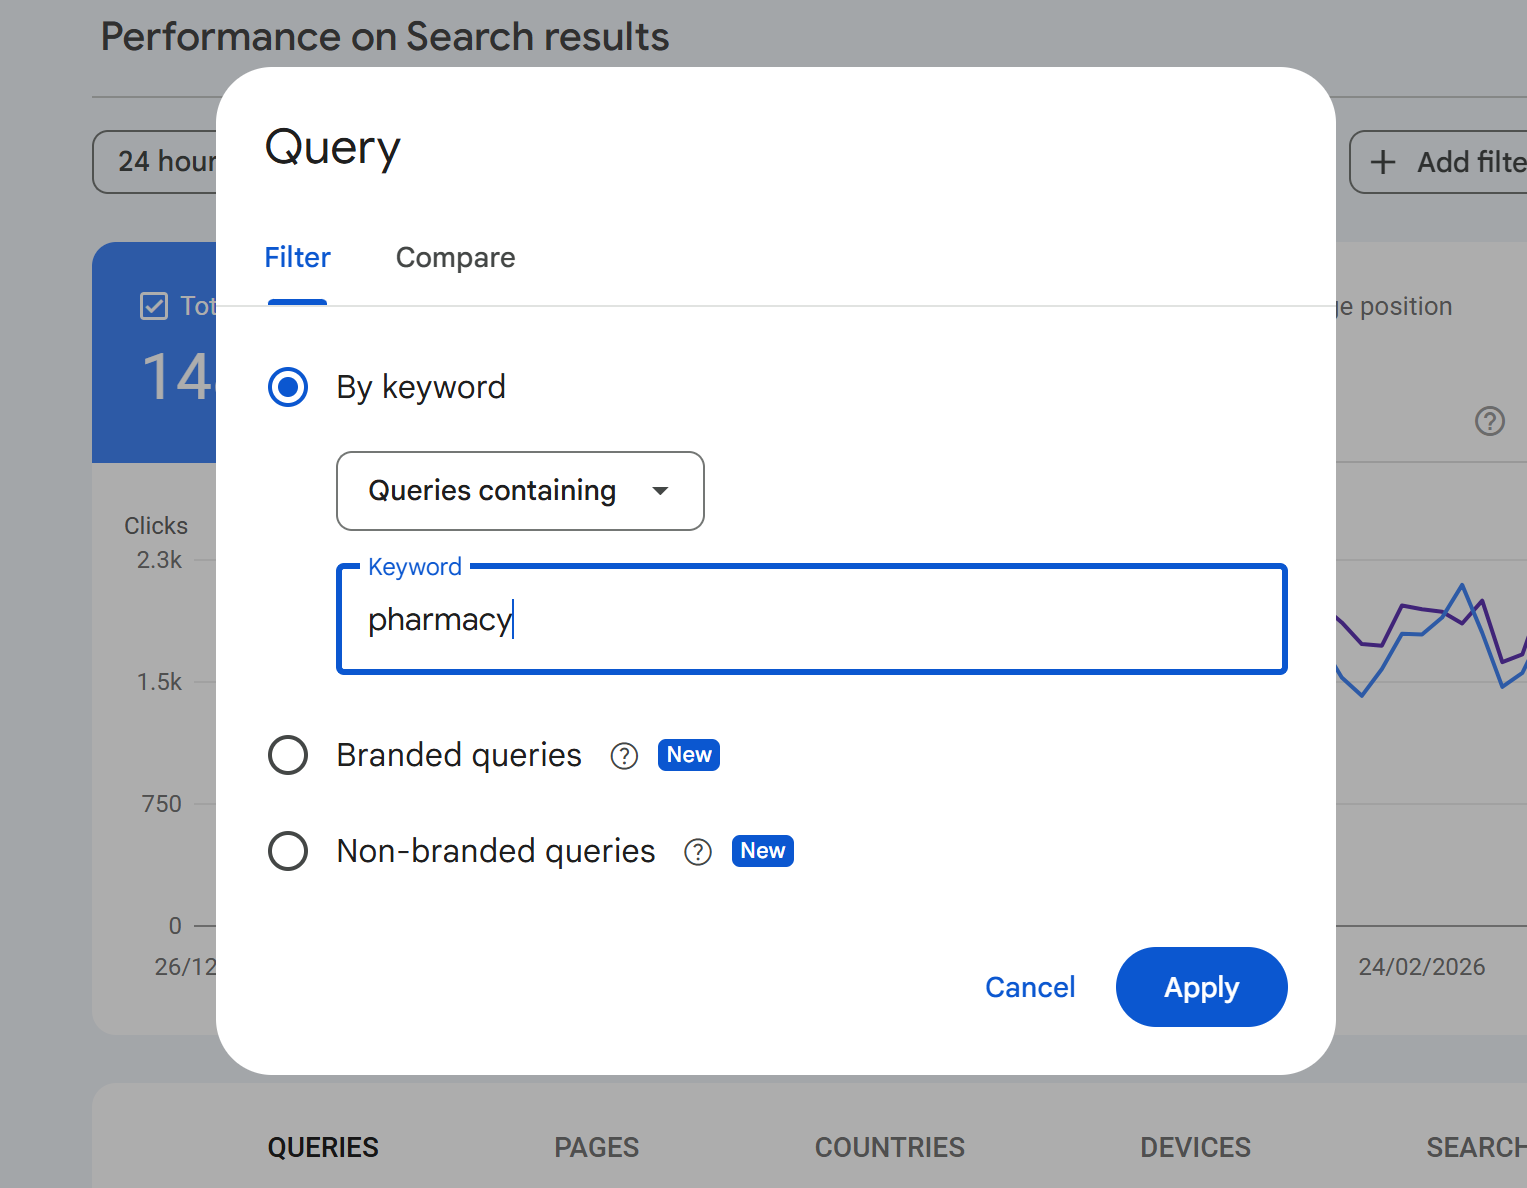
Ahora añade un filtro de consulta: Consultas que contienen «tumarca». El gráfico podría mostrar 4.200 clics.
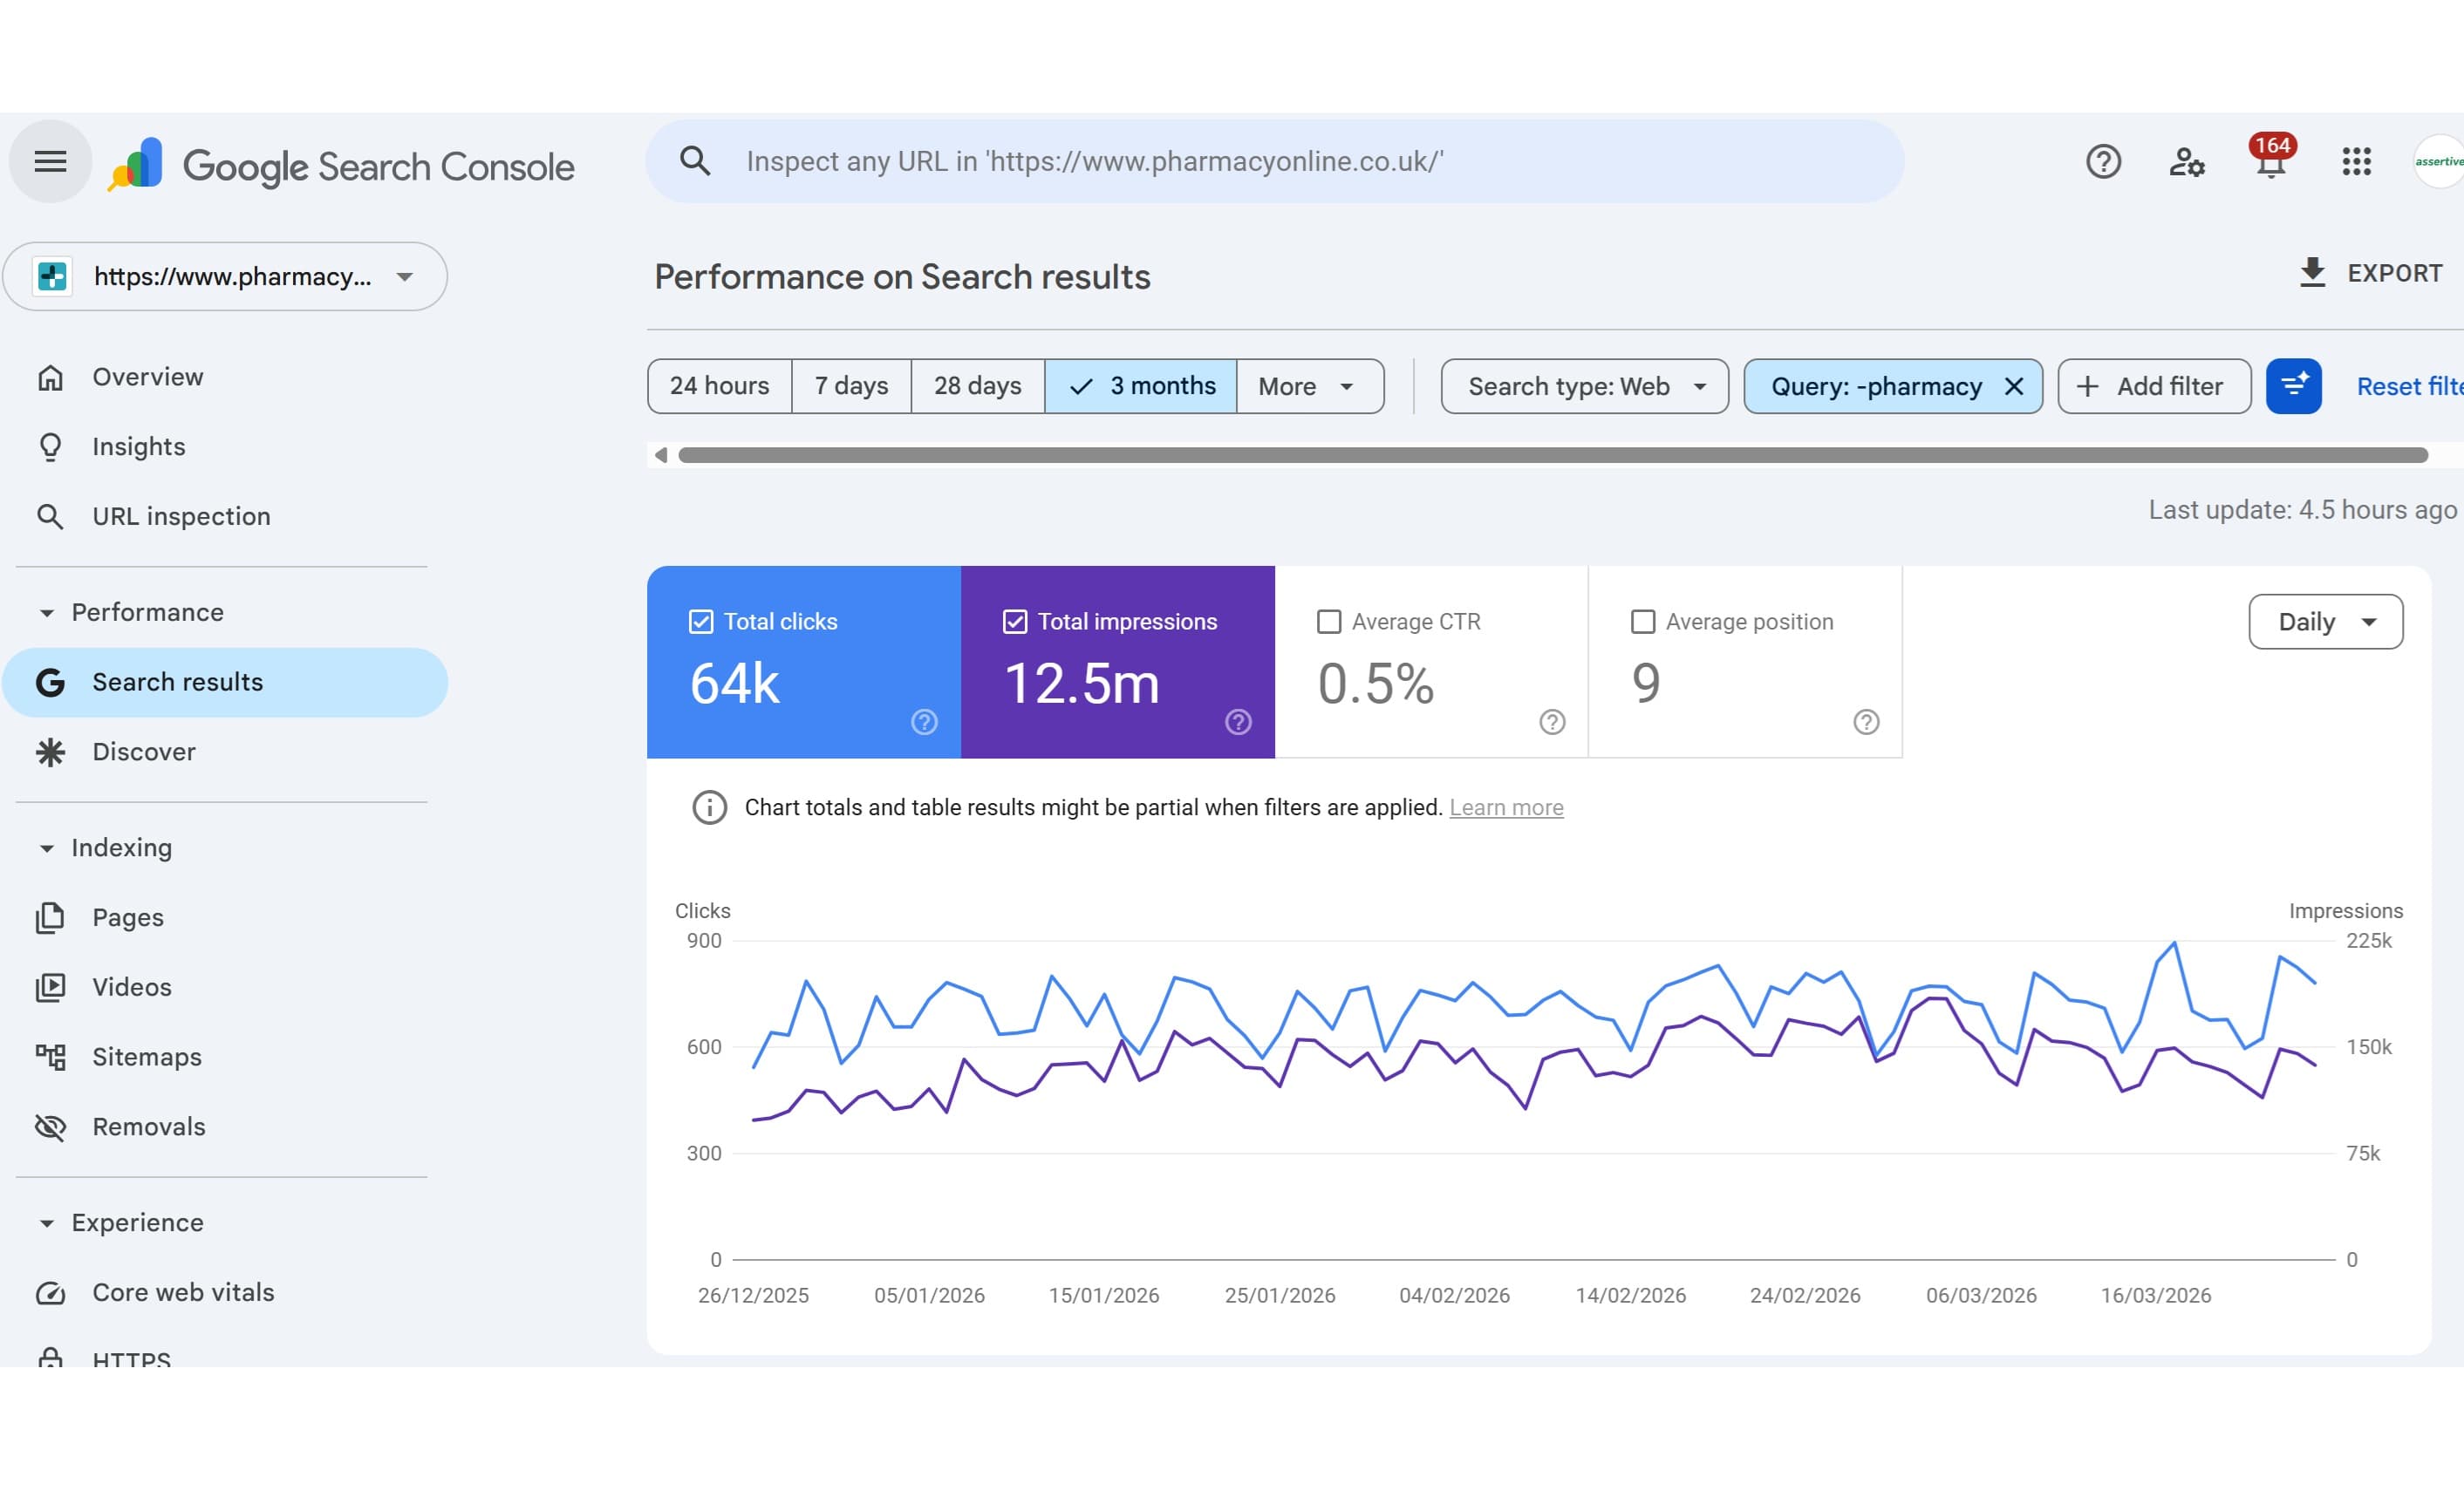
En este ejemplo aplicamos la consulta que contiene "pharmacy"
Cambia el filtro a: Consultas que NO contienen «tumarca». El gráfico podría mostrar 6.300 clics.
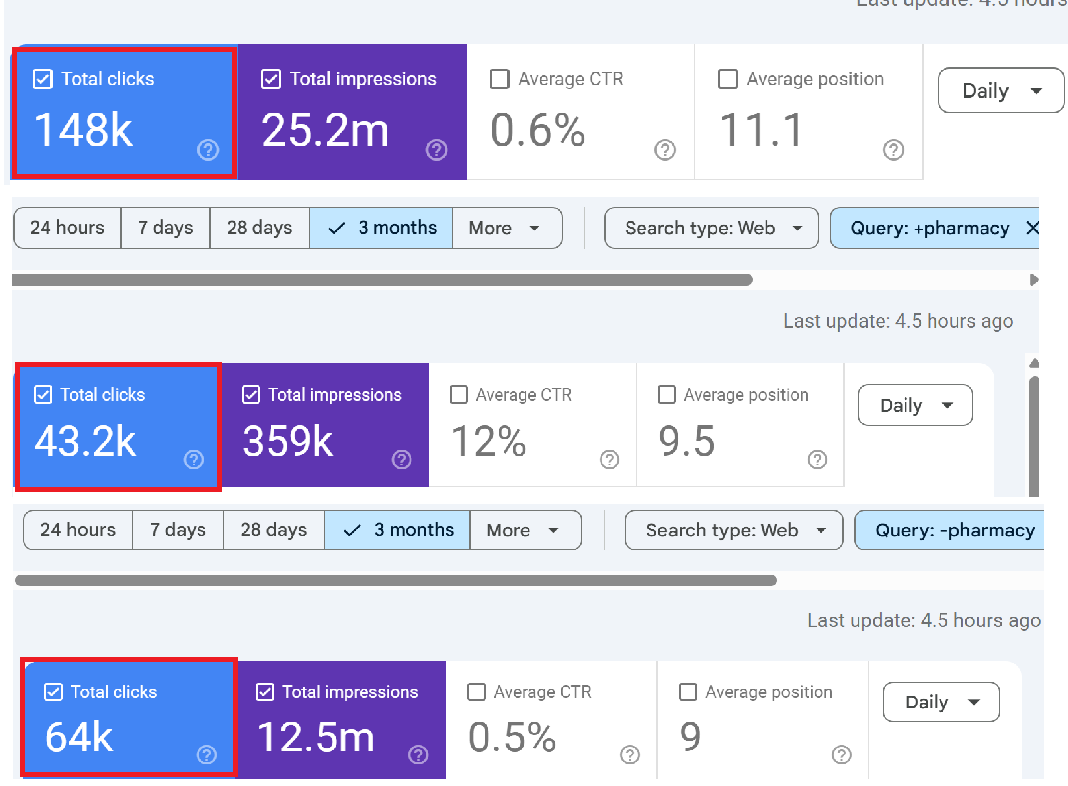
4.200 + 6.300 = 10.500. Pero el total sin filtrar era 15.000. ¿Dónde están los 4.500 clics que faltan?
Qué está pasando: Cuando aplicas cualquier filtro de consulta (de inclusión o exclusión), GSC elimina todas las consultas anonimizadas de los totales. Esos 4.500 clics procedían de consultas que Google anonimizó. Sin ningún filtro, se incluyen en el total del gráfico. Con un filtro aplicado, desaparecen por completo porque Google no puede evaluar si una consulta anonimizada contiene o no el nombre de tu marca.
Ejercicio 2: Total del gráfico vs. suma de la tabla
Qué hacer: En el informe de Rendimiento sin filtros aplicados, anota el total de clics del gráfico. Luego entra en la pestaña «Consultas» de abajo y exporta todas las filas a una hoja de cálculo. Suma la columna de clics.
Qué encontrarás: La suma de clics de la tabla será menor que el total del gráfico. La diferencia son tus datos de consultas anonimizadas. En muchos sitios, esa diferencia será del 30–60 % del total.
Ejercicio 3: Un filtro de página aumenta los clics
Qué hacer: Anota tu total de clics sin filtrar. Luego añade un filtro de página para tu URL más popular (por ejemplo, Páginas que contienen «/tu-pagina-principal/»). Mira el total.
Qué puede pasar: En algunos casos, el total filtrado de esa página será mayor que lo que mostraba el informe sin filtrar para esa misma página en la tabla. Es el filtro de Bloom en acción: el conjunto de datos más pequeño y específico se procesa con mayor precisión, haciendo aflorar datos que se habían perdido en la agregación más amplia.
Ejercicio 4: Lagunas al filtrar por país
Qué hacer: Mira tu total de clics. Luego filtra por país, por ejemplo, Reino Unido. Anota los clics. Después cambia a Estados Unidos y anota esos clics. Suma todos los países que filtres individualmente.
Qué encontrarás: La suma de los clics por país no será igual al total, porque muchos clics no se atribuyen a un país concreto y cada pasada de filtro introduce su propio error de aproximación del filtro de Bloom.
Ejercicio 5: Apilar filtros amplifica la diferencia
Qué hacer: Empieza con un filtro de página para una URL concreta. Anota los clics. Ahora añade encima un filtro de consulta. Ahora añade un filtro de país. Con cada filtro adicional, desaparecen más datos.
Por qué: Cada filtro agrava el efecto. Las consultas anonimizadas se descartan con cualquier filtro de consulta. Los límites de filas recortan de forma más agresiva cuando intervienen varias dimensiones. Y los errores de aproximación del filtro de Bloom se acumulan con cada pasada de filtrado adicional. Cuanto más específico te vuelves, menos completos son tus datos: una paradoja frustrante para cualquiera que intente hacer un análisis granular.
7. Preguntas frecuentes sobre los datos que faltan en GSC
P: ¿Por qué no coinciden los totales de clics de los informes de Consultas y Páginas?
El informe de Consultas y el informe de Páginas utilizan métodos de agregación distintos. El informe de Consultas cuenta los clics por consulta, mientras que el informe de Páginas cuenta los clics por página. Un mismo clic puede aparecer tanto en una fila de consulta como en una fila de página, pero las consultas anonimizadas se excluyen del informe de Consultas mientras que el clic correspondiente a la página sí se contabiliza en el informe de Páginas. Además, una misma página puede posicionar para varias consultas y una misma consulta puede llevar a varias páginas, por lo que la deduplicación funciona de forma diferente en cada vista.
P: ¿Es solo un problema de la interfaz gratuita de GSC?
No. La API tiene límites de filas más altos (50.000 frente a 1.000), pero está sujeta al mismo filtrado por privacidad y al mismo comportamiento del filtro de Bloom. Incluso la exportación masiva a BigQuery, que es la fuente de datos más completa, sigue conteniendo consultas anonimizadas marcadas como valores NULL: puedes ver que existe ese tráfico, pero sigues sin saber qué buscó la gente. Eso sí, BigQuery muestra una tasa de anonimización menor porque captura más consultas de volumen límite que la API descarta.
P: Mi sitio es pequeño, ¿me afecta esto?
Sí, y a menudo de forma desproporcionada. Los sitios más pequeños suelen recibir tráfico de muchas consultas long tail de bajo volumen. Como la anonimización se basa en cuántos usuarios únicos buscaron un término a nivel global, los sitios pequeños con audiencias de nicho suelen tener un porcentaje más alto de datos anonimizados. Un estudio de SEO Gets encontró que los sitios pequeños tenían una visibilidad de consultas de entre el 0 % y el 37 %, con una media de apenas el 18,3 %.
P: ¿Puedo recuperar los datos de consultas que faltan?
No directamente desde Google. Sin embargo, puedes cruzar los datos de GSC con herramientas de terceros como Ahrefs, Semrush o SEO Stack para identificar consultas que probablemente estén generando tráfico pero no aparecen en GSC. La exportación a BigQuery también conserva las filas de consultas anonimizadas (con valores NULL en la consulta), de modo que al menos puedes cuantificar cuánto tráfico queda sin atribuir. La retención de datos ampliada de SEO Stack y su analítica impulsada por IA pueden ayudarte a identificar patrones en tu tráfico long tail que GSC por sí solo no revela.
P: ¿Por qué Google cambió su documentación de «muy raro» a «algunas»?
Tras el estudio de Ahrefs de 2022, que mostró que casi la mitad de todos los clics van a términos ocultos, Google actualizó su documentación de ayuda para eliminar la afirmación de que las consultas anonimizadas eran «muy raras». El texto actualizado dice ahora que «algunas consultas» se anonimizan. Danny Sullivan, de Google, reconoció que los términos long tail, que individualmente son poco frecuentes, pueden sumar una proporción significativa del tráfico total.
P: ¿Por qué filtrar por una página concreta a veces muestra más clics que los datos sin filtrar?
Es el efecto del filtro de Bloom. Cuando aplicas un filtro de página, GSC pasa de la agregación a nivel de propiedad a la agregación a nivel de página. El conjunto de datos más pequeño y específico atraviesa el filtro de Bloom con mayor precisión, lo que puede recuperar datos que se perdieron en la agregación más amplia. Suena contraintuitivo, pero es una consecuencia directa de cómo las estructuras de datos probabilísticas sacrifican precisión a cambio de velocidad.
P: ¿Han empeorado los datos desde el lanzamiento de AI Overviews?
Probablemente, aunque Google no lo ha confirmado explícitamente. AI Overviews y las interfaces de búsqueda conversacional fomentan consultas más largas y en lenguaje más natural. Las consultas más largas tienden a ser más únicas, lo que significa que menos usuarios distintos buscan exactamente la misma cadena. Esto empuja a más consultas por debajo del umbral de anonimización de Google. El estudio de Ahrefs de 2025 se realizó antes del despliegue completo de AI Overviews, lo que sugiere que la tasa de anonimización real actual podría ser incluso superior al 46,77 %.
P: ¿Coinciden los datos de GSC con los de Google Analytics?
No, y no deberían. GA registra sesiones en tu web (requiere la ejecución de JavaScript y la carga de la página). GSC registra clics desde los resultados de búsqueda (contabilizados en el lado de Google). El tráfico de bots, los fallos de JavaScript, los tiempos de espera de carga, las redirecciones y los ajustes de privacidad generan discrepancias entre ambos. Miden cosas relacionadas, pero fundamentalmente distintas.
8. Qué puedes hacer al respecto
1. Usa la API, no solo la interfaz. La API te da 50 veces más filas que la interfaz web. Herramientas como SEO Stack extraen los datos de la API automáticamente y los almacenan con retención ampliada, de modo que siempre trabajas con el conjunto de datos más completo disponible.
2. Activa la exportación masiva a BigQuery. Si tienes acceso de propietario, esta es la fuente de datos más completa. Las consultas anonimizadas aparecen como valores NULL: no puedes ver el texto de la consulta, pero sí cuantificar y segmentar el tráfico no atribuido.
3. No te fíes de la aritmética de los filtros. Asume que los totales filtrados no cuadrarán con los totales sin filtrar. Usa los datos sin filtrar para los informes generales y los datos filtrados para análisis direccionales, no para contabilidad exacta.
4. Cruza los datos con fuentes de terceros. Herramientas como Ahrefs, Semrush y SEO Stack pueden sacar a la luz datos de consultas que GSC anonimiza. El informe de Consultas Anónimas de Ahrefs cruza específicamente los datos de GSC con sus propios datos de posicionamiento para identificar los términos ocultos más probables.
5. Analiza a nivel de página para mayor exhaustividad. Los estudios muestran sistemáticamente que los datos a nivel de página en GSC son mucho más completos que los datos a nivel de consulta. Los sitios pequeños muestran entre el 97 % y el 102 % del total de clics a nivel de página, frente a tan solo el 18 % a nivel de consulta. Si necesitas recuentos de clics precisos, usa dimensiones de página en lugar de dimensiones de consulta.
6. Céntrate en las tendencias, no en los valores absolutos. Los datos de GSC son direccionalmente correctos aunque no sean perfectamente completos. Un aumento del 20 % en clics mes a mes es significativo con independencia de que puedas ver o no cada consulta individual. Usa los datos para el análisis de tendencias y las decisiones estratégicas, no para contar céntimos.
7. Usa SEO Stack para ampliar la retención y profundizar en el análisis. Google solo conserva 16 meses de datos de rendimiento. SEO Stack almacena tus datos de GSC desde el momento en que conectas la cuenta, lo que te permite hacer análisis de tendencias a largo plazo que GSC por sí solo no ofrece. Combinado con analítica impulsada por IA, puedes identificar patrones en tus datos que un análisis manual en GSC pasaría por alto.
Conclusión
Google Search Console es una herramienta imprescindible, pero no es la verdad completa. Entre las consultas anonimizadas que ocultan casi la mitad de tus datos de clics, los límites de filas que recortan la visibilidad de tu long tail y los filtros de Bloom que generan una aritmética que no cuadra, hay una diferencia significativa entre lo que ocurre realmente en la búsqueda y lo que GSC te muestra.
Entender estas limitaciones no hace que GSC sea menos útil: hace que tu análisis sea más honesto. Los SEO que superan a su competencia son los que saben qué les están diciendo realmente sus datos, sortean las lagunas y usan herramientas como SEO Stack para ampliar su visibilidad más allá de lo que ofrece la interfaz gratuita de Google.
La próxima vez que tus cifras de GSC no cuadren, sabrás por qué. Y, lo que es más importante, sabrás qué hacer al respecto.
Fuentes y lecturas adicionales
• SEO Gets: el pequeño y sucio secreto de Google, las consultas anónimas (2024)
• Documentación de ayuda de Google Search Console: informe de rendimiento en la búsqueda

Fundador, SEO Stack
Daniel es el fundador de SEO Stack. Ha dedicado más de 2 décadas al SEO técnico y a los datos de búsqueda, y creó SEO Stack tras toparse una vez más con los mismos límites de Search Console en el trabajo con clientes.
Daniel cuenta con una amplia experiencia en SEO: ha montado agencias de SEO, negocios de auditoría y una consultoría próspera. En su tiempo libre, le gusta realizar experimentos de SEO y compartir los resultados.
Publicado 27 de marzo de 2026


