Google sta rendendo il rank tracking più difficile: quali soluzioni di rank tracking esistono?
Il rank tracking è ancora una delle prime cose che i clienti mi chiedono. È facile da capire, semplice da mettere a grafico e utile per vedere se i termini di ricerca importanti si stanno muovendo. Il problema st
Il rank tracking è ancora una delle prime cose su cui i clienti mi fanno domande. È facile da capire, semplice da mettere in grafico e utile per vedere se i termini di ricerca importanti si stanno muovendo. I problemi iniziano quando trattiamo un piccolo elenco di keyword preselezionate come se rappresentasse l'intera performance organica di un sito.
Questo è un problema di vecchia data dei report di ranking in generale: un numero ristretto di query complessive servite da un sito viene usato per valutare la performance e questo, beh, è di per sé una fallacia.
MA il rank tracking ha comunque un valore, perché è uno dei tanti indicatori nella SEO che possono aiutare un cliente a capire i progressi e la traiettoria, ed è uno dei motivi per cui abbiamo integrato il rank tracking in SEO Stack: perché SEO, freelance e agenzie continuano a presentare ai clienti report di ranking.
La maggior parte dei report di ranking e dei rank tracker monitora 50-100 keyword, alcuni arrivano fino a 500-1000 keyword, ma oltre quella soglia la cosa può diventare un grattacapo per i clienti: la maggior parte dei clienti si concentra su una manciata delle loro keyword più preziose e non vorrà necessariamente guardare 1000 keyword.
Quindi, immagina che il tuo sito venga servito per migliaia di keyword: fare rank tracking e concentrarsi su 50-100 keyword NON è un ottimo indicatore di progresso. Immagina un cliente frustrato perché i posizionamenti di, diciamo, 20 delle keyword monitorate sono calati mentre nel complesso il sito/dominio ha iniziato a essere servito per centinaia/migliaia di nuove keyword.
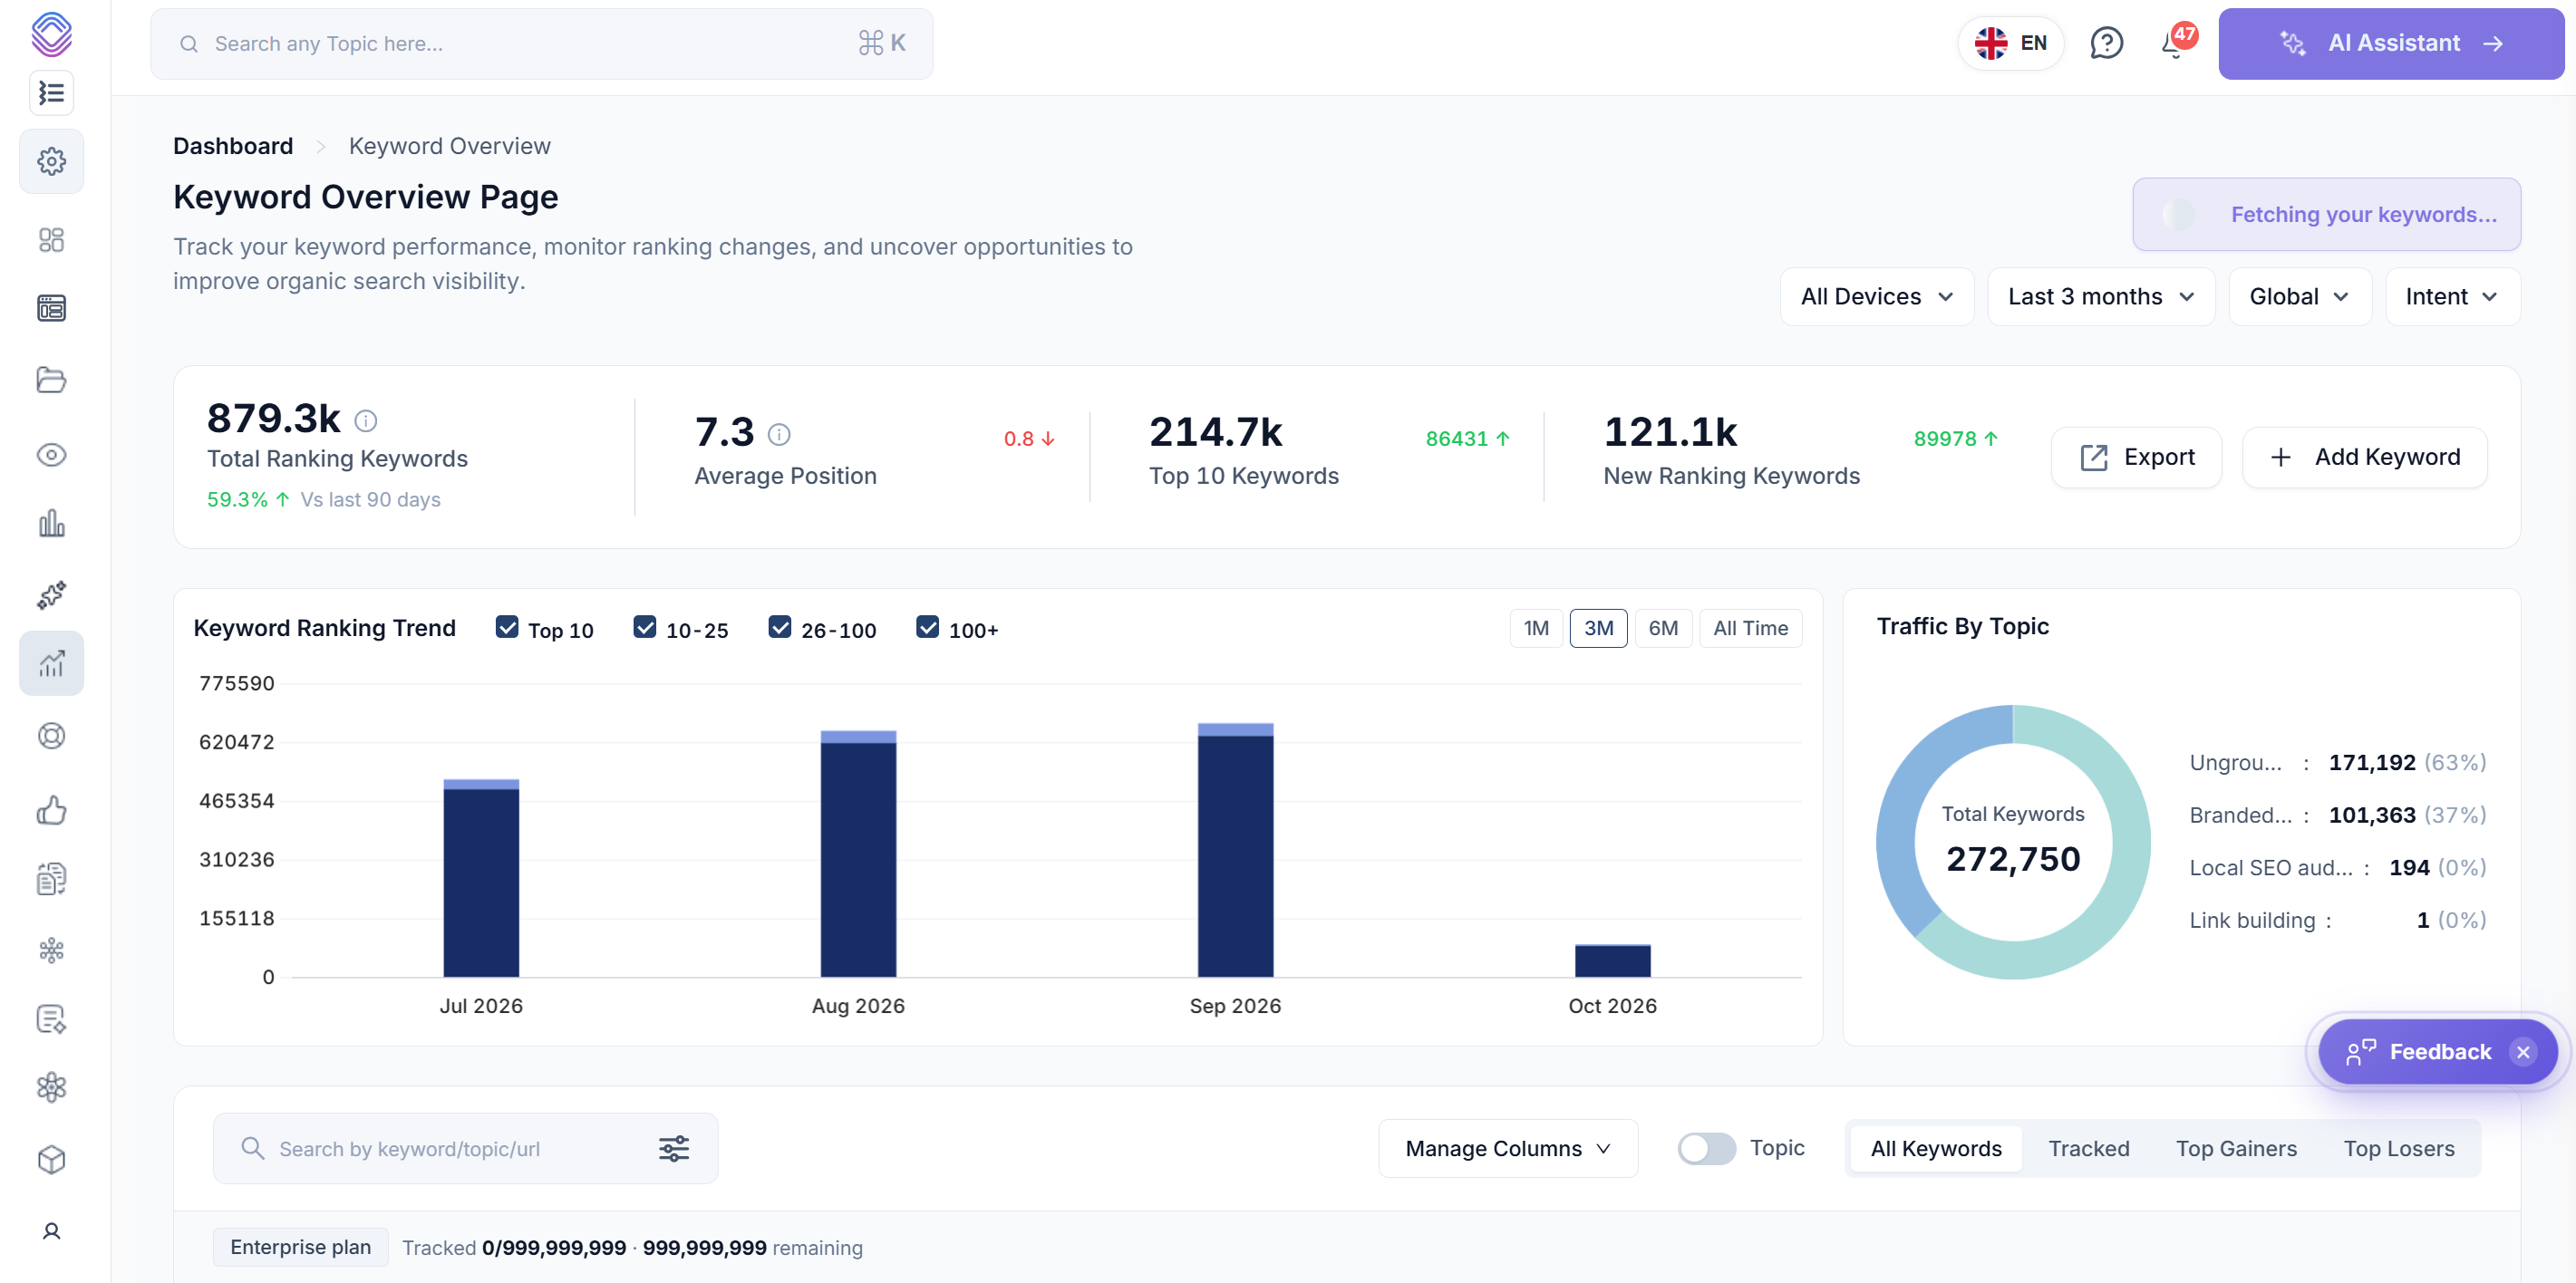
Detto questo, il rank tracking È comunque importante e molti SEO continuano a monitorare i posizionamenti e a riportarli ai clienti, di solito con cadenza settimanale o mensile; tuttavia non è raro che i siti abbiano migliaia di keyword servite, quindi vale sempre la pena essere attenti con i clienti e spiegare che la valutazione della performance può includere sia i report di ranking sia il volume totale di keyword per cui un dominio viene servito. Per esempio, un cliente di una delle nostre agenzie monitora 500 keyword in SEO Stack, ma il suo dominio viene servito per oltre 879.000 keyword!!!!
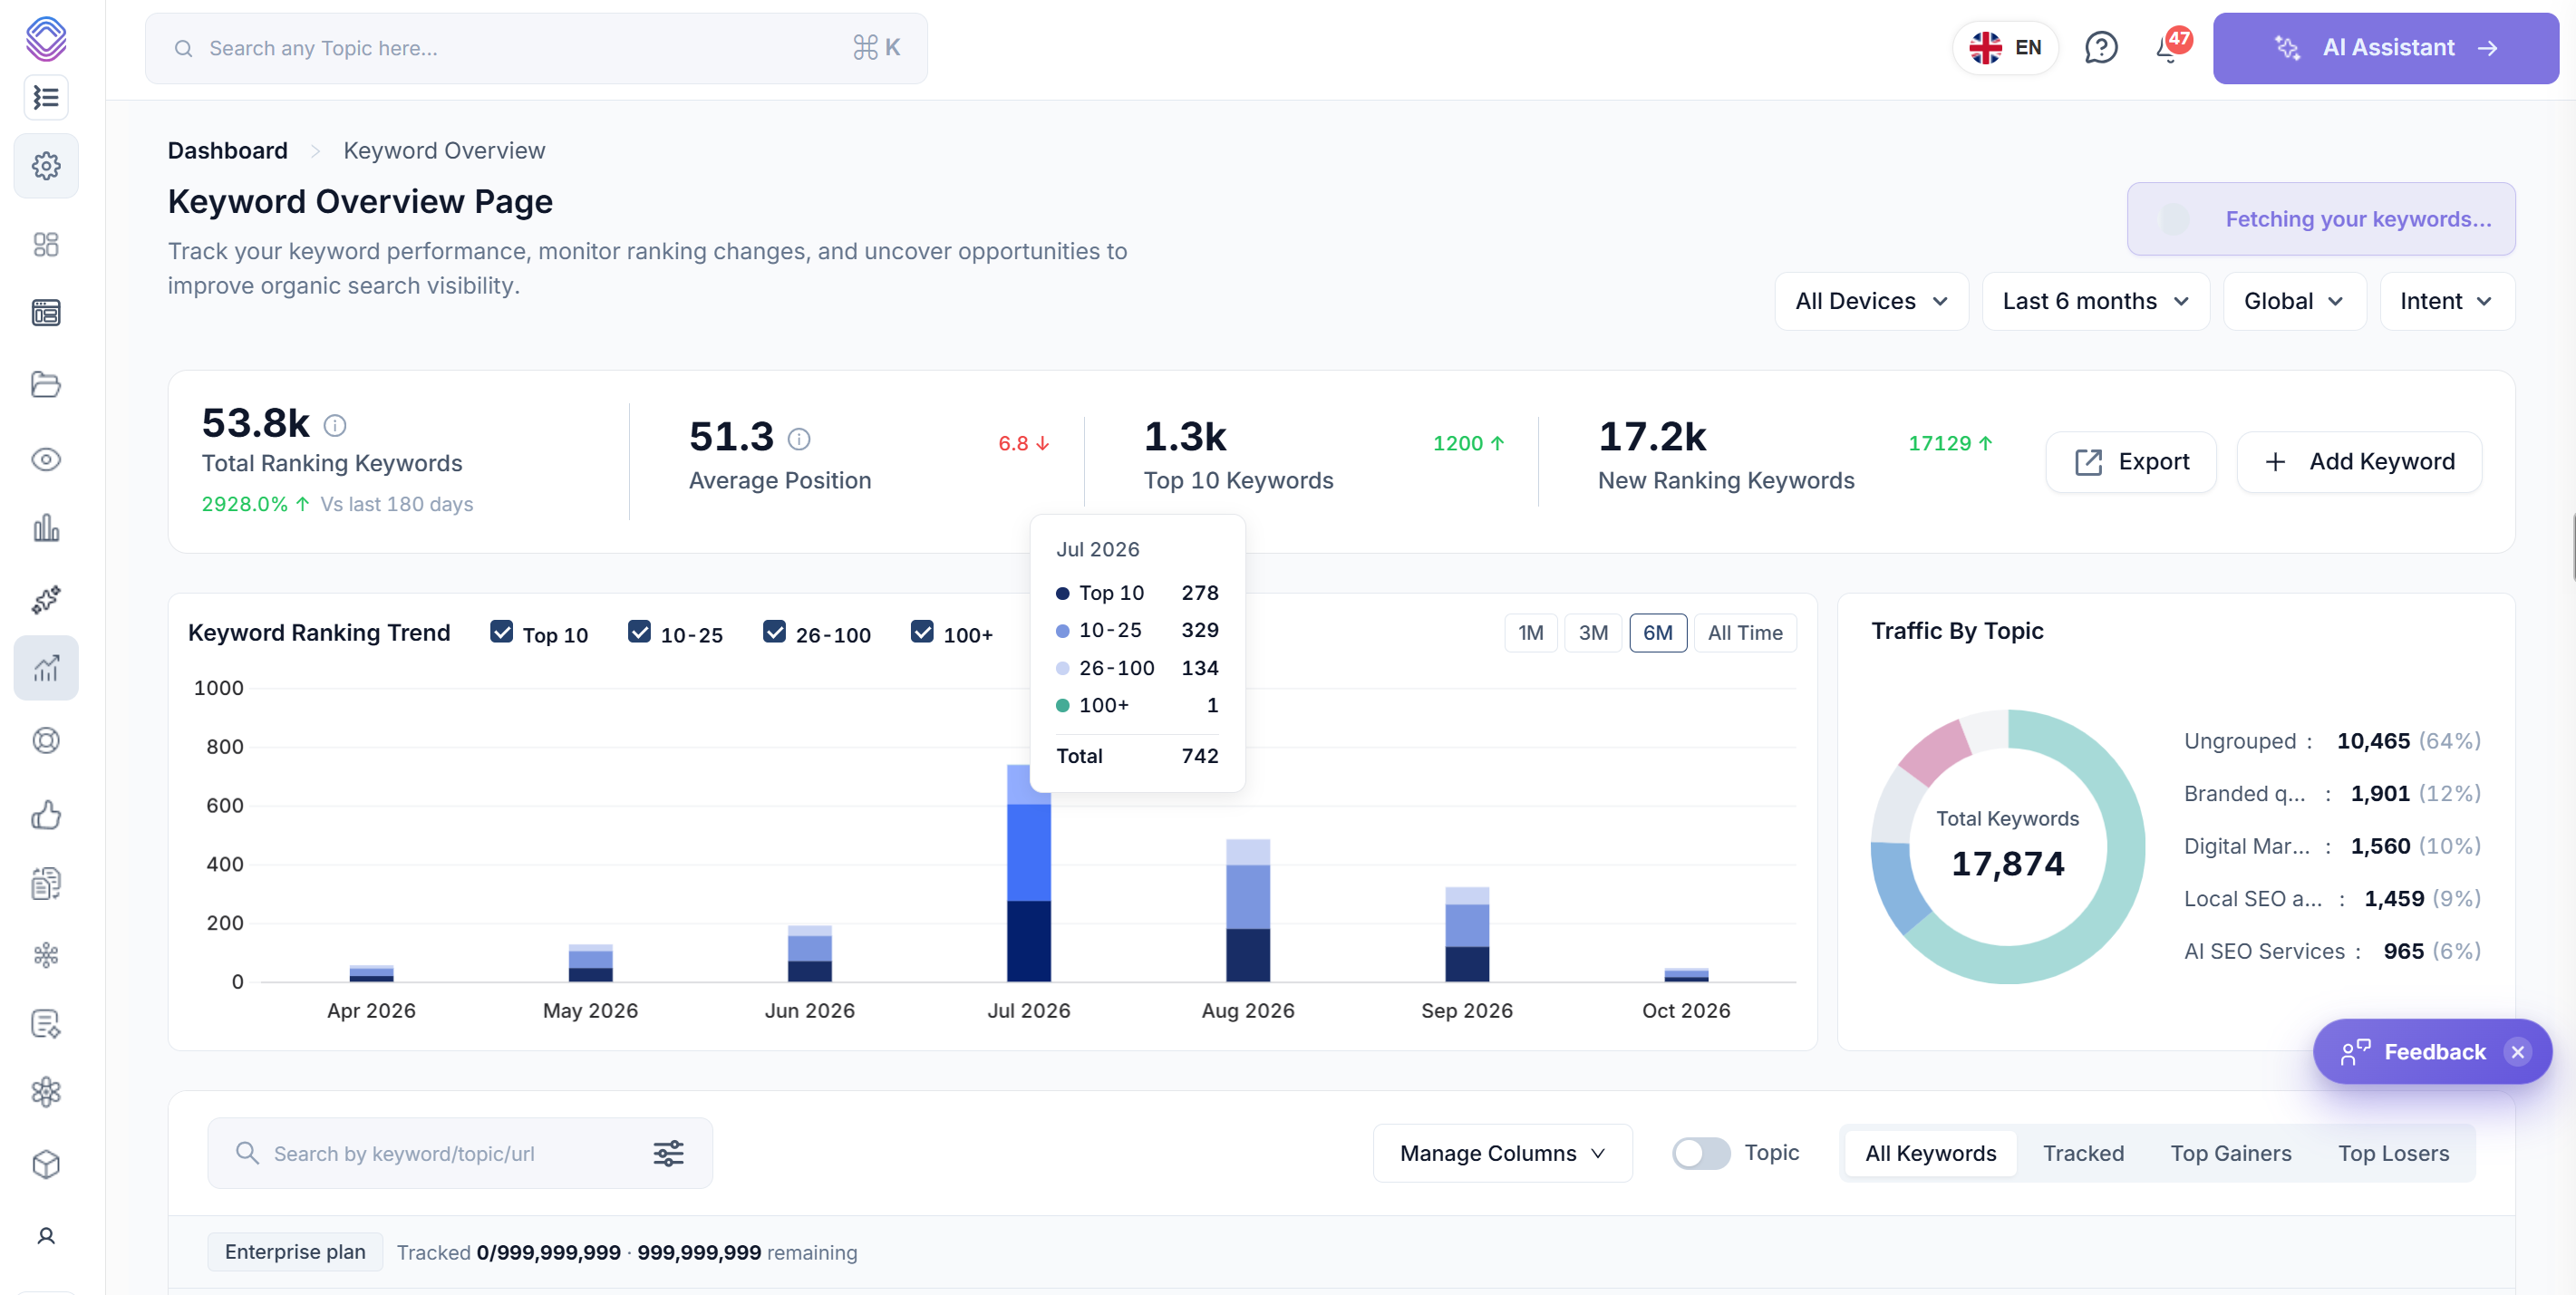
Anche i siti piccoli possono essere serviti per migliaia di keyword, quindi vale la pena tenerlo a mente: di norma diciamo che il rank tracking e i report di ranking possono essere usati per le query di maggior valore, magari quelle più associate a vendite o conversioni.
Anche i siti piccoli possono avere un'ampia impronta di keyword servite:
Quindi immagina che il tuo rank tracking riporti solo, diciamo, l'1% di tutte le query servite: non vuoi che i tuoi clienti si fissino troppo affidandosi al solo rank tracking.
Ora, tornando ai report di ranking, in breve un report di ranking:
Un report di ranking risponde a una domanda generale del cliente: dove ha trovato questo strumento di rank tracking una pagina per queste keyword/query selezionate, in questo luogo, su questo dispositivo, in questo momento?
Si tratta di un'informazione utile, ma non equivale a conoscere ogni query per cui Google serve il tuo sito, né a capire come stia cambiando complessivamente la tua performance nella ricerca organica. Ed è per questo che diciamo che i 2 deliverable chiave su cui concentrarsi dovrebbero essere:
Report di ranking in cui le keyword monitorate siano di valore più alto
Panoramica delle keyword, così da poter dimostrare ai clienti la crescita delle keyword servite nel tempo
Cosa ci dice il rank tracking
Il rank tracking tradizionale monitora un insieme scelto di keyword nel tempo. A seconda dello strumento, puoi specificare un motore di ricerca, un paese o una città, il dispositivo e talvolta un'area di ricerca locale precisa. Puoi poi vedere se una query/pagina target sale o scende nelle SERP, confrontare i competitor sugli stessi termini e monitorare le SERP feature.
Continuo a vederne un'utilità chiara: se un'azienda ha bisogno di sapere se la sua pagina di servizio principale è visibile per una frase commercialmente importante in una determinata città, una verifica specifica per località è una diagnosi utile.
In definitiva, il rank tracking ci dice la "traiettoria" della performance sulla base del pool di keyword monitorate: è un "indicatore di performance" e un deliverable per il cliente. Tuttavia, il rank tracking da solo NON è un indicatore di performance esclusivo perché, come detto sopra, non si tratta solo di guardare una piccola porzione di keyword, ma anche di guardare il quadro più ampio.
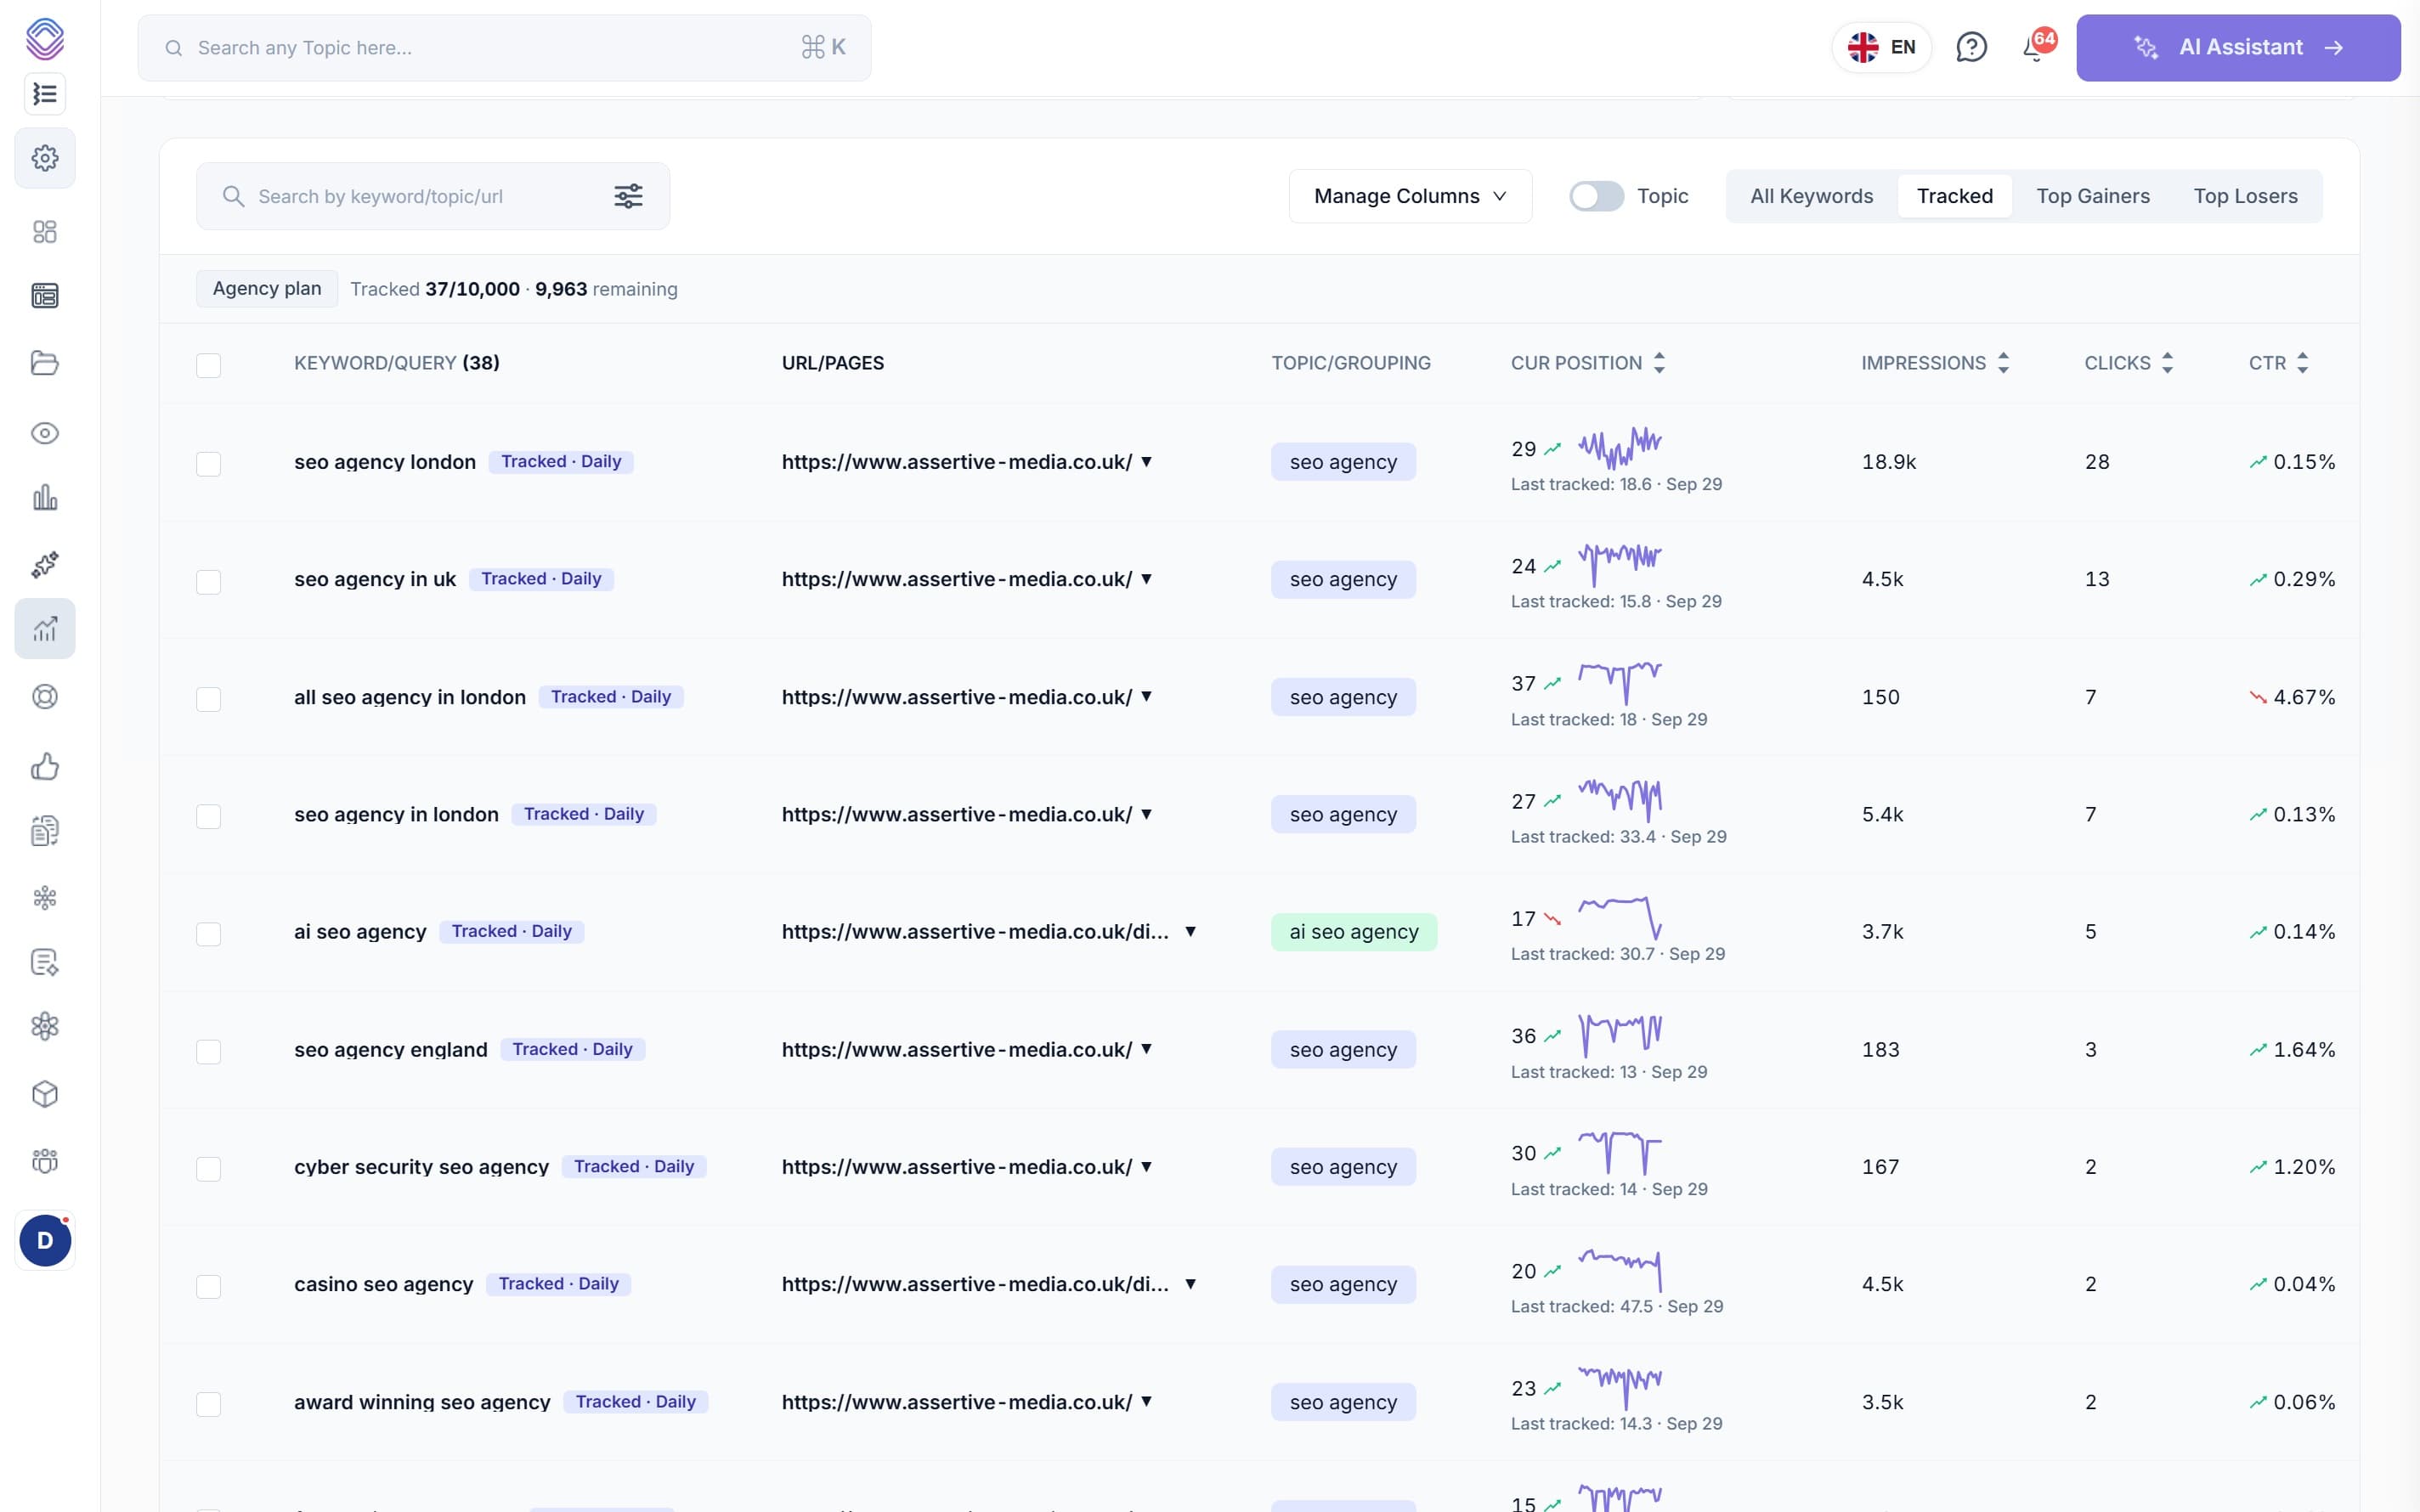
Per esempio, Assertive Media (agenzia SEO con sede a Londra) vuole naturalmente vedere come si posiziona per i termini legati alle agenzie SEO (con e senza località). In SEO Stack possiamo impostare il tracking di keyword specifiche aggiungendo le nostre keyword oppure prelevando i dati delle keyword da Google Search Console:
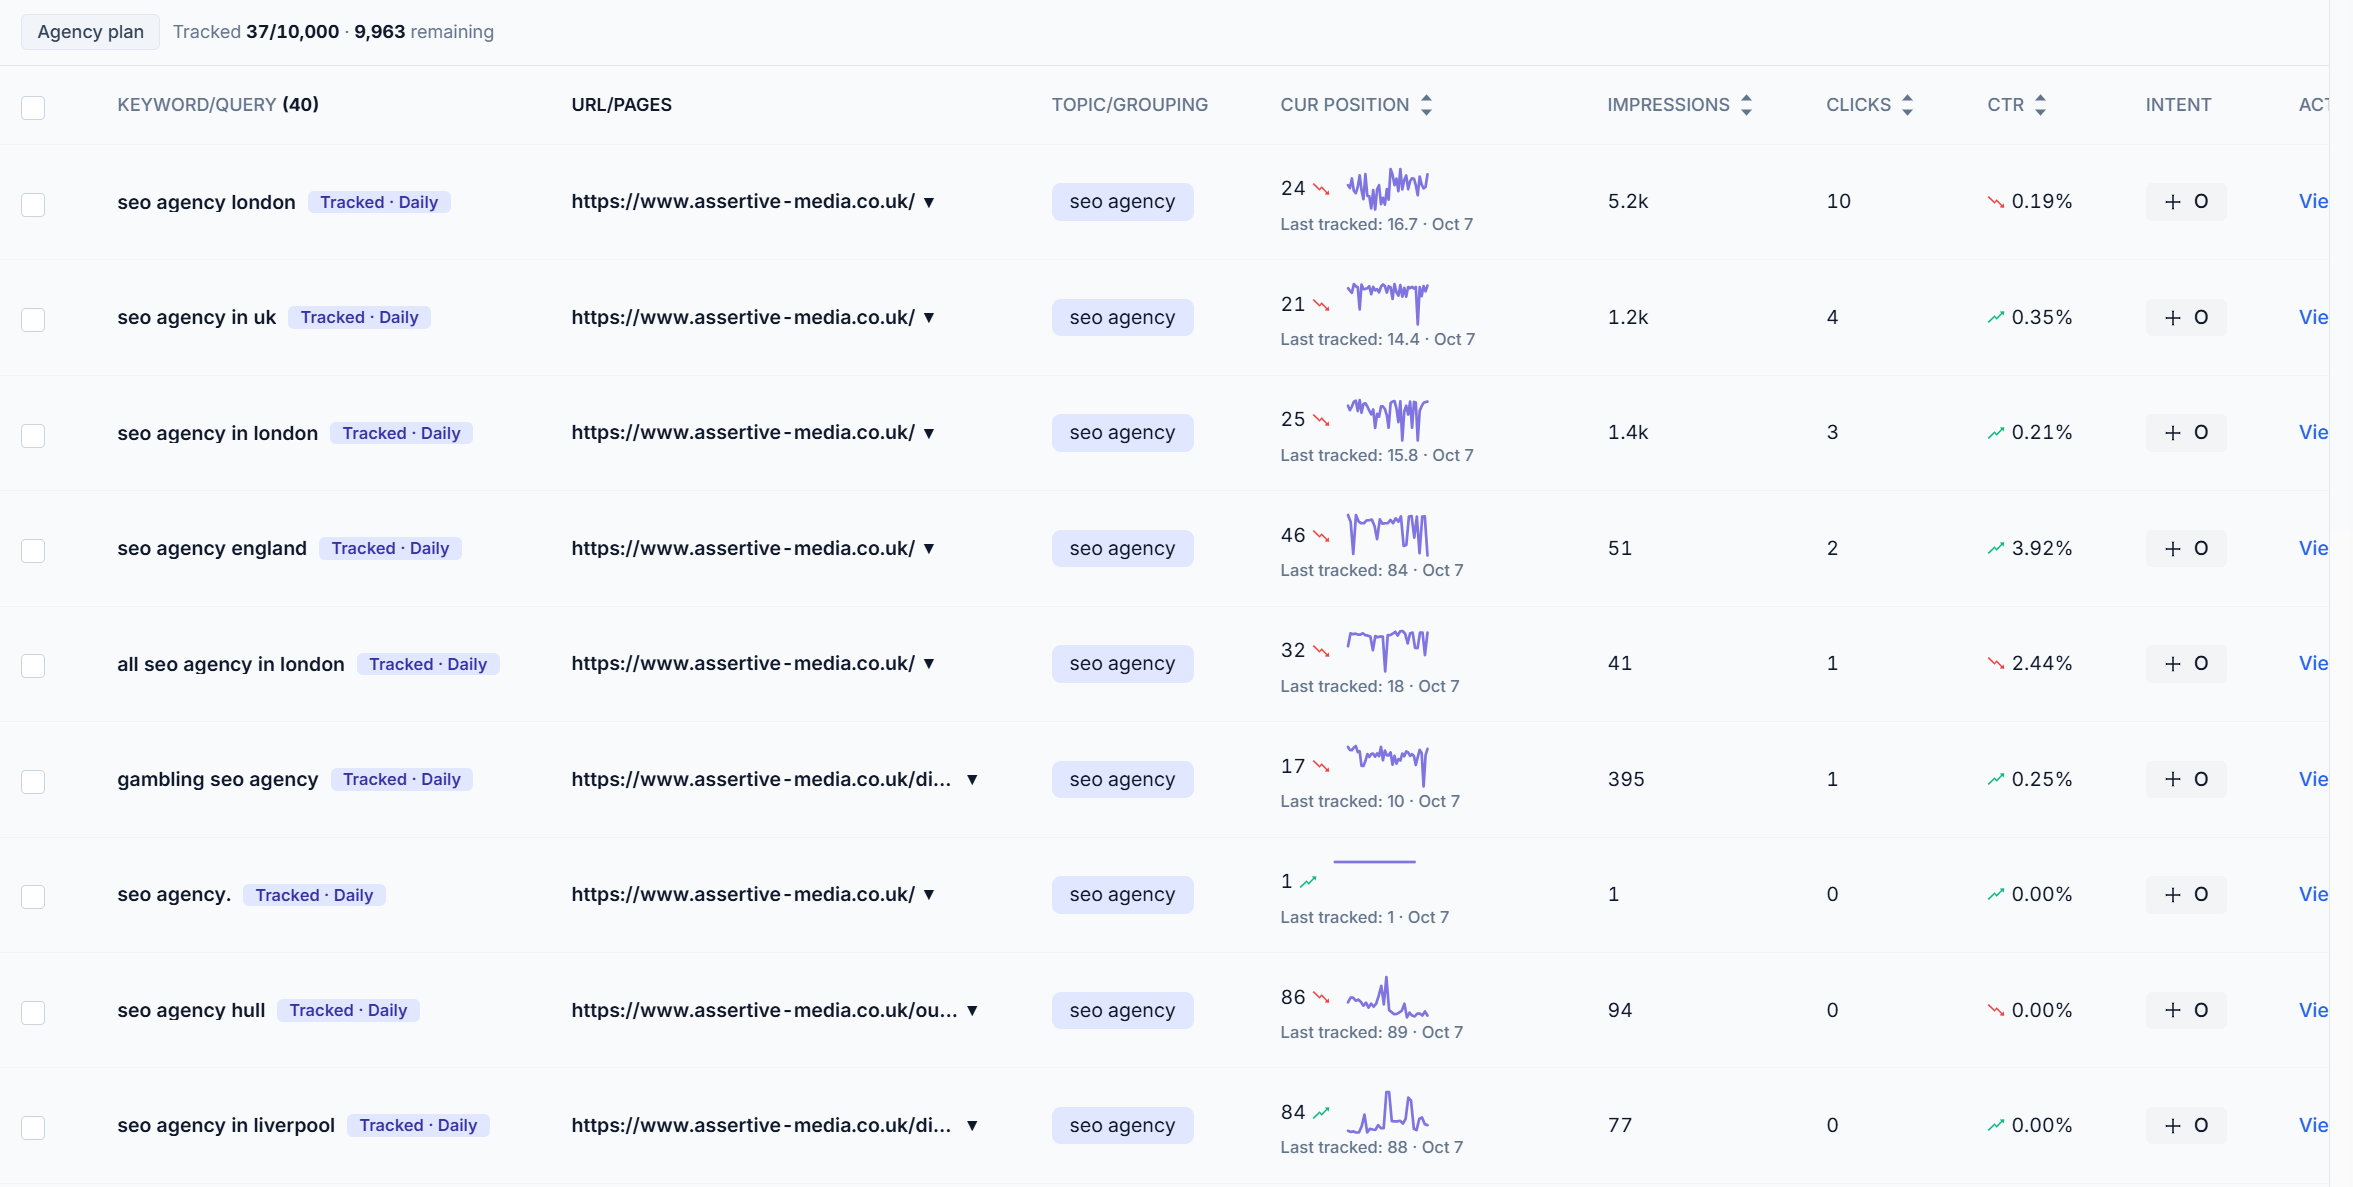
Come nel rank tracking tradizionale, SEO Stack ti permette di vedere la keyword, l'URL servito e la traiettoria complessiva della performance nel tempo —
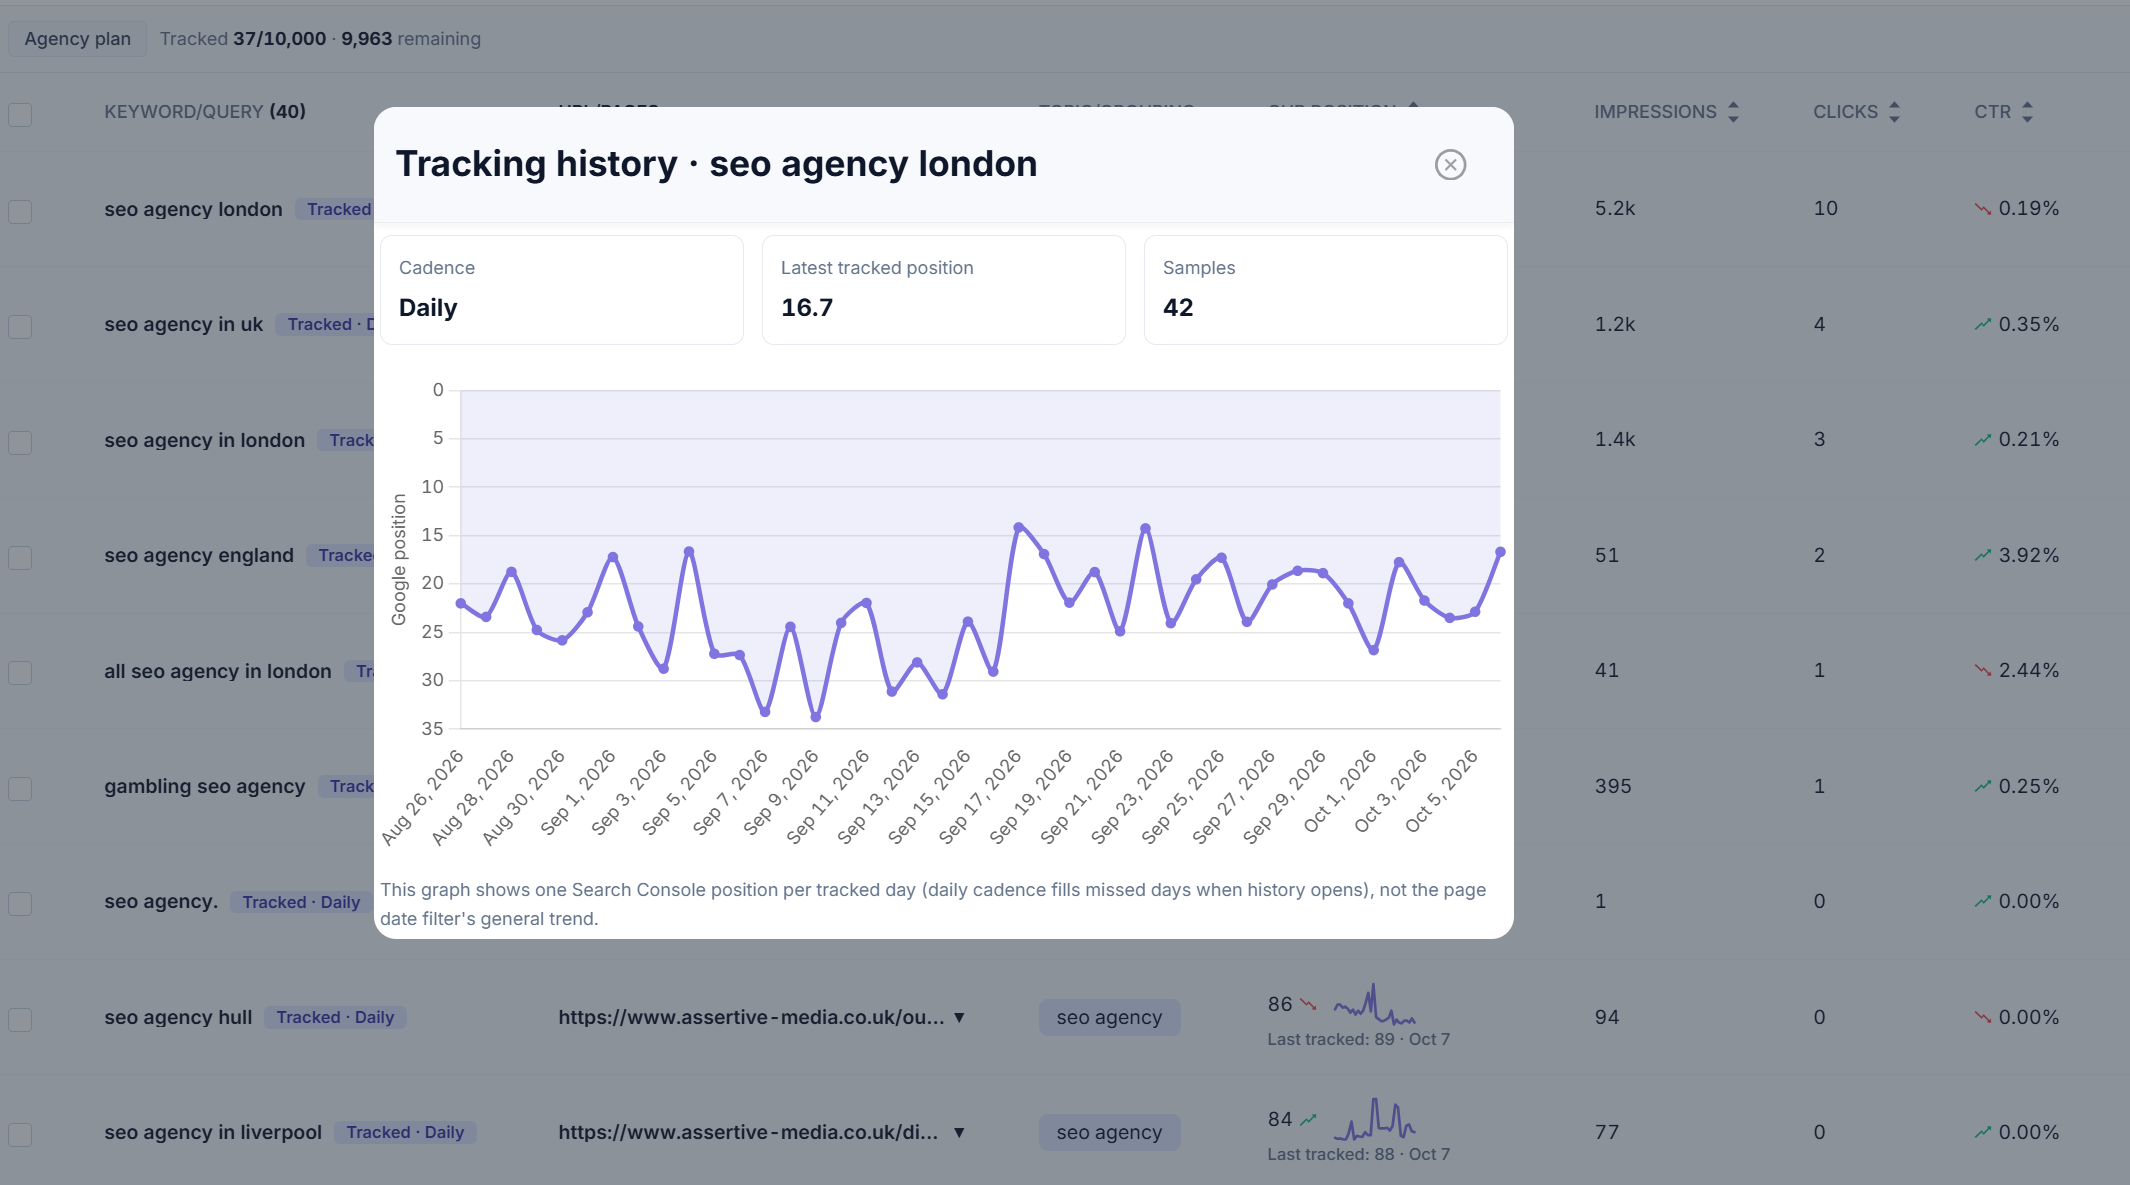
Qui sopra vediamo uno snapshot giorno per giorno della performance di "SEO Agency London" come keyword per Assertive Media; possiamo vederlo affiancato a dati di performance come impression, click, CTR, intent ecc.

Il rank tracking ci dice anche come stanno performando gli URL per le keyword, ma possiamo applicare filtri per restringere ulteriormente l'analisi della performance.
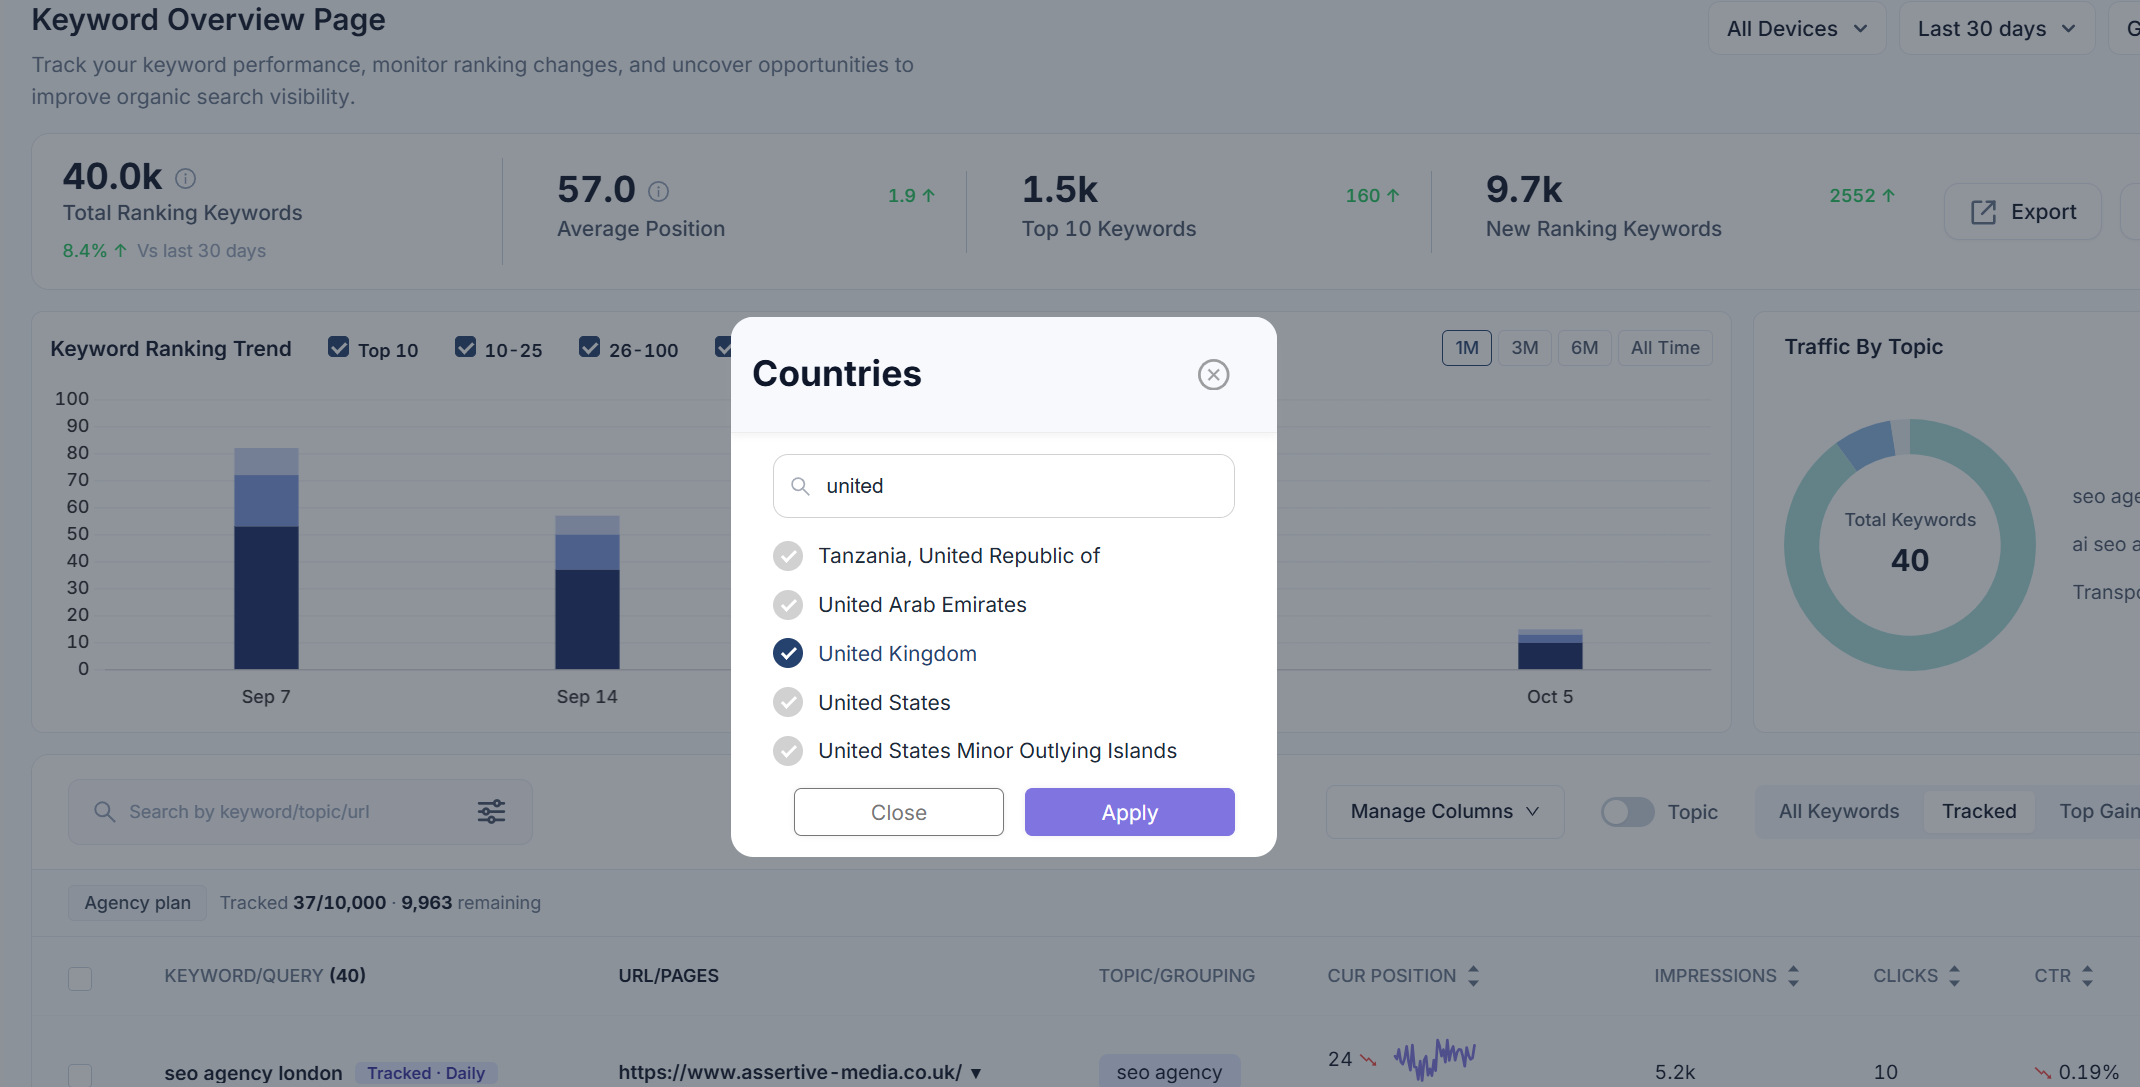
Per esempio, se sto monitorando "seo agency london" come keyword, è chiaramente sensato applicare un filtro a livello di paese: cosa che in SEO Stack possiamo fare in modo rapido e semplice:
Basta selezionare il menu a tendina del localizzatore (GLOBAL) e poi scegliere il paese/i paesi che preferiamo:
E poi possiamo vedere la performance di posizionamento in base ai filtri applicati:
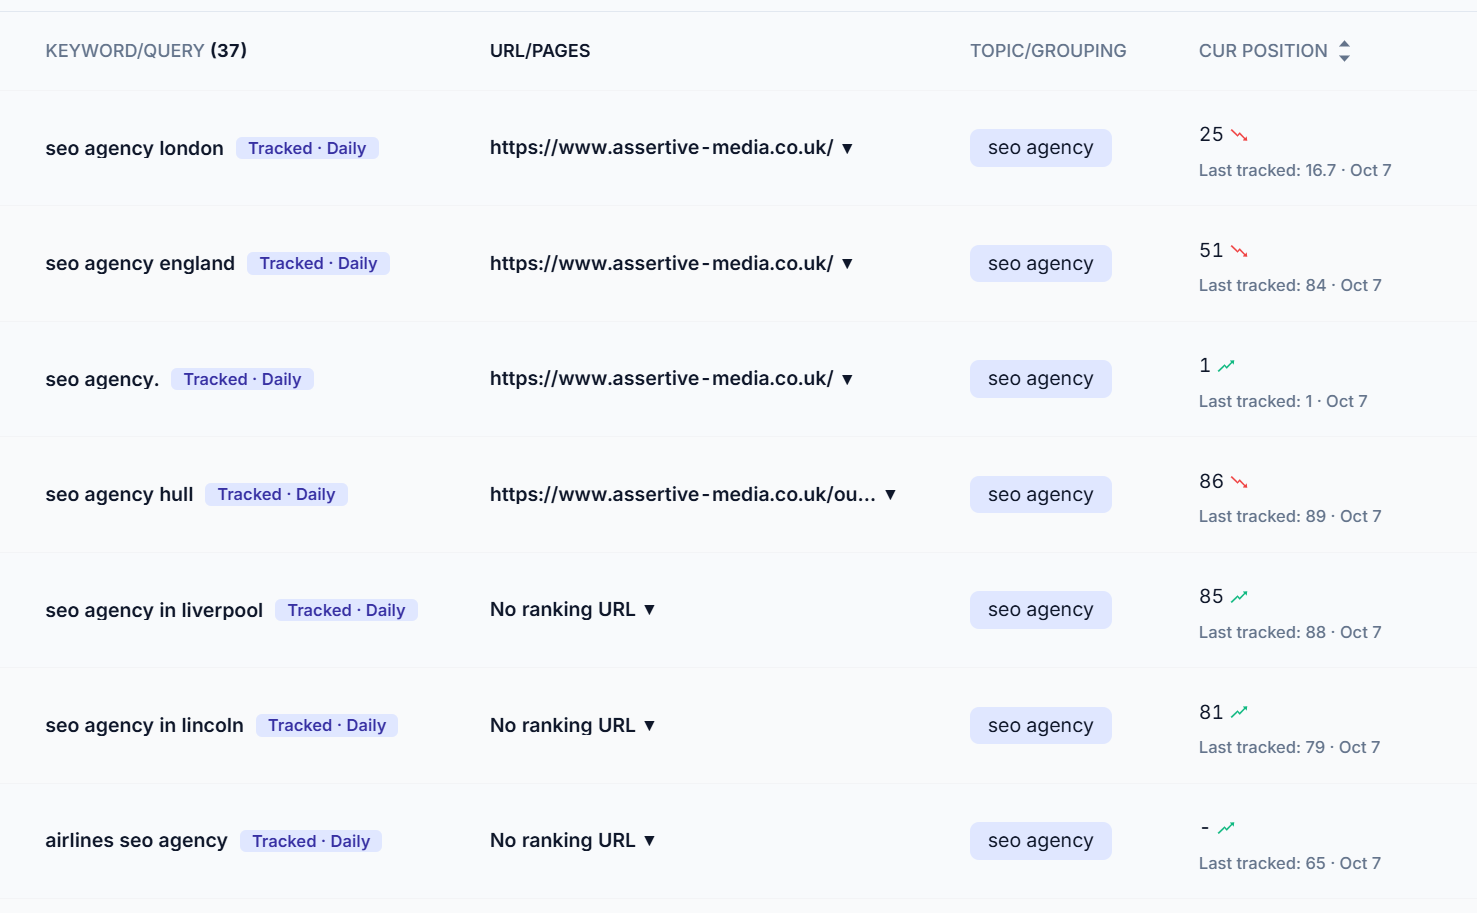
Semplice così!
La fallacia delle 100 keyword
Un sito può comparire per migliaia di ricerche diverse mentre un team SEO ne monitora solo i 100 termini a più alta priorità. Quei 100 vengono di solito scelti deliberatamente: head term, frasi commerciali, prodotti o servizi noti e keyword con volume di ricerca sufficiente a sembrare importanti in un documento di pianificazione. Tipicamente i SEO ricavano le keyword dal feedback del cliente o dai dati PPC, dove le conversioni confermano il valore della keyword.
Di solito il rank tracking dà priorità alle keyword in base al volume di ricerca o al valore/rilevanza commerciale; tuttavia le keyword giuste da monitorare dipendono davvero da molteplici fattori, dal potenziale di conversione alla priorità del cliente.
Pensa a un rivenditore di mobili che monitora “tavolo da pranzo”: quella singola frase ci dice poco sulla visibilità del sito per “tavolo da pranzo piccolo in rovere”, “tavolo allungabile per 6” o per una domanda più specifica su dimensioni e consegna. Alcune di queste ricerche potrebbero generare una manciata di impression al mese, altre potrebbero diventare importanti al variare della domanda o dei contenuti. Su un sito grande possono comunque sommarsi.
Google Search Console offre ai proprietari di siti un'altra prospettiva: le query, le pagine, le impression, i click, il click-through rate e la posizione media che Google ha registrato per la loro property. La posizione media di Google è calcolata sulle impression, quindi non coinciderà con la ricerca in tempo reale di una singola persona in ogni località: è più generica, meno su misura e non tiene conto della personalizzazione. È una misura della performance osservata, non un posizionamento universale valido per ogni utente.
Google spiega la metrica della posizione qui:
https://support.google.com/webmasters/answer/7042828?hl=en
SEO Stack è un data warehouse per i dati di Google Search Console: questo ci permette di contare le query in modo accurato e su larga scala per ogni dominio che importi. È così che possiamo darti i dati di volume nella panoramica delle keyword, un elemento che dovrebbe essere intrinseco nel tuo reporting SEO —
Perché puoi mostrare i progressi ai clienti, ad esempio:
Possiamo osservare i volumi di keyword in un intervallo temporale specifico, ad esempio gli ultimi 3 mesi
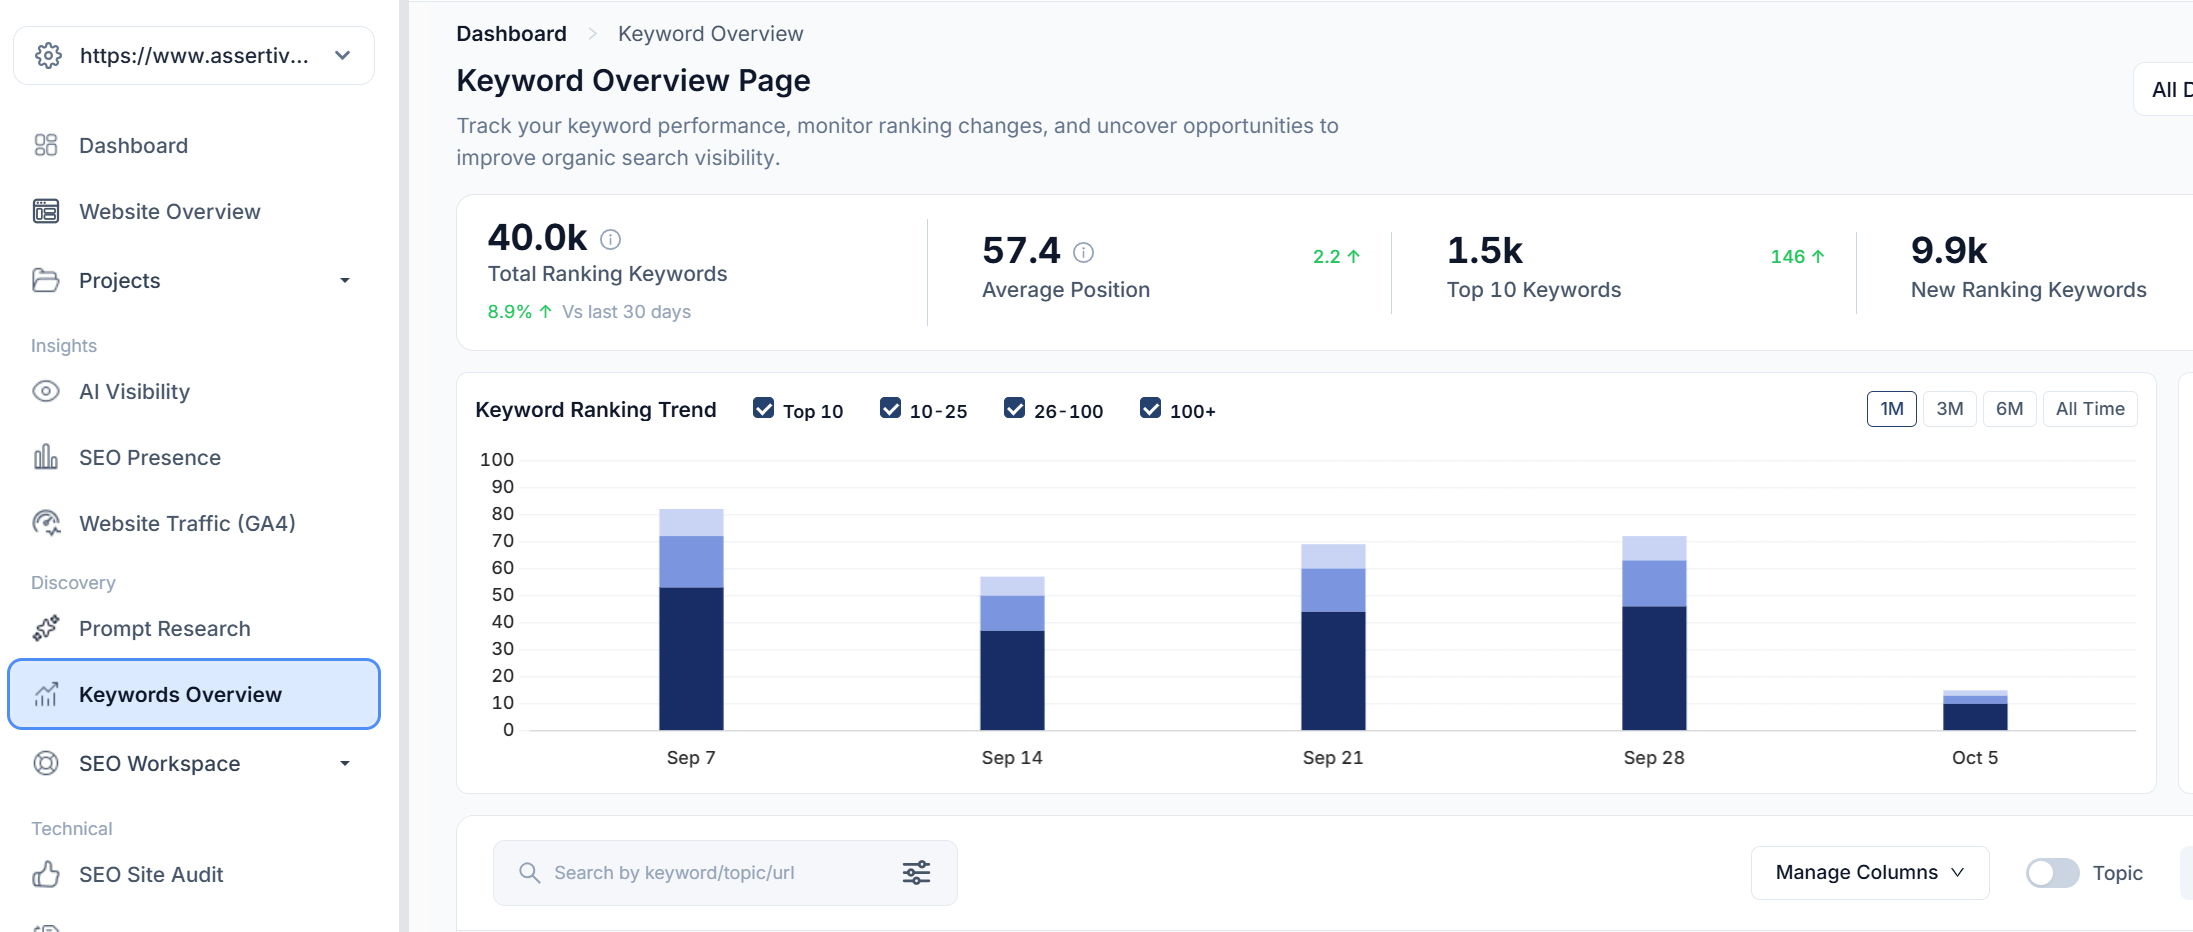
Ma poi possiamo fare un report su un periodo più lungo, ad esempio:
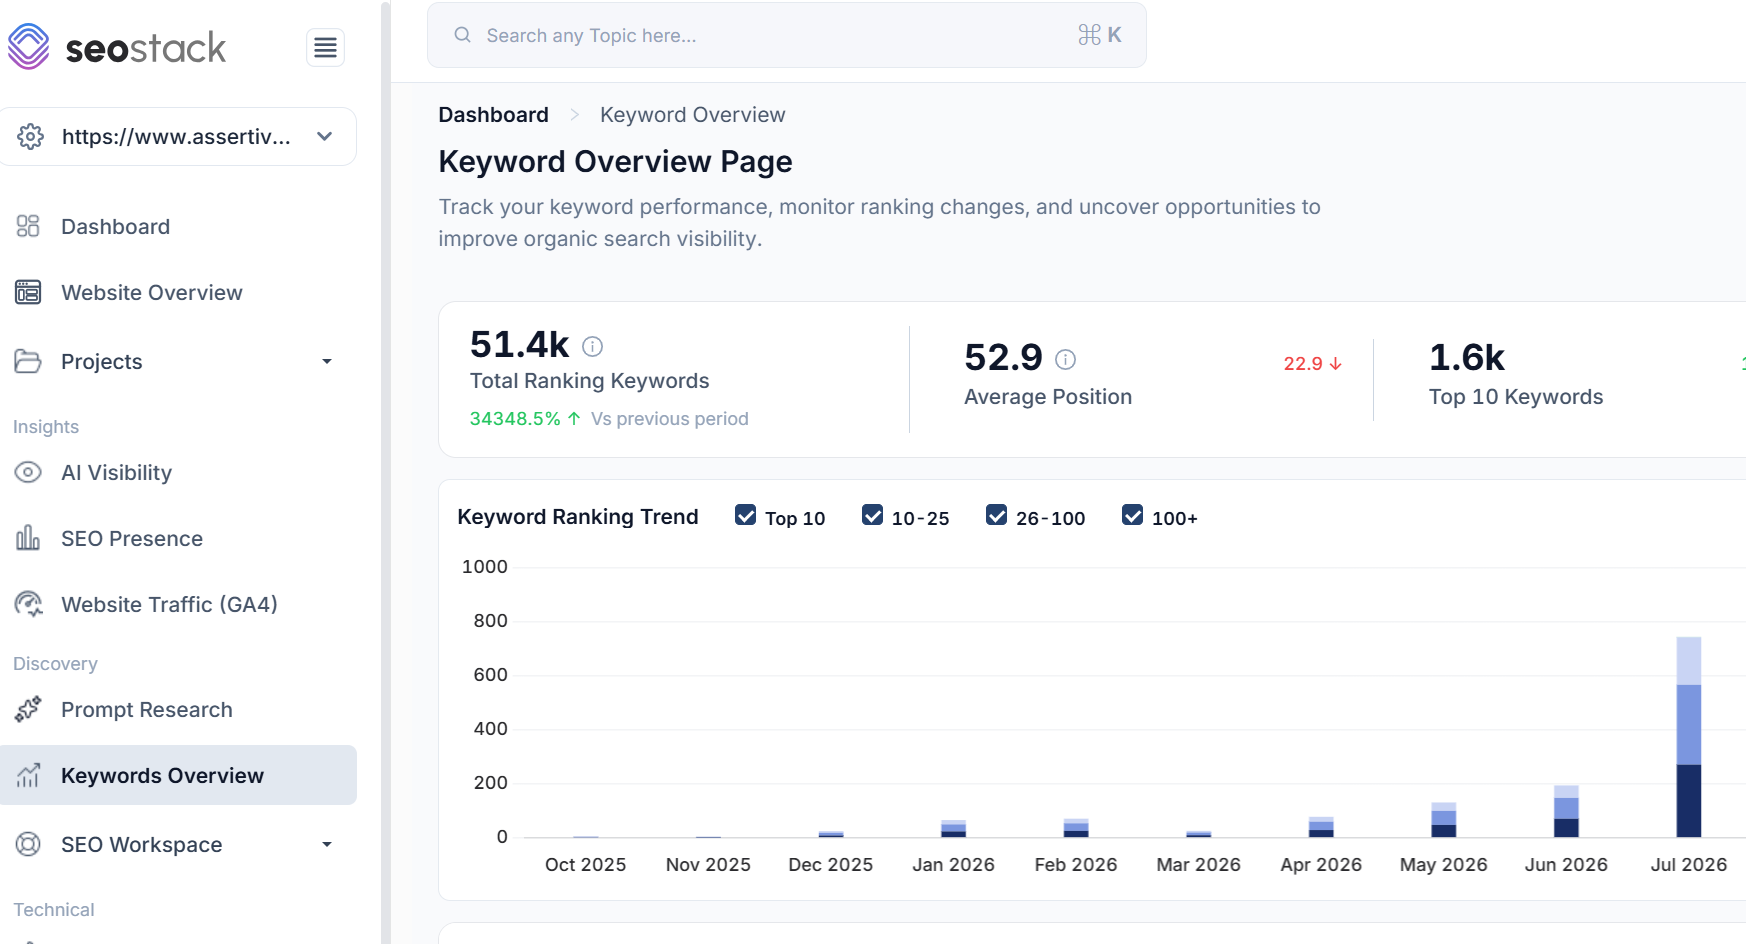
Questo è utile accanto al rank tracking, perché mostriamo il volume totale di keyword posizionate per gruppo di posizione, il che è ottimo per i clienti.
Google ha cambiato la facilità con cui si possono raccogliere le SERP - anzi, l'ha resa molto più difficile per gli strumenti di terze parti
Per anni, i fornitori di rank tracking hanno avuto bisogno di un modo per recuperare i risultati di ricerca su larga scala. Alcuni gestiscono sistemi di raccolta proprietari, altri tendono ad affidarsi a fornitori di dati SERP di terze parti come DataforSEO, SERPAPI ecc. In ogni caso, quando Google cambia il modo in cui vengono serviti i suoi risultati, gli strumenti che dipendono da quei risultati devono adattarsi - e, come abbiamo visto negli ultimi mesi, Google è stata eccezionalmente aggressiva contro gli scraper di terze parti.
Quindi, cosa ha fatto Google?
La modifica di &num=100
Il parametro &num=100 era ampiamente usato per richiedere 100 risultati Google in un singolo caricamento di pagina. A settembre 2025, SEO, fornitori di strumenti e professionisti hanno segnalato che Google aveva smesso di rispettarlo in modo coerente. Raccogliere risultati più in profondità poteva quindi richiedere più richieste, e alcuni strumenti mostravano una profondità di ranking mancante o ridotta mentre modificavano i loro sistemi. Search Engine Journal ha riportato il disservizio.
Questo non è stato solo dirompente, ma ha reso le richieste complessivamente più costose, perché invece di 1 richiesta che restituisce 100 risultati, ora servono 10 richieste per 100 risultati, rendendo più costoso ottenere i dati e mantenerli aggiornati.
L'effetto non è stato identico per tutti i fornitori. Ahrefs ha dichiarato che la modifica ha ridotto il numero di risultati verificabili oltre la prima pagina, per poi segnalare un graduale ripristino dei dati top-100 più avanti nel 2025, con una piccola percentuale di query che ancora non restituisce la profondità completa. È un promemoria utile: la modifica ha messo in luce una dipendenza e creato lavoro aggiuntivo, ma non ha reso ogni rank tracker permanentemente inutilizzabile. L'aggiornamento di Ahrefs è qui.
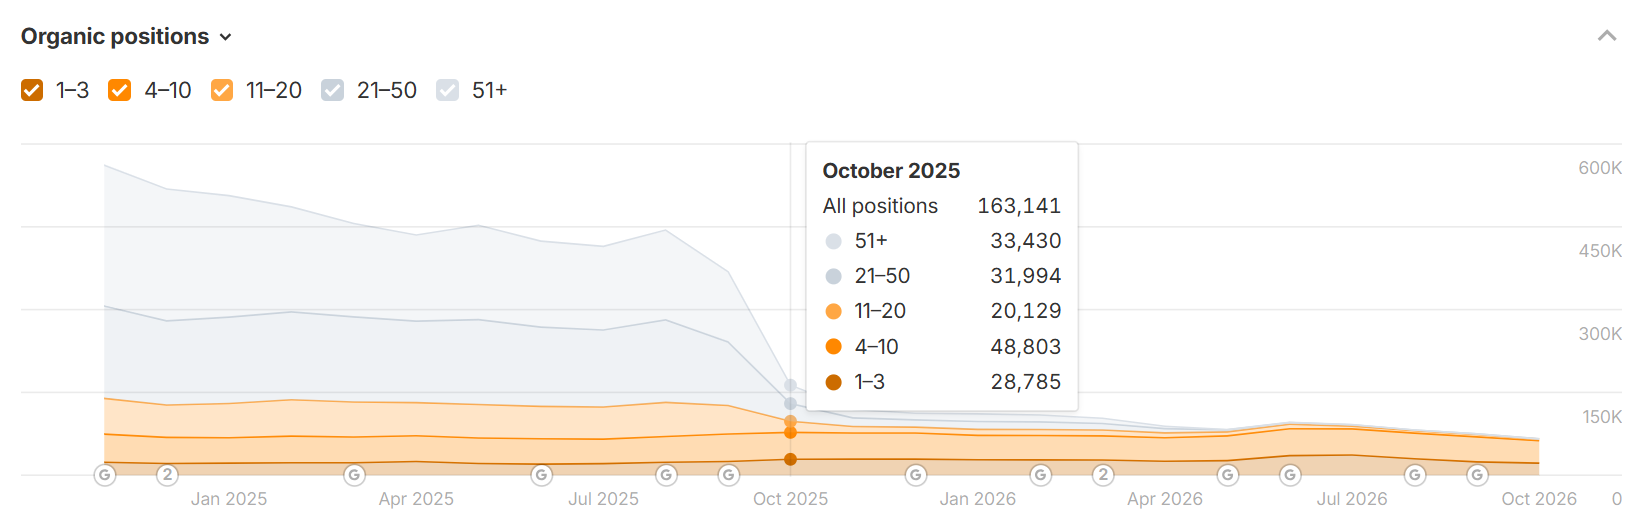
Vediamo però un gran numero di siti analizzati in cui il conteggio totale delle posizioni organiche cala, ma non necessariamente a causa di perdite o cali di ranking, bensì forse per una riduzione dei dati disponibili.
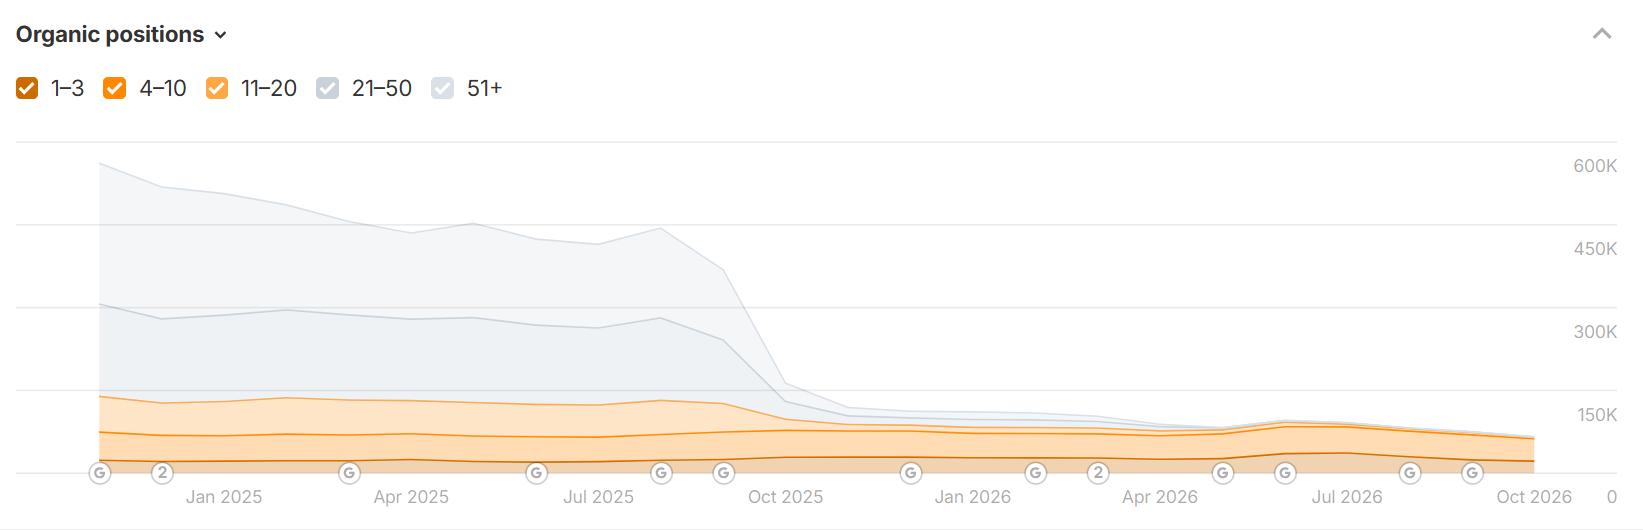
I link dei risultati /goto di Google
Ad agosto 2026, Google ha confermato il rilascio dei link passthrough google.com/goto nei risultati di ricerca. Invece di esporre un URL di destinazione diretto nel link del risultato, la pagina può passare attraverso un URL di Google prima di raggiungere la destinazione. Per uno scraper, questo aggiunge un passaggio di risoluzione dell'URL. Non significa che il ranking della pagina sia cambiato; cambia il modo in cui il link del risultato viene presentato e recuperato. Search Engine Roundtable ha riportato la conferma di Google.
La cosa fondamentale da capire è che gli URL GOTO compaiono nelle sessioni non autenticate: se guardi il risultato in SERP con l'accesso a un account Google effettuato, Google non ha motivo di offuscare l'URL, cioè
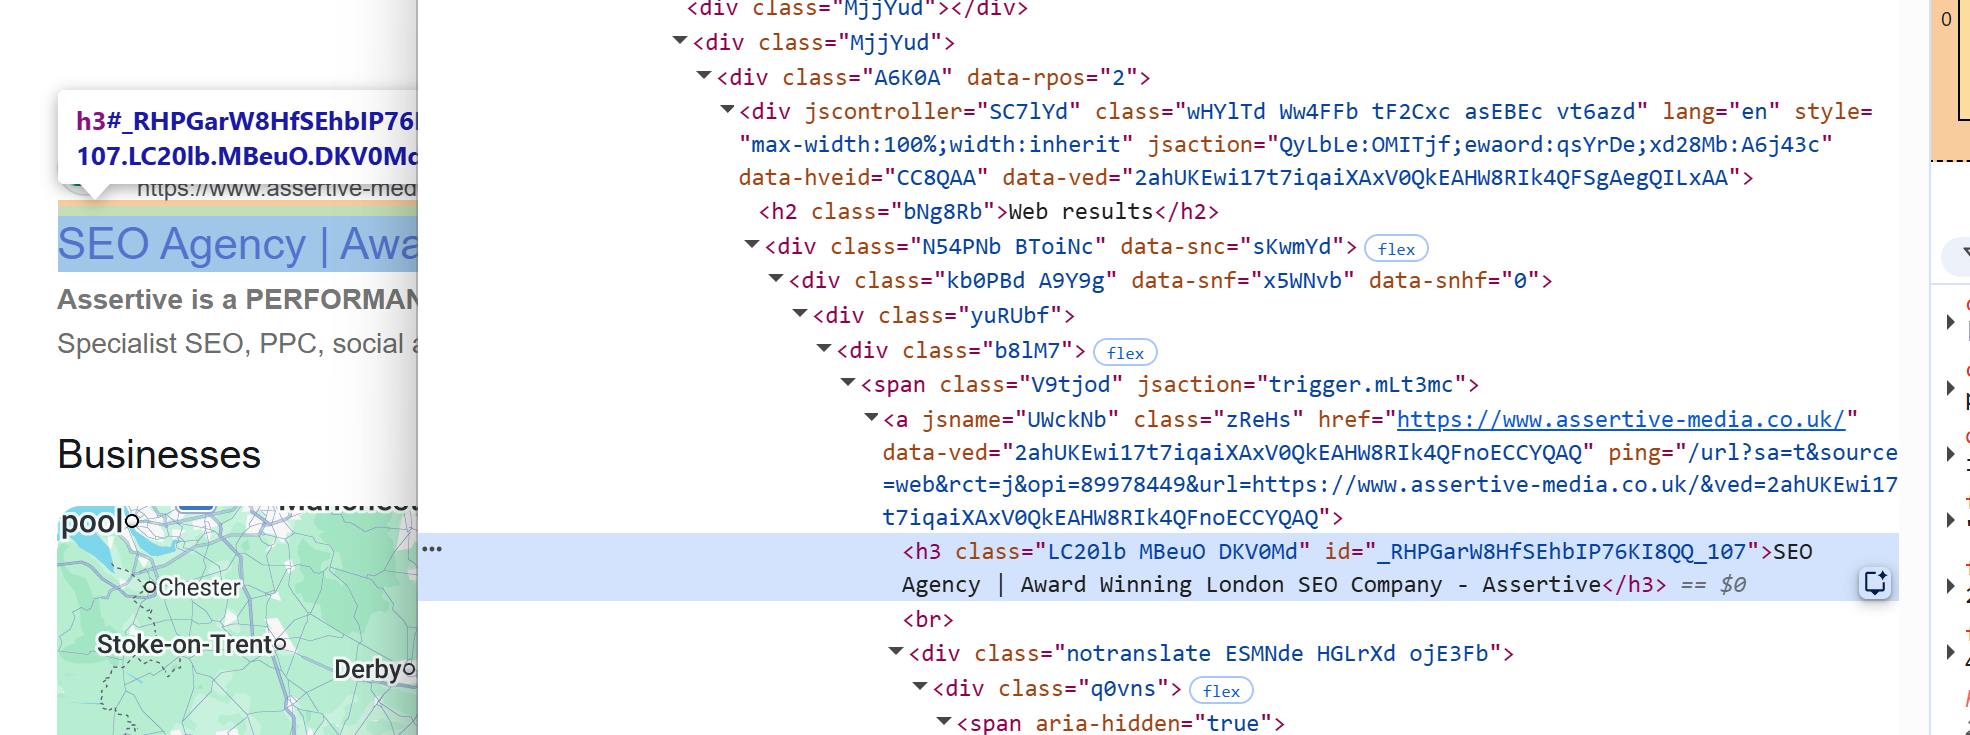
Ma, non appena hai effettuato il logout o sei in incognito, vedrai gli URL GOTO:
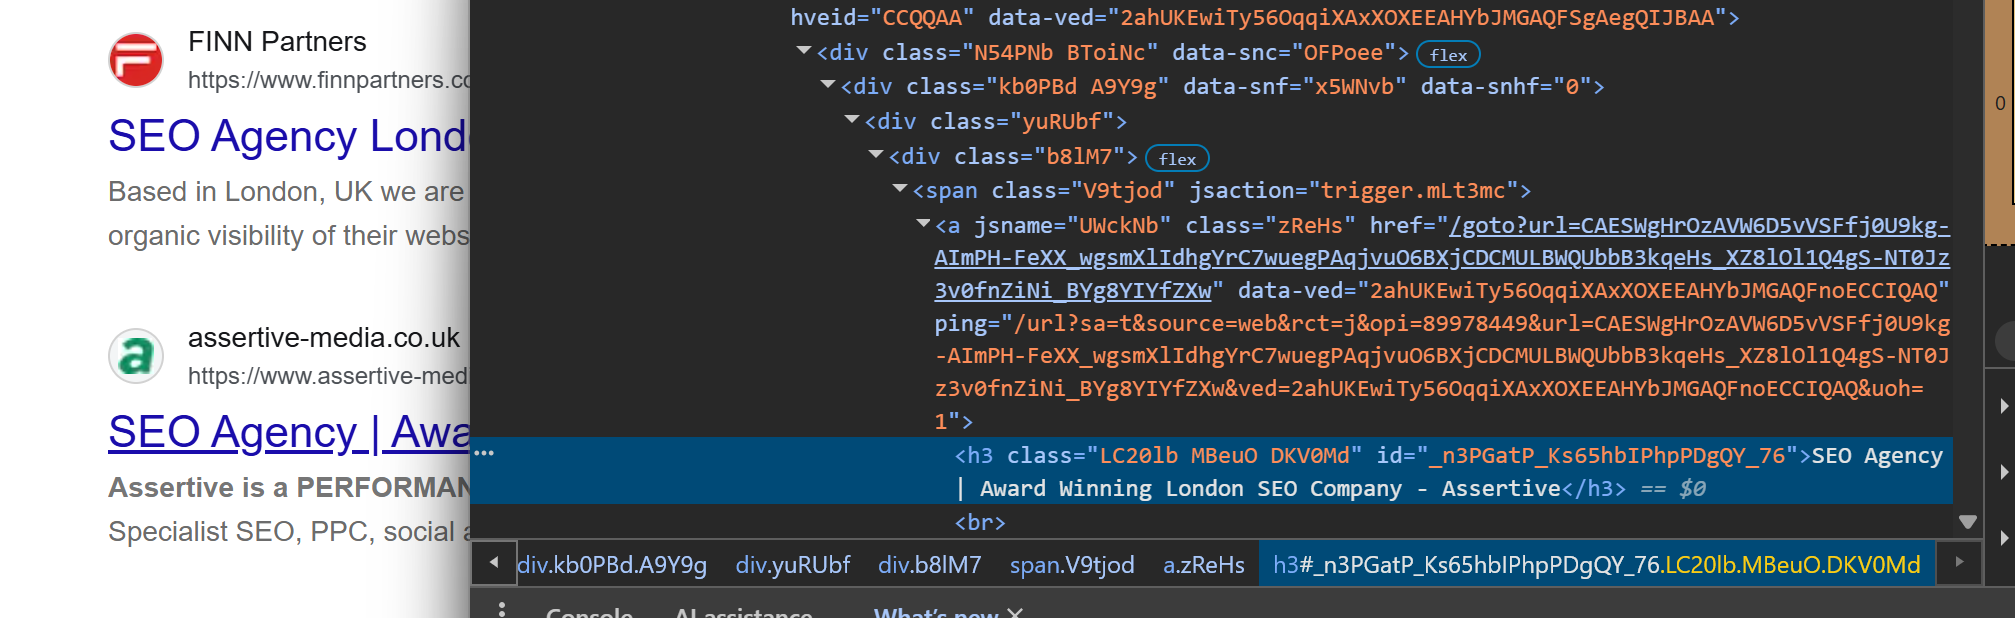
Quindi, chiaramente, questo è solo un altro modo con cui Google rende più difficile alle terze parti fare scraping per ottenere dati, inclusi i dati di rank tracking.
I fornitori di SERP possono sviluppare metodi per risolvere questi link: DataForSEO, ad esempio, dichiara che la sua API risolve la destinazione per il 99,99% delle SERP organiche che restituisce. È il dato riportato dal fornitore stesso, non un'affermazione valida per ogni strumento sul mercato. Dimostra però che i vendor possono adattarsi, chiarendo al contempo che la copertura dipende dall'implementazione di ciascun fornitore. L'aggiornamento di DataForSEO spiega il suo approccio.
I dati giornalieri sono utili, ma la cadenza non è tutta la differenza
Sarebbe fuorviante sostenere che i rank tracker di terze parti non possano fornire aggiornamenti giornalieri. Semrush afferma che il suo strumento Position Tracking monitora quotidianamente keyword specifiche e può segmentarle per località e dispositivo. Sono punti di forza reali quando l'obiettivo è seguire una campagna definita o confrontare i competitor in un mercato specifico. La documentazione di Semrush descrive queste funzionalità.
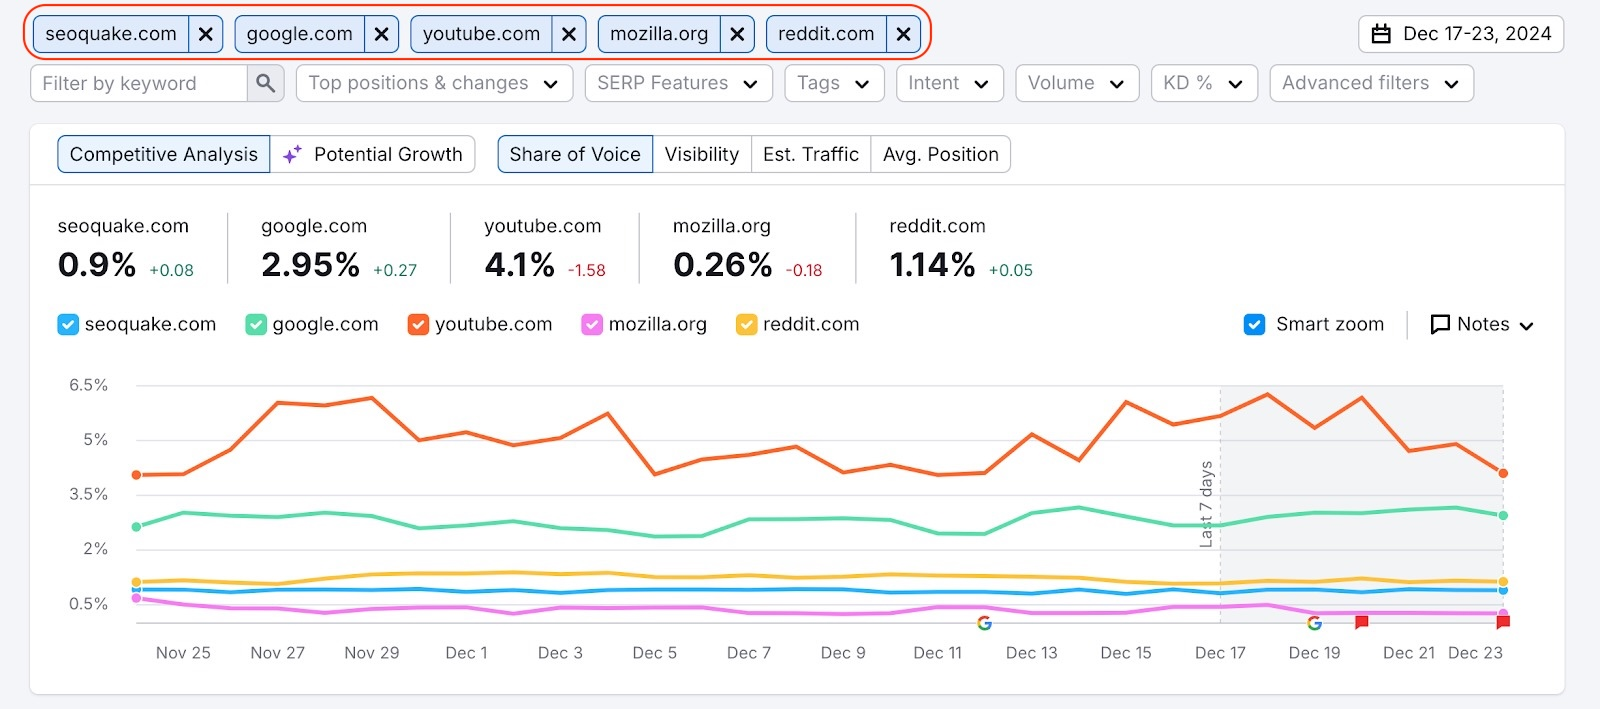
Il report Position Tracking di Semrush illustra il valore di un set di keyword configurato e del confronto con i competitor. Fonte screenshot: Semrush Help Centre.
La differenza sta nel modello di dati: un SERP tracker / strumento di rank tracking verifica termini selezionati in un setup controllato. È questo che distingue SEO Stack dagli altri rank tracker: SEO Stack riporta la posizione media registrata da Google per la tua proprietà, query per query, insieme a impression, clic e CTR.
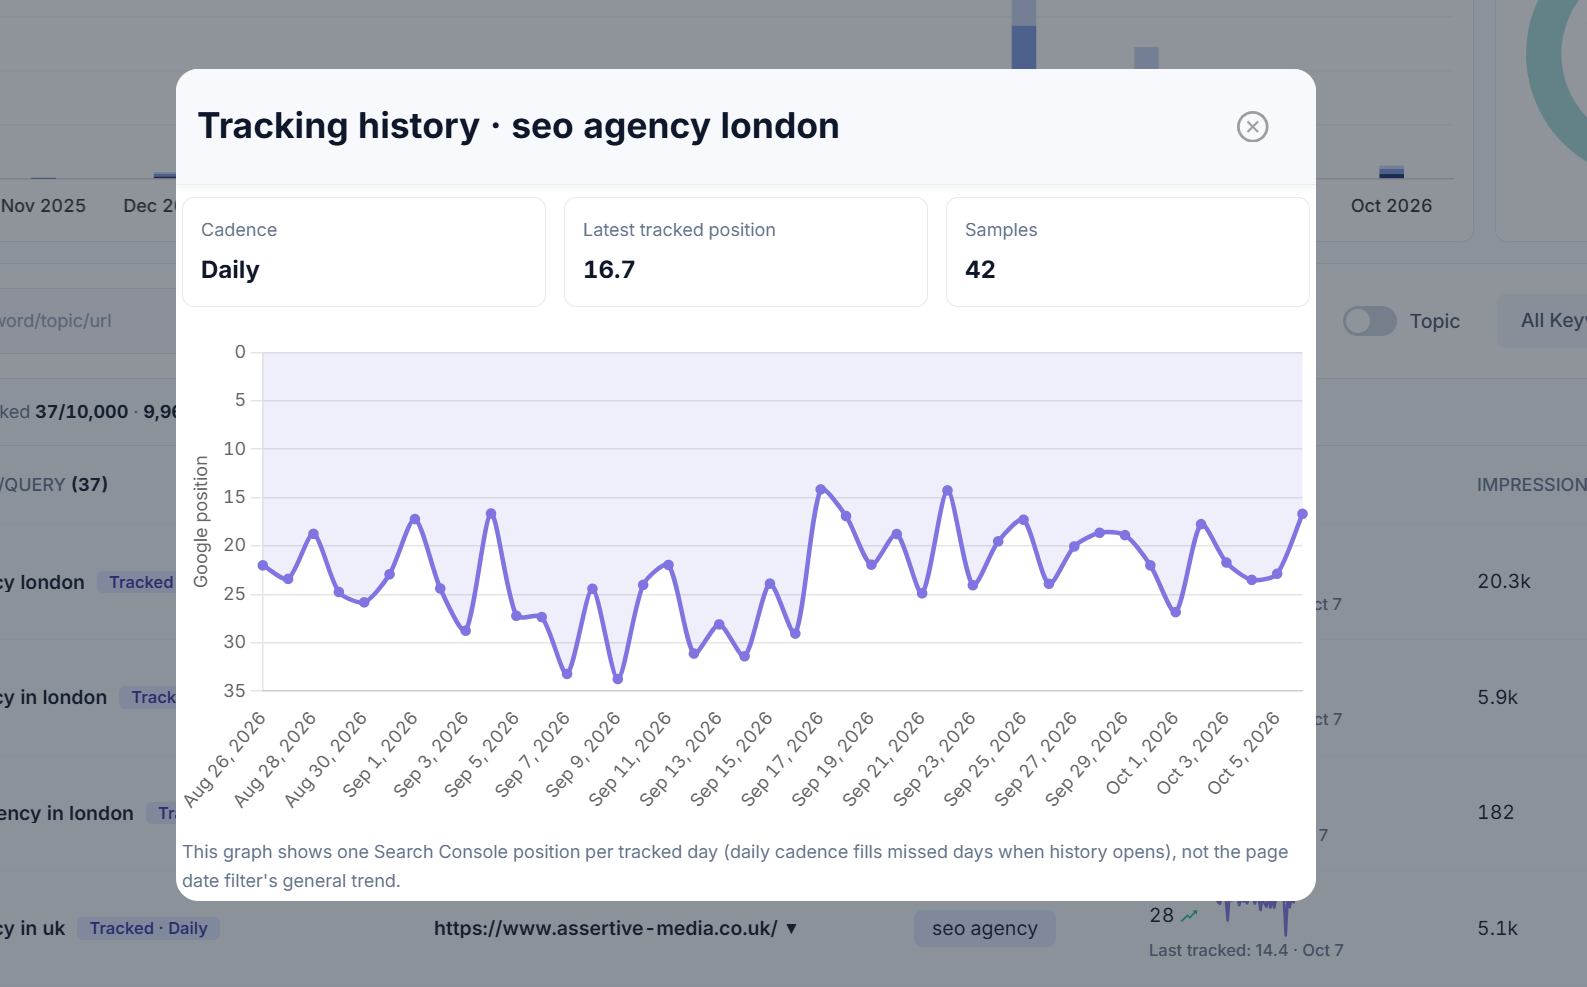
Conserviamo lo storico giornaliero e ti permettiamo di segmentarlo in base alle dimensioni disponibili in Search Console. L'API Search Analytics supporta le dimensioni data, query, pagina, paese e dispositivo, oltre ai filtri per tali dimensioni. La documentazione dell'API di Google spiega come funziona.
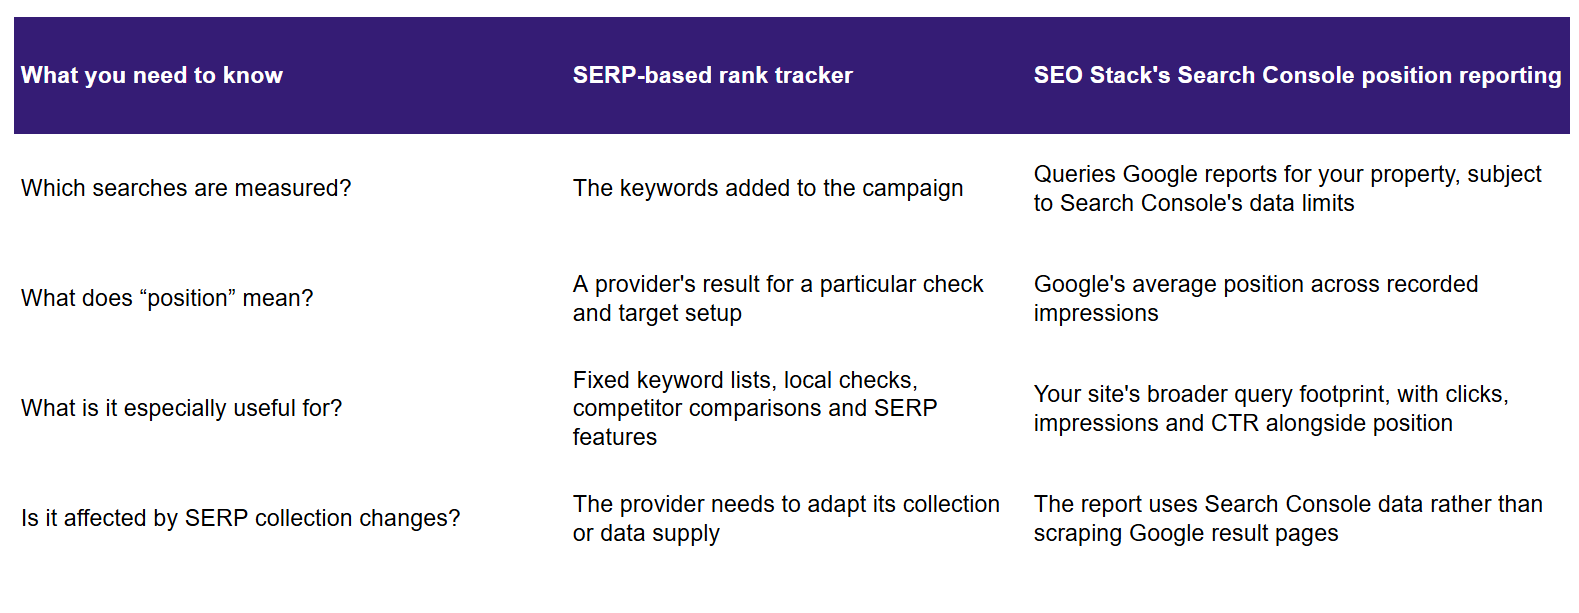
Come SEO Stack evita la dipendenza dallo scraping
SEO Stack è costruito attorno ai dati di Search Console che Google registra già per una proprietà collegata. Pre-filtriamo semplicemente quei dati alla fonte, poi usiamo le righe corrispondenti di query, pagina, data, paese e dispositivo per costruire una vista di reporting ripetibile. Significa che non stiamo cercando di riscoprire le posizioni del tuo sito raccogliendo ripetutamente le pagine dei risultati di Google.
Il vantaggio pratico è l'ampiezza: non devi decidere in anticipo che solo 100 termini meritano un posto nel report. Puoi partire dalle query per cui Google ha mostrato il tuo sito, vedere come cambiano posizioni e impression, e poi creare un gruppo di keyword monitorate più ristretto per i termini che contano a livello commerciale.
Puoi creare i tuoi gruppi di topic/keyword, ad esempio per keyword ad alta conversione, keyword di alto valore per il cliente ecc., e puoi ordinare per metrica, cioè impression o clic >
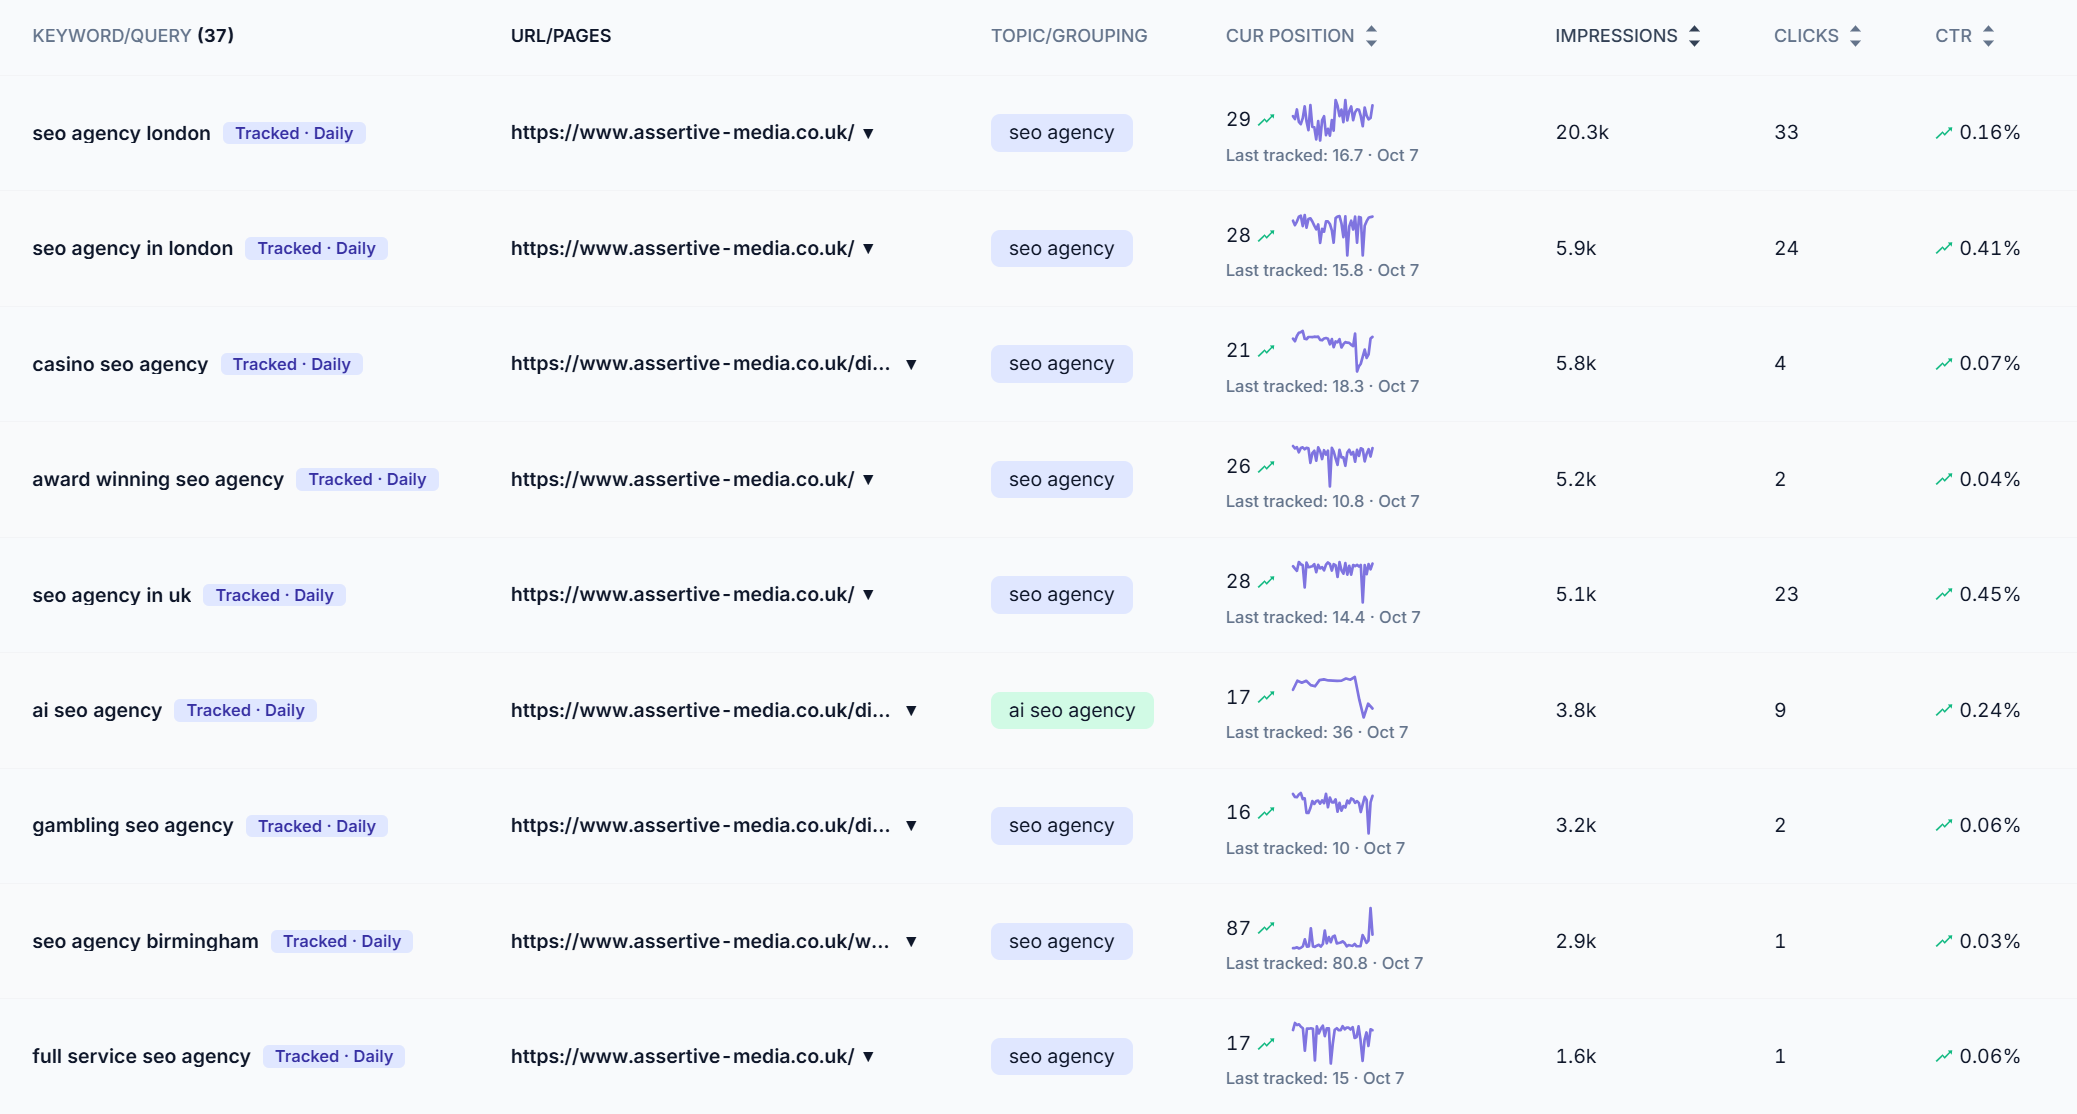
SEO Stack supporta una lista di keyword monitorate costruita di proposito come watchlist mirata, accanto ai dati più ampi delle query di Search Console. Fonte immagine: SEO Stack Rank Tracking.
Poiché SEO Stack non fa scraping delle SERP di Google per produrre questa serie di posizioni, il parametro &num=100 e i link /goto non determinano se i dati di Search Console del sito possano essere riportati. Possiamo continuare a presentare lo storico giornaliero delle posizioni fornito da Google senza recuperare dieci pagine di risultati per ogni keyword o risolvere prima ogni link dei risultati.
La posizione giornaliera non indica un unico ranking live esatto, identico per ogni persona. È la media di Google per le impression che registra quel giorno. Località, dispositivo, layout dei risultati e mix di ricerche possono influenzare la media, quindi il confronto utile è il trend, interpretato insieme a impression, clic e landing page della query.
Anche una fonte di dati first-party ha dei limiti
Search Console non è un registro illimitato e perfetto di ogni ricerca: Google esclude le query anonimizzate dalle tabelle delle query per motivi di privacy, e la sua API Search Analytics specifica che non garantisce la restituzione di ogni riga di dati. L'API consente fino a 25.000 righe per richiesta e supporta la paginazione, ma filtrare e archiviare i dati non può recuperare i termini che Google trattiene. Google documenta questi limiti.
Tuttavia, poiché SEO Stack è un data warehouse per i tuoi dati GSC, non siamo vincolati dalle limitazioni delle API né dagli altri limiti che gli altri rank tracker devono affrontare: disponiamo di dati puri che possono essere filtrati e ordinati rapidamente per fornire insight accurati sul posizionamento.
C'è anche una specifica questione storica da considerare: Google afferma che un errore di logging ha impedito la rilevazione accurata delle impression dal 13 maggio 2025 al 27 aprile 2026. Impression, CTR e posizione media sono stati interessati, mentre i clic no. Se stai confrontando l'andamento delle posizioni in quel periodo, annotalo ed evita di interpretare ogni movimento come un cambiamento nelle performance SEO. La pagina delle anomalie dei dati di Search Console di Google documenta il problema.
Questo è il limite reale: SEO Stack può sfruttare meglio i dati di prima parte che Google espone, conservare lo storico giornaliero e mostrare un insieme di query molto più ampio rispetto a una piccola lista manuale di keyword. Non può rendere visibili le ricerche anonimizzate né correggere un errore di reporting nei dati di origine di Google.
Usa entrambe le prospettive per la domanda a cui ciascuna può rispondere
Un rank tracker focalizzato ha ancora senso quando ti serve un controllo locale controllato, le posizioni dei competitor o il monitoraggio delle SERP feature. Per il tuo sito, una visione basata su Search Console risponde a una domanda più ampia: quali keyword del tuo sito hanno effettivamente prodotto una visibilità significativa, come si è mossa la posizione media delle keyword e quel movimento ha generato impression e clic?
Per questo il rank tracking di SEO Stack è costruito sui tuoi dati GSC: l'obiettivo non è far sparire una watchlist da 100 keyword, ma evitare di scambiare quella watchlist per il quadro completo e fornirti una serie di posizioni giornaliera, di prima parte, che non dipende dall'ultimo modo in cui Google restituisce una pagina di risultati sottoposta a scraping.
Come i rank tracker più diffusi confezionano il loro tracking
Se stai confrontando gli strumenti, guarda oltre il numero di keyword pubblicizzato. Verifica con quale frequenza le posizioni si aggiornano, se il limite è condiviso tra i progetti, come ciascuno strumento conteggia le località e fino a che profondità riporta i risultati di Google. I prezzi riportati di seguito sono prezzi di listino in USD verificati il 7 ottobre 2026; fatturazione annuale, imposte e prezzi regionali possono modificare l'importo che paghi.
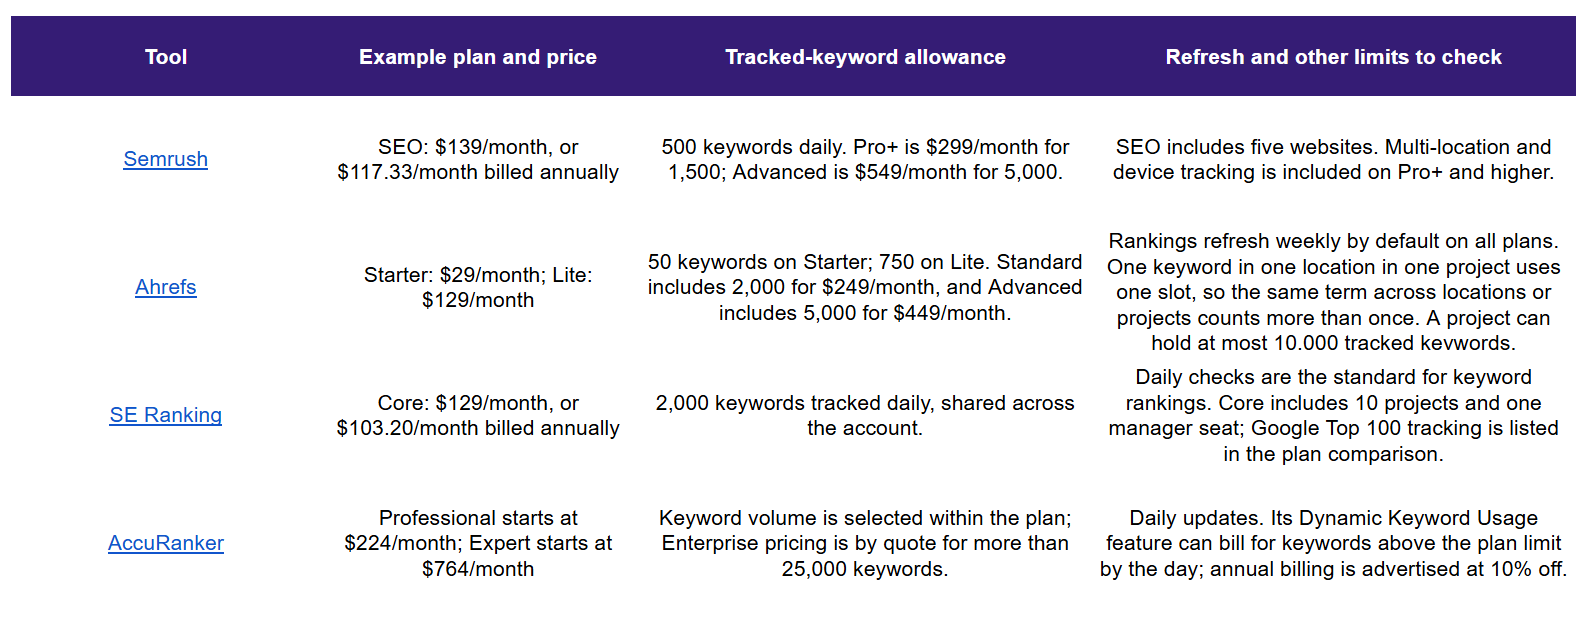
Sono tutti utili per monitorare un insieme definito di keyword, ma i limiti non sono direttamente intercambiabili: una keyword tracciata in due posti, dispositivi o progetti può consumare più volumi allocati, e la frequenza di aggiornamento va da giornaliera a settimanale. Anche il piano standard più ampio traccia comunque una lista di keyword scelte, non ogni query che porta impression a un sito.
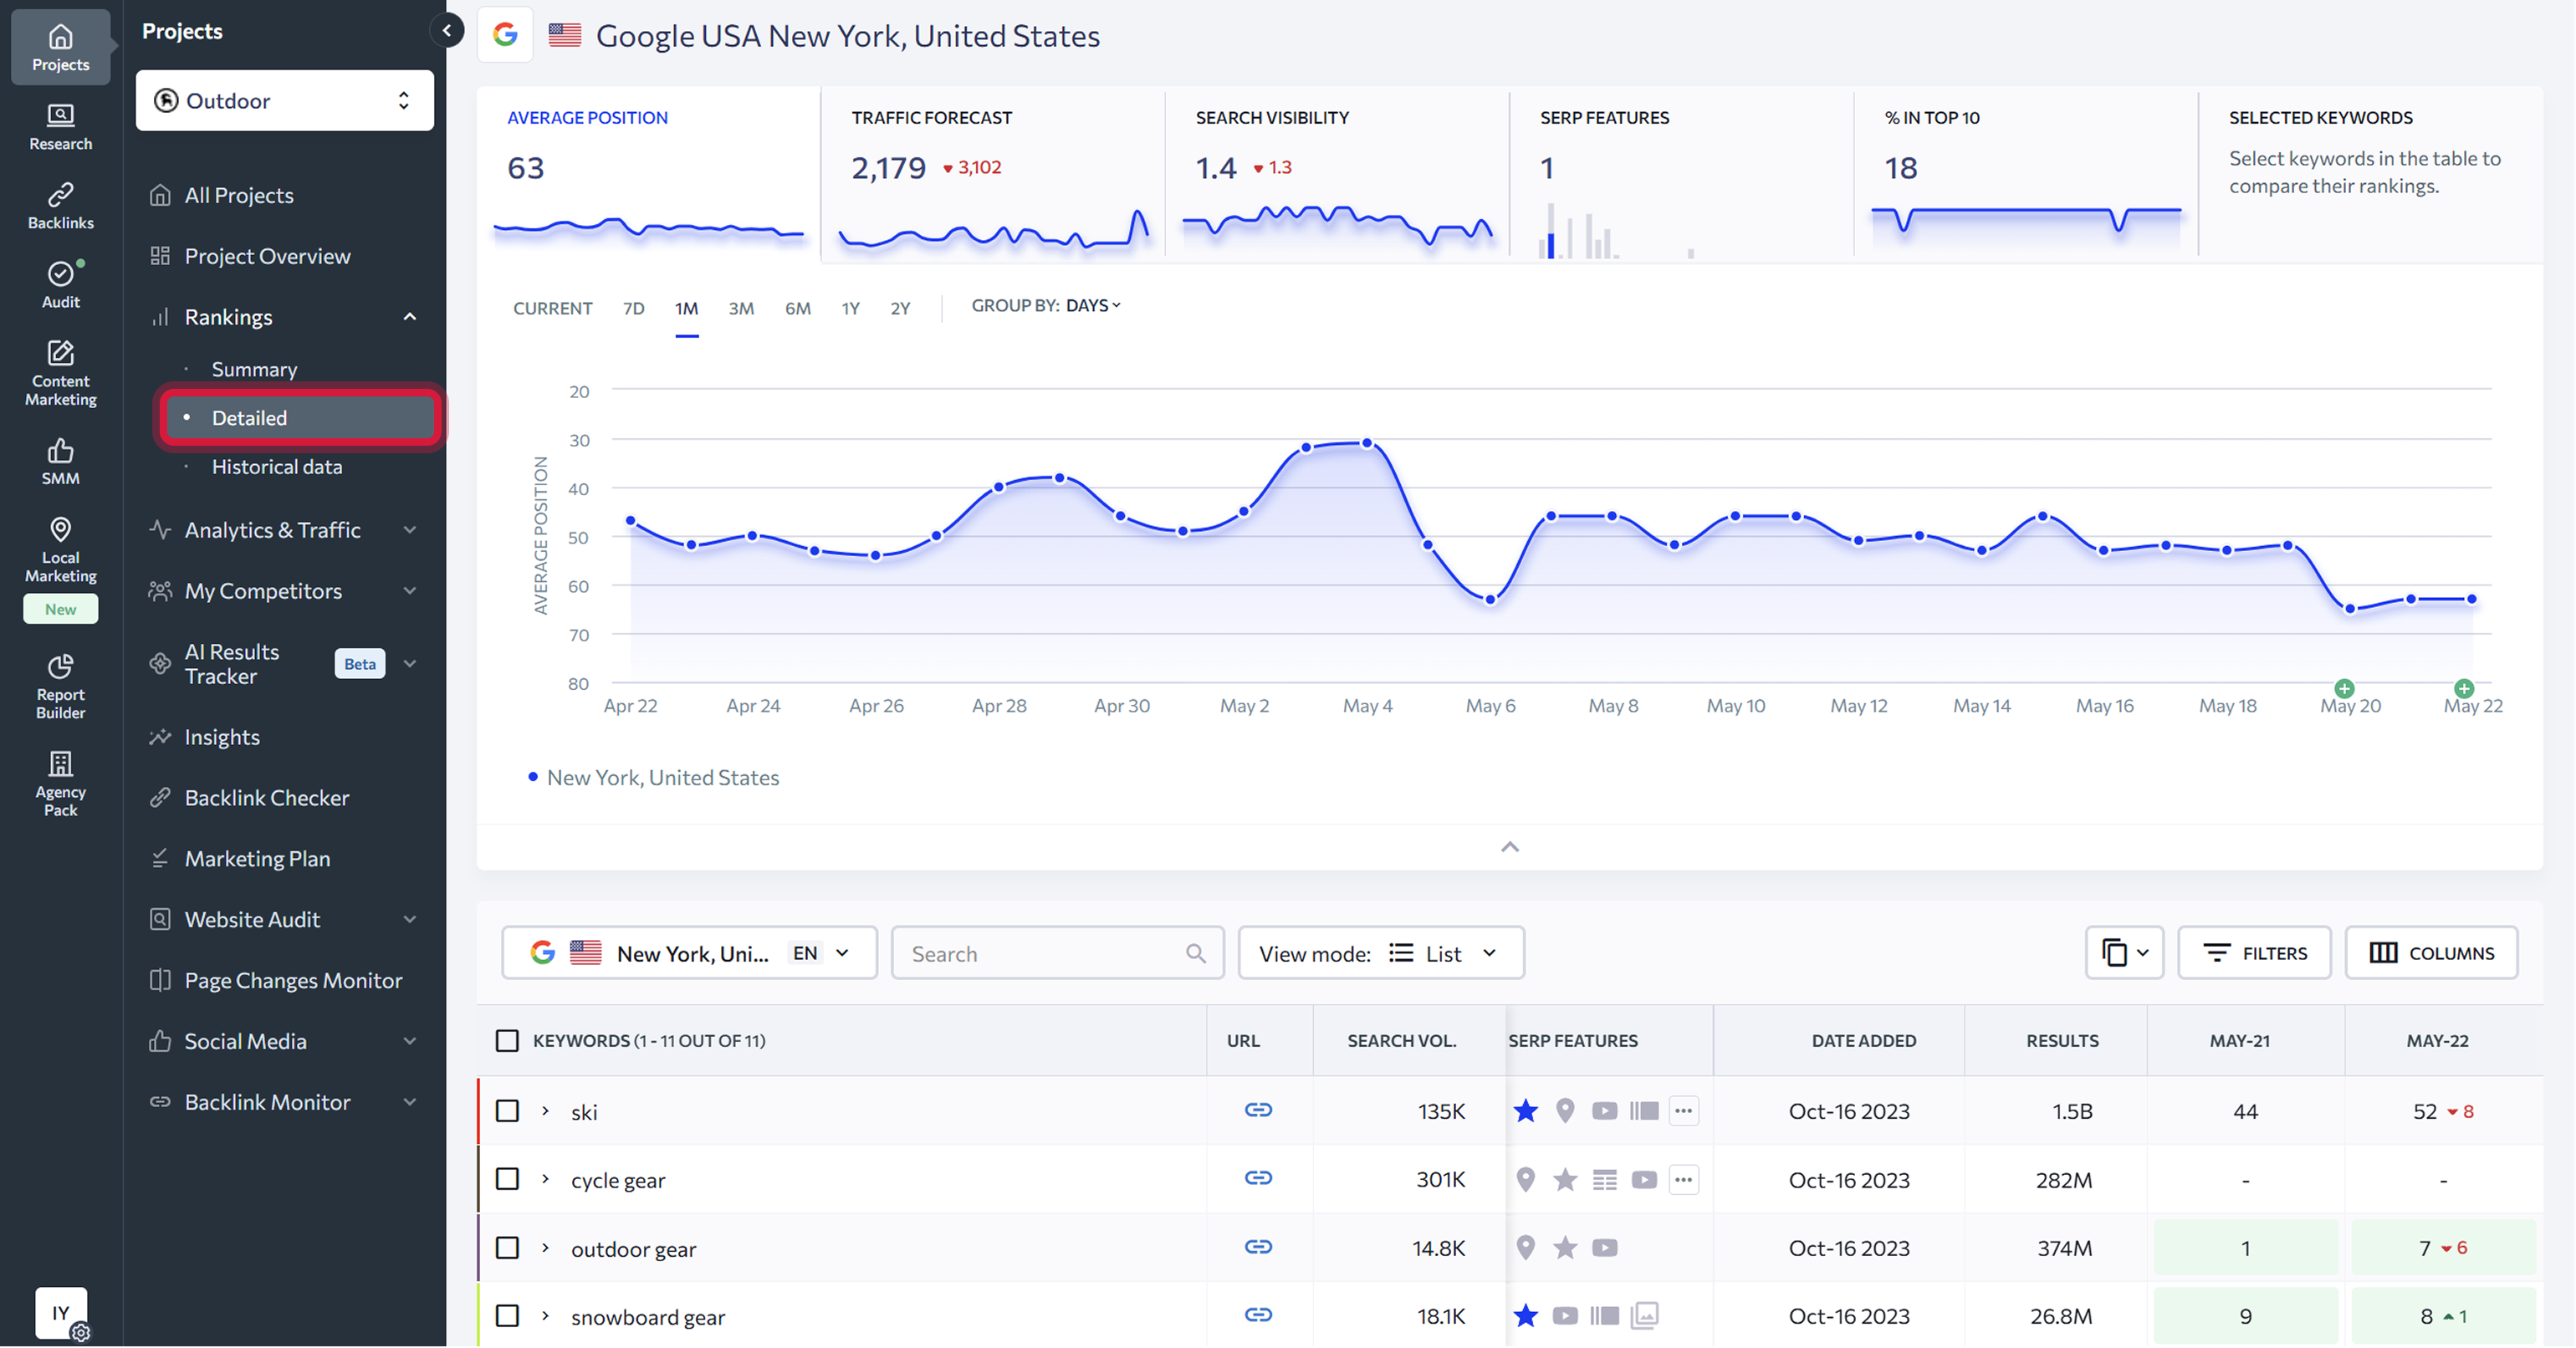
Il modulo Rankings di SE Ranking mostra lo storico delle posizioni per le keyword configurate. Fonte screenshot: SE Ranking Help Centre.
La differenza sta nel modello dei dati: ad esempio un SERP tracker verifica termini selezionati in una configurazione controllata, mentre SEO Stack riporta la posizione media che Google ha registrato per la tua proprietà, query per query, insieme a impression, clic e CTR.
Conserviamo lo storico giornaliero e ti permettiamo di segmentarlo in base alle dimensioni disponibili in Search Console. La Search Analytics API supporta le dimensioni data, query, pagina, paese e dispositivo, oltre ai filtri per tali dimensioni. La documentazione API di Google spiega come funziona.
Perché Google insiste tanto nel bloccare gli scraper?
Google ha pubblicato una motivazione piuttosto diretta: classifica le ricerche automatizzate come traffico generato da macchine, includendo esplicitamente lo scraping dei risultati per verificare i posizionamenti, e afferma che questa attività consuma risorse e interferisce con la sua capacità di servire gli utenti (ma sappiamo che in realtà è solo un modo elegante per dire: non vogliamo che altri strumenti traggano profitto dai nostri dati). #
La pagina di supporto di Google cita anche gli scraper di ricerca e il software che invia ricerche a Google per scoprire dove si posiziona un sito; quando Google rileva traffico insolito, può interrompere l'accesso con un reCAPTCHA. In altre parole, richieste automatizzate ripetute appaiono molto diverse da una persona che cerca occasionalmente, e Google tratta quel volume come una questione di abuso del servizio e di disponibilità. (Le Spam Policies di Google; le indicazioni di Google sul traffico insolito)
Questo non dimostra che ogni modifica alle pagine dei risultati o agli URL di Google sia stata introdotta specificamente per colpire gli strumenti SEO, ma la conclusione viene facile. Google non ha dichiarato che il comportamento di &num=100 o i link /goto fossero una campagna contro i rank tracker (ma per quale altro motivo lo avrebbero fatto? soprattutto dopo il caso SERPAPI). Io li descriverei come modifiche che rendono la raccolta automatizzata meno prevedibile, tenendo però distinta la motivazione dichiarata da Google: Google afferma che il controllo automatizzato dei posizionamenti su larga scala consuma risorse e interferisce con Search.
A Google importa dei rank tracker?
Sì, quando si parla di come raccolgono i dati: Google include esplicitamente lo scraping dei risultati di ricerca per il controllo dei posizionamenti nella sua policy sul traffico generato da macchine e afferma che l'accesso automatizzato senza esplicita autorizzazione viola le sue spam policy e i Termini di Servizio.
La sua pagina di supporto su Search è altrettanto specifica: il software che invia ricerche a Google per scoprire come si posiziona un sito è una delle attività che considera traffico automatizzato. (Google Search Central; Google Search Help) Però, per molto tempo, pur essendo presentata come una pratica non consentita da Google, la maggior parte dei rank tracker ha avuto vita facile.
La distinzione conta perché la formulazione di Google riguarda le query automatizzate inviate a Google: non dice che un sito aziendale venga penalizzato semplicemente perché il proprietario usa un rank tracker — e, come è prevedibile, chi lavora nella SEO vorrà monitorare i posizionamenti.
Personalmente, non trasformerei quella policy in un'affermazione su una penalizzazione del posizionamento di un sito. Google, però, avverte che gli strumenti di terze parti non hanno accesso ai suoi dati di ranking interni e raccomanda Search Console per le informazioni di prima parte su un sito collegato.
Questo rende utile verificare la fonte e il metodo dietro un report di posizionamento, soprattutto quando il report viene presentato come una visione definitiva di ciò che vede ogni utente. (Le indicazioni di Google sugli strumenti SEO di terze parti)
Come si stanno adattando le aziende di rank tracking?
L'intero processo di raccolta è solitamente proprietario, quindi sarei cauto nell'affermare che tutti i tracker usino lo stesso espediente: ogni piattaforma di rank tracking avrà il proprio approccio tecnico per superare questi ostacoli.
Alcune aziende gestiscono processi di raccolta SERP propri, mentre altre si affidano a fornitori di dati esterni. Ahrefs ha dichiarato che la modifica di &num=100 ha interessato sia il proprio monitoraggio sia i fornitori di dati di terze parti, riducendo la profondità verificabile oltre la prima pagina di Google.
Questo indica il lavoro pratico necessario, che consiste nell'adattare la richiesta e la pipeline dei dati, verificare quale profondità resti disponibile e modificare il modo in cui i risultati provenienti da più pagine o fornitori vengono assemblati. (L'aggiornamento di Ahrefs sul monitoraggio delle SERP)
La modifica /goto è tanto un problema di parsing quanto di raccolta: se un risultato punta prima a un URL di passthrough di Google (un redirect, in parole povere), lo strumento o la piattaforma deve identificare e risolvere la destinazione prima di poter riportare in modo affidabile l'URL posizionato. DataForSEO ha dichiarato di aver aggiunto un resolver per i nuovi URL di Google e ha riportato che il 99,99% delle SERP organiche restituite tramite la sua API presentava URL di destinazione diretti al momento dell'aggiornamento. Si tratta della copertura dichiarata da DataForSEO, non di un dato applicabile a ogni fornitore. (L'aggiornamento di DataForSEO su /goto)
Questo continuo adeguamento spiega perché gli “aggiornamenti giornalieri” vanno intesi come la frequenza di controllo pianificata da uno specifico fornitore di dati di ranking, non come la garanzia che ogni keyword restituisca sempre una SERP completa e identica - qualcosa con cui i rank tracker hanno dovuto fare i conti oltre ad altri fattori, ad esempio personalizzazione, localizzazione ecc.
Le modifiche all'accesso o al markup dei risultati possono comportare lavoro di raccolta aggiuntivo, profondità discontinua o ritardi mentre i fornitori si adattano - e probabilmente generano costi maggiori che erodono i margini dei rank tracker.
Nelle campagne SEO i rank tracker restano ovviamente utili per verifiche e monitoraggi su keyword, località e competitor specifici; per le performance delle query osservate sul proprio sito, SEO Stack utilizza i dati di Search Console e non deve fare scraping delle pagine dei risultati di Google per produrre quello storico di posizionamento.

Fondatore, SEO Stack
Daniel è il fondatore di SEO Stack. Ha trascorso oltre due decenni lavorando su SEO tecnica e dati di ricerca, e ha creato SEO Stack dopo essersi scontrato, una volta di troppo, con i soliti limiti di Search Console nel lavoro con i clienti.
Daniel ha una vasta esperienza in ambito SEO: ha costruito agenzie SEO, attività di audit e una consulenza di grande successo. Nel tempo libero, si diverte a condurre esperimenti SEO e a condividerne i risultati.
Pubblicato 7 ottobre 2026


