Google está dificultando el seguimiento de posiciones, ¿qué soluciones de rank tracking existen?
El seguimiento de posiciones sigue siendo una de las primeras cosas por las que me preguntan los clientes. Es fácil de entender, sencillo de representar en gráficos y útil para ver si los términos de búsqueda importantes se están moviendo. El problema es
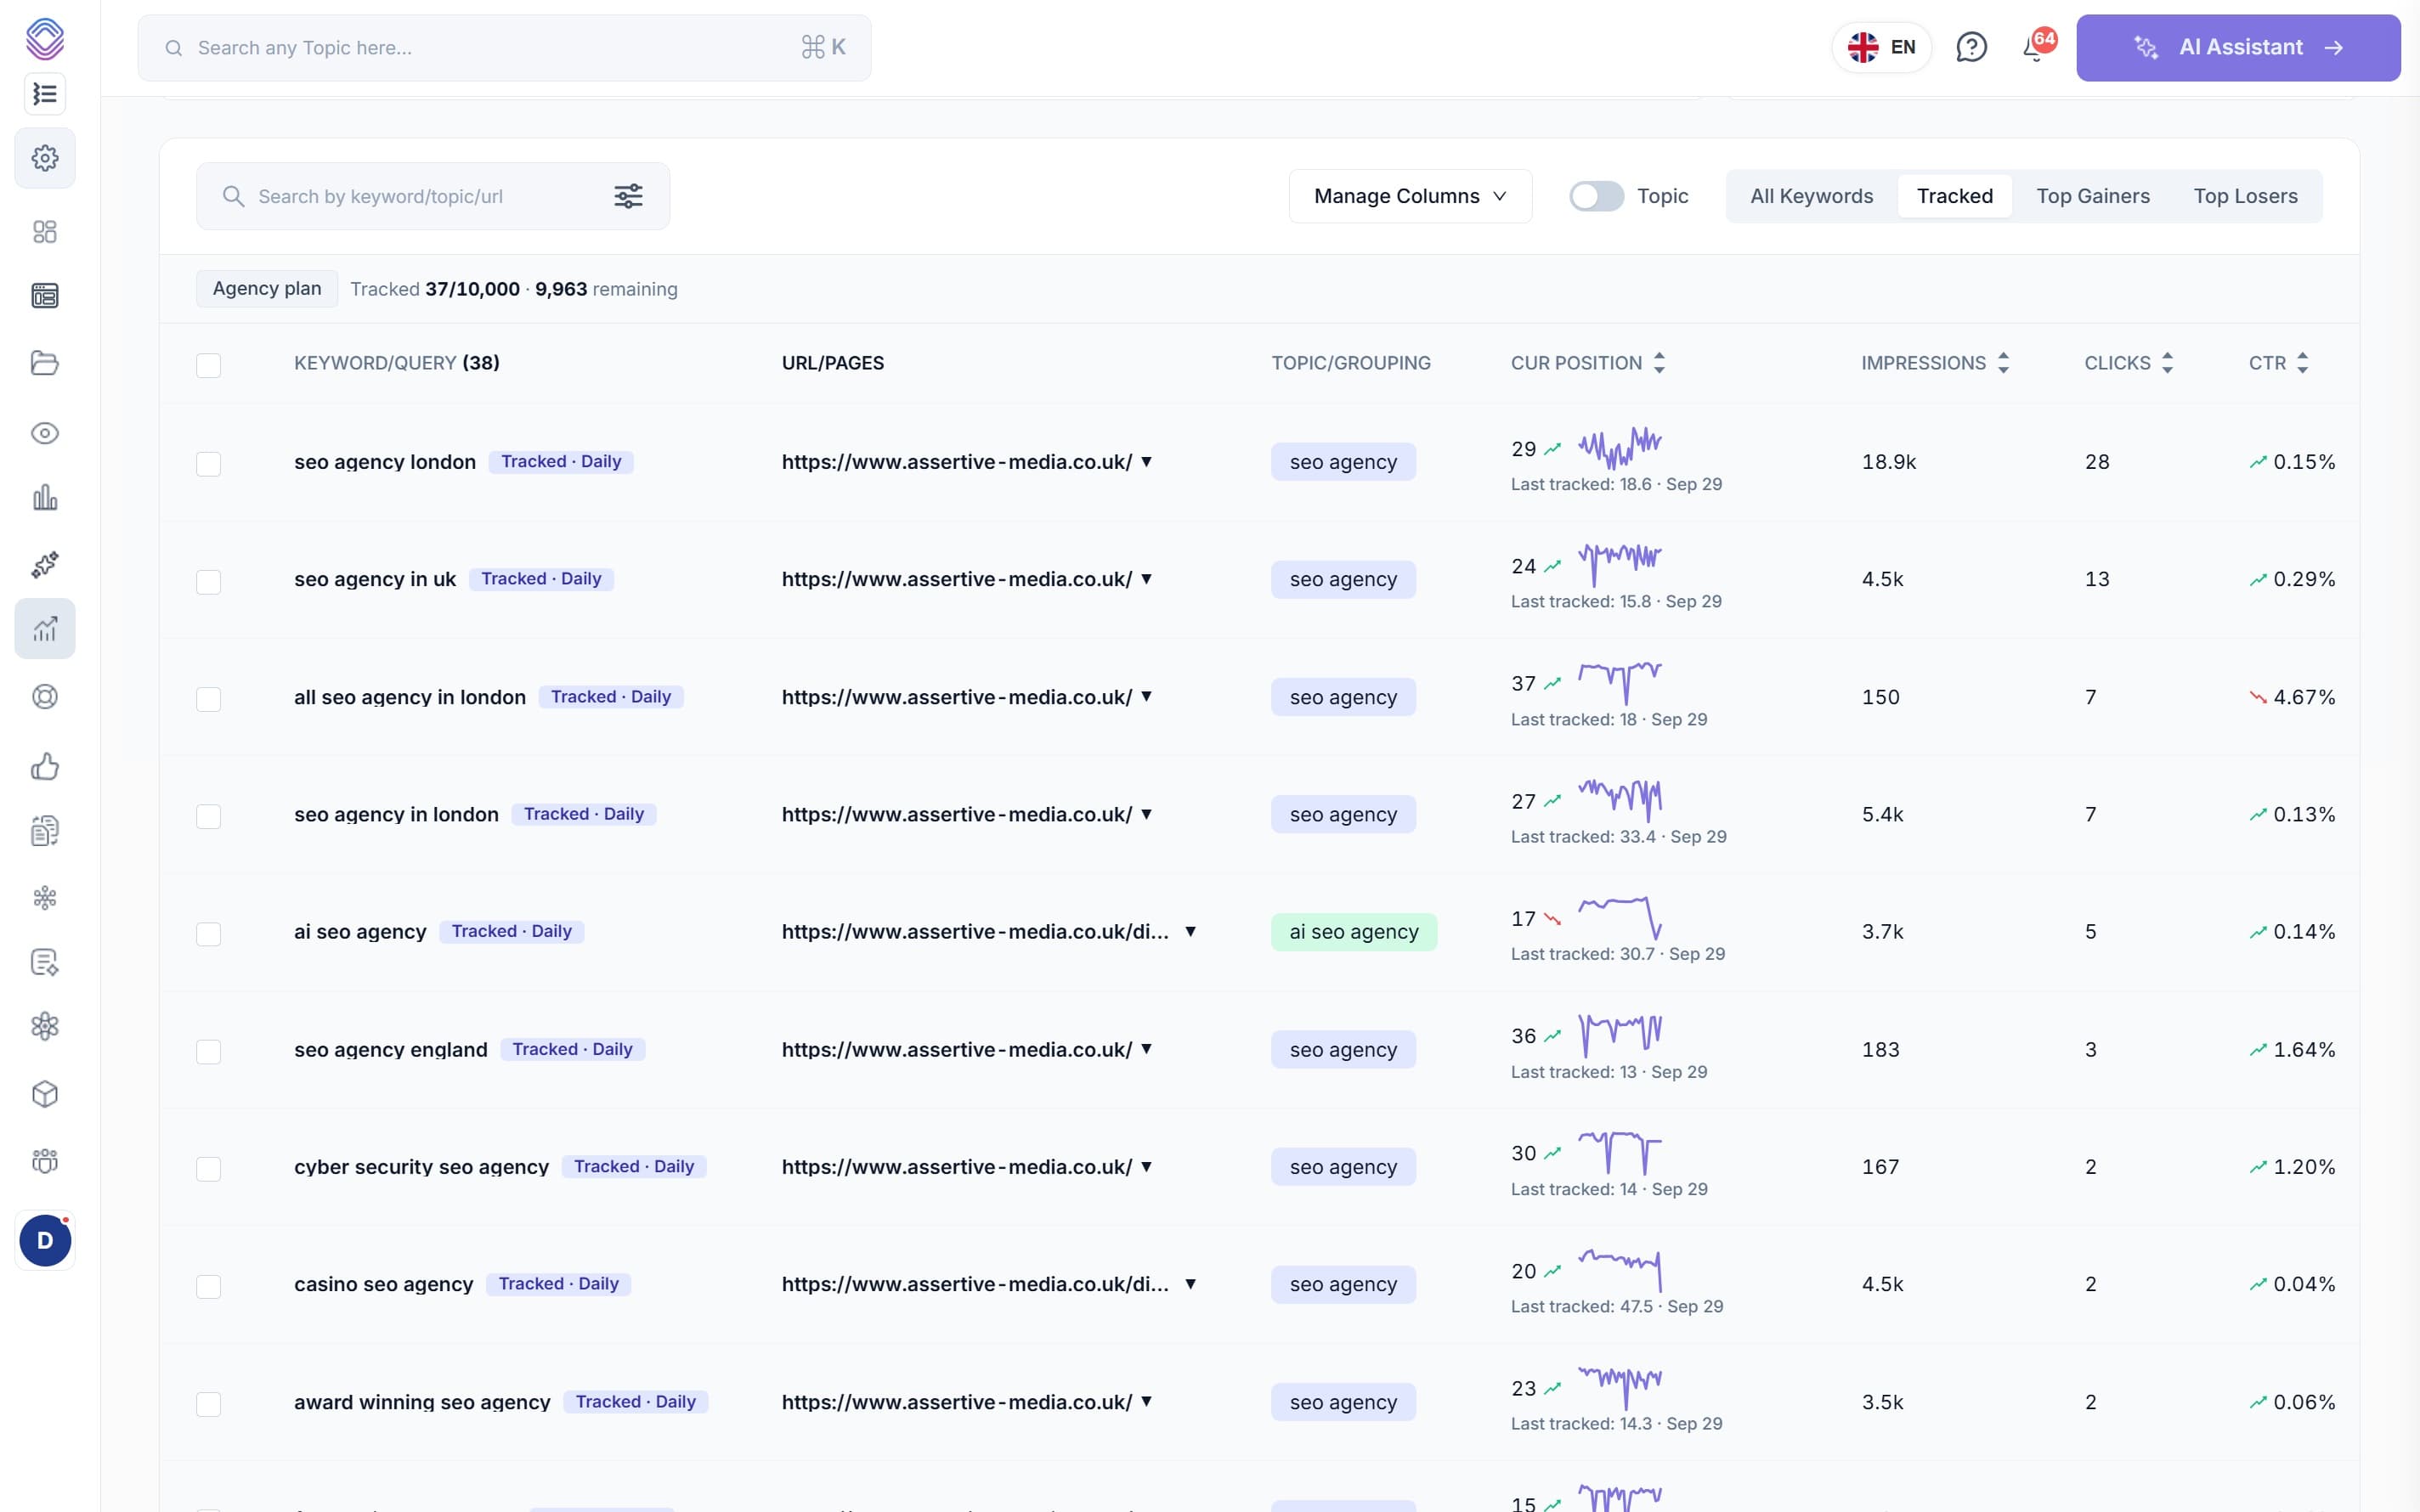
El seguimiento de posiciones sigue siendo una de las primeras cosas por las que me preguntan los clientes. Es fácil de entender, sencillo de graficar y útil para ver si los términos de búsqueda importantes se están moviendo. El problema empieza cuando tratamos una lista pequeña y preseleccionada de keywords como si representara todo el rendimiento orgánico de un sitio web.
Este ha sido un problema recurrente con los informes de posicionamiento en general: se utiliza un número reducido de las consultas totales por las que se muestra un sitio web para medir el rendimiento y eso es, bueno, una falacia en sí misma.
PERO el seguimiento de posiciones sí tiene valor, porque es uno de los muchos indicadores dentro del SEO que pueden ayudar a un cliente a entender el progreso y la trayectoria, y es una de las razones por las que incorporamos el seguimiento de posiciones en SEO Stack, porque los SEOs, freelancers y agencias siguen reportando a sus clientes con informes de posicionamiento.
La mayoría de los informes de posicionamiento y rank trackers suelen hacer seguimiento de entre 50 y 100 keywords, algunos de hasta 500-1000 keywords, pero más allá de eso puede convertirse en un quebradero de cabeza para los clientes; la mayoría de ellos tendrán la atención puesta en un puñado de sus keywords más valiosas, no van a querer necesariamente mirar 1000 keywords.
Así que imagina que tu sitio web se muestra para miles de keywords: hacer seguimiento y centrarse en 50-100 keywords NO es un buen indicador de progreso. Imagina a un cliente frustrado porque sus posiciones en, digamos, 20 de sus keywords monitorizadas han bajado mientras el sitio/dominio en conjunto empezaba a mostrarse para cientos o miles de keywords nuevas.
Dicho esto, el seguimiento de posiciones SIGUE siendo importante y muchos SEOs continúan midiendo posiciones y reportándolas a sus clientes, normalmente en informes semanales o mensuales. Pero no es raro que los sitios web tengan miles de keywords por las que se muestran, así que siempre merece la pena tenerlo presente con los clientes y explicarles que la evaluación del rendimiento puede incluir tanto los informes de posicionamiento como el volumen total de keywords por las que se muestra un dominio. Por ejemplo, uno de los clientes de nuestras agencias hace seguimiento de 500 keywords en SEO Stack, ¡pero su dominio se muestra para más de 879.000 keywords!
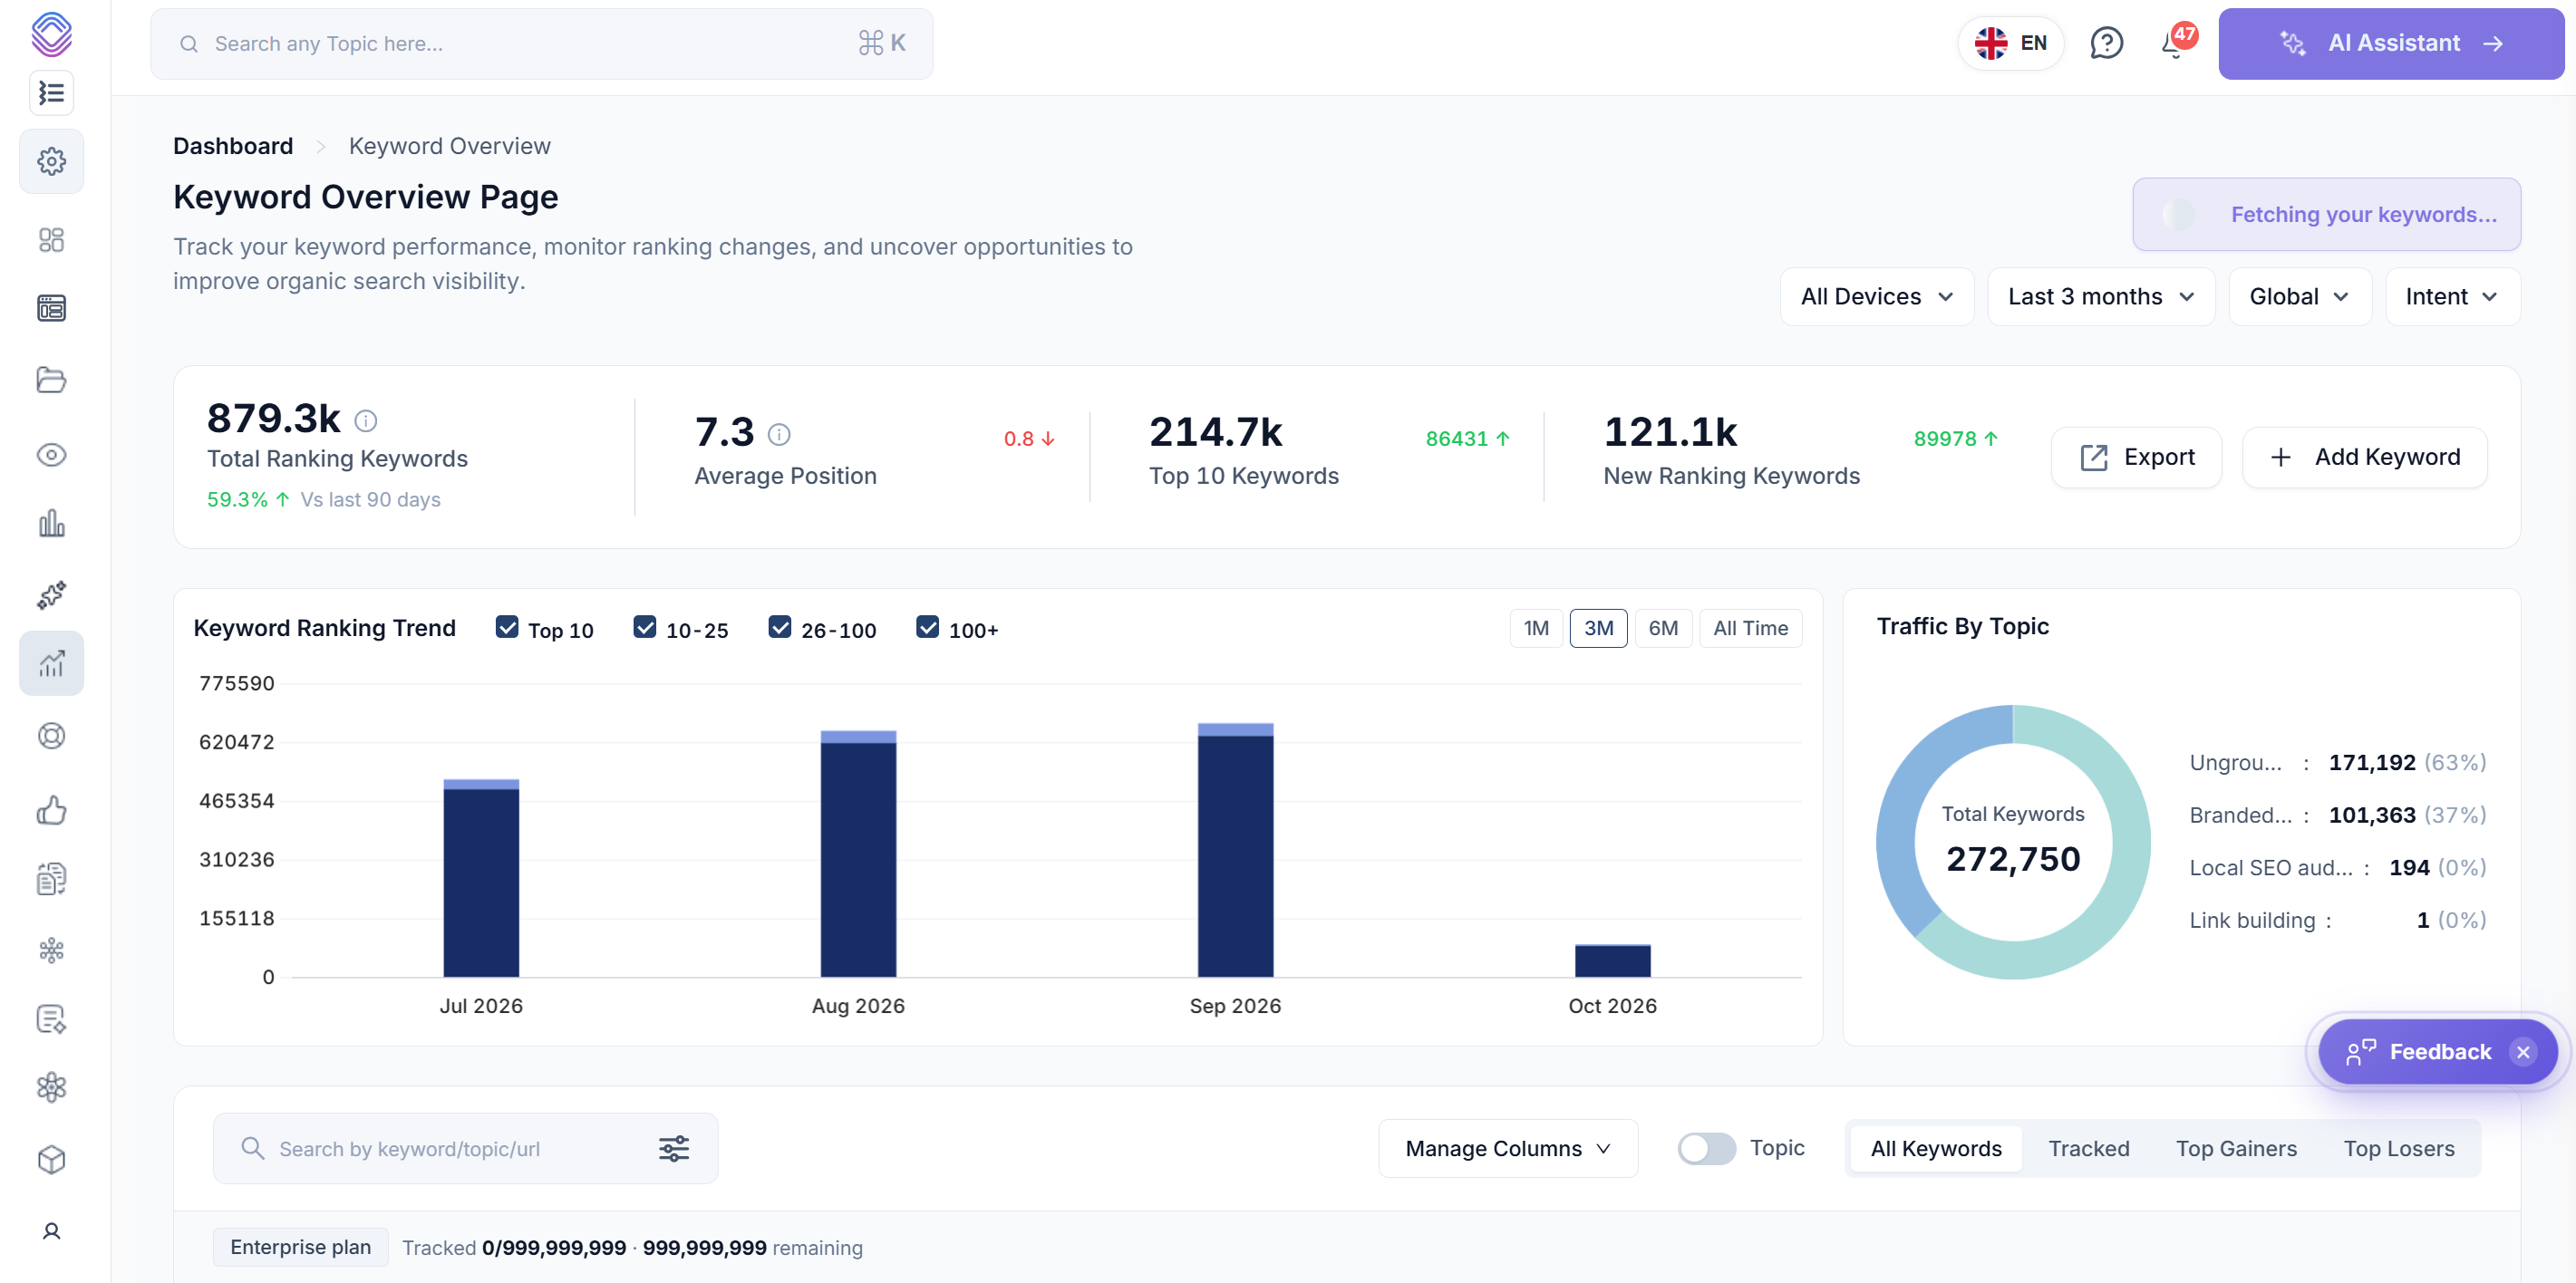
Incluso los sitios web pequeños pueden mostrarse para miles de keywords, así que merece la pena tenerlo en cuenta. Normalmente diríamos que el seguimiento de posiciones y los informes de posicionamiento pueden usarse para consultas de mayor valor, quizá las consultas más asociadas a ventas o conversiones.
Incluso los sitios pequeños pueden tener una gran huella de keywords servidas:
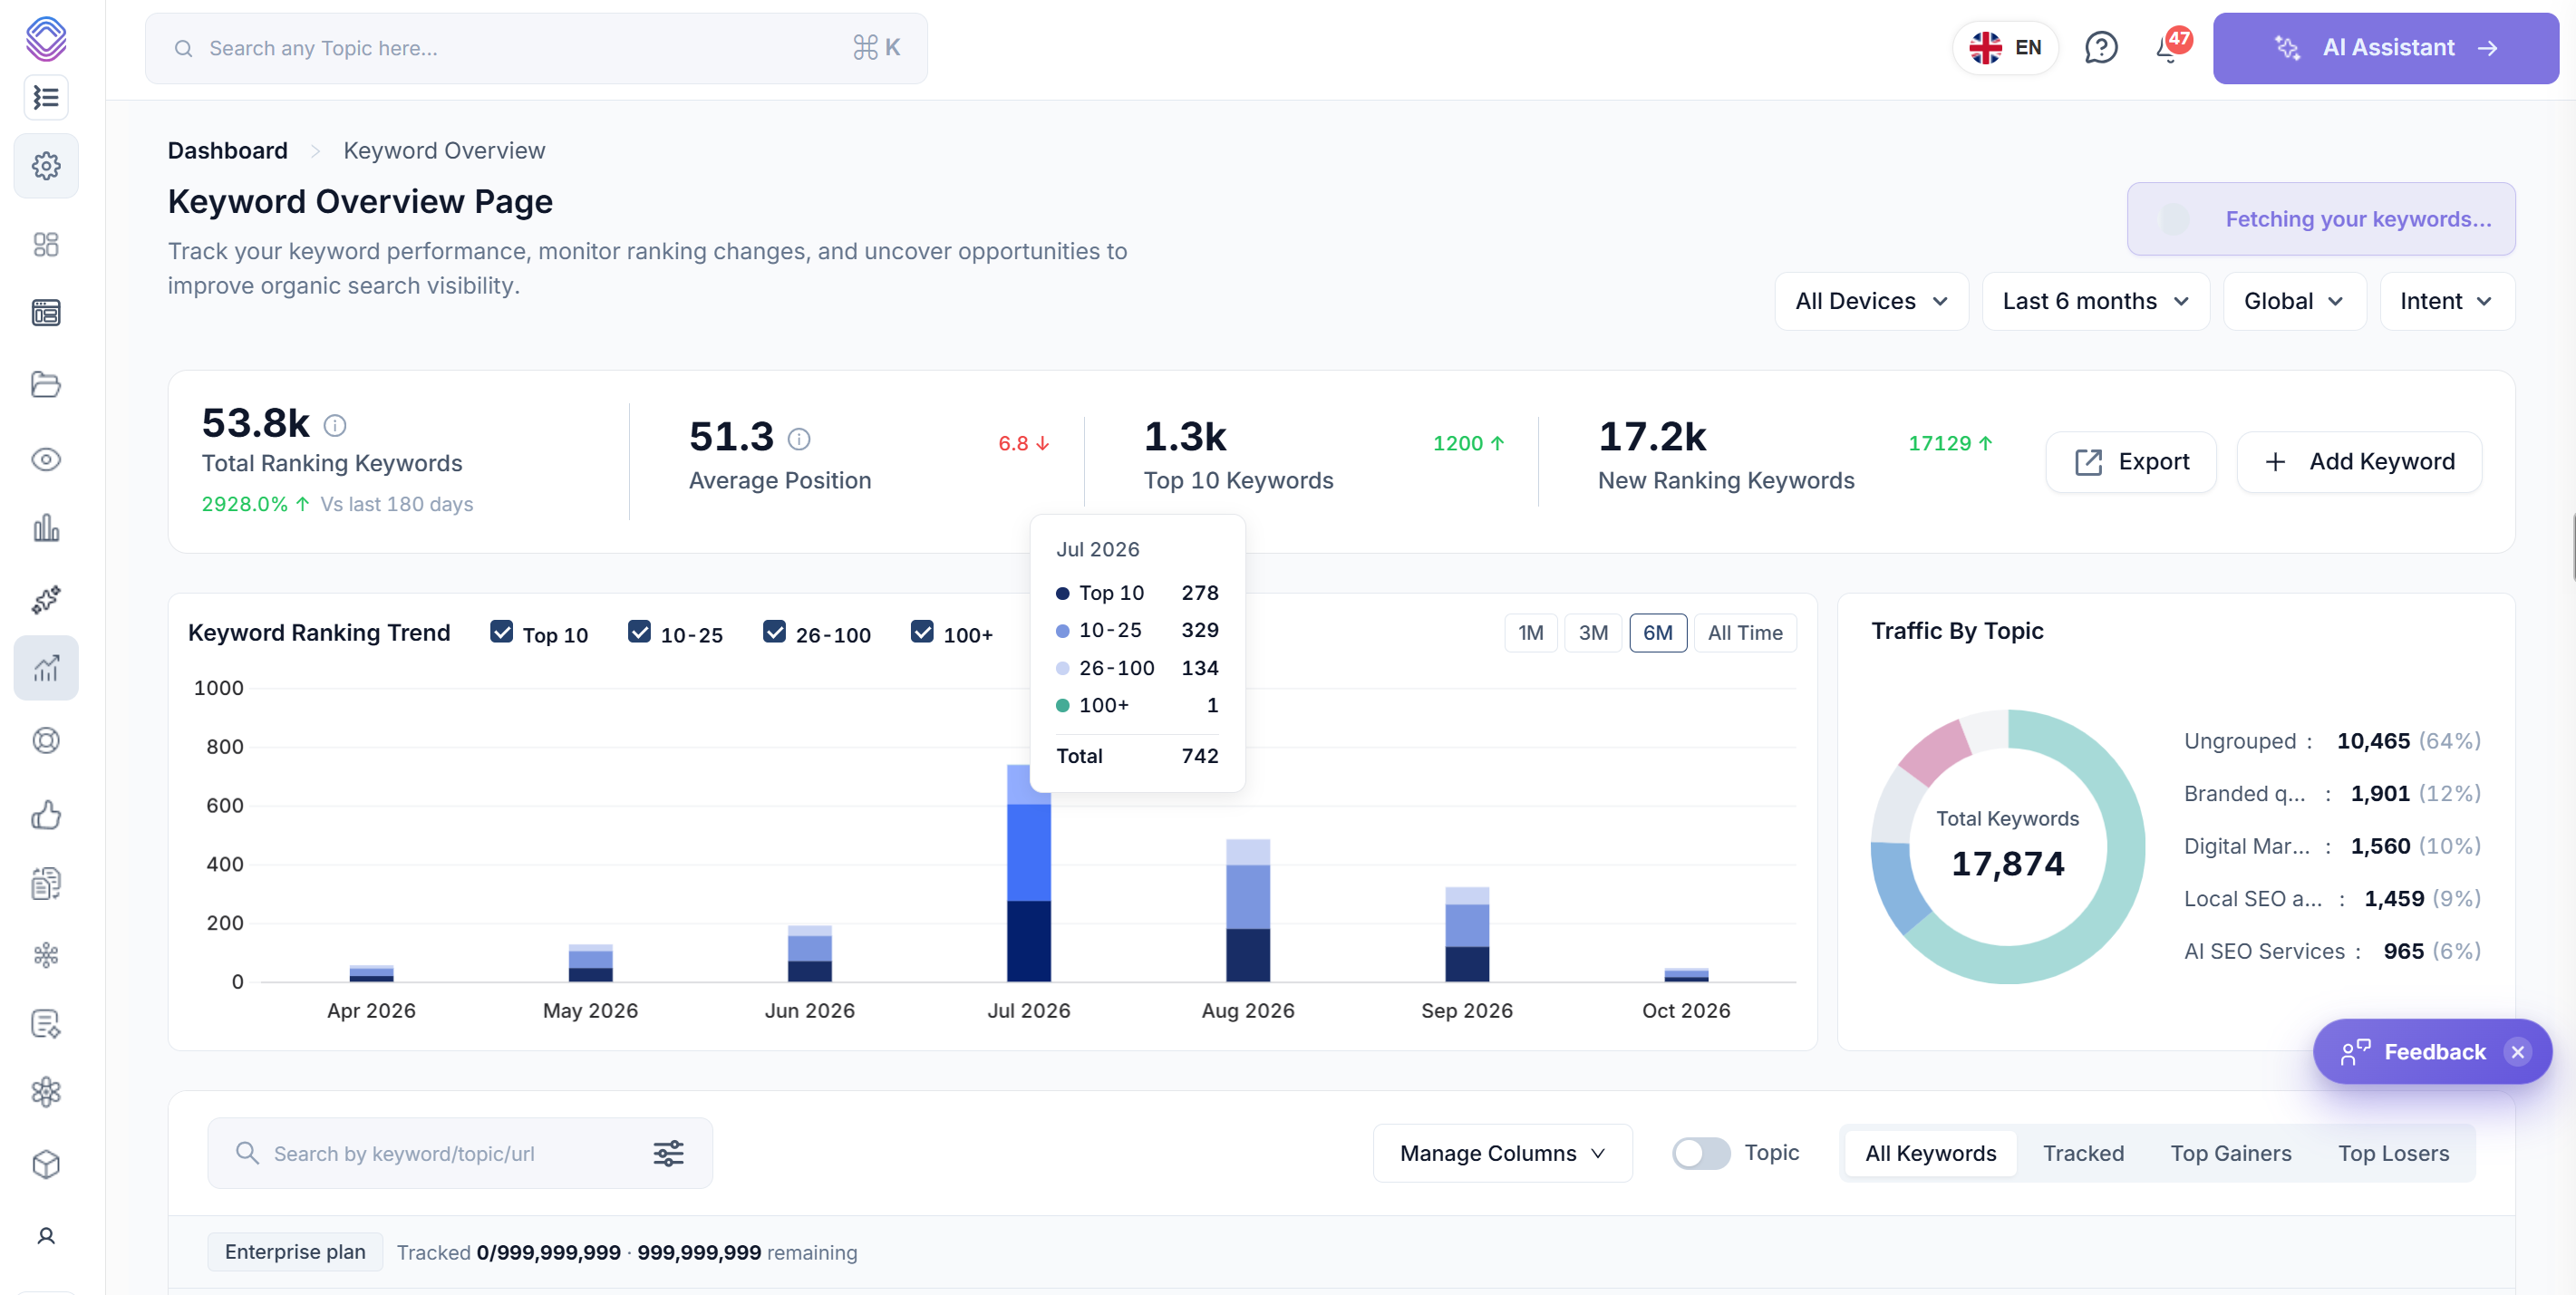
Así que imagina que tu seguimiento de posiciones solo informa sobre, digamos, el 1% de todas las consultas servidas: no querrás que tus clientes se obsesionen con depender únicamente del rank tracking.
Ahora, volviendo a los informes de posicionamiento, en resumen un informe de posicionamiento:
Un informe de posicionamiento responde a la pregunta general de un cliente: ¿dónde encontró esta herramienta de seguimiento una página para estas keywords/consultas seleccionadas, en este lugar, en este dispositivo y en este momento?
Esa información es útil, pero no es lo mismo que saber todas las consultas por las que Google está mostrando tu sitio, ni cómo está cambiando tu rendimiento en búsqueda orgánica en conjunto. Por eso decimos que tus 2 entregables clave deberían centrarse en:
Informes de posicionamiento donde las keywords monitorizadas sean de mayor valor
Visión general de keywords, para poder demostrar a los clientes el crecimiento de las keywords servidas a lo largo del tiempo
Qué nos dice el seguimiento de posiciones
El seguimiento de posiciones tradicional monitoriza un conjunto elegido de keywords a lo largo del tiempo. Según la herramienta, puedes especificar un motor de búsqueda, país o ciudad, dispositivo y, a veces, un área de búsqueda local concreta. Luego puedes ver si una consulta/página objetivo sube o baja en las SERPs, comparar competidores en los mismos términos y monitorizar funciones de la SERP.
Sigo viéndole una utilidad clara: si un negocio necesita saber si su página de servicio principal es visible para una frase comercialmente importante en una localidad concreta, una comprobación específica por ubicación es un diagnóstico útil.
En última instancia, el seguimiento de posiciones nos indica la "trayectoria" del rendimiento en función del conjunto de keywords monitorizadas; es un "indicador de rendimiento" y un entregable para el cliente. Sin embargo, el rank tracking por sí solo NO es un indicador de rendimiento único porque, como se ha mencionado, no se trata solo de mirar una pequeña porción de keywords, sino también de mirar el panorama completo.
Por ejemplo, Assertive Media (agencia SEO con sede en Londres) naturalmente quiere ver cómo posiciona para términos de agencia SEO (con y sin ubicación). Así que en SEO Stack podemos configurar un seguimiento específico de keywords añadiendo nuestras propias keywords o extrayendo los datos de keywords de Google Search Console:
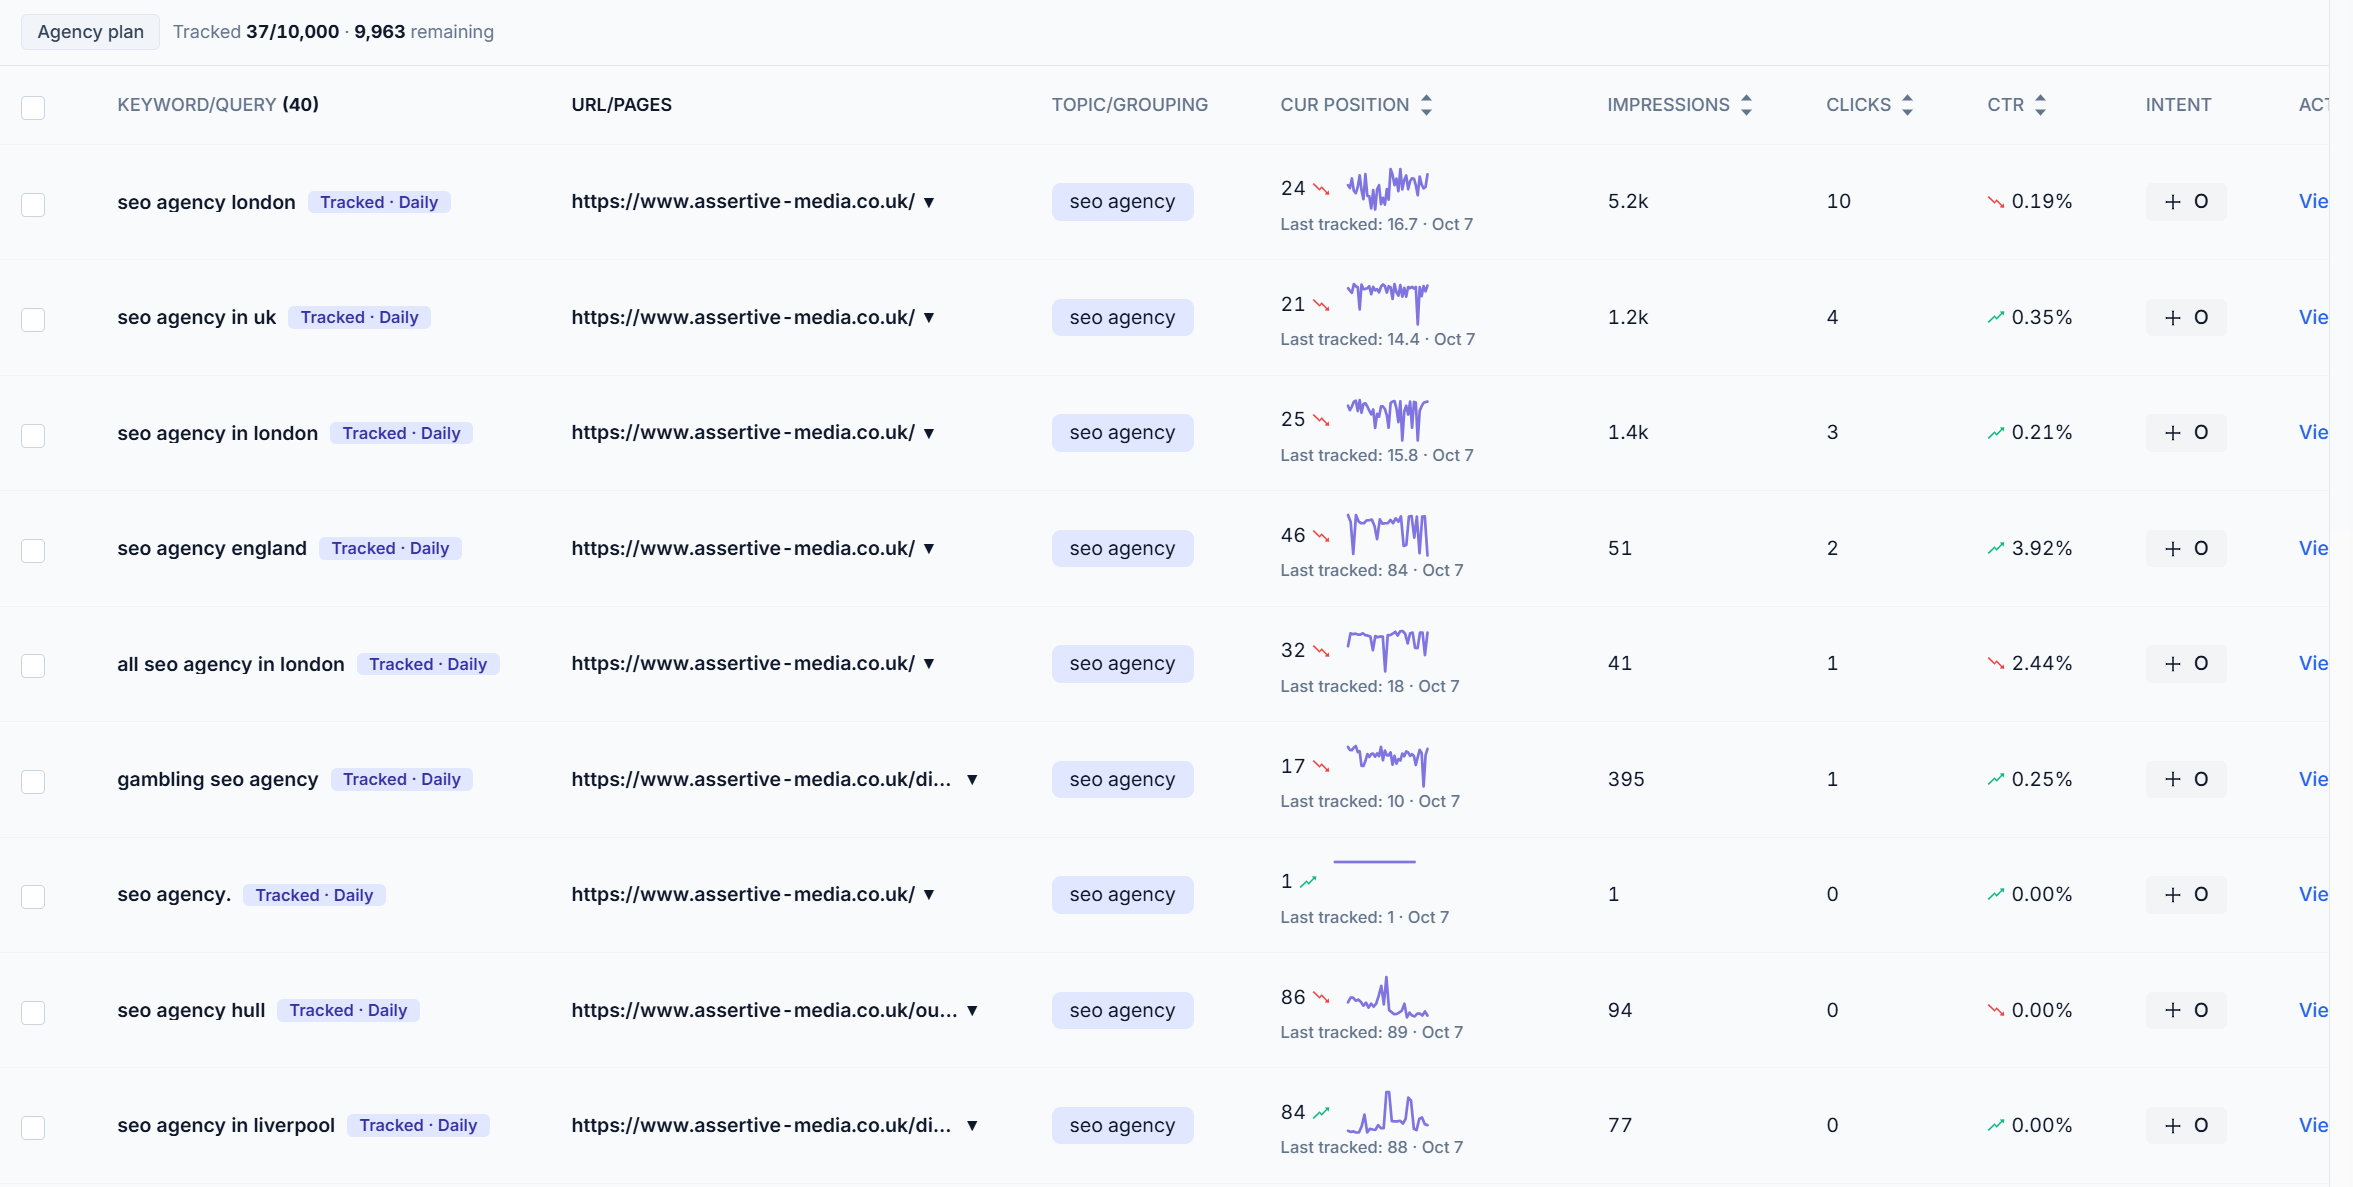
Como en el seguimiento de posiciones tradicional, SEO Stack te permite ver tu keyword, la URL servida y la trayectoria general del rendimiento a lo largo del tiempo:
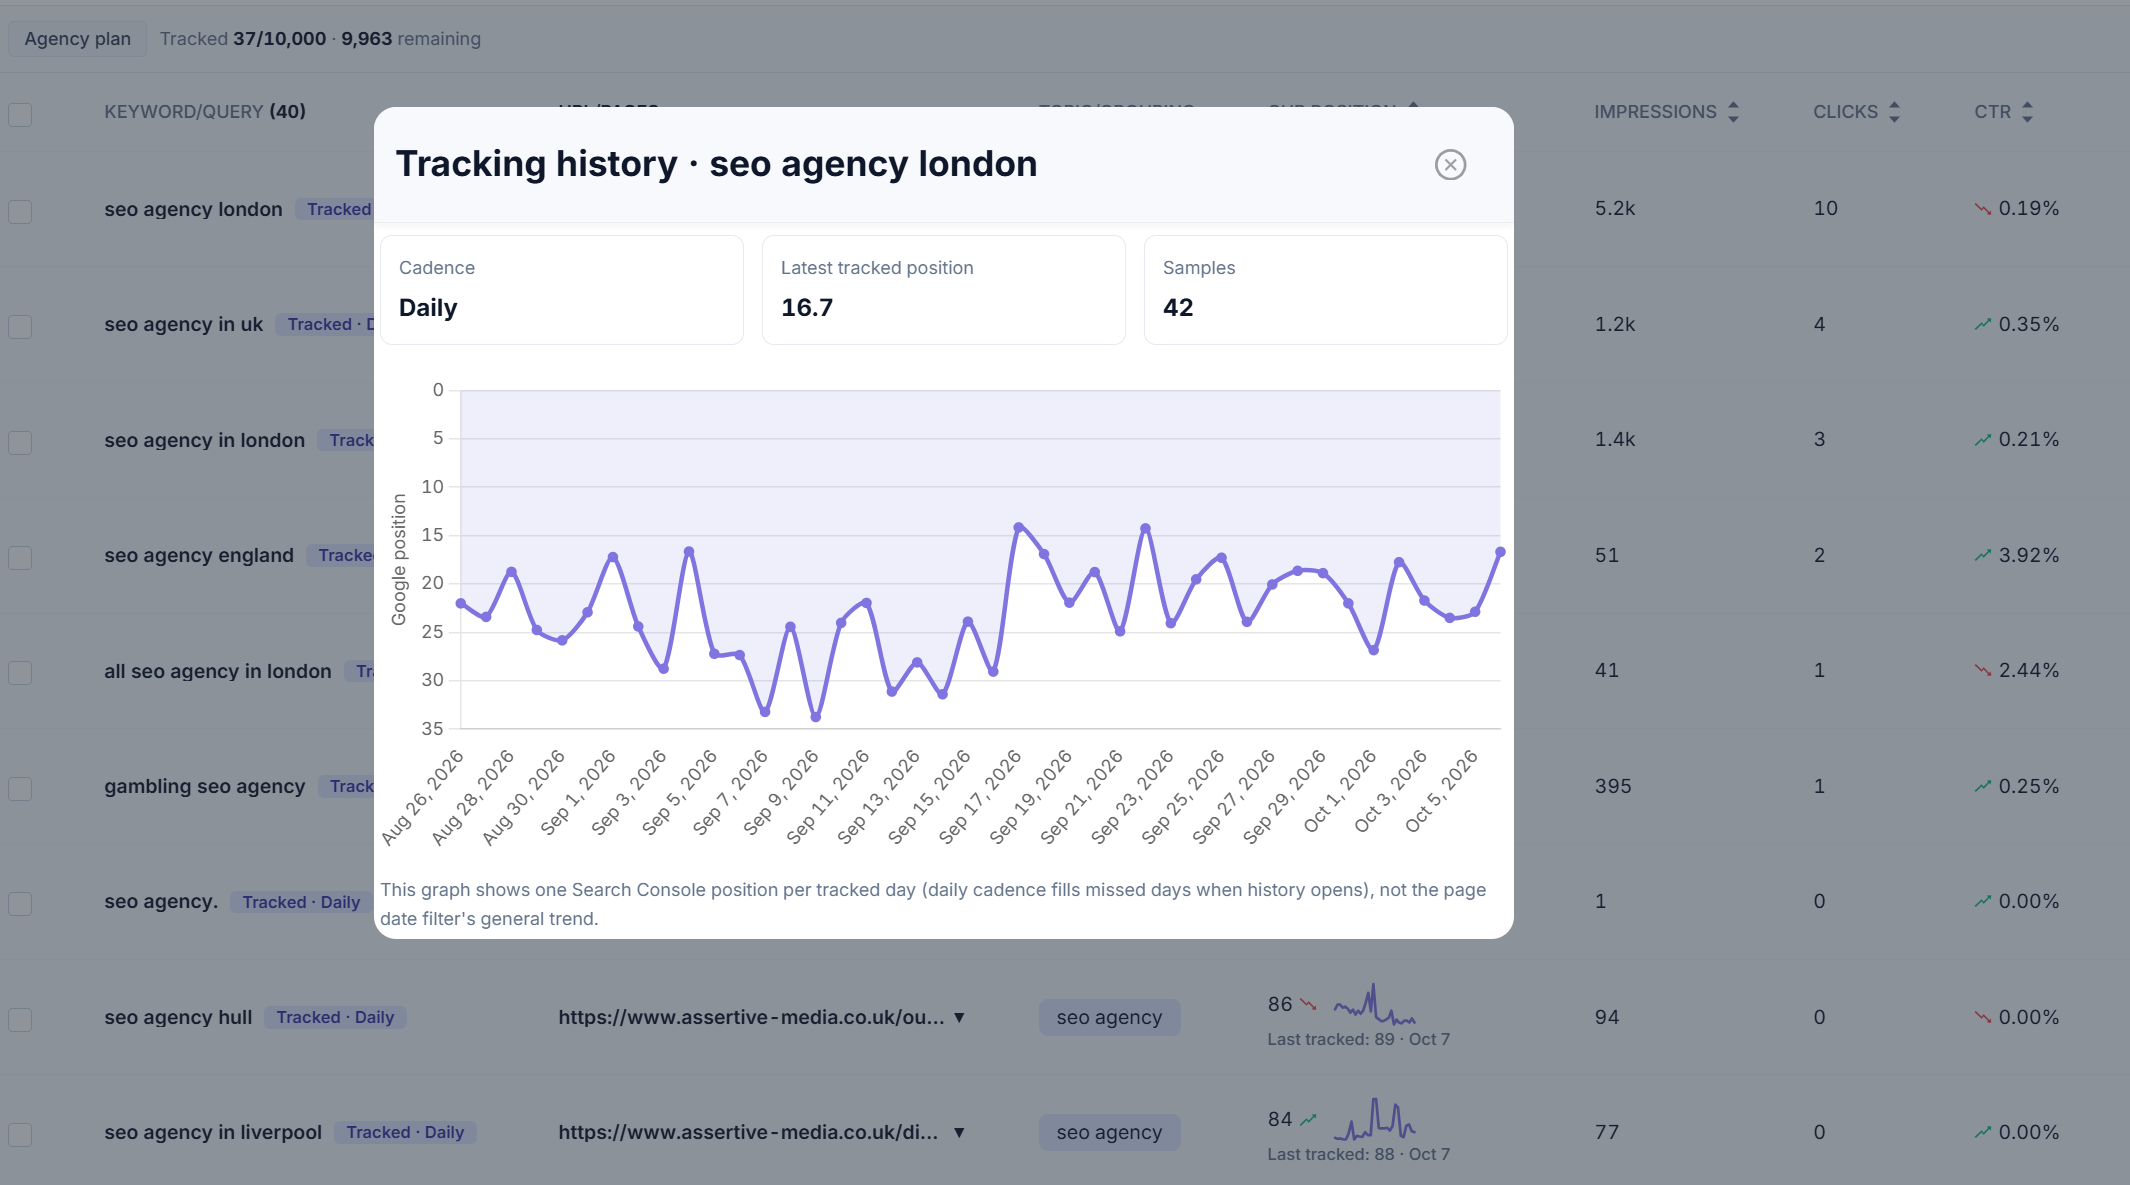
Arriba vemos una instantánea del rendimiento día a día de "SEO Agency London" como keyword para Assertive Media, y podemos verlo junto a datos de rendimiento como impresiones, clics, CTR, intención, etc.

El seguimiento de posiciones también nos dice cómo rinden las URLs para las keywords, pero podemos aplicar filtros para acotar aún más el rendimiento.
Por ejemplo, si estoy haciendo seguimiento de "seo agency london" como keyword, claramente tendría sentido aplicar un filtro a nivel de país, que es lo que podemos hacer en SEO Stack de forma rápida y sencilla:
Simplemente seleccionamos el desplegable de localización (GLOBAL) y luego elegimos el país o países que queramos:
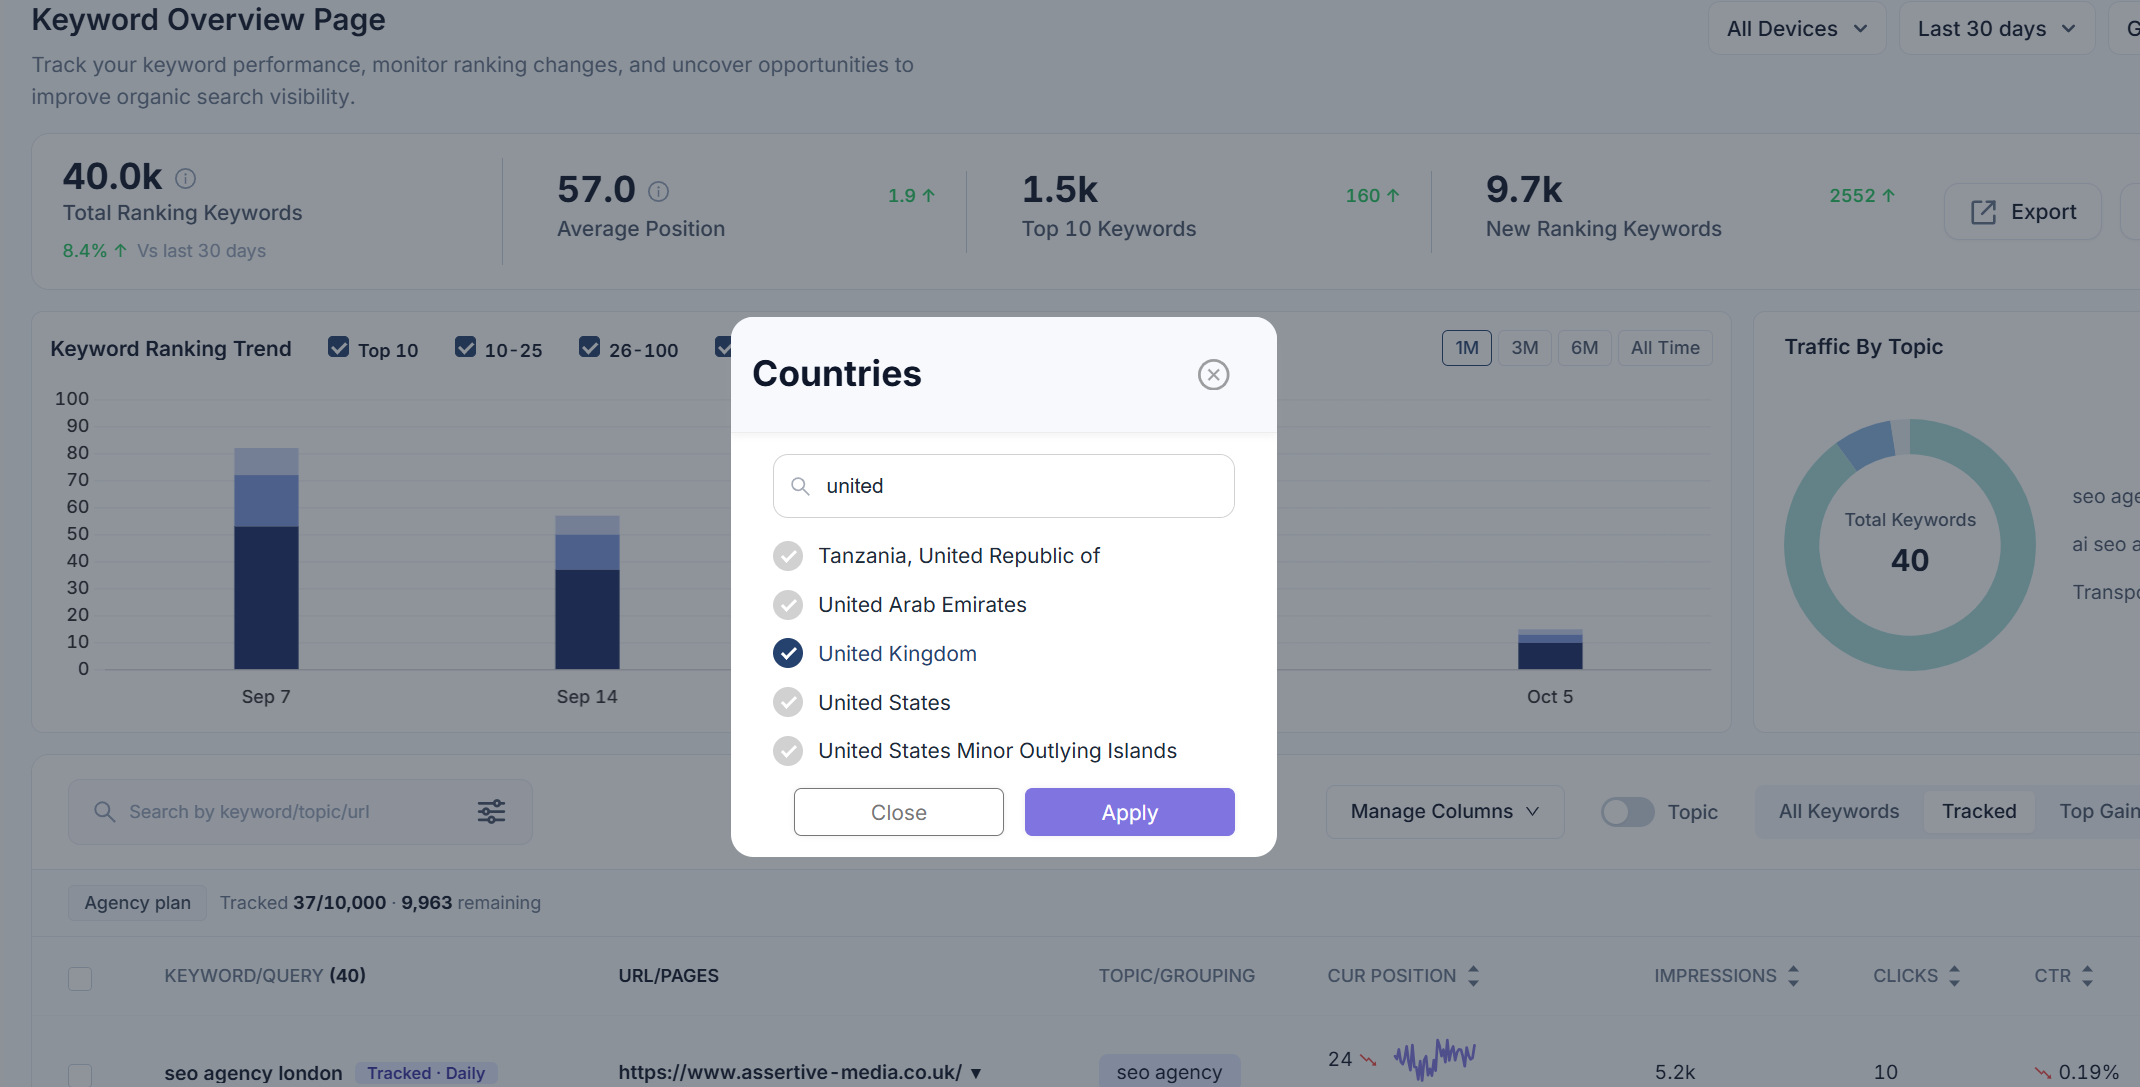
Y entonces podemos ver el rendimiento de posiciones según los filtros aplicados:
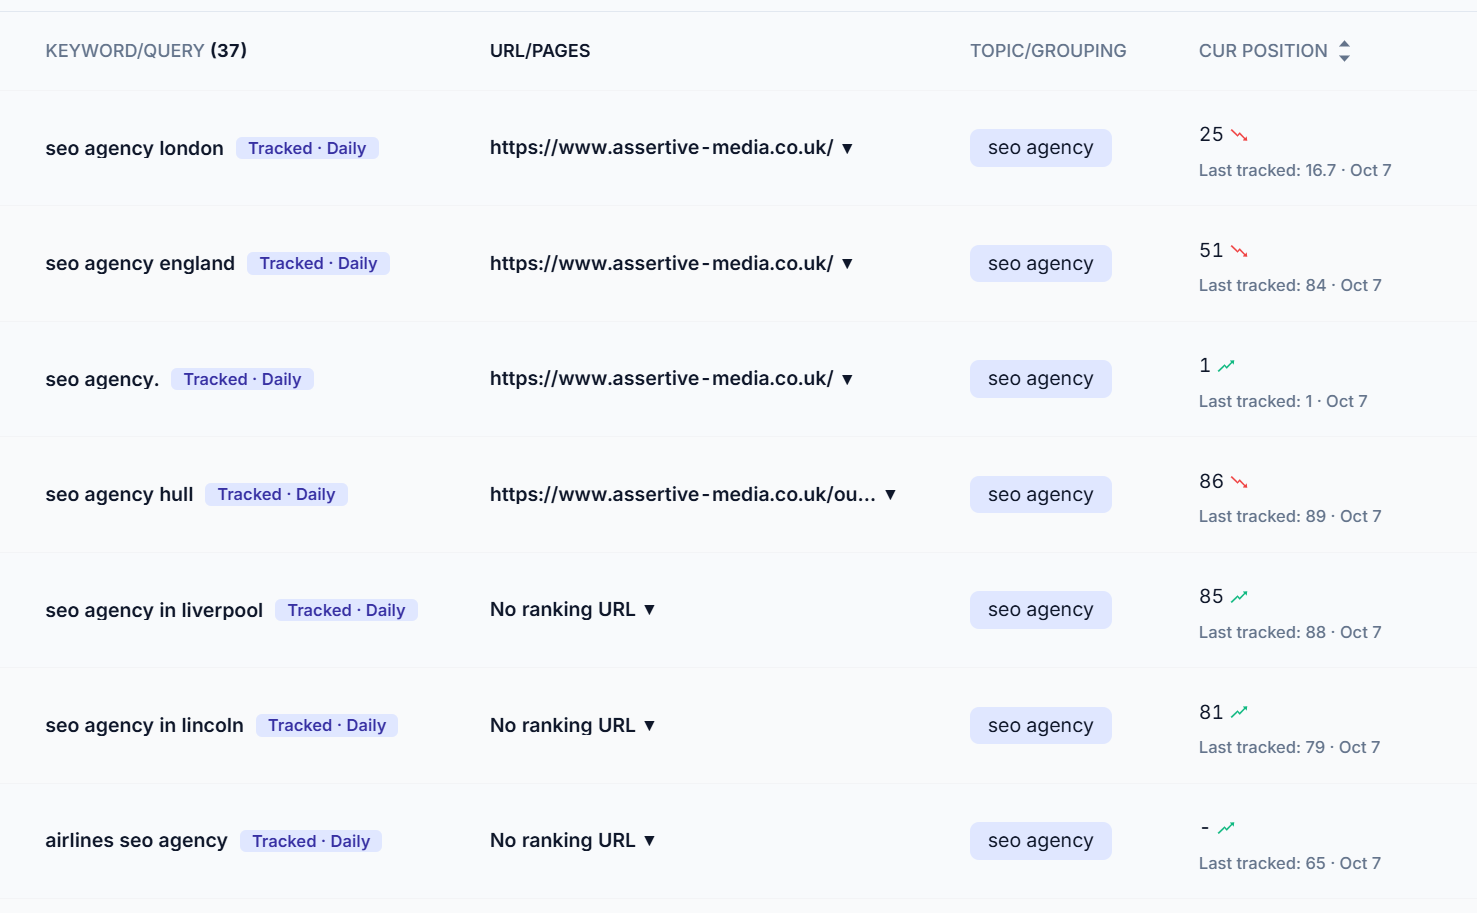
¡Así de sencillo!
La falacia de las 100 keywords
Un sitio web puede aparecer para miles de búsquedas distintas mientras un equipo SEO hace seguimiento únicamente de sus 100 términos de mayor prioridad. Esas 100 suelen elegirse deliberadamente: head terms, frases comerciales, productos o servicios conocidos y keywords con suficiente volumen de búsqueda como para parecer importantes en un documento de planificación. Normalmente los SEOs obtienen las keywords a partir del feedback del cliente o de datos de PPC, donde las conversiones respaldan el valor de la keyword.
Habitualmente, el seguimiento de posiciones prioriza keywords en función del volumen de búsqueda o del valor/relevancia comercial, aunque las keywords adecuadas a monitorizar dependen realmente de múltiples factores, desde el potencial de conversión hasta la prioridad del cliente.
Piensa en un minorista de muebles que hace seguimiento de “mesa de comedor”: esa única frase nos dice poco sobre la visibilidad del sitio para “mesa de comedor pequeña de roble”, “mesa extensible para 6” o una pregunta más concreta sobre dimensiones y entrega. Algunas de esas búsquedas pueden traer un puñado de impresiones al mes, otras pueden volverse importantes a medida que cambian la demanda o el contenido. Aun así, pueden sumar mucho en un sitio grande.
Google Search Console ofrece a los propietarios de sitios otra perspectiva: las consultas, páginas, impresiones, clics, CTR y posición media que Google ha registrado para su propiedad. La posición media de Google se calcula a partir de las impresiones, por lo que no coincidirá con la búsqueda en vivo de una persona en cada ubicación; es más genérica, menos a medida y no tiene en cuenta la personalización. Es una medida del rendimiento observado, no una posición universal para cada usuario.
Google explica la métrica de posición aquí:
https://support.google.com/webmasters/answer/7042828?hl=en
SEO Stack es un almacén de datos de Google Search Console, lo que nos permite contar consultas con precisión y a escala para cada dominio que importes. Así es como podemos darte los datos de volumen en la visión general de keywords, algo que debería ser intrínseco a tu reporting SEO.
Porque puedes mostrar a los clientes el progreso, es decir:
Podemos ver los volúmenes de keywords en un periodo concreto, por ejemplo los últimos 3 meses
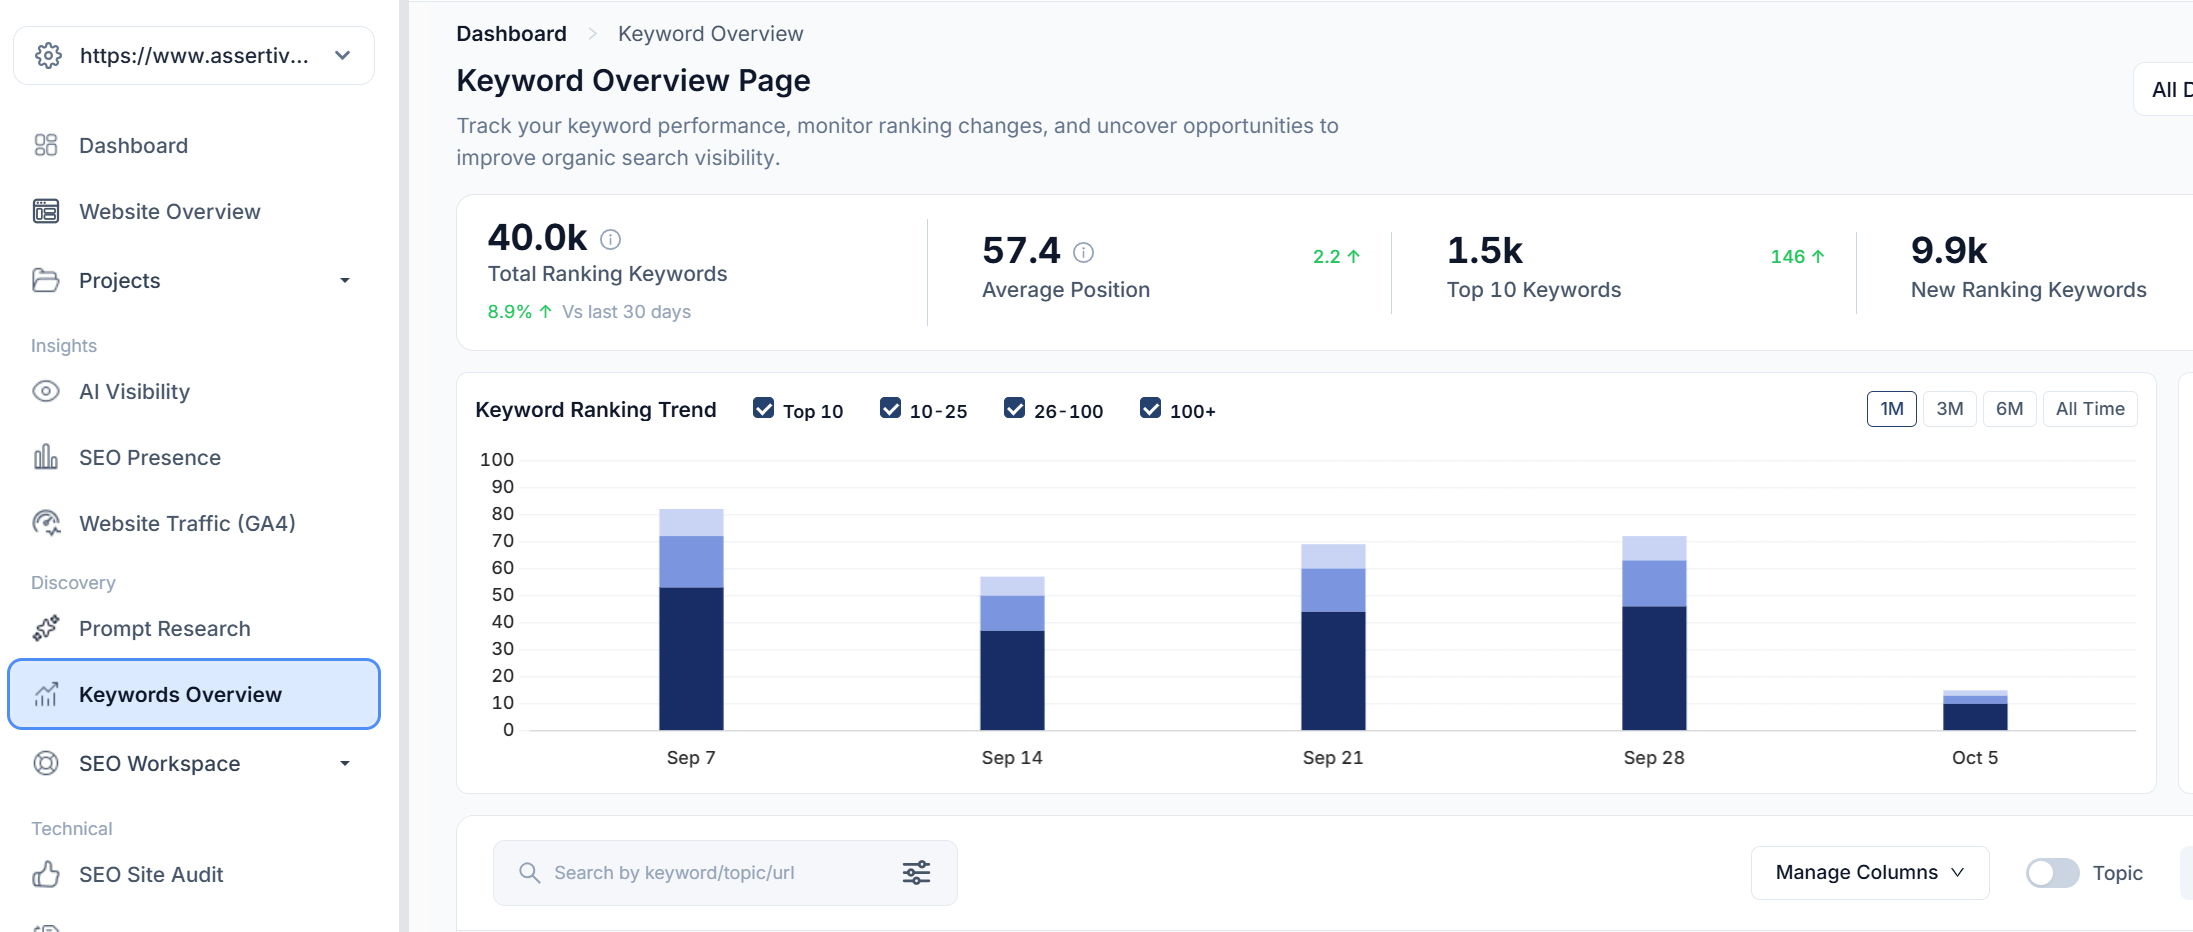
Pero luego podemos reportar sobre un periodo más largo, es decir:
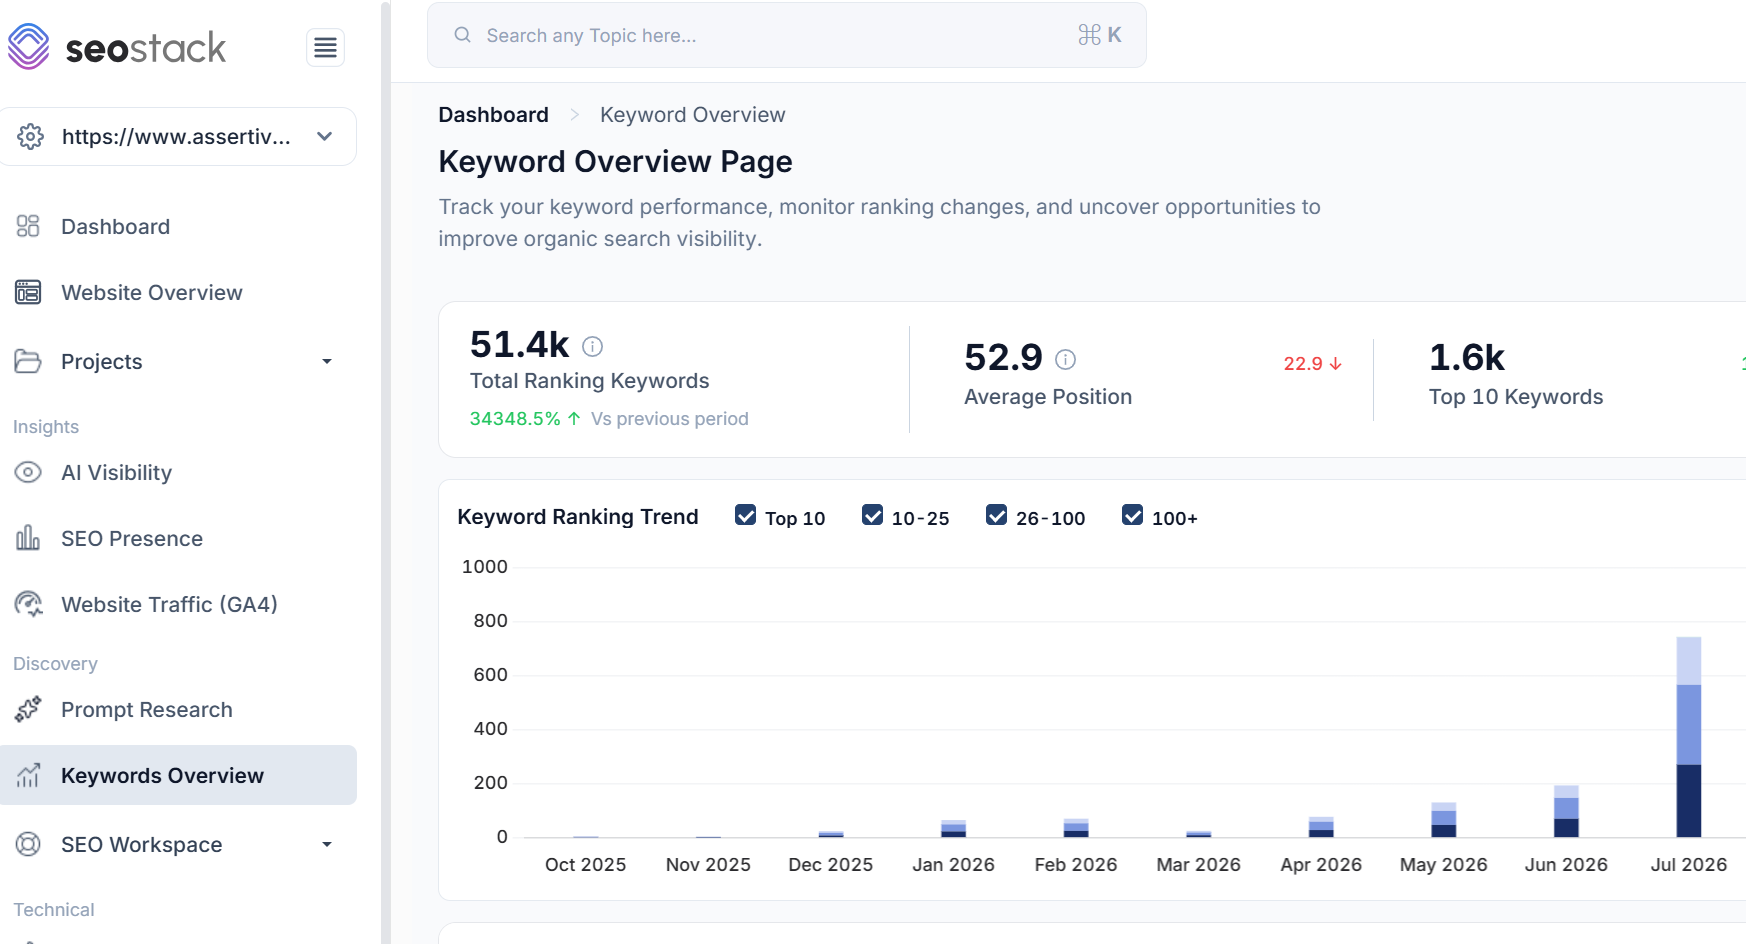
Esto resulta útil junto con el seguimiento de posiciones, porque mostramos el volumen total de keywords posicionadas por grupo de posición, algo que viene bien para los clientes.
Google ha cambiado la facilidad con la que se pueden recopilar las SERPs: bueno, se lo ha puesto mucho más difícil a las herramientas de terceros
Durante años, los proveedores de rank tracking han necesitado una forma de obtener resultados de búsqueda a escala. Algunos operan sus propios sistemas de recopilación, otros suelen depender de proveedores externos de datos de SERP como DataforSEO, SERPAPI, etc. En cualquier caso, cuando Google cambia la forma en que sirve sus resultados, las herramientas que dependen de esos resultados tienen que adaptarse y, como hemos visto en los últimos meses, Google ha sido excepcionalmente agresivo contra los scrapers de terceros.
Entonces, ¿qué ha estado haciendo Google?
El cambio en &num=100
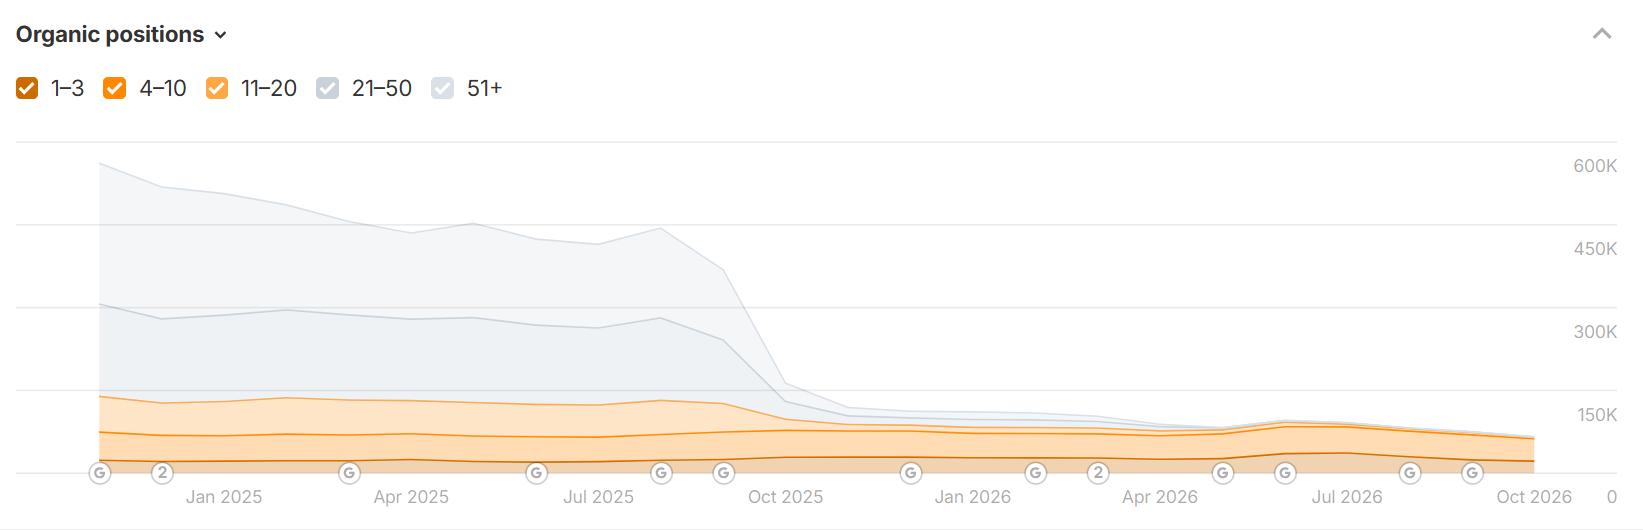
El parámetro &num=100 se usaba ampliamente para solicitar 100 resultados de Google en una sola carga de página. En septiembre de 2025, SEOs, proveedores de herramientas y profesionales informaron de que Google había dejado de respetarlo de forma consistente. Recopilar resultados más profundos pasó a requerir más peticiones, y algunas herramientas mostraron una profundidad de ranking ausente o reducida mientras modificaban sus sistemas. Search Engine Journal informó sobre la disrupción.
Esto no solo fue disruptivo, sino que encareció las peticiones en general, porque en lugar de 1 petición que devolvía 100 resultados, ahora hacen falta 10 peticiones para 100 resultados, lo que hace más caro obtener los datos y mantenerlos actualizados.
El efecto no fue idéntico en todos los proveedores. Ahrefs dijo que el cambio redujo cuántos resultados podía comprobar más allá de la primera página, y después informó de una restauración gradual de los datos del top 100 a lo largo de 2025, con una pequeña proporción de consultas que aún no devolvían la profundidad completa. Es un recordatorio útil: el cambio dejó al descubierto una dependencia y generó trabajo extra, pero no dejó inservible de forma permanente a todos los rank trackers. La actualización de Ahrefs está aquí.
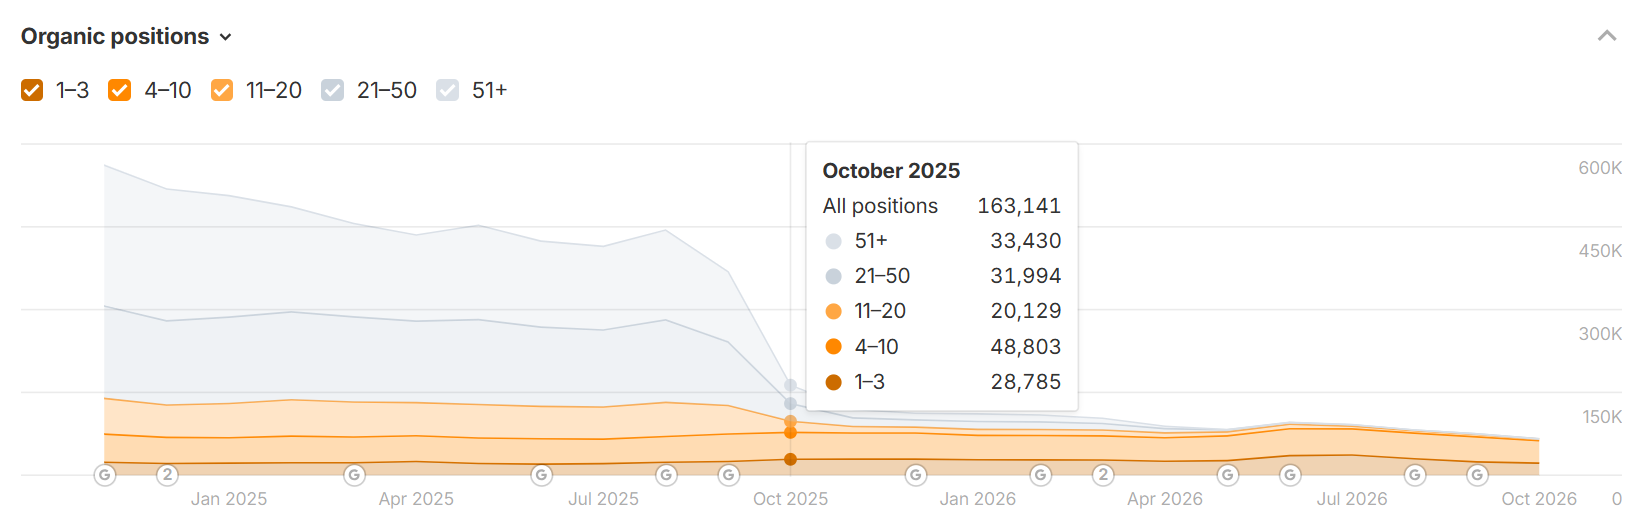
Sin embargo, vemos un gran volumen de sitios analizados en los que el recuento total de posiciones orgánicas cae, pero no necesariamente por caídas o pérdidas de ranking, sino quizá por una reducción de los datos disponibles.
Los enlaces de resultados /goto de Google
En agosto de 2026, Google confirmó que estaba desplegando enlaces de paso google.com/goto en los resultados de búsqueda. En lugar de exponer una URL de destino directa en el enlace del resultado, la página puede enrutarse a través de una URL de Google antes de llegar al destino. Para un scraper, eso añade un paso de resolución de URL. No significa que el ranking de la página haya cambiado; cambia cómo se presenta y se obtiene el enlace del resultado. Search Engine Roundtable informó de la confirmación de Google.
Lo clave que hay que entender es que las URLs GOTO aparecen en sesiones sin iniciar sesión, así que si miras el resultado de la SERP con la sesión iniciada en una cuenta de Google, Google no tiene motivo para ofuscar la URL, es decir:
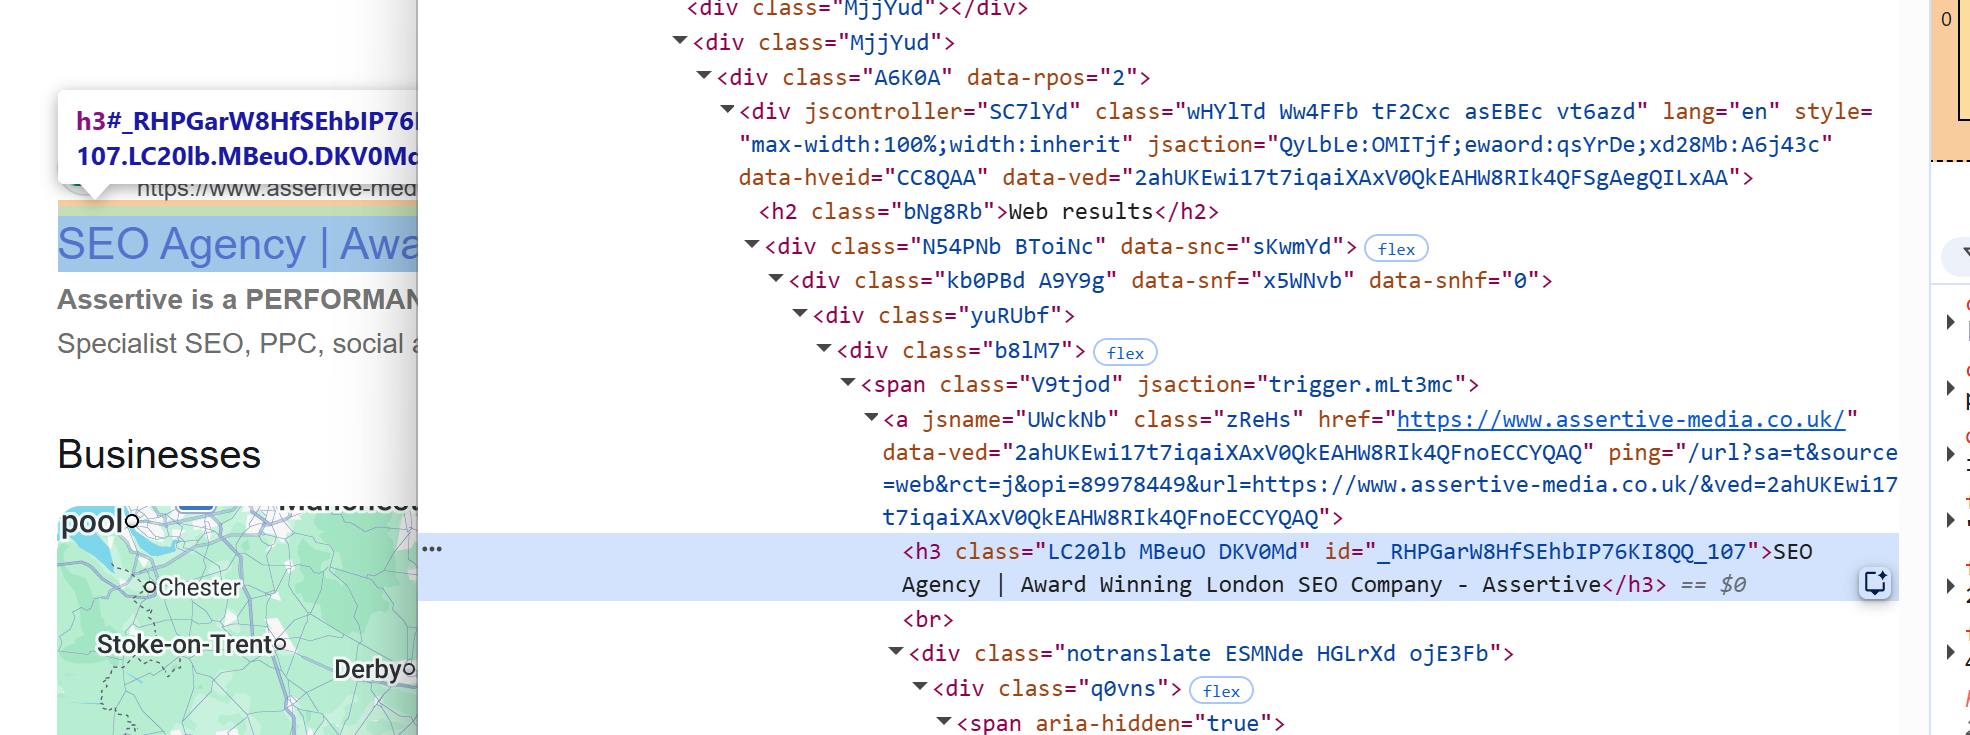
Pero, en cuanto cierras sesión o entras en incógnito, verás las URLs GOTO:
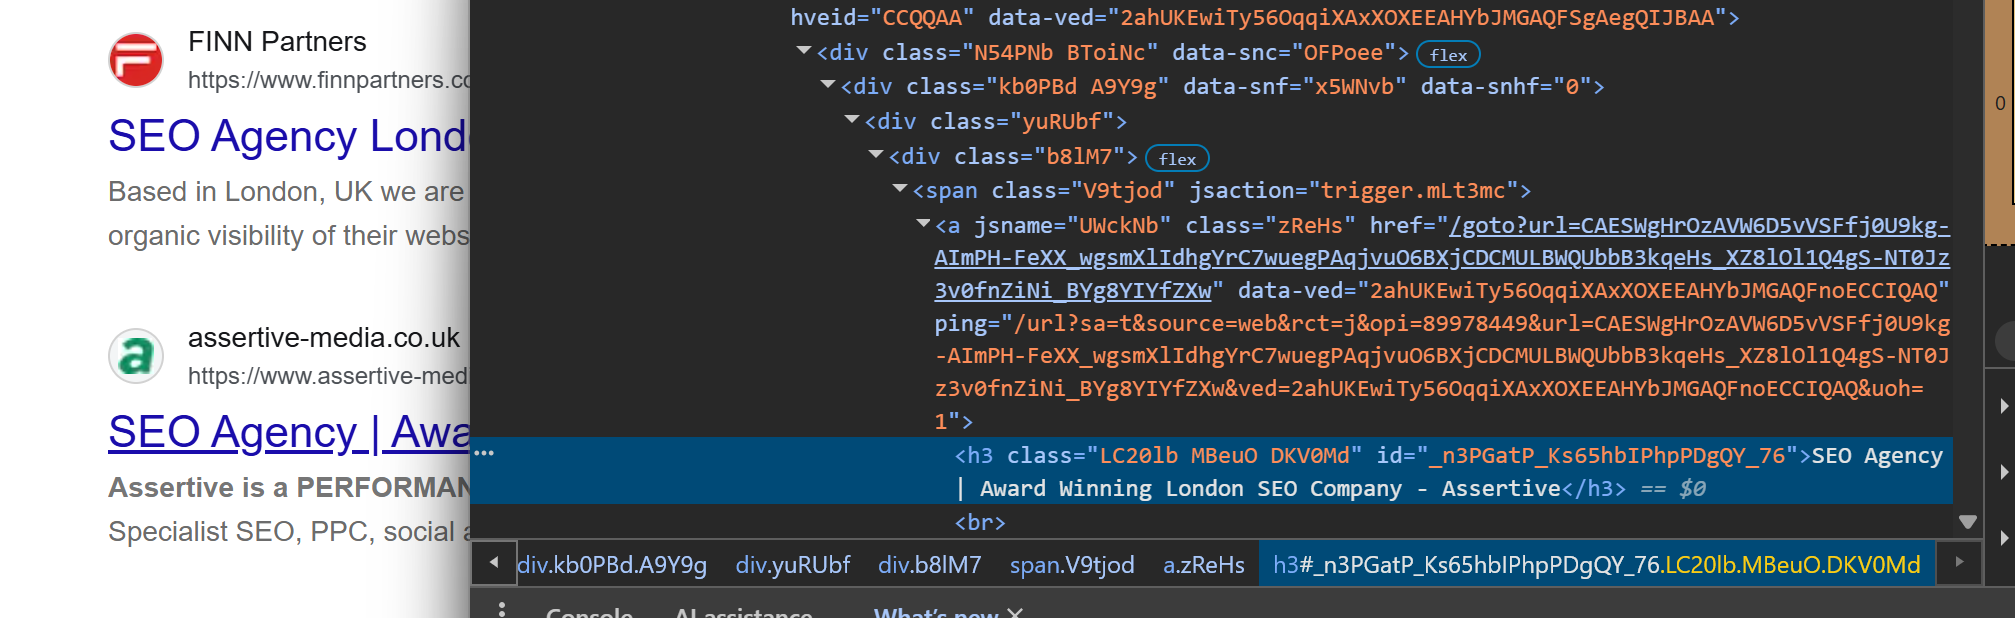
Así que, claramente, esta es solo otra forma en que Google se lo pone más difícil a terceros para hacer scraping y obtener datos, incluidos los datos de rank tracking.
Los proveedores de SERP pueden desarrollar formas de resolver estos enlaces; DataForSEO, por ejemplo, afirma que su API resuelve el destino del 99,99 % de las SERPs orgánicas que devuelve. Es la cifra que reporta el propio proveedor, no una afirmación sobre todas las herramientas del mercado. Sí demuestra que los proveedores pueden adaptarse, al tiempo que deja claro que la cobertura depende de la implementación de cada uno. La actualización de DataForSEO explica su enfoque.
Los datos diarios son útiles, pero la cadencia no lo es todo
Sería engañoso sugerir que los rank trackers de terceros no pueden ofrecer actualizaciones diarias. Semrush dice que su herramienta Position Tracking monitoriza keywords concretas a diario y puede segmentarlas por ubicación y dispositivo. Son fortalezas reales cuando el objetivo es seguir una campaña fija o comparar competidores en un mercado concreto. La documentación de Semrush describe esas funciones.
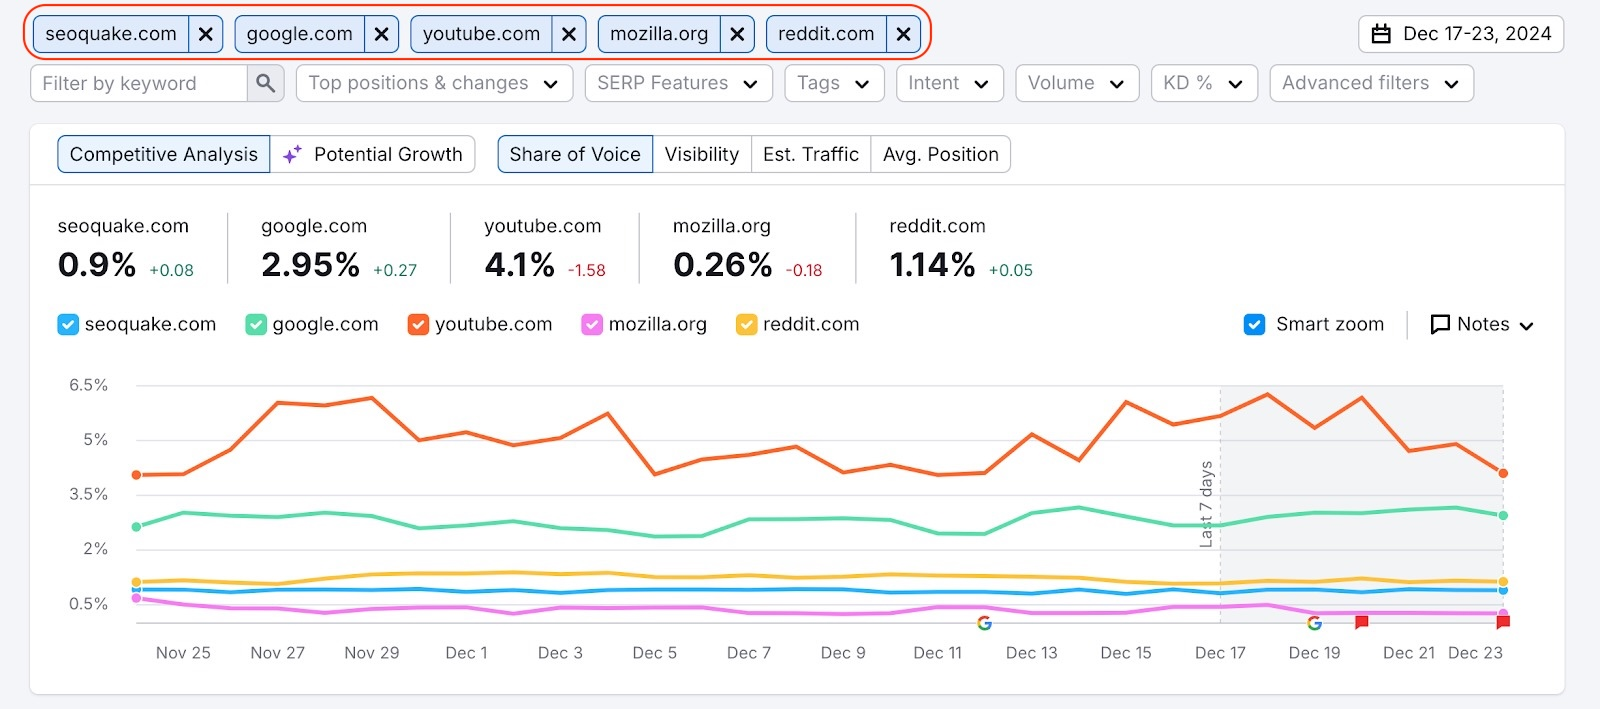
El informe de Position Tracking de Semrush ilustra el valor de un conjunto de keywords configurado y la comparación con competidores. Fuente de la captura: Centro de ayuda de Semrush.
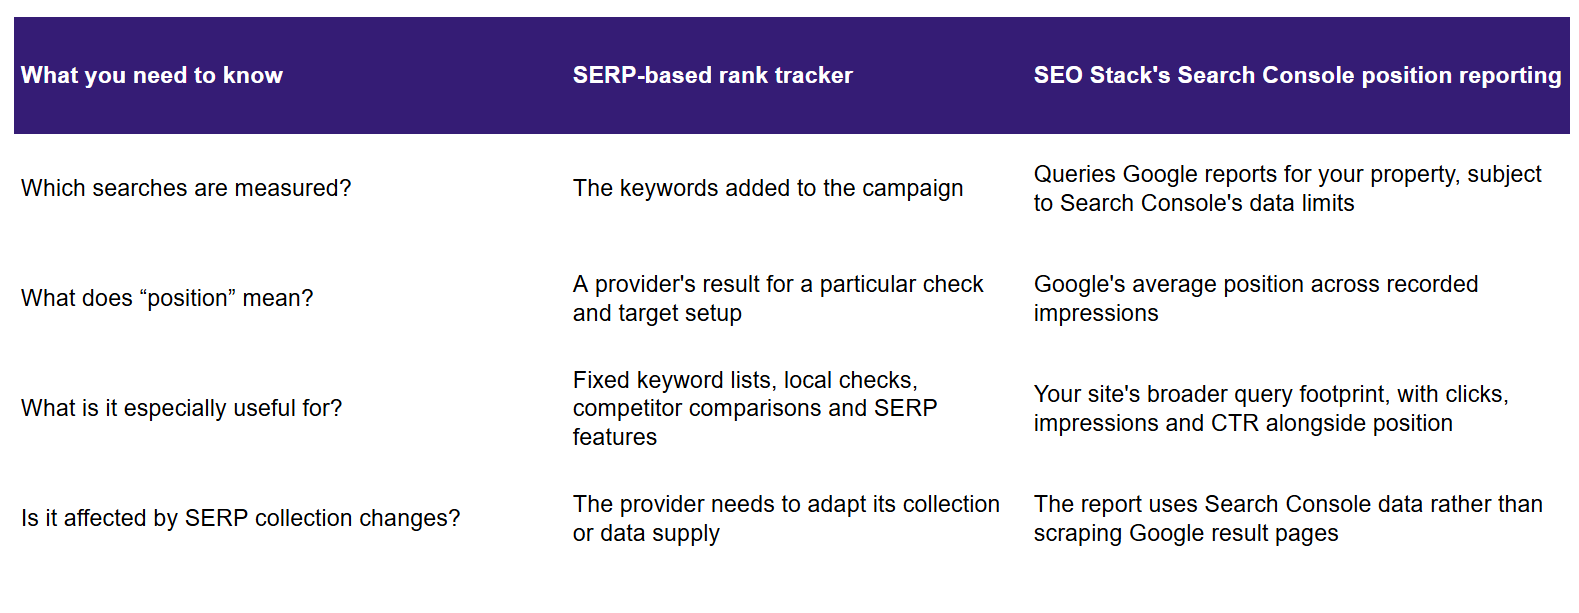
La diferencia está en el modelo de datos: un SERP tracker o herramienta de rank tracking comprueba términos seleccionados en una configuración controlada. Esto es lo que distingue a SEO Stack de otros rank trackers: SEO Stack informa de la posición media que Google registró para tu propia propiedad, consulta por consulta, junto con impresiones, clics y CTR.
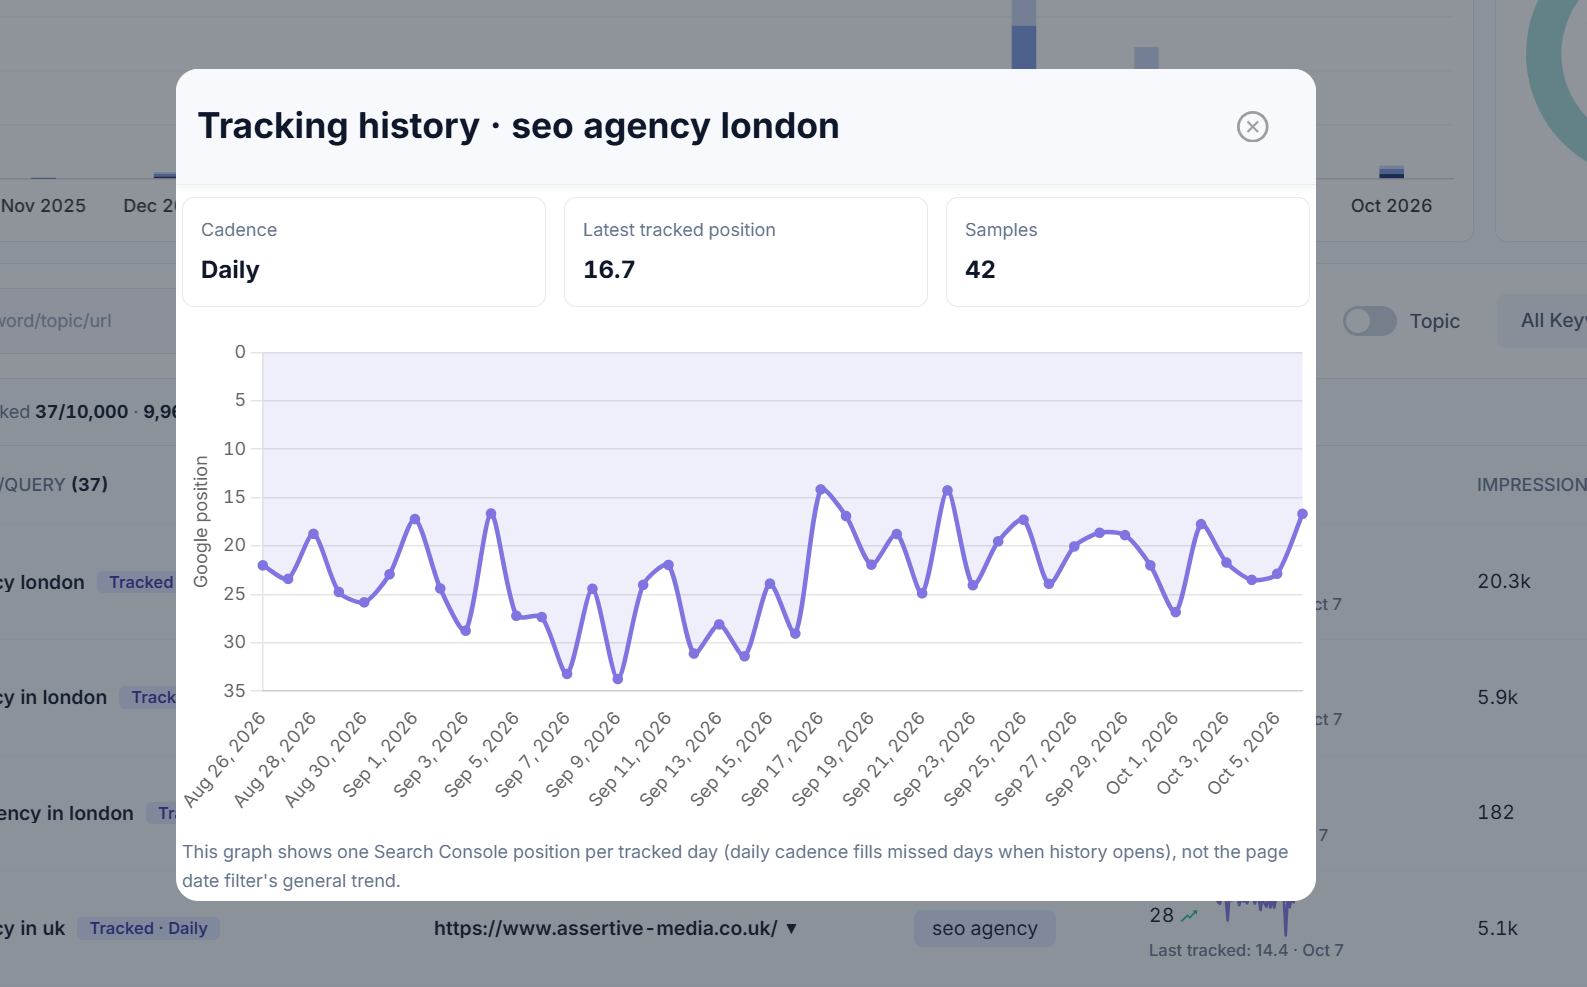
Almacenamos el histórico diario y te permitimos segmentarlo por las dimensiones disponibles en Search Console. La Search Analytics API admite las dimensiones fecha, consulta, página, país y dispositivo, además de filtros para esas dimensiones. La documentación de la API de Google explica cómo funciona.
Cómo SEO Stack evita la dependencia del scraping
SEO Stack se basa en los datos de Search Console que Google ya registra para una propiedad conectada. Simplemente prefiltramos esos datos en origen y después usamos las filas correspondientes de consulta, página, fecha, país y dispositivo para construir una vista de informes repetible. Eso significa que no intentamos redescubrir las posiciones de tu propio sitio recopilando repetidamente páginas de resultados de Google.
El beneficio práctico es la amplitud: no necesitas decidir de antemano que solo 100 términos merecen un hueco en el informe. Puedes empezar por las consultas para las que Google ha servido tu sitio, ver cómo cambian sus posiciones e impresiones y, después, crear un grupo de keywords monitorizadas más acotado con los términos que importan comercialmente.
Puedes crear tus propios grupos de temas o de keywords para, por ejemplo, keywords de alta conversión, keywords de alto valor para el cliente, etc., y además puedes ordenar por métrica, es decir, impresiones o clics >
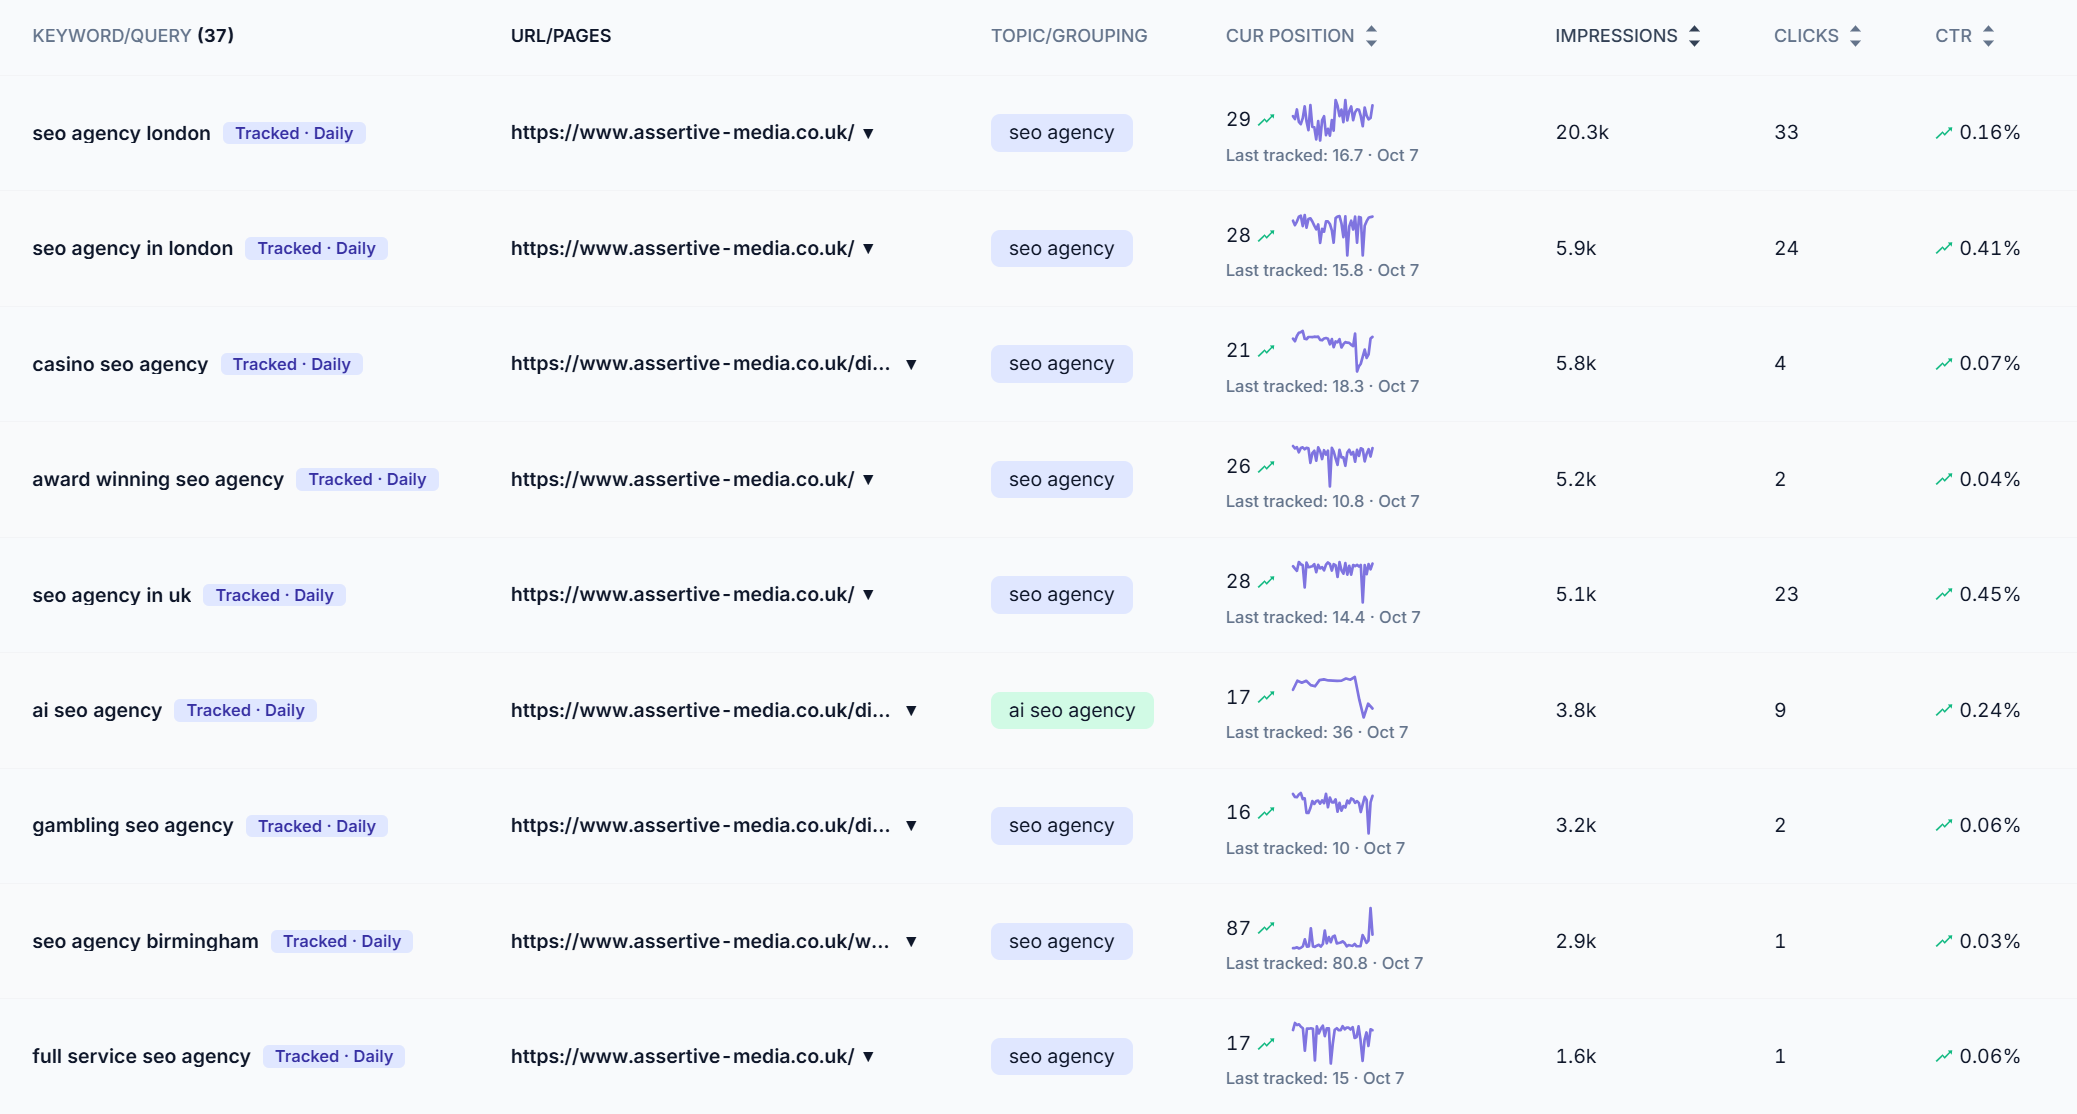
SEO Stack admite una lista deliberada de keywords monitorizadas como watchlist focalizada, junto con los datos más amplios de consultas de Search Console. Fuente de la imagen: SEO Stack Rank Tracking.
Como SEO Stack no hace scraping de las SERPs de Google para producir esta serie de posiciones, ni el parámetro &num=100 ni los enlaces /goto determinan si se pueden reportar los datos de Search Console del sitio. Podemos seguir mostrando el histórico diario de posiciones que facilita Google sin tener que descargar diez páginas de resultados por cada keyword ni resolver antes cada enlace de resultado.
La posición diaria no significa un ranking exacto en vivo que vaya a ser idéntico para todo el mundo. Es la media de Google para las impresiones que registra ese día. La ubicación, el dispositivo, el layout de los resultados y la combinación de búsquedas pueden afectar a la media, así que la comparación útil es la tendencia, interpretada junto con las impresiones, los clics y la landing page de la consulta.
Una fuente de datos propia también tiene límites
Search Console no es un registro ilimitado ni perfecto de cada búsqueda: Google omite las consultas anonimizadas de las tablas de consultas por privacidad, y su Search Analytics API indica que no garantiza que se devuelva cada fila de datos. La API permite hasta 25.000 filas por petición y admite paginación, pero filtrar y almacenar datos no puede recuperar los términos que Google retiene. Google documenta esos límites.
Sin embargo, como SEO Stack es un almacén de datos para tus datos de GSC, no estamos limitados por las restricciones de la API ni por otras limitaciones que afrontan otros rank trackers: tenemos datos puros que pueden filtrarse y ordenarse rápidamente para ofrecer información precisa sobre posiciones.
También hay una incidencia histórica concreta que conviene tener en cuenta: Google afirma que un error de registro impidió informar con precisión de las impresiones entre el 13 de mayo de 2025 y el 27 de abril de 2026. Las impresiones, el CTR y la posición media se vieron afectados, mientras que los clics no. Si estás comparando tendencias de posición en ese periodo, anótalo y evita tratar cada movimiento como un cambio en el rendimiento SEO. La página de anomalías de datos de Search Console de Google documenta la incidencia.
Ese es el límite honesto: SEO Stack puede aprovechar mejor los datos de origen propio que Google expone, conservar el histórico diario y mostrar un conjunto de consultas mucho más amplio que una pequeña lista manual de palabras clave. Lo que no puede hacer es volver visibles las búsquedas anonimizadas ni corregir un error de registro en los datos de origen de Google.
Usa ambas vistas para la pregunta que cada una puede responder
Un rank tracker especializado sigue teniendo su lugar cuando necesitas una comprobación local controlada, las posiciones de la competencia o la monitorización de funciones de la SERP. Para tu propio sitio web, una vista basada en Search Console responde a una pregunta más amplia: cuáles de las palabras clave de tu sitio web generaron realmente visibilidad significativa, cómo se movió la posición media de cada palabra clave y si ese movimiento se tradujo en impresiones y clics.
Por eso el rank tracking de SEO Stack se construye sobre tus propios datos de GSC: el objetivo no es hacer desaparecer una lista de seguimiento de 100 palabras clave. Es dejar de confundir esa lista con el panorama completo y darte una serie diaria de posiciones de origen propio que no dependa de la última forma en que Google sirve una página de resultados rastreada.
Cómo empaquetan su seguimiento los rank trackers más populares
Si estás comparando herramientas, mira más allá del número de palabras clave que anuncian. Comprueba con qué frecuencia se actualizan las posiciones, si el límite se comparte entre proyectos, cómo cuenta cada herramienta las ubicaciones y hasta qué profundidad informa dentro de Google. Los precios que aparecen abajo son precios de lista en USD consultados el 7 de octubre de 2026; la facturación anual, los impuestos y los precios regionales pueden cambiar el importe que pagas.
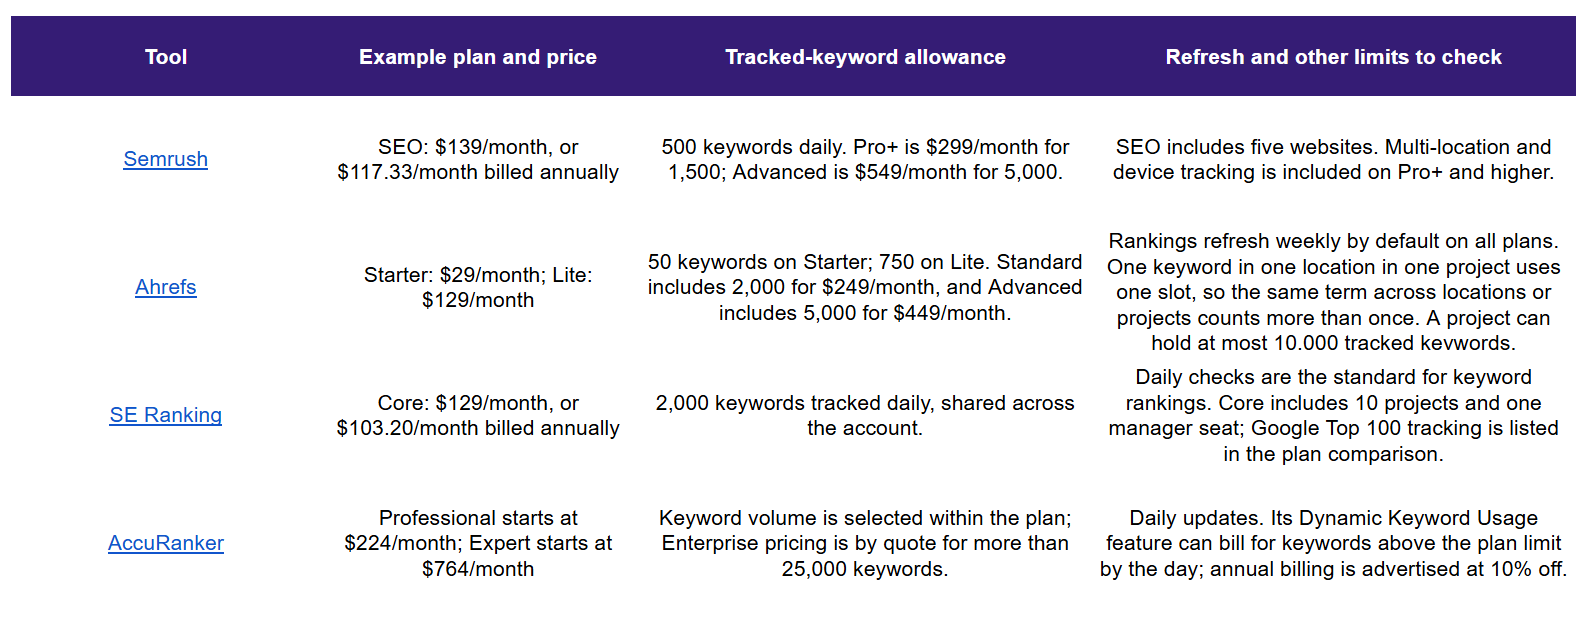
Todas son útiles para monitorizar un conjunto definido de palabras clave, pero los límites no son directamente intercambiables, así que una palabra clave rastreada en dos ubicaciones, dispositivos o proyectos puede consumir varios volúmenes asignados, y la frecuencia de actualización va de diaria a semanal. Incluso el plan estándar más grande sigue rastreando una lista elegida de palabras clave, en lugar de cada consulta que lleva impresiones a un sitio.
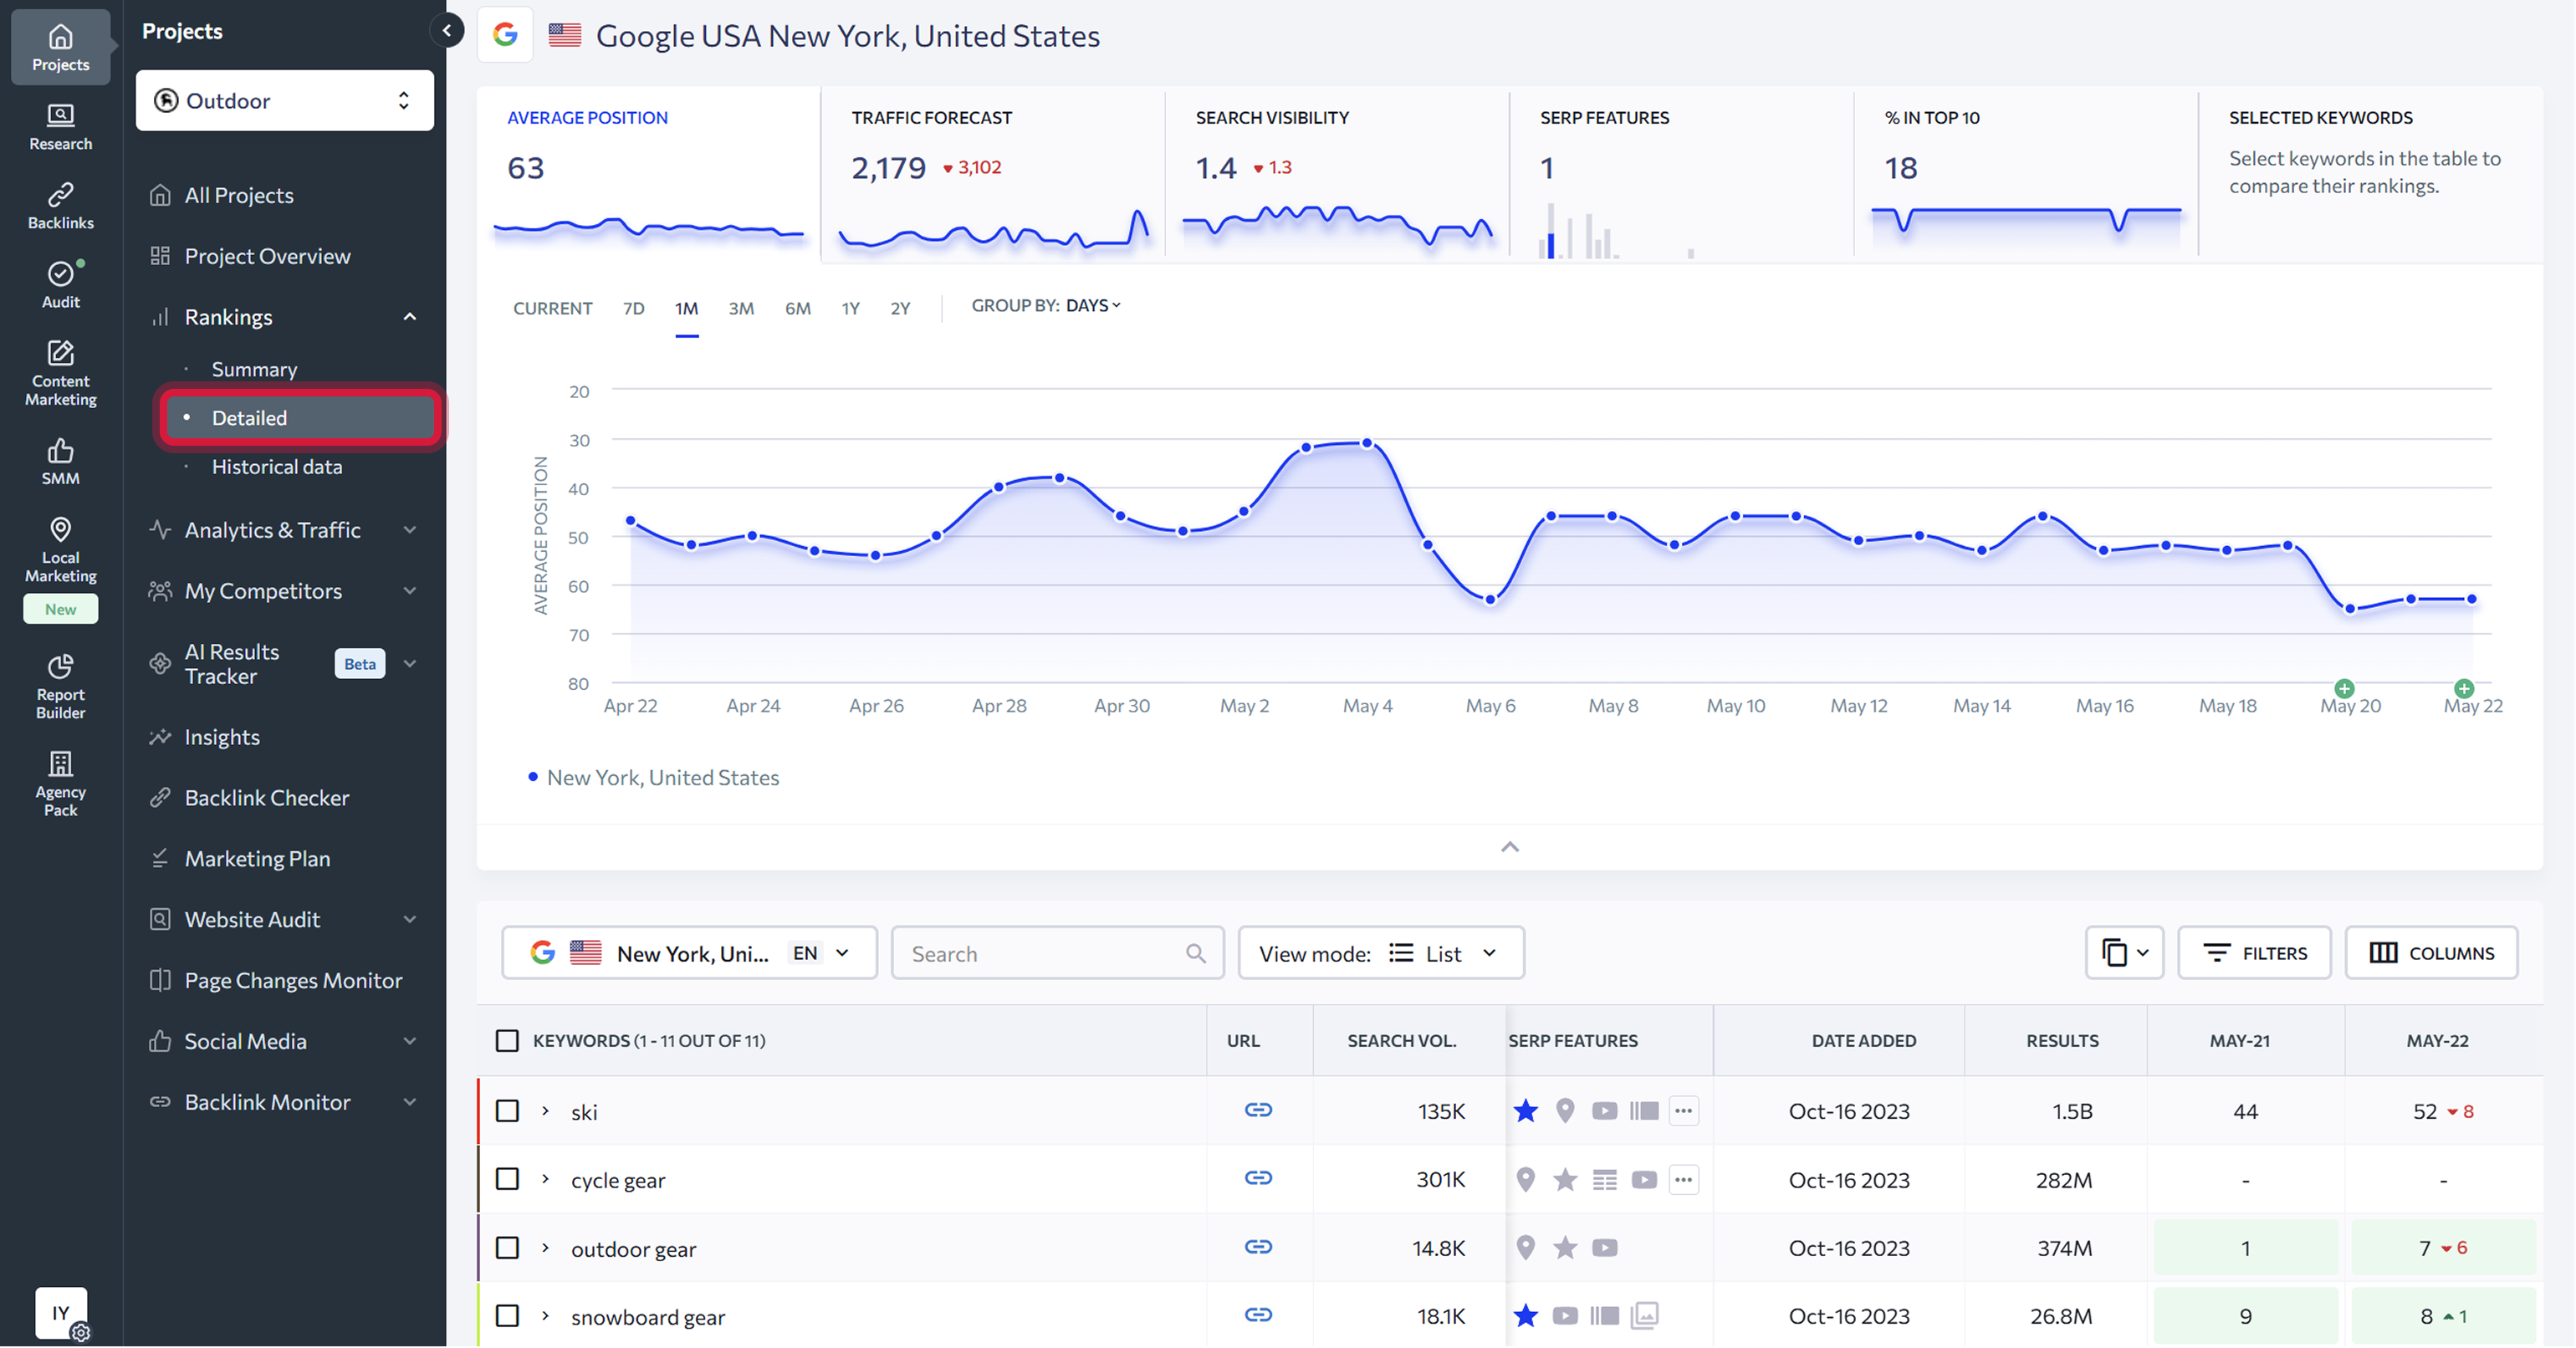
El módulo Rankings de SE Ranking muestra el histórico de posiciones de las palabras clave configuradas. Fuente de la captura: Centro de ayuda de SE Ranking.
La diferencia está en el modelo de datos: por ejemplo, un SERP tracker comprueba términos seleccionados en una configuración controlada, mientras que SEO Stack informa de la posición media que Google registró para tu propia propiedad, consulta por consulta, junto con las impresiones, los clics y el CTR.
Almacenamos el histórico diario y te permitimos segmentarlo por las dimensiones disponibles en Search Console. La API de Search Analytics admite las dimensiones de fecha, consulta, página, país y dispositivo, además de filtros para esas dimensiones. La documentación de la API de Google explica cómo funciona.
¿Por qué insiste tanto Google en bloquear los scrapers?
Google ha publicado una razón bastante directa: clasifica las búsquedas automatizadas como tráfico generado por máquinas, incluyendo explícitamente el scraping de resultados para comprobar posiciones, y dice que esta actividad consume recursos e interfiere con su capacidad de atender a los usuarios (aunque sabemos que en realidad esto significa: no queremos que otras herramientas se lucren con nuestros datos). #
La página de ayuda de Google también menciona los scrapers de búsqueda y el software que envía búsquedas a Google para averiguar dónde posiciona un sitio; cuando Google detecta tráfico inusual, puede interrumpir el acceso con un reCAPTCHA. Dicho de otro modo, las peticiones automatizadas repetidas se ven muy distintas de una persona que busca de vez en cuando, y Google trata ese volumen como un problema de abuso del servicio y de disponibilidad. (Políticas de spam de Google; guía de Google sobre tráfico inusual)
Eso no demuestra que cada cambio en las páginas de resultados o en las URLs de Google se introdujera específicamente para atacar a las herramientas SEO, pero es fácil llegar a esa conclusión. Google no ha dicho que el comportamiento de &num=100 ni los enlaces /goto fueran una campaña contra los rank trackers (pero ¿por qué otra razón lo harían? especialmente después del caso de SERPAPI). Yo los describiría como cambios que pueden hacer la recopilación automatizada menos predecible, manteniendo aparte la razón declarada por Google: Google dice que la comprobación automatizada de posiciones a gran escala consume recursos e interfiere con Search.
¿Le importan a Google los rank trackers?
Sí, cuando hablamos de cómo recopilan los datos. Google incluye explícitamente el scraping de resultados de búsqueda para comprobar posiciones dentro de su política de tráfico generado por máquinas y afirma que el acceso automatizado sin permiso expreso infringe sus políticas de spam y sus Términos del Servicio.
Su página de ayuda de Search es igual de concreta: el software que envía búsquedas a Google para averiguar cómo posiciona un sitio es una de las actividades que considera tráfico automatizado. (Google Search Central; Ayuda de Google Search) Pero, durante mucho tiempo, aunque se haya repetido que es algo que Google no permite, la mayoría de los rank trackers lo han tenido fácil.
La distinción importa porque la redacción de Google se refiere a las consultas automatizadas enviadas a Google; no dice que un sitio de empresa sea penalizado simplemente porque su propietario use un rank tracker, y, como cabe esperar, la gente que trabaja en SEO va a querer hacer seguimiento de posiciones.
Personalmente, no convertiría esa política en una afirmación sobre una penalización de posicionamiento de un sitio. Google sí advierte, en cambio, de que las herramientas de terceros no tienen acceso a sus datos internos de ranking y recomienda Search Console para obtener información de origen propio sobre un sitio conectado.
Eso hace que merezca la pena comprobar la fuente y el método detrás de un informe de posiciones, sobre todo cuando el informe se presenta como una visión definitiva de lo que ve cada usuario que busca. (Guía de Google sobre herramientas SEO de terceros)
¿Cómo se están adaptando las empresas de rank tracking?
El proceso de recopilación completo suele ser propietario, así que sería prudente antes de afirmar que todos los trackers usan la misma solución alternativa: cada plataforma de rank tracking va a tener su propio enfoque técnico para superar estos obstáculos.
Algunas empresas gestionan sus propios procesos de recopilación de SERPs, mientras que otras dependen de proveedores de datos externos. Ahrefs dijo que el cambio de &num=100 afectó tanto a su propia monitorización como a los proveedores de datos de terceros, y redujo la profundidad que podía comprobar más allá de la primera página de Google.
Eso apunta al trabajo práctico que implica: adaptar la petición y el pipeline de datos, comprobar qué profundidad sigue estando disponible y cambiar la forma en que se ensamblan los resultados procedentes de varias páginas o proveedores. (Actualización de Ahrefs sobre la monitorización de SERPs)
El cambio de /goto es un problema de parseo además de un problema de recopilación. Si un resultado apunta primero a una URL de paso de Google (una redirección, para ti y para mí), la herramienta o plataforma tiene que identificar y resolver el destino antes de poder informar de forma fiable de la URL posicionada. DataForSEO dice que añadió un resolutor para las nuevas URLs de Google e informó de que el 99,99% de las SERPs orgánicas devueltas a través de su API tenían URLs de destino directas en el momento de su actualización. Esa es la cobertura declarada por DataForSEO, no una cifra que podamos aplicar a todos los proveedores. (Actualización de DataForSEO sobre /goto)
Este ajuste continuo es la razón por la que las «actualizaciones diarias» deben entenderse como la frecuencia de comprobación programada de un proveedor de rankings concreto, y no como la garantía de que cada keyword vaya a devolver siempre una SERP completa e idéntica, algo con lo que los rank trackers han tenido que lidiar además de la personalización, la localización, etc.
Los cambios en el acceso o en el marcado de los resultados pueden suponer trabajo de recopilación adicional, una profundidad irregular o retrasos mientras los proveedores se adaptan, y probablemente conlleven más coste, lo que reducirá los márgenes de los rank trackers.
En las campañas de SEO, los rank trackers siguen siendo útiles, evidentemente, para comprobar y hacer seguimiento de keywords, ubicaciones y competidores concretos; para el rendimiento de las consultas observado en el propio sitio, SEO Stack utiliza datos de Search Console y no necesita hacer scraping de las páginas de resultados de Google para generar ese historial de posiciones.

Fundador, SEO Stack
Daniel es el fundador de SEO Stack. Ha dedicado más de 2 décadas al SEO técnico y a los datos de búsqueda, y creó SEO Stack tras toparse una vez más con los mismos límites de Search Console en el trabajo con clientes.
Daniel cuenta con una amplia experiencia en SEO: ha montado agencias de SEO, negocios de auditoría y una consultoría próspera. En su tiempo libre, le gusta realizar experimentos de SEO y compartir los resultados.
Publicado 7 de octubre de 2026


