Warum hat die Google Search Console eine Datenbegrenzung von 16 Monaten?
Viele SEOs, die für einen Kunden eine längerfristige Performance-Story aufbauen wollten, sind schon gegen diese Wand gelaufen. Du loggst dich in Search Console ein, öffnest den Performance-Bericht, wählst die letzten 16 Monate aus und …
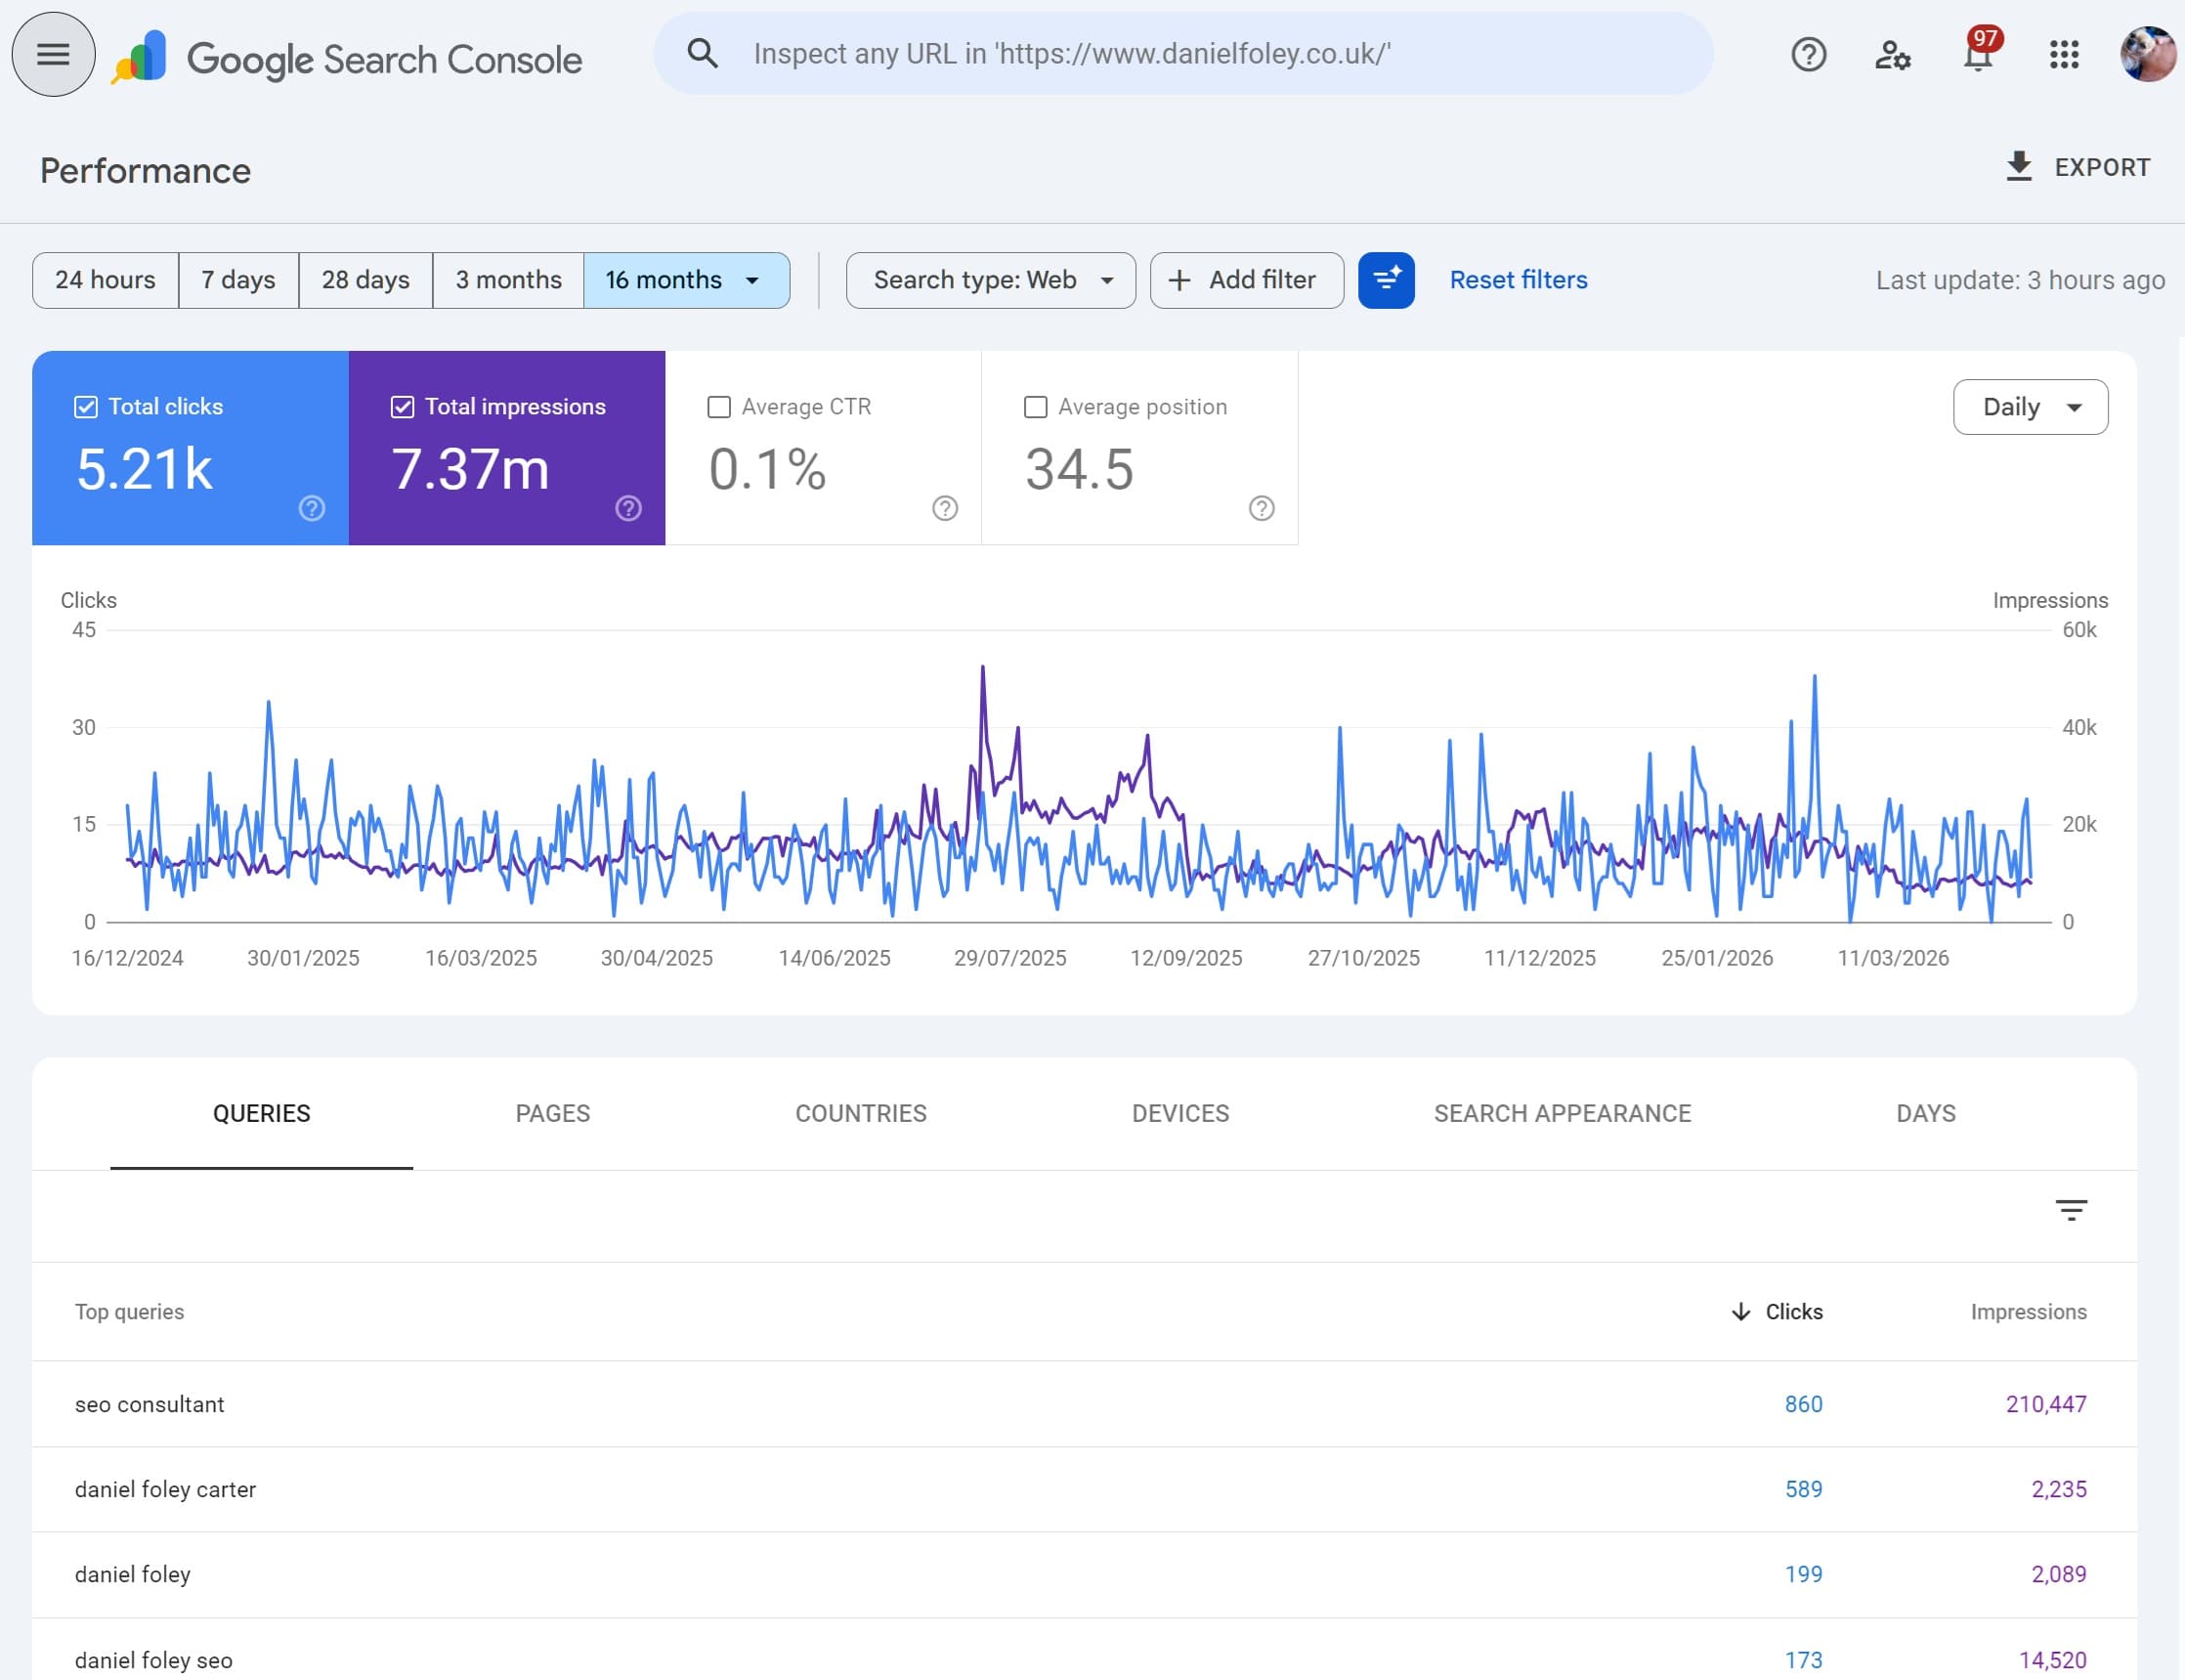
Viele SEOs, die versucht haben, für einen Kunden eine längerfristige Performance-Story aufzubauen, sind gegen diese Wand gelaufen. Du loggst dich in Search Console ein, öffnest den Leistungsbericht, wählst die letzten 16 Monate – und das war's.
Du willst Daten darüber hinaus? Nun, sofern du sie nicht in BigQuery gesichert hast, sind sie weg. Und genau an dieser Stelle greifen viele SEOs erfahrungsgemäß zu SEMRUSH, AHREFS oder Sistrix.
Einige SEOs haben mich danach gefragt, deshalb dachte ich, ich schreibe auf, was da eigentlich passiert, was Google dazu gesagt hat (nicht viel) und welche Workarounds tatsächlich funktionieren. Ich habe über die Jahre die meisten Optionen ausprobiert und einige davon scheitern sehen. Das hier ist die ehrliche Version, nicht der Verkaufspitch.
Was das Limit tatsächlich bedeutet
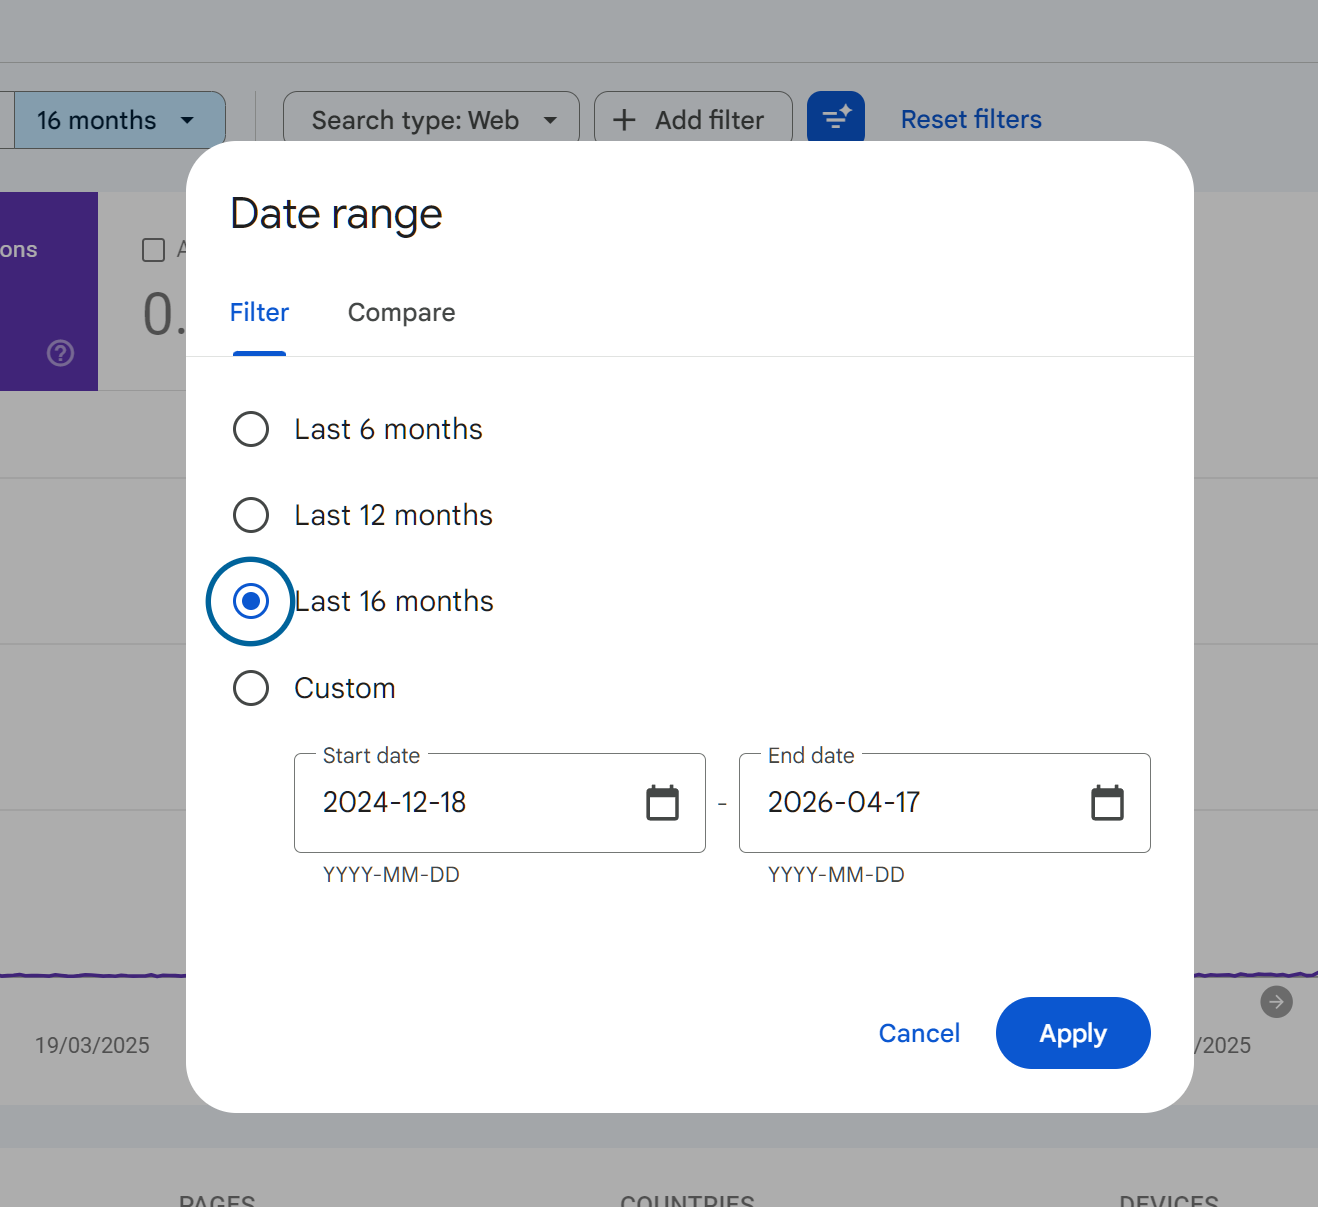
Google Search Console arbeitet bei Performance-Daten mit einem rollierenden 16-Monats-Fenster. Das umfasst Klicks, Impressionen, CTR, durchschnittliche Position, Suchanfragen, Seiten, Länder, Geräte und Suchtyp. Jeden Tag kommt am einen Ende ein Tag hinzu und am anderen fällt einer weg. Das Fenster geht nie darüber hinaus. Sobald ein Datum hinten herausfällt, wird es dauerhaft aus Googles Datenbanken gelöscht und es gibt keine Möglichkeit, diese Daten zurückzuholen. Die einzige Chance hast du, wenn du eine Data-Warehousing-Lösung wie Googles BigQuery nutzt (die du in Search Console aktivieren kannst) oder Tools wie SEO Stack oder SEO Gets einsetzt.
Wissenswert: Die 16 Monate gelten für Performance-Daten. Andere Bereiche der Google Search Console, etwa die Seitenindexierung, zeigen nur die letzten 3 Monate.
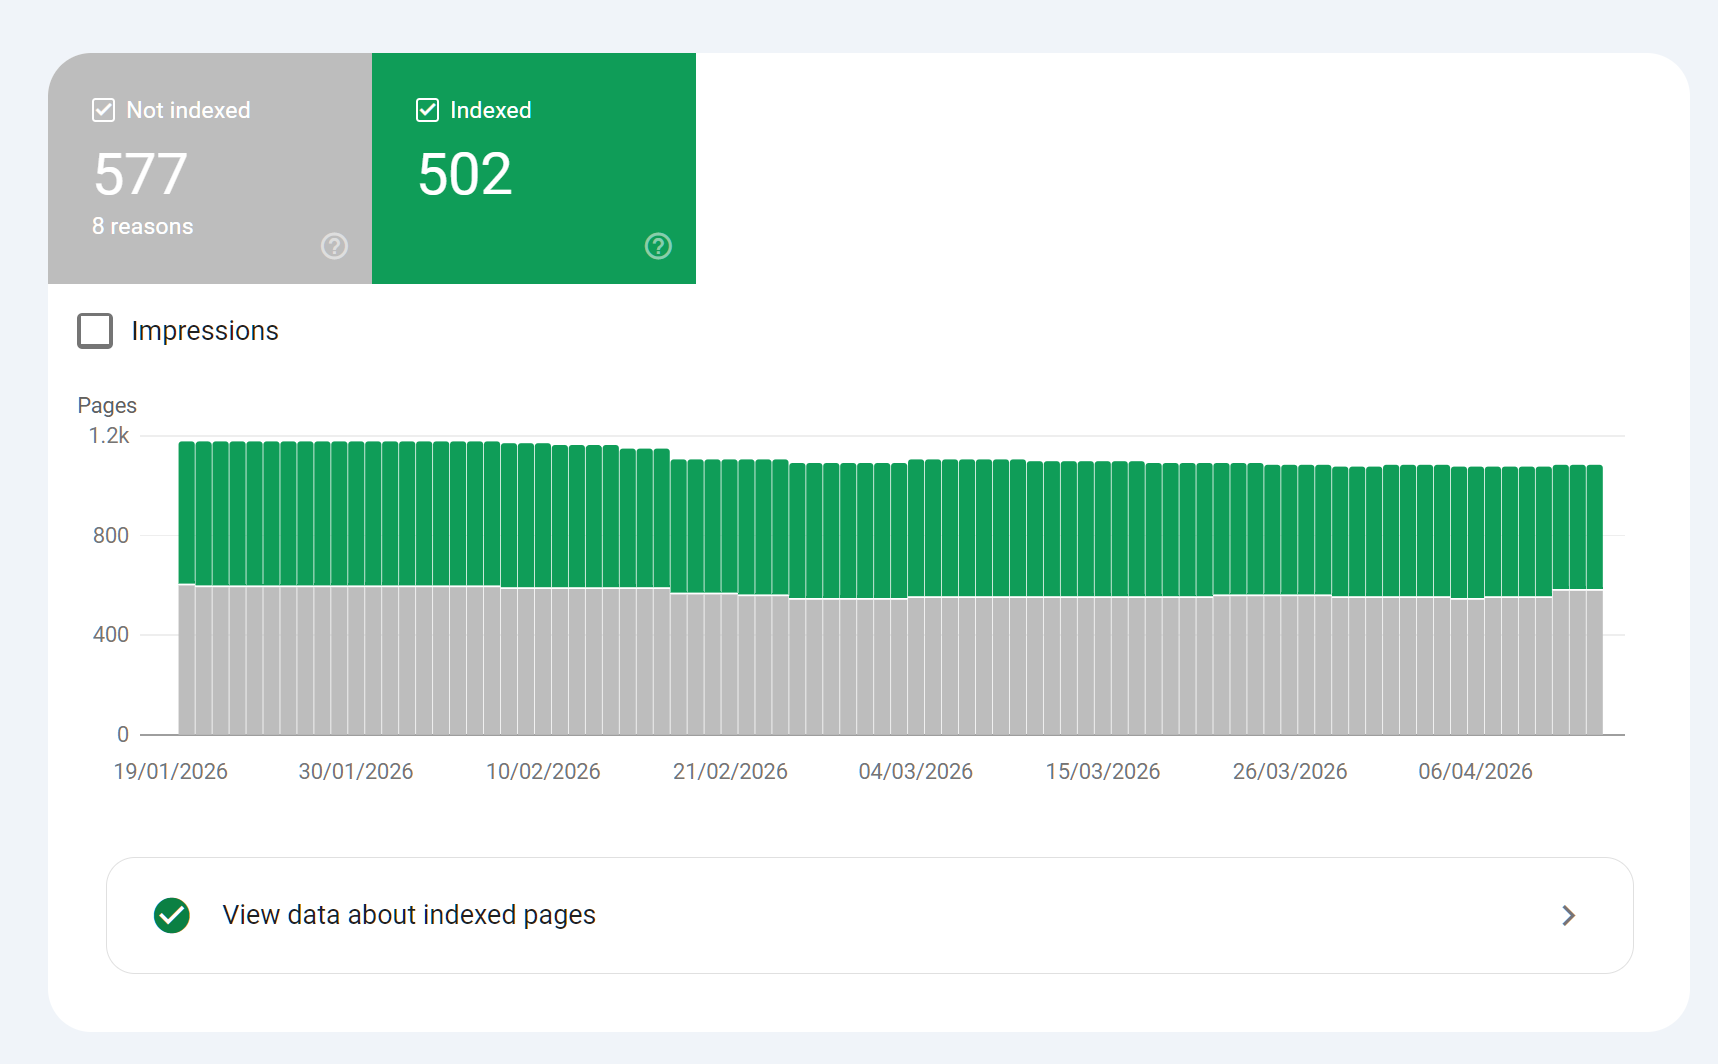
Die 16 Monate gelten schon seit Langem. Realistisch betrachtet gibt es für Google keinen Grund, das auszuweiten – es kostet Geld, und aus Googles Sicht liefern 16 Monate Webmastern „ausreichend" Daten zum Arbeiten.
Was Google dazu tatsächlich gesagt hat
Hier wird es dünn. Google hat nie klar erklärt, warum die Aufbewahrungsdauer bei 16 Monaten liegt. Nicht 12, nicht 18, nicht 24. Du findest die Zahl in der Hilfe-Dokumentation als Fakt erwähnt, aber nicht als Position mit einer Begründung dahinter.
Die deutlichste öffentliche Aussage kam im Mai 2023 von John Mueller, als Leute fragten, ob das neue BigQuery-Bulk-Export-Feature historische Daten ziehen könne. Mueller bestätigte auf Twitter, dass es „keine Pläne" für einen historischen Export gebe. BigQuery erfasst Daten nur ab dem Tag, an dem du es einschaltest. Alles, was bereits im 16-Monats-Fenster liegt, bleibt dort – und wenn es herausfällt, ist es an beiden Stellen weg.
Bleibt also nur, aus Googles grundsätzlicher Arbeitsweise Rückschlüsse zu ziehen.
Die wahrscheinlichen Gründe
Da ich selbst eine SEO-Analytics-Plattform gebaut und betrieben habe, kann ich eine fundierte Vermutung anstellen, was dahintersteckt.
Speicher- und Query-Kosten.
Search Console ist kostenlos. Google liefert Milliarden von Zeilen an Hunderte Millionen Properties weltweit, und jeder Report im UI ist faktisch ein Live-Query. Jahrelange Daten pro Suchanfrage, pro Seite, pro Land, pro Gerät für jede verifizierte Property vorzuhalten, wäre eine enorme Infrastrukturrechnung für ein Produkt, das keinen direkten Umsatz erzeugt. 16 Monate sind der Kompromiss, der dir Jahresvergleiche ermöglicht, ohne Google zu unbegrenzter Aufbewahrung zu verpflichten.
Wir wissen aus erster Hand vom Aufbau von SEO Stack, wie heimtückisch groß die tatsächlich gespeicherte Datenmenge ist. Es gibt insgesamt 16 Dimensionen – stell dir also vor, für jeden Tag und jede ausgelieferte URL deiner Website gibt es Query-Daten, dazu alle Metriken wie Impressionen, CTR, Position, Gerät, Suchtyp, Land usw.
Für Google ist es also wirtschaftlich nicht tragfähig, das Limit aufzuheben – das ist auch einer der Gründe, warum du pro gesetztem Filter nur die obersten 1000 Zeilen abrufen kannst: Die Verarbeitung dieser Daten kostet Google Geld.
In SEO Stack siehst du, WIE groß Datensätze für eine EINZIGE Website werden können! Genau DAS ist der Grund, warum Google Search Console nicht über 16 Monate und 1000 Zeilen hinausgeht.
Schau dir diesen Snapshot an: 1 Website mit in SEO Stack eingelagerten Search-Console-Daten hat 656.917.649 Zeilen Textdaten mit insgesamt 67 Gigabyte! Und das ist 1 Website! Wenn du diese Website in SEO Stack öffnest, müssen wir jeden einzelnen Datensatz verarbeiten, damit wir Massensortierung und Query-Filterung über den gesamten Datensatz hinweg anbieten können – anders als GSC, das dir nur gesampelte Daten gibt.
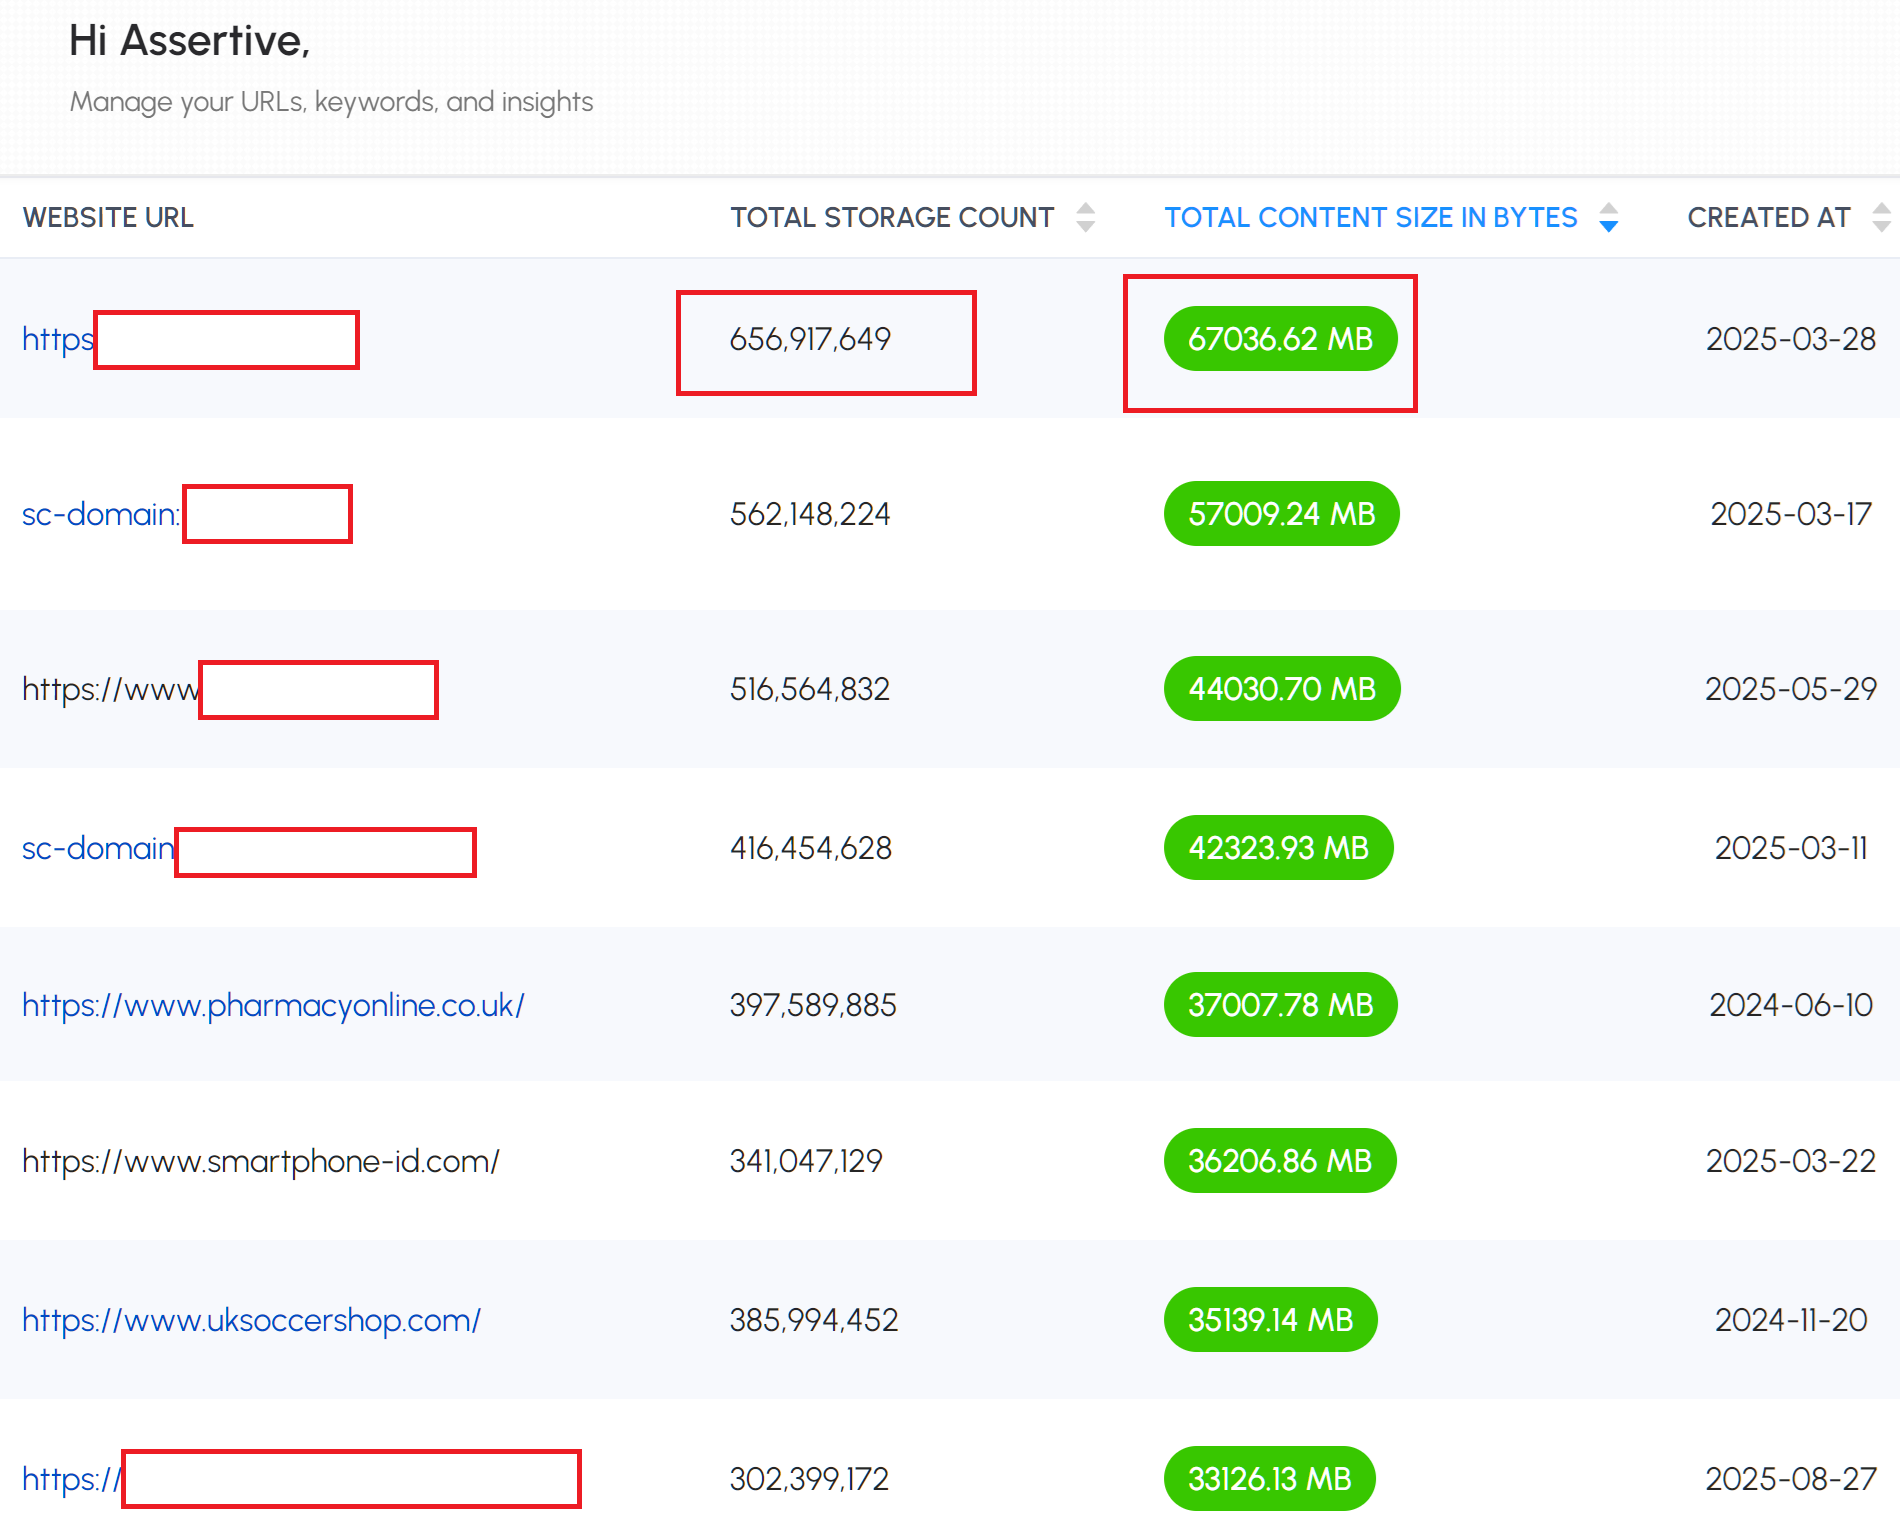
Wir haben das auf die harte Tour gelernt – und verstehen deshalb inzwischen, warum Google strikte Limits bei Zeiträumen und Zeilenzahlen gesetzt hat.
Geschwindigkeit.
Wer schon einmal eine große GSC-Property über einen langen Zeitraum gefiltert hat, kennt das träge UI. Das Fenster auf mehrere Jahre auszuweiten, ohne die Speicherarchitektur neu zu bauen, würde die Nutzung des Tools zur Qual machen. Google liefert lieber ein schnelles kostenloses Tool als ein langsames mit mehr Historie.
Dabei nicht vergessen: Google extrahiert IMMER NOCH nur die obersten 1000 Datenzeilen und sampelt Daten. So leistungsfähig Google Search Console auch ist – die Performance ist für die begrenzte Datenmenge, die du bekommst, insgesamt langsam.
SEO Stack verarbeitet über 10.000.000 Datenzeilen pro Sekunde und hängt Google Search Console damit weit ab. Bis GSC 1000 Suchanfragen verarbeitet hat, hat SEO Stack über 1 Million verarbeitet.
Datenminimierung.
Spekulativ, aber plausibel. Regulierungsbehörden in der EU und anderswo drängen stark auf kürzere Aufbewahrungsfristen für alles, was Query-Level-Daten betrifft. Aggregierte Suchperformance-Daten sind weniger sensibel als individuelle Nutzer-Logs, aber Googles allgemeine Richtung lautet: weniger speichern, kürzer speichern. 16 Monate passen in dieses Muster.
Das Ökosystem.
Die höfliche Version: Google stellt das Rohdatenfenster bereit und überlässt Drittanbieter-Tools die längerfristige Analyse darauf. Die zynische Version: Würde GSC fünf Jahre saubere First-Party-Daten kostenlos speichern, wäre der Business Case für Ahrefs, Semrush und Co. deutlich schwieriger. Ich glaube nicht, dass Ökosystem-Schutz der Hauptgrund ist, aber es würde mich wundern, wenn er nicht irgendwo auf der Liste stünde.
Nichts davon ist bestätigt. Googles offizielle Position lautet im Kern: „16 Monate sind das, was du bekommst." Alles andere ist fundiertes Raten.
Ihre Haltung ist: Wir geben dir genug Daten zum Arbeiten; willst du mehr, nutze unsere API oder Google BigQuery. Aber Daten in BigQuery zu speichern ist eine Sache – sie wieder herauszubekommen erfordert SQL-Kenntnisse oder dass du dein eigenes UI baust (oder Data Studio anbindest).
Warum BigQuery das Problem für mich nicht wirklich gelöst hat
Als Google im Februar 2023 den Bulk Export zu BigQuery ankündigte, habe ich ihn noch in derselben Woche auf der Website meiner Agentur und auf ein paar Kunden-Properties eingerichtet. Das Feature selbst ist wirklich nützlich. Du bekommst ungesampelte Daten mit vollständiger Zeilenzahl, die täglich in dein eigenes BigQuery-Projekt geschrieben werden – inklusive der Long-Tail-Suchanfragen, die das UI hinter seinem 1.000-Zeilen-Limit versteckt. Für meine eigene Analysearbeit war das wertvoll.
Aber es füllt nichts rückwirkend auf. Keinen einzigen Tag.
Ich hatte einen Kunden, der ein Deck mit Traffic-Mustern bis zurück ins Jahr 2020 wollte (ja, es gibt GA4, aber dort fehlte eine riesige Datenmenge). Ich wusste bereits, dass die historischen Daten nicht verfügbar waren – und ich gebe Kunden ungern Drittanbieter-Daten aus AHREFS oder SEMRUSH, vor allem wegen der schieren Lücken zwischen First-Party-Daten (GSC) und Third-Party-Daten (SEMRUSH/AHREFS etc.). Der Tag, an dem du den Export für BigQuery einschaltest, ist Tag null. Jeder Tag danach baut Historie auf. Davor: nichts.
Wir hatten mit dem Aufbau von SEO Stack begonnen, bevor Google die BigQuery-Integration in GSC ankündigte, denn davor konntest du GSC-Daten nur über die API ziehen und musstest dann deine eigene Architektur drumherum bauen, um die Daten zu speichern und zu verarbeiten (und ich kann dir aus Erfahrung sagen: das war NICHT einfach) – GSC ist deutlich komplexer, als es aussieht. Das haben wir erst gemerkt, als wir es nachgebaut haben.
Die praktische Konsequenz ist, dass BigQuery das Problem nur in der Zukunftsform löst. Richtest du den Export heute ein, hast du in 16 Monaten zum ersten Mal das rollierende Fenster durchbrochen – mit 16 Monaten aus GSC plus allem, was du darüber hinaus in BigQuery angesammelt hast. Nach drei Jahren Export hast du drei Jahre Historie. Es funktioniert, aber es ist ein langsamer Aufbau, und der Preis ist, dass du diese Entscheidung achtzehn Monate vor dem Zeitpunkt treffen musst, an dem du die Daten tatsächlich brauchst.
Die Lehre, die ich daraus gezogen habe und die ich jetzt bei jedem neuen Kunden durchsetze: Schalte den BigQuery-Export am ersten Tag der Zusammenarbeit ein, nicht an dem Tag, an dem jemand nach einem Fünf-Jahres-Trend fragt. Wenn die Frage kommt, hast du die nicht exportierten Monate bereits verloren. Wir empfehlen Kunden außerdem SEO Stack, vor allem weil wir eine deutlich bessere Architektur für Data Warehousing und Verarbeitung bieten.
Noch etwas: Der BigQuery-Export hat eine Verzögerung von rund 48 Stunden, bis die ersten Daten ankommen, und er enthält nicht jeden Reporttyp. Coverage-Daten etwa sind nicht im Export enthalten. Wenn du auch die technischen Daten archivieren willst, brauchst du dafür einen separaten Prozess.
Warum Ahrefs und Semrush kein Ersatz waren
Der naheliegende Ausweg, wenn du keine historischen Daten von Google bekommst, ist, sie aus einem Drittanbieter-Tool zu ziehen. Ahrefs und Semrush zeigen beide geschätzten organischen Traffic über Jahre zurück. Wenn du ein Diagramm für ein Pitch-Deck brauchst und Präzision keine große Rolle spielt, ist das die praktikabelste Antwort.
Ich habe das in einem Projekt sauber getestet, in dem ich vollen GSC-Zugang hatte und die Zahlen gegenprüfen wollte. Die Ergebnisse waren so grob, dass ich aufgehört habe, sie zu nutzen.
Hier habe ich die schiere Lücke zwischen den Query-Zahlen einer Kunden-Website in SEO Stack (also eingelagerte GSC-Daten ohne Limits) gegenüber AHREFS und SEMRUSH gezeigt – und nun, die Zahlen sprechen für sich.
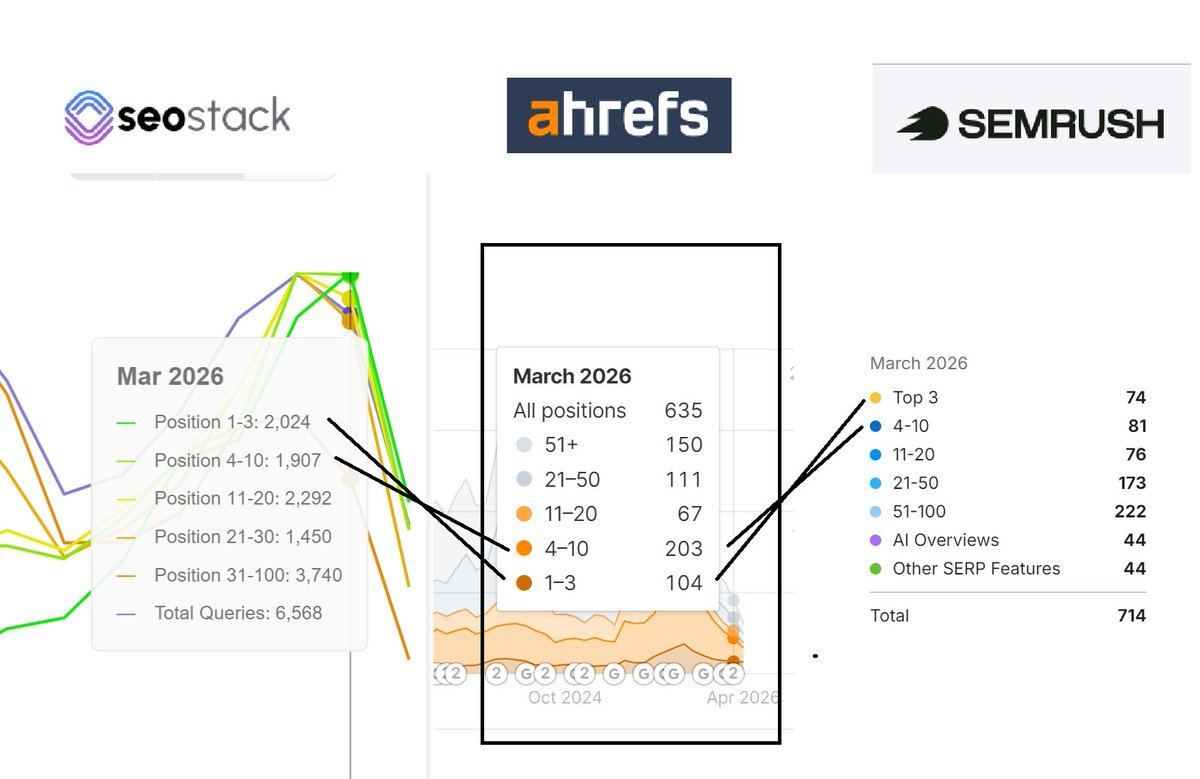
Bei den von mir verglichenen Domains lagen die Traffic-Schätzungen von Ahrefs und Semrush so weit daneben, dass sie für alles Entscheidungsrelevante unbrauchbar waren. Das deckt sich mit unabhängigen Untersuchungen: Eine Studie von Collaborator, die 184 Websites verglich, ermittelte über Ahrefs, Semrush und Similarweb hinweg eine durchschnittliche Fehlerquote von rund 50 % gegenüber den tatsächlichen GSC-Werten, wobei Ahrefs mit etwa 48 % Fehler am besten abschnitt. Ein separater Beitrag von Serpple bezifferte die durchschnittliche Abweichung von Ahrefs in ihrer Stichprobe auf rund 22 %. Wie man es auch dreht: Du hast ein Tool vor dir, das in der Tendenz nützlich, in den Zahlen aber unzuverlässig ist.
Der Grund ist struktureller Natur, und es lohnt sich, ihn zu verstehen, statt ihn einfach abzutun:
Ihr Keyword-Universum ist eine Stichprobe, keine vollständige Erfassung. Sie tracken ein definiertes Keyword-Set, nicht jede Suchanfrage, die jemals einen Klick auf deine Seite gebracht hat. Drittanbieter-Tools tun sich mit einem RIESIGEN Volumen an ZSV-Suchanfragen (Zero Search Volume) schwer.
Ihre Positionsdaten sind eine Momentaufnahme, keine durchgehende Aufzeichnung. Keywords, für die du in einer volatilen Phase gerankt hast, werden übersehen.
Ihre Suchvolumenzahlen sind selbst Schätzungen, oft zeitverzögert und manchmal weit daneben, besonders bei kleineren Märkten und Long-Tail-Begriffen.
Die Klickrate ist modelliert, nicht beobachtet.
Multipliziere vier Schätzungen miteinander, und das Ergebnis hat sehr wenig damit zu tun, was in Googles Logs tatsächlich passiert ist. Für Wettbewerbsanalysen, Marktdimensionierung oder das Erkennen von Trendrichtungen sind Ahrefs und Semrush weiterhin in Ordnung. Um fehlende GSC-Historie für die eigene Website aufzufüllen, sind sie nicht genau genug, um sie jemandem vorzulegen, der die Zahlen nachprüft.
Ich nutze AHREFS und habe in der Vergangenheit SEMRUSH genutzt – sie sind großartig zur „Orientierung" bei Wettbewerbsvergleichen, aber die Realität ist: Die Zahlen liegen weit daneben.
Was man dagegen tun kann
Drei Dinge, nach Wichtigkeit geordnet.
Schalte den BigQuery-Bulk-Export heute für jede relevante Property ein. Für eine normale Website kostet das an Speicher sehr wenig, und es ist der einzige Mechanismus, den Google selbst bereitstellt, um Daten über 16 Monate hinaus zu behalten. Der Preis dafür, sich in einem Jahr zu wünschen, man hätte es getan, ist deutlich höher als die BigQuery-Rechnung.
Oder nutze SEO Stack oder SEO Gets für Datenspeicherung + UI.Führe parallel einen monatlichen CSV-Export als doppelte Absicherung. Wenn BigQuery getrennt wird, das Projekt umstrukturiert wird oder ein Owner geht und die Berechtigungen brechen, hast du immer noch die monatlichen Snapshots. Ich habe BigQuery-Konfigurationen oft genug schieflaufen sehen, um mich nicht allein darauf zu verlassen.
Nutze Drittanbieter-Tools für das, worin sie tatsächlich gut sind: Wettbewerbs-Sichtbarkeit, Backlink-Discovery, Erweiterung des Keyword-Universums, grobe Marktdimensionierung. Nutze sie nicht als Ersatz für deine eigene GSC-Historie, denn das sind sie nicht.
Das 16-Monats-Fenster wird sich nicht ändern. Google hatte beim Launch des BigQuery-Exports die offensichtliche Gelegenheit, es auszuweiten, und hat sich dagegen entschieden. Die vernünftige Annahme ist, dass das Limit bleibt, wo es ist, und die Verantwortung für längere Aufbewahrung beim Website-Betreiber liegt. Das ist ärgerlich, aber es ist die Arbeitsrealität – und je früher du handelst, desto weniger Historie verlierst du.

Gründer, SEO Stack
Daniel ist der Gründer von SEO Stack. Er arbeitet seit über 2 Jahrzehnten an technischem SEO und Suchdaten und hat SEO Stack entwickelt, nachdem er in der Kundenarbeit einmal zu oft an dieselben Search-Console-Limits gestoßen war.
Daniel verfügt über umfangreiche SEO-Erfahrung: Er hat SEO-Agenturen, Audit-Unternehmen und eine erfolgreiche Beratung aufgebaut. In seiner Freizeit führt Daniel gerne SEO-Experimente durch und teilt seine Erkenntnisse.
Veröffentlicht 19. April 2026

